La curiosité et l’intuition sont deux des outils les plus puissants du Data Scientist. Le troisième est peut-être Pandas…
Nous allons voir ici l’extraction d’informations avec Pandas et Seaborn, à partir d’un dataset Kaggle sur les athlètes des Jeux olympiques.
En bref : à partir de la colonne Sport du dataset « 120 ans d’histoire olympique », cet article extrait des informations avec Pandas et Seaborn. Chez les hommes, le tir à la corde, le rugby à 7 et le bobsleigh ont les athlètes les plus corpulents, la gymnastique les plus légers et les plus petits, et le basket-ball les plus grands. 34 des 63 sports sont apparus aux Jeux en 1920 au plus tard.
Dans un précédent article, je t’ai montré comment avoir une idée du degré d’exhaustivité d’un jeu de données, tracer quelques variables et examiner les tendances et les évolutions dans le temps. Pour cela, nous avons utilisé Pandas dans un notebook Jupyter pour l’analyse et le traitement des données, et Seaborn pour les visuels.
Pour cet article, comme pour le précédent, nous utilisons le jeu de données Kaggle « 120 ans d’histoire olympique : athlètes et résultats » que tu peux télécharger ici.
Nous avions examiné la participation des femmes au fil du temps, la répartition du poids et de la taille des athlètes, ainsi que d’autres variables, mais sans utiliser le sport que chaque athlète pratiquait.
Cette fois-ci, nous nous concentrons sur la colonne Sport pour en tirer quelques enseignements. Voici les questions auxquelles on peut penser :
- Quels sont les sports qui favorisent les personnes lourdes ? Et les personnes de grande taille ?
- Quels sont les sports les plus récents et les plus anciens ? Y en a-t-il qui ont cessé d’être pratiqués aux Jeux olympiques ?
- Y a-t-il des sports où le même pays gagne presque toujours ? Celle-ci, je te la laisse en exercice à la fin de l’article.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : le fichier de données s’y télécharge tout seul. Le code est testé avec Pandas 3 et Seaborn 0.13, et il fonctionne aussi avec Pandas 2. Plongeons dans le vif du sujet !
Quels sports ont les athlètes les plus lourds et les plus grands ?
Pour notre première analyse, nous allons regarder quels sports ont les athlètes les plus lourds et les plus grands, et lesquels ont les plus légers ou les plus petits.
Le fichier athlete_events.csv pèse 41 Mo. Pour le publier sur GitHub, je l’ai découpé en deux parties d’environ 20 Mo. Ce premier bloc télécharge les deux parties et les recolle en un seul fichier. Si tu as déjà athlete_events.csv à côté de ton notebook (téléchargé depuis Kaggle, par exemple), il est simplement réutilisé :
from pathlib import Path
import urllib.request

FICHIER = 'athlete_events.csv'
BASE = 'https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/exploration-de-donnees-statistiques/'
PARTIES = ['athlete_events_partie1.csv', 'athlete_events_partie2.csv']

if not Path(FICHIER).exists():
    with open(FICHIER, 'wb') as sortie:
        for numero, nom in enumerate(PARTIES):
            urllib.request.urlretrieve(BASE + nom, nom)
            lignes = Path(nom).read_bytes().splitlines(keepends=True)
            sortie.writelines(lignes if numero == 0 else lignes[1:])

print(FICHIER, 'prêt :', round(Path(FICHIER).stat().st_size / 1e6, 1), 'Mo')athlete_events.csv prêt : 41.2 MoJe charge ensuite le fichier avec Pandas :
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

sns.set_theme(style='whitegrid')

df = pd.read_csv('athlete_events.csv')
df.shape(271116, 15)Comme nous l’avons vu dans l’article précédent, la taille et le poids dépendent fortement du sexe, et nous avons plus de données sur les athlètes masculins que sur les athlètes féminines. Nous allons donc faire cette analyse sur les hommes. Le même code fonctionnerait pour les femmes : il suffit de changer le filtre sur la colonne Sex.
male_df = df[df['Sex'] == 'M']

sport_metrics = male_df.groupby('Sport')[['Weight', 'Height']].agg(['min', 'max', 'mean'])

sport_metrics['Weight'].dropna().sort_values('mean', ascending=False).head(5).round(2)Si je regroupe par sport avec groupby(), la méthode agg() me donne le poids et la taille minimum, maximum et moyenne des athlètes de chaque sport. (Si tu veux revoir groupby en détail, j’ai écrit un guide sur le groupby de Pandas.)
Note les doubles crochets dans [['Weight', 'Height']] : avec des crochets simples, comme on l’écrivait dans d’anciennes versions de Pandas, tu obtiens aujourd’hui une erreur.
J’ai ensuite regardé les 5 sports avec les athlètes les plus lourds, et j’ai trouvé ceci (en kilogrammes) :
                   min    max   mean
Sport
Tug-Of-War        75.0  118.0  95.62
Basketball        59.0  156.0  91.68
Rugby Sevens      65.0  113.0  91.01
Bobsleigh         55.0  145.0  90.39
Beach Volleyball 62.0 110.0 89.51Rien d’inattendu, n’est-ce pas ? Les tireurs à la corde, les joueurs de basket-ball et de rugby à 7 sont tous lourds. Il est intéressant de voir que les poids varient énormément chez les basketteurs (de 59 à 156 kg), alors que presque tous les tireurs à la corde sont lourds. Voyons cela de plus près :
corde = male_df.loc[male_df['Sport'] == 'Tug-Of-War', 'Weight'].dropna()

# Nombre d'athlètes avec un poids connu, et part de ceux qui pèsent plus de 80 kg
len(corde), float(round((corde > 80).mean(), 2))Sur les 52 tireurs à la corde dont le poids est renseigné, 94 % pèsent plus de 80 kg :
(52, 0.94)Ensuite, j’ai regroupé le poids moyen de chaque sport dans un histogramme. La méthode dropna() retire les sports pour lesquels aucun poids n’est renseigné, et kde=True ajoute la courbe de densité :
mean_weights = sport_metrics['Weight']['mean'].dropna()
mean_heights = sport_metrics['Height']['mean'].dropna()

sns.histplot(mean_weights, kde=True)
plt.xlabel('Poids moyen des hommes par sport (kg)')
plt.ylabel('Nombre de sports')
plt.show()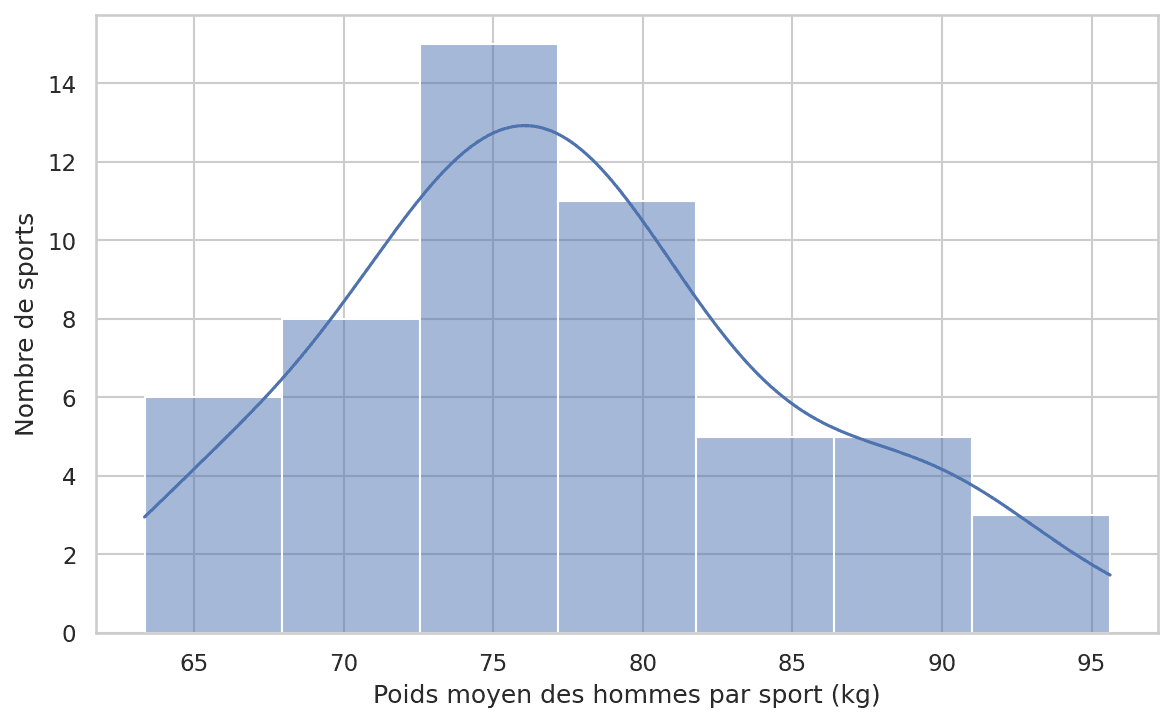
La répartition ressemble à une cloche centrée autour de 77 kg, légèrement étalée vers les poids élevés.
La taille moyenne des athlètes a aussi une répartition en cloche, mais plus resserrée. Un petit groupe de trois sports se détache à droite, entre 193 et 195 cm :
sns.histplot(mean_heights, kde=True)
plt.xlabel('Taille moyenne des hommes par sport (cm)')
plt.ylabel('Nombre de sports')
plt.show()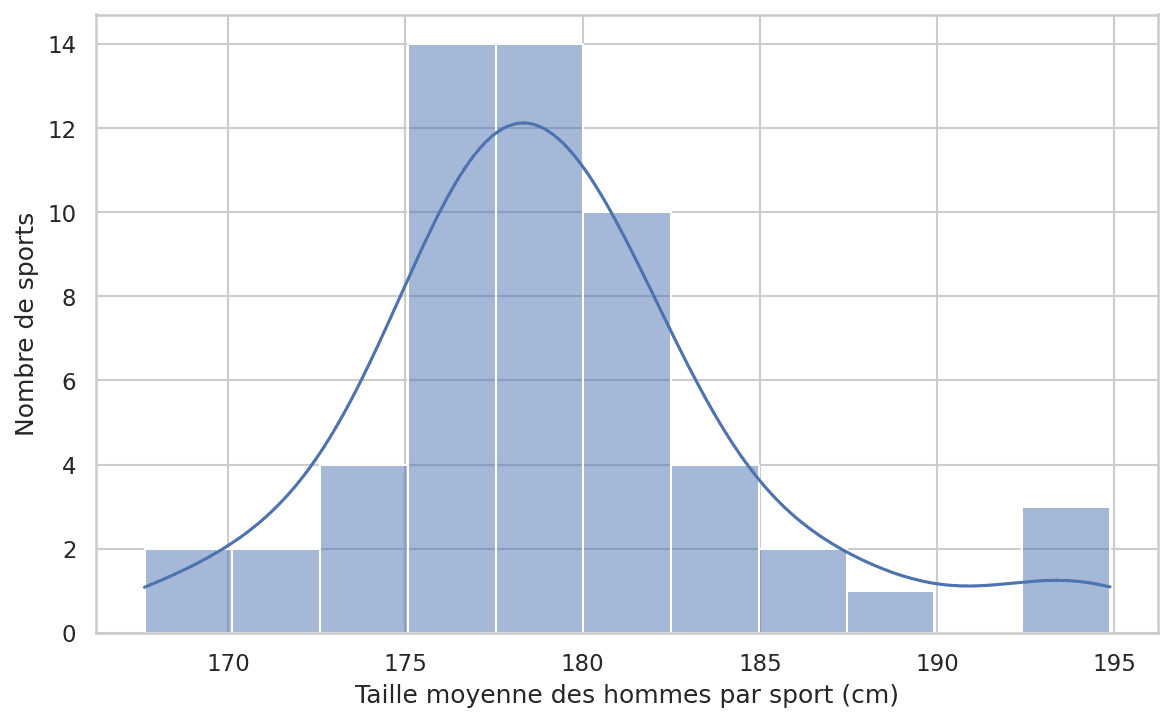
Pour comparer les deux, voici leurs statistiques descriptives :
pd.DataFrame({'poids (kg)': mean_weights.describe(), 'taille (cm)': mean_heights.describe()}).round(1) poids (kg) taille (cm)
count 53.0 56.0
mean 77.4 179.3
std 7.5 5.4
min 63.3 167.6
25% 72.2 176.4
50% 76.9 178.7
75% 81.5 181.1
max 95.6 194.9La taille moyenne est de 179,3 cm pour un écart-type de 5,4 cm, soit 3 % de la moyenne. Pour le poids, l’écart-type est de 7,5 kg pour 77,4 kg de moyenne, soit 10 %. Les sports se ressemblent donc beaucoup plus par la taille que par le poids. Remarque aussi la ligne count : 53 sports ont au moins un poids renseigné chez les hommes, mais 56 ont une taille. Trois sports anciens (le polo, les raquettes et le jeu de paume) n’ont que la taille.
Ensuite, j’ai représenté toutes les moyennes dans un nuage de points ordonné, pour voir s’il y avait des valeurs aberrantes. Comme je vais refaire le même graphique pour la taille, j’écris une fonction :
def tracer_classement(valeurs, ylabel):
    """Nuage de points des moyennes triées, avec le nom des deux sports aux extrémités."""
    valeurs = valeurs.sort_values()
    ax = sns.scatterplot(x=range(len(valeurs)), y=valeurs.values)
    ax.set(xlabel='Sports classés du plus petit au plus grand', ylabel=ylabel)
    for rang, cote in ((0, 'left'), (len(valeurs) - 1, 'right')):
        decalage = 10 if cote == 'left' else -10
        ax.annotate(valeurs.index[rang], (rang, valeurs.iloc[rang]),
                    textcoords='offset points', xytext=(decalage, -3), ha=cote)
    plt.show()

tracer_classement(mean_weights, 'Poids moyen (kg)')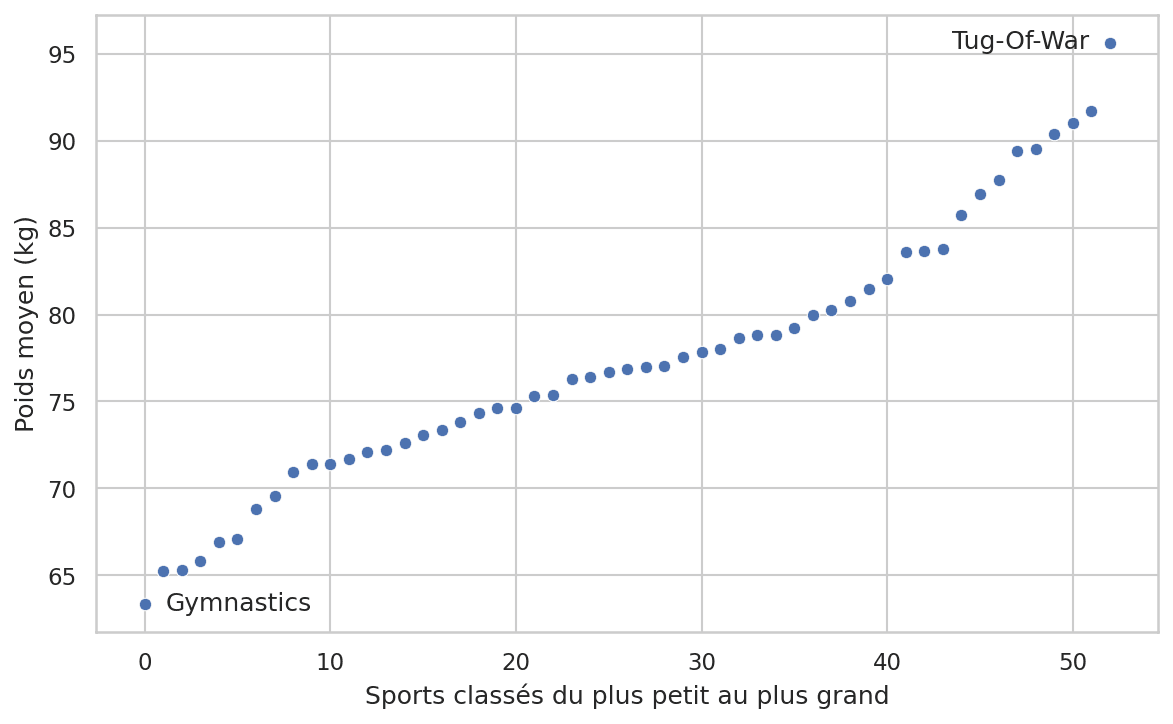
Le tir à la corde est à part : son poids moyen dépasse de 3,9 kg celui du sport suivant (le basket-ball), alors que l’écart habituel entre deux sports voisins est d’environ 0,5 kg. En bas du classement, la gymnastique se détache moins, avec 1,9 kg de moins que le saut à ski.
Pour les sports les plus légers (on a déjà vu les plus lourds), on utilise le même classement :
print(mean_weights.sort_values().head(5).round(2).to_string())Sport
Gymnastics 63.34
Ski Jumping 65.25
Boxing 65.30
Trampolining 65.84
Nordic Combined 66.91Ainsi, les gymnastes, même masculins, sont les plus légers ! Ils sont suivis de près par le saut à ski, la boxe (ce qui m’a un peu surpris : la moyenne mélange toutes les catégories de poids) et le trampoline, ce qui est en fait très logique.
Voyons maintenant la taille, avec la fonction que l’on vient d’écrire :
tracer_classement(mean_heights, 'Taille moyenne (cm)')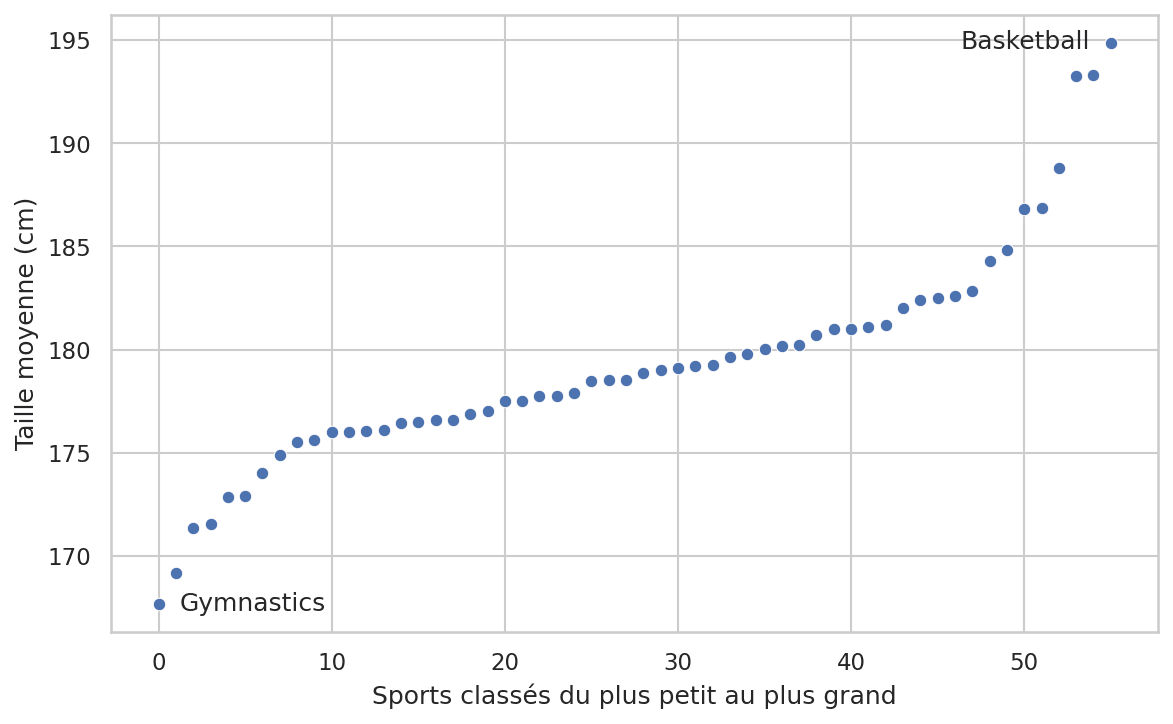
Même si la variance est nettement plus faible, le graphique montre un écart encore plus net : le volley-ball, le beach-volley et le basket-ball dépassent de 4,5 cm le sport suivant (le handball), alors que l’écart habituel entre deux sports voisins est d’environ 0,15 cm.
Pour comparer des kilos et des centimètres, on peut mesurer l’écart à la moyenne en écarts-types :
# Écart à la moyenne, exprimé en écarts-types (comparable entre kg et cm)
for nom, valeurs in (('poids', mean_weights), ('taille', mean_heights)):
    z = (valeurs - valeurs.mean()) / valeurs.std()
print(f"{nom} : {z.idxmax()} {z.max():.1f} ; {z.idxmin()} {z.min():.1f}")poids : Tug-Of-War 2.4 ; Gymnastics -1.9
taille : Basketball 2.9 ; Gymnastics -2.2Le basket-ball est à 2,9 écarts-types de la moyenne des tailles, alors que le tir à la corde est à 2,4 écarts-types de la moyenne des poids. Les valeurs aberrantes sont donc plus marquées pour la taille, justement parce que la plupart des sports se ressemblent.
Voici les cinq sports aux athlètes les plus petits et les plus grands :
print('Les plus petits :')
print(mean_heights.sort_values().head(5).round(1).to_string())
print('\nLes plus grands :')
print(mean_heights.sort_values(ascending=False).head(5).round(1).to_string())Les plus petits :
Sport
Gymnastics 167.6
Weightlifting 169.2
Trampolining 171.4
Diving 171.6
Wrestling 172.9
Les plus grands :
Sport
Basketball 194.9
Beach Volleyball 193.3
Volleyball 193.3
Handball 188.8
Rowing 186.9Je suppose que nous nous attendions tous à ce que le même sport arrive en tête, et sans surprise, c’est le basket-ball. Au moins, nous pouvons maintenant dire que ce n’est pas un stéréotype. Autre point : la gymnastique est à la fois le sport le plus léger et le plus petit.
Mais certains sports ne figurent que dans l’un des deux classements : l’haltérophilie, par exemple, est parmi les plus petits mais pas parmi les plus légers. Pour combiner les deux, je me demande quelle est la « corpulence » de chaque sport. Je la mesure ici de façon simple, en divisant le poids moyen par la taille moyenne :
# Corpulence simplifiée : poids moyen (kg) / taille moyenne (cm)
avg_build = (mean_weights / mean_heights).dropna().sort_values()

sns.lineplot(x=range(len(avg_build)), y=avg_build.values)
plt.xlabel('Sports classés du moins au plus corpulent')
plt.ylabel('Poids / taille (kg par cm)')
plt.show()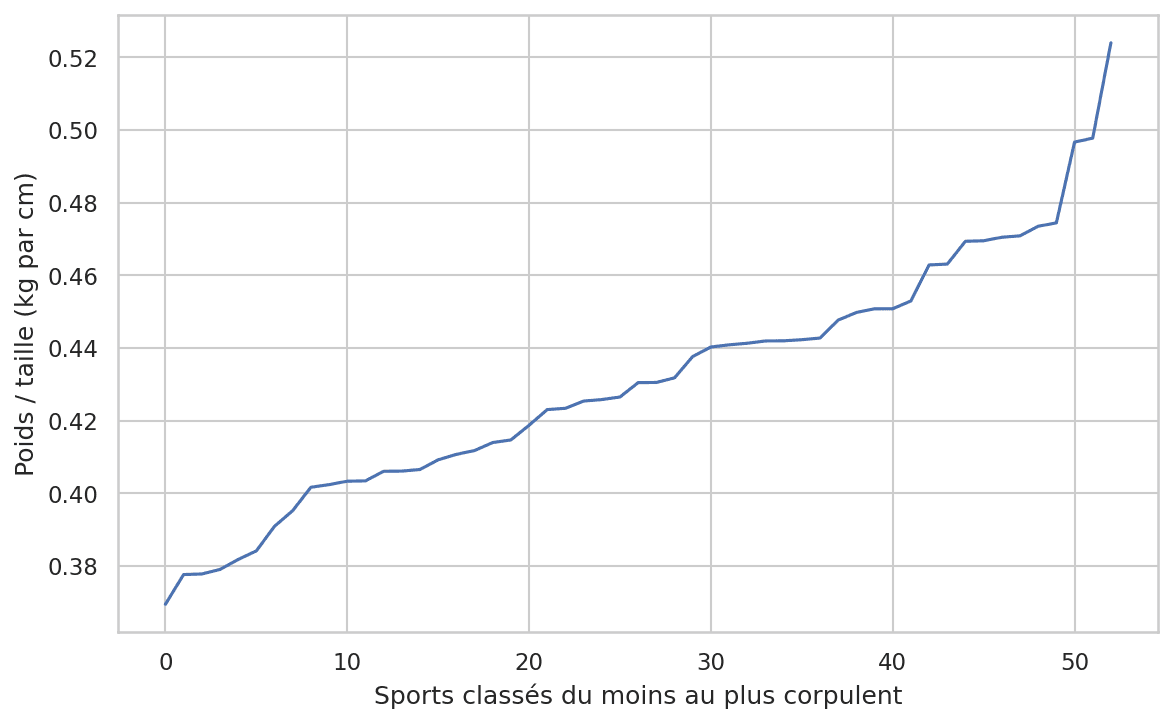
Pandas aligne les deux séries sur le nom du sport : un sport sans poids ou sans taille donne NaN, que dropna() retire (il reste 53 sports). La courbe monte presque régulièrement, puis se redresse nettement pour les trois derniers sports :
print('Les moins corpulents :')
print(avg_build.head(5).round(3).to_string())
print('\nLes plus corpulents :')
print(avg_build.tail(5)[::-1].round(3).to_string())Les moins corpulents :
Sport
Ski Jumping 0.369
Boxing 0.378
Gymnastics 0.378
Nordic Combined 0.379
Triathlon 0.382
Les plus corpulents :
Sport
Tug-Of-War 0.524
Rugby Sevens 0.498
Bobsleigh 0.497
Weightlifting 0.474
Handball 0.474Une fois encore, le tir à la corde, le rugby à 7 et le bobsleigh sont les sports où les athlètes sont les plus corpulents. L’haltérophilie et le handball suivent, avec un écart net par rapport aux trois premiers. À l’autre bout, ce sont le saut à ski, la boxe et la gymnastique qui ont les athlètes les moins corpulents, suivis du combiné nordique et du triathlon.
Quand les sports ont-ils été introduits aux Jeux olympiques ?
Maintenant que nous avons fait les analyses auxquelles je pensais avec ces trois colonnes, j’aimerais regarder la variable temporelle, et plus précisément l’année. Je veux voir si de nouveaux sports ont été introduits aux Jeux olympiques, et quand. Mais aussi quels sports ont été délaissés.
Ce code est utile chaque fois qu’on a besoin de savoir quand quelque chose s’est produit pour la première fois, surtout pour repérer une augmentation anormale d’une variable. Pour chaque sport, je récupère la première et la dernière année de participation, puis value_counts() compte combien de sports ont fait leur première apparition chaque année :
sport_years = male_df.groupby('Sport')['Year'].agg(['min', 'max'])

# Nombre de sports dont la première participation date de chaque année
new_sports = sport_years['min'].value_counts().sort_index()

sns.scatterplot(x=new_sports.index, y=new_sports.values)
plt.xlabel('Année')
plt.ylabel('Nombre de nouveaux sports')
plt.show()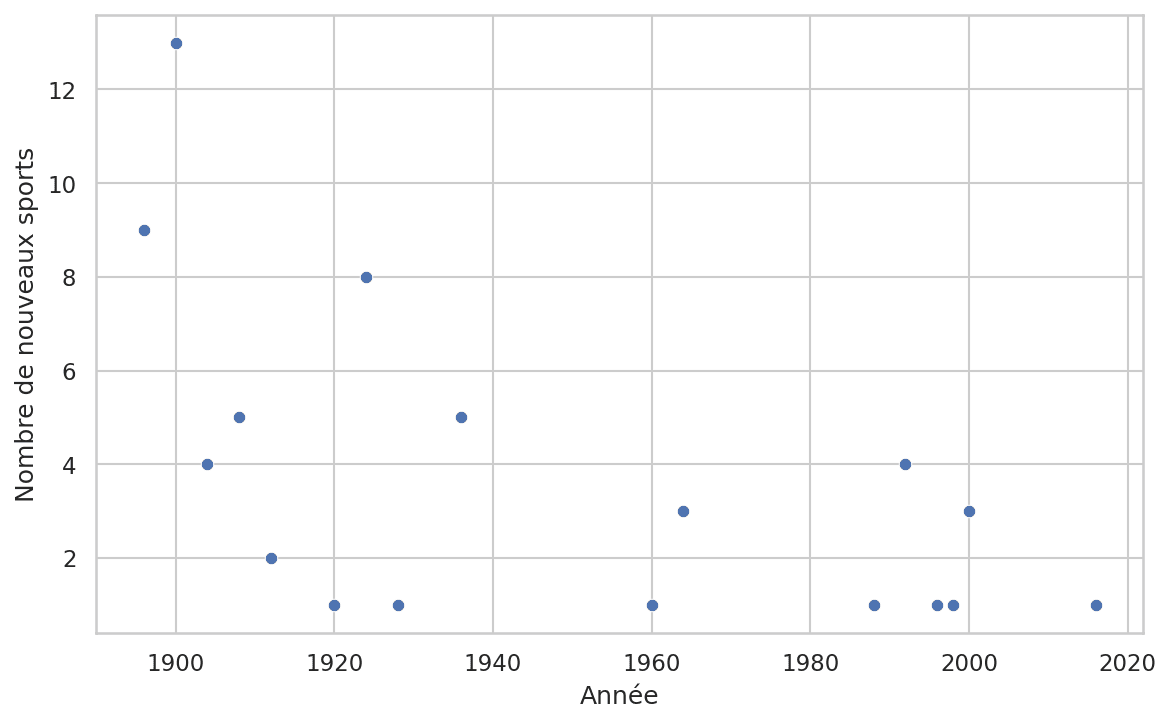
Le graphique nous montre combien de sports ont été pratiqués aux Jeux olympiques pour la première fois chaque année. Ou, en d’autres termes, combien de sports ont été introduits chaque année. Voici les chiffres :
print(new_sports.to_string())min
1896 9
1900 13
1904 4
1908 5
1912 2
1920 1
1924 8
1928 1
1936 5
1960 1
1964 3
1988 1
1992 4
1996 1
1998 1
2000 3
2016 1Plus de la moitié des sports (34 sur 63) sont apparus en 1920 au plus tard, dont 31 avant 1910, avec un pic de 13 nouveaux sports en 1900. Il y a un autre pic en 1924 (8 sports) : ce sont les sports d’hiver, comme le curling, le bobsleigh et le saut à ski, qui arrivent avec les premiers Jeux d’hiver. En 1936, cinq nouveaux sports apparaissent (l’aéronautique, le ski alpin, le basket-ball, le canoë-kayak et le handball). Ensuite, ils sont toujours introduits en petits groupes, jamais plus de quatre à la fois.
Il n’y a pas eu de nouveaux sports entre 1936 et 1960, lorsque le biathlon a été introduit, et ensuite ils ont continué à en ajouter assez régulièrement :
sport_years.loc[sport_years['min'] > 1936, 'min'].sort_values(kind='stable')Sport
Biathlon 1960
Judo 1964
Luge 1964
Volleyball 1964
Table Tennis 1988
Badminton 1992
Baseball 1992
Freestyle Skiing 1992
Short Track Speed Skating 1992
Beach Volleyball 1996
Snowboarding 1998
Taekwondo 2000
Trampolining 2000
Triathlon 2000
Rugby Sevens 2016
Name: min, dtype: int64Attention, nous travaillons ici sur les hommes. Trois sports du jeu de données n’apparaissent donc pas dans cette liste : la gymnastique rythmique (1984), le softball (1996) et la natation synchronisée (1984), qui n’ont que des athlètes féminines. Pour les 63 autres sports, la première année de participation ne change pas quand on ajoute les femmes.
Une analyse analogue, sur l’année maximale, donne les sports qui n’ont plus d’athlète masculin aux Jeux depuis avant 2000. Voici cette liste, dont la plupart ne m’avaient jamais été présentés (même si ce n’est en aucun cas une bonne mesure de la popularité d’un sport !) :
sport_years.loc[sport_years['max'] < 2000, 'max'].sort_values(kind='stable')Sport
Basque Pelota 1900
Cricket 1900
Croquet 1900
Roque 1904
Jeu De Paume 1908
Lacrosse 1908
Motorboating 1908
Racquets 1908
Tug-Of-War 1920
Military Ski Patrol 1924
Rugby 1924
Aeronautics 1936
Alpinism 1936
Polo 1936
Art Competitions 1948
Name: max, dtype: int64On voit que les concours artistiques ont été abandonnés après 1948, que le polo n’est plus pratiqué aux Jeux olympiques depuis 1936, et qu’il en va de même pour l’aéronautique. Mais que pouvait bien être cette discipline ? J’imaginais des gens dans un avion sans voir ce que pourrait être la compétition. Regardons les données :
df[df['Sport'] == 'Aeronautics'][['Name', 'Team', 'Games', 'Event', 'Medal']] Name Team Games Event Medal
214105 Hermann Schreiber Switzerland 1936 Summer Aeronautics Mixed Aeronautics GoldIl n’y a qu’un seul athlète : le Suisse Hermann Schreiber, médaille d’or en 1936. D’après Wikipédia, il a reçu cette médaille pour avoir été le premier à traverser les Alpes en planeur, de Thun à Bellinzona, en 5 h 47. Il est le seul à avoir reçu une médaille olympique d’aéronautique.
À toi de jouer
Voici la troisième question de départ : y a-t-il des sports où le même pays gagne presque toujours ? Pour y répondre, compte les médailles par sport et par pays, puis calcule la part du pays le plus titré :
medaled = df.dropna(subset=['Medal'])
medals = medaled.groupby(['Sport', 'NOC']).size()
total = medals.groupby('Sport').sum()

# Part des médailles du pays le plus titré, pour les sports avec au moins 200 médailles
share_top_country = (medals.groupby('Sport').max() / total)[total >= 200]
share_top_country.sort_values(ascending=False).head(10)Attention, une médaille d’équipe compte une ligne par athlète : un sport collectif pèse donc plus lourd qu’un sport individuel. À toi de voir comment en tenir compte. Tu peux aussi refaire toute l’analyse sur les athlètes féminines, en changeant le filtre df['Sex'] == 'F', et comparer avec les hommes.
Grouper, agréger, tracer : le geste que nous venons de répéter plusieurs fois. Le cours Analyse et visualisation de données de DataXp l’entraîne sur des jeux de données réels (annonces eBay, trafic de l’autoroute I-94, taux de change de l’euro). Tu écris et exécutes ton code dans le navigateur, avec 128 exercices, et les 3 premiers chapitres sont gratuits.
Pour aller plus loin avec Pandas, tu peux aussi lire mes astuces Pandas en Python.
C’est tout pour cette analyse ! J’espère que tu as apprécié ce tutoriel, et que tu as peut-être appris un fait intéressant à évoquer lors de ton prochain dîner de famille 🙂
Comme d’habitude, n’hésite pas à tourner et retourner le code de cette analyse et à y ajouter tes propres idées.