Si tu es data scientist, tu as sans doute déjà travaillé avec des graphiques à nuage de points. Malgré leur simplicité, ce sont des outils puissants pour visualiser des données.
Il existe de nombreuses façons de les représenter, en jouant sur la couleur, la taille, la forme ou le tracé de régression.
Dans cet article, je te dis à peu près tout ce que tu dois savoir sur la visualisation de données avec des graphiques à nuage de points. On passe en revue les principaux paramètres, et je t’explique quand et comment les utiliser (code inclus).
En bref : un graphique à nuage de points (scatter plot) représente deux variables numériques sous forme de points. Avec seaborn, tu peux y ajouter une droite ou une courbe de régression, une couleur ou une forme par catégorie, des histogrammes marginaux avec jointplot, et une troisième variable avec la taille des points (graphique à bulles).
Tu peux aussi exécuter tous les exemples dans ce notebook Google Colab : chaque graphique est dans sa propre cellule, prêt à être modifié.
Tu y trouveras peut-être quelques bonnes surprises et astuces à ajouter à ta boîte à outils data science !
Comment charger les données et les bibliothèques ?
Importation des bibliothèques
Avant de tracer nos graphiques, importons les bibliothèques nécessaires, seaborn et matplotlib :
import seaborn as sns
import matplotlib.pyplot as pltChargement du dataset
On travaille sur le dataset iris, que l’on charge dans un DataFrame avec load_dataset :
df = sns.load_dataset('iris')Comment ajouter une régression à un nuage de points ?
Lorsqu’on trace ses données pour la première fois sur un graphique à nuage de points, on obtient déjà un aperçu rapide :
# Graphique à nuage de points
sns.regplot(x=df["sepal_length"], y=df["sepal_width"], fit_reg=False)
plt.show()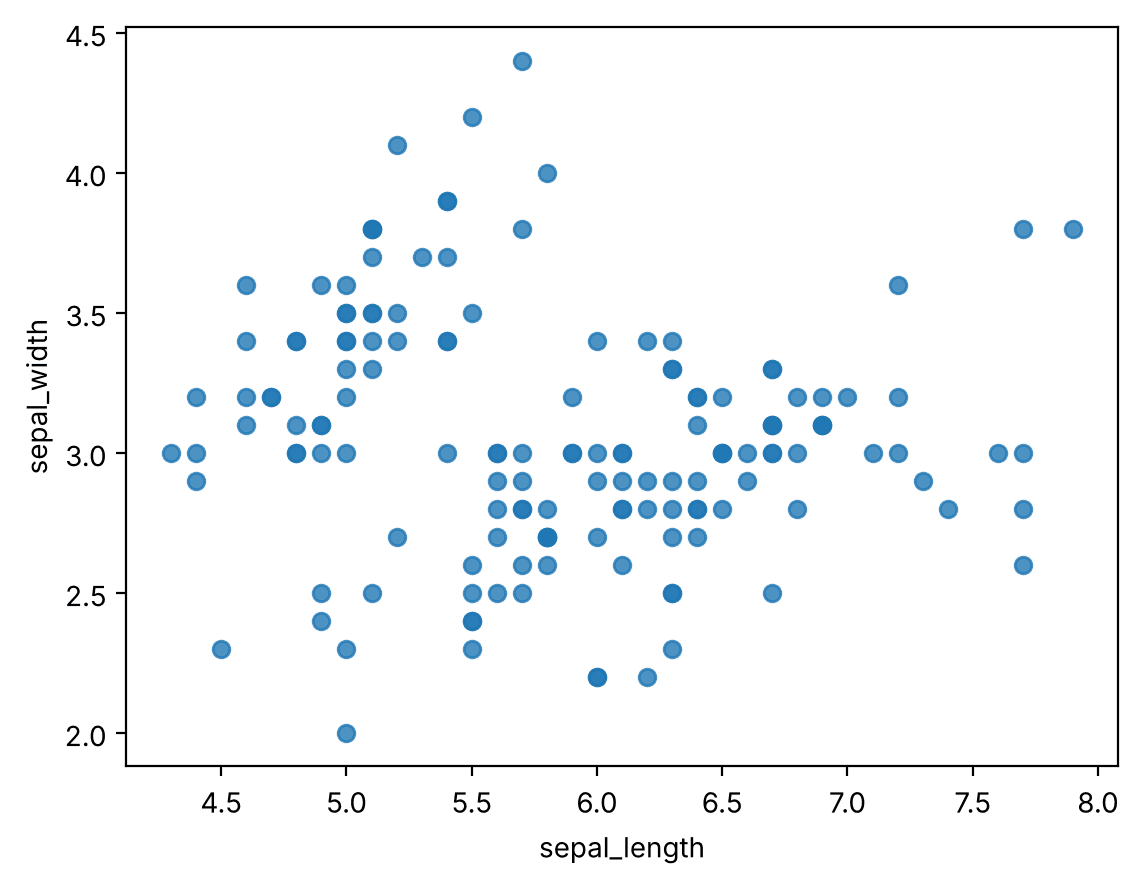
On distingue déjà les groupes où la plupart des points se concentrent, et l’on peut repérer rapidement les valeurs aberrantes.
Un tracé de régression permet d’aller plus loin et de voir à quel point la tâche de modélisation peut être compliquée. Voici d’abord une régression linéaire, avec fit_reg=True :
# Régression linéaire ajustée au graphique précédent
sns.regplot(x=df["sepal_length"], y=df["sepal_width"], fit_reg=True)
plt.show()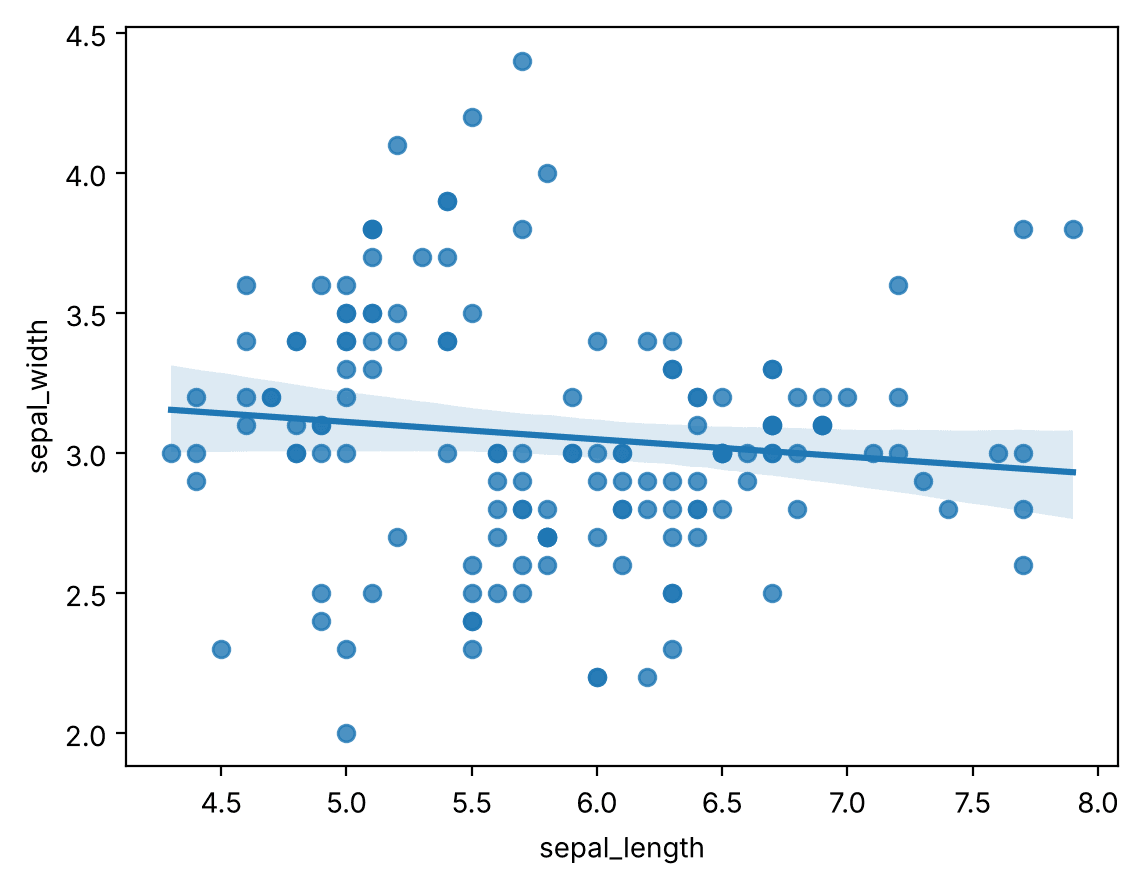
Dans la figure ci-dessus, on a tracé une droite de régression. On voit assez facilement qu’une fonction linéaire ne conviendra pas : beaucoup de points sont éloignés de la droite.
Essayons une régression polynomiale, avec l’argument order :
# Régression polynomiale ajustée au graphique d'origine
sns.regplot(x=df["sepal_length"], y=df["sepal_width"], fit_reg=True, order=4)
plt.show()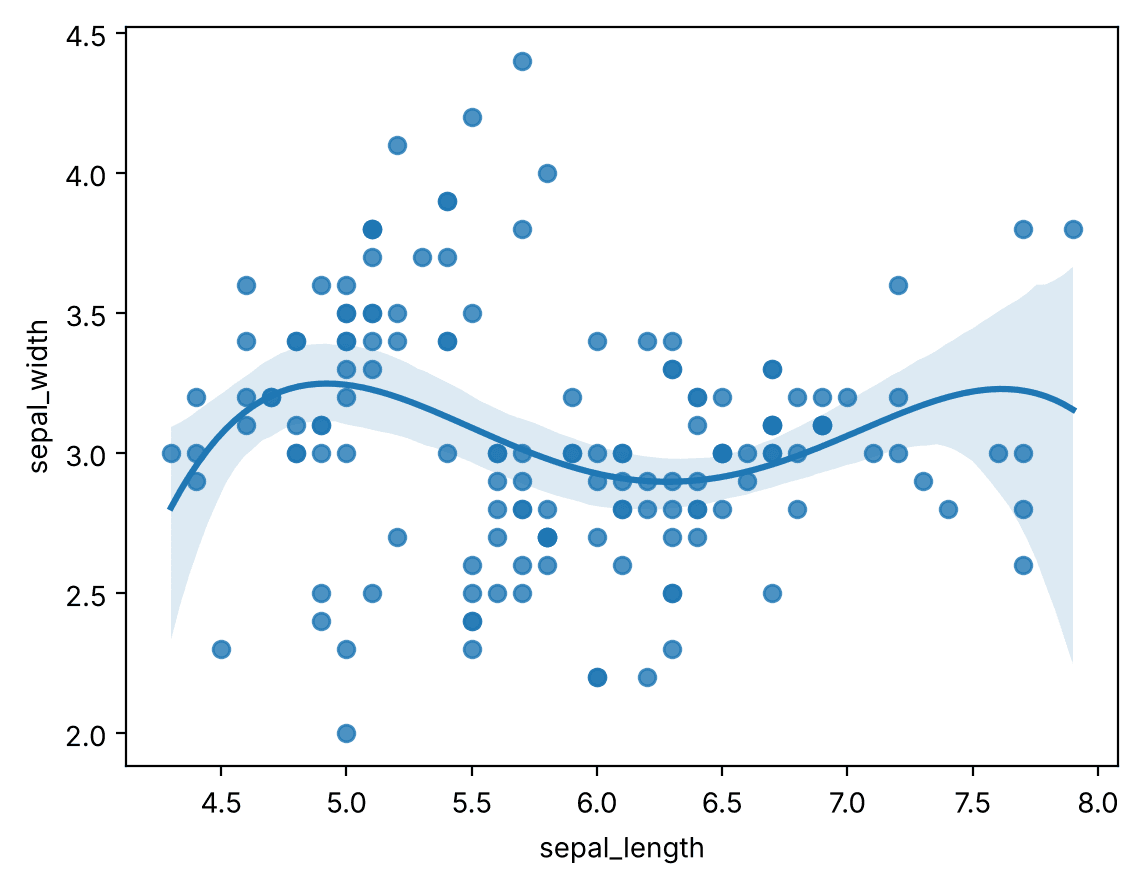
Ici, on utilise un polynôme d’ordre 4, qui épouse mieux la forme du nuage de points. Il faut donc vraisemblablement un modèle plus flexible qu’une droite pour ce jeu de données. Attention toutefois : un ordre élevé augmente le risque de surajustement (overfitting).
Comment colorer les points selon une catégorie ?
Les couleurs et les formes permettent de visualiser les différentes catégories d’un dataset. Elles sont très intuitives pour le système visuel humain : quand des groupes de points ont des couleurs ou des formes différentes, il est tout de suite évident qu’ils appartiennent à des groupes différents.
C’est exactement ce qu’on cherche pour créer des visualisations de données claires et convaincantes.
“Ce qui est évident se passe d’explication.”
# L'argument 'hue' permet de colorer les points selon une variable catégorielle
sns.lmplot(x="sepal_length", y="sepal_width", data=df, fit_reg=False, hue='species', legend=False)
plt.legend(loc='lower right')
plt.show()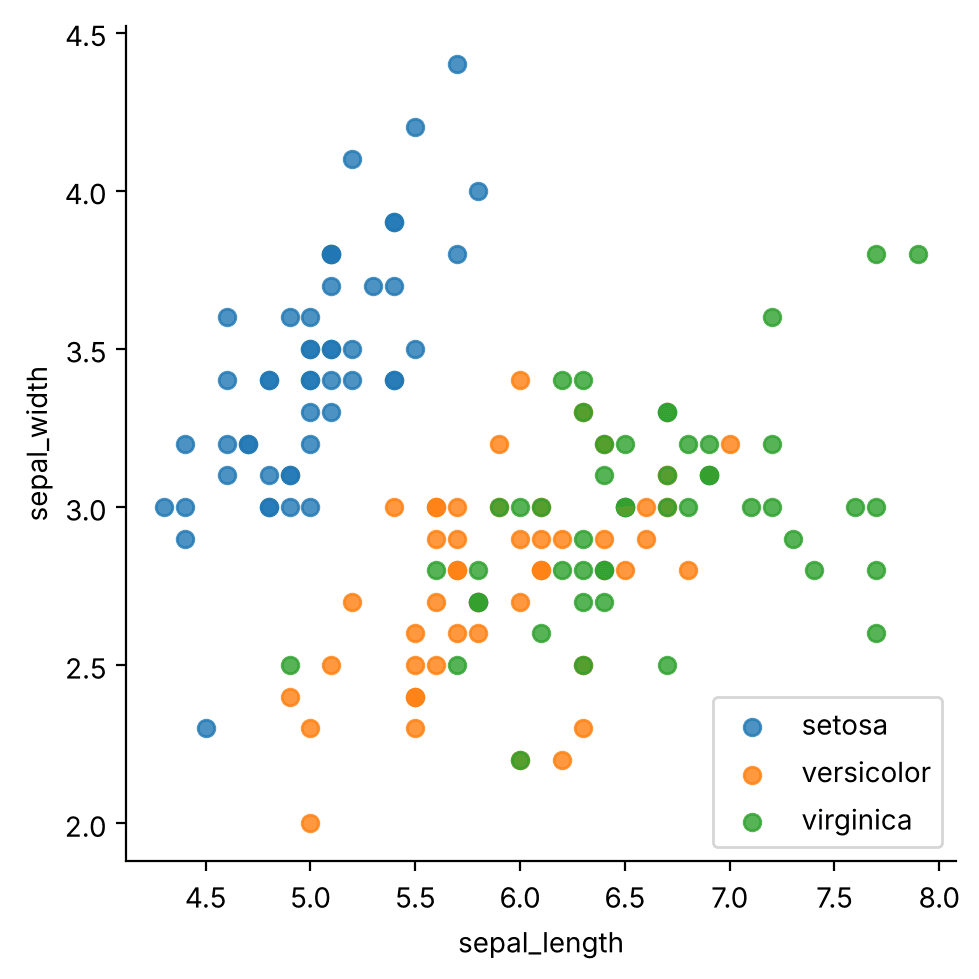
La figure ci-dessus montre les classes regroupées par couleur. Ensuite, on ajoute des formes différentes avec l’argument markers :
sns.lmplot(x="sepal_length", y="sepal_width", data=df, fit_reg=False, hue='species', legend=False, markers=["o", "P", "D"])
plt.legend(loc='lower right')
plt.show()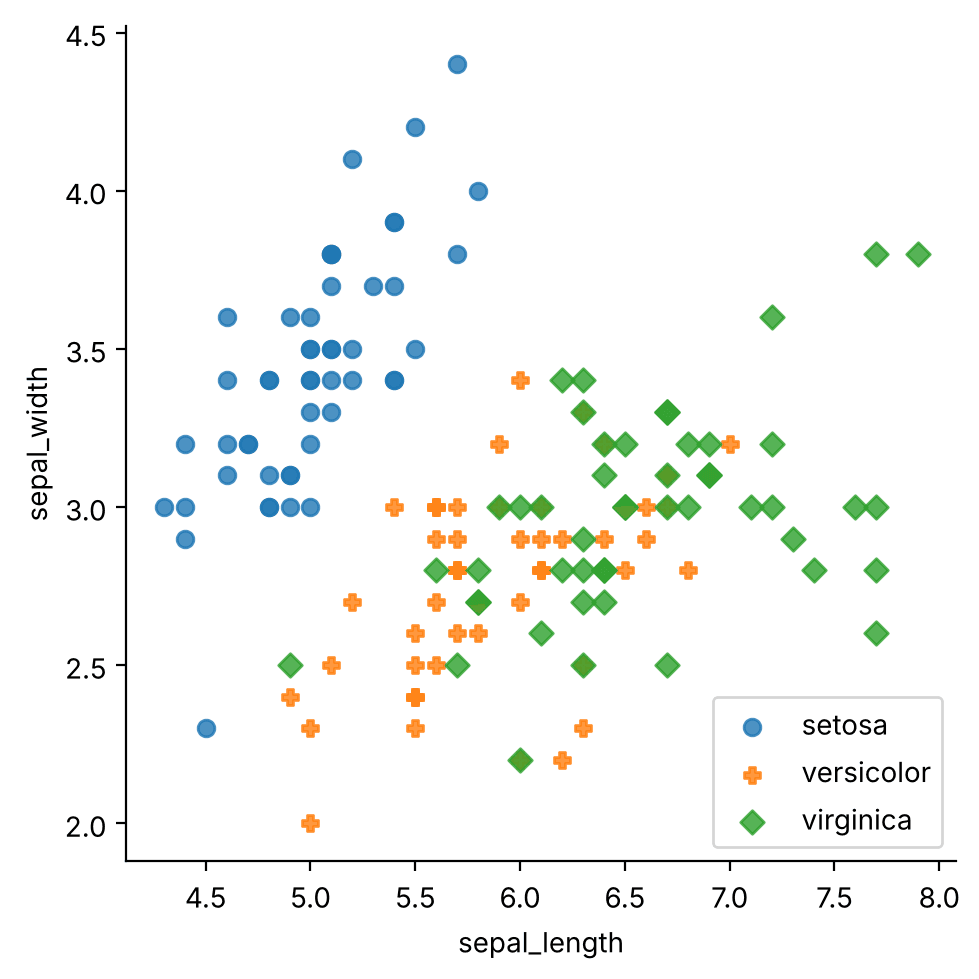
La figure ci-dessus montre les classes séparées par leur couleur et leur forme.
Dans les deux cas, les groupes sont beaucoup plus faciles à voir que sur le premier graphique, où tous les points étaient bleus. On comprend maintenant qu’il sera probablement facile de séparer la classe setosa avec une erreur faible, et qu’il faut concentrer son attention sur la séparation des deux autres.
Il est aussi clair qu’une seule droite ne pourra pas séparer les points verts et orange : il faudra une dimension supplémentaire.
Choisir entre couleur et forme est une question de préférence. Personnellement, je trouve la couleur un peu plus claire et intuitive, mais le choix t’appartient !
Comment voir la distribution des points avec des histogrammes ?
Un nuage de points avec histogrammes marginaux est un nuage de points accompagné d’histogrammes au-dessus et sur le côté, qui représentent la distribution des points le long des axes x et y. On les obtient avec jointplot.
C’est un petit ajout, mais il permet de voir la répartition exacte des points et d’identifier plus précisément les valeurs aberrantes.
sns.jointplot(x=df["sepal_length"], y=df["sepal_width"], kind='scatter')
plt.show()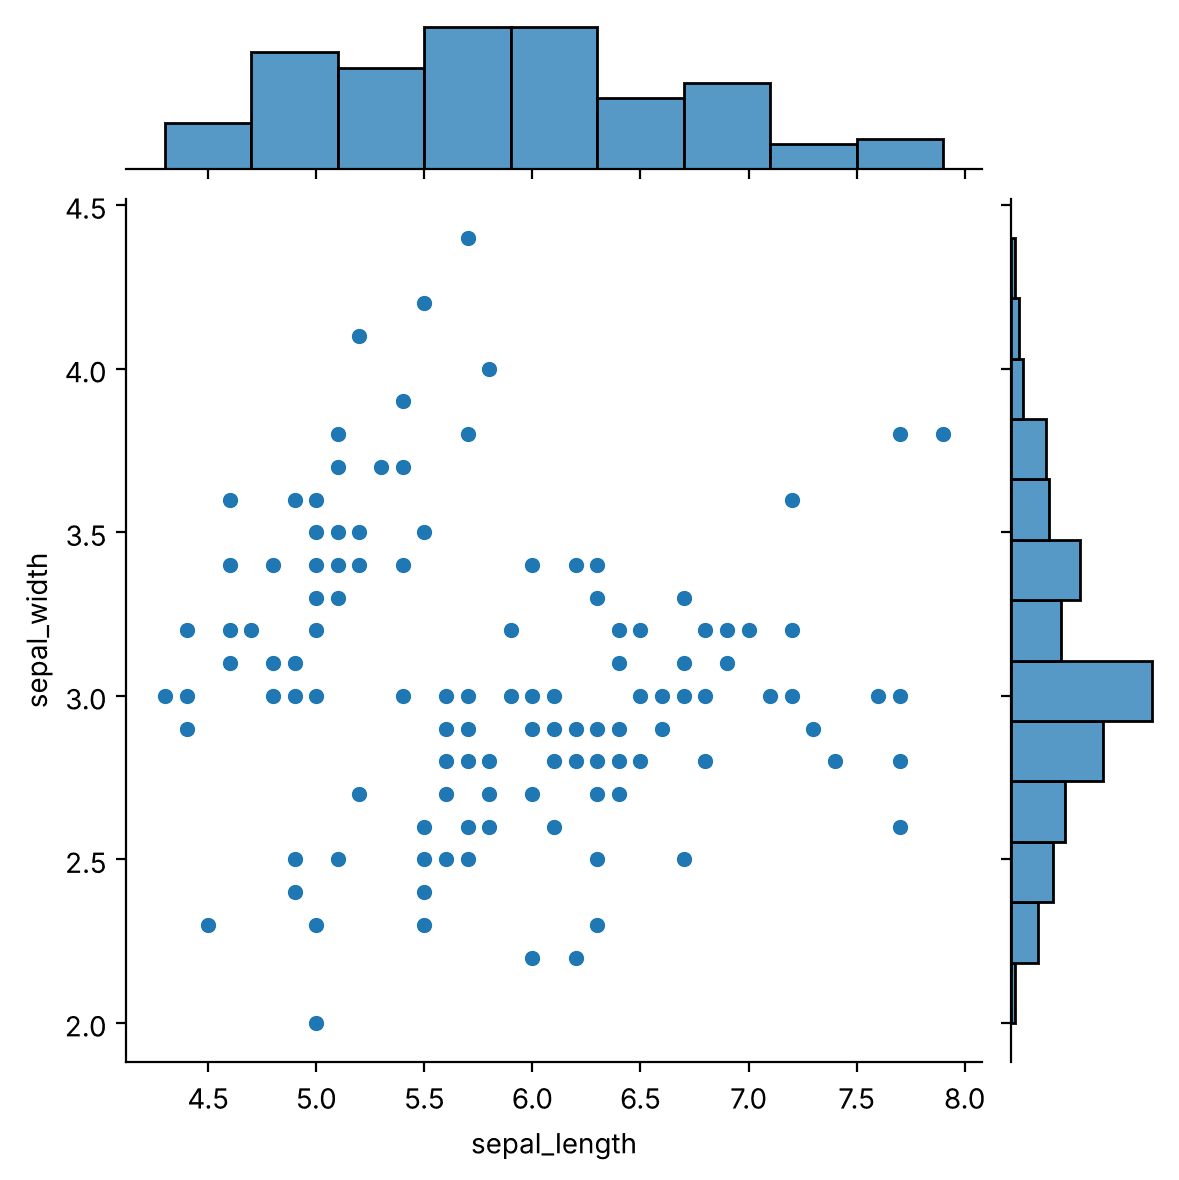
Dans la figure ci-dessus, on voit une très forte concentration de points autour de 3,0 sur l’axe y. C’est l’histogramme de droite qui le montre le mieux : il y a au moins trois fois plus de points autour de 3,0 que dans n’importe quelle autre plage. On constate aussi qu’il n’y a pratiquement aucun point au-dessus de 3,75.
Sur l’axe x, la répartition est un peu plus équilibrée, à l’exception des valeurs extrêmes tout à droite.
Comment représenter une troisième variable avec un graphique à bulles ?
Avec un graphique à bulles, on peut coder plusieurs variables à la fois. Le nouveau paramètre ajouté ici est la taille des points.
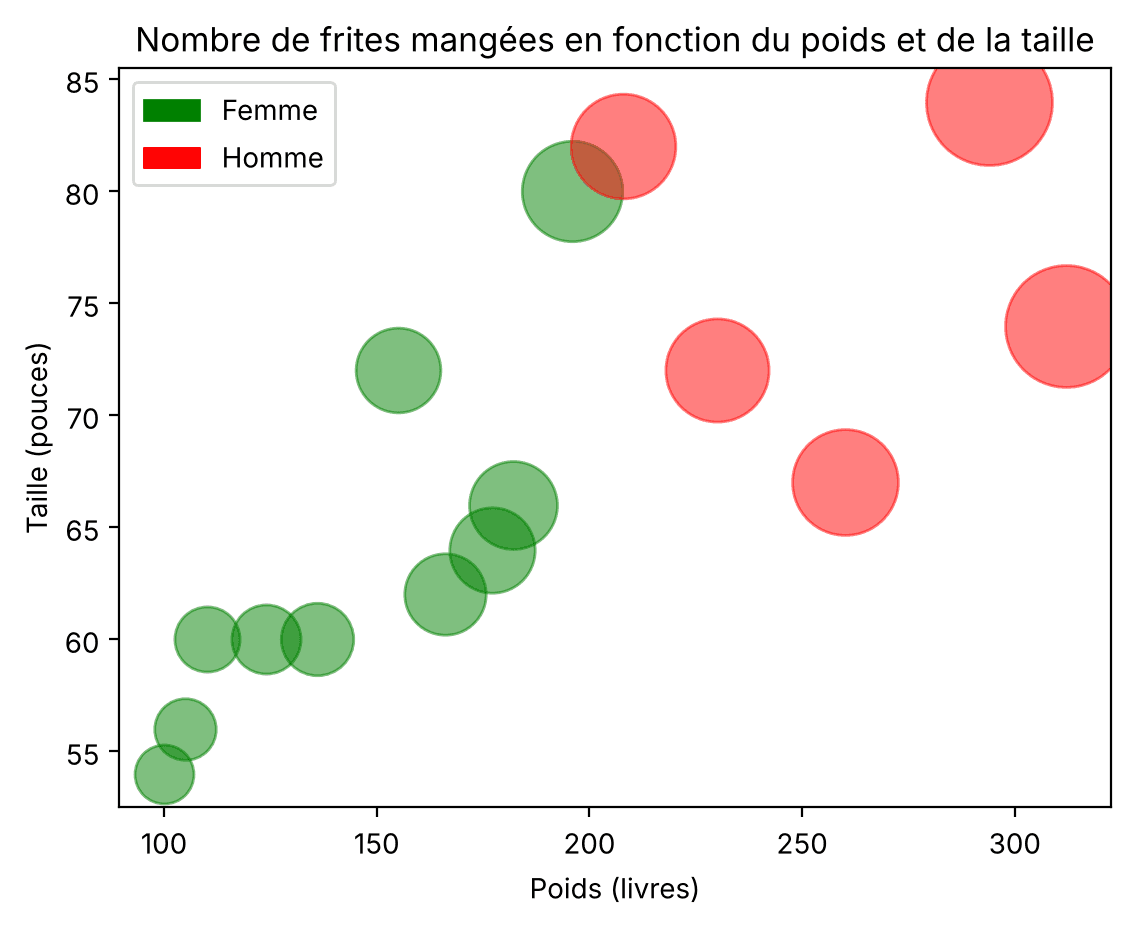
Dans la figure ci-dessous, on indique le nombre de frites mangées par chaque personne en fonction de sa taille et de son poids. Un nuage de points n’est qu’un outil de visualisation 2D, mais grâce à ces attributs, on peut y représenter des informations en 3 dimensions.
Ici, on utilise la position, la couleur et la taille des bulles :
- la position indique le poids (axe horizontal) et la taille de la personne (axe vertical) ;
- la couleur indique le sexe ;
- la taille de la bulle indique le nombre de frites mangées.
Le graphique à bulles permet de combiner facilement tous ces attributs et de lire des informations multidimensionnelles dans une simple vue 2D.
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches

x = np.array([100, 105, 110, 124, 136, 155, 166, 177, 182, 196, 208, 230, 260, 294, 312])
y = np.array([54, 56, 60, 60, 60, 72, 62, 64, 66, 80, 82, 72, 67, 84, 74])
z = (x * y) / 60   # nombre de frites mangées (valeurs fictives)

for index, val in enumerate(z):
    if index < 10:
        color = 'g'   # femmes
    else:
        color = 'r'   # hommes
    plt.scatter(x[index], y[index], s=z[index]*5, alpha=0.5, c=color)

red_patch = mpatches.Patch(color='red', label='Homme')
green_patch = mpatches.Patch(color='green', label='Femme')
plt.legend(handles=[green_patch, red_patch])

plt.title("Nombre de frites mangées en fonction du poids et de la taille")
plt.xlabel("Poids (livres)")
plt.ylabel("Taille (pouces)")
plt.show()Pour pratiquer la visualisation de données avec Seaborn et Matplotlib, le parcours Analyse et visualisation des données de DataXp te fait pratiquer sur des exercices corrigés, avec un coach IA qui t’aide quand tu bloques. Les premiers modules sont gratuits.
Questions fréquentes sur les nuages de points
Qu’est-ce qu’un graphique à nuage de points ?
C’est un graphique où chaque observation est un point placé selon ses valeurs sur deux variables numériques. Il sert à repérer des groupes, des valeurs aberrantes et la forme de la relation entre les variables.
Comment ajouter une droite de régression à un nuage de points avec seaborn ?
Avec l’argument fit_reg=True. Pour une courbe polynomiale, ajoute l’argument order (par exemple 4). Attention : un ordre élevé augmente le risque de surajustement.
Comment distinguer des catégories sur un nuage de points ?
En jouant sur la couleur des points et sur leur forme (argument markers). Les groupes deviennent beaucoup plus faciles à voir que lorsque tous les points ont la même couleur.
Comment afficher la distribution des points sur chaque axe ?
Avec jointplot, qui ajoute des histogrammes marginaux au-dessus et sur le côté du nuage de points. Ils montrent la répartition exacte des points et aident à repérer les valeurs aberrantes.
Qu’est-ce qu’un graphique à bulles ?
C’est un nuage de points où la taille de chaque point représente une troisième variable. Avec la couleur pour une quatrième variable catégorielle, on lit des informations multidimensionnelles dans une simple vue 2D.
Pour aller plus loin avec Python, consulte aussi notre guide des 21 astuces et concepts Python pour améliorer ton code.