Les données ne sont pas toujours dans la forme dont tu as besoin : un tableau pratique à lire n’est pas forcément pratique à analyser, et inversement. Remodeler les données avec Pandas (reshape en anglais) consiste à changer la forme d’un DataFrame sans changer l’information qu’il contient. Dans cet article, tu vas apprendre à le faire avec cinq méthodes : pivot(), pivot_table(), stack(), unstack() et melt().
Article mis à jour en octobre 2026 : tout le code a été exécuté (pandas 3.0 et pandas 2.3, mêmes résultats). J’ai remplacé np.mean par la chaîne "mean" dans pivot_table() (avec pandas 2, np.mean affiche un avertissement), corrigé une faute dans les données de melt(), et ajouté l’erreur de pivot() en cas de doublons, pivot_table() avec plusieurs colonnes et des totaux, var_name et value_name pour melt(), ainsi qu’un aller-retour entre melt() et pivot().
En bref : pivot() transforme un tableau « long » en tableau « large » (une ligne par individu, une colonne par catégorie), mais refuse les doublons. pivot_table() fait la même chose en agrégeant les doublons (moyenne par défaut). stack() empile les colonnes dans l’index, unstack() fait l’inverse, et melt() transforme un tableau large en tableau long en gardant quelques colonnes comme identifiants.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys
import numpy, pandas
print("Python", sys.version.split()[0])
print("pandas", pandas.__version__)
print("numpy", numpy.__version__)Python 3.13.16
pandas 3.0.5
numpy 2.5.3Qu’est-ce que remodeler les données avec Pandas ?
Un même jeu de données peut s’écrire sous deux formes. Dans le format long, chaque ligne est une observation : le nom de l’étudiant et le cours se répètent sur plusieurs lignes, et une seule colonne contient les notes. Dans le format large, chaque ligne est un individu et chaque cours a sa propre colonne. Le format long est pratique pour regrouper, filtrer et tracer des graphiques ; le format large est plus lisible pour une personne. Remodeler un DataFrame, c’est passer de l’un à l’autre.
Si tu veux d’abord revoir comment sélectionner des lignes, lis les 8 façons de filtrer un DataFrame Pandas.
Comment remodeler un DataFrame avec pivot() ?
Quand tu veux organiser un DataFrame selon un index et des colonnes donnés, utilise la méthode pivot(). Commençons par créer des données fictives : les notes de trois étudiants dans trois cours.
import pandas as pddf = pd.DataFrame({
"nom": ["Bastien", "Bastien", "Bastien", "Salma", "Salma", "Salma", "Alain", "Alain", "Alain"],
"cours": ["A", "B", "C", "A", "B", "C", "A", "B", "C"],
"note": [66, 75, 80, 70, 77, 81, 80, 85, 90],
"genre": ["H", "H", "H", "F", "F", "F", "H", "H", "H"],
})
df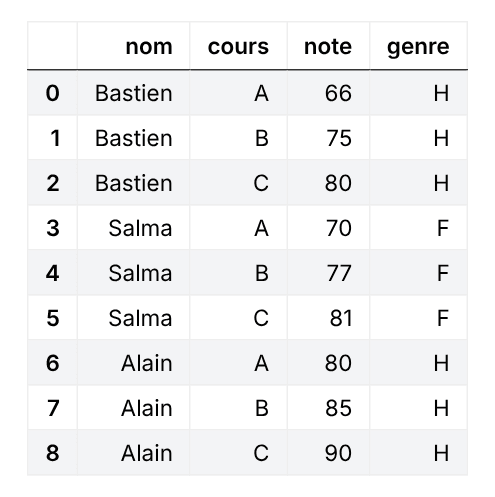
Ce tableau est au format long : le nom de chaque étudiant et le cours apparaissent de manière répétée sur plusieurs lignes. Si tu veux afficher la note de chaque cours pour chaque étudiant, écris :
df.pivot(index="nom", columns="cours", values="note")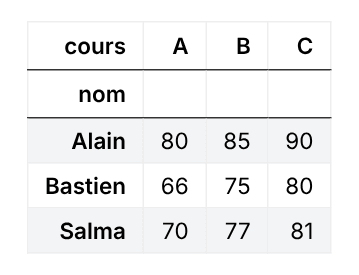
Les trois paramètres de pivot() sont :
index: la colonne dont les valeurs deviennent les lignes (l’axe vertical) ;columns: la colonne dont les valeurs deviennent les colonnes (l’axe horizontal) ;values: la colonne dont les valeurs remplissent les cellules.
Pourquoi pivot() renvoie-t-il une erreur avec des doublons ?
La méthode pivot() ne sait pas gérer les doublons : si une même paire index/colonne apparaît deux fois, quelle valeur mettre dans la cellule ? Ajoutons une deuxième note de Bastien au cours A :
nouvelle_note = pd.DataFrame({"nom": ["Bastien"], "cours": ["A"], "note": [70], "genre": ["H"]})
df_doublon = pd.concat([df, nouvelle_note], ignore_index=True)

try:
    df_doublon.pivot(index="nom", columns="cours", values="note")
except ValueError as erreur:
print(erreur)Index contains duplicate entries, cannot reshapeDans ce cas, utilise pivot_table().
Comment pivoter et agréger les données avec pivot_table() ?
La fonction pivot_table() gère les valeurs dupliquées : elle les agrège avec la fonction de ton choix, donnée au paramètre aggfunc. Par défaut, aggfunc calcule la moyenne. Tu peux aussi passer un dictionnaire pour appliquer une fonction différente à chaque colonne. Par exemple, pour compter le nombre de cours et calculer la moyenne des notes de chaque étudiant :
pd.pivot_table(df, index="nom", values=["cours", "note"], aggfunc={"cours": "count", "note": "mean"})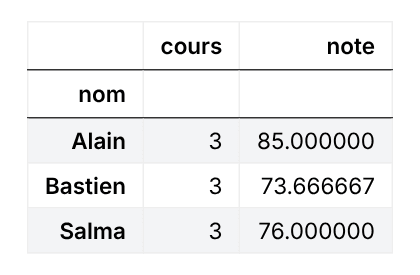
L’index (l’axe vertical) contient les étudiants, les colonnes sont les valeurs demandées, et chaque cellule contient le résultat de l’agrégation. Note que j’écris "mean" en chaîne de caractères : avec pandas 2, passer np.mean affiche un FutureWarning.
Avec pivot_table(), le doublon de tout à l’heure ne pose plus de problème. La note de Bastien au cours A est maintenant la moyenne de ses deux notes, (66 + 70) / 2 = 68 :
pd.pivot_table(df_doublon, index="nom", columns="cours", values="note", aggfunc="mean")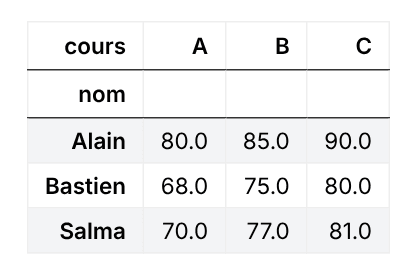
Enfin, le paramètre margins=True ajoute les totaux (ici, des moyennes) dans une ligne et une colonne « All ». Voici la note moyenne par genre et par cours :
pd.pivot_table(df, index="genre", columns="cours", values="note", aggfunc="mean", margins=True)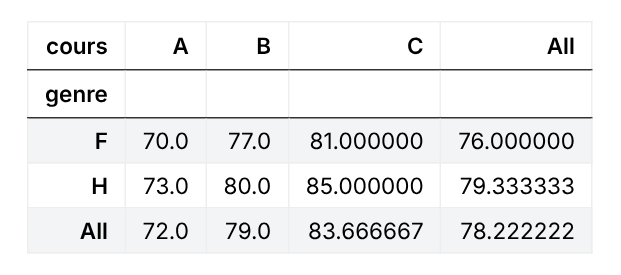
Le groupe F (Salma) a une moyenne de 76 et le groupe H (Bastien et Alain) de 79,33 ; la moyenne de toutes les notes est de 78,22. Ce n’est qu’un exemple sur 9 notes : ne tire aucune conclusion de si peu de données.
Si tu veux aller plus loin avec ces fonctions, lis le guide détaillé sur le pivot de Pandas.
Comment empiler et dépiler des colonnes avec stack() et unstack() ?
Pour empiler les valeurs de toutes les colonnes (horizontales) sur plusieurs lignes (verticales), utilise la méthode stack(). Voici un nouveau DataFrame, au format large : chaque étudiant a ses trois cours en colonnes.
df = pd.DataFrame({
    "cours_A": [60, 70, 80],
    "cours_B": [65, 75, 85],
    "cours_C": [70, 75, 83],
}, index=["Bastien", "Salma", "Alain"])
df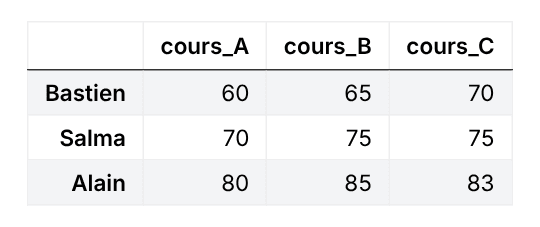
Pour empiler toutes les colonnes à la verticale :
df_stack = df.stack()
df_stackBastien cours_A 60
cours_B 65
cours_C 70
Salma cours_A 70
cours_B 75
cours_C 75
Alain cours_A 80
cours_B 85
cours_C 83
dtype: int64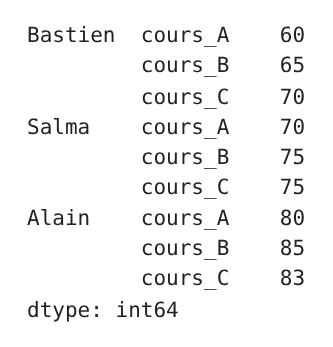
Le résultat est une Series (et non plus un DataFrame) avec un index à deux niveaux : l’étudiant, puis le nom de l’ancienne colonne.
print(type(df_stack).__name__)
print(df_stack.index.nlevels, "niveaux d'index")Series
2 niveaux d'indexLa méthode unstack() fait l’opération inverse : elle déplie un niveau de l’index en colonnes. Appliquée à df_stack, elle redonne le DataFrame d’origine :
df_stack.unstack()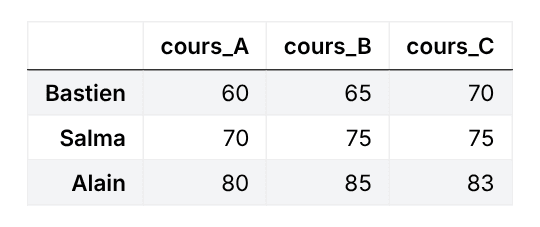
Comment passer du format large au format long avec melt() ?
Si tu veux garder certaines colonnes comme identifiants et empiler toutes les autres dans une seule colonne, utilise la méthode melt(). Préparons de nouvelles données, au format large, avec une colonne de plus pour le genre :
df = pd.DataFrame({
    "nom": ["Bastien", "Salma", "Alain"],
    "genre": ["H", "F", "H"],
    "cours_A": [74, 85, 90],
    "cours_B": [65, 75, 85],
    "cours_C": [70, 75, 83],
})
df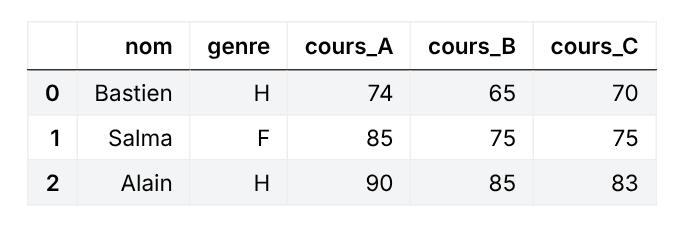
Gardons nom et genre comme identifiants (id_vars) et empilons cours_A, cours_B et cours_C :
df.melt(id_vars=["nom", "genre"])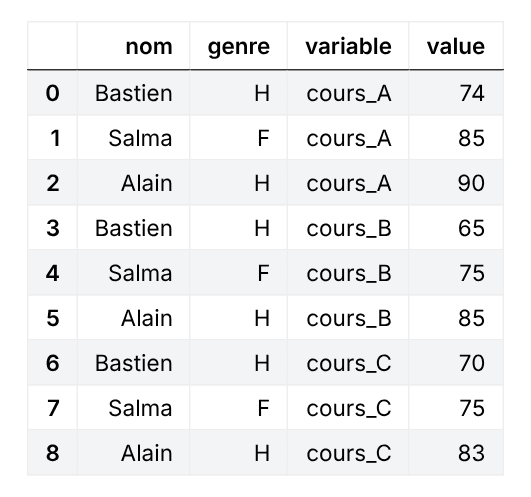
Pandas crée deux colonnes : variable contient les anciens noms de colonnes, et value contient les valeurs. Ces noms ne sont pas très parlants : tu peux les changer avec var_name et value_name :
df_long = df.melt(
    id_vars=["nom", "genre"],
    var_name="cours",
    value_name="note",
)
df_long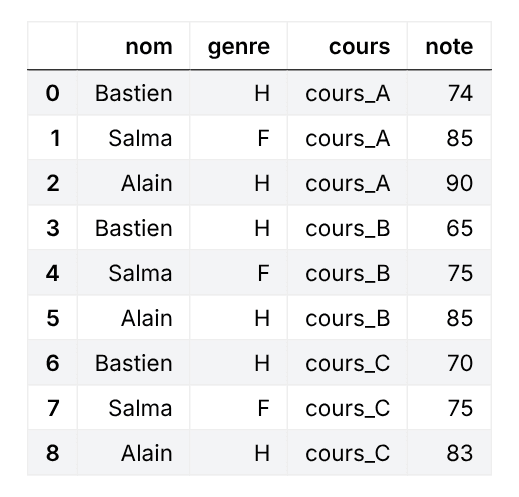
On retrouve le format long du début de l’article. Et pivot() permet de revenir au format large : on retrouve les mêmes valeurs, avec les lignes triées par nom. La méthode reset_index() remet les identifiants en colonnes :
df_long.pivot(index=["nom", "genre"], columns="cours", values="note").reset_index().rename_axis(columns=None)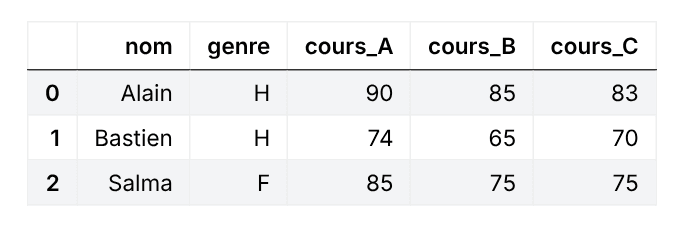
Quelle méthode choisir pour remodeler un DataFrame Pandas ?
pivot(): du long au large, quand il n’y a aucun doublon pour une paire index/colonne.pivot_table(): du long au large avec agrégation des doublons, comme un tableau croisé dynamique d’Excel.stack(): empile les colonnes dans l’index et renvoie une Series avec un index à deux niveaux.unstack(): déplie un niveau de l’index en colonnes, l’inverse destack().melt(): du large au long, en gardant des colonnes identifiantes et en ajoutant les colonnesvariableetvalue.
Questions fréquentes
Quelle est la différence entre pivot() et pivot_table() dans Pandas ?
pivot() remodèle un DataFrame sans calcul et renvoie une erreur s’il y a des doublons pour une paire index/colonne. pivot_table() accepte les doublons et les agrège avec le paramètre aggfunc (la moyenne par défaut), comme un tableau croisé dynamique d’Excel.
Pourquoi pivot() renvoie « Index contains duplicate entries, cannot reshape » ?
Parce qu’une même combinaison d’index et de colonne apparaît plusieurs fois : Pandas ne sait pas quelle valeur mettre dans la cellule. Utilise pivot_table() avec une fonction d’agrégation, ou supprime les doublons avec drop_duplicates().
Quelle est la différence entre melt() et stack() ?
melt() transforme un DataFrame large en DataFrame long en gardant des colonnes identifiantes (id_vars) et crée les colonnes variable et value. stack() empile les colonnes dans l’index et renvoie une Series avec un index à deux niveaux.
À quoi sert unstack() dans Pandas ?
unstack() déplie un niveau de l’index en colonnes : c’est l’opération inverse de stack(). Appliquée au résultat de df.stack(), elle redonne le DataFrame d’origine.
Quelle est la différence entre le format long et le format large ?
Dans le format long, chaque ligne est une observation et une colonne contient toutes les valeurs. Dans le format large, chaque ligne est un individu et chaque catégorie a sa colonne. Le format long est pratique pour regrouper et tracer, le format large pour lire.
Comment éviter l’avertissement avec np.mean dans pivot_table() ?
Passe la chaîne de caractères “mean” au paramètre aggfunc au lieu de np.mean : aggfunc={“note”: “mean”}. Avec pandas 2, np.mean affiche un FutureWarning.
Conclusion
Tu as vu comment remodeler les données avec Pandas : pivot() et pivot_table() pour passer du long au large, stack() et unstack() pour empiler et déplier un niveau d’index, et melt() pour passer du large au long. Pour t’entraîner, prends un tableau de ventes ou de notes et passe-le dans les deux sens, du long au large puis du large au long, en vérifiant que tu retrouves les mêmes valeurs.
Savoir remodeler un DataFrame, c’est une compétence de base ; savoir mener une analyse complète, c’est un métier. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin sur Pandas :