Dans cet article, je te propose de réaliser une prédiction des maladies cardiaques à partir de données d’hommes vivant dans une région où le risque d’en développer est élevé.
En bref : sur 462 hommes d’une région à haut risque de maladies cardiaques, trois modèles (SVM, kNN et réseau de neurones) sont comparés par validation croisée à 10 plis. Le SVM et le réseau de neurones sont à égalité (73,1 % et 71,8 % d’exactitude), le kNN est le moins bon (64,0 %). Un « modèle » qui répondrait toujours « pas de maladie » atteint déjà 65,4 %, et aucun des trois ne détecte plus d’un cas sur deux : l’exactitude seule ne suffit pas pour juger un modèle.
Le projet compare trois algorithmes de Machine Learning :
- Support Vector Machine (SVM)
- K Nearest Neighbors (kNN), que je détaille dans un article dédié
- Artificial Neural Network (ANN), ou réseau de neurones artificiel
L’idée est de savoir quelle est la meilleure approche. Spoiler : la réponse est moins nette qu’on pourrait le croire, et nous verrons pourquoi.
Article mis à jour en octobre 2026 : le code fonctionne avec les versions actuelles de scikit-learn et de Keras, et l’évaluation des modèles est corrigée (mise à l’échelle des données, précision et rappel, validation croisée).
Attention : c’est un exercice pédagogique, pas un outil de diagnostic médical.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : le fichier de données se charge tout seul depuis GitHub, sans rien télécharger.
Quelles données utiliser pour prédire les maladies cardiaques ?
Source
Un échantillon rétrospectif d’hommes dans une région à haut risque de maladies cardiaques à l’ouest du Cap, en Afrique du Sud.
Source de l’ensemble de données sur les maladies cardiaques en Afrique du Sud : https://www.openml.org/d/1498
Description
Il y a environ deux témoins par cas de coronaropathie (ici, 302 témoins pour 160 cas). Beaucoup d’hommes atteints de maladies coronariennes ont suivi un traitement de réduction de la pression artérielle et d’autres programmes visant à réduire leurs facteurs de risque après l’apparition de la maladie. Dans certains cas, les mesures ont été effectuées après ces traitements. Ces données sont tirées d’un ensemble de données plus vaste, décrit dans Rousseauw et al., 1983, South African Medical Journal.
Attributs
- sbp (systolic blood pressure) : tension artérielle systolique
- tobacco (cumulative tobacco consumption) : consommation cumulée de tabac, en kg
- ldl (low density lipoprotein cholesterol) : cholestérol LDL, lipoprotéine de basse densité
- adiposity : adiposité
- famhist (family history of heart disease) : antécédents familiaux de maladies cardiaques (Present ou Absent)
- typea (type-A behavior) : score de comportement de type A
- obesity : obésité (valeurs de 14,7 à 46,6, comparables à un indice de masse corporelle)
- alcohol (current alcohol consumption) : consommation actuelle d’alcool
- age : âge au moment de l’apparition de l’affection
- chd (coronary heart disease) : maladie coronarienne (1 = cas, 0 = témoin)
Nombre total de lignes : 462 hommes.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

sns.set_theme(style='whitegrid')Comment préparer les données ?
Dans cette partie, nous préparons les données pour les visualiser, puis pour construire nos modèles de Machine Learning. Je lis le fichier au format CSV, dont les noms de colonnes sont déjà en place :
URL = 'https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/prediction-des-maladies-cardiaques/SAheart.csv'
data = pd.read_csv(URL, index_col='row.names')

data.head() sbp tobacco ldl adiposity famhist typea obesity alcohol \
row.names
1 160 12.00 5.73 23.11 Present 49 25.30 97.20
2 144 0.01 4.41 28.61 Absent 55 28.87 2.06
3 118 0.08 3.48 32.28 Present 52 29.14 3.81
4 170 7.50 6.41 38.03 Present 51 31.99 24.26
5 134 13.60 3.50 27.78 Present 60 25.99 57.34
age chd
row.names
1 52 1
2 63 1
3 46 0
4 58 1
5 49 1Vérifions la taille du jeu de données, les valeurs manquantes et la proportion de cas :
print(data.shape)
print('Valeurs manquantes :', data.isnull().sum().sum())
print(data['chd'].value_counts(normalize=True).round(3))(462, 10)
Valeurs manquantes : 0
chd
0 0.654
1 0.346
Name: proportion, dtype: float64Nous n’avons pas de valeurs manquantes. Il y a 462 hommes, dont 34,6 % de cas. Retiens ce chiffre : un « modèle » qui répondrait toujours « pas de maladie » aurait raison dans 65,4 % des cas. Nous allons y revenir.
La colonne famhist contient du texte (Present ou Absent). Je la transforme en 0 et 1. La colonne chd est déjà codée en 0 et 1. Voici les statistiques descriptives :
# famhist : 'Present' devient 1, 'Absent' devient 0
data['famhist'] = (data['famhist'] == 'Present').astype(int)

data.describe().T.round(2) count mean std min 25% 50% 75% max
sbp 462.0 138.33 20.50 101.00 124.00 134.00 148.00 218.00
tobacco 462.0 3.64 4.59 0.00 0.05 2.00 5.50 31.20
ldl 462.0 4.74 2.07 0.98 3.28 4.34 5.79 15.33
adiposity 462.0 25.41 7.78 6.74 19.77 26.12 31.23 42.49
famhist 462.0 0.42 0.49 0.00 0.00 0.00 1.00 1.00
typea 462.0 53.10 9.82 13.00 47.00 53.00 60.00 78.00
obesity 462.0 26.04 4.21 14.70 22.98 25.80 28.50 46.58
alcohol 462.0 17.04 24.48 0.00 0.51 7.51 23.89 147.19
age 462.0 42.82 14.61 15.00 31.00 45.00 55.00 64.00
chd 462.0 0.35 0.48 0.00 0.00 0.00 1.00 1.00Les attributs n’ont pas du tout la même échelle : sbp va de 101 à 218, tobacco de 0 à 31 et famhist de 0 à 1. Les modèles que nous allons utiliser y sont sensibles, nous mettrons donc les variables à la même échelle. Mais pas tout de suite, et pas n’importe comment : nous le ferons après avoir séparé les données d’entraînement et de test, pour que le test ne « fuite » pas dans l’entraînement.
Qu’est-ce qui distingue les hommes malades des témoins ?
Que montrent les moyennes et les boîtes à moustaches ?
Qu’est-ce qui distingue les hommes atteints (chd = 1) des témoins (chd = 0) ? Commençons par la moyenne de chaque variable dans chaque groupe (pour famhist, la moyenne est la proportion d’hommes avec antécédents familiaux) :
data.groupby('chd').mean().round(2).Tchd 0 1
sbp 135.46 143.74
tobacco 2.63 5.52
ldl 4.34 5.49
adiposity 23.97 28.12
famhist 0.32 0.60
typea 52.37 54.49
obesity 25.74 26.62
alcohol 15.93 19.15
age 38.85 50.29Les cas sont en moyenne plus âgés (50,3 ans contre 38,9), ils ont fumé plus (5,5 kg cumulés contre 2,6), ont plus souvent des antécédents familiaux (60 % contre 32 %), un cholestérol LDL plus élevé (5,5 contre 4,3), plus d’adiposité (28,1 contre 24,0) et une tension un peu plus haute (143,7 contre 135,5). Les écarts sont plus faibles pour l’obésité, le comportement de type A et l’alcool.
Les boîtes à moustaches montrent la même chose. Pour chaque variable, la boîte contient la moitié centrale des valeurs, le trait au milieu est la médiane, et les points sont les valeurs extrêmes :
colonnes_numeriques = ['sbp', 'tobacco', 'ldl', 'adiposity', 'typea', 'obesity', 'alcohol', 'age']

fig, axes = plt.subplots(2, 4, figsize=(14, 7))
for ax, colonne in zip(axes.ravel(), colonnes_numeriques):
    sns.boxplot(data=data, x='chd', y=colonne, ax=ax)
    ax.set_xlabel('chd (0 = témoin, 1 = cas)')
plt.tight_layout()
plt.show()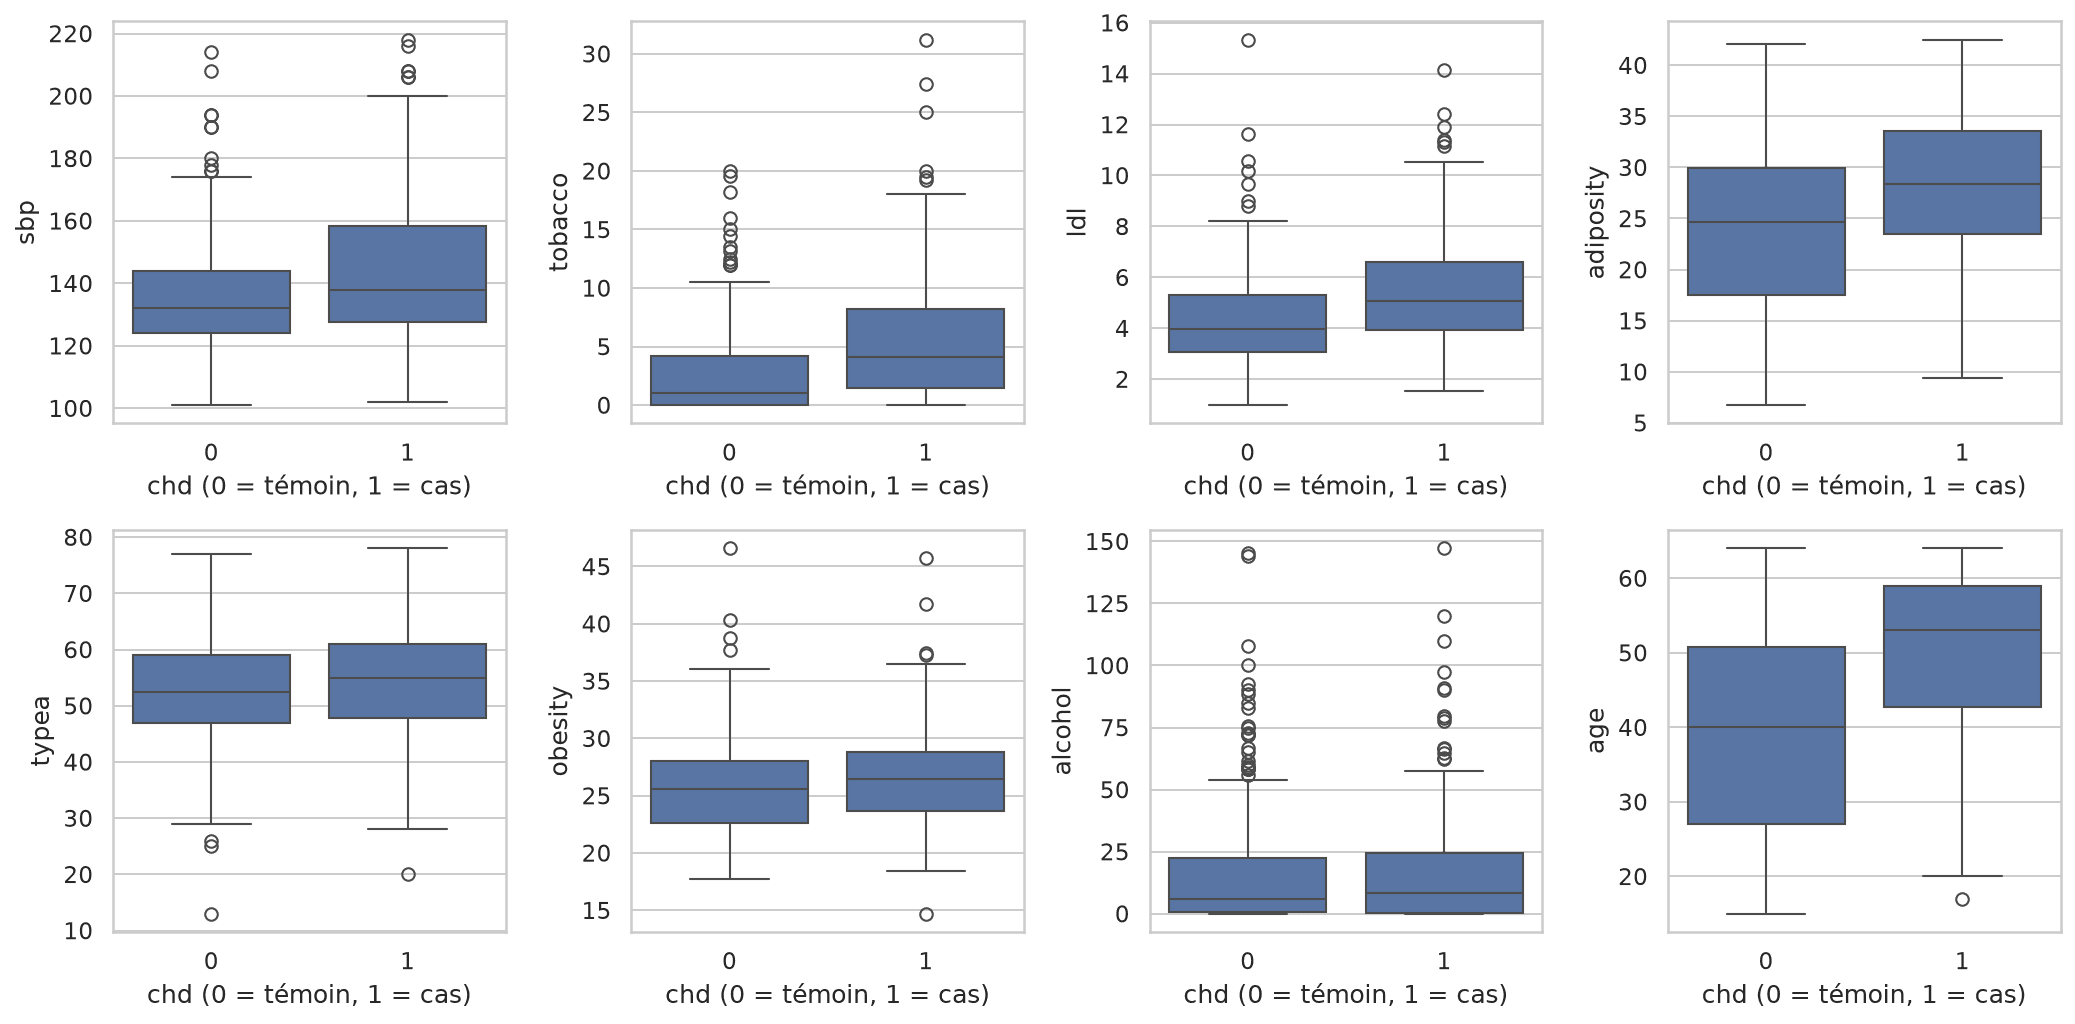
L’âge, le tabac, l’adiposité et le LDL se décalent nettement vers le haut chez les cas. L’alcool, l’obésité et le comportement de type A, eux, se recouvrent presque complètement entre les deux groupes.
Quel est le rôle de l’âge ?
L’âge est la variable qui distingue le plus les deux groupes. Voici comment la part de cas et la moyenne de quelques variables évoluent par tranche d’âge :
tranches = pd.cut(data['age'], [14, 29, 39, 49, 64], labels=['15-29', '30-39', '40-49', '50-64'])

data.groupby(tranches, observed=True).agg(
    effectif=('age', 'size'),
    tabac=('tobacco', 'mean'),
    alcool=('alcohol', 'mean'),
    obesite=('obesity', 'mean'),
    part_de_cas=('chd', 'mean'),
).round(2) effectif tabac alcool obesite part_de_cas
age
15-29 101 0.47 11.48 23.50 0.07
30-39 75 2.21 17.42 26.25 0.28
40-49 106 4.25 22.43 26.84 0.31
50-64 180 5.64 16.84 26.91 0.55La part de cas passe de 7 % chez les 15-29 ans à 55 % chez les 50-64 ans. Regardons maintenant ces variables en fonction de l’âge, avec les cas en bleu et les témoins en orange.
groupe = data['chd'].map({0: 'témoin', 1: 'cas'})

sns.scatterplot(data=data, x='age', y='obesity', hue=groupe, alpha=0.7)
plt.xlabel('Âge (ans)')
plt.ylabel('Obésité')
plt.legend(title='Groupe')
plt.show()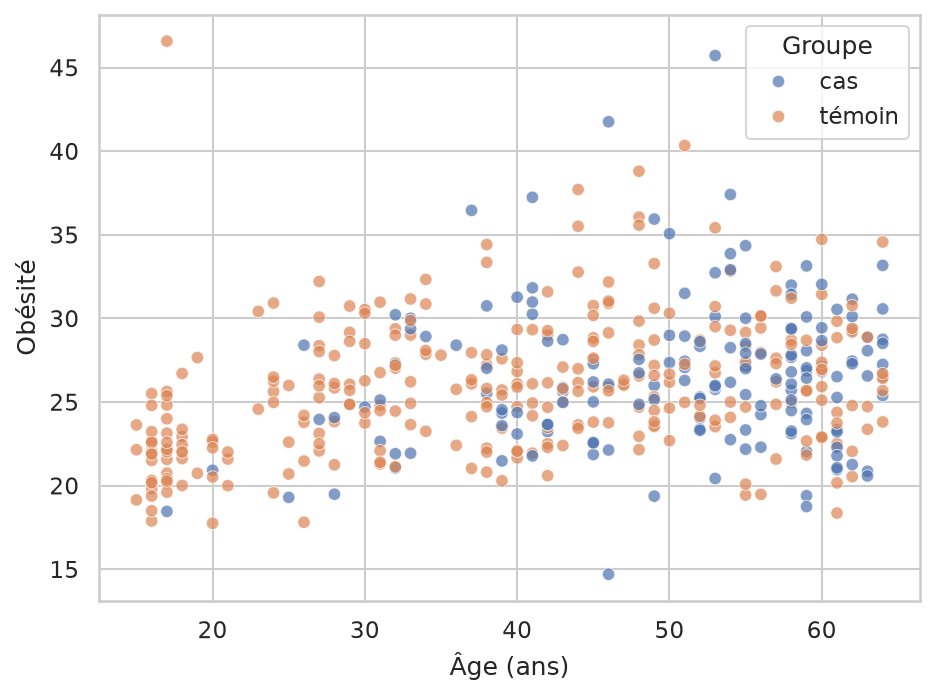
Dans le graphique de dispersion ci-dessus (obésité en fonction de l’âge), l’obésité moyenne augmente jusqu’à la trentaine (23,5 chez les 15-29 ans, 26,3 chez les 30-39 ans), puis elle se stabilise autour de 27. Les cas et les témoins ne se séparent pas nettement sur ce graphique.
sns.scatterplot(data=data, x='age', y='tobacco', hue=groupe, alpha=0.7)
plt.xlabel('Âge (ans)')
plt.ylabel('Consommation cumulée de tabac (kg)')
plt.legend(title='Groupe')
plt.show()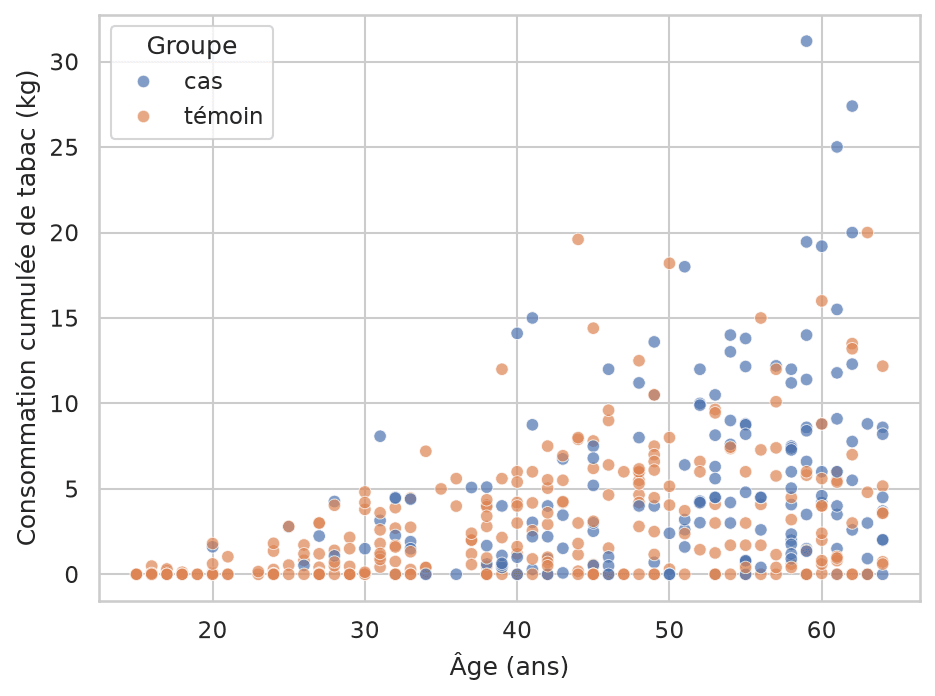
Dans le graphique de la consommation de tabac en fonction de l’âge, la consommation cumulée augmente avec l’âge, de 0,5 kg en moyenne avant 30 ans à 5,6 kg après 50 ans. Tous les hommes qui ont fumé plus de 8 kg au total ont au moins 31 ans, et les cas (en bleu) sont plus nombreux dans le haut du nuage.
sns.scatterplot(data=data, x='age', y='alcohol', hue=groupe, alpha=0.7)
plt.xlabel('Âge (ans)')
plt.ylabel('Consommation d\'alcool')
plt.legend(title='Groupe')
plt.show()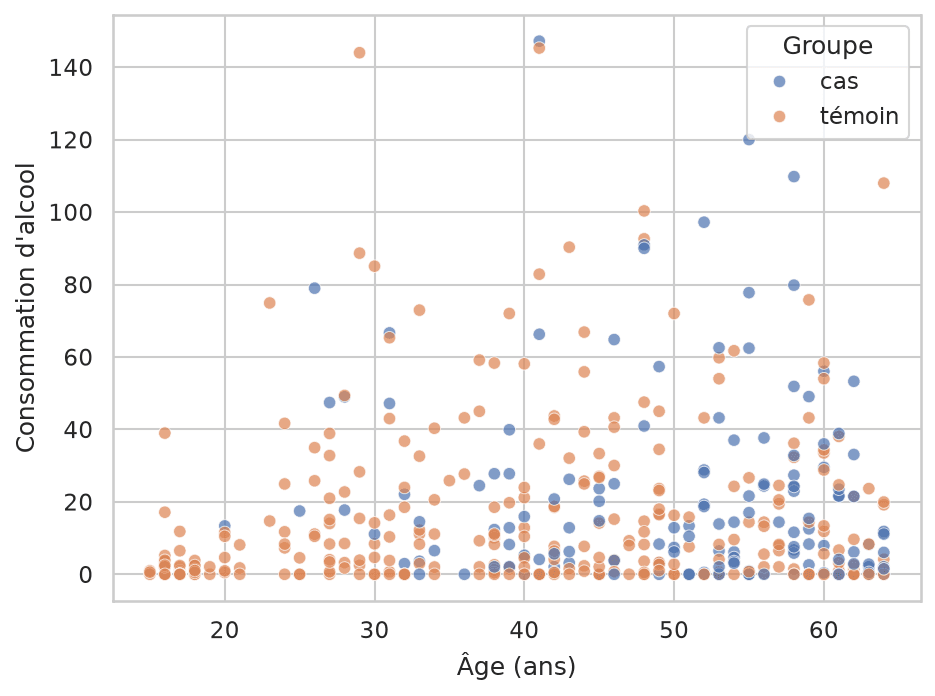
Dans le graphique de la consommation d’alcool en fonction de l’âge, la consommation moyenne est la plus élevée entre 40 et 49 ans (22,4), puis elle baisse (16,8 chez les 50-64 ans). On voit aussi quelques valeurs extrêmes, jusqu’à 147.
Quel modèle de Machine Learning prédit le mieux les maladies cardiaques ?
Dans cette partie, nous allons tester 3 approches différentes de Machine Learning pour prédire les maladies cardiaques. Pour les évaluer correctement, deux précautions :
- comparer chaque modèle à une référence : celui qui répond toujours « pas de maladie » ;
- regarder plusieurs mesures, pas seulement l’exactitude.
Voici les mesures, en considérant les cas (chd = 1) comme la classe à détecter :
- la matrice de confusion : le nombre de témoins et de cas bien ou mal classés ;
- l’exactitude (accuracy) : la part de bonnes réponses ;
- la précision : parmi les hommes que le modèle annonce malades, la part qui l’est vraiment ;
- le rappel (recall, ou sensibilité) : parmi les hommes réellement malades, la part que le modèle détecte.
Pour dépister une maladie, le rappel est important : un malade que le modèle manque est le cas le plus coûteux.
Je sépare d’abord les données : 80 % pour l’entraînement et 20 % pour le test.
from sklearn.model_selection import train_test_split

colonnes = ['sbp', 'tobacco', 'ldl', 'adiposity', 'famhist', 'typea', 'obesity', 'alcohol', 'age']
X = data[colonnes]
y = data['chd']

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=1234)
print(len(X_train), len(X_test))369 93Puis j’écris une fonction d’évaluation et je calcule la référence :
from sklearn.dummy import DummyClassifier
from sklearn.metrics import confusion_matrix, accuracy_score, precision_score, recall_score

def evaluer(nom, y_vrai, y_pred):
    print(nom)
    print(confusion_matrix(y_vrai, y_pred))
    print(f"Exactitude : {accuracy_score(y_vrai, y_pred):.3f}")
    print(f"Précision  : {precision_score(y_vrai, y_pred, zero_division=0):.3f}")
    print(f"Rappel     : {recall_score(y_vrai, y_pred):.3f}")

# Référence : un « modèle » qui répond toujours 0 (pas de maladie)
reference = DummyClassifier(strategy='most_frequent').fit(X_train, y_train)
evaluer('Référence (toujours 0)', y_test, reference.predict(X_test))Référence (toujours 0)
[[60 0]
[33 0]]
Exactitude : 0.645
Précision : 0.000
Rappel : 0.000Cette référence a une exactitude de 64,5 % sur ce découpage, sans détecter aucun cas (rappel de 0). C’est le score à battre.
Modèle 1 : qu’est-ce qu’un Support Vector Machine (SVM) ?
Un Support Vector Machine (SVM) est un algorithme de classification : il cherche la frontière (l’hyperplan) qui sépare le mieux deux classes. Plus précisément, c’est un classificateur discriminatoire formellement défini par un hyperplan de séparation. En d’autres termes, à partir de données d’entraînement étiquetées (apprentissage supervisé), l’algorithme produit un hyperplan optimal qui catégorise les nouveaux exemples.
–> En savoir plus sur Wikipédia
J’utilise un Pipeline qui enchaîne deux étapes : StandardScaler (qui retire la moyenne et divise par l’écart-type de chaque variable) puis le SVM. La moyenne et l’écart-type sont calculés sur les données d’entraînement uniquement, puis appliqués aux données de test.
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

svm_clf = make_pipeline(StandardScaler(), SVC(kernel='linear'))
svm_clf.fit(X_train, y_train)

y_pred_svm = svm_clf.predict(X_test)
evaluer('SVM', y_test, y_pred_svm)SVM
[[51 9]
[15 18]]
Exactitude : 0.742
Précision : 0.667
Rappel : 0.545L’exactitude est de 74,2 %. Sur les 60 témoins du test, 51 sont bien classés ; sur les 33 cas, 18 sont détectés et 15 sont manqués. La précision est de 66,7 % et le rappel de 54,5 %.
Modèle 2 : comment fonctionne le k Nearest Neighbors (kNN) ?
En reconnaissance de formes, l’algorithme des k plus proches voisins (k-NN) est une méthode non paramétrique utilisée pour la classification et la régression. Dans les deux cas, l’entrée consiste en k exemples d’entraînement les plus proches dans l’espace des caractéristiques. Dans la classification k-NN, la sortie est une appartenance à une classe.
–> En savoir plus sur Wikipédia
Ce modèle calcule des distances entre hommes : la mise à l’échelle est donc indispensable. Sans elle, sbp et alcohol (de grandes valeurs) écraseraient les autres variables.
from sklearn.neighbors import KNeighborsClassifier

knn_clf = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=5))
knn_clf.fit(X_train, y_train)

y_pred_knn = knn_clf.predict(X_test)
evaluer('kNN', y_test, y_pred_knn)kNN
[[47 13]
[20 13]]
Exactitude : 0.645
Précision : 0.500
Rappel : 0.394L’exactitude est de 64,5 %, exactement celle de la référence, avec une précision de 50 % et un rappel de 39,4 %. Pour voir l’effet de la mise à l’échelle, voici le même modèle sans elle :
# Le même kNN, mais sans mise à l'échelle
knn_brut = KNeighborsClassifier(n_neighbors=5).fit(X_train, y_train)
accuracy_score(y_test, knn_brut.predict(X_test))0.6344086021505376Sans mise à l’échelle, l’exactitude tombe à 63,4 %. La mise à l’échelle aide donc un peu, mais pas assez pour que ce kNN soit meilleur que la référence.
Modèle 3 : que donne un réseau de neurones (ANN) ?
Les réseaux neuronaux artificiels ou systèmes connexionnistes sont des systèmes informatiques vaguement inspirés des réseaux neuronaux biologiques qui constituent nos cerveaux.
–> En savoir plus sur Wikipédia
Le réseau a 9 entrées (une par variable), deux couches cachées de 6 neurones et un neurone de sortie, qui donne la probabilité d’être un cas. Avec les versions actuelles de Keras, les arguments des anciennes versions ont changé : output_dim devient units (premier argument de Dense), nb_epoch devient epochs, et la taille de l’entrée se déclare avec keras.Input. Je garde l’initialisation par défaut des poids.
import keras
from keras import layers

def construire_ann():
    modele = keras.Sequential([
        keras.Input(shape=(9,)),
        layers.Dense(6, activation='relu'),   # première couche cachée
        layers.Dense(6, activation='relu'),   # seconde couche cachée
        layers.Dense(1, activation='sigmoid'),  # sortie : probabilité d'être un cas
    ])
    modele.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
    return modele

keras.utils.set_random_seed(1234)

# Un réseau de neurones a aussi besoin de données mises à l'échelle
scaler = StandardScaler().fit(X_train)

ann = construire_ann()
ann.fit(scaler.transform(X_train), y_train, batch_size=10, epochs=100, verbose=0)

y_pred_ann = (ann.predict(scaler.transform(X_test), verbose=0) > 0.5).astype(int).ravel()
evaluer('ANN', y_test, y_pred_ann)ANN
[[49 11]
[16 17]]
Exactitude : 0.710
Précision : 0.607
Rappel : 0.515L’exactitude est de 71,0 %, avec une précision de 60,7 % et un rappel de 51,5 %. Le résultat d’un réseau de neurones peut varier de quelques points d’une exécution à l’autre, et selon la version de TensorFlow : j’ai fixé la graine aléatoire, mais tu peux obtenir des valeurs un peu différentes.
Quelle approche est la meilleure ? La validation croisée
La validation croisée à 10 plis est une méthode d’évaluation où les données sont coupées en 10 parts, chacune servant une fois de test. Avec 93 hommes dans le jeu de test, un seul homme pèse 1,1 point d’exactitude : l’écart entre le SVM (69 hommes bien classés) et le réseau de neurones (66) ne tient qu’à 3 personnes. Un seul découpage est trop fragile pour conclure. J’utilise donc la validation croisée à 10 plis : les données sont coupées en 10 parts, chaque part sert une fois de test, et chaque homme est testé exactement une fois. StratifiedKFold garde la même proportion de cas dans chaque part.
from sklearn.model_selection import StratifiedKFold, cross_validate
from sklearn.metrics import make_scorer

cv = StratifiedKFold(n_splits=10, shuffle=True, random_state=1234)
metriques = {'accuracy': 'accuracy',
             'precision': make_scorer(precision_score, zero_division=0),
             'recall': 'recall'}

scores = {}
for nom, modele in [('Référence', DummyClassifier(strategy='most_frequent')),
                    ('SVM', svm_clf), ('kNN', knn_clf)]:
    resultat = cross_validate(modele, X, y, cv=cv, scoring=metriques)
    scores[nom] = {m: resultat['test_' + m] for m in metriques}

# Le réseau de neurones : une boucle, car il faut refaire la mise à l'échelle à chaque pli
scores['ANN'] = {m: [] for m in metriques}
for idx_train, idx_test in cv.split(X, y):
    keras.backend.clear_session()   # libère la mémoire entre deux plis
    sc = StandardScaler().fit(X.iloc[idx_train])
    reseau = construire_ann()
    reseau.fit(sc.transform(X.iloc[idx_train]), y.iloc[idx_train], batch_size=10, epochs=100, verbose=0)
    pred = (np.asarray(reseau(sc.transform(X.iloc[idx_test]))) > 0.5).astype(int).ravel()
    scores['ANN']['accuracy'].append(accuracy_score(y.iloc[idx_test], pred))
    scores['ANN']['precision'].append(precision_score(y.iloc[idx_test], pred, zero_division=0))
scores['ANN']['recall'].append(recall_score(y.iloc[idx_test], pred))Voici la moyenne des mesures sur les 10 plis (en %). Les valeurs du réseau de neurones peuvent varier de quelques dixièmes d’une machine à l’autre :
moyennes = pd.DataFrame({nom: {m: np.mean(v) for m, v in s.items()} for nom, s in scores.items()}).T
ecarts = pd.DataFrame({nom: {m: np.std(v) for m, v in s.items()} for nom, s in scores.items()}).T

moyennes.columns = ['Exactitude', 'Précision', 'Rappel']
(moyennes * 100).round(1) Exactitude Précision Rappel
Référence 65.4 0.0 0.0
SVM 73.1 64.7 52.5
kNN 64.0 48.1 34.4
ANN 71.8 62.1 49.4Et l’écart-type de ces mesures d’un pli à l’autre :
(ecarts * 100).round(1).rename(columns={'accuracy': 'Exactitude', 'precision': 'Précision', 'recall': 'Rappel'}) Exactitude Précision Rappel
Référence 0.3 0.0 0.0
SVM 5.5 10.9 8.5
kNN 7.1 15.4 10.6
ANN 6.1 11.9 9.0ax = (moyennes.loc[['SVM', 'kNN', 'ANN']] * 100).plot(kind='bar', figsize=(6, 6), ylim=[0, 100], rot=0)
ax.set_ylabel('%')
ax.set_title('Comparaison des 3 modèles (validation croisée à 10 plis)')
ax.grid(axis='x', visible=False)
plt.show()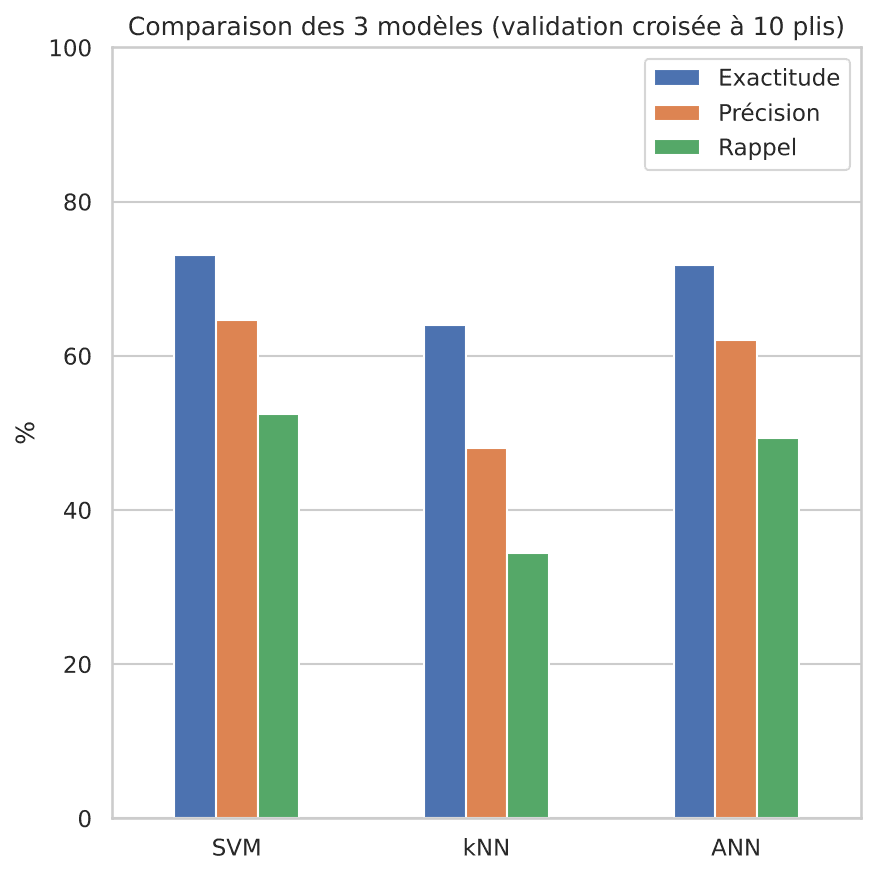
Ce que l’on peut en conclure :
- Le SVM et le réseau de neurones sont à égalité. Leur exactitude (73,1 % et 71,8 %) diffère de moins de deux points, pour un écart-type d’un pli à l’autre de plus de 5 points : on ne peut pas dire que l’un est meilleur que l’autre sur ce jeu de données.
- Le kNN est le moins bon. Son exactitude (64,0 %) est même un peu sous celle de la référence (65,4 %) et il ne détecte qu’un cas sur trois (rappel de 34,4 %).
- Aucun modèle n’est utilisable pour dépister la maladie. Les meilleurs ne détectent qu’environ un cas sur deux (rappel de 49 à 53 %). Avec 462 hommes et 9 variables, c’est limité : il faudrait plus de données, et probablement d’autres variables.
Pour comprendre la démarche générale du Machine Learning, tu peux lire Apprendre le Machine Learning avec Python.
Un score ne veut rien dire sans point de comparaison. Ici, 74 % d’exactitude paraît correct, mais la référence qui répond toujours « pas de maladie » fait déjà 65 %. Sur DataXp, tu t’entraînes à ces réflexes d’évaluation en passant de Python et pandas au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
À toi de jouer : change le random_state du découpage et regarde à quel point les résultats d’un seul découpage bougent. Essaie aussi une régression logistique, un classique sur ce jeu de données, ou un autre nombre de voisins pour le kNN.