Combien devrait coûter une course de taxi à New York ? Dans cet article, tu vas apprendre à prédire le prix des taxis avec le Machine Learning : à partir des lieux de prise en charge et de dépose, de la date et du nombre de passagers, on entraîne des modèles qui estiment le montant de la course. C’est le défi Kaggle « New York City Taxi Fare Prediction ».
C’est la partie 2 de la série. Dans la partie 1 : l’analyse exploratoire du prix des taxis, on a nettoyé les données, repéré les relations entre les variables et créé de nouvelles variables (les aéroports, les quartiers, le bas de Manhattan). Ici, on s’en sert pour construire, comparer et régler des modèles, et on mesure ce que chaque étape apporte vraiment.
Un mot sur les chiffres : ils viennent de mon exécution dans Google Colab sur 3 millions de courses (sur les 55 millions du jeu d’entraînement), avec 80 % des données pour l’entraînement et 20 % pour la validation, et une graine fixe pour la recherche Hyperopt. Avec une autre machine ou d’autres versions des bibliothèques, tu obtiendras des valeurs très proches, mais pas identiques au dernier chiffre. Le code, lui, est à jour : il fonctionne avec LightGBM 4, XGBoost 2 ou 3 et Scikit-learn 1.4 ou plus récent.
En bref : pour prédire le prix d’une course de taxi à New York, on part d’une référence (prédire le prix moyen, RMSE de 9,61 $), puis on compare régression linéaire, Random Forest, LightGBM et XGBoost. Les trois modèles d’arbres font entre 3,7 et 3,9 $ d’erreur contre 8,1 $ pour la régression linéaire. Les variables créées (aéroports, quartiers) améliorent le RMSE d’environ 4 %, la distance du trajet d’environ 3 % de plus, alors que le réglage des hyperparamètres n’apporte presque rien (3,6432 $ avant, 3,6430 $ après).
Comment prédire le prix des taxis : quel plan d’attaque ?
Après le nettoyage et l’exploration, on arrive à la construction des modèles. La qualité du résultat dépend autant des données et des variables que de l’algorithme choisi. On avance en cinq étapes :
- Préparer les données et les séparer en un jeu d’entraînement et un jeu de validation ;
- Calculer une prédiction de référence, le chiffre à battre ;
- Entraîner et comparer quatre modèles, sans ingénierie des caractéristiques ;
- Ajouter les variables créées dans la partie 1 ;
- Régler le meilleur modèle avec Hyperopt.
Comment préparer les données ?
On commence par charger les bibliothèques. En plus de Pandas et de Scikit-learn (version 1.4 ou plus récente, pour root_mean_squared_error), il te faut LightGBM, XGBoost et Hyperopt : pip install lightgbm xgboost hyperopt.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import lightgbm as lgb
import xgboost as xgb
from hyperopt import STATUS_OK, Trials, fmin, hp, tpe
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import root_mean_squared_error
from sklearn.model_selection import train_test_splitLe jeu d’entraînement vient de la compétition Kaggle (la partie 1 explique où le télécharger). Si tu as le fichier train.csv.zip, donne son nom à read_csv : Pandas lit directement dans l’archive, sans la décompresser.
# Pour tester le code rapidement, remplace 3_000_000 par 500_000
train = pd.read_csv("train.csv", nrows=3_000_000)
print("Dimensions du jeu d'entraînement :", train.shape)Dimensions du jeu d'entraînement : (3000000, 8)Ensuite, le nettoyage. On reprend les règles de la partie 1 : on supprime les tarifs négatifs, les courses hors de New York (coordonnées à 0 ou impossibles) et les courses de plus de 8 passagers (le jeu de test n’en contient aucune). On ajoute aussi les variables de date, avec le jour de la semaine encodé en nombre (dimanche = 0, …, samedi = 6) :
LIMITES_NY = {"min_lng": -74.263242, "min_lat": 40.573143,
              "max_lng": -72.986532, "max_lat": 41.709555}


def dans_zone(lat, lng, zone):
    """True si le point (lat, lng) est dans le rectangle `zone` (fonctionne sur des colonnes entières)."""
    return ((lat >= zone["min_lat"]) & (lat <= zone["max_lat"]) &
            (lng >= zone["min_lng"]) & (lng <= zone["max_lng"]))


def preparer(df):
    """Variables de date et suppression des courses aberrantes."""
    df = df.copy()
    dates = pd.to_datetime(df["pickup_datetime"], format="%Y-%m-%d %H:%M:%S UTC")
    df["pickup_day"] = dates.dt.day
    df["pickup_hour"] = dates.dt.hour
    df["pickup_day_of_week"] = (dates.dt.dayofweek + 1) % 7  # dimanche = 0, ..., samedi = 6
    df["pickup_month"] = dates.dt.month
    df["pickup_year"] = dates.dt.year

    dans_ny = (dans_zone(df["pickup_latitude"], df["pickup_longitude"], LIMITES_NY)
               & dans_zone(df["dropoff_latitude"], df["dropoff_longitude"], LIMITES_NY))
    return df[(df["fare_amount"] >= 0) & dans_ny & (df["passenger_count"] <= 8)]


train = preparer(train)
print("Dimensions après nettoyage :", train.shape)Dimensions après nettoyage : (2935680, 13)Il reste 2 935 680 courses sur 3 000 000 : environ 2,1 % des lignes ont été supprimées.
Pourquoi séparer l’entraînement et la validation ?
Dernière étape de préparation : couper les données en deux. Les modèles apprennent sur 80 % des courses (l’entraînement), puis on les évalue sur les 20 % restants (la validation), qu’ils n’ont jamais vues. On retrouve cette étape dans presque tous les projets de Machine Learning, et c’est elle qui permet de repérer le sur-apprentissage (overfitting) : une erreur faible sur l’entraînement mais élevée sur la validation, signe que le modèle a mémorisé les données au lieu de généraliser.
cible = "fare_amount"
X = train.drop(columns=["key", "pickup_datetime", cible])
y = train[cible]

X_train, X_valid, y_train, y_valid = train_test_split(X, y, test_size=0.2, random_state=123)
print("Entraînement :", X_train.shape)
print("Validation :", X_valid.shape)Entraînement : (2348544, 10)
Validation : (587136, 10)Les modèles simples, comme la régression linéaire, ne mémorisent pas : ils font des hypothèses fortes sur les données, donc leur erreur est élevée (un biais fort), mais stable. Les modèles complexes sont plus flexibles, mais ont tendance à mémoriser (une variance forte). Pour comparer les modèles, on regardera donc deux choses : l’erreur de validation, et l’écart entre l’erreur d’entraînement et l’erreur de validation.
Qu’est-ce qu’un modèle de référence (baseline) ?
Un modèle de référence (baseline) est la solution la plus simple, sans Machine Learning : tout modèle sérieux doit faire mieux. Pour un problème de régression comme le nôtre, on prédit simplement le montant moyen. On mesure l’erreur avec le RMSE (root mean squared error) : la racine de la moyenne des erreurs au carré. Il s’exprime en dollars, comme le tarif, et plus il est petit, meilleur est le modèle.
prix_moyen = round(y_train.mean(), 2)
print("Prix moyen d'une course :", prix_moyen)

pred_reference = np.full(len(y_valid), prix_moyen)
rmse_reference = root_mean_squared_error(y_valid, pred_reference)
print(f"RMSE de référence sur la validation : {rmse_reference:.4f}")Prix moyen d'une course : 11.31
RMSE de référence sur la validation : 9.6112Prédire 11,31 $ pour toutes les courses donne un RMSE de 9,61 $. C’est le chiffre à battre.
Quels modèles de Machine Learning utiliser pour prédire le prix ?
1. Que donnent les modèles sans ingénierie des caractéristiques ?
Dans cette première étape, on n’utilise que les colonnes brutes (les quatre coordonnées et le nombre de passagers) et les variables de date : dix colonnes en tout. Pas encore de distance, d’aéroport ni de quartier. On compare quatre algorithmes :
- la régression linéaire ;
- le Random Forest ;
- LightGBM ;
- XGBoost.
À part la régression linéaire, ce sont des ensembles d’arbres de décision, qui diffèrent par la façon de construire les arbres :
- Bagging (Random Forest) : on entraîne beaucoup d’arbres, chacun sur un échantillon tiré au hasard des données (avec remise) et sur un sous-ensemble de variables, puis on fait la moyenne de leurs prédictions. Chaque arbre est profond et très flexible ; la moyenne lisse leurs erreurs.
- Boosting (LightGBM, XGBoost) : les arbres sont construits l’un après l’autre, et chaque nouvel arbre corrige les erreurs de l’ensemble construit jusque-là. C’est le gradient boosting. XGBoost fait grandir chaque arbre niveau par niveau, alors que LightGBM le fait feuille par feuille, en développant d’abord la feuille qui réduit le plus l’erreur : c’est ce qui le rend très rapide.
Régression linéaire
La régression linéaire cherche la droite (ici, un hyperplan) qui s’ajuste le mieux aux données, en minimisant la somme des erreurs au carré. C’est le modèle le plus simple, et il est sensible aux valeurs aberrantes. Pour revoir le principe, lis la régression linéaire avec Python. On commence par une petite fonction qui garde les erreurs de chaque modèle :
resultats = []


def enregistrer(nom, rmse_entrainement, rmse_validation):
    """Garde les erreurs d'un modèle et les affiche."""
    ecart = abs(rmse_entrainement - rmse_validation)
    resultats.append({"modele": nom, "rmse_entrainement": rmse_entrainement,
                      "rmse_validation": rmse_validation, "ecart": ecart})
    print(f"{nom} : entraînement {rmse_entrainement:.4f} | validation {rmse_validation:.4f} | écart {ecart:.4f}")


lm = LinearRegression()
lm.fit(X_train, y_train)

enregistrer("Régression linéaire",
            root_mean_squared_error(y_train, lm.predict(X_train)),
root_mean_squared_error(y_valid, lm.predict(X_valid)))Régression linéaire : entraînement 8.2095 | validation 8.1403 | écart 0.0693Avec un RMSE de validation de 8,14 $ (contre 9,61 $ pour la référence), le modèle fait mieux, mais l’erreur reste très élevée. L’écart entre entraînement et validation est minuscule (0,07) : le modèle est trop simple pour sur-apprendre, c’est un problème de biais. C’est logique : le prix ne dépend pas linéairement des coordonnées brutes (la partie 1 montrait qu’il dépend surtout de la distance et des aéroports). Passons à un modèle plus flexible.
Random Forest
Un Random Forest est bien plus flexible : son biais est plus faible, mais le risque de sur-apprentissage augmente. Avec 100 arbres sur 2,3 millions de lignes, compte plusieurs minutes et beaucoup de mémoire.
rf = RandomForestRegressor(n_estimators=100, random_state=883, n_jobs=-1)
rf.fit(X_train, y_train)

enregistrer("Random Forest",
            root_mean_squared_error(y_train, rf.predict(X_train)),
root_mean_squared_error(y_valid, rf.predict(X_valid)))Random Forest : entraînement 1.4120 | validation 3.7246 | écart 2.3125Le RMSE de validation tombe à 3,72 $, mais celui de l’entraînement est de 1,41 $ : l’écart de 2,31 est énorme, c’est du sur-apprentissage. Les arbres, laissés sans limite de profondeur, ont mémorisé les courses d’entraînement. On pourrait réduire cet écart en réglant le modèle (profondeur maximale, nombre minimal de courses par feuille…).
LightGBM
LightGBM est une bibliothèque de gradient boosting très rapide, qui consomme peu de mémoire. Il faut choisir le nombre d’arbres : trop peu et le modèle sous-apprend, trop et il sur-apprend. On le choisit par validation croisée : on coupe les données d’entraînement en 10 parties, on entraîne sur 9 et on évalue sur la dixième, à tour de rôle, et on arrête d’ajouter des arbres dès que l’erreur ne s’améliore plus pendant 20 itérations (early stopping).
def entrainer_lightgbm(X_train, y_train, nfold=5):
    """Choisit le nombre d'arbres par validation croisée, puis entraîne le modèle sur tout le jeu."""
    params = {"objective": "regression", "metric": "rmse", "num_leaves": 31, "verbose": -1}
    donnees = lgb.Dataset(X_train, label=y_train)
    cv = lgb.cv(params, donnees, num_boost_round=5000, nfold=nfold, stratified=False,
                callbacks=[lgb.early_stopping(20, verbose=False)])
    nb_arbres = len(cv["valid rmse-mean"])
    return lgb.train(params, donnees, num_boost_round=nb_arbres), nb_arbres


modele_lgb, nb_arbres = entrainer_lightgbm(X_train, y_train, nfold=10)
print("Nombre d'arbres retenu :", nb_arbres)

enregistrer("LightGBM",
            root_mean_squared_error(y_train, modele_lgb.predict(X_train)),
root_mean_squared_error(y_valid, modele_lgb.predict(X_valid)))Nombre d'arbres retenu : 2482
LightGBM : entraînement 3.3012 | validation 3.7900 | écart 0.4888La validation croisée retient 2 482 arbres. Le RMSE de validation est de 3,79 $, proche de celui du Random Forest, avec un écart entraînement/validation (0,49) bien plus faible.
Un détail si tu reprends d’anciens tutoriels : dans LightGBM 4, l’arrêt anticipé se règle avec le callback lgb.early_stopping ; les anciens arguments early_stopping_rounds et verbose_eval n’existent plus.
XGBoost
XGBoost est l’autre grande bibliothèque de gradient boosting. On procède de la même façon, avec une validation croisée à 5 plis pour choisir le nombre d’arbres. (L’objectif reg:linear des anciens tutoriels s’appelle aujourd’hui reg:squarederror.)
dtrain = xgb.DMatrix(X_train, label=y_train)
dvalid = xgb.DMatrix(X_valid, label=y_valid)
params_xgb = {"objective": "reg:squarederror", "eval_metric": "rmse"}

cv_xgb = xgb.cv(params_xgb, dtrain, num_boost_round=5000, nfold=5, early_stopping_rounds=20)
modele_xgb = xgb.train(params_xgb, dtrain, num_boost_round=len(cv_xgb))

enregistrer("XGBoost",
            root_mean_squared_error(y_train, modele_xgb.predict(dtrain)),
root_mean_squared_error(y_valid, modele_xgb.predict(dvalid)))XGBoost : entraînement 3.5198 | validation 3.8553 | écart 0.3356Quel modèle garder ?
Réunissons les résultats dans un tableau :
tableau = pd.DataFrame(resultats).round(4)
print(tableau.to_string(index=False)) modele rmse_entrainement rmse_validation ecart
Régression linéaire 8.2095 8.1403 0.0693
Random Forest 1.4120 3.7246 2.3125
LightGBM 3.3012 3.7900 0.4888
XGBoost 3.5198 3.8553 0.3356Les trois modèles d’arbres sont nettement meilleurs que la régression linéaire (entre 3,7 et 3,9 $ d’erreur contre 8,1 $). Le Random Forest a la meilleure erreur de validation (3,72), mais il sur-apprend fortement (écart de 2,31). LightGBM (3,79) et XGBoost (3,86) ont des erreurs proches et un écart bien plus raisonnable (0,49 et 0,34). On garde LightGBM pour la suite : erreur comparable, écart faible, et un entraînement bien plus rapide que le Random Forest, ce qui compte quand on veut tester beaucoup de variantes.
2. Qu’apporte l’ingénierie des caractéristiques ?
L’ingénierie des caractéristiques (feature engineering) transforme les données brutes en variables plus parlantes pour le modèle. De bonnes variables permettent à un modèle simple de mieux prédire, parce qu’elles décrivent la structure des données. On reprend celles de la partie 1. Pour chaque lieu, la prise en charge et la dépose :
- est-ce un aéroport (JFK, Newark ou LaGuardia) ?
- quelle est la distance, en miles, au centre de chaque aéroport et de chaque quartier ?
- dans quel quartier se trouve-t-il (Manhattan, Queens, Brooklyn, Bronx ou Staten Island) ?
- est-il dans le bas de Manhattan ?
On regroupe d’abord les zones dans des dictionnaires. Ce sont les rectangles de la partie 1, des approximations qui se chevauchent :
aeroports = {
    "JFK": {"min_lng": -73.8352, "min_lat": 40.6195, "max_lng": -73.7401, "max_lat": 40.6659},
    "EWR": {"min_lng": -74.1925, "min_lat": 40.6700, "max_lng": -74.1531, "max_lat": 40.7081},
    "la_guardia": {"min_lng": -73.8895, "min_lat": 40.7664, "max_lng": -73.8550, "max_lat": 40.7931},
}
quartiers = {
    "manhattan": {"min_lng": -74.0479, "min_lat": 40.6829, "max_lng": -73.9067, "max_lat": 40.8820},
    "queens": {"min_lng": -73.9630, "min_lat": 40.5431, "max_lng": -73.7004, "max_lat": 40.8007},
    "brooklyn": {"min_lng": -74.0421, "min_lat": 40.5707, "max_lng": -73.8334, "max_lat": 40.7395},
    "bronx": {"min_lng": -73.9339, "min_lat": 40.7855, "max_lng": -73.7654, "max_lat": 40.9176},
    "staten_island": {"min_lng": -74.2558, "min_lat": 40.4960, "max_lng": -74.0522, "max_lat": 40.6490},
}
bas_manhattan = {"min_lng": -74.0194, "min_lat": 40.6997, "max_lng": -73.9716, "max_lat": 40.7427}

# Centres (longitude, latitude) des aéroports et des quartiers
centres = {
    "jfk": (-73.7900, 40.6437), "ewr": (-74.1843, 40.6924), "laguardia": (-73.8733, 40.7746),
    "manhattan": (-73.9664, 40.7909), "queens": (-73.8317, 40.7038), "brooklyn": (-73.9489, 40.6551),
    "bronx": (-73.8568, 40.8572), "statenisland": (-74.1540, 40.5725),
}Puis une seule fonction crée toutes les variables, sur des colonnes entières. Pas de apply ligne par ligne : sur 2,3 millions de lignes, ce serait beaucoup plus lent (la partie 1 compare les temps, et 10 astuces Pandas explique la logique). Le quartier est encodé en colonnes 0/1 (one-hot). On fixe la liste des quartiers pour que les jeux d’entraînement et de validation aient exactement les mêmes colonnes, même si un quartier manque dans l’un des deux :
def distance_miles(lat1, lng1, lat2, lng2):
    """Distance de Haversine en miles (fonctionne sur des colonnes entières)."""
    p = np.pi / 180
    a = (0.5 - np.cos((lat2 - lat1) * p) / 2
         + np.cos(lat1 * p) * np.cos(lat2 * p) * (1 - np.cos((lng2 - lng1) * p)) / 2)
    return 0.6213712 * 12742 * np.arcsin(np.sqrt(a))


NOMS_QUARTIERS = [*quartiers, "others"]


def ajouter_caracteristiques(df):
    df = df.copy()
    for sens in ("pickup", "dropoff"):
        lat, lng = df[f"{sens}_latitude"], df[f"{sens}_longitude"]

        for nom, zone in aeroports.items():
            df[f"is_{sens}_{nom}"] = dans_zone(lat, lng, zone).astype(int)
        df[f"is_{sens}_lower_manhattan"] = dans_zone(lat, lng, bas_manhattan).astype(int)

        for nom, (lng_centre, lat_centre) in centres.items():
            df[f"{sens}_distance_{nom}"] = distance_miles(lat, lng, lat_centre, lng_centre)

        # Premier rectangle qui contient le point (les rectangles se chevauchent)
        quartier = np.select([dans_zone(lat, lng, zone) for zone in quartiers.values()],
                             list(quartiers), default="others")
        df[f"{sens}_borough"] = pd.Categorical(quartier, categories=NOMS_QUARTIERS)

    # Encodage "one-hot" : une colonne 0/1 par quartier
    return pd.get_dummies(df, columns=["pickup_borough", "dropoff_borough"], dtype=int)


X_train = ajouter_caracteristiques(X_train)
X_valid = ajouter_caracteristiques(X_valid)
print("Nombre de variables :", X_train.shape[1])Nombre de variables : 46On passe de 10 à 46 variables. On relance LightGBM avec les mêmes réglages (5 plis au lieu de 10, pour gagner du temps) :
modele_lgb_fe, nb_arbres_fe = entrainer_lightgbm(X_train, y_train, nfold=5)
print("Nombre d'arbres retenu :", nb_arbres_fe)

enregistrer("LightGBM + variables de la partie 1",
            root_mean_squared_error(y_train, modele_lgb_fe.predict(X_train)),
root_mean_squared_error(y_valid, modele_lgb_fe.predict(X_valid)))Nombre d'arbres retenu : 2191
LightGBM + variables de la partie 1 : entraînement 3.1371 | validation 3.6432 | écart 0.5061Le RMSE de validation passe de 3,79 $ à 3,64 $, soit une baisse d’environ 4 %, sans que l’écart entre entraînement et validation change beaucoup (0,51 contre 0,49). Le gain est réel, mais modeste : on y revient dans les notes de fin.
3. Comment régler le modèle avec Hyperopt ?
Un bon modèle a une erreur faible et un écart faible. Les hyperparamètres de LightGBM permettent d’agir sur le sur-apprentissage. On en règle trois :
max_depth: la profondeur maximale d’un arbre. LightGBM fait grandir les arbres feuille par feuille : sans limite, ils peuvent devenir très profonds ;- subsample : la fraction des courses utilisée à chaque itération. Elle accélère l’entraînement et limite le sur-apprentissage ;
colsample_bytree: la fraction des variables utilisée pour construire chaque arbre.
Hyperopt est une bibliothèque de recherche d’hyperparamètres. Il faut lui fournir une fonction objectif à minimiser (ici, le RMSE de validation d’un LightGBM), un espace de recherche (les valeurs que peut prendre chaque paramètre) et un algorithme de recherche. L’algorithme TPE regarde les essais précédents pour choisir les suivants, plus malin qu’un tirage au hasard. On lance 20 essais, avec une graine (rstate) pour retrouver les mêmes valeurs à chaque exécution :
def objectif(espace):
    """Entraîne un LightGBM avec ces hyperparamètres et renvoie son RMSE de validation."""
    modele = lgb.LGBMRegressor(
        objective="regression", boosting_type="gbdt", num_leaves=60, n_estimators=5000,
        subsample_freq=20, max_depth=int(espace["max_depth"]), subsample=espace["subsample"],
        colsample_bytree=espace["colsample"], n_jobs=-1, verbose=-1)
    modele.fit(X_train, y_train, eval_set=[(X_valid, y_valid)], eval_metric="rmse",
               callbacks=[lgb.early_stopping(20, verbose=False)])
    rmse = root_mean_squared_error(y_valid, modele.predict(X_valid))
    return {"loss": rmse, "status": STATUS_OK}


espace = {
    "max_depth": hp.quniform("x_max_depth", 5, 30, 3),
    "subsample": hp.uniform("x_subsample", 0.8, 1),
    "colsample": hp.uniform("x_colsample", 0.3, 1),
}

essais = Trials()
meilleurs = fmin(fn=objectif, space=espace, algo=tpe.suggest, max_evals=20,
                 trials=essais, rstate=np.random.default_rng(1234), show_progressbar=False)

meilleurs = {cle: float(meilleurs[cle]) for cle in ("x_max_depth", "x_subsample", "x_colsample")}
print(meilleurs){'x_max_depth': 15.0, 'x_subsample': 0.9950917970340202, 'x_colsample': 0.45254958279352975}Attention au temps de calcul : chaque essai entraîne un modèle complet, soit environ une minute et demie dans Colab sur 3 millions de lignes. Les 20 essais prennent donc une demi-heure environ ; 100 essais demanderaient près de 2 heures, pour un résultat à peine meilleur. Pour tester le code, passe à max_evals=10 et à 500 000 lignes.
Hyperopt propose une profondeur de 15, un subsample de 0,995 et un colsample_bytree de 0,453 : chaque arbre ne regarde que 45 % des variables. On entraîne le modèle final avec ces valeurs :
modele_final = lgb.LGBMRegressor(
    objective="regression", boosting_type="gbdt", num_leaves=60, n_estimators=5000,
    subsample_freq=20, max_depth=int(meilleurs["x_max_depth"]), subsample=meilleurs["x_subsample"],
    colsample_bytree=meilleurs["x_colsample"], n_jobs=-1, verbose=-1)
modele_final.fit(X_train, y_train, eval_set=[(X_valid, y_valid)], eval_metric="rmse",
                 callbacks=[lgb.early_stopping(20, verbose=False)])
print("Nombre d'arbres retenu :", modele_final.best_iteration_)

enregistrer("LightGBM réglé",
            root_mean_squared_error(y_train, modele_final.predict(X_train)),
root_mean_squared_error(y_valid, modele_final.predict(X_valid)))Nombre d'arbres retenu : 778
LightGBM réglé : entraînement 3.2860 | validation 3.6430 | écart 0.3570Le RMSE de validation passe de 3,6432 à 3,6430 : un gain de 0,0002 $, autrement dit rien. Le seul effet visible est que l’écart entre entraînement et validation descend à 0,36 (contre 0,51) : le modèle sur-apprend moins. Pour ce problème, le réglage apporte donc beaucoup moins que les variables (−4 % avec les nouvelles variables, quasiment 0 % avec le réglage).
Une précision importante : on a utilisé les données de validation pour arrêter l’entraînement et pour choisir les hyperparamètres. Le RMSE de validation final est donc un peu optimiste. Pour une évaluation honnête, garde un troisième jeu de données, que tu n’utilises qu’une seule fois, à la toute fin. On pourrait aussi régler num_leaves, min_child_samples et les régularisations L1 et L2 (reg_alpha, reg_lambda).
Quelles variables comptent le plus pour prédire le prix ?
LightGBM peut dire combien de fois chaque variable a servi à découper les données dans les arbres :
importances = pd.Series(modele_final.feature_importances_, index=X_train.columns)
importances = importances.sort_values(ascending=False)

plt.figure(figsize=(10, 15))
sns.barplot(x=importances.values, y=importances.index, hue=importances.index,
            palette="husl", legend=False)
plt.show()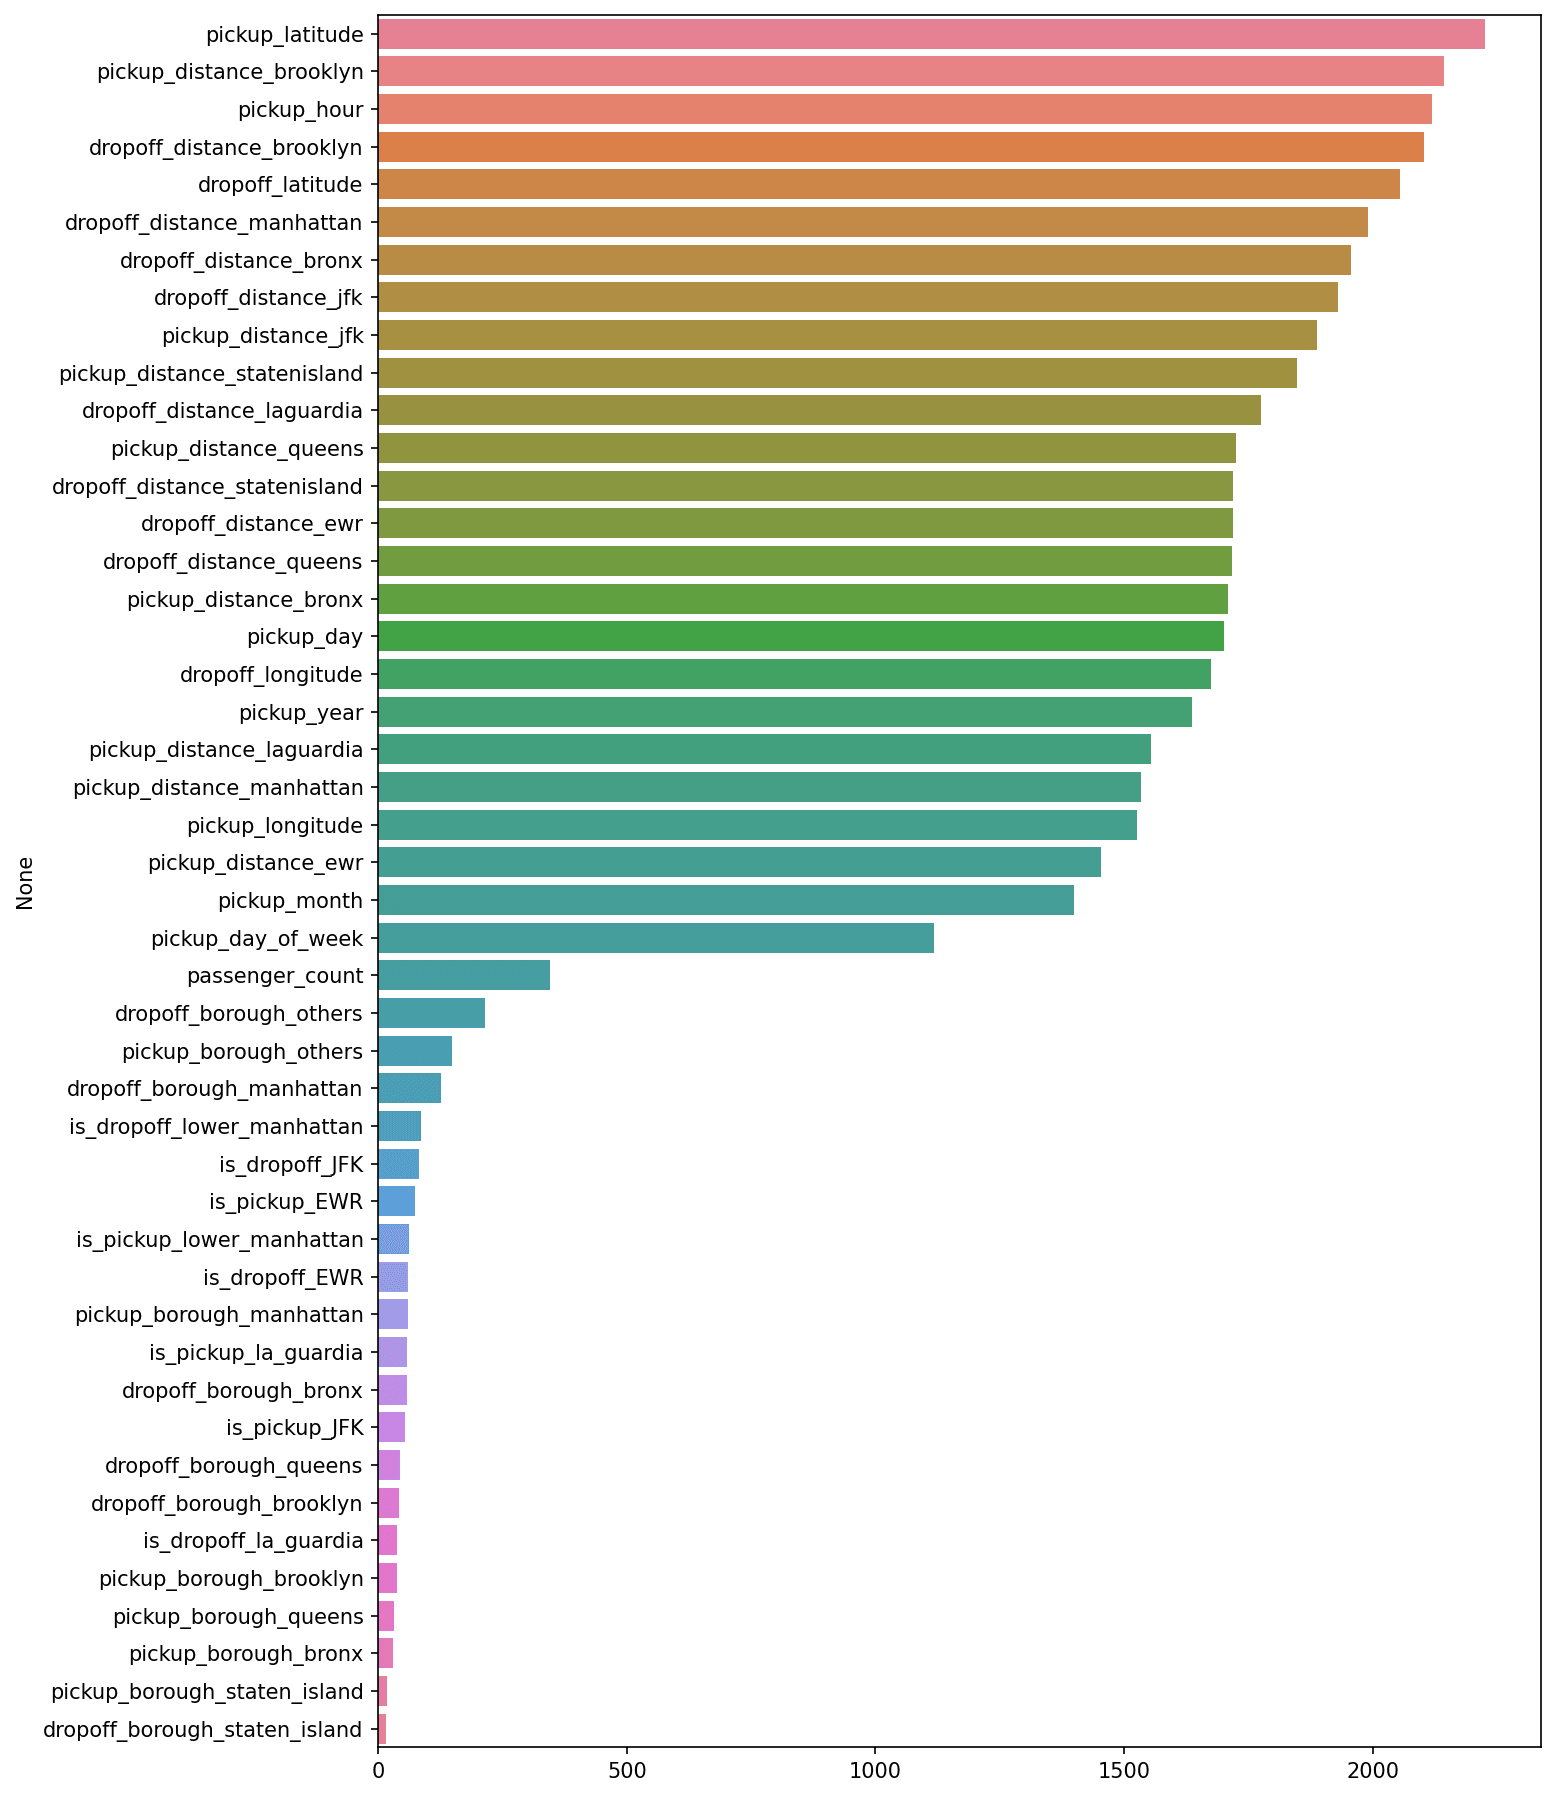
En tête : les distances aux centres des aéroports et des quartiers, surtout la distance de prise en charge à JFK et à Staten Island, puis la distance de dépose à LaGuardia. Viennent ensuite le jour du mois, la longitude de dépose et l’année. Loin derrière : le nombre de passagers, qui compte très peu (le montant moyen d’une course varie à peine avec le nombre de passagers), et tout en bas les variables 0/1 (quartiers, aéroports, bas de Manhattan).
Attention à la lecture : ce classement compte les découpages. Une variable 0/1 ne permet qu’un seul découpage, elle est donc mécaniquement moins utilisée qu’une variable continue : ce classement ne dit pas qu’elle est inutile.
Qu’est-ce qu’il faut retenir ?
Voici le chemin parcouru, de la référence au modèle réglé :
| Étape | RMSE de validation | Écart entraînement/validation |
|---|---|---|
| Référence (prix moyen) | 9,61 $ | — |
| Régression linéaire | 8,14 $ | 0,07 |
| Random Forest | 3,72 $ | 2,31 |
| XGBoost | 3,86 $ | 0,34 |
| LightGBM | 3,79 $ | 0,49 |
| LightGBM + variables de la partie 1 | 3,64 $ | 0,51 |
| LightGBM réglé avec Hyperopt | 3,64 $ | 0,36 |
| LightGBM + distance du trajet (sans réglage) | 3,54 $ | 0,37 |
- Commence toujours par une référence : elle donne le chiffre à battre ;
- Compare l’erreur de validation et l’écart avec l’erreur d’entraînement : le Random Forest a la meilleure erreur, mais il sur-apprend ;
- Les variables ont fait gagner environ 4 %, la distance du trajet environ 3 % de plus, le réglage presque rien : améliore tes données avant de chercher les hyperparamètres ;
- Garde un jeu de données intact pour l’évaluation finale.
Tu viens de faire passer l’erreur de 9,61 $ à 3,54 $ en créant des variables et en choisissant le bon modèle. Ce genre de projet repose sur des bases de Python solides (fonctions, boucles, manipulation de données). Si tu veux les consolider avant d’aller plus loin dans le Machine Learning, le cours Python pour la data science de DataXp reprend ces bases pas à pas.
Notes de fin
Le notebook complet de cet article est à jour avec les versions récentes de LightGBM, XGBoost et Scikit-learn : ouvre-le dans Google Colab (rien à installer ; il t’explique comment récupérer les données depuis Kaggle). Clique sur « Copier sur Drive » pour pouvoir l’exécuter et le modifier.
Une piste pour aller plus loin : les modèles ci-dessus n’utilisent pas la distance du trajet (trip_distance), créée dans la partie 1, alors que c’est la variable la plus évidente pour un prix de taxi. En l’ajoutant, le RMSE de validation passe de 3,64 $ à 3,54 $ (environ −3 %), même sans régler le modèle :
for jeu in (X_train, X_valid):
    jeu["trip_distance"] = distance_miles(jeu["pickup_latitude"], jeu["pickup_longitude"],
                                          jeu["dropoff_latitude"], jeu["dropoff_longitude"])

modele_distance, nb_arbres_distance = entrainer_lightgbm(X_train, y_train, nfold=5)
print("Nombre d'arbres retenu :", nb_arbres_distance)

enregistrer("LightGBM + distance du trajet",
            root_mean_squared_error(y_train, modele_distance.predict(X_train)),
root_mean_squared_error(y_valid, modele_distance.predict(X_valid)))Nombre d'arbres retenu : 1130
LightGBM + distance du trajet : entraînement 3.1660 | validation 3.5357 | écart 0.3697D’autres pistes : utiliser plus de données (on n’a pris que 3 des 55 millions de courses), construire des modèles d’ensemble (par exemple la moyenne des prédictions de LightGBM et de XGBoost), ou régler d’autres hyperparamètres.
Pour soumettre tes prédictions sur Kaggle, applique les mêmes transformations au jeu de test, sans supprimer de lignes : il faut une prédiction pour chaque course. Ne compare pas ton RMSE de validation au score du classement (3,03760 pour mon modèle XGBoost dans la partie 1) : ce ne sont ni les mêmes données ni le même modèle.
Si tu débutes, commence par apprendre le Machine Learning avec Python.