Pandas est la bibliothèque Python de référence pour manipuler des données : lire un fichier, le nettoyer, filtrer, regrouper, fusionner, puis tracer un graphique. Dans cet article, tu vas découvrir ses concepts clés en 9 minutes de lecture, avec un cas réel : le catalogue Netflix (6 137 films et séries, plus 81 355 lignes de générique).
Que tu débutes ou que tu veuilles revoir les bases, tu retrouveras ici les opérations que tu utiliseras à chaque projet de data science. Chaque exemple a été exécuté, et tu vois les vraies sorties.
Article mis à jour en novembre 2026 : j’ai refait tous les exemples avec Pandas 3 et rajouté ce qui manquait : info() et describe(), loc et iloc, les filtres sur plusieurs conditions, query(), les genres, le left join avec indicateur, deux graphiques et un exemple de dates sur les données réelles. J’ai aussi corrigé l’ancien exemple de dates, dont le texte ne correspondait pas au code.
En bref : la data science avec Pandas commence par un DataFrame, qui se lit avec pd.read_csv(), s’observe avec head(), info() et describe(), se filtre avec une condition entre crochets, se regroupe avec groupby(), se nettoie avec fillna() ou dropna(), se trie avec sort_values() et se combine avec merge(). Voici comment faire chaque étape.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : les fichiers de données se téléchargent automatiquement depuis GitHub.
Comment importer Pandas ?
Avant de travailler avec Pandas, il faut importer la bibliothèque. Par convention, on lui donne l’alias pd :
import pandas as pd

print(pd.__version__)3.1.1Comment lire un fichier CSV dans un DataFrame ?
Un DataFrame est une structure de données bidimensionnelle, comme un tableau : des lignes, des colonnes nommées, et un index. La façon la plus courante d’en créer un est de lire un fichier. Pandas sait lire de nombreux formats :
# lire un fichier CSV
csv_df = pd.read_csv("chemin/nom_du_fichier.csv")

# lire un fichier texte
text_df = pd.read_csv("chemin/nom_du_fichier.txt")

# lire un fichier Excel
excel_df = pd.read_excel("chemin/nom_du_fichier.xlsx")Nous utiliserons le jeu de données Netflix Movies and TV Shows publié sur Kaggle, qui contient les films et séries du catalogue Netflix, ainsi que leur générique. Les deux fichiers (titles.csv et credits.csv) sont aussi disponibles sur mon GitHub. Cette commande les télécharge dans le dossier où tu exécutes ton code :
from urllib.request import urlretrieve

for fichier in ("titles.csv", "credits.csv"):
    urlretrieve(
        "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/data-science-avec-pandas/" + fichier,
        fichier,
)Puis on lit les deux fichiers :
netflix_titles = pd.read_csv("titles.csv")
netflix_credits = pd.read_csv("credits.csv")

print(netflix_titles.shape)
print(netflix_credits.shape)(6137, 15)
(81355, 5)Le fichier titles.csv contient 6 137 titres et 15 colonnes. Le fichier credits.csv contient 81 355 lignes : une par acteur ou réalisateur et par titre.
Comment observer les données d’un DataFrame ?
Une fois le DataFrame créé, plusieurs méthodes permettent de l’explorer. head() affiche les 5 premières lignes. Les sorties de cet article viennent de Pandas 3 : avec une version plus ancienne, tu peux voir quelques différences d’affichage, par exemple object à la place de str pour les colonnes de texte.
pd.set_option("display.max_columns", 8)
netflix_titles.head() id title type description \
0 ts300399 Five Came Back: The Reference Films SHOW This collection includes 12 World War II-era p...
1 tm82169 Rocky MOVIE When world heavyweight boxing champion, Apollo...
2 tm17823 Grease MOVIE Australian good girl Sandy and greaser Danny f...
3 tm191099 The Sting MOVIE A novice con man teams up with an acknowledged...
4 tm69975 Rocky II MOVIE After Rocky goes the distance with champ Apoll...
... imdb_score imdb_votes tmdb_popularity tmdb_score
0 ... NaN NaN 0.601 NaN
1 ... 8.1 588100.0 106.361 7.782
2 ... 7.2 283316.0 33.160 7.406
3 ... 8.3 266738.0 24.616 8.020
4 ... 7.3 216307.0 75.699 7.246
[5 rows x 15 columns]Les données des titres contiennent le nom du film ou de la série, son type, l’année de sortie, les genres, le nombre de saisons, la note IMDB, etc. Et le générique :
netflix_credits.head() person_id id name character role
0 3180 tm82169 Sylvester Stallone Robert "Rocky" Balboa ACTOR
1 7748 tm82169 Talia Shire Adrianna "Adrian" Pennino ACTOR
2 7749 tm82169 Burt Young Paulie Pennino ACTOR
3 7750 tm82169 Carl Weathers Apollo Creed ACTOR
4 7751 tm82169 Burgess Meredith Mickey Goldmill ACTORChaque ligne associe une personne (name) à un titre (id), avec son rôle : ACTOR ou DIRECTOR.
Que renvoient info() et describe() ?
info() donne les types des colonnes et le nombre de valeurs non manquantes. describe() résume les statistiques des colonnes numériques :
netflix_titles.info()<class 'pandas.DataFrame'>
RangeIndex: 6137 entries, 0 to 6136
Data columns (total 15 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 id 6137 non-null str
1 title 6137 non-null str
2 type 6137 non-null str
3 description 6114 non-null str
4 release_year 6137 non-null int64
5 age_certification 3394 non-null str
6 runtime 6137 non-null int64
7 genres 6137 non-null str
8 production_countries 6137 non-null str
9 seasons 2306 non-null float64
10 imdb_id 5741 non-null str
11 imdb_score 5669 non-null float64
12 imdb_votes 5653 non-null float64
13 tmdb_popularity 6061 non-null float64
14 tmdb_score 5885 non-null float64
dtypes: float64(5), int64(2), str(8)
memory usage: 2.4 MBnetflix_titles[["release_year", "runtime", "imdb_score"]].describe().round(2) release_year runtime imdb_score
count 6137.00 6137.00 5669.00
mean 2017.37 76.38 6.54
std 6.60 39.09 1.14
min 1945.00 0.00 1.50
25% 2017.00 44.00 5.80
50% 2019.00 80.00 6.60
75% 2021.00 105.00 7.30
max 2023.00 225.00 9.60Tu remarques déjà qu’il manque des valeurs : seasons n’est renseignée que pour 2 306 titres, et imdb_score pour 5 669 sur 6 137. Nous y reviendrons plus bas.
Comment sélectionner des colonnes et des lignes ?
Tu peux sélectionner une colonne avec des crochets. Le résultat est une Series (une colonne avec son index) :
netflix_titles["description"]0 This collection includes 12 World War II-era p...
1 When world heavyweight boxing champion, Apollo...
2 Australian good girl Sandy and greaser Danny f...
3 A novice con man teams up with an acknowledged...
4 After Rocky goes the distance with champ Apoll...
...
6132 Two young boys must work together to stop robb...
6133 ‘Theatre is my life,’ Yıldız Kenter admits in ...
6134 This Queen of Comedy shines as she takes the s...
6135 The lives of three teenagers and a hit-man int...
6136 A story about young boy sultan, 11 years old l...
Name: description, Length: 6137, dtype: strPour sélectionner plusieurs colonnes, utilise une liste, donc des doubles crochets. Le résultat est un DataFrame :
netflix_titles[["title", "description"]] title description
0 Five Came Back: The Reference Films This collection includes 12 World War II-era p...
1 Rocky When world heavyweight boxing champion, Apollo...
2 Grease Australian good girl Sandy and greaser Danny f...
3 The Sting A novice con man teams up with an acknowledged...
4 Rocky II After Rocky goes the distance with champ Apoll...
... ... ...
6132 عبود في البيت Two young boys must work together to stop robb...
6133 Sweetie ‘Theatre is my life,’ Yıldız Kenter admits in ...
6134 Sommore: Queen Chandelier This Queen of Comedy shines as she takes the s...
6135 All Na Vibes The lives of three teenagers and a hit-man int...
6136 Going to Heaven A story about young boy sultan, 11 years old l...
[6137 rows x 2 columns]Quelle est la différence entre loc et iloc ?
loc sélectionne avec les étiquettes (le nom des lignes et des colonnes), iloc avec les positions (des numéros). Attention : avec loc, la borne de fin d’une tranche est incluse (:3 donne les lignes 0 à 3), alors qu’avec iloc elle est exclue.
print(netflix_titles.loc[0, "title"])
print(netflix_titles.iloc[2, 1])
netflix_titles.loc[:3, ["title", "type", "release_year"]]Five Came Back: The Reference Films
Grease
title type release_year
0 Five Came Back: The Reference Films SHOW 1945
1 Rocky MOVIE 1976
2 Grease MOVIE 1978
3 The Sting MOVIE 1973Comment filtrer les données d’un DataFrame ?
Pour filtrer, tu places une condition entre crochets. La condition produit une série de True et False (un masque), et Pandas garde les lignes vraies. Par exemple, les titres dont la note IMDB est supérieure à 8 :
bien_notes = netflix_titles[netflix_titles["imdb_score"] > 8]

print(len(bien_notes), "titres avec une note IMDB supérieure à 8")
bien_notes[["title", "type", "release_year", "imdb_score"]].head()425 titres avec une note IMDB supérieure à 8
title type release_year imdb_score
1 Rocky MOVIE 1976 8.1
3 The Sting MOVIE 1973 8.3
5 Monty Python and the Holy Grail MOVIE 1975 8.2
7 Monty Python's Flying Circus SHOW 1969 8.8
13 Richard Pryor: Live in Concert MOVIE 1979 8.1Cette opération renvoie un nouveau DataFrame avec 425 titres. Pour combiner plusieurs conditions, utilise & (et), | (ou) et ~ (non), avec des parenthèses autour de chaque condition. Les films avec une note supérieure à 8,5 :
films_cultes = netflix_titles[
    (netflix_titles["type"] == "MOVIE") & (netflix_titles["imdb_score"] > 8.5)
]

print(len(films_cultes), "films avec une note supérieure à 8,5")
films_cultes[["title", "release_year", "imdb_score"]].sort_values("imdb_score", ascending=False).head()18 films avec une note supérieure à 8,5
title release_year imdb_score
209 The Lord of the Rings: The Return of the King 2003 9.0
201 The Dark Knight 2008 9.0
4758 Split at the Root 2022 8.9
3215 David Attenborough: A Life on Our Planet 2020 8.9
195 The Lord of the Rings: The Fellowship of the Ring 2001 8.8Existe-t-il une syntaxe plus lisible avec query() ?
Oui : query() accepte la condition sous forme de texte, avec and et or, ce qui est souvent plus lisible. Le résultat est identique :
same = netflix_titles.query("type == 'MOVIE' and imdb_score > 8.5")

print(same.equals(films_cultes))TrueComment agréger des données avec groupby ?
La méthode groupby() regroupe les lignes selon une ou plusieurs colonnes, puis applique une fonction d’agrégation à chaque groupe. Ici, le nombre de titres par type :
netflix_titles.groupby(["type"]).agg(title_count=("title", "count")) title_count
type
MOVIE 3831
SHOW 2306Le catalogue contient 3 831 films et 2 306 séries. On peut calculer plusieurs agrégats à la fois :
netflix_titles.groupby("type").agg(
    title_count=("title", "count"),
    imdb_moyen=("imdb_score", "mean"),
    duree_mediane=("runtime", "median"),
).round(2) title_count imdb_moyen duree_mediane
type
MOVIE 3831 6.27 99.0
SHOW 2306 6.99 42.0Les séries ont une meilleure note moyenne (6,99 contre 6,27 pour les films), et leurs épisodes sont plus courts (durée médiane de 42 minutes contre 99). Pour approfondir, lis mon article sur GroupBy de Pandas en 10 étapes.
Comment compter les genres, stockés dans une liste ?
La colonne genres contient du texte qui ressemble à une liste (['romance', 'comedy']). On la convertit en vraie liste avec ast.literal_eval, puis explode() crée une ligne par genre :
import ast

netflix_titles["genres"] = netflix_titles["genres"].apply(ast.literal_eval)   # texte -> vraie liste

genres = netflix_titles.explode("genres")
genres["genres"].value_counts().head(5)genres
drama 3120
comedy 2485
thriller 1229
action 1140
romance 1054
Name: count, dtype: int64Le drame (3 120 titres) et la comédie (2 485) sont les genres les plus fréquents.
Comment gérer les valeurs manquantes avec Pandas ?
Un DataFrame contient souvent des valeurs manquantes : erreurs de saisie, absence de réponse, information qui n’existe pas. Pandas les représente par NaN. Pour les repérer, isna().sum() compte les valeurs manquantes par colonne :
netflix_titles.isna().sum()id 0
title 0
type 0
description 23
release_year 0
age_certification 2743
runtime 0
genres 0
production_countries 0
seasons 3831
imdb_id 396
imdb_score 468
imdb_votes 484
tmdb_popularity 76
tmdb_score 252
dtype: int64Comment remplacer les valeurs manquantes avec fillna ?
Dans la colonne seasons, les 3 831 valeurs manquantes correspondent aux films : un film n’a pas de saison. On peut les remplacer par 0 avec fillna() :
netflix_titles["seasons"] = netflix_titles["seasons"].fillna(0)

print(netflix_titles["seasons"].isna().sum(), "valeurs manquantes dans seasons")
print(netflix_titles.groupby("type")["seasons"].agg(["min", "max"]))0 valeurs manquantes dans seasons
min max
type
MOVIE 0.0 0.0
SHOW 1.0 44.0Ce remplacement a un sens ici, mais ce n’est pas toujours le cas : remplacer la note IMDB manquante par 0 fausserait toutes les moyennes, car une note absente n’est pas une note de zéro.
Comment supprimer les lignes incomplètes avec dropna ?
dropna() supprime les lignes qui contiennent des valeurs manquantes. Avec subset, tu limites la vérification aux colonnes qui t’intéressent :
avec_note = netflix_titles.dropna(subset=["imdb_score"])

print(len(netflix_titles), "titres avant,", len(avec_note), "après dropna sur imdb_score")6137 titres avant, 5669 après dropna sur imdb_scoreComment trier un DataFrame avec sort_values ?
La méthode sort_values() trie selon une ou plusieurs colonnes. L’ordre est croissant par défaut :
# trier les données en fonction de l'année de publication
netflix_titles.sort_values("release_year")[["title", "type", "release_year"]].head() title type release_year
0 Five Came Back: The Reference Films SHOW 1945
9 White Christmas MOVIE 1954
27 The Blazing Sun MOVIE 1954
26 Dark Waters MOVIE 1956
12 Cairo Station MOVIE 1958Pour trier selon plusieurs colonnes, passe une liste, et une liste d’ordres avec ascending. Ici, les titres les plus récents d’abord, puis les mieux notés :
# année de sortie puis note IMDB, tous deux dans l'ordre décroissant
netflix_titles.sort_values(
    ["release_year", "imdb_score"], ascending=[False, False]
)[["title", "release_year", "imdb_score"]].head() title release_year imdb_score
6104 Nanpakal Nerathu Mayakkam 2023 8.8
6113 Black Sunshine Baby 2023 8.5
6120 Rekha 2023 8.4
6129 Thalaikoothal 2023 8.4
6043 Full Swing 2023 8.2Comment fusionner deux DataFrames avec merge ?
Pandas permet de combiner des DataFrames sur une colonne commune avec merge(), join() et concat(). Ici, la colonne id relie les titres à leur générique :
# fusionner les DataFrames sur la base de la colonne "id"
joined_df = pd.merge(netflix_titles, netflix_credits, on="id", how="inner")

print(joined_df.shape)
joined_df[["title", "type", "name", "role"]].head()(81355, 19)
title type name role
0 Rocky MOVIE Sylvester Stallone ACTOR
1 Rocky MOVIE Talia Shire ACTOR
2 Rocky MOVIE Burt Young ACTOR
3 Rocky MOVIE Carl Weathers ACTOR
4 Rocky MOVIE Burgess Meredith ACTORLe résultat contient 81 355 lignes : une par personne et par titre, avec les colonnes des deux tables (19 colonnes). Le paramètre how décide ce qui arrive aux lignes sans correspondance : inner ne garde que les correspondances, left garde toutes les lignes de la table de gauche. Avec indicator=True, Pandas ajoute une colonne qui indique l’origine de chaque ligne :
avec_indicateur = pd.merge(
    netflix_titles, netflix_credits, on="id", how="left", indicator=True
)

sans_generique = avec_indicateur[avec_indicateur["_merge"] == "left_only"]
print(len(sans_generique), "titres sans aucune ligne dans credits")
print(len(avec_indicateur), "lignes avec un left join, contre", len(joined_df), "avec un inner join")349 titres sans aucune ligne dans credits
81704 lignes avec un left join, contre 81355 avec un inner join349 titres n’ont aucune ligne dans le générique : un inner les supprime, un left les conserve avec des valeurs manquantes. Attention aussi à la forme du résultat : un titre apparaît autant de fois qu’il a de personnes au générique.
credits_par_titre = netflix_credits.groupby("id").size()

print(credits_par_titre.describe().round(1))
print(joined_df["id"].nunique(), "titres distincts dans joined_df")count 5788.0
mean 14.1
std 14.5
min 1.0
25% 5.0
50% 10.0
75% 18.0
max 209.0
dtype: float64
5788 titres distincts dans joined_dfUn titre a en médiane 10 personnes au générique, et jusqu’à 209. Si tu calcules une moyenne sur le DataFrame fusionné, les titres avec un grand générique pèsent davantage. Si tu veux une ligne par titre, agrège d’abord le générique avec groupby, puis fusionne. Tu retrouveras ces jointures côté SQL dans mes 30 requêtes SQL expliquées par leurs équivalents Pandas.
Comment appliquer une fonction à une colonne ?
Avec apply() et une fonction lambda, tu appliques une opération à chaque valeur d’une colonne. Ici, on convertit la durée de minutes en heures, dans une nouvelle colonne (plutôt que d’écraser la colonne d’origine) :
# convertir la durée en heures avec apply et lambda
joined_df["runtime_hours"] = joined_df["runtime"].apply(lambda x: x / 60)

# la même opération, vectorisée
runtime_hours_vec = joined_df["runtime"] / 60

print(joined_df["runtime_hours"].equals(runtime_hours_vec))
joined_df[["title", "runtime", "runtime_hours"]].head()True
title runtime runtime_hours
0 Rocky 119 1.983333
1 Rocky 119 1.983333
2 Rocky 119 1.983333
3 Rocky 119 1.983333
4 Rocky 119 1.983333La seconde version, joined_df["runtime"] / 60, donne exactement le même résultat. Quand une opération arithmétique existe, utilise-la directement : elle est vectorisée, donc plus rapide que apply() sur de gros volumes. Je compare les deux dans mon article sur la vectorisation.
Comment visualiser les données avec Pandas et Matplotlib ?
Pandas s’appuie sur Matplotlib pour tracer des graphiques directement depuis un DataFrame ou une Series. Étudions d’abord la distribution du nombre d’acteurs et de réalisateurs par titre :
import matplotlib.pyplot as plt

role_count = joined_df.groupby("id").agg(count_role=("role", "count")).reset_index()

plt.hist(role_count["count_role"], bins=15, color="#2a78d6")
plt.xlabel("Nombre d'acteurs et de réalisateurs")
plt.ylabel("Nombre de titres")
plt.title("Combien de personnes figurent au générique d'un titre ?", loc="left")
plt.show()

print(role_count["count_role"].median(), "personnes au générique pour un titre médian")10.0 personnes au générique pour un titre médian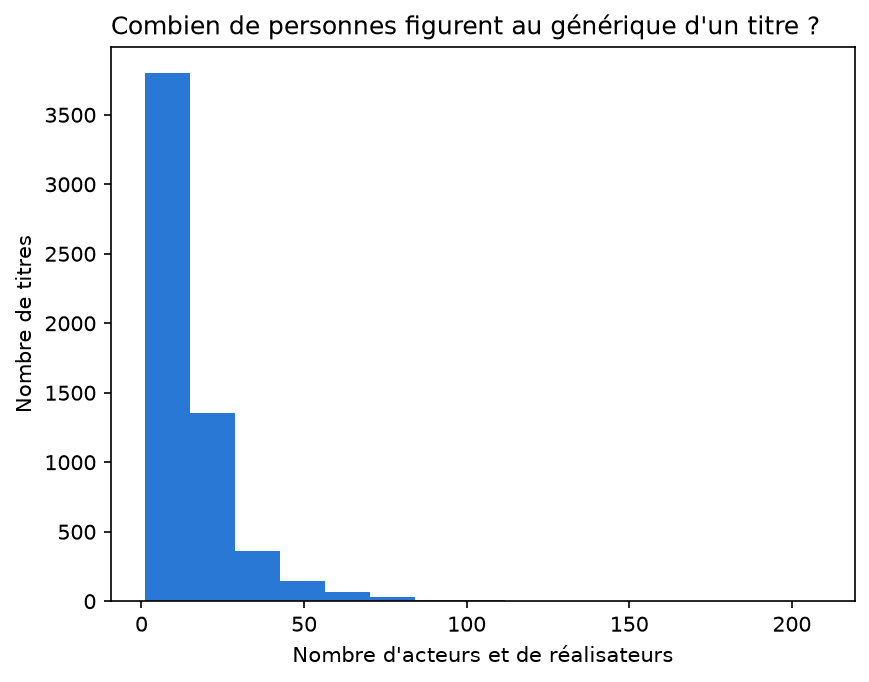
La plupart des titres comptent moins de 30 personnes au générique, avec quelques cas extrêmes au-delà de 100. Autre graphique, avec DataFrame.plot() : le nombre de films et de séries selon leur année de sortie.
par_annee = (
    netflix_titles[netflix_titles["release_year"] >= 2000]
    .groupby(["release_year", "type"])
    .size()
    .unstack("type")
)

ax = par_annee.plot(color={"MOVIE": "#2a78d6", "SHOW": "#eb6834"}, figsize=(8, 4.5))
ax.set_xlabel("Année de sortie")
ax.set_ylabel("Nombre de titres")
ax.set_title("Films et séries au catalogue, selon l'année de sortie", loc="left")
ax.legend(["Films", "Séries"], frameon=False)
ax.spines[["top", "right"]].set_visible(False)
plt.show()

print(par_annee.loc[[2000, 2010, 2020]])type MOVIE SHOW
release_year
2000 5 6
2010 35 18
2020 496 333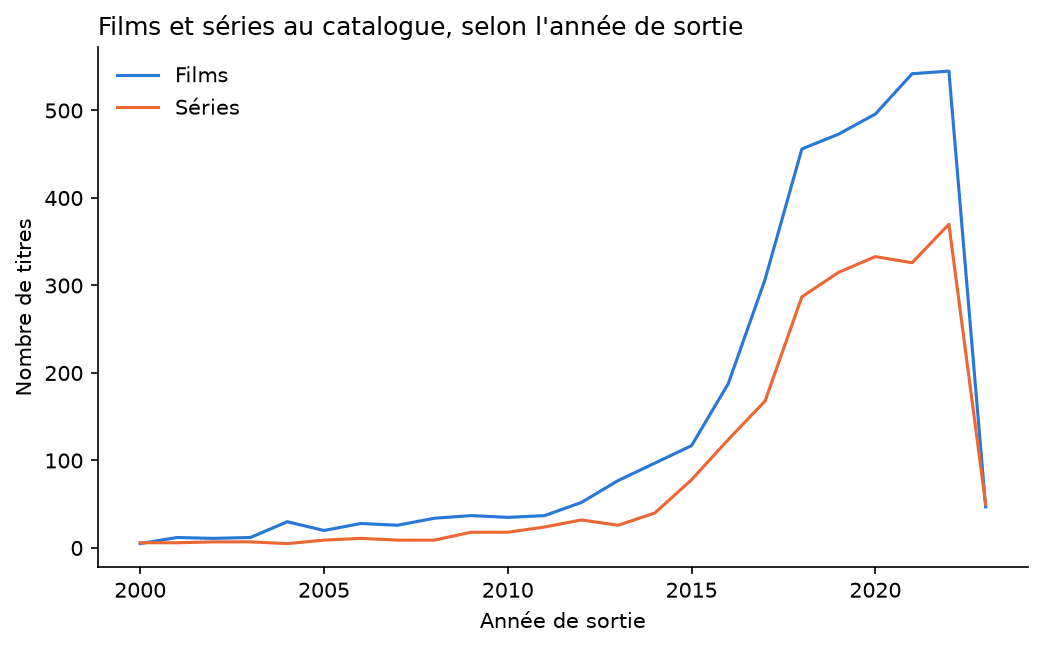
Le catalogue s’est fortement étoffé à partir de 2015 : 496 films et 333 séries sortis en 2020. La chute en 2023 s’explique par les données : l’année est incomplète dans ce jeu de données.
Comment travailler avec des dates dans Pandas ?
Les colonnes de dates sont partout en analyse de données. Pandas les gère avec le type datetime. Ici, on convertit l’année de sortie en date avec pd.to_datetime() et on la définit comme index. On peut alors sélectionner une période avec une simple tranche :
titres_dates = netflix_titles.assign(
    release_date=pd.to_datetime(netflix_titles["release_year"].astype(str), format="%Y")
).set_index("release_date").sort_index()

print(titres_dates.index.dtype)
titres_dates.loc["2018":"2020", ["title", "type"]].head()datetime64[us]
title type
release_date
2018-01-01 FIGHTWORLD SHOW
2018-01-01 AMO SHOW
2018-01-01 Paradox MOVIE
2018-01-01 Drug Lords SHOW
2018-01-01 BuyBust MOVIELes titres de 2018 à 2020 sont maintenant sélectionnés par leur date. Autre outil : resample() regroupe les données par période. Voici le nombre de titres par tranche de 5 ans :
# nombre de titres par période de 5 ans
titres_dates["id"].resample("5YS").count().tail(6)release_date
1995-01-01 60
2000-01-01 101
2005-01-01 201
2010-01-01 438
2015-01-01 2513
2020-01-01 2709
Freq: 5YS-JAN, Name: id, dtype: int64Sur la dernière ligne, 2020-01-01 couvre les années 2020 à 2024 (2 709 titres). Le principe est le même avec des dates quotidiennes. Voici un petit exemple avec 10 jours, pour voir la sélection par tranche de dates et le rééchantillonnage hebdomadaire :
dates = pd.date_range("2023-01-01", periods=10)
df = pd.DataFrame({"A": range(1, 11), "B": range(11, 21)}, index=dates)

print(df.loc["2023-01-03":"2023-01-07"])
print(df.resample("W").mean()) A B
2023-01-03 3 13
2023-01-04 4 14
2023-01-05 5 15
2023-01-06 6 16
2023-01-07 7 17
A B
2023-01-01 1.0 11.0
2023-01-08 5.0 15.0
2023-01-15 9.5 19.5Chaque semaine (qui se termine le dimanche) est résumée par la moyenne des valeurs de ses jours.
Questions fréquentes
Comment lire un fichier CSV avec Pandas ?
Avec pd.read_csv(“fichier.csv”), qui renvoie un DataFrame. Pour un fichier Excel, utilise pd.read_excel(). Après la lecture, vérifie le résultat avec head(), info() et shape.
Quelle est la différence entre loc et iloc ?
loc sélectionne par étiquettes (noms de lignes et de colonnes) et inclut la borne de fin d’une tranche. iloc sélectionne par positions entières et exclut la borne de fin.
Comment filtrer un DataFrame avec plusieurs conditions ?
Combine les conditions avec & (et), | (ou) et ~ (non), en mettant chaque condition entre parenthèses : df[(df[“type”] == “MOVIE”) & (df[“imdb_score“] > 8.5)]. Tu peux aussi écrire df.query(“type == ‘MOVIE’ and imdb_score > 8.5″), qui renvoie le même résultat.
Comment gérer les valeurs manquantes dans Pandas ?
Repère-les avec isna().sum(), remplace-les avec fillna() quand une valeur par défaut a du sens (par exemple 0 saison pour un film), ou supprime les lignes incomplètes avec dropna(subset=[…]). Ne remplace pas une note manquante par 0 : cela fausse les moyennes.
Quelle différence entre inner join et left join dans merge ?
inner ne garde que les lignes qui ont une correspondance dans les deux tables, left garde toutes les lignes de la table de gauche. Sur les données Netflix, l’inner join donne 81 355 lignes et le left join 81 704, car 349 titres n’ont pas de générique.
Comment travailler avec les dates dans Pandas ?
Convertis la colonne avec pd.to_datetime(), définis-la comme index avec set_index(), puis sélectionne une période avec une tranche (df.loc[“2018″:”2020”]) et regroupe par période avec resample().
Conclusion : que retenir de ces concepts clés ?
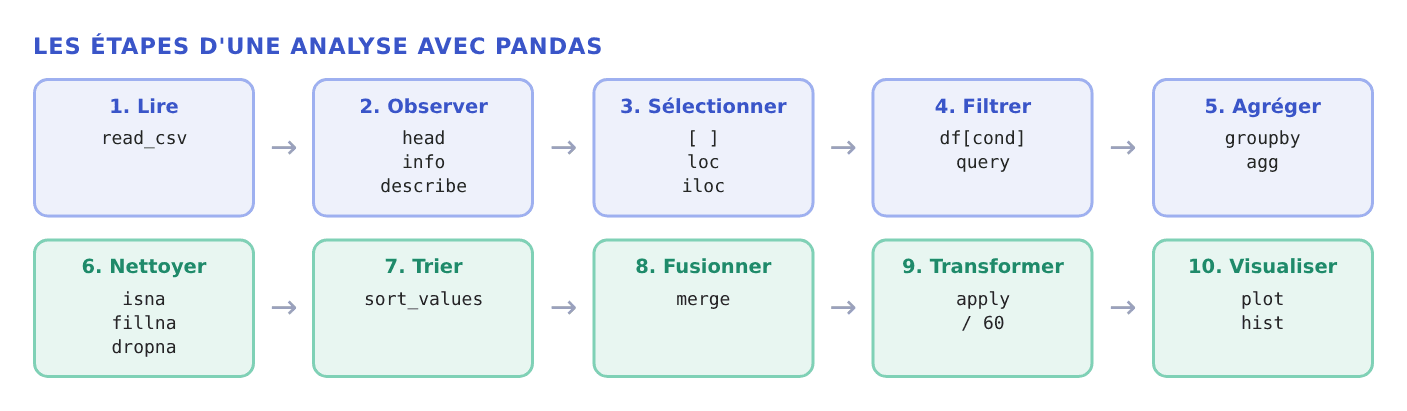
Tu as vu les étapes d’une analyse avec Pandas : importer, lire, observer, sélectionner, filtrer, agréger, nettoyer, trier, fusionner, transformer, visualiser et manipuler des dates. Ces opérations ne sont que la partie visible de l’iceberg, mais les comprendre est essentiel pour travailler avec des données en Python. N’hésite pas à refaire ces exemples sur le jeu de données Netflix, puis sur tes propres fichiers.
Pour aller plus loin avec Pandas et Python, le mieux est de pratiquer. Sur DataXp, tu apprends Python et la data science avec des exercices pratiques à faire directement en ligne.
Pour aller plus loin, voici d’autres articles qui pourraient te plaire :