Le modèle ARIMA avec Python permet de faire des prévisions à partir d’observations passées : ventes, trafic, nombre de passagers, consommation d’énergie… C’est un vrai avantage concurrentiel.
Par exemple, une entreprise qui prévoit mieux les quantités vendues d’un produit optimise ses stocks : moins de trésorerie immobilisée, moins de ruptures et des clients mieux servis.
En Machine Learning et en statistiques, certaines méthodes sont particulièrement adaptées pour prédire une variable en fonction du temps. Dans cet article, tu vas découvrir l’une des plus célèbres : le modèle ARIMA (AutoRegressive Integrated Moving Average, soit « modèle autorégressif intégré à moyenne mobile »).
En bref : le modèle ARIMA (AutoRegressive Integrated Moving Average) prévoit une série temporelle à partir de ses valeurs passées. Il est paramétré par trois entiers (p, d, q) et exige une série stationnaire. Sur le nombre de passagers aériens de 1949 à 1960, la série n’est pas stationnaire (p-value de 0,99), le modèle (2, 1, 1) a l’AIC le plus bas, mais ARIMA ne gère pas la saisonnalité (RMSE d’environ 108). Le modèle SARIMA, lui, ramène l’erreur à environ 43.
Tu peux aussi exécuter tous ces exemples dans ce notebook Google Colab : chaque extrait de code est dans sa propre cellule, prêt à être modifié.
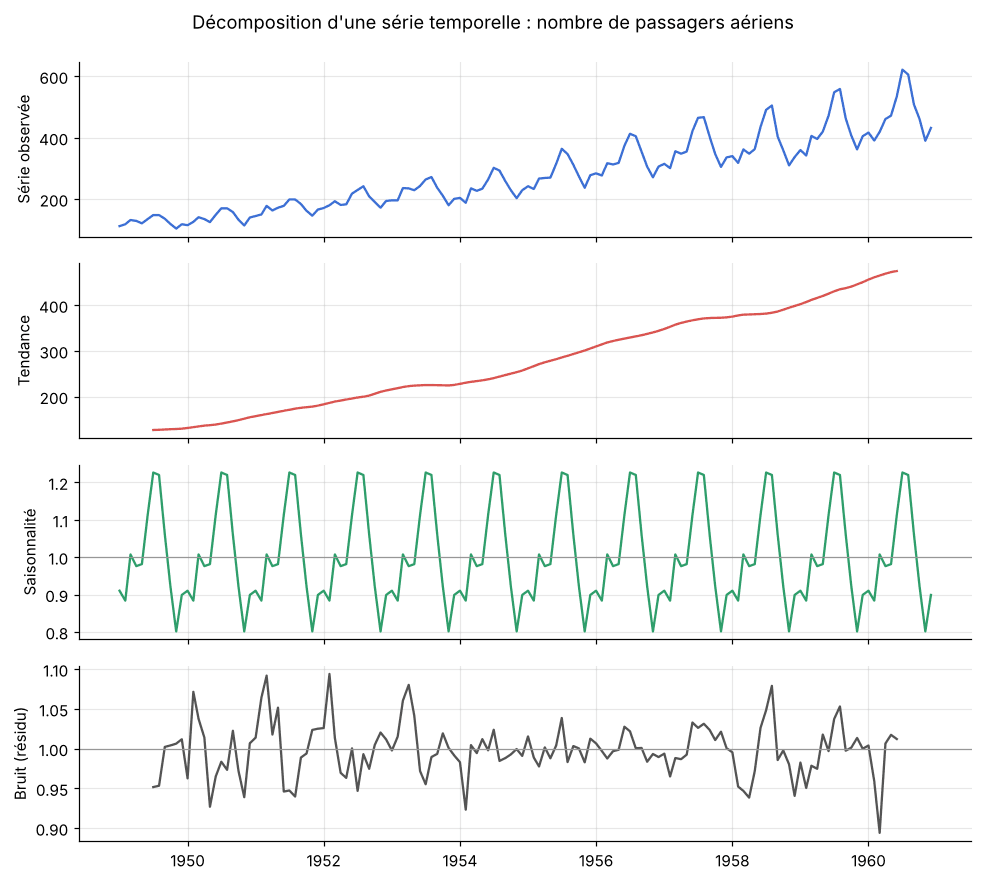
Une série de points de données indexés dans l’ordre chronologique s’appelle une série temporelle (time series). Elle se décompose en 3 composantes :
- Tendance : mouvement de hausse ou de baisse des données sur une longue période (par exemple le prix de l’immobilier) ;
- Saisonnalité : variation qui se répète à intervalles réguliers (par exemple la hausse de la demande de glaces pendant l’été) ;
- Bruit : pics et creux à intervalles aléatoires, que le modèle ne peut pas expliquer.
Avant d’appliquer un modèle statistique à une série temporelle, tu dois t’assurer qu’elle est stationnaire.
Qu’est-ce qu’une série stationnaire ?
Une série est stationnaire si elle respecte trois conditions.
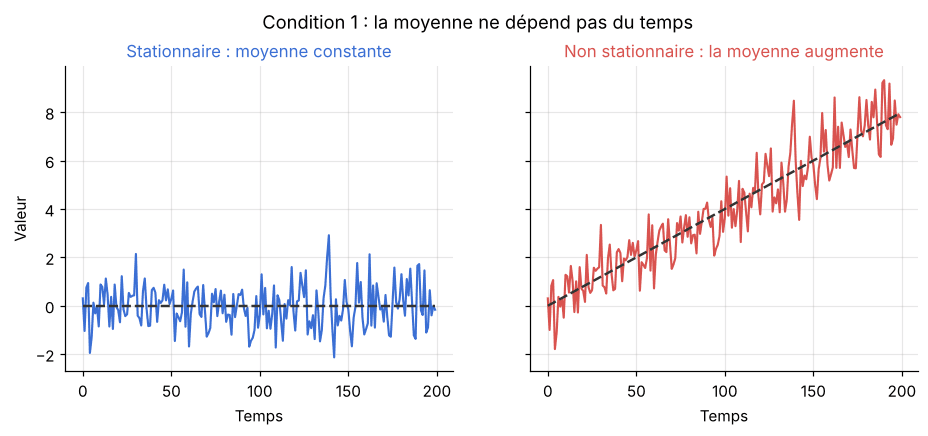
1. La moyenne de la série ne dépend pas du temps. Dans le graphique ci-dessous, la série de gauche (en bleu) est stationnaire. Celle de droite (en rouge) ne l’est pas : sa moyenne augmente avec le temps.
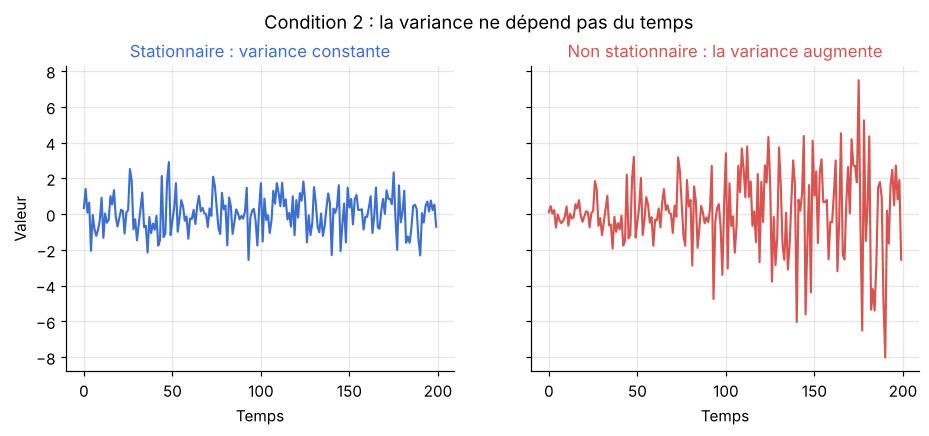
2. La variance de la série ne dépend pas du temps. Ici, la série rouge à droite n’est pas stationnaire : l’amplitude de ses variations (sa variance) augmente au fil du temps.
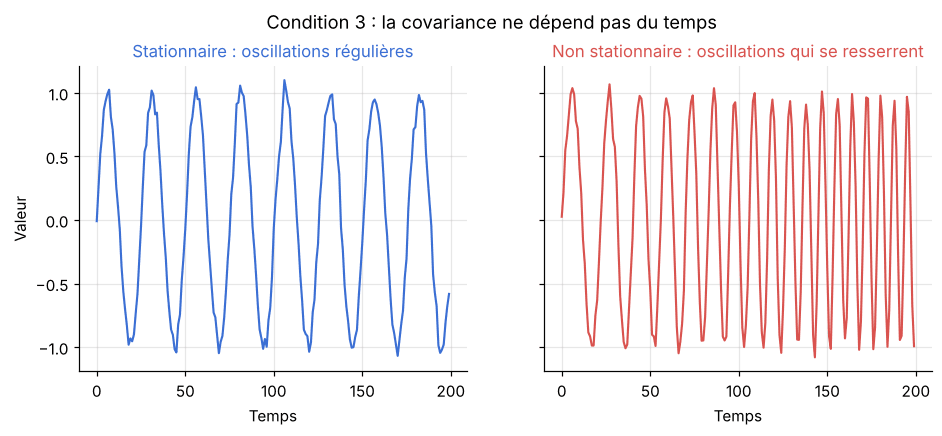
3. La covariance entre le i-ème terme et le (i + m)-ième terme ne dépend pas du temps. Dans la série rouge à droite, les oscillations se resserrent au fil du temps : la covariance dépend donc du temps, et la série n’est pas stationnaire.
Si une série stationnaire a présenté un comportement particulier pendant un intervalle de temps, on peut supposer qu’elle le présentera à nouveau plus tard. C’est pourquoi la plupart des méthodes de modélisation statistique exigent une série stationnaire.
Comment coder un modèle ARIMA avec Python ?
Comment installer les bibliothèques et charger les données ?
La bibliothèque statsmodels propose de nombreux outils pour travailler avec des séries temporelles. Installe-la :
pip install statsmodelsPuis importe les bibliothèques :
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.stattools import adfuller
from statsmodels.tsa.arima.model import ARIMA
from statsmodels.graphics.tsaplots import plot_acf, plot_pacfAttention : si tu trouves du code qui importe statsmodels.tsa.arima_model, il est obsolète. Cet ancien module a été supprimé : utilise statsmodels.tsa.arima.model.
On travaille avec le jeu de données classique du nombre de passagers aériens par mois (en milliers), de janvier 1949 à décembre 1960. C’est le jeu de données flights de seaborn, que j’ai copié sur le GitHub de MonCoachData. Les mois y sont écrits en toutes lettres, d’où le format "%Y%B" dans pd.to_datetime() :
URL = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/modele-arima-avec-python/flights.csv"

donnees = pd.read_csv(URL)
donnees["Month"] = pd.to_datetime(donnees["year"].astype(str) + donnees["month"].astype(str), format="%Y%B")

df = donnees.set_index("Month")[["passengers"]].rename(columns={"passengers": "Passengers"})
df = df.asfreq("MS")

print(df.head())
print(df.shape) Passengers
Month
1949-01-01 112
1949-02-01 118
1949-03-01 132
1949-04-01 129
1949-05-01 121
(144, 1)L’appel à asfreq("MS") indique à Pandas que les dates sont mensuelles (début de mois). statsmodels en a besoin pour dater correctement les prévisions.
Tu travailles avec seaborn et tu préfères charger le jeu de données avec sns.load_dataset("flights") ? Tu peux, mais ce dépôt peut évoluer : le format des mois y a déjà changé une fois. Avec le fichier CSV hébergé ici, tu obtiens toujours le même résultat.
Trace la série pour voir de quoi elle a l’air :
plt.xlabel("Date")
plt.ylabel("Nombre de passagers aériens (en milliers)")
plt.title("Passagers aériens par mois, de 1949 à 1960")
plt.plot(df)
plt.show()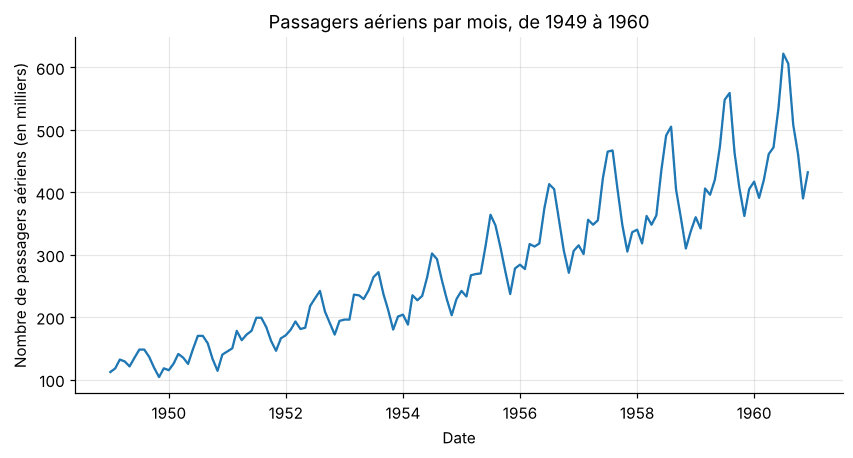
On voit une tendance à la hausse et une saisonnalité qui se répète chaque année, avec des pics de plus en plus grands.
Comment vérifier si une série est stationnaire ?
Comme vu plus haut, avant de construire un modèle, il faut vérifier que la série est stationnaire. Il y a deux façons principales de le faire :
- Les statistiques mobiles : tu traces la moyenne mobile et l’écart-type mobile. La série est stationnaire si ces deux courbes restent constantes dans le temps (à l’œil nu, regarde si elles sont droites et parallèles à l’axe des x) ;
- Le test de Dickey-Fuller augmenté (ADF) : son hypothèse nulle est que la série n’est pas stationnaire. Si la p-value est inférieure à 0,05 (ou si la statistique ADF est inférieure aux valeurs critiques), tu rejettes cette hypothèse : la série est considérée comme stationnaire.
Si tu ne vois pas la différence entre une moyenne et une moyenne mobile : une moyenne mobile sur 12 mois calcule, pour chaque mois, la moyenne des 12 derniers mois. Elle lisse la saisonnalité et laisse apparaître la tendance.
Écrivons une fonction qui exécute les deux vérifications d’un coup :
def verifier_stationnarite(serie):
    # Statistiques mobiles sur 12 mois
    moyenne_mobile = serie.rolling(window=12).mean()
    ecart_type_mobile = serie.rolling(window=12).std()

    plt.plot(serie, color="blue", label="Série")
    plt.plot(moyenne_mobile, color="red", label="Moyenne mobile")
    plt.plot(ecart_type_mobile, color="black", label="Écart-type mobile")
    plt.legend(loc="best")
    plt.title("Moyenne et écart-type mobiles")
    plt.show()

    # Test de Dickey-Fuller augmenté
    resultat = adfuller(serie["Passengers"])
    print(f"Statistique ADF : {resultat[0]:.3f}")
    print(f"p-value : {resultat[1]:.4f}")
    for seuil, valeur in resultat[4].items():
print(f"Valeur critique {seuil} : {valeur:.3f}")Appliquons-la à la série d’origine :
verifier_stationnarite(df)Statistique ADF : 0.815
p-value : 0.9919
Valeur critique 1% : -3.482
Valeur critique 5% : -2.884
Valeur critique 10% : -2.579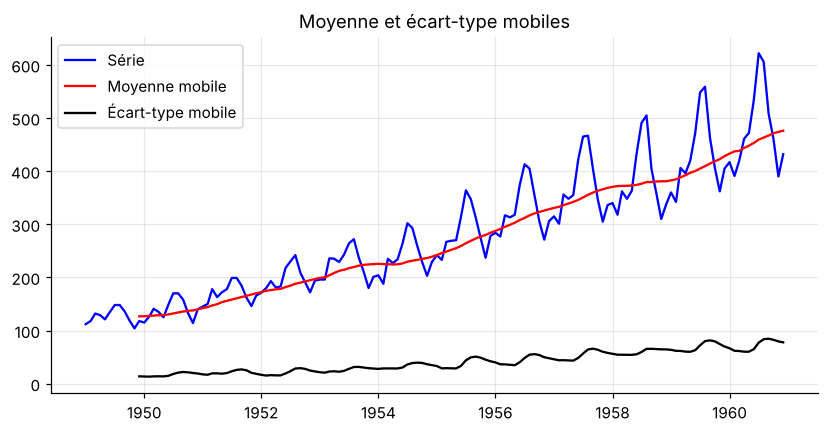
La moyenne mobile et l’écart-type mobile augmentent avec le temps. De plus, la statistique ADF (0,815) est supérieure à toutes les valeurs critiques et la p-value (0,99) est très au-dessus du seuil de 0,05. On ne peut pas rejeter l’hypothèse de non-stationnarité : la série n’est pas stationnaire.
Comment rendre une série stationnaire ?
Il existe plusieurs transformations pour rendre une série stationnaire. La plus simple consiste à prendre le logarithme de la variable : cela réduit la croissance des variations, car l’amplitude des pics augmente ici avec le niveau de la série.
df_log = np.log(df)
verifier_stationnarite(df_log)Statistique ADF : -1.717
p-value : 0.4224
Valeur critique 1% : -3.482
Valeur critique 5% : -2.884
Valeur critique 10% : -2.579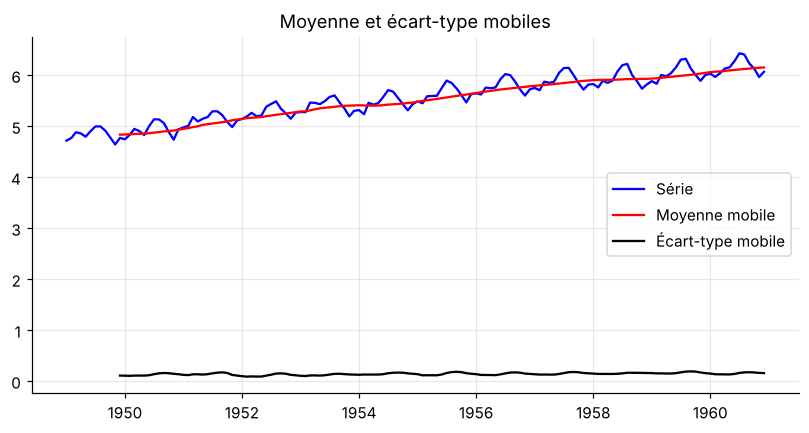
Le logarithme stabilise l’amplitude des variations, mais la tendance est toujours là : la p-value (0,42) est loin de 0,05. Il faut aller plus loin. Essayons trois transformations.
1. Soustraire la moyenne mobile. Chaque valeur est diminuée de la moyenne des 12 derniers mois :
moyenne_mobile = df_log.rolling(window=12).mean()
df_log_moins_moyenne = (df_log - moyenne_mobile).dropna()

verifier_stationnarite(df_log_moins_moyenne)Statistique ADF : -3.163
p-value : 0.0222
Valeur critique 1% : -3.487
Valeur critique 5% : -2.886
Valeur critique 10% : -2.580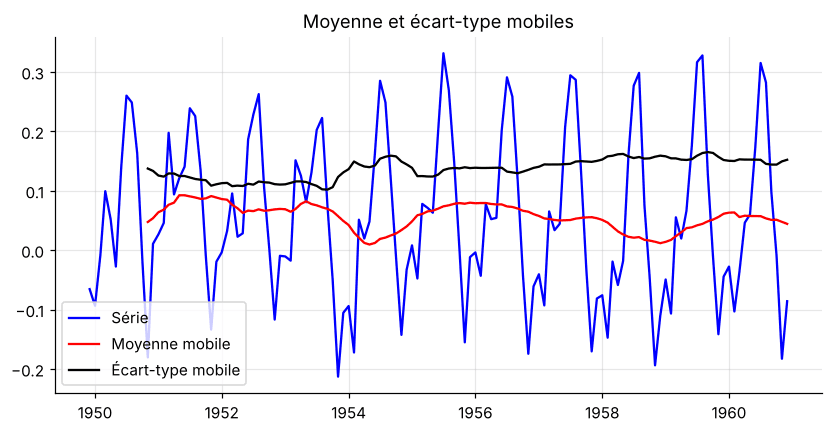
La moyenne mobile et l’écart-type sont maintenant à peu près horizontaux. La p-value (0,022) est inférieure à 0,05 et la statistique ADF (-3,163) est inférieure à la valeur critique à 5 % (-2,886). La série est donc stationnaire au seuil de 5 %.
2. Appliquer une décroissance exponentielle. On soustrait cette fois une moyenne qui donne plus de poids aux valeurs récentes :
moyenne_exponentielle = df_log.ewm(halflife=12).mean()
df_log_exponentielle = (df_log - moyenne_exponentielle).dropna()

verifier_stationnarite(df_log_exponentielle)Statistique ADF : -3.601
p-value : 0.0057
Valeur critique 1% : -3.482
Valeur critique 5% : -2.884
Valeur critique 10% : -2.579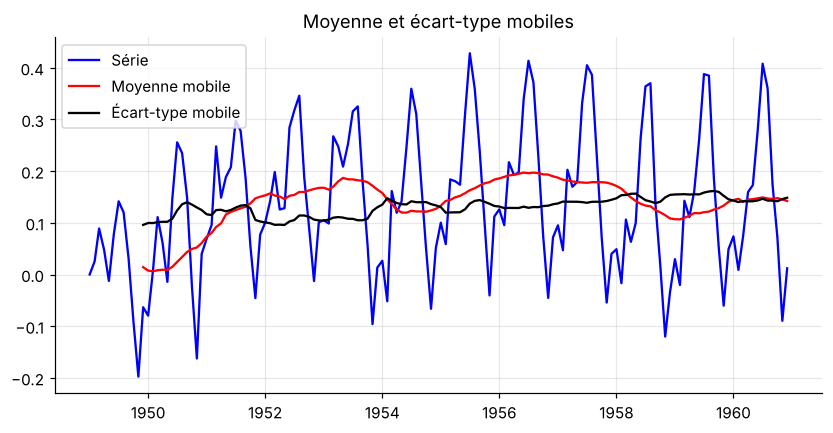
Sur ces données, c’est la meilleure des deux : la p-value (0,0057) est inférieure à 0,01 et la statistique ADF (-3,601) passe sous la valeur critique à 1 % (-3,482). La série est stationnaire même au seuil de 1 %.
3. Appliquer un décalage temporel. On soustrait à chaque point celui qui le précède. C’est ce qu’on appelle une différenciation d’ordre 1 :
df_log_decale = (df_log - df_log.shift()).dropna()

verifier_stationnarite(df_log_decale)Statistique ADF : -2.717
p-value : 0.0711
Valeur critique 1% : -3.483
Valeur critique 5% : -2.884
Valeur critique 10% : -2.579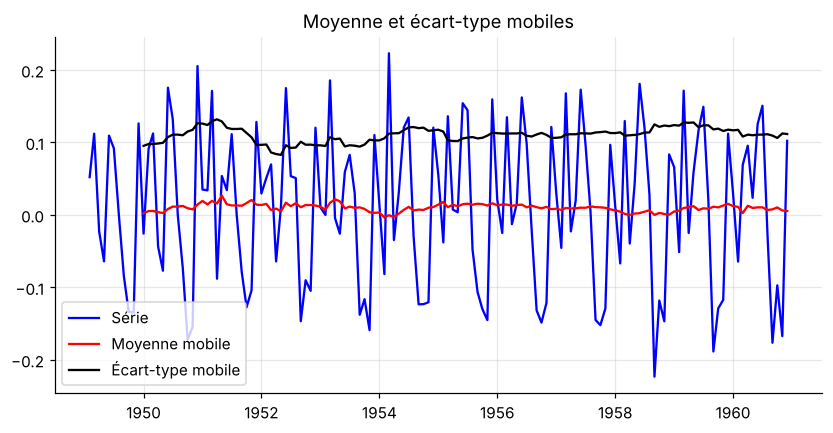
Ici, la p-value (0,071) reste légèrement au-dessus de 0,05 : la série n’est pas tout à fait stationnaire au seuil de 5 %, même si elle l’est bien plus que la série d’origine (p-value de 0,99).
Retiens surtout la différenciation : c’est exactement ce que fait le paramètre d du modèle ARIMA. Tu n’auras donc pas à la faire à la main au moment de construire le modèle.
Que signifient AR, MA et ARMA dans un modèle ARIMA ?
Qu’est-ce qu’un modèle auto-régressif (AR) ?
Les modèles auto-régressifs partent du principe que les valeurs passées influencent la valeur actuelle. On les utilise couramment pour analyser la nature, l’économie et d’autres processus qui varient dans le temps. Tant que cette hypothèse tient, on peut construire une régression linéaire qui prédit la valeur d’aujourd’hui à partir de celles des périodes précédentes.
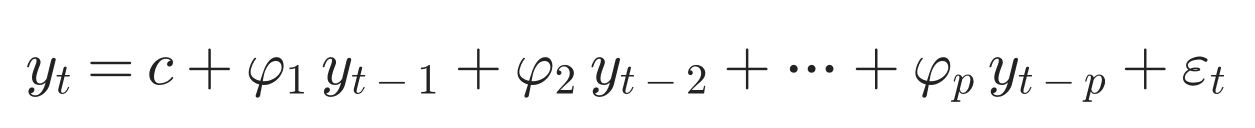
Ici, c est une constante, les (φ1, …, φp) sont les paramètres du modèle et εt est le terme d’erreur (le bruit). L’ordre p du modèle AR correspond au nombre de valeurs passées utilisées dans la formule.
Qu’est-ce qu’un modèle de moyenne mobile (MA) ?
Ce modèle suppose que la valeur actuelle dépend des termes d’erreur des périodes précédentes. La formule peut s’écrire ainsi :
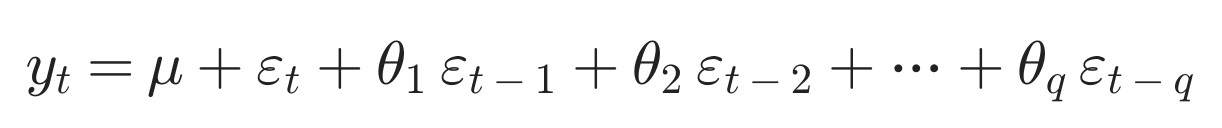
Tu peux aussi rencontrer l’équation écrite avec une somme :
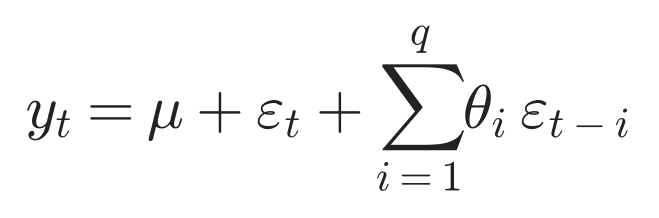
Ici, μ est la moyenne de la série, les (θ1, …, θq) sont les paramètres du modèle et les (εt, εt-1, …, εt-q) sont les termes d’erreur (le bruit). La valeur de q est l’ordre du modèle MA.
Qu’est-ce qu’un modèle ARMA ?
Le modèle ARMA (AutoRegressive Moving Average) combine simplement les deux modèles précédents, AR et MA :
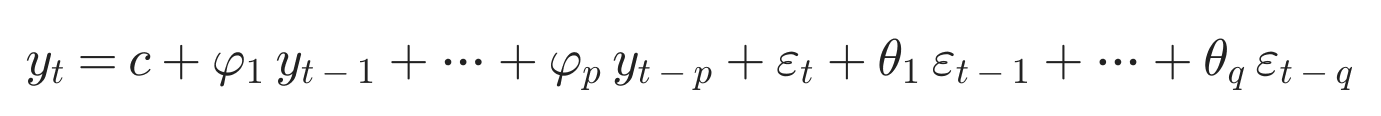
Qu’est-ce qu’un modèle ARIMA ?
Le modèle ARIMA ajoute une différenciation à un modèle ARMA. Différencier consiste à soustraire la valeur précédente à la valeur actuelle : on peut ainsi transformer une série non stationnaire en série stationnaire.
Par exemple, la différenciation d’ordre 1 traite les tendances linéaires avec la transformation zi = yi – yi-1. La différenciation d’ordre 2 traite les tendances quadratiques : c’est une différence d’ordre 1 appliquée à une différence d’ordre 1, soit zi = (yi – yi-1) – (yi-1 – yi-2), et ainsi de suite.
Trois entiers (p, d, q) paramètrent un modèle ARIMA :
- p : le nombre de termes auto-régressifs (ordre AR) ;
- d : le nombre de différenciations (ordre de différenciation) ;
- q : le nombre de termes de moyenne mobile (ordre MA).
À quoi sert la fonction d’auto-corrélation (ACF) ?
L’ACF mesure la corrélation entre la série et elle-même décalée de k périodes (le retard, ou lag). On l’utilise pour choisir l’ordre q du modèle MA.
À quoi sert la fonction d’auto-corrélation partielle (PACF) ?
La PACF mesure la corrélation entre la série et elle-même décalée de k périodes, une fois retirée l’influence des retards intermédiaires. On l’utilise pour choisir l’ordre p du modèle AR.
Traçons l’ACF et la PACF de la série différenciée :
fig, axes = plt.subplots(1, 2, figsize=(12, 4))
plot_acf(df_log_decale["Passengers"], lags=24, ax=axes[0], title="ACF")
plot_pacf(df_log_decale["Passengers"], lags=24, ax=axes[1], title="PACF")
plt.show()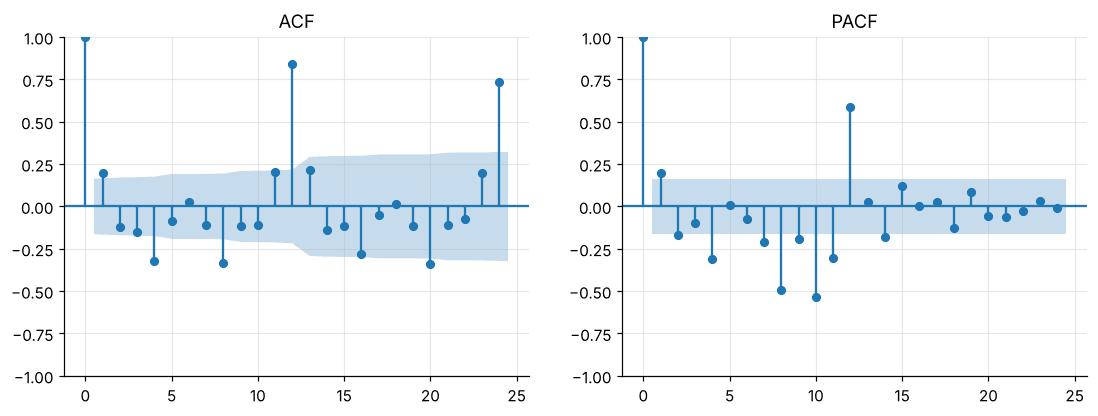
Chaque barre verticale représente la corrélation pour un retard donné. La zone bleutée est le seuil de signification : seules les barres qui la dépassent sont considérées comme significatives.
PACF: les retards 1 et 2 dépassent le seuil. On retient donc un modèle AR d’ordre 2.ACF: le retard 1 dépasse le seuil. On retient donc un modèle MA d’ordre 1.
Regarde aussi le retard 12 sur l’ACF : la corrélation y est très forte (environ 0,84). C’est la signature de la saisonnalité annuelle de nos données. Garde cette observation en tête, on y revient à la fin de l’article.
Comment ajuster un modèle ARIMA avec Python ?
D’après l’ACF et la PACF, on crée un modèle ARIMA avec un AR d’ordre 2, une différenciation d’ordre 1 et un MA d’ordre 1. On l’ajuste sur le logarithme de la série. Comme ARIMA gère lui-même la différenciation, on lui donne la série avant différenciation :
modele = ARIMA(df_log, order=(2, 1, 1))
resultats = modele.fit()

print(resultats.summary().tables[1])==============================================================================
coef std err z P>|z| [0.025 0.975]
------------------------------------------------------------------------------
ar.L1 0.9792 0.100 9.839 0.000 0.784 1.174
ar.L2 -0.3740 0.118 -3.178 0.001 -0.605 -0.143
ma.L1 -0.8303 0.102 -8.118 0.000 -1.031 -0.630
sigma2 0.0095 0.002 6.134 0.000 0.006 0.013
==============================================================================Ce tableau donne les coefficients estimés pour chaque terme AR et MA. Pour choisir entre plusieurs ordres, tu peux comparer leur critère AIC : plus il est bas, meilleur est le compromis entre précision et simplicité.
for ordre in [(1, 1, 1), (2, 1, 1), (2, 1, 2)]:
    aic = ARIMA(df_log, order=ordre).fit().aic
print(ordre, round(aic, 1))(1, 1, 1) -242.6
(2, 1, 1) -251.5
(2, 1, 2) -247.8Le modèle (2, 1, 1), celui que suggèrent l’ACF et la PACF, a bien l’AIC le plus bas.
Comment faire des prévisions avec ARIMA ?
Un bon modèle de prévision se juge sur des données qu’il n’a jamais vues. On le réentraîne donc sur les 10 premières années seulement, puis on lui demande de prévoir les 24 derniers mois, qu’on compare aux vraies valeurs.
Comme le modèle travaille sur le logarithme, on revient à l’échelle d’origine avec np.exp() :
train = df_log.iloc[:-24]
test = df["Passengers"].iloc[-24:]

modele_arima = ARIMA(train, order=(2, 1, 1)).fit()
prevision = modele_arima.get_forecast(steps=24)

pred_arima = np.exp(prevision.predicted_mean)
ic = np.exp(prevision.conf_int())

rmse_arima = np.sqrt(((pred_arima - test) ** 2).mean())
print(f"RMSE ARIMA : {rmse_arima:.1f}")RMSE ARIMA : 107.8La RMSE (root mean squared error) mesure l’erreur moyenne des prévisions, ici en milliers de passagers. Traçons le résultat :
plt.plot(df.loc["1957":, "Passengers"], color="blue", label="Réel")
plt.plot(pred_arima, color="red", label="Prévision ARIMA (2, 1, 1)")
plt.fill_between(ic.index, ic.iloc[:, 0], ic.iloc[:, 1], color="red", alpha=0.15)
plt.legend(loc="upper left")
plt.title("Prévision ARIMA sur les 24 derniers mois")
plt.show()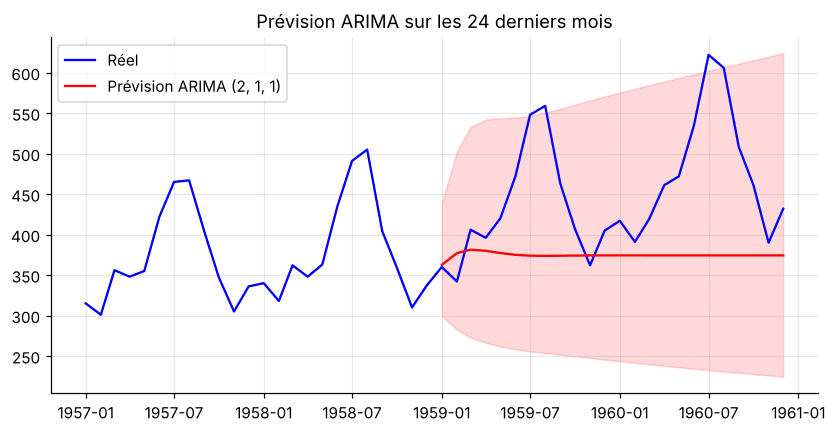
Le résultat est décevant : le modèle prévoit un niveau quasi constant et ne reproduit pas du tout les pics et les creux de chaque année. L’erreur est importante (RMSE d’environ 108, pour des valeurs réelles qui oscillent entre 340 et 620).
Et la saisonnalité ? Passer au modèle SARIMA
C’est la limite du modèle ARIMA : il ne gère pas la saisonnalité. Le pic de corrélation au retard 12 que tu as vu dans l’ACF l’annonçait déjà.
La solution s’appelle SARIMA (Seasonal ARIMA). Il ajoute un second jeu de paramètres (P, D, Q, s) qui s’appliquent à la saisonnalité, où s est la longueur du cycle : 12 pour des données mensuelles avec un cycle annuel.
Avec statsmodels, il suffit d’ajouter le paramètre seasonal_order. On utilise ici la configuration classique pour ce jeu de données, (0, 1, 1) × (0, 1, 1, 12) :
modele_sarima = ARIMA(train, order=(0, 1, 1), seasonal_order=(0, 1, 1, 12)).fit()
pred_sarima = np.exp(modele_sarima.get_forecast(steps=24).predicted_mean)

rmse_sarima = np.sqrt(((pred_sarima - test) ** 2).mean())
print(f"RMSE SARIMA : {rmse_sarima:.1f}")RMSE SARIMA : 43.2plt.plot(df.loc["1957":, "Passengers"], color="blue", label="Réel")
plt.plot(pred_arima, color="red", label="ARIMA (2, 1, 1)")
plt.plot(pred_sarima, color="green", label="SARIMA (0, 1, 1) × (0, 1, 1, 12)")
plt.legend(loc="upper left")
plt.title("ARIMA et SARIMA sur les 24 derniers mois")
plt.show()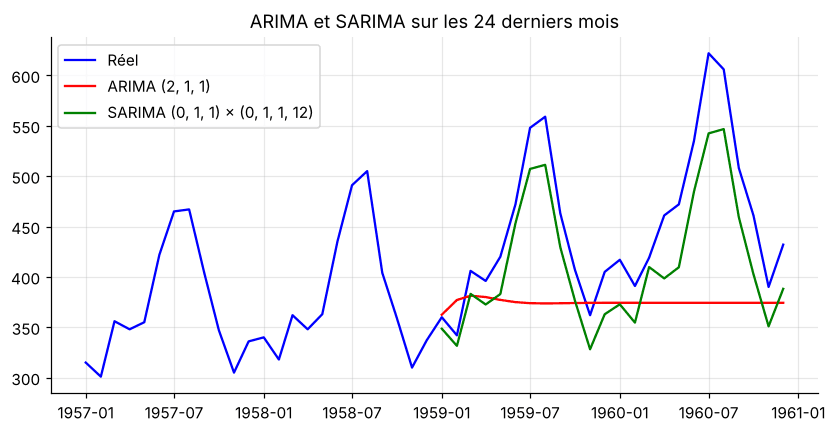
L’erreur passe d’environ 108 à 43 : SARIMA reproduit les pics d’été et les creux d’hiver, même s’il sous-estime un peu les pics. C’est la bonne approche pour une série qui présente une saisonnalité marquée.
Une fois le modèle validé, tu le réentraînes sur toute la série pour prévoir le futur. Voici les prévisions des 12 mois de 1961 :
modele_final = ARIMA(df_log, order=(0, 1, 1), seasonal_order=(0, 1, 1, 12)).fit()
futur = np.exp(modele_final.get_forecast(steps=12).predicted_mean)

print(futur.round().astype(int))1961-01-01 450
1961-02-01 426
1961-03-01 479
1961-04-01 492
1961-05-01 509
1961-06-01 583
1961-07-01 670
1961-08-01 667
1961-09-01 558
1961-10-01 497
1961-11-01 430
1961-12-01 477
Freq: MS, Name: predicted_mean, dtype: int64Questions fréquentes sur le modèle ARIMA
Qu’est-ce qu’une série stationnaire et pourquoi est-ce nécessaire pour ARIMA ?
Une série est stationnaire si sa moyenne, sa variance et la covariance entre ses termes ne dépendent pas du temps. La plupart des méthodes de modélisation statistique l’exigent : si une série stationnaire a eu un comportement particulier pendant un intervalle, on peut supposer qu’elle le présentera à nouveau plus tard.
Comment vérifier si une série temporelle est stationnaire ?
Avec deux outils : les statistiques mobiles (la moyenne mobile et l’écart-type mobile doivent rester constants dans le temps) et le test de Dickey-Fuller augmenté (ADF). Si la p-value du test ADF est inférieure à 0,05, tu rejettes l’hypothèse de non-stationnarité et la série est considérée comme stationnaire.
Que signifient les paramètres (p, d, q) d’un modèle ARIMA ?
p est le nombre de termes auto-régressifs (ordre AR), d le nombre de différenciations et q le nombre de termes de moyenne mobile (ordre MA). On choisit p avec la PACF et q avec l’ACF de la série différenciée, puis on compare les modèles avec leur critère AIC : plus il est bas, mieux c’est.
Pourquoi ARIMA prévoit-il mal une série saisonnière ?
Parce qu’il ne gère pas la saisonnalité. Sur le nombre de passagers aériens, il prévoit un niveau quasi constant et ne reproduit pas les pics annuels (RMSE d’environ 108). Le modèle SARIMA ajoute des paramètres saisonniers (P, D, Q, s) et ramène l’erreur à environ 43.
Comment évaluer les prévisions d’un modèle ARIMA ?
Sur des données que le modèle n’a jamais vues : on le réentraîne sur les premières années seulement (ici les 10 premières), on lui demande de prévoir les derniers mois (ici 24), puis on compare aux vraies valeurs avec la RMSE (root mean squared error), qui mesure l’erreur moyenne des prévisions.
Conclusion
Tu sais maintenant utiliser le modèle ARIMA avec Python : vérifier la stationnarité, choisir les ordres (p, d, q) avec l’ACF et la PACF, ajuster le modèle avec statsmodels, puis évaluer ses prévisions sur des données de test. Tu as aussi vu sa limite principale, la saisonnalité, et comment la dépasser avec SARIMA.
Pour aller plus loin, découvre les méthodes de séries temporelles avec Pandas, ou une approche très différente avec Prophet de Meta.
Pandas et Matplotlib sont la base de toute analyse de série temporelle. Dates en index, moyennes mobiles, graphiques : pour pratiquer ces réflexes sur des jeux de données réels, le cours Analyse et visualisation de données de DataXp propose 3 projets guidés. Les 3 premiers chapitres sont gratuits.
Merci pour cet article détaillé sur le modèle ARIMA ! J’ai trouvé les explications claires et les exemples très utiles pour mieux comprendre son application dans l’analyse des séries temporelles. J’attends avec impatience d’autres articles sur les techniques d’analyse avancées.