Pour résumer un tableau de données, la question revient toujours : combien en moyenne, en tout, au maximum, par catégorie ? La fonction groupby() de Pandas répond à cette question. Elle fait partie des opérations les plus utilisées en analyse de données, et on la retrouve dans presque tous les projets.
Dans cet article, je te présente 10 étapes pour la maîtriser, de la moyenne par groupe jusqu’aux valeurs manquantes. Chaque étape s’appuie sur la précédente, et tout le code a été exécuté avec les vraies sorties affichées.
Article mis à jour en novembre 2026 : j’ai vérifié tout le code avec Pandas 3. Je précise ce qui change avec cette version (le type str des colonnes de texte, l’erreur de mean() sur du texte), j’ai corrigé l’étape 9 (la valeur manquante n’est plus créée avec iloc) et j’ai ajouté une section sur size() et count(), transform() et filter().
En bref : groupby() sépare un DataFrame en groupes selon les valeurs d’une ou plusieurs colonnes, applique un calcul à chaque groupe, puis combine les résultats. Retiens 4 réflexes : nomme tes agrégations avec agg(nom=("colonne", "fonction")), ajoute as_index=False pour garder les groupes en colonnes, passe les colonnes de groupe dans une liste, et utilise dropna=False pour ne pas perdre les lignes dont la clé est manquante.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : il n’y a aucun fichier à télécharger.
À quoi sert la fonction groupby() de Pandas ?
La fonction groupby regroupe les lignes d’un DataFrame selon les valeurs distinctes d’une colonne (ou de plusieurs colonnes). Une fois les groupes formés, tu appliques une fonction d’agrégation (moyenne, somme, médiane, etc.) à chacun d’eux.
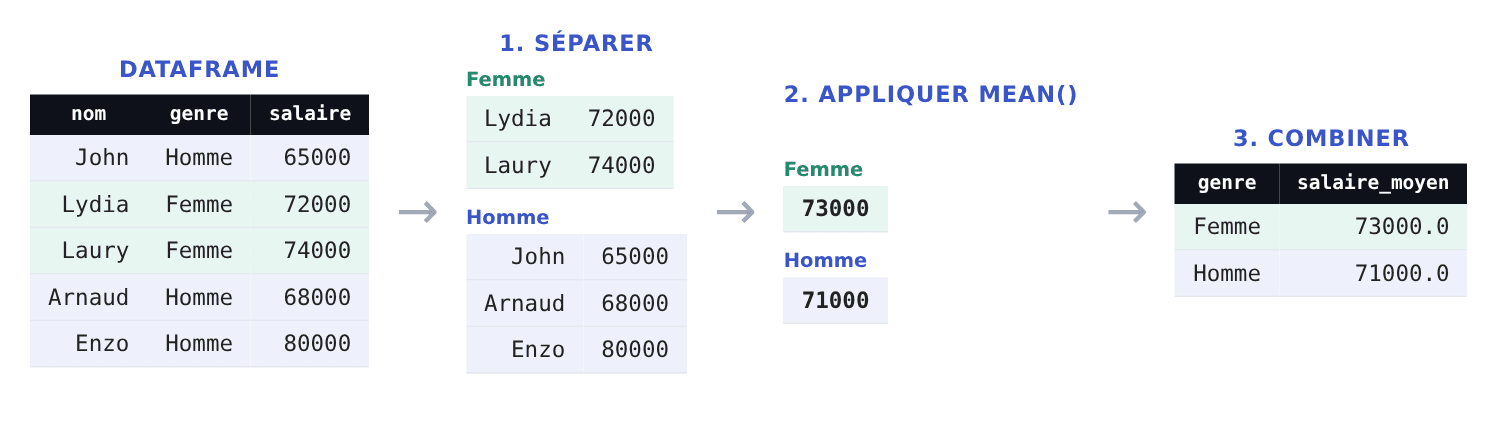
Prenons des données de salaires. Pour calculer le salaire moyen des hommes et celui des femmes, on regroupe les lignes selon la colonne genre, puis on applique la moyenne à la colonne salaire. Pandas suit toujours le même schéma en 3 temps : séparer, appliquer, combiner.
Créons un DataFrame avec des données inventées, qui servira pour toutes les étapes :
import pandas as pd

df = pd.DataFrame({
    "nom": ["John", "Lydia", "Laury", "Arnaud", "Enzo"],
    "genre": ["Homme", "Femme", "Femme", "Homme", "Homme"],
    "taille": [182, 166, 170, 178, 172],
    "education": ["Master", "Master", "Licence", "Licence", "Master"],
    "salaire": [65000, 72000, 74000, 68000, 80000],
})

df nom genre taille education salaire
0 John Homme 182 Master 65000
1 Lydia Femme 166 Master 72000
2 Laury Femme 170 Licence 74000
3 Arnaud Homme 178 Licence 68000
4 Enzo Homme 172 Master 80000Le test a été fait avec Pandas 3. Voici ta version, pour t’assurer que tu obtiens les mêmes résultats :
print(pd.__version__)3.1.1Comment calculer une moyenne par groupe ?
Étape 1 : comment appliquer une fonction à tout le DataFrame ?
Le cas le plus simple : on crée les groupes selon le genre et on applique mean().
df.groupby("genre").mean(numeric_only=True) taille salaire
genre
Femme 168.000000 73000.0
Homme 177.333333 71000.0Comme on ne précise aucune colonne, Pandas calcule la moyenne de chaque colonne numérique. Le paramètre numeric_only=True est ici indispensable : sans lui, Pandas essaie de calculer la moyenne des colonnes de texte nom et education, et renvoie une erreur :
try:
    df.groupby("genre").mean()
except TypeError as erreur:
print(f"{type(erreur).__name__} : {erreur}")TypeError : dtype 'str' does not support operation 'mean'Cette erreur est le signe qu’il vaut mieux, de toute façon, choisir explicitement les colonnes qui t’intéressent. C’est l’étape suivante.
Étape 2 : comment calculer sur une seule colonne ?
Pour n’agréger qu’une colonne, on peut d’abord sélectionner les colonnes utiles, avant d’appeler groupby() :
df[["genre", "salaire"]].groupby("genre").mean() salaire
genre
Femme 73000.0
Homme 71000.0On peut aussi appeler groupby() d’abord, puis sélectionner la colonne entre crochets. C’est souvent plus lisible, mais le résultat est alors une série (une seule colonne, sans titre de colonne) et non un DataFrame :
df.groupby("genre")["salaire"].mean()genre
Femme 73000.0
Homme 71000.0
Name: salaire, dtype: float64Comment donner un nom aux colonnes calculées ?
Étape 3 : comment utiliser NamedAgg ?
Un jeu de données réel contient souvent plusieurs colonnes, et on veut agréger plusieurs d’entre elles de façons différentes. Filtrer les colonnes une par une devient fastidieux. Une meilleure méthode utilise pd.NamedAgg dans la méthode agg() :
df.groupby("genre").agg(
    salaire_moyen=pd.NamedAgg(column="salaire", aggfunc="mean")
) salaire_moyen
genre
Femme 73000.0
Homme 71000.0Tu précises la colonne et la fonction d’agrégation. Un autre avantage : tu choisis le nom de la colonne résultat (salaire_moyen), bien plus clair que le nom d’origine.
Étape 4 : quelle est la syntaxe la plus courte ?
Il existe une écriture plus compacte : un simple tuple (colonne, fonction). C’est celle que j’utilise le plus souvent, parce qu’elle demande le moins de frappe et donne le même résultat.
df.groupby("genre").agg(salaire_moyen=("salaire", "mean")) salaire_moyen
genre
Femme 73000.0
Homme 71000.0Comment calculer plusieurs agrégations à la fois ?
Étape 5 : comment combiner plusieurs agrégations ?
Une fois les groupes formés, tu calcules autant d’agrégations que nécessaire. Ce code donne le salaire médian et la taille moyenne de chaque genre :
df.groupby("genre").agg(
    salaire_median=("salaire", "median"),
    taille_moyenne=("taille", "mean"),
) salaire_median taille_moyenne
genre
Femme 73000.0 168.000000
Homme 68000.0 177.333333Étape 6 : comment garder les groupes en colonne avec as_index=False ?
Jusqu’ici, les groupes servent d’index au DataFrame résultat. Il est souvent préférable de les avoir dans une colonne, pour pouvoir les filtrer, les fusionner ou les tracer. Le paramètre as_index=False le permet :
df.groupby("genre", as_index=False).agg(
    salaire_median=("salaire", "median"),
    taille_moyenne=("taille", "mean"),
) genre salaire_median taille_moyenne
0 Femme 73000.0 168.000000
1 Homme 68000.0 177.333333Cette écriture est préférable, surtout quand il y a plusieurs groupes. Tu peux aussi appeler reset_index() sur le résultat pour obtenir le même effet.
Étape 7 : comment regrouper selon plusieurs colonnes ?
Comme on peut agréger plusieurs colonnes, on peut former des groupes à partir de plusieurs colonnes. Avec deux colonnes, groupby() crée un groupe pour chaque combinaison de valeurs, ici les 4 couples genre et niveau d’études :
df.groupby(["genre", "education"], as_index=False).agg(
    salaire_median=("salaire", "median"),
    taille_moyenne=("taille", "mean"),
) genre education salaire_median taille_moyenne
0 Femme Licence 74000.0 170.0
1 Femme Master 72000.0 166.0
2 Homme Licence 68000.0 178.0
3 Homme Master 72500.0 177.0Transmets toujours les noms de colonnes dans une liste. Si tu écris les deux noms séparés par une virgule, Pandas interprète le second comme un niveau d’index et renvoie une erreur :
try:
df.groupby("genre", "education").mean(numeric_only=True)
except Exception as erreur:
print(f"{type(erreur).__name__} : {erreur}")ValueError : level name education is not the name of the indexComment trier les résultats d’un groupby ?
Étape 8 : comment trier les groupes selon une valeur agrégée ?
Avec 4 groupes, ce n’est pas indispensable. Mais imagine 100 groupes, dont tu cherches les 3 meilleurs en salaire médian : il faut trier les résultats. On enchaîne simplement sort_values() :
df.groupby(["genre", "education"], as_index=False).agg(
    salaire_median=("salaire", "median"),
    taille_moyenne=("taille", "mean"),
).sort_values(by="salaire_median", ascending=False) genre education salaire_median taille_moyenne
0 Femme Licence 74000.0 170.0
3 Homme Master 72500.0 177.0
1 Femme Master 72000.0 166.0
2 Homme Licence 68000.0 178.0Par défaut, le tri est croissant : le paramètre ascending=False l’inverse. Remarque que l’index d’origine (0, 3, 1, 2) est conservé, et qu’il n’a plus de sens après le tri : ajoute reset_index(drop=True) si tu veux une numérotation propre. Pour récupérer seulement le meilleur groupe, nlargest() est plus direct :
(df.groupby("education", as_index=False)
    .agg(salaire_moyen=("salaire", "mean"))
.nlargest(1, "salaire_moyen")) education salaire_moyen
1 Master 72333.333333Le niveau « Master » a le salaire moyen le plus élevé (72 333 environ).
Que fait groupby() des valeurs manquantes ?
Étape 9 : comment inclure les valeurs manquantes avec dropna=False ?
Notre DataFrame ne contient aucune valeur manquante, mais les données réelles en contiennent presque toujours. Si la colonne de regroupement contient une valeur manquante, Pandas supprime par défaut cette ligne du résultat. Pour le voir, on remplace le genre d’Enzo par une valeur manquante, dans une copie du DataFrame :
df_na = df.copy()
df_na.loc[4, "genre"] = None
df_na nom genre taille education salaire
0 John Homme 182 Master 65000
1 Lydia Femme 166 Master 72000
2 Laury Femme 170 Licence 74000
3 Arnaud Homme 178 Licence 68000
4 Enzo NaN 172 Master 80000Maintenant, on recalcule le salaire moyen par genre :
df_na.groupby("genre").agg(salaire_moyen=("salaire", "mean")) salaire_moyen
genre
Femme 73000.0
Homme 66500.0La valeur manquante est ignorée : Enzo (80 000) a disparu, et la moyenne des hommes passe à 66 500, calculée sur John et Arnaud seulement. C’est discret, et on peut ne jamais s’en apercevoir. Dans de nombreux cas, il faut garder ces lignes. Avec dropna=False, elles forment un groupe à part :
df_na.groupby("genre", dropna=False).agg(salaire_moyen=("salaire", "mean")) salaire_moyen
genre
Femme 73000.0
Homme 66500.0
NaN 80000.0Étape 10 : comment passer une liste d’agrégations ?
À l’étape 5, on a calculé plusieurs agrégations avec des arguments nommés. Une autre méthode consiste à passer une liste de fonctions à agg(). Comme nom et education sont des colonnes de texte, on sélectionne d’abord les colonnes numériques taille et salaire :
df_na.groupby("genre", dropna=False)[["taille", "salaire"]].agg(["mean", "count"]) taille salaire
mean count mean count
genre
Femme 168.0 2 73000.0 2
Homme 180.0 2 66500.0 2
NaN 172.0 1 80000.0 1Le résultat a des colonnes à deux niveaux (la colonne d’origine, puis la fonction). Pour les aplatir en noms simples, assemble les deux niveaux :
resume = df_na.groupby("genre", dropna=False)[["taille", "salaire"]].agg(["mean", "count"])
resume.columns = ["_".join(col) for col in resume.columns]
resume taille_mean taille_count salaire_mean salaire_count
genre
Femme 168.0 2 73000.0 2
Homme 180.0 2 66500.0 2
NaN 172.0 1 80000.0 1Quelle est la différence entre size() et count() ?
Ces deux méthodes comptent des lignes, mais pas de la même façon : size() compte toutes les lignes du groupe, count() ignore les valeurs manquantes. Pour le voir, on supprime le salaire de Lydia :
df_nan = df.copy()
df_nan.loc[1, "salaire"] = None

df_nan.groupby("genre").agg(
    nb_lignes=("salaire", "size"),
    nb_salaires=("salaire", "count"),
) nb_lignes nb_salaires
genre
Femme 2 1
Homme 3 3Le groupe « Femme » contient 2 lignes, mais seulement 1 salaire renseigné. Utilise count() pour savoir combien de valeurs servent réellement à un calcul de moyenne.
Comment ajouter une colonne calculée par groupe avec transform() ?
Une agrégation réduit chaque groupe à une valeur. Avec transform(), le résultat garde la même taille que le DataFrame d’origine : chaque ligne reçoit la valeur de son groupe. C’est idéal pour comparer chaque ligne à la moyenne de son groupe :
df["salaire_moyen_groupe"] = df.groupby("genre")["salaire"].transform("mean")
df["ecart"] = df["salaire"] - df["salaire_moyen_groupe"]

df[["nom", "genre", "salaire", "salaire_moyen_groupe", "ecart"]] nom genre salaire salaire_moyen_groupe ecart
0 John Homme 65000 71000.0 -6000.0
1 Lydia Femme 72000 73000.0 -1000.0
2 Laury Femme 74000 73000.0 1000.0
3 Arnaud Homme 68000 71000.0 -3000.0
4 Enzo Homme 80000 71000.0 9000.0John gagne 6 000 de moins que la moyenne des hommes (71 000). Cette technique évite de refaire une jointure entre le DataFrame et le résultat de groupby().
Comment garder seulement certains groupes avec filter() ?
La méthode filter() garde ou supprime des groupes entiers selon une condition calculée sur le groupe. Ici, on garde les niveaux d’études dont le salaire moyen dépasse 72 000 :
df.groupby("education").filter(lambda g: g["salaire"].mean() > 72000)[["nom", "education", "salaire"]] nom education salaire
0 John Master 65000
1 Lydia Master 72000
4 Enzo Master 80000Seul le niveau « Master » (moyenne d’environ 72 333) passe le test, donc on récupère ses 3 lignes. C’est l’équivalent de HAVING en SQL, mais le résultat contient les lignes d’origine et non des groupes agrégés. Tu retrouveras cette correspondance dans mon article sur les requêtes SQL et leur équivalent Pandas.
Comment parcourir les groupes un par un ?
L’objet renvoyé par groupby() est un itérable : une boucle for donne, pour chaque groupe, sa clé et le sous-DataFrame correspondant. C’est pratique pour inspecter les groupes ou appliquer un traitement spécifique à chacun :
for genre, groupe in df.groupby("genre"):
print(genre, "->", groupe["nom"].tolist())Femme -> ['Lydia', 'Laury']
Homme -> ['John', 'Arnaud', 'Enzo']Pour obtenir d’un coup un résumé statistique de chaque groupe (effectif, moyenne, écart type, quartiles), describe() fait le travail :
df.groupby("genre")["salaire"].describe() count mean std min 25% 50% 75% max
genre
Femme 2.0 73000.0 1414.213562 72000.0 72500.0 73000.0 73500.0 74000.0
Homme 3.0 71000.0 7937.253933 65000.0 66500.0 68000.0 74000.0 80000.0Questions fréquentes
À quoi sert la fonction groupby() de Pandas ?
Elle regroupe les lignes d’un DataFrame selon les valeurs d’une ou de plusieurs colonnes, puis applique une fonction d’agrégation (moyenne, somme, médiane, comptage) à chaque groupe. Le schéma est toujours le même : séparer en groupes, appliquer un calcul, combiner les résultats dans un nouveau DataFrame.
Comment calculer plusieurs agrégations par groupe en Pandas ?
Utilise agg() avec des arguments nommés, chacun étant un tuple (colonne, fonction), par exemple df.groupby(“genre”).agg(salaire_median=(“salaire”, “median”), taille_moyenne=(“taille”, “mean”)). Tu peux aussi passer une liste de fonctions, comme agg([“mean”, “count”]), sur des colonnes numériques.
Comment garder la colonne de regroupement comme colonne et non comme index ?
Ajoute le paramètre as_index=False dans groupby(), par exemple df.groupby(“genre”, as_index=False).agg(…). Tu peux aussi appeler reset_index() sur le résultat, ce qui produit le même DataFrame.
Que fait groupby() quand la colonne de regroupement contient des valeurs manquantes ?
Par défaut, Pandas supprime ces lignes du résultat (dropna=True). Pour les conserver dans un groupe à part, écris groupby(“colonne”, dropna=False). Dans mon test, ignorer la valeur manquante faisait disparaître un salaire de 80 000 et faussait la moyenne du groupe « Homme » (66 500 au lieu de 71 000).
Quelle est la différence entre size() et count() dans un groupby ?
size() compte toutes les lignes de chaque groupe, valeurs manquantes comprises. count() compte les valeurs non manquantes d’une colonne. Si une colonne contient des valeurs manquantes, count() renvoie un nombre inférieur à size().
Comment ajouter la moyenne de chaque groupe comme colonne du DataFrame ?
Utilise transform() : df[“moyenne_groupe“] = df.groupby(“genre”)[“salaire”].transform(“mean”). Contrairement à agg(), transform() renvoie une valeur par ligne d’origine, ce qui permet d’ajouter une colonne ou de calculer un écart à la moyenne du groupe.
Conclusion : que retenir de groupby() en Pandas ?
La fonction groupby() permet de passer de milliers de lignes à un résumé lisible en une ligne de code. Les réflexes à garder : nommer les agrégations avec agg(), utiliser as_index=False pour garder des colonnes, passer les colonnes de groupe dans une liste, penser à dropna=False et choisir entre agg(), transform() et filter() selon que tu veux un résumé, une colonne de même taille ou un tri des groupes.
Pour appliquer ces techniques sur des jeux de données réels, le mieux est de pratiquer. Sur DataXp, tu apprends Python et la data science avec des exercices pratiques à faire directement en ligne.
Pour aller plus loin, voici d’autres articles qui pourraient te plaire :