Pandas et NumPy sont les deux bibliothèques Python les plus utilisées pour analyser et manipuler des données. Pandas permet d’appliquer directement des fonctions NumPy à ses colonnes, sans écrire de boucle. Dans cet article, tu vas découvrir 3 fonctions NumPy à utiliser avec Pandas pour faciliter tes analyses de données : np.where(), np.select() et np.log().
Article mis à jour en octobre 2026 : tout le code a été exécuté (pandas 3.0 et pandas 2.3, mêmes résultats). L’ancienne version utilisait des nombres aléatoires, donc tes résultats ne ressemblaient pas à ceux de l’article : les données sont maintenant fixes. J’ai ajouté np.where() avec du texte, la différence avec where() de Pandas, l’ordre des conditions de np.select(), un graphique pour np.log() et le cas des zéros avec np.log1p().
En bref : np.where(condition, a, b) crée une colonne à deux valeurs selon une condition. np.select(conditions, valeurs, default) fait la même chose avec plusieurs conditions. np.log(colonne) calcule le logarithme d’une colonne et réduit l’écart entre des valeurs très différentes.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys
import numpy, pandas
print("Python", sys.version.split()[0])
print("pandas", pandas.__version__)
print("numpy", numpy.__version__)Python 3.13.16
pandas 3.0.5
numpy 2.5.3Comment préparer des données pour utiliser des fonctions NumPy avec Pandas ?
Commençons par importer les bibliothèques et créer un petit DataFrame sur lequel travailler. Les valeurs sont fixes : tu obtiendras exactement les mêmes résultats que dans l’article.
import numpy as np
import pandas as pd

df = pd.DataFrame({
    "A": [8, 3, 8, 7, 1, 8],
    "B": [12, 5, 9, 15, 17, 7],
    "C": [14, 11, 19, 10, 16, 12],
    "D": [0.42, 0.87, 0.15, 0.63, 0.91, 0.28],
})
df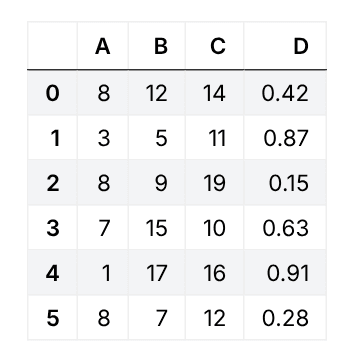
Comment créer une colonne conditionnelle avec np.where ?
La première fonction est np.where(), qui fournit un moyen pratique de créer des colonnes conditionnelles. Tu lui passes une condition, puis une valeur pour les lignes qui la respectent et une autre pour les lignes qui ne la respectent pas.
Par exemple, créons une colonne E qui vaut 1 si les valeurs des colonnes B et C sont toutes les deux supérieures à 10, et 0 sinon :
df["E"] = np.where((df["B"] > 10) & (df["C"] > 10), 1, 0)
df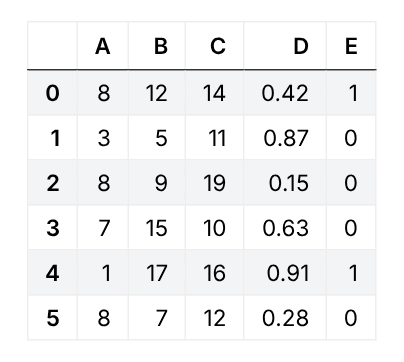
Seules les lignes 0 et 4 respectent les deux conditions. Note que la ligne 3 vaut 0 : sa valeur de C est 10, et 10 n’est pas strictement supérieur à 10. Tu peux combiner autant de conditions que nécessaire avec les opérateurs logiques & (et), | (ou) et ~ (non). Chaque condition doit être entre parenthèses, et il ne faut pas utiliser les mots-clés and et or, qui provoquent une erreur sur des colonnes. Si tu veux revoir les conditions sur un DataFrame, lis les 8 façons de filtrer un DataFrame Pandas.
Les deux valeurs ne sont pas obligatoirement des nombres. Tu peux aussi créer une colonne de texte :
df["B_niveau"] = np.where(df["B"] > 10, "grand", "petit")
df[["B", "B_niveau"]]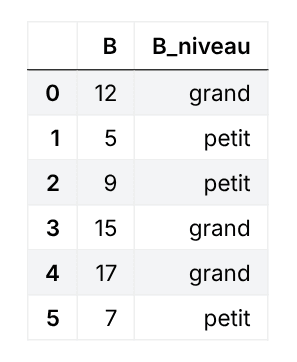
Quelle est la différence entre np.where() et where() de Pandas ?
Les deux ont le même nom, mais ils ne font pas la même chose. np.where() renvoie un tableau NumPy, avec la valeur de ton choix dans chaque cas :
resultat = np.where(df["B"] > 10, "grand", "petit")
print(type(resultat).__name__, resultat)ndarray ['grand' 'petit' 'petit' 'grand' 'grand' 'petit']La méthode where() de Pandas garde les valeurs qui respectent la condition et remplace les autres par la valeur donnée. Ici, les valeurs de B inférieures ou égales à 10 sont remplacées par 0 :
# where() de Pandas : garde les valeurs qui respectent la condition, remplace les autres
df["B"].where(df["B"] > 10, 0)0 12
1 0
2 0
3 15
4 17
5 0
Name: B, dtype: int64Comment appliquer plusieurs conditions avec np.select ?
La fonction np.select() est une version améliorée de np.where(). Avec np.where(), tu testes une condition (ou un ensemble de conditions) et tu choisis deux valeurs. Avec np.select(), tu testes plusieurs conditions et tu attribues une valeur distincte aux lignes qui respectent chacune d’elles. Le paramètre default donne la valeur des lignes qui ne respectent aucune condition.
Ce sera plus clair avec un exemple : on met 1 dans la colonne F si B vaut au moins 7 et A vaut 8, on met 2 si B vaut au moins 11 et A vaut 7, et 0 dans tous les autres cas.
conditions = [
    (df["B"] >= 7) & (df["A"] == 8),
    (df["B"] >= 11) & (df["A"] == 7),
]

valeurs = [1, 2]

df["F"] = np.select(conditions, valeurs, default=0)
df[["A", "B", "F"]]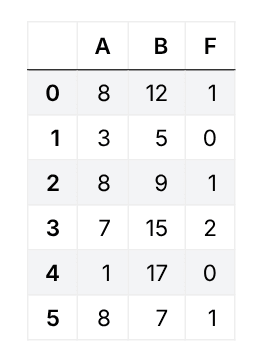
Les listes conditions et valeurs doivent avoir la même longueur : la première valeur correspond à la première condition, et ainsi de suite.
Que se passe-t-il quand plusieurs conditions sont vraies en même temps ?
Pour chaque ligne, np.select() retient la première condition vraie de la liste. L’ordre compte donc. Ici, une valeur de B égale à 15 respecte les deux conditions, B >= 7 et B >= 15. Avec la condition la plus large en premier, elle reçoit « moyen » ; en la mettant en dernier, elle reçoit « élevé » :
# Avec deux conditions vraies sur la même ligne, la première de la liste gagne
conditions = [df["B"] >= 7, df["B"] >= 15]
print(np.select(conditions, ["moyen", "élevé"], default="faible"))
print(np.select(conditions[::-1], ["élevé", "moyen"], default="faible"))['moyen' 'faible' 'moyen' 'moyen' 'moyen' 'moyen']
['moyen' 'faible' 'moyen' 'élevé' 'élevé' 'moyen']Place donc les conditions les plus précises en premier, et les plus larges ensuite.
Comme np.where(), np.select() accepte aussi du texte, ce qui est pratique pour créer des catégories à partir d’une colonne numérique :
conditions = [df["D"] >= 0.8, df["D"] >= 0.5]
df["D_niveau"] = np.select(conditions, ["fort", "moyen"], default="faible")
df[["D", "D_niveau"]]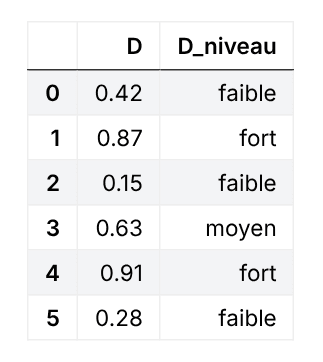
Comment utiliser np.log sur une colonne Pandas ?
La fonction np.log() calcule le logarithme d’une valeur. NumPy en propose trois versions : np.log() pour le logarithme népérien (en base e), np.log2() pour la base 2 et np.log10() pour la base 10.
print(np.log10(100))
print(np.log2(16))
print(np.log(1000))2.0
4.0
6.907755278982137Heureusement, tu peux appliquer np.log() à une colonne entière d’un DataFrame. Prendre le logarithme d’une colonne est utile dans de nombreux cas. Par exemple, si la variable cible d’un modèle de Machine Learning contient des valeurs très grandes par rapport aux autres, le logarithme réduit leur poids : on entraîne alors le modèle sur le logarithme de la cible. Les modèles linéaires sur une échelle logarithmique sont fréquemment utilisés en Machine Learning.
Prenons le DataFrame suivant :
df_log = pd.DataFrame({"target": [12, 18, 25, 31, 600, 850]})
df_log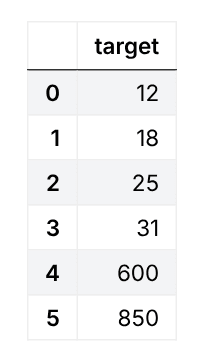
Les valeurs 600 et 850 sont très grandes par rapport aux autres valeurs de la colonne. Prenons le logarithme de cette colonne pour voir la différence :
df_log["log_target"] = np.log(df_log["target"])
df_log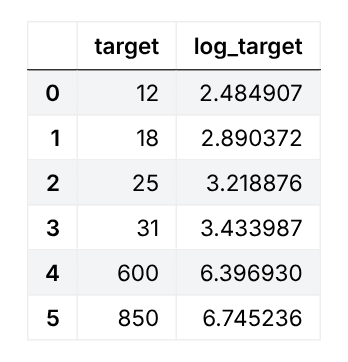
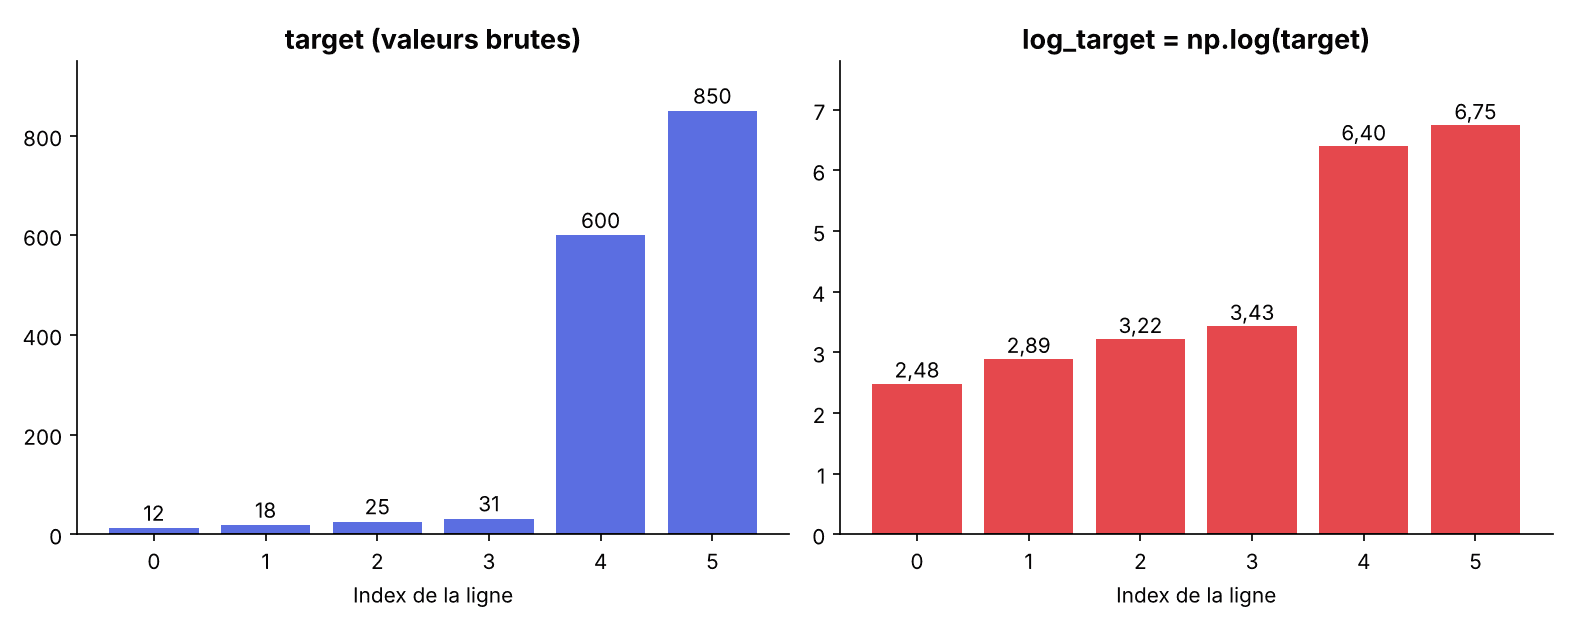
Les écarts sont devenus beaucoup plus petits : la valeur 850 est environ 71 fois plus grande que 12, mais son logarithme (6,75) n’est que 2,7 fois plus grand que celui de 12 (2,48). Le graphique ci-dessous montre la même chose :
Pour revenir à l’échelle d’origine, par exemple après avoir fait des prédictions sur la cible transformée, utilise la fonction inverse np.exp() :
# np.exp() annule np.log() : utile pour revenir à l'échelle d'origine
print(np.exp(df_log["log_target"]).round(0).tolist())[12.0, 18.0, 25.0, 31.0, 600.0, 850.0]Que faire si la colonne contient des zéros ?
Le logarithme de 0 n’existe pas. Avec np.log(), NumPy renvoie -inf (moins l’infini) et affiche un avertissement ; les valeurs négatives donnent nan. Si ta colonne contient des zéros, utilise np.log1p(), qui calcule le logarithme de 1 + x :
import warnings

valeurs = pd.Series([0, 1, 10, 100])
with warnings.catch_warnings(record=True) as avert:
    warnings.simplefilter("always")
    print(np.log(valeurs).tolist())
print(avert[0].message)[-inf, 0.0, 2.302585092994046, 4.605170185988092]
divide by zero encountered in logprint(np.log1p(valeurs).round(3).tolist())[0.0, 0.693, 2.398, 4.615]Le résultat pour 0 est maintenant 0, et plus d’avertissement.
Quelle fonction NumPy choisir ?
np.where(): créer une colonne avec deux valeurs possibles, selon une condition.np.select(): créer une colonne avec plusieurs valeurs possibles, selon plusieurs conditions (la première condition vraie gagne).np.log(): réduire l’écart entre des valeurs très différentes ;np.log1p()si la colonne contient des zéros,np.exp()pour revenir à l’échelle d’origine.
Ces trois fonctions travaillent sur des colonnes entières, sans boucle : c’est ce qu’on appelle la vectorisation. Si tu veux comprendre pourquoi c’est plus rapide qu’une boucle, lis l’article sur la vectorisation en Python.
Questions fréquentes
Comment créer une colonne conditionnelle avec NumPy dans Pandas ?
Utilise np.where(condition, valeur_si_vrai, valeur_si_faux) et affecte le résultat à une nouvelle colonne, par exemple df[“E”] = np.where((df[“B”] > 10) & (df[“C”] > 10), 1, 0). Chaque condition doit être entre parenthèses et combinée avec & (et) ou | (ou).
Quelle est la différence entre np.where() et where() de Pandas ?
np.where() renvoie un tableau NumPy avec la valeur de ton choix dans chaque cas (vrai ou faux). where() de Pandas garde les valeurs qui respectent la condition et remplace les autres par une valeur donnée, 0 ou NaN par exemple.
Quand utiliser np.select() plutôt que np.where() ?
Utilise np.select() quand tu as plus de deux résultats possibles. Tu lui passes une liste de conditions et une liste de valeurs de même longueur, et le paramètre default donne la valeur des lignes qui ne respectent aucune condition.
Que se passe-t-il quand plusieurs conditions de np.select() sont vraies ?
np.select() retient la première condition vraie de la liste. L’ordre des conditions compte donc : place les conditions les plus précises en premier et les plus larges ensuite.
Pourquoi appliquer le logarithme à une colonne ?
Le logarithme réduit l’écart entre des valeurs très différentes. Il est utile quand une colonne contient quelques valeurs très grandes, par exemple la variable cible d’un modèle de Machine Learning : les grandes valeurs pèsent alors moins dans le modèle.
Que faire si une colonne contient des zéros avec np.log() ?
Le logarithme de 0 n’existe pas : np.log() renvoie -inf avec un avertissement. Utilise np.log1p(), qui calcule le logarithme de 1 + x et renvoie 0 pour x = 0, et np.expm1() pour revenir à l’échelle d’origine.
Conclusion
NumPy et Pandas vont de pair : Pandas et beaucoup d’autres bibliothèques Python sont construites sur NumPy. Dans la plupart des cas, une fonction Pandas suffit pour accomplir une tâche, mais np.where(), np.select() et np.log() offrent des avantages supplémentaires pour créer des colonnes et transformer des valeurs. Pour t’entraîner, crée à partir d’un de tes jeux de données une colonne de catégories avec np.select(), puis compare avec le même résultat obtenu à l’aide d’une boucle.
Maîtriser ces fonctions, c’est une compétence de base ; savoir mener une analyse complète, c’est un métier. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin sur NumPy et Pandas :