Prédire le prix d’une course de taxi à New York : c’est le défi Kaggle « New York City Taxi Fare Prediction ». Le jeu d’entraînement contient 55 millions de courses en taxi depuis 2009, et le jeu de test 9 914 courses. L’objectif est de prédire le prix d’une course à partir des lieux de prise en charge et de dépose, de la date et de l’heure de la prise en charge, et du nombre de passagers.
Dans cette analyse exploratoire du prix des taxis, on va nettoyer les données, visualiser la relation entre les variables et créer de nouvelles caractéristiques (features) qui aident à mieux prévoir le prix. On dit souvent que 80 % du temps d’un projet de data va au nettoyage, à l’exploration et à la création de variables : c’est exactement ce qu’on fait ici.
Un mot sur les résultats : les chiffres et les graphiques viennent de mon exécution sur 6 millions de lignes du jeu Kaggle. Les fonctions de l’article, elles, sont testées sur des lieux réels de New York (JFK, Times Square, Wall Street…) : tu peux les copier telles quelles.
En bref : cette analyse exploratoire part du défi Kaggle « New York City Taxi Fare Prediction » (55 millions de courses, 6 millions importées ici). On supprime 262 tarifs négatifs et 128 443 courses hors de New York (environ 2 %), puis on crée des variables : aéroports, quartiers, bas de Manhattan, distance de Haversine et variables de date. Avec ces caractéristiques, un modèle XGBoost de base obtient un RMSE de 3,03760 sur le classement public Kaggle, dans le top 15 %.
Quelles données utilise-t-on pour prédire le prix d’un taxi à New York ?
Les données sont disponibles sur la page Data de la compétition Kaggle : télécharge les fichiers train.csv et test.csv (compte Kaggle gratuit, règlement de la compétition à accepter). Pour cette analyse, je n’ai importé que 6 millions de lignes sur les 55 millions du jeu d’entraînement. Les champs présents sont les suivants :
key: identifiant unique de la course ;fare_amount: le prix de la course en dollars, c’est la variable à prédire ;pickup_datetime: date et heure de la prise en charge ;pickup_longitudeetpickup_latitude: coordonnées du lieu de prise en charge ;dropoff_longitudeetdropoff_latitude: coordonnées du lieu de dépose ;passenger_count: nombre de passagers.
Comment charger 6 millions de lignes avec Pandas ?
On a besoin de NumPy, Pandas, Matplotlib et Seaborn. Si tu débutes avec les graphiques, regarde Visualisation de données avec Matplotlib.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as snsLe fichier d’entraînement est énorme (55 millions de lignes). Le paramètre nrows de read_csv() permet de n’en lire que les 6 premiers millions :
train = pd.read_csv("train.csv", nrows=6_000_000)
train.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 6000000 entries, 0 to 5999999
Data columns (total 8 columns):
key object
fare_amount float64
pickup_datetime object
pickup_longitude float64
pickup_latitude float64
dropoff_longitude float64
dropoff_latitude float64
passenger_count int64
dtypes: float64(5), int64(1), object(2)
memory usage: 366.2+ MBLa date de prise en charge est lue comme du texte (object). On la convertit en vrai type date avec pd.to_datetime(), puis on en extrait l’année, le mois, le jour, l’heure et le jour de la semaine avec l’accesseur .dt, qui travaille sur toute la colonne d’un coup :
train["pickup_datetime"] = pd.to_datetime(train["pickup_datetime"],
                                          format="%Y-%m-%d %H:%M:%S UTC")
train["pickup_date"] = train["pickup_datetime"].dt.date
train["pickup_day"] = train["pickup_datetime"].dt.day
train["pickup_hour"] = train["pickup_datetime"].dt.hour
train["pickup_day_of_week"] = train["pickup_datetime"].dt.day_name()
train["pickup_month"] = train["pickup_datetime"].dt.month
train["pickup_year"] = train["pickup_datetime"].dt.yearPour voir ce que ça donne, voici les mêmes lignes de code appliquées aux 4 premières courses du jeu :
extrait = pd.DataFrame({
    "fare_amount": [4.5, 16.9, 5.7, 7.7],
    "pickup_datetime": ["2009-06-15 17:26:21 UTC", "2010-01-05 16:52:16 UTC",
                        "2011-08-18 00:35:00 UTC", "2012-04-21 04:30:42 UTC"],
})
extrait["pickup_datetime"] = pd.to_datetime(extrait["pickup_datetime"],
                                            format="%Y-%m-%d %H:%M:%S UTC")
extrait["pickup_hour"] = extrait["pickup_datetime"].dt.hour
extrait["pickup_day_of_week"] = extrait["pickup_datetime"].dt.day_name()
extrait["pickup_month"] = extrait["pickup_datetime"].dt.month
extrait["pickup_year"] = extrait["pickup_datetime"].dt.year
print(extrait.drop(columns="pickup_datetime").to_string(index=False)) fare_amount pickup_hour pickup_day_of_week pickup_month pickup_year
4.5 17 Monday 6 2009
16.9 16 Tuesday 1 2010
5.7 0 Thursday 8 2011
7.7 4 Saturday 4 2012Dernière vérification avant de nettoyer : y a-t-il des valeurs manquantes ?
print(train.isnull().sum().sum())0Aucune valeur manquante dans ces 6 millions de lignes. Les problèmes sont ailleurs : des valeurs absurdes.
Quelles hypothèses peut-on faire sur le prix d’une course ?
L’étape suivante, dans tout problème d’analyse, est de dresser une liste d’hypothèses : ici, les facteurs qui devraient influencer le prix d’une course.
- Distance du trajet : plus la distance est grande, plus le prix devrait être élevé.
- Heure de la course : aux heures de pointe ou la nuit, le prix peut être plus élevé.
- Jour de la course : le prix peut varier entre la semaine et le week-end.
- Conditions météorologiques : s’il neige, il y a moins de taxis disponibles, donc les tarifs peuvent monter.
- Trajets depuis ou vers l’aéroport : ils ont souvent un tarif forfaitaire.
- Quartier de départ ou d’arrivée : le tarif peut varier selon le type de quartier.
- Disponibilité des taxis : dans un endroit avec beaucoup de taxis, les tarifs peuvent être plus bas.
Toutes ne sont pas testables : les données ne contiennent ni la météo ni la disponibilité des taxis. Les hypothèses 1, 2, 3, 5 et 6 (distance, heure, jour, aéroport, quartier) peuvent, elles, être vérifiées et transformées en variables.
Comment nettoyer et explorer les données de taxis ?
Dans cette section, on nettoie les données étape par étape, on comprend la relation entre les variables, et on utilise cette compréhension pour créer de meilleures caractéristiques.
1. Comment se répartit le montant de la course ?
On commence par le montant des courses. Combien de courses ont un tarif négatif ?
print((train["fare_amount"] < 0).sum())262Il y a 262 courses avec un tarif négatif. Comme le prix d’une course ne peut pas être négatif, on les supprime :
train = train[train["fare_amount"] >= 0]
print(len(train))5999738Le montant est très asymétrique : beaucoup de petites courses et quelques très chères. Pour mieux voir sa répartition, on applique une transformation logarithmique avant de tracer la densité avec Seaborn. On garde seulement les montants strictement positifs, car le logarithme de 0 n’est pas défini :
fig, ax = plt.subplots(figsize=(8, 5))
montants = train.loc[train["fare_amount"] > 0, "fare_amount"]
sns.kdeplot(np.log(montants), ax=ax)
ax.set_title("Distribution du montant de la course (échelle logarithmique)")
plt.show()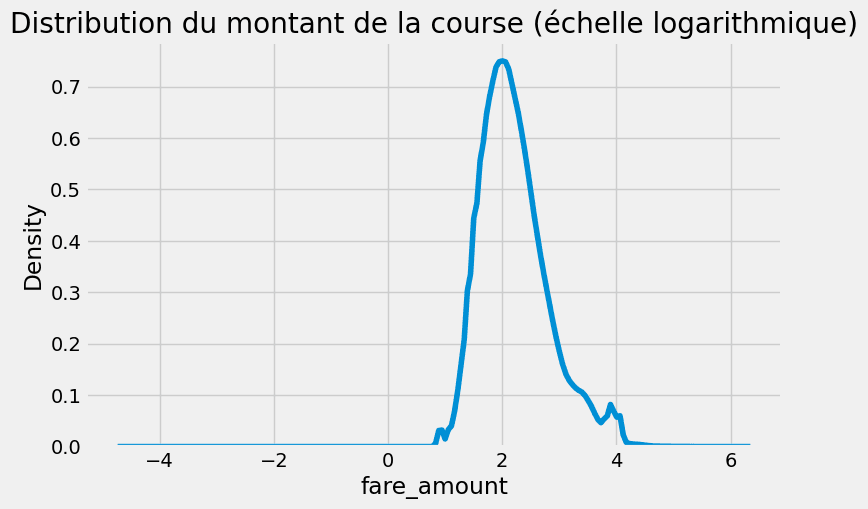
La courbe est maintenant proche d’une cloche. Sur l’échelle logarithmique, la plupart des courses se situent entre 1 et 4, c’est-à-dire entre environ 3 et 55 $ (le logarithme de 3 vaut environ 1, celui de 55 environ 4). Le petit pic vers 4 correspond aux courses à tarif forfaitaire : on y revient avec les aéroports.
2. Comment repérer les coordonnées géographiques aberrantes ?
Les latitudes et longitudes sont comprises respectivement entre -90 et 90, et entre -180 et 180. Voyons ce que contiennent nos données :
print("Latitude de prise en charge, min et max :",
train["pickup_latitude"].min(), train["pickup_latitude"].max())Latitude de prise en charge, min et max : -3488.079513 3344.459268Une latitude de -3 488 ou de 3 344 n’existe pas. Beaucoup de lignes ont aussi des coordonnées égales à 0 (le point 0, 0 se trouve dans l’océan Atlantique, au large de l’Afrique). Comme il s’agit de trajets de taxi à New York, tous ces points sont des erreurs.
Pour décider ce qui est « à New York », on s’appuie sur le jeu de test : on prend les limites des coordonnées qu’il contient. Aucune anomalie de ce genre n’a été trouvée dans les données de test.
On écrit d’abord une petite fonction dans_zone() qui dit si des coordonnées sont dans un rectangle. Elle travaille sur des colonnes entières, donc on peut l’appliquer d’un coup à des millions de lignes :
def dans_zone(lat, lng, zone):
    """True si le point (lat, lng) est dans le rectangle `zone`."""
    return ((lat >= zone["min_lat"]) & (lat <= zone["max_lat"]) &
            (lng >= zone["min_lng"]) & (lng <= zone["max_lng"]))


# Limites des coordonnées du jeu de test (New York et ses environs)
limites_ny = {"min_lng": -74.263242, "min_lat": 40.573143,
"max_lng": -72.986532, "max_lat": 41.709555}On repère les courses dont la prise en charge ou la dépose est hors de ces limites, puis on les supprime :
dans_ny = (dans_zone(train["pickup_latitude"], train["pickup_longitude"], limites_ny)
           & dans_zone(train["dropoff_latitude"], train["dropoff_longitude"], limites_ny))

print(f"Courses hors de New York : {(~dans_ny).sum():,}")
train = train[dans_ny]
print(f"Courses restantes : {len(train):,}")Courses hors de New York : 128,443
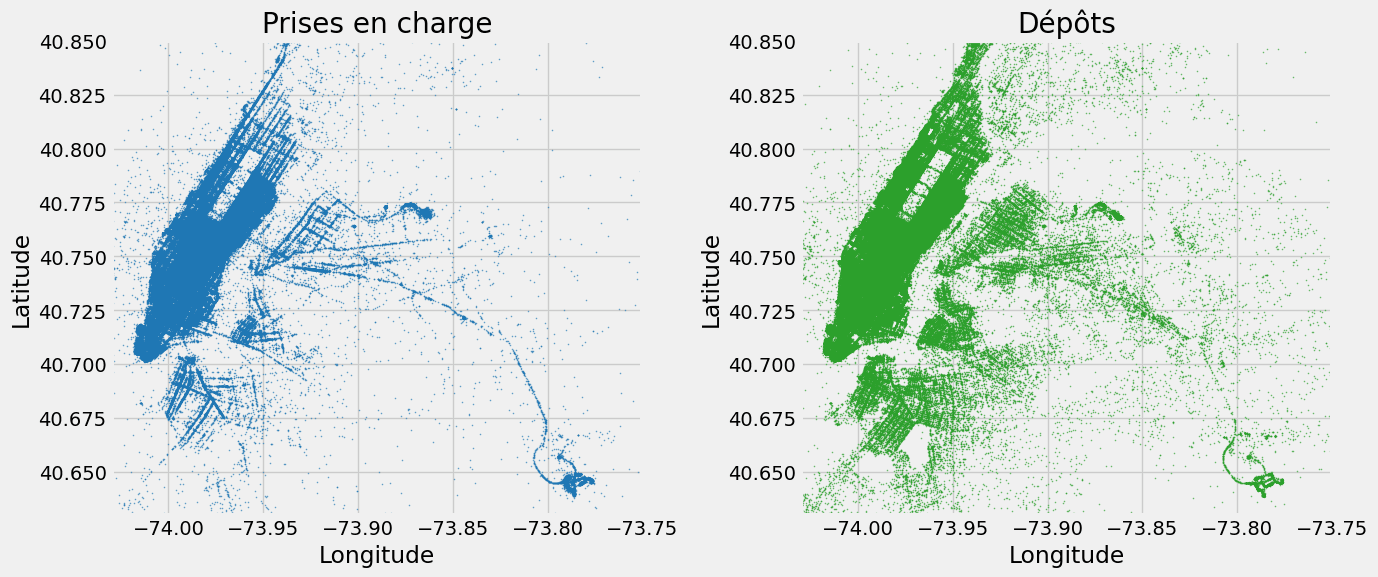
Courses restantes : 5,871,295128 443 courses (environ 2 % des données) sont supprimées. On peut maintenant tracer les lieux de prise en charge et de dépose : en plus de Manhattan, on voit une forte activité autour de JFK et de LaGuardia, les deux grands aéroports de la ville.
Les courses depuis et vers les aéroports coûtent-elles plus cher ?
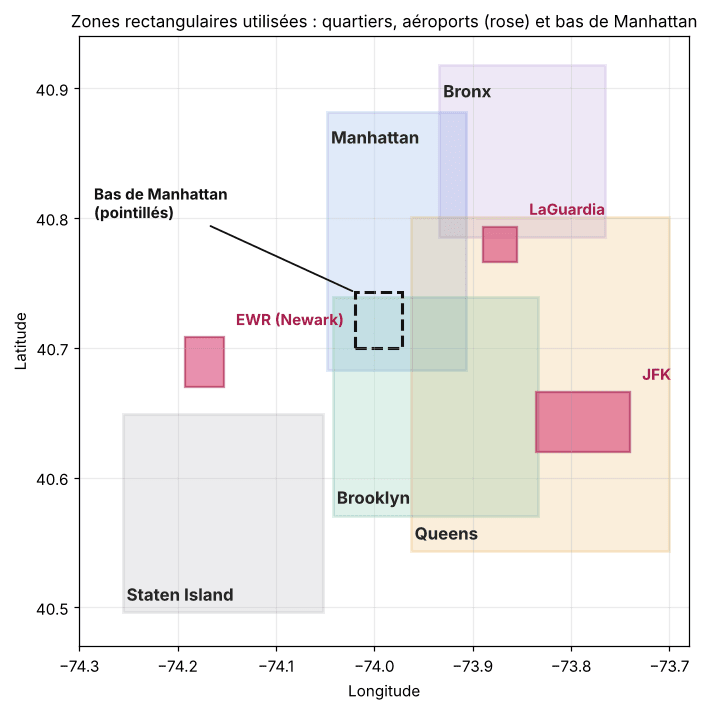
Regardons le montant moyen des courses au départ de JFK, comparé à toutes les courses des données d’entraînement. On définit pour cela un rectangle autour de chaque aéroport :
aeroports = {
    "JFK": {"min_lng": -73.8352, "min_lat": 40.6195, "max_lng": -73.7401, "max_lat": 40.6659},
    "EWR": {"min_lng": -74.1925, "min_lat": 40.6700, "max_lng": -74.1531, "max_lat": 40.7081},
    "la_guardia": {"min_lng": -73.8895, "min_lat": 40.7664, "max_lng": -73.8550, "max_lat": 40.7931},
}(EWR est l’aéroport de Newark, dans le New Jersey, mais c’est un aéroport très utilisé par les New-Yorkais.) Combien de courses partent de JFK ou y arrivent ?
prise_jfk = dans_zone(train["pickup_latitude"], train["pickup_longitude"], aeroports["JFK"])
depose_jfk = dans_zone(train["dropoff_latitude"], train["dropoff_longitude"], aeroports["JFK"])

print("Prises en charge à JFK :", prise_jfk.sum())
print("Dépôts à JFK :", depose_jfk.sum())Prises en charge à JFK : 90182
Dépôts à JFK : 45609On compare ensuite la répartition du montant (échelle logarithmique) des courses au départ de JFK avec celle de toutes les courses :
fig, ax = plt.subplots(figsize=(8, 5))
sns.kdeplot(np.log(train.loc[prise_jfk, "fare_amount"].clip(lower=0.01)), label="Départs de JFK", ax=ax)
sns.kdeplot(np.log(train["fare_amount"].clip(lower=0.01)), label="Toutes les courses", ax=ax)
ax.set_title("Distribution du montant (échelle logarithmique)")
ax.legend()
plt.show()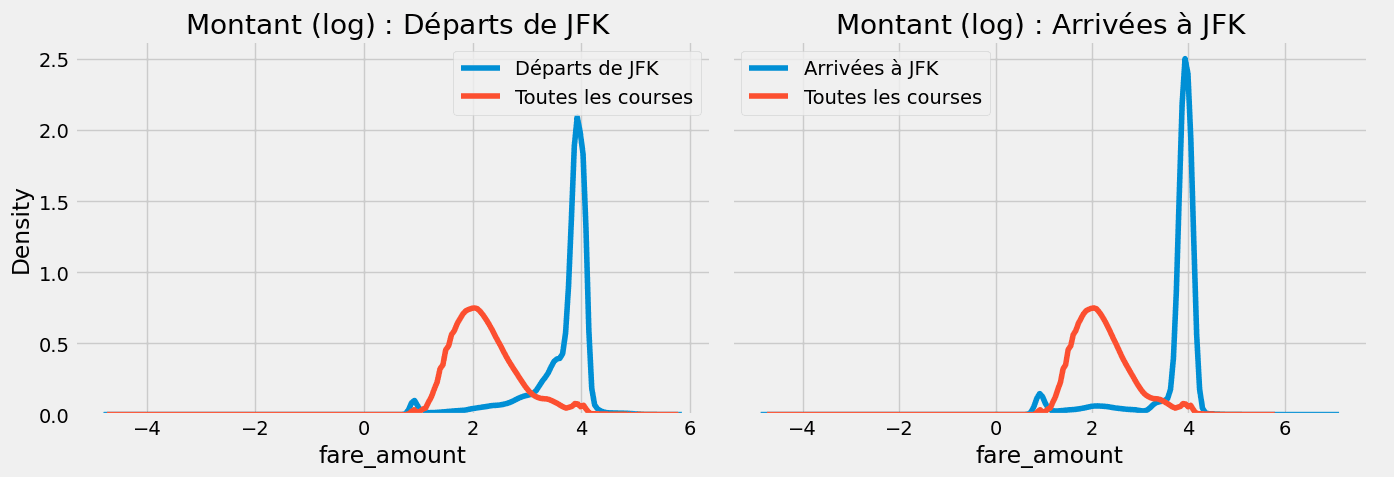
Les courses depuis JFK sont nettement plus chères. Leur montant se concentre en un pic très marqué vers 4 sur l’échelle logarithmique, soit environ 52 $ : c’est le tarif forfaitaire entre JFK et Manhattan. La répartition des montants est semblable pour les départs et pour les arrivées à JFK.
On crée donc, pour chacun des trois aéroports, une variable qui indique si la prise en charge ou la dépose s’y fait. On construit un petit tableau de 7 trajets entre des lieux connus (sans tarifs) pour tester le code sans avoir besoin des 6 millions de lignes :
lieux = {
    "JFK": (40.6413, -73.7781), "LaGuardia": (40.7769, -73.8740),
    "Newark": (40.6895, -74.1745), "Times Square": (40.7580, -73.9855),
    "Wall Street": (40.7069, -74.0113), "Coney Island": (40.5755, -73.9707),
    "Yankee Stadium": (40.8296, -73.9262), "St George (Staten Island)": (40.6437, -74.0737),
}
parcours = [("JFK", "Times Square"), ("LaGuardia", "Times Square"),
            ("Newark", "Times Square"), ("Times Square", "Wall Street"),
            ("Coney Island", "Wall Street"), ("Yankee Stadium", "Times Square"),
            ("St George (Staten Island)", "Wall Street")]

trajets = pd.DataFrame([{
    "depart": a, "arrivee": b,
    "pickup_latitude": lieux[a][0], "pickup_longitude": lieux[a][1],
    "dropoff_latitude": lieux[b][0], "dropoff_longitude": lieux[b][1],
} for a, b in parcours])Pour chaque aéroport, une colonne pour la prise en charge (is_pickup_…) et une pour la dépose (is_dropoff_…) :
def ajouter_aeroports(df):
    for nom, zone in aeroports.items():
        df[f"is_pickup_{nom}"] = dans_zone(df["pickup_latitude"], df["pickup_longitude"], zone).astype(int)
        df[f"is_dropoff_{nom}"] = dans_zone(df["dropoff_latitude"], df["dropoff_longitude"], zone).astype(int)
    return df


trajets = ajouter_aeroports(trajets)
print(trajets[["depart", "is_pickup_JFK", "is_pickup_EWR", "is_pickup_la_guardia"]].to_string(index=False)) depart is_pickup_JFK is_pickup_EWR is_pickup_la_guardia
JFK 1 0 0
LaGuardia 0 0 1
Newark 0 1 0
Times Square 0 0 0
Coney Island 0 0 0
Yankee Stadium 0 0 0
St George (Staten Island) 0 0 0Sur les 6 millions de lignes, on appelle simplement train = ajouter_aeroports(train). La fonction est vectorisée : elle prend quelques secondes là où une version avec apply() ligne par ligne prendrait de longues minutes (on mesure l’écart plus bas, avec le calcul de distance).
Le quartier de départ ou d’arrivée influence-t-il le prix ?
L’étape suivante vérifie si notre hypothèse sur le quartier se confirme. New York est divisée en 5 quartiers (boroughs) : Manhattan, Queens, Brooklyn, Staten Island et le Bronx. On associe un rectangle à chacun et on regroupe chaque lieu de prise en charge et de dépose dans l’un d’eux, ou dans « others » s’il n’est dans aucun :
quartiers = {
    "manhattan": {"min_lng": -74.0479, "min_lat": 40.6829, "max_lng": -73.9067, "max_lat": 40.8820},
    "queens": {"min_lng": -73.9630, "min_lat": 40.5431, "max_lng": -73.7004, "max_lat": 40.8007},
    "brooklyn": {"min_lng": -74.0421, "min_lat": 40.5707, "max_lng": -73.8334, "max_lat": 40.7395},
    "bronx": {"min_lng": -73.9339, "min_lat": 40.7855, "max_lng": -73.7654, "max_lat": 40.9176},
    "staten_island": {"min_lng": -74.2558, "min_lat": 40.4960, "max_lng": -74.0522, "max_lat": 40.6490},
}


def quartier(lat, lng):
    """Nom du quartier (le premier rectangle qui contient le point)."""
    conditions = [dans_zone(lat, lng, zone) for zone in quartiers.values()]
    return np.select(conditions, list(quartiers.keys()), default="others")


def ajouter_quartiers(df):
    df["pickup_borough"] = quartier(df["pickup_latitude"], df["pickup_longitude"])
    df["dropoff_borough"] = quartier(df["dropoff_latitude"], df["dropoff_longitude"])
    return df


trajets = ajouter_quartiers(trajets)
print(trajets[["depart", "arrivee", "pickup_borough", "dropoff_borough"]].to_string(index=False)) depart arrivee pickup_borough dropoff_borough
JFK Times Square queens manhattan
LaGuardia Times Square queens manhattan
Newark Times Square others manhattan
Times Square Wall Street manhattan manhattan
Coney Island Wall Street brooklyn manhattan
Yankee Stadium Times Square manhattan manhattan
St George (Staten Island) Wall Street staten_island manhattanSur les données d’entraînement : train = ajouter_quartiers(train).
Attention, c’est une approximation : des rectangles ne suivent pas les frontières réelles, et ils se chevauchent. L’ordre compte : un point qui est dans plusieurs rectangles reçoit le premier nom de la liste. Dans le test ci-dessus, Yankee Stadium (qui est dans le Bronx) est classé « manhattan », parce que le rectangle de Manhattan le contient et passe en premier. Pour un résultat exact, utilise les polygones officiels des quartiers avec GeoPandas.
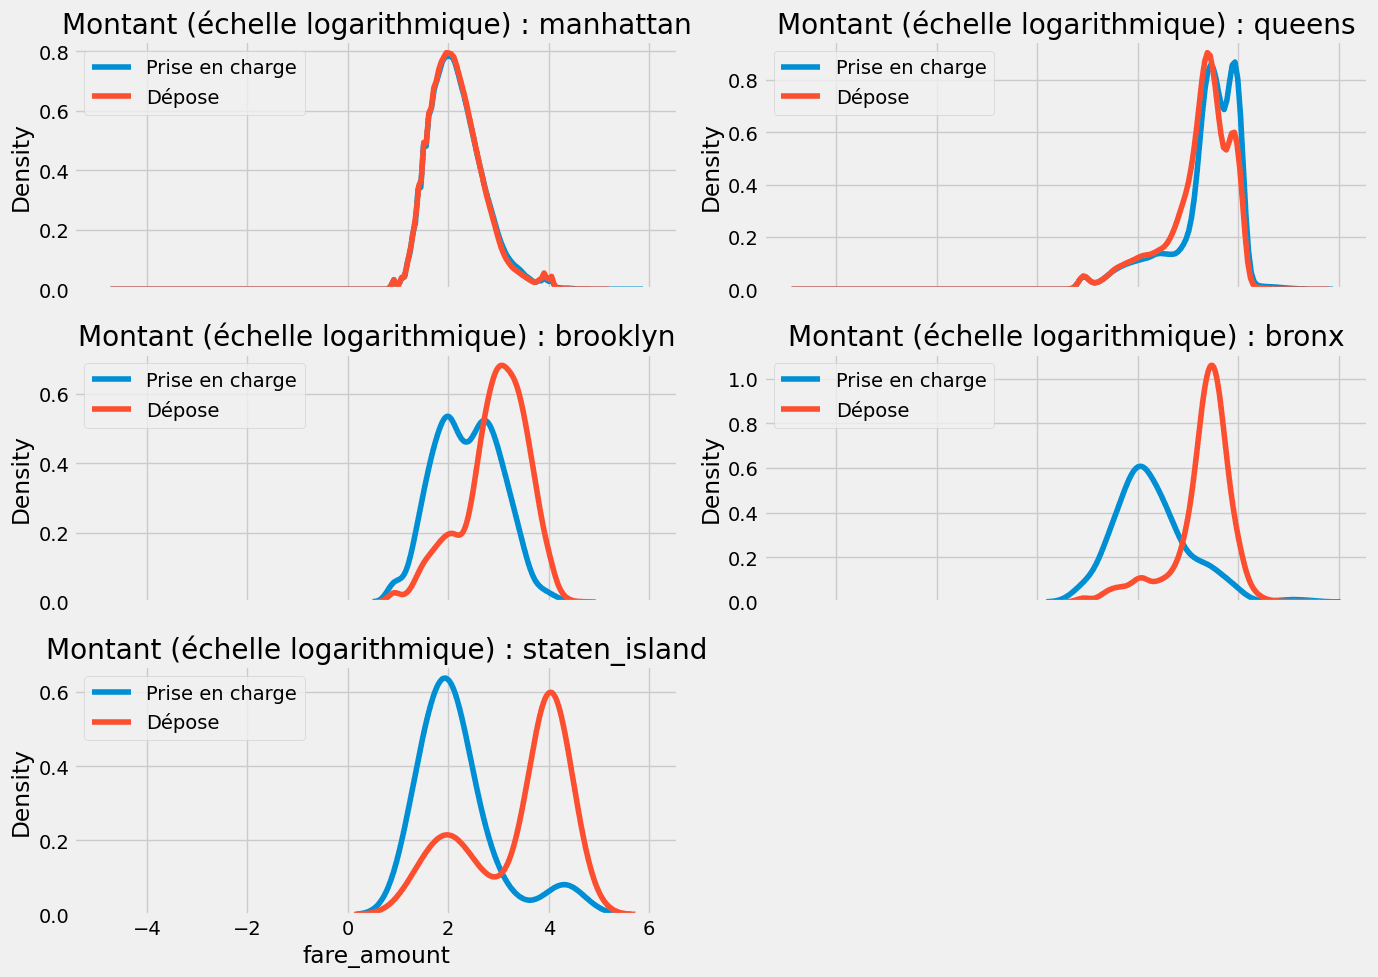
Malgré cette approximation, l’hypothèse se vérifie : sauf pour Manhattan, où se trouve la quasi-totalité des courses (environ 98 % ont au moins une extrémité dans le rectangle de Manhattan), la répartition des tarifs de prise en charge et de dépose est différente d’un quartier à l’autre. Les prises en charge dans le Queens sont plus chères en moyenne que dans les autres quartiers (le Queens abrite JFK et LaGuardia), et l’écart entre prise en charge et dépose est très marqué pour Staten Island et pour le Bronx.
3. Comment calculer la distance d’un trajet avec la formule de Haversine ?
Avec les coordonnées de prise en charge et de dépose, on calcule la distance du trajet en miles avec la distance de Haversine, qui donne la distance « à vol d’oiseau » entre deux points d’une sphère. Elle ne tient pas compte des rues, mais c’est une bonne approximation de la distance réelle :
def distance_miles(lat1, lng1, lat2, lng2):
    """Distance de Haversine en miles (accepte des colonnes Pandas entières)."""
    p = np.pi / 180
    a = (0.5 - np.cos((lat2 - lat1) * p) / 2
         + np.cos(lat1 * p) * np.cos(lat2 * p) * (1 - np.cos((lng2 - lng1) * p)) / 2)
    return 0.6213712 * 12742 * np.arcsin(np.sqrt(a))   # 12742 km = diamètre de la Terre


trajets["trip_distance"] = distance_miles(trajets["pickup_latitude"], trajets["pickup_longitude"],
                                          trajets["dropoff_latitude"], trajets["dropoff_longitude"])
print(trajets[["depart", "arrivee", "trip_distance"]].round(2).to_string(index=False)) depart arrivee trip_distance
JFK Times Square 13.53
LaGuardia Times Square 5.98
Newark Times Square 10.97
Times Square Wall Street 3.78
Coney Island Wall Street 9.33
Yankee Stadium Times Square 5.84
St George (Staten Island) Wall Street 5.46JFK – Times Square fait environ 13,5 miles : on retrouve bien l’ordre de grandeur d’une course depuis l’aéroport. Sur les données d’entraînement, il suffit de l’appliquer aux colonnes :
train["trip_distance"] = distance_miles(train["pickup_latitude"], train["pickup_longitude"],
train["dropoff_latitude"], train["dropoff_longitude"])Pourquoi écrire une fonction qui travaille sur des colonnes entières, plutôt que d’utiliser train.apply(lambda row: ..., axis=1) ? Parce que c’est bien plus rapide. Mesure sur 200 000 trajets tirés au hasard dans les limites de New York :
import time

rng = np.random.default_rng(0)
n = 200_000
test = pd.DataFrame({
    "pickup_latitude": rng.uniform(40.57, 40.9, n), "pickup_longitude": rng.uniform(-74.25, -73.7, n),
    "dropoff_latitude": rng.uniform(40.57, 40.9, n), "dropoff_longitude": rng.uniform(-74.25, -73.7, n),
})

debut = time.time()
d1 = test.apply(lambda r: distance_miles(r.pickup_latitude, r.pickup_longitude,
                                         r.dropoff_latitude, r.dropoff_longitude), axis=1)
temps_apply = time.time() - debut

debut = time.time()
d2 = distance_miles(test["pickup_latitude"], test["pickup_longitude"],
                    test["dropoff_latitude"], test["dropoff_longitude"])
temps_vectorise = time.time() - debut

print(f"apply, ligne par ligne : {temps_apply:.1f} s")
print(f"colonnes entières      : {temps_vectorise:.3f} s")
print("Mêmes résultats :", np.allclose(d1, d2))apply, ligne par ligne : 5.2 s
colonnes entières : 0.010 s
Mêmes résultats : TrueLes résultats sont identiques, mais la version vectorisée est des centaines de fois plus rapide (les temps varient selon ta machine). Sur 6 millions de lignes, la différence se compte en minutes.
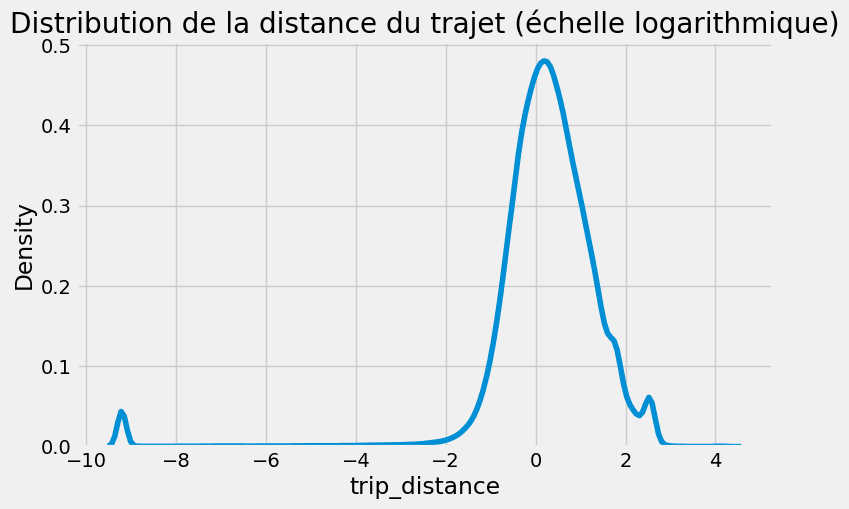
La distance du trajet, tout comme le montant du tarif, suit une distribution à longue queue : on prend le logarithme pour la rapprocher d’une distribution normale.
Une de nos hypothèses est que le montant de la course devrait augmenter avec la distance. Un diagramme de dispersion entre distance et montant montre bien une relation linéaire, mais avec deux particularités : le tarif par mile (la pente) est faible, et des trajets de plus de 50 miles ont un tarif très bas.
Pour savoir si ce sont des trajets d’aéroport (qui ont des tarifs forfaitaires), on les retire et on trace à nouveau. On repère les trajets sans aéroport avec les colonnes créées plus haut :
colonnes_aeroport = [f"is_{sens}_{nom}" for sens in ("pickup", "dropoff") for nom in aeroports]
non_airport = train[train[colonnes_aeroport].sum(axis=1) == 0]
print(len(non_airport))5547254Il reste 5 547 254 trajets, soit environ 94,5 % : environ 324 000 trajets (5,5 %) touchent donc un des trois aéroports. Sans eux, le tarif par mile est plus élevé, et un petit groupe de trajets de plus de 50 miles apparaît toujours.
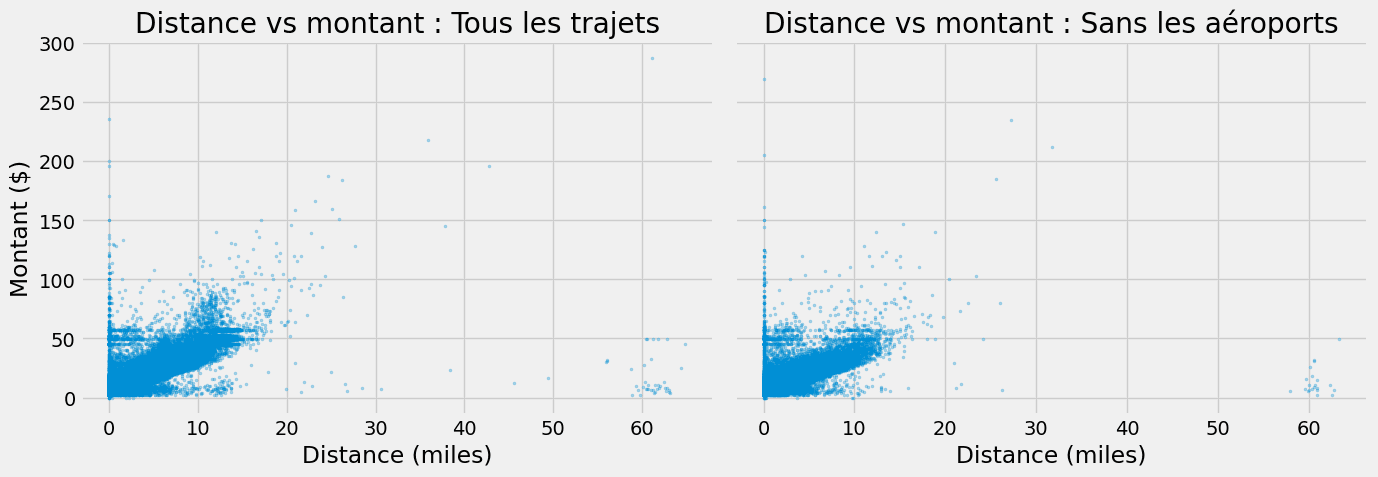
Un trajet de 60 miles facturé moins de 50 $ n’a pas de sens à New York : ces courses ont très probablement une coordonnée erronée. Voyons où elles se situent :
trajets_longs = non_airport[non_airport["trip_distance"] >= 50]En traçant les prises en charge (points bleus) et les dépôts (points verts) de ces trajets de plus de 50 miles sur une carte, on voit que la plupart se concentrent à Manhattan, surtout dans sa partie basse, les autres étant dispersés dans les autres quartiers et même hors de la ville.
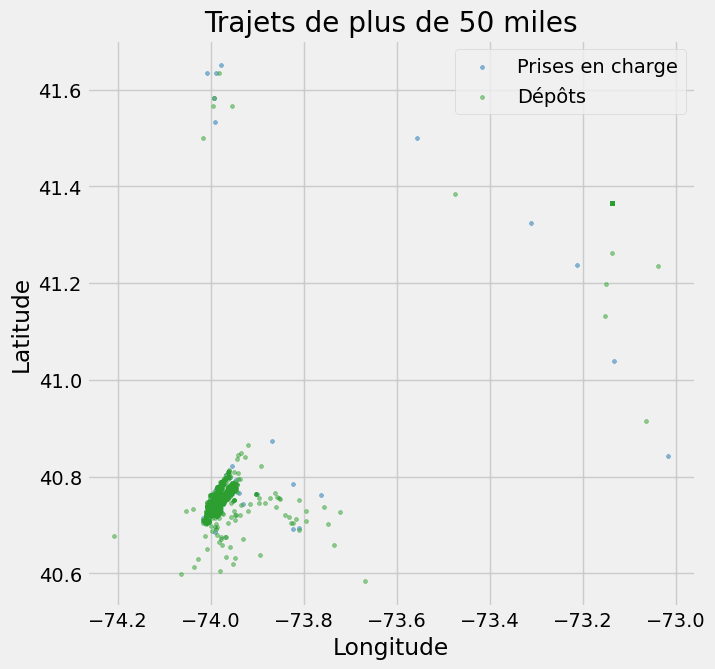
Cela conduit à deux nouvelles caractéristiques : is_pickup_lower_manhattan et is_dropoff_lower_manhattan, qui indiquent si la prise en charge ou la dépose est dans le bas de Manhattan :
bas_manhattan = {"min_lng": -74.0194, "min_lat": 40.6997, "max_lng": -73.9716, "max_lat": 40.7427}


def ajouter_bas_manhattan(df):
    df["is_pickup_lower_manhattan"] = dans_zone(df["pickup_latitude"], df["pickup_longitude"], bas_manhattan).astype(int)
    df["is_dropoff_lower_manhattan"] = dans_zone(df["dropoff_latitude"], df["dropoff_longitude"], bas_manhattan).astype(int)
    return df


trajets = ajouter_bas_manhattan(trajets)
print(trajets[["depart", "arrivee", "is_pickup_lower_manhattan", "is_dropoff_lower_manhattan"]].to_string(index=False)) depart arrivee is_pickup_lower_manhattan is_dropoff_lower_manhattan
JFK Times Square 0 0
LaGuardia Times Square 0 0
Newark Times Square 0 0
Times Square Wall Street 0 1
Coney Island Wall Street 0 1
Yankee Stadium Times Square 0 0
St George (Staten Island) Wall Street 0 1Sur les données d’entraînement : train = ajouter_bas_manhattan(train).
Quand on compare les courses de Manhattan selon qu’elles partent du bas de Manhattan ou du reste de l’île, les distributions du montant sont proches. La différence la plus nette est le petit pic vers 4 sur l’échelle logarithmique (les tarifs forfaitaires d’aéroport), moins marqué quand la course part du bas de Manhattan ou y arrive. L’écart est modeste, mais on garde ces deux variables : on verra dans la partie 2 si elles aident les modèles.
4. Comment le prix varie-t-il selon l’heure et la date ?
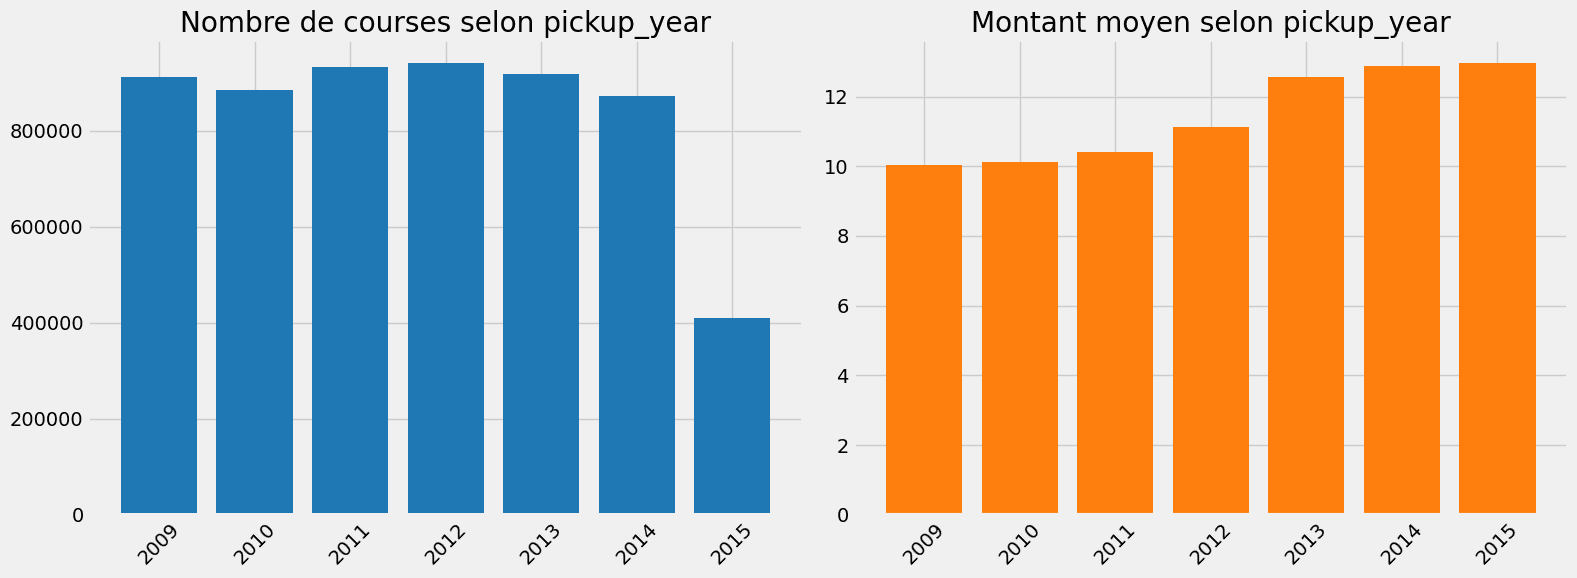
Pour analyser l’évolution du prix dans le temps, on utilise les variables créées au début (heure, jour de la semaine, mois, année). Commençons par l’année.
Comme prévu, le prix moyen d’une course a augmenté au fil des années : environ 10 $ en 2009, environ 13 $ en 2015, avec un saut en 2013 (les tarifs officiels ont été relevés en septembre 2012). Attention, l’année 2015 est incomplète : elle compte environ deux fois moins de courses que les autres, parce que les données s’arrêtent en milieu d’année.
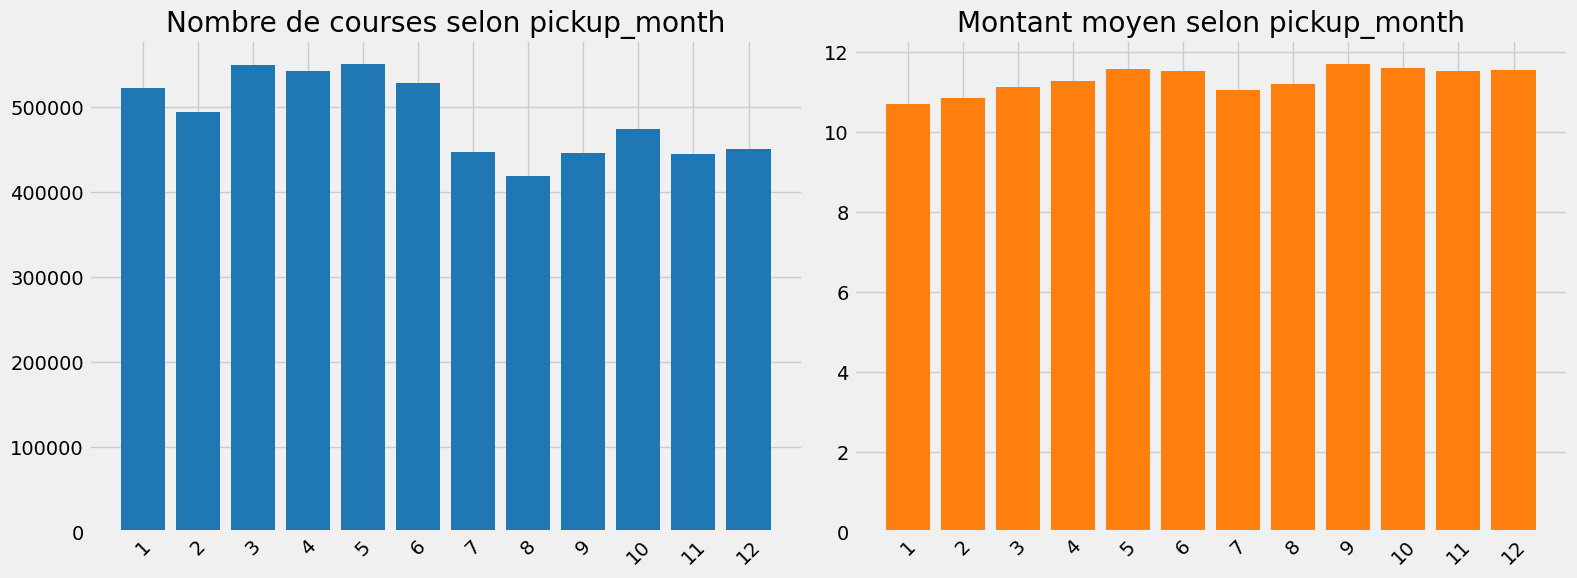
Au fil des mois, le tarif moyen reste presque constant (entre 10,7 et 11,7 $). Il y a moins de courses de juillet à décembre, en partie parce que les données de 2015 ne couvrent que le début de l’année.
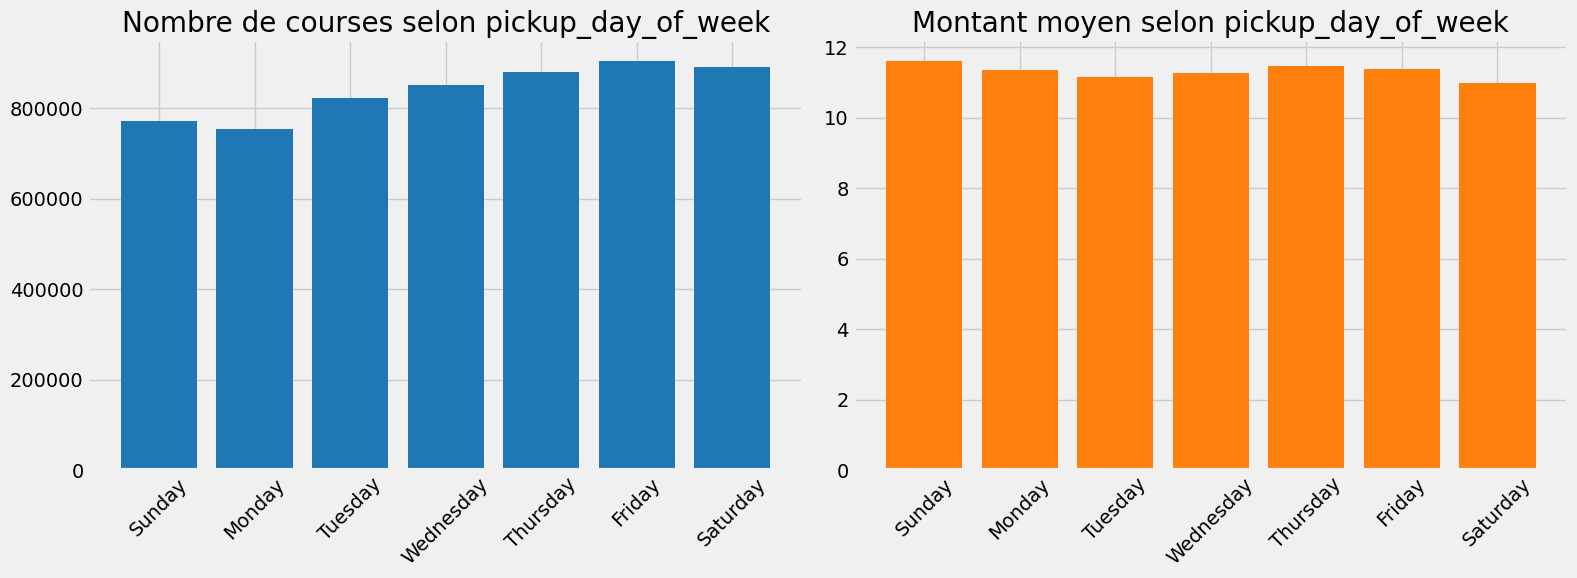
Côté jours de la semaine, ce sont le vendredi et le samedi qui comptent le plus de courses, le lundi et le dimanche le moins. Le montant moyen est le plus bas le samedi (environ 11 $) et le plus haut le dimanche (environ 11,6 $). Les écarts restent faibles, de moins d’un dollar : le jour de la semaine seul ne suffira pas à expliquer le prix.
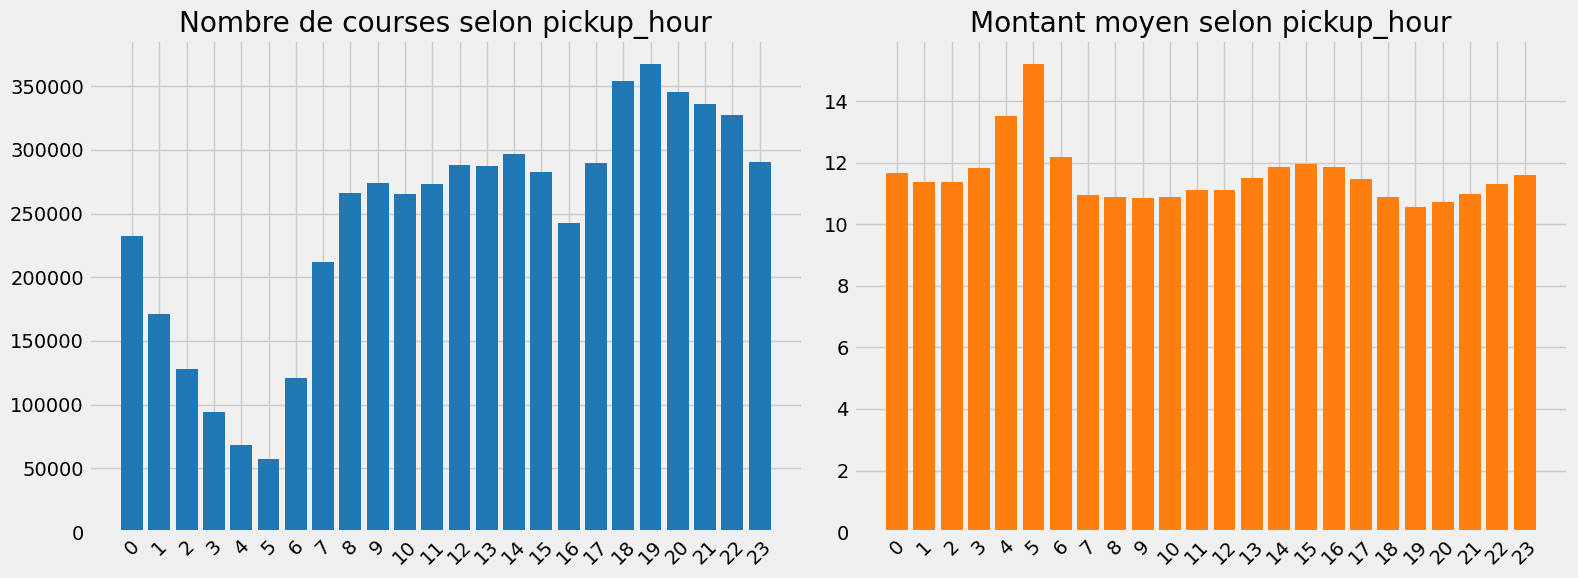
Le tarif moyen est le plus élevé à 5 h du matin (environ 15 $), alors que c’est l’heure où il y a le moins de courses (moins de 60 000). Une explication possible : à cette heure, une part importante des courses sont des trajets d’aéroport, au tarif plus élevé (c’est une hypothèse à vérifier avec les variables d’aéroport). Les courses sont les plus nombreuses à 18 h et 19 h.
5. Que faire des nombres de passagers aberrants ?
Dernière variable : le nombre de passagers. On y trouve des courses avec 0 passager, qui ne sont pas des courses vides pour autant : la distance moyenne de ces courses est de 1,77 mile. On y trouve aussi des valeurs absurdes (129 et 208 passagers sur 3 courses) et quelques courses à 9 passagers. Le jeu de test ne contient aucune course avec plus de 8 passagers, donc on supprime ces valeurs du jeu d’entraînement :
print(train.loc[train["passenger_count"] == 0, "trip_distance"].mean())

train = train[train["passenger_count"] <= 8]1.7726290784433825Ce que tu retiens
Voici le bilan du nettoyage de cette analyse exploratoire du prix des taxis, avec les variables à garder pour la modélisation :
- Nettoyage : 262 tarifs négatifs supprimés, 128 443 courses hors de New York supprimées (coordonnées à 0 ou aberrantes), courses à plus de 8 passagers supprimées ;
- Variables de date :
pickup_hour,pickup_day_of_week,pickup_day,pickup_month,pickup_year; - Variables de lieu : aéroports (
is_pickup_JFK,is_dropoff_JFK,is_pickup_EWR,is_dropoff_EWR,is_pickup_la_guardia,is_dropoff_la_guardia), quartiers (pickup_borough,dropoff_borough) et bas de Manhattan (is_pickup_lower_manhattan,is_dropoff_lower_manhattan) ; - Variable de distance :
trip_distance, la distance de Haversine en miles.
Tu viens de nettoyer un jeu de données avec de vraies anomalies : tarifs négatifs, coordonnées impossibles, nombres de passagers aberrants. Si tu veux t’entraîner à repérer et traiter ces cas sur d’autres jeux de données, le cours Nettoyage de données de DataXp reprend ces méthodes sur 3 projets guidés, avec 2 chapitres gratuits. Pour approfondir Pandas, tu peux aussi lire Nettoyage de données avec Python et 22 astuces Pandas qui rendront ton travail plus efficace.
Notes de fin
Sur la base des caractéristiques créées dans cette analyse exploratoire, le modèle de base utilisant XGBoost a obtenu un RMSE de 3,03760 sur le tableau des leaders publics, ce qui le place dans le top 15 % des participants à ce moment-là.
Le notebook complet est à jour avec les versions récentes de Pandas, Matplotlib et Seaborn : ouvre-le dans Google Colab (rien à installer ; il t’explique comment récupérer les données depuis Kaggle). Clique sur « Copier sur Drive » pour pouvoir l’exécuter et le modifier. Les fonctions de cet article en sont extraites.
Dans la partie 2 : construire des modèles de prix de taxi avec le Machine Learning, on utilise ces caractéristiques pour entraîner plusieurs modèles de Machine Learning et apprendre à les évaluer. Si tu n’as pas encore vu les bases, commence par apprendre le Machine Learning avec Python.