Filtrer les lignes d’un tableau selon une ou plusieurs conditions est l’une des opérations les plus courantes en analyse de données. Dans cet article, tu vas apprendre à filtrer un DataFrame Pandas de 8 façons différentes, avec pour chacune un exemple testé et son résultat.
Article mis à jour en octobre 2026 : tout le code a été exécuté (pandas 3.0 et pandas 2.3, mêmes résultats). Le DataFrame d’exemple utilise désormais des valeurs fixes, pour que tu obtiennes exactement les mêmes résultats que moi. J’ai aussi ajouté between(), le message d’erreur du mot-clé and, la sensibilité à la casse de str.contains(), les variables dans query() et la différence entre loc et iloc pour les bornes d’une tranche.
En bref : pour filtrer un DataFrame Pandas, tu peux utiliser (1) un opérateur de comparaison, comme df[df.val1 > 0.5], (2) plusieurs conditions combinées avec & (et) ou | (ou), (3) isin() pour une liste de valeurs, (4) l’accesseur str pour le texte, (5) ~ pour inverser un filtre, (6) query() pour écrire la condition sous forme de texte, (7) nlargest() et nsmallest() pour les valeurs extrêmes, et (8) loc et iloc pour sélectionner par label ou par position.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys
import numpy, pandas
print("Python", sys.version.split()[0])
print("pandas", pandas.__version__)
print("numpy", numpy.__version__)Python 3.13.16
pandas 3.0.5
numpy 2.5.3Comment créer un DataFrame pour tester les filtres ?
Pandas est la bibliothèque d’analyse et de manipulation de données la plus populaire de Python. Sa structure de données de base, le DataFrame, stocke les données sous forme de tableau avec des lignes et des colonnes étiquetées. Pour filtrer un DataFrame Pandas, on sélectionne les lignes qui répondent à une condition. Commençons par importer Pandas :
import pandas as pdPuis créons un DataFrame pour nos exemples, avec des valeurs fixes :
df = pd.DataFrame({
    'name': ['Alba', 'Noah', 'Jon', 'Tom', 'Emilie', 'Coco', 'Anna'],
    'cat': ['A', 'A', 'C', 'B', 'B', 'C', 'B'],
    'val1': [0.09, 0.58, 0.76, 0.96, 0.27, 0.45, 0.17],
    'val2': [6, 2, 1, 3, 4, 4, 2]
})
df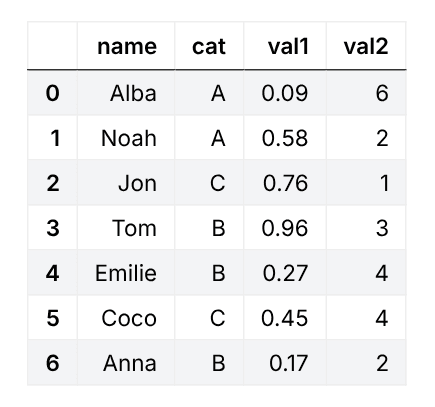
Voici mon top 8 des façons de filtrer un DataFrame Pandas.
1. Comment filtrer avec des opérateurs de comparaison ?
Tu peux utiliser les opérateurs de comparaison (>, <, >=, <=, ==, !=) sur les valeurs d'une colonne. La condition renvoie une série de booléens, un par ligne :
df.val1 > 0.50 False
1 True
2 True
3 True
4 False
5 False
6 False
Name: val1, dtype: boolQuand on passe cette série entre crochets, Pandas garde uniquement les lignes où la valeur est True :
df[df.val1 > 0.5]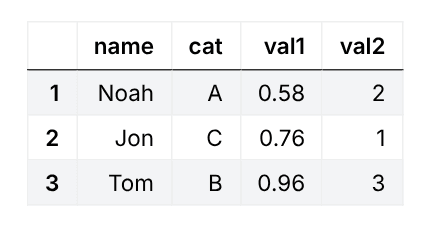
Nous avons sélectionné les lignes dont la valeur de la colonne val1 est supérieure à 0,5. Les opérateurs de comparaison fonctionnent aussi sur les chaînes de caractères, selon l'ordre alphabétique :
df[df.name > 'Jon'] name cat val1 val2
1 Noah A 0.58 2
3 Tom B 0.96 3Seuls les prénoms qui suivent « Jon » dans l'ordre alphabétique sont sélectionnés (la comparaison tient compte de la casse : les majuscules passent avant les minuscules). Pour garder les valeurs comprises entre deux bornes, la méthode between() est plus lisible que deux comparaisons. Les deux bornes sont incluses par défaut :
df[df.val1.between(0.2, 0.6)] name cat val1 val2
1 Noah A 0.58 2
4 Emilie B 0.27 4
5 Coco C 0.45 42. Comment combiner plusieurs conditions ?
Pandas permet de combiner plusieurs conditions. Utilise & pour « et » et | pour « ou », et mets chaque condition entre parenthèses. Par exemple, pour appliquer des conditions sur les colonnes val1 et val2 :
df[(df.val1 > 0.5) & (df.val2 == 1)] name cat val1 val2
2 Jon C 0.76 1Seule la ligne de Jon répond aux deux conditions à la fois. Avec « ou », il suffit qu'une condition soit vraie :
df[(df.val1 < 0.5) | (df.val2 == 3)] name cat val1 val2
0 Alba A 0.09 6
3 Tom B 0.96 3
4 Emilie B 0.27 4
5 Coco C 0.45 4
6 Anna B 0.17 2Attention : n'utilise pas les mots-clés Python and, or et not pour combiner des conditions sur des colonnes. Ils comparent des objets entiers, pas ligne par ligne, et Pandas renvoie une erreur :
try:
    df[(df.val1 > 0.5) and (df.val2 == 1)]
except ValueError as erreur:
print(erreur)The truth value of a Series is ambiguous. Use a.empty, a.bool(), a.item(), a.any() or a.all().3. Comment filtrer avec isin() ?
La méthode isin() est une autre façon d'appliquer des conditions multiples : elle garde les lignes dont la valeur existe dans une liste donnée. Par exemple, filtrons les prénoms qui figurent dans une liste :
names = ['Jon', 'Noah', 'Emilie']

df[df.name.isin(names)] name cat val1 val2
1 Noah A 0.58 2
2 Jon C 0.76 1
4 Emilie B 0.27 44. Comment filtrer des textes avec l'accesseur str ?
Pandas est aussi très efficace avec les données textuelles. Les méthodes de l'accesseur str permettent de filtrer les lignes selon le contenu des chaînes de caractères. Par exemple, sélectionnons les prénoms qui commencent par la lettre « A » avec startswith() :
df[df.name.str.startswith('A')] name cat val1 val2
0 Alba A 0.09 6
6 Anna B 0.17 2La méthode contains() renvoie les valeurs qui contiennent un ensemble donné de caractères. Ici, tous les prénoms qui contiennent la lettre « a » :
df[df.name.str.contains('a')] name cat val1 val2
0 Alba A 0.09 6
1 Noah A 0.58 2
6 Anna B 0.17 2Attention à la casse : contains() distingue les majuscules des minuscules. Avec « A » en majuscule, Noah (qui n'a qu'un « a » minuscule) n'est plus sélectionné :
df[df.name.str.contains('A')] name cat val1 val2
0 Alba A 0.09 6
6 Anna B 0.17 2Pour ignorer la casse, ajoute case=False :
df[df.name.str.contains('A', case=False)] name cat val1 val2
0 Alba A 0.09 6
1 Noah A 0.58 2
6 Anna B 0.17 2Tu peux aussi passer à contains() une séquence de caractères plus longue, selon ce que contiennent les chaînes de tes données.
5. Comment inverser un filtre avec le tilde (~) ?
L'opérateur ~ (tilde) représente le « non » dans un filtre. Si tu l'ajoutes avant la condition, Pandas renvoie les lignes qui ne la respectent pas. Ici, les prénoms qui ne commencent pas par « A » :
df[~df.name.str.startswith('A')] name cat val1 val2
1 Noah A 0.58 2
2 Jon C 0.76 1
3 Tom B 0.96 3
4 Emilie B 0.27 4
5 Coco C 0.45 4Le tilde fonctionne avec toutes les conditions, par exemple avec isin() pour exclure une liste de valeurs :
df[~df.name.isin(names)] name cat val1 val2
0 Alba A 0.09 6
3 Tom B 0.96 3
5 Coco C 0.45 4
6 Anna B 0.17 26. Comment filtrer avec query() ?
La méthode query() offre plus de souplesse pour écrire les conditions : on les passe sous forme de chaîne de caractères, avec and et or pour combiner, sans répéter le nom du DataFrame. Par exemple, les lignes de la catégorie B dont la valeur de val1 dépasse 0,5 :
df.query('cat == "B" and val1 > 0.5') name cat val1 val2
3 Tom B 0.96 3Pour utiliser une variable Python dans la condition, fais-la précéder de @ :
seuil = 0.5
df.query('val1 > @seuil') name cat val1 val2
1 Noah A 0.58 2
2 Jon C 0.76 1
3 Tom B 0.96 37. Comment sélectionner les plus grandes ou les plus petites valeurs ?
Parfois, tu n'as pas de plage de valeurs précise : tu veux juste les valeurs les plus grandes ou les plus petites. Les méthodes nlargest() et nsmallest() sélectionnent les lignes qui ont les plus grandes ou les plus petites valeurs d'une colonne. On indique le nombre de lignes et le nom de la colonne :
df.nlargest(3, 'val1') name cat val1 val2
3 Tom B 0.96 3
2 Jon C 0.76 1
1 Noah A 0.58 2df.nsmallest(2, 'val2') name cat val1 val2
2 Jon C 0.76 1
1 Noah A 0.58 2Dans le second exemple, Noah et Anna ont tous les deux la valeur 2 dans val2. Par défaut (keep='first'), Pandas garde la première, Noah. Pour garder toutes les égalités, utilise keep='all'.
8. Comment filtrer avec loc et iloc ?
Les méthodes loc et iloc sélectionnent des lignes ou des colonnes :
loc: par label (l'étiquette de la ligne ou de la colonne) ;iloc: par position (le numéro de la ligne ou de la colonne, en partant de 0).
On peut donc les utiliser pour filtrer, mais ici on sélectionne une partie du DataFrame sans condition. Voici les lignes en position 3 et 4, avec toutes les colonnes :
df.iloc[3:5, :] # lignes en position 3 et 4, toutes les colonnes name cat val1 val2
3 Tom B 0.96 3
4 Emilie B 0.27 4Quand l'index est composé d'entiers, les labels et les positions sont les mêmes, mais les tranches se comportent différemment : la borne de fin est exclue avec iloc (lignes 3 et 4) et incluse avec loc (lignes 3, 4 et 5).
df.loc[3:5, :] # lignes de label 3 à 5, toutes les colonnes name cat val1 val2
3 Tom B 0.96 3
4 Emilie B 0.27 4
5 Coco C 0.45 4Changeons l'index du DataFrame pour mieux voir la différence entre les deux :
df.index = ['a', 'b', 'c', 'd', 'e', 'f', 'g']
df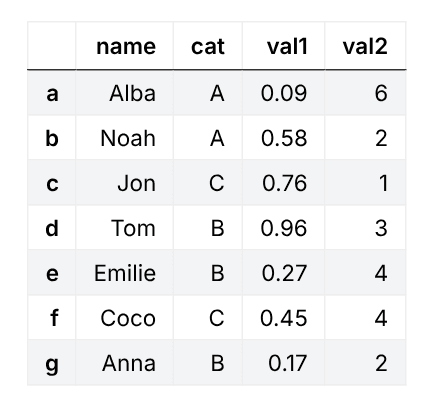
Les labels de l'index sont maintenant des lettres. Avec loc, on utilise ces lettres, et la borne de fin est incluse :
df.loc['b':'d', :] name cat val1 val2
b Noah A 0.58 2
c Jon C 0.76 1
d Tom B 0.96 3Avec iloc, on utilise toujours les positions, de 0 à 6, et la borne de fin est exclue. Les lignes b, c et d sont donc aux positions 1 à 3 :
df.iloc[1:4, :] name cat val1 val2
b Noah A 0.58 2
c Jon C 0.76 1
d Tom B 0.96 3On ne peut plus passer des entiers à loc pour une tranche, puisque les labels sont des lettres :
try:
    df.loc[3:5, :]
except TypeError as erreur:
print(erreur)cannot do slice indexing on Index with these indexers [3] of type intEnfin, loc accepte aussi une condition pour les lignes et une liste de colonnes à garder. C'est la façon la plus propre de filtrer des lignes et de choisir des colonnes en une seule fois :
df.loc[df.val1 > 0.5, ['name', 'val1']] name val1
b Noah 0.58
c Jon 0.76
d Tom 0.96Quelle méthode choisir pour filtrer un DataFrame Pandas ?
- Une condition simple sur une colonne : opérateur de comparaison (
df[df.val1 > 0.5]). - Plusieurs conditions :
&et|avec des parenthèses, ouquery()pour un code plus lisible. - Une liste de valeurs autorisées :
isin(). - Du texte : l'accesseur
str(startswith(),contains()). - L'inverse d'une condition :
~. - Les plus grandes ou plus petites valeurs :
nlargest()etnsmallest(). - Une sélection par label ou par position, avec ou sans condition :
locetiloc.
Questions fréquentes
Comment filtrer un DataFrame Pandas selon une condition ?
Écris la condition sur une colonne, par exemple df.val1 > 0.5, puis passe-la entre crochets : df[df.val1 > 0.5]. Pandas renvoie uniquement les lignes où la condition est vraie. Tu peux aussi utiliser df.query('val1 > 0.5').
Comment filtrer un DataFrame Pandas avec plusieurs conditions ?
Combine les conditions avec & pour « et » et | pour « ou », en mettant chaque condition entre parenthèses : df[(df.val1 > 0.5) & (df.val2 == 1)]. N'utilise pas les mots-clés and et or, qui provoquent une erreur sur des colonnes.
Comment filtrer les lignes d'un DataFrame qui contiennent un texte ?
Utilise l'accesseur str : df[df.name.str.contains('a')] garde les lignes dont la colonne name contient « a ». La méthode distingue les majuscules des minuscules : ajoute case=False pour les ignorer.
Comment exclure des valeurs avec Pandas ?
Ajoute l'opérateur ~ devant la condition pour l'inverser : df[~df.name.isin(['Jon', 'Noah'])] garde toutes les lignes sauf celles de Jon et Noah. Tu peux aussi utiliser != pour exclure une seule valeur.
Quelle est la différence entre loc et iloc dans Pandas ?
loc sélectionne par label, avec une borne de fin incluse dans les tranches ; iloc sélectionne par position, avec une borne de fin exclue. Sur un index de lettres, df.loc['b':'d'] et df.iloc[1:4] donnent les mêmes trois lignes.
Comment sélectionner les n plus grandes valeurs d'une colonne ?
Utilise df.nlargest(3, 'val1') pour les 3 lignes qui ont les plus grandes valeurs de la colonne val1, et df.nsmallest() pour les plus petites. En cas d'égalité, keep='first' (par défaut) garde la première ligne, et keep='all' garde toutes les égalités.
Conclusion
Tu as vu 8 façons de filtrer un DataFrame Pandas : les opérateurs de comparaison, les conditions multiples, isin(), l'accesseur str, le tilde, query(), nlargest() et nsmallest(), et enfin loc et iloc. Toutes sont utiles, et chacune brille dans des cas particuliers. Pour t'entraîner, applique-les à un vrai jeu de données de ton choix et compare les résultats de query() et des conditions entre crochets.
Savoir filtrer un DataFrame, c'est la base ; savoir mener une analyse complète, c'est un métier. Sur DataXp, tu t'entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin sur Pandas :
Merci très intéressant