Selon Forbes, les data scientists passent 60 % de leur temps à nettoyer et organiser les données. Cela montre l’importance du nettoyage et du traitement des données dans un projet de Data Science. Pour l’occasion, je te présente 14 fonctions Pandas qui servent à ces 60 % du temps.
Article mis à jour en novembre 2026 : le code a été retesté sur les vrais fichiers avec pandas 3 et pandas 2.3 (la version de Google Colab). Les fichiers sont maintenant hébergés sur GitHub et se chargent directement depuis Colab. J’ai corrigé deux points : les « espaces » à supprimer sont en réalité des espaces insécables (\xa0), et le match annulé de 1938 apparaît dans les données sous la forme w/o[a]. J’ai aussi remplacé inplace=True par des affectations, plus lisibles et recommandées avec pandas 3, et ajouté une vérification finale des données.
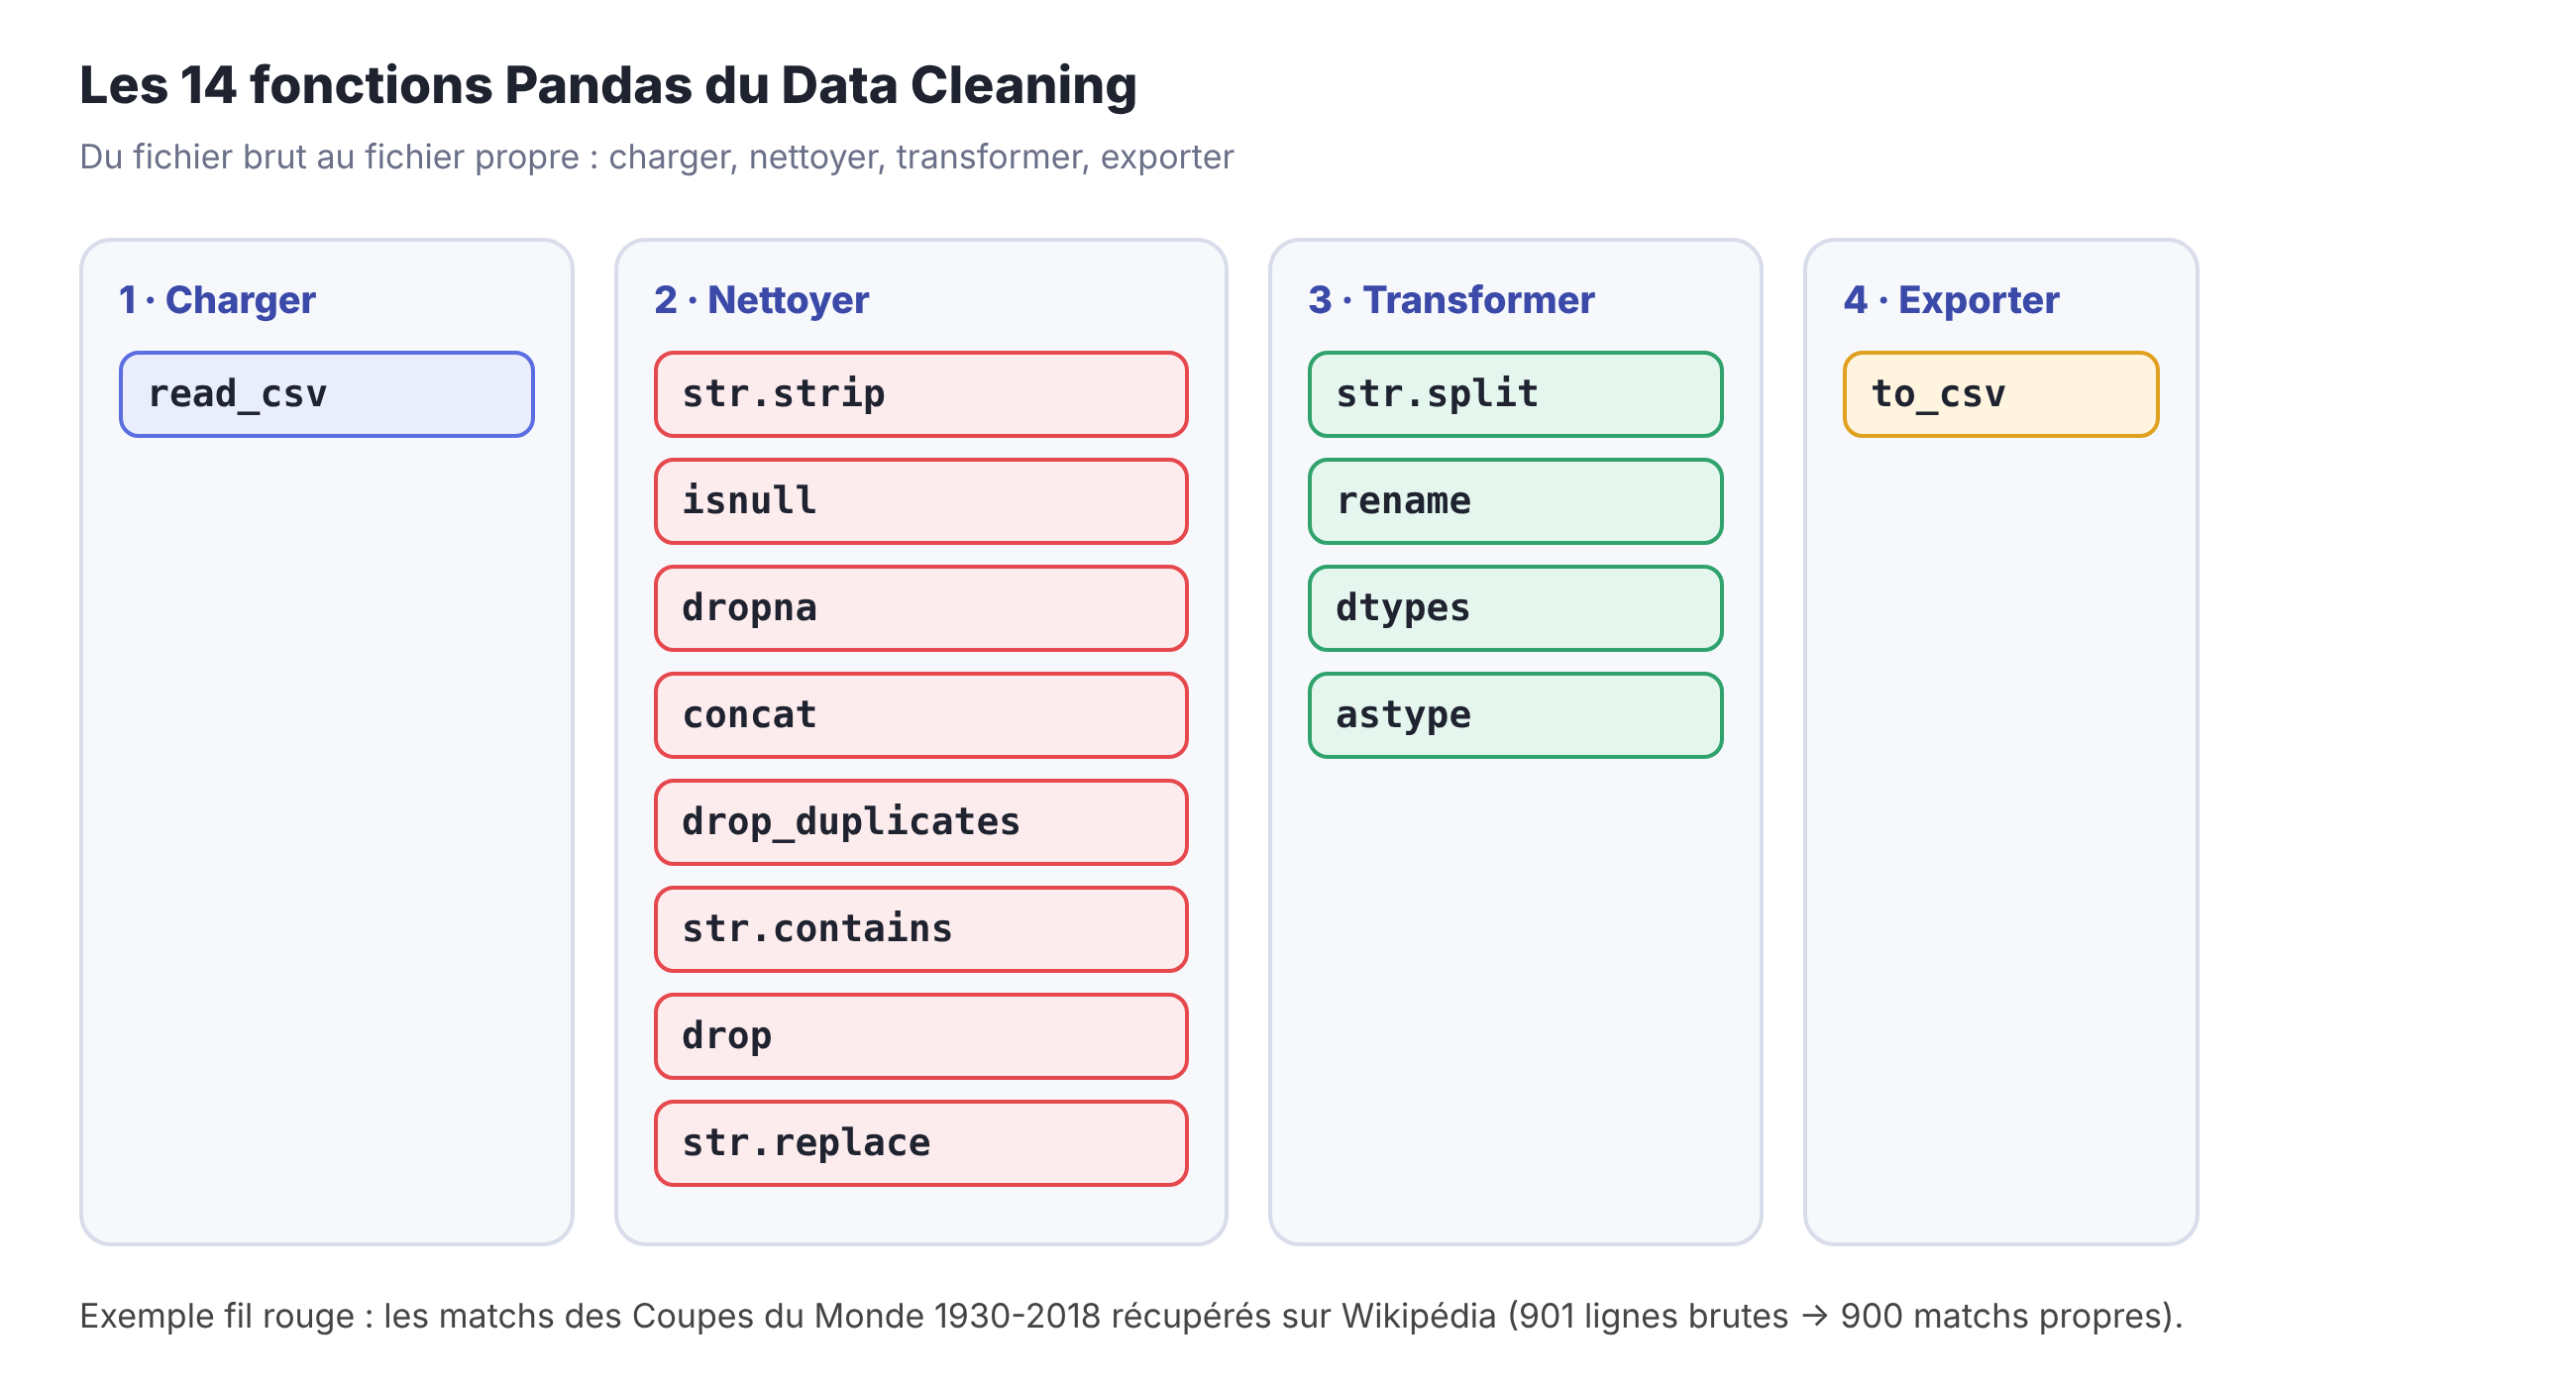
En bref : le nettoyage des données (data cleaning) consiste à corriger les données incorrectes, dupliquées ou incomplètes, puis à les transformer dans un format exploitable. Avec Pandas, 14 fonctions couvrent l’essentiel : read_csv, str.strip, isnull, dropna, concat, drop_duplicates, str.contains, drop, str.replace, str.split, rename, dtypes, astype et to_csv. On les applique ici sur un vrai jeu de données : les matchs des Coupes du Monde de football de 1930 à 2018, soit 901 lignes brutes qui deviennent 900 matchs propres.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Qu’est-ce que le nettoyage de données et pourquoi est-il si important ?
Le nettoyage des données consiste à retirer des données que tu vas utiliser tout ce qui est incorrect, corrompu, dupliqué ou incomplet. Les données du monde réel ne sont pas aussi propres que la plupart des jeux de données d’un cours en ligne : c’est pourquoi le nettoyage est essentiel dans les projets réels.
Une autre étape importante consiste à transformer (wrangle en anglais) les données brutes dans un autre format, pour qu’elles soient prêtes à être analysées. Dans ce guide, on apprend à utiliser 14 fonctions Pandas pour nettoyer et transformer un jeu de données qui servira ensuite à un projet de Data Science.
Comment charger les jeux de données avec read_csv ?
Pour suivre ce tutoriel, tu dois avoir installé Python et Pandas (c’est déjà le cas dans Google Colab). Sur ton ordinateur, installe Pandas avec :
pip install pandasLes données sont un jeu de données de football qui contient les matchs des Coupes du Monde de la FIFA de 1930 à 2022, scrapés sur Wikipédia. Tu peux télécharger les trois fichiers dans le dossier GitHub de cet article. Pour savoir comment ils ont été récoltés, consulte l’article Web scraping des matchs de football des Coupes du Monde : ils viennent d’une version plus ancienne du scraping, c’est pourquoi ils sont incomplets et irréguliers, ce qui fait d’eux un bon terrain d’entraînement.
On lit les trois fichiers CSV avec la fonction pd.read_csv(). Ici, l’adresse du fichier est une adresse web : Pandas sait lire un CSV directement depuis une URL.
import pandas as pd

BASE = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/14-fonctions-pandas-pour-data-science/"

df_historical_data = pd.read_csv(BASE + "fifa_worldcup_matches.csv")
df_fixture = pd.read_csv(BASE + "fifa_worldcup_fixture.csv")
df_missing_data = pd.read_csv(BASE + "fifa_worldcup_missing_data.csv")print(df_historical_data.shape, df_fixture.shape, df_missing_data.shape)(457, 4) (64, 4) (508, 4)On a trois DataFrames : df_historical_data (457 matchs de 1930 à 2018), df_fixture (les 64 matchs de la Coupe du Monde 2022 au programme) et df_missing_data (508 lignes, des matchs manquants dans le premier fichier). Nettoyons-les !
Comment supprimer les espaces inutiles avec str.strip ?
Commençons par df_fixture. Voici ses premières lignes :
df_fixture.head(8)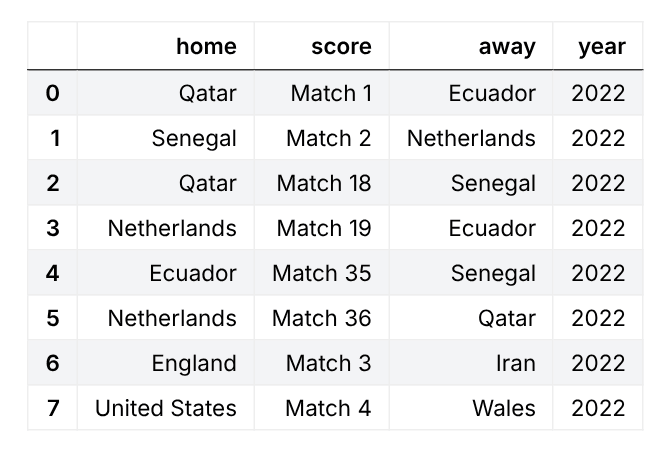
Apparemment, tout va bien, non ? Mais non : il y a un caractère invisible après (ou avant) chaque nom d’équipe. Affichons le contenu de la colonne home avec tolist() pour le voir :
df_fixture["home"].head(3).tolist()['Qatar\xa0', 'Senegal\xa0', 'Qatar\xa0']Les noms se terminent par \xa0, une espace insécable : un espace qui ne se voit pas à l’écran, mais que Pandas considère comme un caractère à part entière. Au lieu de 'Qatar', on a 'Qatar\xa0', et 'Qatar' == 'Qatar\xa0' vaut False : ces caractères gâcheraient toute analyse ultérieure (jointure, regroupement…). La méthode .str.strip() supprime les espaces, y compris insécables, au début et à la fin de chaque texte :
df_fixture["home"] = df_fixture["home"].str.strip()
df_fixture["away"] = df_fixture["away"].str.strip()df_fixture["home"].head(3).tolist()['Qatar', 'Senegal', 'Qatar']C’est tout pour df_fixture. Passons à un autre DataFrame.
Comment repérer les valeurs manquantes avec isnull et les supprimer avec dropna ?
Le problème de df_missing_data est qu’il contient des valeurs manquantes (NaN). On les compte colonne par colonne avec .isnull().sum() :
df_missing_data.isnull().sum()home 64
score 64
away 64
year 0
dtype: int6464 lignes sont entièrement vides. On affiche les 5 premières en utilisant .isnull() comme filtre :
df_missing_data[df_missing_data["home"].isnull()].head(5)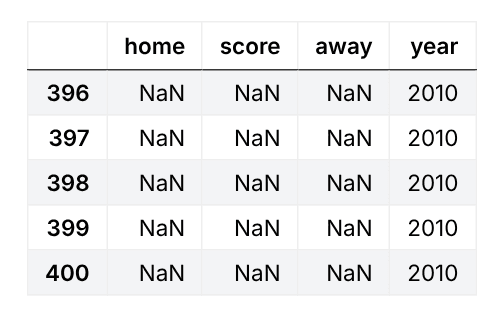
Toutes ces lignes vides datent de 2010 (les vrais matchs de 2010 se trouvent plus loin dans le fichier). On supprime les lignes qui contiennent des NaN avec .dropna() (on réaffecte le résultat à la variable plutôt que d’utiliser inplace=True) :
df_missing_data = df_missing_data.dropna()
df_missing_data.shape(444, 4)Il reste 444 lignes de matchs (508 − 64).
Comment fusionner deux DataFrames avec concat et supprimer les doublons avec drop_duplicates ?
Maintenant que df_missing_data est propre, on l’ajoute aux données historiques avec pd.concat(). Le paramètre ignore_index=True crée un nouvel index continu au lieu de recopier les anciens :
df_historical_data = pd.concat([df_historical_data, df_missing_data], ignore_index=True)
df_historical_data.shape(901, 4)457 + 444 = 901 lignes. Le problème de la fusion de deux DataFrames, c’est qu’on peut obtenir les mêmes données en double. On le vérifie avec .duplicated().sum() :
print(df_historical_data.duplicated().sum())0Il n’y a aucun doublon ici, mais ce contrôle fait partie de la routine : drop_duplicates() supprime les lignes identiques (en gardant la première par défaut). On en profite pour trier le DataFrame par année avec sort_values(). Le paramètre kind="stable" conserve l’ordre d’origine des matchs au sein d’une même année, et reset_index(drop=True) remet l’index en ordre :
df_historical_data = (
df_historical_data
.drop_duplicates()
.sort_values("year", kind="stable")
.reset_index(drop=True)
)
df_historical_data.shape(901, 4)Voici les dernières lignes du DataFrame :
df_historical_data.tail(6)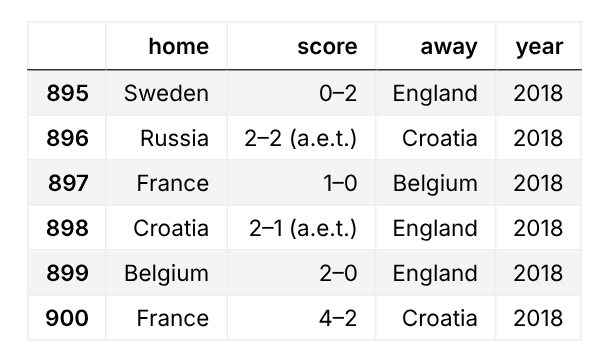
On a bien 901 lignes. Attention : ce ne sont pas 901 matchs joués, comme on le verra juste après.
Comment repérer et supprimer une anomalie avec str.contains et drop ?
Il est temps de nettoyer df_historical_data. On commence par supprimer les anomalies que l’on ne veut pas dans le jeu final. Selon l’objectif du projet, on peut supprimer ou conserver un enregistrement. Ici, je prévois d’utiliser ces données pour prédire le vainqueur de la Coupe du Monde en fonction des buts marqués par chaque équipe. Je ne veux donc pas des matchs terminés par un walkover (w/o), c’est-à-dire un forfait : la victoire est attribuée à une équipe parce que l’autre déclare forfait.
Dans l’histoire de la Coupe du Monde, il y a eu un seul match de ce type : Suède–Autriche en 1938 (l’Autriche a déclaré forfait et la Suède s’est qualifiée sans jouer). Pour le repérer, on cherche la chaîne "w/o" dans la colonne score avec .str.contains() :
df_historical_data[df_historical_data["score"].str.contains("w/o")] home score away year
37 Sweden w/o[a] Austria 1938Le score vaut w/o[a] : le [a] est une note de bas de page de Wikipédia, récupérée avec le texte lors du scraping. On supprime la ligne avec .drop(), en repérant son index grâce aux équipes (Sweden à domicile et Austria à l’extérieur) :
walkover = df_historical_data[
df_historical_data["home"].str.contains("Sweden")
& df_historical_data["away"].str.contains("Austria")
].index
df_historical_data = df_historical_data.drop(index=walkover)
df_historical_data.shape(900, 4)On a maintenant 900 matchs réellement joués.
Comment corriger les incohérences avec une regex et str.replace ?
Les données du monde réel sont incohérentes. Une colonne peut suivre un modèle dans l’aperçu du DataFrame, mais si tu l’explores ligne par ligne, tu peux rencontrer des écarts qui vont gâcher ton projet. Ici, la colonne score suit apparemment le format « buts à domicile – buts à l’extérieur », mais certaines lignes contiennent du texte en plus. Pour les repérer, on utilise une expression régulière (regex).
L’expression [^\d–] correspond à tout caractère qui n’est ni un chiffre (\d) ni un tiret demi-cadratin (–), le séparateur utilisé par Wikipédia dans les scores. Attention : ce n’est pas le trait d’union - du clavier. Le ^ au début des crochets signifie « tout sauf ». Comptons les lignes concernées :
incoherences = df_historical_data[df_historical_data["score"].str.contains(r"[^\d–]")]
len(incoherences)68incoherences.head(6)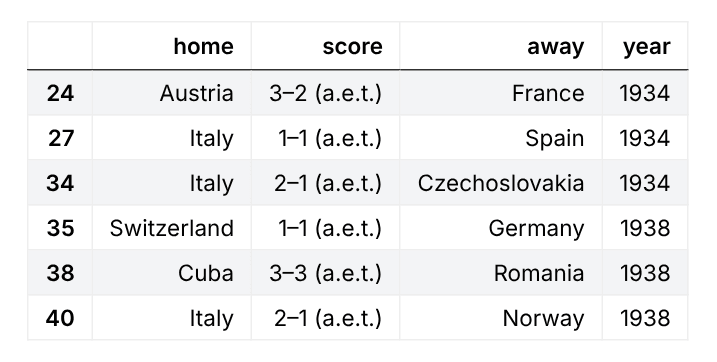
Ces 68 scores contiennent la mention (a.e.t.) (after extra time, c’est-à-dire après prolongation). Pour ne garder que les chiffres et le tiret, on remplace tout le reste par une chaîne vide avec .str.replace(). Le paramètre regex=True indique que le premier argument est une expression régulière. Puis on vérifie qu’il ne reste plus aucune incohérence :
df_historical_data["score"] = df_historical_data["score"].str.replace(r"[^\d–]", "", regex=True)
print(df_historical_data["score"].str.contains(r"[^\d–]").sum())0Avec cette étape, on perd l’information « prolongation ». Si elle t’intéresse, extrais-la dans une colonne avant de nettoyer le score (c’est ce qu’on fait dans l’article de scraping). Enfin, on s’assure que les colonnes home et away ne contiennent plus d’espaces superflus :
df_historical_data["home"] = df_historical_data["home"].str.strip()
df_historical_data["away"] = df_historical_data["away"].str.strip()
df_historical_data["home"].head(3).tolist()['France', 'Argentina', 'Chile']Le nettoyage est terminé ! Il est maintenant temps de transformer les données pour qu’elles soient prêtes à être utilisées dans un projet.
Comment séparer une colonne en deux avec str.split ?
En général, on veut des colonnes qui contiennent uniquement des nombres, sans symbole comme le « – ». Pour s’en débarrasser, on utilise .str.split() avec le paramètre expand=True, qui place chaque morceau dans une colonne distincte. On crée ainsi deux nouvelles colonnes, HomeGoals et AwayGoals, puis on supprime la colonne score avec .drop(columns=...) :
df_historical_data[["HomeGoals", "AwayGoals"]] = df_historical_data["score"].str.split("–", expand=True)
df_historical_data = df_historical_data.drop(columns="score")
df_historical_data.head(3) home away year HomeGoals AwayGoals
0 France Mexico 1930 4 1
1 Argentina France 1930 1 0
2 Chile Mexico 1930 3 0Comment renommer des colonnes avec rename et changer leur type avec astype ?
Renommons les colonnes pour qu’elles aient une meilleure apparence, avec .rename() et un dictionnaire « ancien nom : nouveau nom ». On regarde ensuite le type de chaque colonne avec l’attribut .dtypes :
df_historical_data = df_historical_data.rename(
columns={"home": "HomeTeam", "away": "AwayTeam", "year": "Year"}
)
df_historical_data.dtypesHomeTeam object
AwayTeam object
Year int64
HomeGoals object
AwayGoals object
dtype: objectLes colonnes HomeGoals et AwayGoals sont de type object (avec pandas 3, tu verras str à la place de object pour les colonnes de texte) : ce sont des textes, pas des nombres, car split produit toujours du texte. On les convertit en entiers avec .astype() :
df_historical_data = df_historical_data.astype({"HomeGoals": int, "AwayGoals": int})
df_historical_data.dtypesHomeTeam object
AwayTeam object
Year int64
HomeGoals int64
AwayGoals int64
dtype: objectComment vérifier que le nettoyage est complet ?
Un nettoyage n’est fini que lorsqu’on a vérifié le résultat. Ici, on contrôle le nombre de matchs, le total de buts, et le nombre de matchs de chaque Coupe du Monde :
buts = df_historical_data["HomeGoals"].sum() + df_historical_data["AwayGoals"].sum()
print("Matchs :", len(df_historical_data), "| Buts :", buts)
df_historical_data.groupby("Year").size().to_dict()Matchs : 900 | Buts : 2548
{1930: 18, 1934: 17, 1938: 18, 1950: 22, 1954: 26, 1958: 35, 1962: 32, 1966: 32, 1970: 32, 1974: 38, 1978: 38, 1982: 52, 1986: 52, 1990: 52, 1994: 52, 1998: 64, 2002: 64, 2006: 64, 2010: 64, 2014: 64, 2018: 64}On retrouve 900 matchs et 2 548 buts, ce qui correspond au total relevé sur Wikipédia pour les 21 Coupes du Monde de 1930 à 2018. Les effectifs par édition sont ceux attendus : 18 matchs en 1930, 52 de 1982 à 1994 (24 équipes) et 64 à partir de 1998 (32 équipes). Tous les matchs sont bien là, y compris ceux de 2010 qui étaient vides au départ.
Comment exporter les DataFrames propres avec to_csv ?
Enfin, on exporte les jeux de données propres vers des fichiers CSV avec .to_csv(). Le paramètre index=False évite d’écrire l’index dans le fichier :
df_historical_data.to_csv("clean_fifa_worldcup_matches.csv", index=False)
df_fixture.to_csv("clean_fifa_worldcup_fixture.csv", index=False)Voilà, c’est fait ! Nos données sont maintenant prêtes à être utilisées dans notre projet de prédiction du vainqueur de la Coupe du Monde.
Tout le code de l’article
Voici le code complet, de la lecture des trois fichiers à l’export des fichiers propres :
import pandas as pd

BASE = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/14-fonctions-pandas-pour-data-science/"

df_historical_data = pd.read_csv(BASE + "fifa_worldcup_matches.csv")
df_fixture = pd.read_csv(BASE + "fifa_worldcup_fixture.csv")
df_missing_data = pd.read_csv(BASE + "fifa_worldcup_missing_data.csv")
# 1. Nettoyer df_fixture
df_fixture["home"] = df_fixture["home"].str.strip()
df_fixture["away"] = df_fixture["away"].str.strip()
# 2. Supprimer les lignes vides de df_missing_data et fusionner
df_missing_data = df_missing_data.dropna()
df_historical_data = pd.concat([df_historical_data, df_missing_data], ignore_index=True)
df_historical_data = (
df_historical_data
.drop_duplicates()
.sort_values("year", kind="stable")
.reset_index(drop=True)
)
# 3. Supprimer le walkover Suède - Autriche (1938)
walkover = df_historical_data[
df_historical_data["home"].str.contains("Sweden")
& df_historical_data["away"].str.contains("Austria")
].index
df_historical_data = df_historical_data.drop(index=walkover)
# 4. Corriger les scores et les noms d'équipes
df_historical_data["score"] = df_historical_data["score"].str.replace(r"[^\d–]", "", regex=True)
df_historical_data["home"] = df_historical_data["home"].str.strip()
df_historical_data["away"] = df_historical_data["away"].str.strip()
# 5. Transformer : séparer le score, renommer, convertir
df_historical_data[["HomeGoals", "AwayGoals"]] = df_historical_data["score"].str.split("–", expand=True)
df_historical_data = df_historical_data.drop(columns="score")
df_historical_data = df_historical_data.rename(
columns={"home": "HomeTeam", "away": "AwayTeam", "year": "Year"}
)
df_historical_data = df_historical_data.astype({"HomeGoals": int, "AwayGoals": int})
# 6. Exporter
df_historical_data.to_csv("clean_fifa_worldcup_matches.csv", index=False)
df_fixture.to_csv("clean_fifa_worldcup_fixture.csv", index=False)
df_historical_data.head() HomeTeam AwayTeam Year HomeGoals AwayGoals
0 France Mexico 1930 4 1
1 Argentina France 1930 1 0
2 Chile Mexico 1930 3 0
3 Chile France 1930 1 0
4 Argentina Mexico 1930 6 3Questions fréquentes
Quelles sont les principales fonctions Pandas pour nettoyer des données ?
Les plus utiles sont read_csv (charger), str.strip (supprimer les espaces), isnull et dropna (valeurs manquantes), concat et drop_duplicates (fusionner et supprimer les doublons), str.contains, drop et str.replace (repérer et corriger des anomalies), str.split, rename et astype (transformer les colonnes) et to_csv (exporter).
Pourquoi dit-on que les data scientists passent 60 % de leur temps à nettoyer les données ?
Ce chiffre vient d’une enquête relayée par Forbes en 2016 : les data scientists consacrent environ 60 % de leur temps à nettoyer et organiser les données. Les données du monde réel contiennent des valeurs manquantes, des doublons, des espaces invisibles ou des formats incohérents, qu’il faut corriger avant toute analyse.
Comment supprimer les espaces dans une colonne avec Pandas ?
Utilise df[“colonne”].str.strip(), qui supprime les espaces au début et à la fin de chaque texte, y compris les espaces insécables (\xa0) souvent présents dans les données copiées depuis le web. str.lstrip() et str.rstrip() ne nettoient que le début ou que la fin.
Quelle est la différence entre dropna et fillna ?
dropna() supprime les lignes (ou les colonnes) qui contiennent des valeurs manquantes, alors que fillna() les remplace par une valeur de ton choix (0, la moyenne, la valeur précédente…). On supprime quand les lignes sont inutilisables, comme des lignes entièrement vides, et on remplace quand on veut conserver les lignes.
Comment supprimer les doublons d’un DataFrame ?
Compte-les avec df.duplicated().sum(), puis supprime-les avec df.drop_duplicates(). Par défaut, la première ligne est conservée. Avec le paramètre subset, tu choisis les colonnes à comparer, et avec keep=”last” tu gardes la dernière ligne plutôt que la première.
Faut-il encore utiliser inplace=True avec Pandas ?
Non, ce n’est pas recommandé. Avec pandas 3 (Copy-on-Write), il vaut mieux réaffecter le résultat : df = df.dropna(). Le code est plus lisible, il s’enchaîne facilement avec d’autres méthodes et il évite les modifications silencieuses d’une copie.
Conclusion
Tu connais maintenant 14 fonctions Pandas pour nettoyer et transformer des données : charger les fichiers, repérer les espaces invisibles, les valeurs manquantes, les doublons et les anomalies, corriger un format avec une regex, séparer une colonne, convertir les types et exporter le résultat. Pour t’entraîner, applique la même démarche à un autre jeu de données du monde réel et vérifie toujours le résultat à la fin (nombre de lignes, totaux, types).
Nettoyer des données, c’est 60 % du métier de data scientist ; savoir le faire vite et proprement fait la différence sur un projet. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin, voici des articles qui pourraient te plaire :