Comment écrire du code Python comme un développeur expérimenté ? Pas en connaissant plus de syntaxe, mais en prenant quelques habitudes qui rendent ton code plus clair, plus sûr et plus facile à relire. Ce sont ces détails que tes collègues remarquent en relisant ta pull request, et que les recruteurs repèrent en entretien technique.
Dans ce guide, je compare, exemples exécutables à l’appui, le code d’un développeur débutant et celui d’un développeur expérimenté sur 6 points : le choix du type d’itérable, les conventions de nommage, les comparaisons, les exceptions, les indications de type avec les docstrings, et le logging.
Article mis à jour en novembre 2026 : tout le code a été exécuté avec Python 3.13 et les vraies sorties sont affichées. J’ai corrigé plusieurs points de la première version : PEP 8 recommande if x: plutôt que is True pour un booléen, raise ... from remplace .with_traceback(), le test d’itérabilité avec iter() laissait passer les générateurs, et l’exemple de logging n’affichait rien tant que basicConfig() n’était pas appelé. J’ai aussi ajouté des mesures de performance, la vérification automatique avec ruff et mypy, et un test de docstring avec doctest.
En bref : un code senior se reconnaît à 6 habitudes. 1) Il choisit le bon type : un set pour tester une présence (jusqu’à 208 706 fois plus rapide qu’une liste sur 1 000 000 d’éléments dans mon test), un tuple pour une suite figée. 2) Il suit la PEP 8 : snake_case pour les variables et fonctions, CapWords pour les classes, MAJUSCULES pour les constantes. 3) Il compare avec if x: et is None, jamais == None ni != []. 4) Il lève des exceptions avec un message utile. 5) Il ajoute des indications de type et des docstrings, vérifiées par mypy. 6) Il utilise logging plutôt que print().
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : il n’y a aucun fichier à télécharger.
Comment choisir le bon type d’itérable en Python ?
Un itérable est un objet que Python peut parcourir élément par élément, par exemple dans une boucle for (voir la définition officielle). Un débutant utilise une liste partout. Un développeur expérimenté choisit le type selon ce qu’il veut faire des données :
- La liste (
list) : ordonnée, modifiable, accepte les doublons. C’est le bon choix pour une séquence qui évolue. - L’ensemble (
set) : valeurs uniques, sans ordre, modifiable. Il est fait pour tester si un élément est présent. - Le tuple (
tuple) : ordonné et non modifiable. Il convient à une suite de valeurs qui ne doit pas changer. - Le dictionnaire (
dict) : associe une clé à une valeur, avec une recherche par clé aussi rapide que dans un set.
Quand utiliser un set plutôt qu’une liste ?
Prenons un cas simple : prévenir l’utilisateur quand un nom d’utilisateur est déjà pris. Voici la version courante, avec une liste :
pris = ["Tom123", "Léa"]            # une liste
demandes = ["Tom123", "Sofia42"]

for nom in demandes:
    if nom not in pris:
        pris.append(nom)
    else:
print(f"Le nom '{nom}' est déjà pris !")Le nom 'Tom123' est déjà pris !Les noms pris sont uniques, et on ne fait que vérifier leur présence : il n’y a aucune raison d’utiliser une liste. Avec un set, le résultat est identique :
pris = {"Tom123", "Léa"}            # un ensemble (set)
demandes = ["Tom123", "Sofia42"]

for nom in demandes:
    if nom not in pris:
        pris.add(nom)
    else:
print(f"Le nom '{nom}' est déjà pris !")Le nom 'Tom123' est déjà pris !Les deux versions affichent la même chose, mais elles ne coûtent pas la même chose. Pour savoir si x in liste est vrai, Python compare x à chaque élément, l’un après l’autre : plus la liste est longue, plus c’est lent. Un set utilise une table de hachage : il va directement à l’endroit où l’élément devrait se trouver. Voici la mesure avec le dernier élément, qui est le pire cas pour la liste :
import timeit

resultats = []
for n in (1_000, 10_000, 100_000, 1_000_000):
    liste = list(range(n))
    ensemble = set(liste)
    cible = n - 1                      # pire cas pour la liste : le dernier élément
    t_liste = timeit.timeit("cible in liste", globals=globals(), number=20) / 20
    t_set = timeit.timeit("cible in ensemble", globals=globals(), number=20000) / 20000
    resultats.append((n, t_liste, t_set))
print(f"{n:>9,} éléments | liste : {t_liste * 1e6:10.1f} µs | set : {t_set * 1e6:5.2f} µs | rapport : x{t_liste / t_set:,.0f}") 1,000 éléments | liste : 8.2 µs | set : 0.05 µs | rapport : x174
10,000 éléments | liste : 81.0 µs | set : 0.04 µs | rapport : x1,886
100,000 éléments | liste : 800.7 µs | set : 0.04 µs | rapport : x18,645
1,000,000 éléments | liste : 8716.3 µs | set : 0.04 µs | rapport : x208,706Sur 1 000 éléments, la liste met 8,2 µs contre 0,05 µs pour le set. Sur 1 000 000 d’éléments, la liste demande environ 8,7 ms pour une seule recherche, le set toujours environ 0,04 µs. Le temps de la liste augmente avec la taille, celui du set reste plat (les valeurs exactes dépendent de ta machine) :
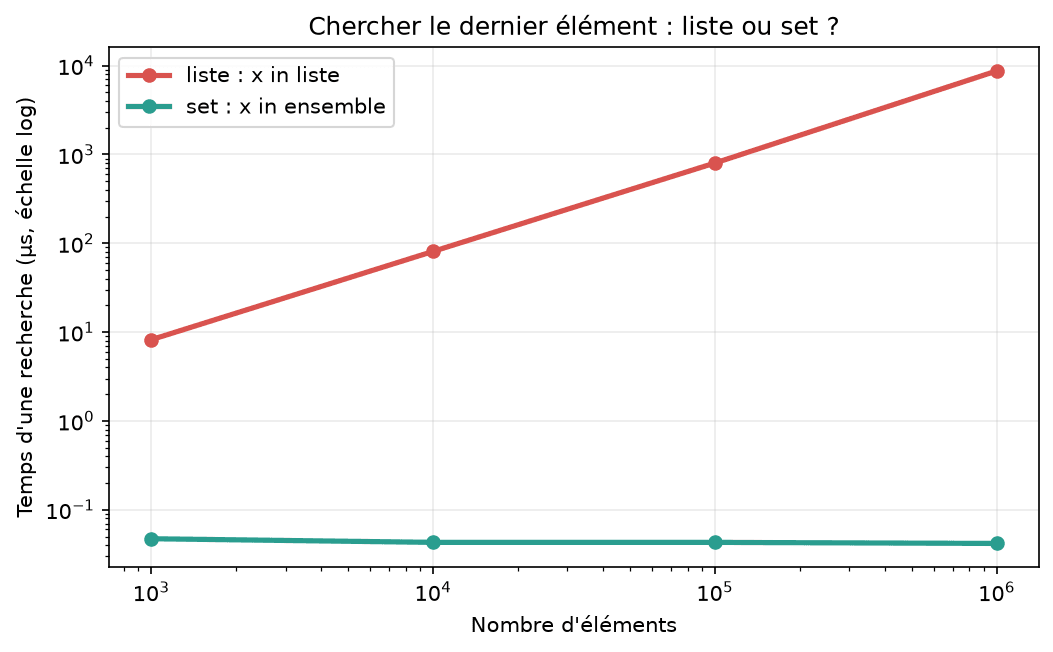
Retiens la règle : pour tester une présence dans une grande collection, convertis-la en set (ou utilise-le dès le départ). Si l’ordre ou les doublons comptent, garde la liste.
Quand utiliser un tuple ?
Pour une suite de valeurs qui ne doit pas changer pendant l’exécution (les jours de la semaine, des coordonnées, des mots interdits), utilise un tuple, et écris son nom en majuscules : c’est une constante. Python protège alors ta constante d’une modification accidentelle, et le tuple occupe un peu moins de mémoire :
import sys

jours_liste = ["Lundi", "Mardi", "Mercredi", "Jeudi", "Vendredi"]
JOURS = ("Lundi", "Mardi", "Mercredi", "Jeudi", "Vendredi")

print("liste :", sys.getsizeof(jours_liste), "octets")
print("tuple :", sys.getsizeof(JOURS), "octets")

try:
    JOURS[0] = "Dimanche"
except TypeError as erreur:
print("TypeError :", erreur)liste : 104 octets
tuple : 80 octets
TypeError : 'tuple' object does not support item assignmentTu vois que JOURS est écrit en majuscules : c’est une convention de nommage. C’est le sujet de la section suivante.
Quelles conventions de nommage suivre en Python ?
Il existe deux sortes de règles pour les noms en Python. Les règles imposées par l’interpréteur : un nom ne peut pas commencer par un chiffre ni contenir de tiret. Et les conventions de nommage, décrites dans la PEP 8, que Python n’impose pas mais que tout développeur Python respecte. Voici ce que Python répond quand tu enfreins une règle imposée :
for code in ["2e_nom = 'John'", "second-nom = 'John'"]:
    try:
        compile(code, "<test>", "exec")
    except SyntaxError as erreur:
print(f"{code:<20} -> SyntaxError : {erreur.msg}")2e_nom = 'John' -> SyntaxError : invalid decimal literal
second-nom = 'John' -> SyntaxError : cannot assign to expression here. Maybe you meant '==' instead of '='?Les conventions, elles, ne produisent aucune erreur. Les voici :
- Variables, fonctions et méthodes : minuscules séparées par des tirets bas (
prenom,charger_donnees) - Classes : CapWords, sans tiret bas (
Cercle,GareDeTrain) - Constantes : majuscules séparées par des tirets bas (
PI,MOTS_INTERDITS) - Modules (les noms de fichiers) : minuscules, avec des tirets bas si nécessaire (
calculs.py,preparation_donnees.py)
À quoi ressemble un code qui respecte la PEP 8 ?
Voici un fichier cercle.py qui respecte les conventions :
PI = 3.14159  # la valeur ne change pas : c'est une constante


class Cercle:
    def __init__(self, rayon: float):
        self.rayon = rayon

    @property
    def aire(self):
        return (self.rayon ** 2) * PI

    @property
    def perimetre(self):
        return 2 * self.rayon * PI


petit_cercle = Cercle(1)
grand_cercle = Cercle(5)

print(f"Aire du petit cercle = {petit_cercle.aire}")
print(f"Périmètre du grand cercle = {grand_cercle.perimetre}")Et un code qui ne les respecte pas ?
Voici le même programme, sans les conventions, dans un fichier CERCLE.py :
Pi = 3.14159


class CERCLE:
    def __init__(Self, RAYON: float):
        Self.Rayon = RAYON

    @property
    def AIRE(Self):
        return (Self.Rayon ** 2) * Pi

    @property
    def PERIMETRE(Self):
        return 2 * Self.Rayon * Pi


PetitCERCLE = CERCLE(1)
GrandCERCLE = CERCLE(5)

print(f"Aire du petit cercle = {PetitCERCLE.AIRE}")
print(f"Périmètre du grand cercle = {GrandCERCLE.PERIMETRE}")Les deux fonctionnent et donnent exactement le même résultat :
python cercle.py
echo "---"
python CERCLE.pyAire du petit cercle = 3.14159
Périmètre du grand cercle = 31.4159
---
Aire du petit cercle = 3.14159
Périmètre du grand cercle = 31.4159Pourtant, le second est difficile à lire : on ne distingue plus une classe, une constante et une variable, et Self à la place de self fait douter de la maîtrise de Python. Tu n’as pas à t’en souvenir seul : un linter comme ruff détecte ces écarts automatiquement. La règle --select N active les contrôles de nommage :
ruff check --select N --output-format concise cercle.py CERCLE.pyCERCLE.py:5:18: N803 Argument name `Self` should be lowercase
CERCLE.py:5:18: N805 First argument of a method should be named `self`
CERCLE.py:5:24: N803 Argument name `RAYON` should be lowercase
CERCLE.py:9:9: N802 Function name `AIRE` should be lowercase
CERCLE.py:9:14: N803 Argument name `Self` should be lowercase
CERCLE.py:9:14: N805 First argument of a method should be named `self`
CERCLE.py:13:9: N802 Function name `PERIMETRE` should be lowercase
CERCLE.py:13:19: N803 Argument name `Self` should be lowercase
CERCLE.py:13:19: N805 First argument of a method should be named `self`
Found 9 errors.
3 unsafe fixes available with `--fix --unsafe-fixes`.ruff trouve 9 écarts, tous dans le second fichier. Un dépôt qui lance ruff à chaque commit garde un style homogène sans effort.
Comment écrire de bonnes comparaisons en Python ?
Python permet d’écrire de nombreuses façons presque identiques une même comparaison. Elles ne se valent pas. Prenons une petite fonction. Au passage, un débutant écrit souvent return True if x % 2 == 0 else False : l’expression x % 2 == 0 est déjà un booléen, il suffit de la renvoyer.
def est_pair(x):
    return x % 2 == 0

x = 10
if est_pair(x) == True:
    print(f"{x} est pair (== True)")

if est_pair(x) is True:
    print(f"{x} est pair (is True)")

if est_pair(x):
print(f"{x} est pair (sans comparaison)")10 est pair (== True)
10 est pair (is True)
10 est pair (sans comparaison)Les trois tests donnent le même résultat. Le dernier, if est_pair(x):, est le plus lisible et celui que recommande la PEP 8 pour un booléen : écrire == True ajoute du bruit, et is True est classé « pire » encore.
Qu’est-ce qui est considéré comme vrai ou faux en Python ?
Le dernier test fonctionne parce que Python peut évaluer n’importe quel objet comme un booléen. Presque tout est vrai, sauf les séquences et collections vides, le nombre 0 (entier ou décimal), None et False :
valeurs = [[], (), set(), {}, "", 0, 0.0, None, False, [0], "0", " ", 0.1, -1]

for v in valeurs:
print(f"{v!r:<7} -> {bool(v)}")[] -> False
() -> False
set() -> False
{} -> False
'' -> False
0 -> False
0.0 -> False
None -> False
False -> False
[0] -> True
'0' -> True
' ' -> True
0.1 -> True
-1 -> TrueAttention : [0] et '0' sont vrais, car ils ne sont pas vides. Cette règle permet d’écrire if elements: pour dire « si la collection contient quelque chose ». On voit souvent if elements != []:, mais ce test est fragile : un ensemble vide n’est pas égal à une liste vide.
def afficher_v1(elements):
    if elements != []:
        for e in elements:
            print(e)
    else:
        raise ValueError("liste vide, rien à afficher")

def afficher_v2(elements):
    if elements:
        for e in elements:
            print(e)
    else:
        raise ValueError("collection vide, rien à afficher")

for fonction in (afficher_v1, afficher_v2):
    try:
        fonction(set())
        print(fonction.__name__, "-> aucune erreur, rien affiché")
    except ValueError as erreur:
print(fonction.__name__, "-> ValueError :", erreur)afficher_v1 -> aucune erreur, rien affiché
afficher_v2 -> ValueError : collection vide, rien à afficherAvec != [], un set vide passe le test et la fonction ne lève aucune erreur : le bug est silencieux. Avec if elements:, le cas est traité pour tous les types de collections.
Pourquoi comparer avec is None plutôt que == None ?
None est un objet unique en Python (un singleton). La PEP 8 demande de le comparer avec is ou is not, jamais avec ==. Mais attention à l’inverse : n’utilise pas if valeur: pour tester qu’une valeur existe, car 0, une chaîne vide ou une liste vide sont « faux » sans être absents :
reduction = 0                          # 0 % de réduction : une vraie valeur

if reduction:
    print("if reduction          -> réduction appliquée")
else:
    print("if reduction          -> traitée comme « absente » (piège)")

if reduction is not None:
print("if reduction is not None -> valeur bien reconnue")if reduction -> traitée comme « absente » (piège)
if reduction is not None -> valeur bien reconnueUne réduction de 0 % est une vraie valeur, pas une absence. Pour savoir si une valeur est présente, écris if valeur is not None:.
Quand utiliser is True ou is False ?
Presque jamais, mais il existe un cas utile : distinguer le booléen True d’une valeur seulement « vraie ». Et il y a un piège avec NumPy et Pandas, dont les comparaisons renvoient leur propre type de booléen :
import numpy as np

un = 1
print(un == True, un is True)

valeur = (np.array([3]) > 2)[0]       # un booléen NumPy
print(type(valeur).__name__, valeur == True, valeur is True)True False
bool True FalseLe 1 est égal à True sans être True, et le booléen NumPy (numpy.bool) n’est pas le True de Python : is True renvoie False. Dans un code de Data Science, if resultat: est donc le choix le plus sûr.
Comment lever des exceptions informatives en Python ?
Un développeur débutant lève rarement ses propres exceptions : il laisse Python échouer là où ça casse. Un développeur expérimenté vérifie ce qui peut mal tourner et échoue tôt, avec un message qui dit quoi corriger. Voici une moyenne appelée avec une liste vide :
def moyenne_v1(notes):
    return sum(notes) / len(notes)

def moyenne_v2(notes):
    if not notes:
        raise ValueError("'notes' est vide : impossible de calculer une moyenne")
    return sum(notes) / len(notes)

for fonction in (moyenne_v1, moyenne_v2):
    try:
        fonction([])
    except Exception as erreur:
print(f"{fonction.__name__} -> {type(erreur).__name__} : {erreur}")moyenne_v1 -> ZeroDivisionError : division by zero
moyenne_v2 -> ValueError : 'notes' est vide : impossible de calculer une moyenneLe message division by zero ne dit pas d’où vient le problème. Dans le code d’un collègue, il faut remonter la pile pour comprendre qu’une liste était vide. Le ValueError de la seconde version le dit directement.
Pourquoi un échec silencieux est-il pire qu’une erreur ?
Reprenons une fonction qui affiche chaque élément d’un itérable. La version la plus simple fonctionne, mais lorsqu’on lui donne une liste vide, rien ne se passe, et on ne sait pas si c’est normal :
def afficher_chaque(elements):
    for element in elements:
        print(element)

afficher_chaque([])
print("Fin : aucune erreur, mais aucun résultat non plus. Est-ce normal ?")

try:
    afficher_chaque(42)
except TypeError as erreur:
print("TypeError :", erreur)Fin : aucune erreur, mais aucun résultat non plus. Est-ce normal ?
TypeError : 'int' object is not iterablePour un objet non itérable, le message de Python est déjà clair. En revanche, le cas de la liste vide est silencieux : c’est celui qu’il faut traiter.
Pourquoi if items ne suffit-il pas toujours ?
Dans la section précédente, on testait la présence d’éléments avec if elements:. Cela marche pour les listes, sets, tuples et dictionnaires, mais pas pour tous les itérables :
import numpy as np

try:
    if np.array([1, 2]):
        pass
except ValueError as erreur:
    print("tableau NumPy :", erreur)

generateur = (n for n in [])           # un générateur vide
print("générateur vide, bool() :", bool(generateur))tableau NumPy : The truth value of an array with more than one element is ambiguous. Use a.any() or a.all()
générateur vide, bool() : TrueUn tableau NumPy de plus d’un élément refuse d’être converti en booléen, et un générateur est toujours « vrai », même vide : on ne peut pas savoir s’il contient quelque chose sans le consommer. Le test iter(items) de la première version de cet article laissait donc passer les générateurs. Une solution plus fiable est d’exiger une Collection (un objet qui a une taille, qu’on peut parcourir et dans lequel on peut tester la présence) et de tester sa longueur :
from collections.abc import Collection

def afficher_chaque(elements):
    if not isinstance(elements, Collection):
        raise TypeError(f"'elements' doit être une collection (liste, set, tuple...), pas {type(elements).__name__}")
    if len(elements) == 0:
        raise ValueError("'elements' ne doit pas être vide")
    for element in elements:
        print(element)

import numpy as np

essais = [["a", "b"], set(), 42, (n for n in range(3)), np.array([])]
for essai in essais:
    try:
        afficher_chaque(essai)
    except (TypeError, ValueError) as erreur:
print(f"{type(erreur).__name__} : {erreur}")a
b
ValueError : 'elements' ne doit pas être vide
TypeError : 'elements' doit être une collection (liste, set, tuple...), pas int
TypeError : 'elements' doit être une collection (liste, set, tuple...), pas generator
ValueError : 'elements' ne doit pas être videChaque entrée reçoit un message précis : la liste et le tableau NumPy vides déclenchent ValueError, et l’entier et le générateur déclenchent TypeError avec le type reçu.
Comment relever une exception sans perdre la cause d’origine ?
Quand tu attrapes une erreur pour la remplacer par un message plus parlant, chaîne les deux avec raise ... from. Python garde la cause d’origine dans l’attribut __cause__ et l’affiche dans la trace d’erreur :
def convertir_age(texte):
    try:
        return int(texte)
    except ValueError as erreur:
        raise ValueError(f"âge invalide : {texte!r} n'est pas un entier") from erreur

try:
    convertir_age("abc")
except ValueError as erreur:
    print("erreur :", erreur)
print("cause :", repr(erreur.__cause__))erreur : âge invalide : 'abc' n'est pas un entier
cause : ValueError("invalid literal for int() with base 10: 'abc'")C’est la méthode recommandée. Elle remplace .with_traceback(), qui sert surtout à manipuler des traces avancées.
Pourquoi ajouter des indications de type et des docstrings ?
Les indications de type (type hints, apparues avec Python 3.5) déclarent le type attendu d’un argument et d’un résultat. Les docstrings décrivent ce que fait une fonction, directement dans son code. Ensemble, ils rendent une fonction compréhensible sans lire son contenu. Voici un exemple minimal, dans un fichier exclamation.py :
def ajouter_point_exclamation(phrase: str) -> str:
    return f"{phrase} !"


print(ajouter_point_exclamation("Bonjour"))
print(ajouter_point_exclamation(42))Python n’impose pas ces types à l’exécution : si on passe un entier à une fonction qui attend une chaîne, le programme tourne quand même.
python exclamation.pyBonjour !
42 !Comment vérifier les types avec mypy ?
C’est un outil de vérification statique comme mypy qui exploite ces indications, avant même d’exécuter le code (ton éditeur, comme VS Code ou PyCharm, fait la même chose en direct) :
mypy exclamation.pyexclamation.py:6: error: Argument 1 to "ajouter_point_exclamation" has incompatible type "int"; expected "str" [arg-type]
Found 1 error in 1 file (checked 1 source file)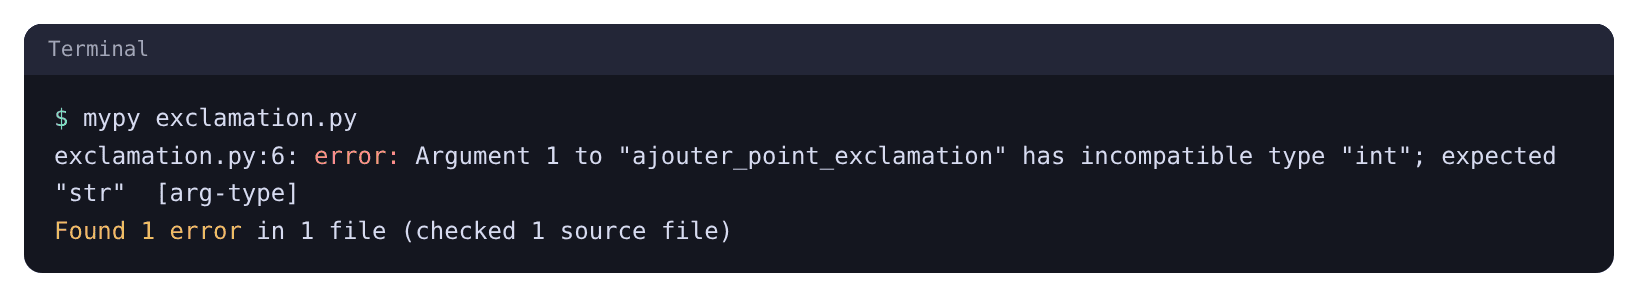
mypy signale la ligne 6 : l’argument est un int alors que la fonction attend un str. Le bug est repéré sans rien lancer.
Quelle syntaxe de type hints utiliser aujourd’hui ?
Depuis Python 3.9, tu peux écrire list[str] directement, sans importer List de typing. Depuis Python 3.10, str | None remplace Optional[str]. Pour les types abstraits, importe-les depuis collections.abc, comme Collection plus haut.
def trouver_prenom(prenoms: list[str], recherche: str) -> str | None:
    """Renvoie le prénom trouvé, ou None s'il est absent."""
    for prenom in prenoms:
        if prenom.lower() == recherche.lower():
            return prenom
    return None

print(trouver_prenom(["Léa", "Tom"], "tom"))
print(trouver_prenom(["Léa", "Tom"], "Sofia"))Tom
NoneComment écrire une bonne docstring ?
Une bonne docstring dit ce que fait la fonction, décrit ses paramètres, les exceptions qu’elle peut lever, et donne un exemple. Le format numpydoc ci-dessous est très répandu en Data Science (voir aussi la PEP 257). Voici la fonction complète, avec type hints et docstring :
from collections.abc import Collection

def afficher_chaque(elements: Collection) -> None:
    """Affiche chaque élément d'une collection.

    Paramètres
    ----------
    elements : Collection
        Une collection non vide (liste, set, tuple...).

    Lève
    ----
    TypeError
        Si ``elements`` n'est pas une collection.
    ValueError
        Si ``elements`` est vide.

    Exemples
    --------
    >>> afficher_chaque([1, 2, 3])
    1
    2
    3
    >>> afficher_chaque([])
    Traceback (most recent call last):
        ...
    ValueError: 'elements' ne doit pas être vide
    """
    if not isinstance(elements, Collection):
        raise TypeError(f"'elements' doit être une collection (liste, set, tuple...), pas {type(elements).__name__}")
    if len(elements) == 0:
        raise ValueError("'elements' ne doit pas être vide")
    for element in elements:
print(element)Les outils savent maintenant l’exploiter. La commande help() (ou le survol dans ton éditeur) affiche la documentation :
help(afficher_chaque)Help on function afficher_chaque in module __main__:
afficher_chaque(elements: collections.abc.Collection) -> None
Affiche chaque élément d'une collection.
Paramètres
----------
elements : Collection
Une collection non vide (liste, set, tuple...).
Lève
----
TypeError
Si ``elements`` n'est pas une collection.
ValueError
Si ``elements`` est vide.
Exemples
--------
>>> afficher_chaque([1, 2, 3])
1
2
3
>>> afficher_chaque([])
Traceback (most recent call last):
...
ValueError: 'elements' ne doit pas être videLes exemples de la docstring sont même des tests : le module doctest les exécute et vérifie que les résultats affichés sont exacts.
import doctest

runner = doctest.DocTestRunner()
for test in doctest.DocTestFinder().find(afficher_chaque, "afficher_chaque", globs=globals()):
    runner.run(test)
print(runner.summarize())TestResults(failed=0, attempted=2)Les 2 exemples passent. Une docstring dont les exemples sont testés ne devient jamais fausse sans que tu le remarques.
Pourquoi utiliser logging plutôt que print() ?
Le logging est l’une des fonctionnalités les plus sous-utilisées de Python. Un print() est une trace temporaire, que l’on supprime après le débogage. Un message de log a un niveau de gravité, il peut être filtré, redirigé vers un fichier et conservé en production. Deux lignes suffisent pour commencer :
import logging

logger = logging.getLogger(__name__)

logger.debug("message de débogage")
logger.warning("avertissement")
print("Le message DEBUG n'apparaît pas : le niveau par défaut est WARNING.")avertissement
Le message DEBUG n'apparaît pas : le niveau par défaut est WARNING.Le message warning apparaît, pas le debug : par défaut, seuls les messages de niveau WARNING ou supérieur sont affichés. C’est un piège courant, et la première version de cet article l’omettait : sans configuration, tes logger.debug() restent invisibles.
Quels sont les niveaux de logging ?
Du moins grave au plus grave : DEBUG (détails pour le développeur), INFO (le programme progresse), WARNING (quelque chose d’inhabituel), ERROR (une opération a échoué) et CRITICAL (le programme ne peut pas continuer). On configure le niveau minimal affiché, ainsi que le format, avec basicConfig() :
import sys

logging.basicConfig(
    level=logging.DEBUG,
    format="%(levelname)-8s %(name)s : %(message)s",
    stream=sys.stdout,
    force=True,
)

logger.debug("niveau DEBUG : détails pour le développeur")
logger.info("niveau INFO : le programme progresse")
logger.warning("niveau WARNING : quelque chose d'inhabituel")
logger.error("niveau ERROR : une opération a échoué")
logger.critical("niveau CRITICAL : le programme ne peut pas continuer")DEBUG __main__ : niveau DEBUG : détails pour le développeur
INFO __main__ : niveau INFO : le programme progresse
WARNING __main__ : niveau WARNING : quelque chose d'inhabituel
ERROR __main__ : niveau ERROR : une opération a échoué
CRITICAL __main__ : niveau CRITICAL : le programme ne peut pas continuerLe paramètre force=True est utile dans un notebook comme Colab, où un gestionnaire de log existe déjà et ferait ignorer basicConfig(). Dans une application, appelle basicConfig() une seule fois, au point d’entrée. Dans les modules et les bibliothèques, utilise seulement logging.getLogger(__name__) : c’est celui qui utilise ton code qui décide du niveau et de la destination.
Comment utiliser le logging dans une fonction ?
Voici notre fonction avec ses logs. Remarque %d et %s dans le message : avec ce format, Python n’assemble le texte que si le niveau est actif, contrairement à une f-string, évaluée à chaque appel.
from collections.abc import Collection

def afficher_chaque(elements: Collection) -> None:
    """Affiche chaque élément d'une collection non vide."""
    if not isinstance(elements, Collection):
        message = f"'elements' doit être une collection, pas {type(elements).__name__}"
        logger.error(message)
        raise TypeError(message)

    logger.debug("Affichage de %d éléments (type %s)", len(elements), type(elements).__name__)

    if len(elements) == 0:
        message = "'elements' ne doit pas être vide"
        logger.error(message)
        raise ValueError(message)

    for element in elements:
        print(element)

afficher_chaque(["a", "b"])

try:
    afficher_chaque(42)
except TypeError as erreur:
print("exception levée :", erreur)DEBUG __main__ : Affichage de 2 éléments (type list)
a
b
ERROR __main__ : 'elements' doit être une collection, pas int
exception levée : 'elements' doit être une collection, pas intLes lignes DEBUG et ERROR donnent le contexte à celui qui lit les logs, et l’exception est levée comme avant. Dans une vraie application, évite de journaliser la même erreur à chaque niveau d’appel : journalise-la à l’endroit où tu l’attrapes, avec logger.exception() qui ajoute la trace complète. Pour masquer les messages détaillés sans toucher au code, change simplement le niveau :
logger.setLevel(logging.INFO)           # on cache les messages DEBUG de ce logger

afficher_chaque(["a", "b"])a
bComment vérifier ces bonnes pratiques automatiquement ?
Tu n’as pas à tout surveiller de tête. Dans un projet, branche trois outils sur tes commits (par exemple avec pre-commit) : ruff pour le style et le nommage, mypy pour les types, et doctest ou pytest pour les tests. Les bonnes pratiques de cet article deviennent alors des contrôles qui s’exécutent tout seuls.
Questions fréquentes
Quelles sont les bonnes pratiques Python à connaître ?
Choisir le bon type d’itérable (set pour tester une présence, tuple pour une suite figée), suivre la PEP 8 pour les noms, comparer avec if x: et is None, lever des exceptions avec un message utile, ajouter des indications de type et des docstrings, et utiliser logging plutôt que print(). Des outils comme ruff et mypy vérifient plusieurs de ces points automatiquement.
Pourquoi un set est-il plus rapide qu’une liste pour tester une présence ?
Une liste compare l’élément cherché à chaque valeur, une par une : le temps croît avec la taille. Un set utilise une table de hachage et accède directement à l’emplacement. Dans mon test, chercher le dernier élément de 1 000 000 de valeurs prenait environ 8,7 ms avec une liste et environ 0,04 µs avec un set.
Faut-il écrire == True ou is True pour comparer un booléen ?
Ni l’un ni l’autre dans le cas général : la PEP 8 recommande if x:. Pour None, utilise is None ou is not None. Réserve is True aux rares cas où tu dois distinguer le booléen True d’une valeur simplement vraie, en sachant que le booléen de NumPy n’est pas le True de Python.
Comment lever une exception avec un message personnalisé en Python ?
Écris raise ValueError(“message précis”) (ou TypeError selon le cas). Pour remplacer une exception attrapée tout en gardant sa cause, utilise raise ValueError(“message”) from erreur : l’erreur d’origine reste disponible dans __cause__ et apparaît dans la trace.
Les type hints sont-ils obligatoires en Python ?
Non, Python ne les vérifie pas à l’exécution : un entier passé à une fonction qui attend un str ne provoque aucune erreur. Ils servent à l’éditeur et à des outils comme mypy, qui repèrent les erreurs de type avant l’exécution. Depuis Python 3.10, tu peux écrire str | None et list[str] sans rien importer.
Pourquoi mes messages logger.debug() ne s’affichent-ils pas ?
Le niveau par défaut du logging est WARNING : DEBUG et INFO sont ignorés tant que tu n’as pas configuré le niveau. Appelle logging.basicConfig(level=logging.DEBUG) au point d’entrée de ton programme (avec force=True dans un notebook) pour les afficher.
Conclusion : que retenir des bonnes pratiques Python ?
Ces 6 habitudes coûtent peu et se voient tout de suite : le bon type de données, des noms conformes à la PEP 8, des comparaisons simples, des erreurs explicites, des fonctions documentées et typées, et des logs plutôt que des print(). Ce ne sont pas les seuls critères qui distinguent un développeur senior d’un débutant, mais ce sont ceux que tu peux appliquer dès aujourd’hui, et que des outils vérifient pour toi.
Pour écrire du code de qualité et progresser en Python, le mieux est de pratiquer. Sur DataXp, tu apprends Python et la data science avec des exercices pratiques à faire directement en ligne.
Pour aller plus loin, voici d’autres articles qui pourraient te plaire :