Si tu travailles dans le domaine de la Data Science, quel que soit ton job, SQL est l’une des compétences les plus importantes que tu dois posséder. Je le placerais dans le top 3 avec Python. C’est pourquoi, dans cet article, je te propose d’améliorer tes compétences SQL avec Python.
Article mis à jour en novembre 2026 : j’ai ré-exécuté tout le code avec pandas 3 et pandas 2.3 (la version de Google Colab), avec les mêmes résultats. J’ai ajouté les requêtes paramétrées pour éviter les injections SQL, executemany, une requête avec agrégation, l’écriture d’un DataFrame dans SQLite avec to_sql et la connexion via SQLAlchemy.
En bref : pour progresser en SQL avec Python, utilise le module sqlite3, intégré à Python : rien à installer. Tu crées une base avec sqlite3.connect(), tu exécutes tes requêtes avec un curseur (execute() puis fetchall()), tu valides les modifications avec commit() et tu transformes le résultat en DataFrame pandas avec pd.read_sql_query(). Passe toujours les valeurs variables avec des paramètres (?) plutôt qu’en collant du texte dans la requête.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Lorsque j’ai commencé à apprendre la Data Science, j’ai trouvé qu’il était un peu difficile de mettre en place un environnement pour pratiquer le SQL. Je devais installer un moteur de base de données et un IDE pour écrire des requêtes, comme MySQL Workbench ou pgAdmin.
Cette configuration n’est pas très compliquée et il est probable que tu utilises ce type d’environnement lorsque tu travailleras dans le domaine de la Data Science. Cependant, il existe une option beaucoup plus simple pour s’entraîner lorsque tu commences à apprendre.
Cette option est sqlite3, un module Python intégré. Il fournit une interface SQL facile à utiliser. Le module sqlite3 est basé sur SQLite, une bibliothèque en langage C qui fournit une base de données légère, stockée dans un simple fichier.
Puisque la plupart d’entre nous commencent leur voyage dans la Data Science en installant Python, pourquoi ne pas l’utiliser également pour apprendre SQL ? Dans cet article, nous allons passer en revue plusieurs exemples pour apprendre à :
- Créer une base de données
- Créer des tables
- Alimenter les tables
- Interroger les tables
…avec le module sqlite3, puis à récupérer les résultats dans un DataFrame pandas.
Comment créer une base de données SQLite avec Python ?
Comment se connecter à une base de données ?
La première étape consiste à créer une base de données. Nous pouvons utiliser la fonction connect pour cette tâche. Elle permet de se connecter à une base de données et, si la base de données n’existe pas, la fonction connect la crée également (ici, dans le fichier sample.db).
import sqlite3

con = sqlite3.connect("sample.db")Astuce : avec sqlite3.connect(":memory:"), la base est créée en mémoire et disparaît à la fermeture de la connexion. C’est pratique pour faire des tests sans laisser de fichier.
Comment créer un curseur et lister les tables ?
L’étape suivante consiste à créer un curseur de base de données, nécessaire à l’exécution des instructions SQL et à la récupération des résultats.
cursor = con.cursor()Nous pouvons voir les tables de cette base de données en utilisant la requête suivante et la fonction fetchall. Nous interrogeons essentiellement la table intégrée sqlite_master.
check_tables = """SELECT name FROM sqlite_master WHERE type='table';"""
cursor.execute(check_tables)
cursor.fetchall()[]Comme la base de données ne contient aucune table, la fonction fetchall renvoie une liste vide.
Comment créer une table et l’alimenter ?
Comment créer une table avec CREATE TABLE ?
Créons une table. Nous allons écrire la requête pour créer une table et utiliser le curseur pour l’exécuter.
create_products_table = """CREATE TABLE IF NOT EXISTS products (
                                    id integer PRIMARY KEY,
                                    category text NOT NULL,
                                    price real,
                                    cost real
                                );"""

cursor.execute(create_products_table)Vérifions à nouveau les tables de la base de données d’exemple.
cursor.execute(check_tables)
cursor.fetchall()[('products',)]Nous voyons maintenant que la table products existe dans la base de données.
Nous pouvons exécuter n’importe quelle requête à l’aide du curseur. Par exemple, l’extrait de code suivant exécute la requête pour sélectionner toutes les lignes de la table products et affecte le résultat à une variable appelée result. Ensuite, la fonction fetchall est appelée sur la variable result pour voir ce qu’elle contient.
result = cursor.execute("SELECT * FROM products")
result.fetchall()[]Comment insérer des lignes et valider la transaction ?
Elle ne renvoie rien puisque la table products est vide. Remplissons-la à l’aide de l’instruction INSERT INTO.
populate_products_table = """INSERT INTO products VALUES
(1001, 'A', 15.9, 12.9),
(1002, 'B', 24.9, 20.5),
(1003, 'A', 13.5, 10.6),
(1004, 'A', 17.5, 13.5),
(1005, 'B', 28.9, 23.5)
;"""
cursor.execute(populate_products_table)Note : l’instruction INSERT ouvre implicitement une transaction, qui doit être validée avant que les modifications ne soient enregistrées dans la base de données.
con.commit()La table products devrait maintenant comporter 5 lignes. Confirmons en exécutant l’instruction SELECT ci-dessus.
result = cursor.execute("SELECT * FROM products")
result.fetchall()[(1001, 'A', 15.9, 12.9),
(1002, 'B', 24.9, 20.5),
(1003, 'A', 13.5, 10.6),
(1004, 'A', 17.5, 13.5),
(1005, 'B', 28.9, 23.5)]Attention : si tu relances la cellule d’insertion, SQLite refuse les doublons sur la clé primaire (erreur IntegrityError). Dans ce cas, supprime le fichier sample.db et repars de zéro.
Comment filtrer sans risque d’injection SQL ?
On peut bien sûr écrire des requêtes plus avancées. Par exemple, la requête suivante renvoie les lignes qui appartiennent à la catégorie A. Remarque la façon de passer la valeur : on met un point d’interrogation (?) dans la requête et on fournit les valeurs dans un tuple. C’est la méthode recommandée : ne construis jamais une requête en collant du texte venant d’un utilisateur (avec un f-string, par exemple), car cela ouvre la porte aux injections SQL.
result = cursor.execute("SELECT * FROM products WHERE category = ?", ("A",))
result.fetchall()[(1001, 'A', 15.9, 12.9), (1003, 'A', 13.5, 10.6), (1004, 'A', 17.5, 13.5)]Tu peux aussi utiliser des paramètres nommés (:nom) avec un dictionnaire, ce qui est plus lisible quand il y a plusieurs valeurs :
query = "SELECT id, price FROM products WHERE category = :cat AND price > :prix_min"
result = cursor.execute(query, {"cat": "A", "prix_min": 15})
result.fetchall()[(1001, 15.9), (1004, 17.5)]Comment obtenir un DataFrame pandas à partir d’une requête SQL ?
L’un des avantages du module sqlite3 est qu’il est compatible avec pandas. Ainsi, nous pouvons facilement écrire les résultats d’une requête dans un DataFrame. Nous appelons la fonction read_sql_query de pandas avec la requête et l’objet de connexion.
import pandas as pd
products = pd.read_sql_query("SELECT * FROM products", con)
products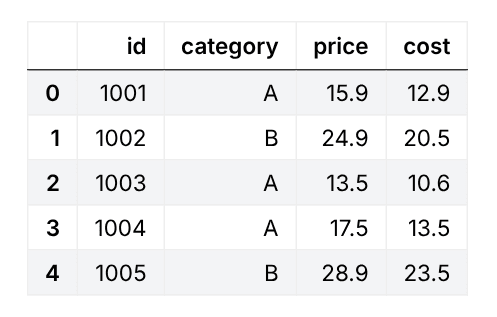
Créons une autre table et remplissons-la. Cette fois, j’utilise executemany : la requête est écrite une seule fois avec des paramètres ?, et SQLite l’exécute pour chaque ligne de la liste. C’est plus court et plus sûr que d’écrire un gros INSERT à la main.
create_customers_table = """CREATE TABLE IF NOT EXISTS customers (
id integer PRIMARY KEY,
customer_id integer NOT NULL,
is_member integer NOT NULL,
purchase_date text,
purchased_product integer,
purchase_quantity integer
);"""
cursor.execute(create_customers_table)customers_data = [
(1, 110, 0, '2022-12-23', 1002, 5),
(2, 112, 0, '2022-12-14', 1001, 4),
(3, 113, 1, '2022-12-08', 1003, 6),
(4, 113, 1, '2022-12-14', 1002, 4),
(5, 114, 0, '2022-12-21', 1004, 10),
]
cursor.executemany("INSERT INTO customers VALUES (?, ?, ?, ?, ?, ?)", customers_data)
con.commit()Nous pouvons créer un DataFrame avec la table customers comme suit :
customers = pd.read_sql_query("SELECT * FROM customers", con)
customers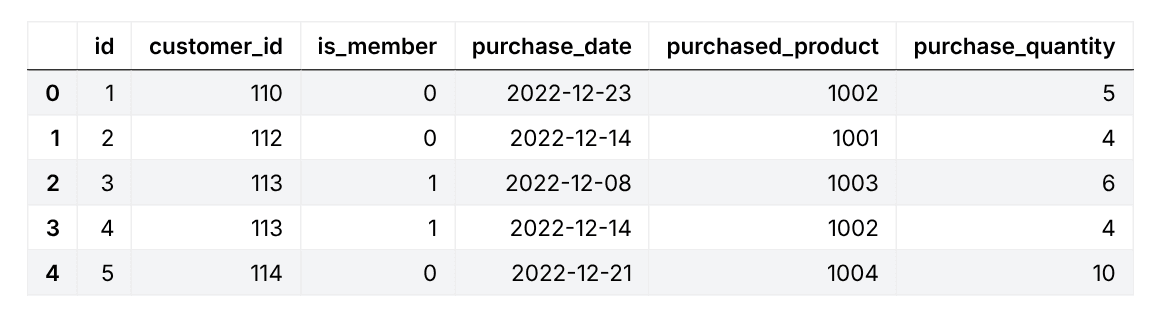
Comment écrire des requêtes SQL plus complexes avec Python ?
Comment faire une jointure entre deux tables ?
Écrivons une requête qui récupère les données des tables products et customers. Elle comprendra une instruction de jointure.
query = '''
SELECT
customer_id,
purchased_product,
purchase_quantity,
price
FROM customers c
LEFT JOIN products p ON c.purchased_product = p.id
'''
cursor.execute(query)
cursor.fetchall()[(110, 1002, 5, 24.9),
(112, 1001, 4, 15.9),
(113, 1003, 6, 13.5),
(113, 1002, 4, 24.9),
(114, 1004, 10, 17.5)]Comment récupérer les noms des colonnes du résultat ?
Tu peux utiliser l’attribut description du curseur pour voir les noms des colonnes dans le résultat de la requête (seul le premier élément de chaque tuple est renseigné) :
cursor.description(('customer_id', None, None, None, None, None, None),
('purchased_product', None, None, None, None, None, None),
('purchase_quantity', None, None, None, None, None, None),
('price', None, None, None, None, None, None))# enregistrer les noms dans une liste Python en utilisant la compréhension de liste
col_names = [description[0] for description in cursor.description]
col_names['customer_id', 'purchased_product', 'purchase_quantity', 'price']Comment mettre le résultat d’une jointure dans un DataFrame ?
Pour éviter de gérer les tuples et les noms de colonnes à la main, passe simplement la même requête à read_sql_query :
pd.read_sql_query(query, con)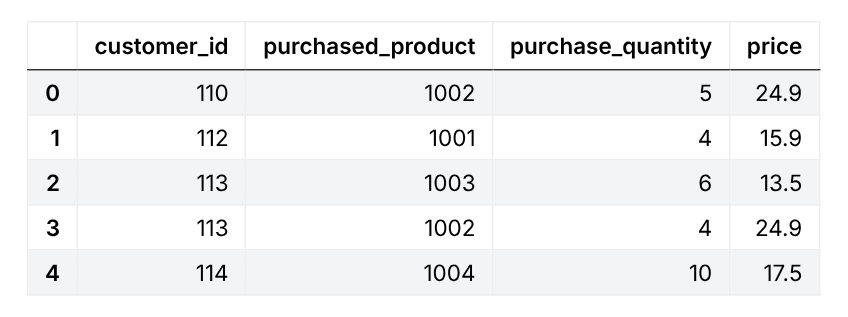
Comment calculer un chiffre d’affaires avec GROUP BY ?
Allons un cran plus loin avec une agrégation : pour chaque catégorie de produits, calculons la quantité vendue, le chiffre d’affaires et la marge (prix moins coût). SQL fait le calcul, pandas récupère le résultat.
query_agg = '''
SELECT
p.category,
SUM(c.purchase_quantity) AS quantite,
ROUND(SUM(c.purchase_quantity * p.price), 1) AS chiffre_affaires,
ROUND(SUM(c.purchase_quantity * (p.price - p.cost)), 1) AS marge
FROM customers c
LEFT JOIN products p ON c.purchased_product = p.id
GROUP BY p.category
ORDER BY chiffre_affaires DESC
'''
ventes = pd.read_sql_query(query_agg, con)
ventes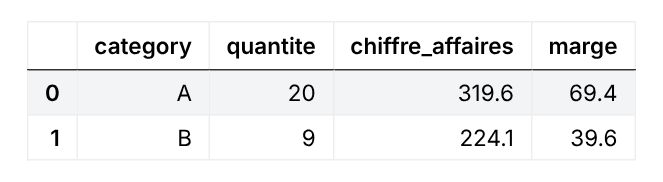
La catégorie A représente 20 unités vendues et 319,6 de chiffre d’affaires, contre 9 unités et 224,1 pour la catégorie B. Pour approfondir ce type de requêtes, lis le top 10 des requêtes SQL avancées et l’ordre d’exécution des requêtes SQL.
Comment enregistrer un DataFrame pandas dans SQLite ?
Le chemin inverse existe aussi : la méthode to_sql d’un DataFrame écrit son contenu dans une table. Avec if_exists="replace", la table est recréée si elle existe déjà, et index=False évite d’enregistrer l’index. La méthode renvoie le nombre de lignes écrites, ici 2 (la dernière ligne du code relit la table pour vérifier).
ventes.to_sql("ventes_par_categorie", con, if_exists="replace", index=False)
pd.read_sql_query("SELECT * FROM ventes_par_categorie", con) category quantite chiffre_affaires marge
0 A 20 319.6 69.4
1 B 9 224.1 39.6Comment modifier des données et lire les lignes par nom de colonne ?
Pour modifier des données, on utilise UPDATE. Le bloc with con: valide automatiquement la transaction à la fin (commit) ou l’annule en cas d’erreur (rollback), sans fermer la connexion. Ici, je change le prix du produit 1001 :
with con:
con.execute("UPDATE products SET price = 16.5 WHERE id = 1001")
con.execute("SELECT id, price FROM products WHERE id = 1001").fetchall()[(1001, 16.5)]Autre confort : en réglant row_factory sur sqlite3.Row, chaque ligne se lit par nom de colonne, et pas seulement par position.
con.row_factory = sqlite3.Row
ligne = con.execute("SELECT * FROM products WHERE id = 1002").fetchone()
print(ligne["category"], ligne["price"])
print(dict(ligne))
con.row_factory = NoneB 24.9
{'id': 1002, 'category': 'B', 'price': 24.9, 'cost': 20.5}Comment fermer la connexion et vérifier que tout est enregistré ?
Nous pouvons utiliser la méthode close pour fermer la connexion actuelle à la base de données.
con.close()Pour vérifier si les modifications sont enregistrées dans la base de données, nous pouvons créer une nouvelle connexion et écrire une requête pour vérifier.
con = sqlite3.connect("sample.db")
cursor = con.cursor()
result = cursor.execute("SELECT * FROM products")
result.fetchall()[(1001, 'A', 16.5, 12.9),
(1002, 'B', 24.9, 20.5),
(1003, 'A', 13.5, 10.6),
(1004, 'A', 17.5, 13.5),
(1005, 'B', 28.9, 23.5)]Oui, les modifications ont été enregistrées dans la base de données sample.db (y compris le nouveau prix du produit 1001).
Comment utiliser une autre base de données (PostgreSQL, MySQL) ?
SQLite est parfait pour apprendre et pour de petits projets, mais en entreprise tu travailleras souvent avec PostgreSQL, MySQL ou un entrepôt de données cloud. Dans ce cas, pandas recommande de passer par SQLAlchemy : tu crées un « moteur » avec une URL de connexion et tu le donnes à read_sql_query. Voici l’exemple avec notre fichier SQLite ; pour PostgreSQL, seule l’URL change (par exemple postgresql+psycopg://utilisateur:mot_de_passe@serveur/base, avec le pilote installé). SQLAlchemy est déjà installé dans Google Colab ; ailleurs, lance pip install sqlalchemy :
from sqlalchemy import create_engine

engine = create_engine("sqlite:///sample.db")
pd.read_sql_query("SELECT category, COUNT(*) AS nb_produits FROM products GROUP BY category", engine) category nb_produits
0 A 3
1 B 2Les requêtes SQL restent les mêmes : ce que tu as appris avec sqlite3 se transpose directement. Pour la suite, lis SQL pour l’analyse de données et nos 16 bonnes pratiques SQL.
con.close()Questions fréquentes
Comment utiliser SQL avec Python ?
Utilise le module sqlite3, intégré à Python : crée une connexion avec sqlite3.connect(), un curseur avec con.cursor(), exécute tes requêtes avec cursor.execute() et récupère les résultats avec fetchall(). Pour obtenir un DataFrame, utilise pd.read_sql_query(requête, con).
Faut-il installer SQLite pour utiliser sqlite3 ?
Non. Le module sqlite3 fait partie de la bibliothèque standard de Python et embarque le moteur SQLite : il n’y a ni serveur à installer, ni configuration. La base de données est un simple fichier, ou la mémoire avec “:memory:”.
Pourquoi faut-il faire un commit après un INSERT ?
Les instructions INSERT, UPDATE et DELETE ouvrent une transaction. Tant que tu n’appelles pas con.commit(), les modifications ne sont pas enregistrées dans le fichier de la base. Le bloc with con: valide automatiquement la transaction (ou l’annule en cas d’erreur).
Comment éviter les injections SQL avec sqlite3 ?
Ne construis jamais une requête en collant des valeurs dans le texte (f-string, concaténation). Mets des paramètres (? ou :nom) dans la requête et passe les valeurs séparément : cursor.execute(“SELECT * FROM products WHERE category = ?”, (“A”,)). SQLite traite alors les valeurs comme des données, jamais comme du code.
Comment transformer le résultat d’une requête SQL en DataFrame pandas ?
Appelle pd.read_sql_query(“SELECT …”, con) avec ta requête et ta connexion : tu obtiens directement un DataFrame, avec les noms de colonnes de la requête. Dans l’autre sens, df.to_sql(“table”, con, index=False) écrit un DataFrame dans une table.
SQLite suffit-il pour travailler en Data Science ?
Pour apprendre le SQL et pour de petits jeux de données, oui. En entreprise, tu utiliseras plutôt PostgreSQL, MySQL ou un entrepôt cloud, via SQLAlchemy ou un connecteur dédié. La syntaxe SQL de base reste la même, avec quelques différences de dialecte.
Conclusion : tes nouvelles compétences SQL avec Python
Le module sqlite3 fournit un environnement facile à utiliser pour pratiquer le SQL, ce qui est d’une importance cruciale pour presque tous ceux qui travaillent dans l’écosystème de la Data Science.
Le fait de ne pas avoir à installer d’outil ou de moteur de base de données supplémentaire encourage encore plus l’utilisation de sqlite3. De plus, il suffit d’une ligne de code pour enregistrer le résultat d’une requête dans un DataFrame pandas. Je pense qu’il s’agit d’une fonctionnalité très intéressante, car pandas est l’outil de manipulation et d’analyse de données le plus utilisé.
Pour que le SQL devienne un réflexe, il faut écrire des requêtes tous les jours, avec des données qui te ressemblent. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Tu peux également consulter ces articles :