Il existe des dizaines de bibliothèques de visualisation en Python, mais le duo Matplotlib + Seaborn reste le plus complet : il permet de créer et de personnaliser presque n’importe quel graphique. Dans ce guide, je te montre pas à pas comment construire des visualisations de données Python avancées.
En bref : Matplotlib dessine la figure, Seaborn la simplifie. Pour progresser vite, retiens trois idées : utilise l’interface orientée objet (fig, ax = plt.subplots()), passe ax=ax aux fonctions Seaborn pour les dessiner dans ta figure, et découpe la figure avec GridSpec ou subplot_mosaic pour assembler plusieurs graphiques. Le guide se termine par une visualisation complète sur les ventes du Black Friday.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : les données du Black Friday y sont chargées toutes seules. Le code est testé avec Matplotlib 3.11, Seaborn 0.13 et Pandas 3, et il donne les mêmes résultats avec Pandas 2.
Dans cet article, je commence par les bases pour les débutants Matplotlib :
- Comprendre les deux interfaces de Matplotlib (elles prêtent souvent à confusion).
- Connaître les éléments d’une figure, pour trouver facilement la bonne méthode dans la documentation.
- Découvrir les types de graphiques courants, et savoir quand les utiliser.
- Apprendre à augmenter la « dimension » de tes graphiques.
- Apprendre à partitionner la figure avec
GridSpecetsubplot_mosaic.
Je déroule ensuite le processus de création d’une visualisation avancée sur les données du Black Friday :
- Fixer un objectif.
- Préparer les variables.
- Préparer la visualisation.
C’est parti !
Matplotlib : interface fonctionnelle ou orientée objet ?
Commence par importer le module pyplot de Matplotlib. Dans Jupyter et dans Colab, les graphiques s’affichent automatiquement : il n’est plus nécessaire d’ajouter %matplotlib inline.
import matplotlib.pyplot as pltIl y a deux façons de coder avec Matplotlib.
La méthode fonctionnelle
La première est la méthode fonctionnelle : tu appelles des fonctions plt.xxx() qui agissent sur la figure courante.
plt.figure(figsize=(5, 4))
plt.plot([0, 1], [0, 1], 'r--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.0])
plt.title('Une figure test')
plt.show()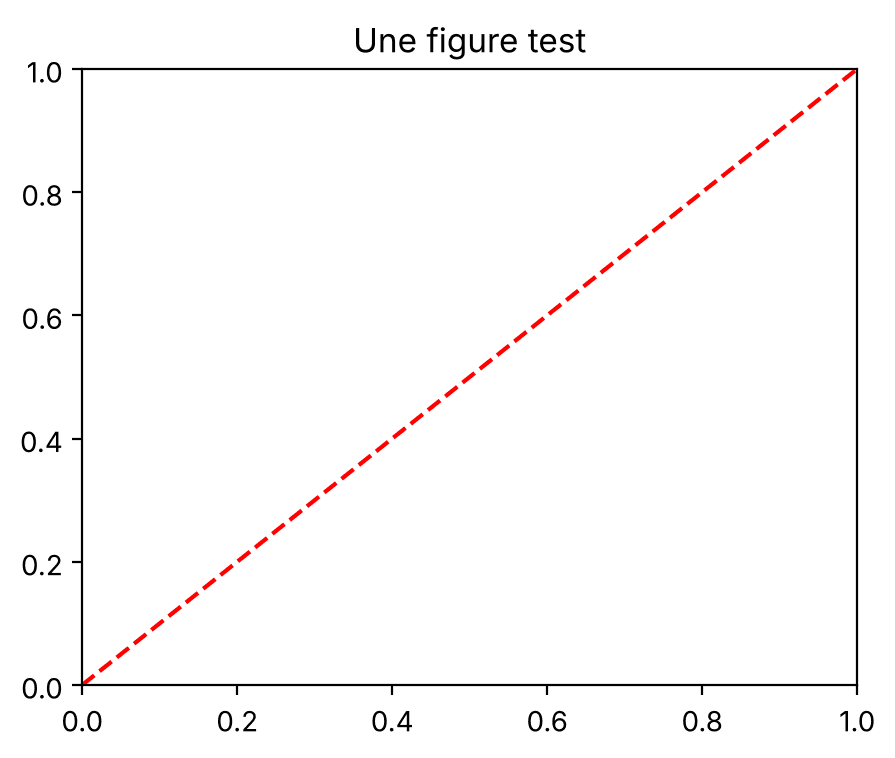
C’est pratique pour obtenir vite un graphique simple, mais tu as peu de contrôle sur le résultat.
La méthode orientée objet
L’autre méthode est la méthode orientée objet (OO) : tu crées d’abord une figure et ses axes, puis tu les manipules avec leurs méthodes.
fig, ax = plt.subplots(figsize=(5, 4))
ax.bar(x=['A', 'B', 'C'], height=[3.1, 7, 4.2], color='r')
ax.set_xlabel('Titre X', size=20)
ax.set_ylabel('Titre Y', color='b', size=20)
plt.show()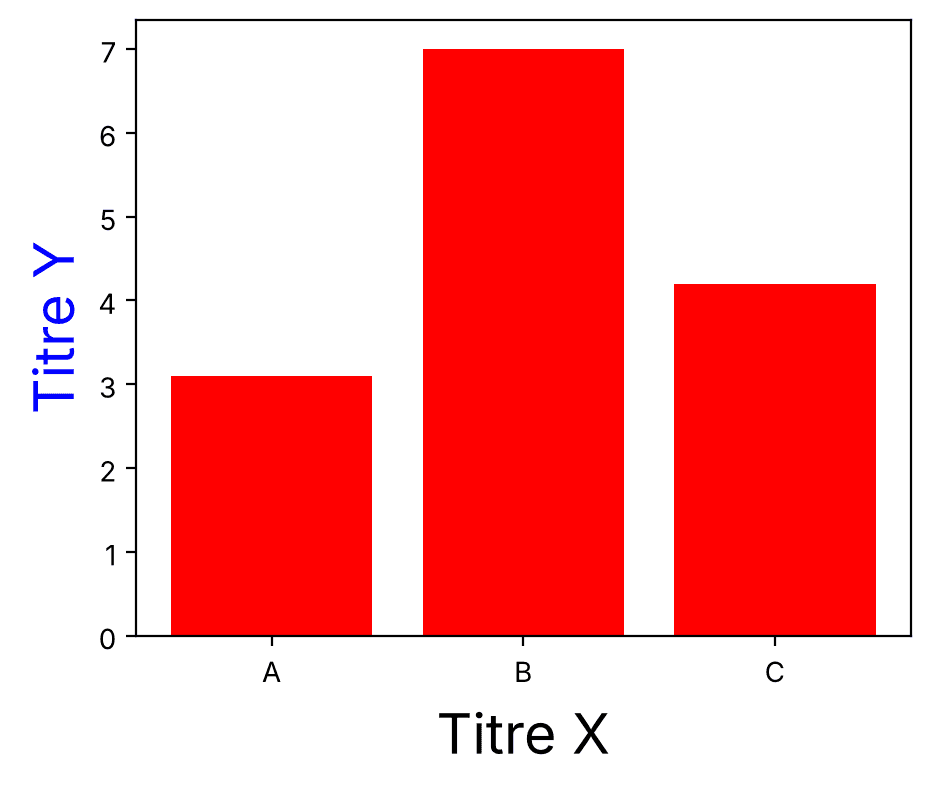
Il faut un peu plus de code, mais tu contrôles entièrement l’allure du graphique : ça vaut le coup ! L’idée est de créer un objet figure (la boîte qui englobe toute la visualisation) et un ou plusieurs objets axes (les sous-graphiques, appelés « axes » en anglais : axes). Chaque objet ax se manipule ensuite avec ses propres méthodes.
Pour une explication détaillée des deux interfaces, lis le guide de démarrage rapide de Matplotlib. Dans la suite de ce guide, on utilise l’approche orientée objet.
Quels sont les éléments d’une figure Matplotlib ?
L’illustration ci-dessous nomme les composants d’une figure. Apprends à les reconnaître : tu sauras ainsi quelle méthode chercher dans la documentation pour modifier chacun d’eux.
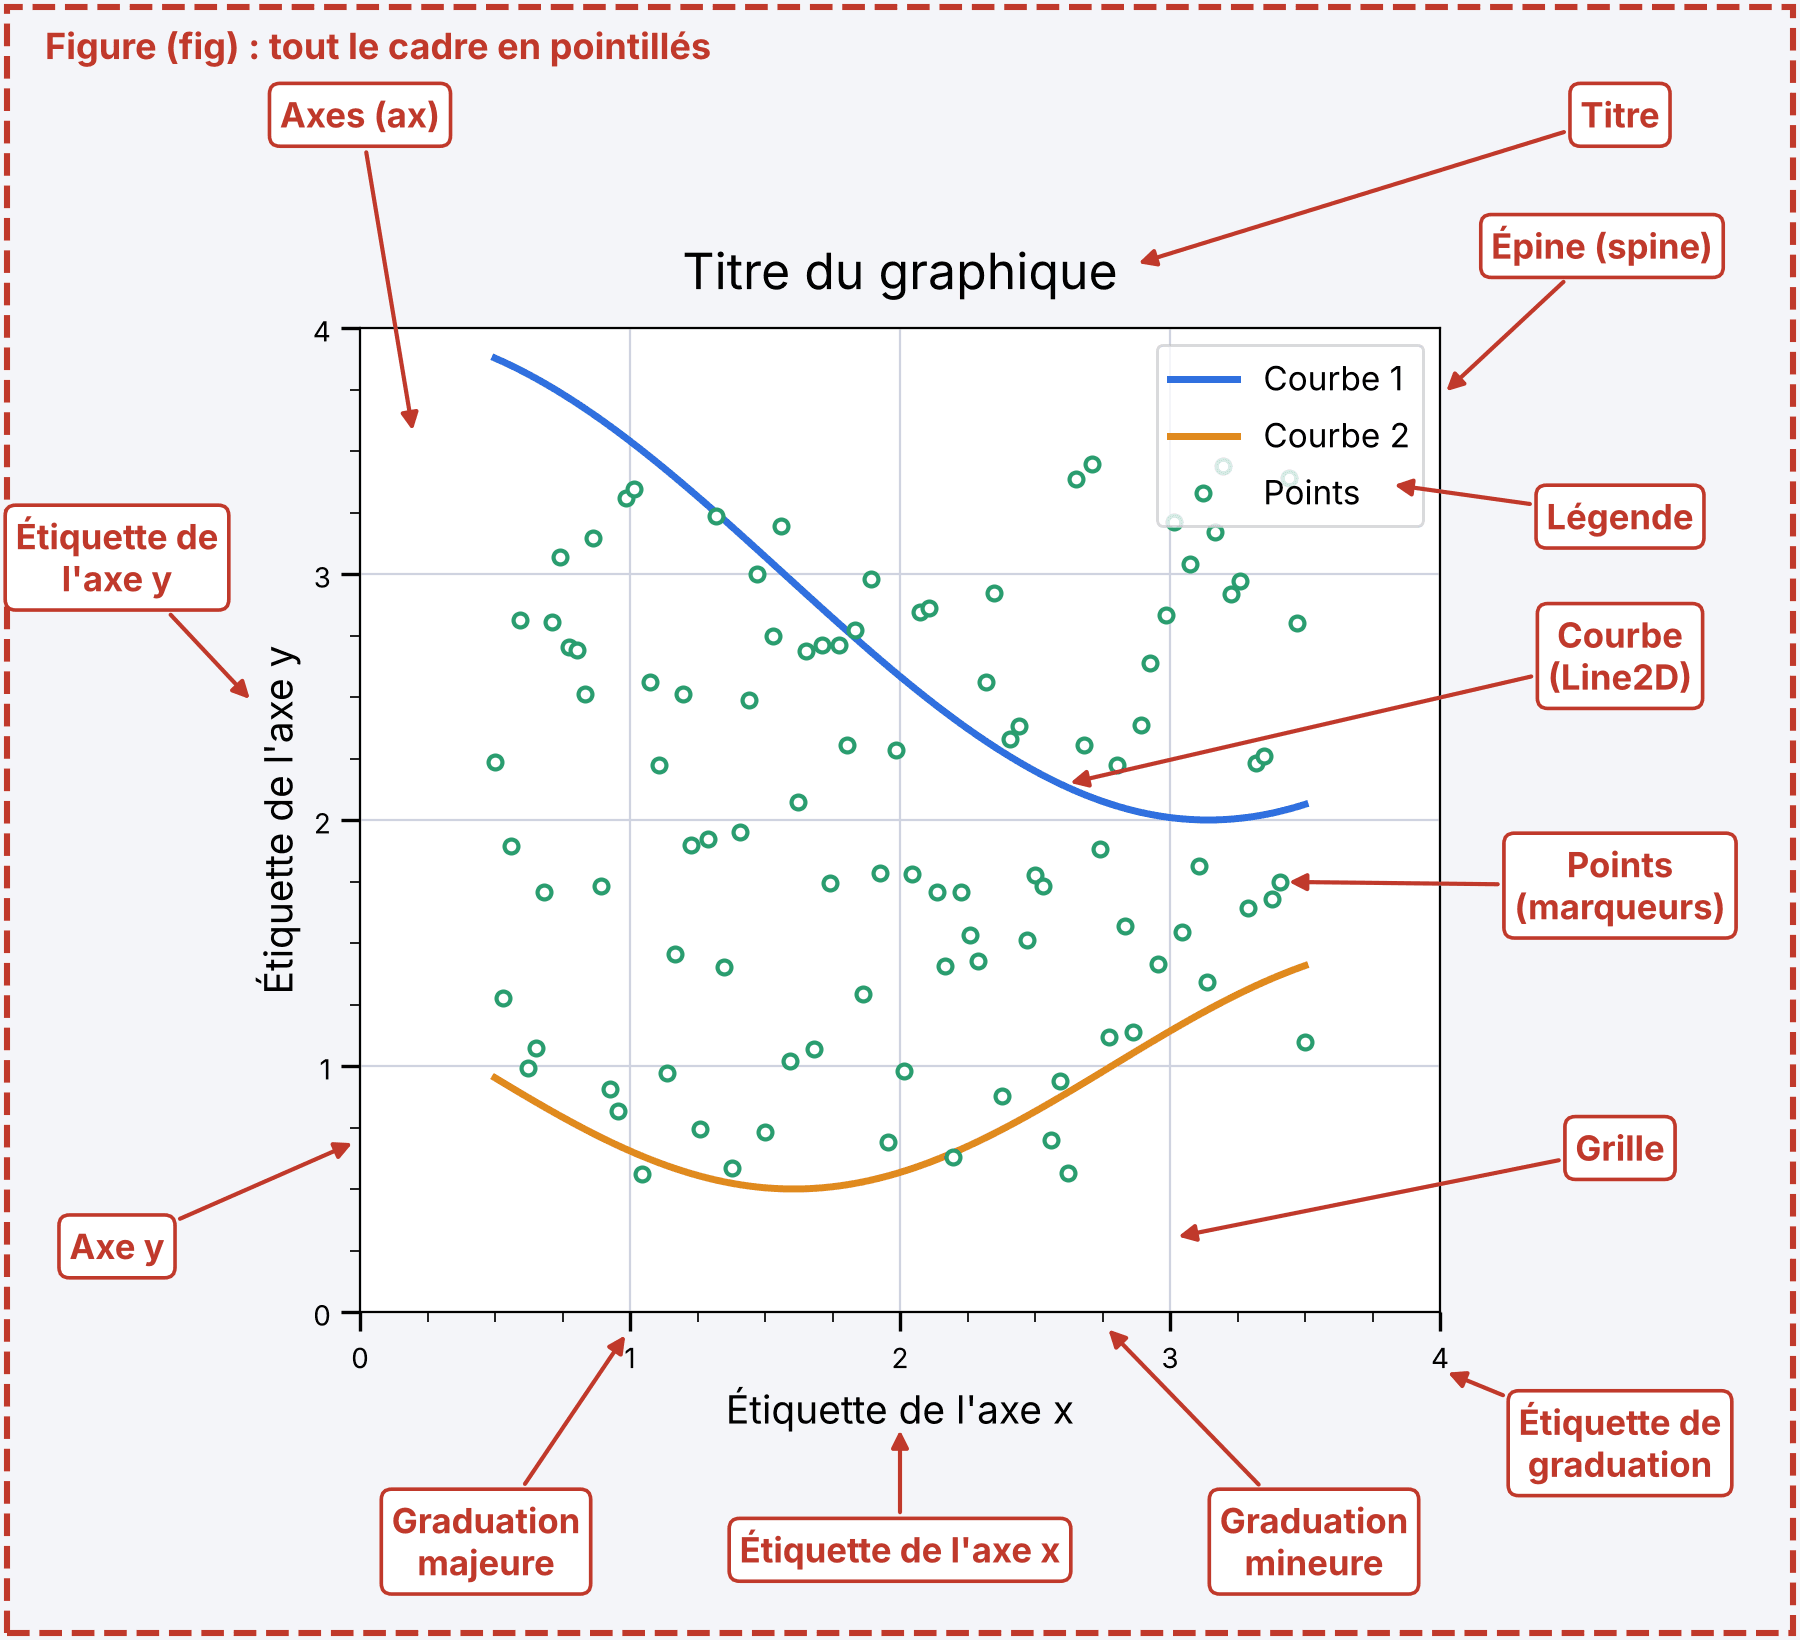
Attention à un piège de vocabulaire : Axes désigne la zone de dessin complète (c’est l’objet ax), tandis que Axis désigne un seul axe (l’axe x ou l’axe y), avec ses graduations.
Voyons un exemple simple de graphique linéaire avec l’interface orientée objet.
fig, ax = plt.subplots(figsize=(5, 4))
ax.plot(['Camille', 'Thomas', 'Laura'], [5, 2, 3], color='r')
ax.set_xlabel('TITRE 1')
ax.tick_params(axis='x', rotation=45)
plt.show()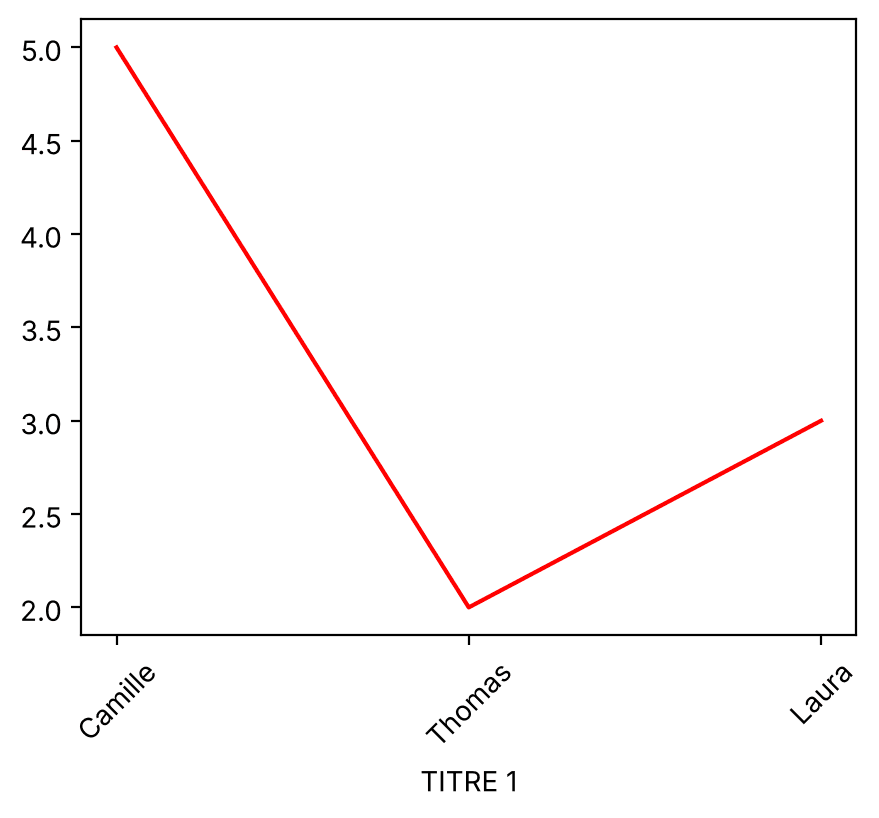
Dans ce code, on crée un objet ax, on trace une ligne dessus, on ajoute le titre de l’axe x avec set_xlabel(), et on fait pivoter de 45 degrés les étiquettes de l’axe x avec tick_params().
Pour savoir comment manipuler les objets axes, consulte l’API officielle.
Quels types de graphiques utiliser avec Seaborn ?
Maintenant que tu as une idée du fonctionnement de Matplotlib, regardons les graphiques les plus courants. Seaborn s’appuie sur Matplotlib : il propose des fonctions plus simples, avec de beaux styles par défaut. Pour les exemples, j’utilise deux petits jeux de données fournis avec Seaborn : les pourboires d’un restaurant (tips) et le nombre de passagers aériens (flights).
import numpy as np
import pandas as pd
import seaborn as sns

sns.set_theme()  # style par défaut de Seaborn

tips = sns.load_dataset("tips")
flights = sns.load_dataset("flights")
print(tips.head()) total_bill tip sex smoker day time size
0 16.99 1.01 Female No Sun Dinner 2
1 10.34 1.66 Male No Sun Dinner 3
2 21.01 3.50 Male No Sun Dinner 3
3 23.68 3.31 Male No Sun Dinner 2
4 24.59 3.61 Female No Sun Dinner 4Pour chaque type, tu as le rôle des variables, le code et le résultat. Tous les exemples utilisent l’interface orientée objet : la fonction Seaborn dessine dans l’objet ax grâce à l’argument ax=ax.
1. Nuage de points (scatter plot)
Deux variables numériques : une sur l’axe x, l’autre sur l’axe y. C’est le graphique idéal pour voir si deux variables sont liées. Fonction : sns.scatterplot().
fig, ax = plt.subplots(figsize=(6, 4))
sns.scatterplot(data=tips, x="total_bill", y="tip", ax=ax)
ax.set(xlabel="Addition ($)", ylabel="Pourboire ($)")
plt.show()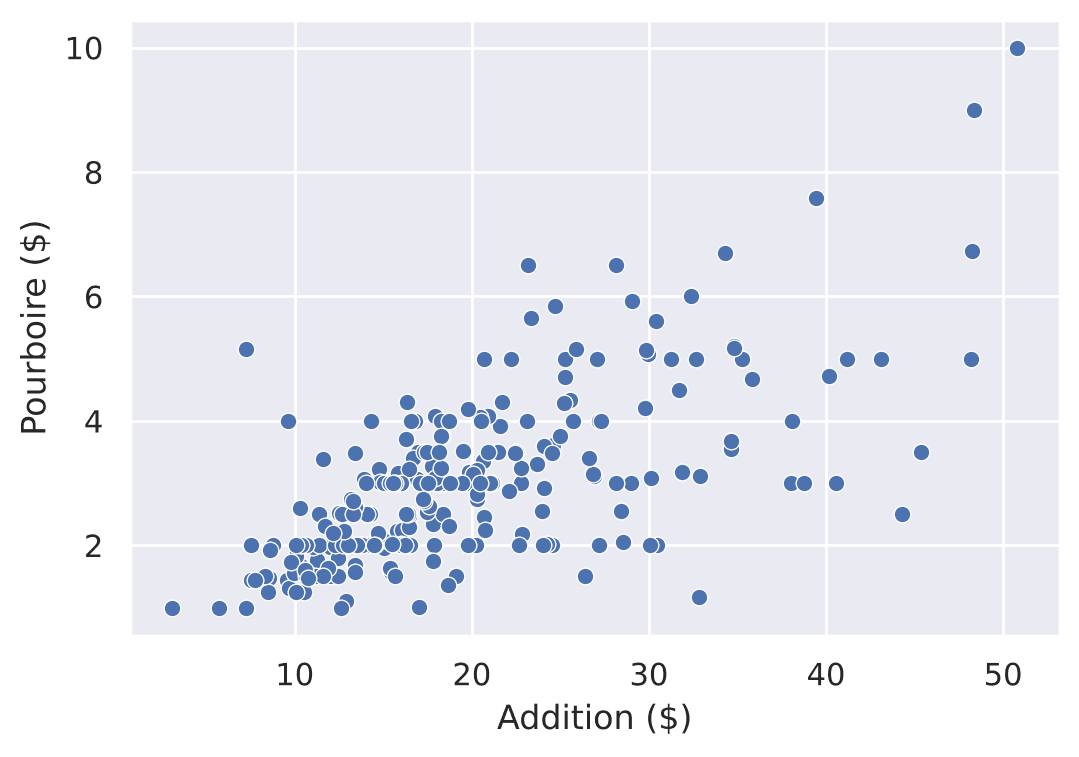
2. Tracé linéaire (line plot)
Une variable ordonnée ou temporelle en x, une variable numérique en y. Idéal pour suivre une évolution. Fonction : sns.lineplot(). Quand plusieurs lignes ont le même x, Seaborn en trace la moyenne avec un intervalle de confiance.
juillet = flights[flights["month"] == "Jul"]

fig, ax = plt.subplots(figsize=(6, 4))
sns.lineplot(data=juillet, x="year", y="passengers", ax=ax)
ax.set(xlabel="Année", ylabel="Passagers en juillet (en milliers)")
plt.show()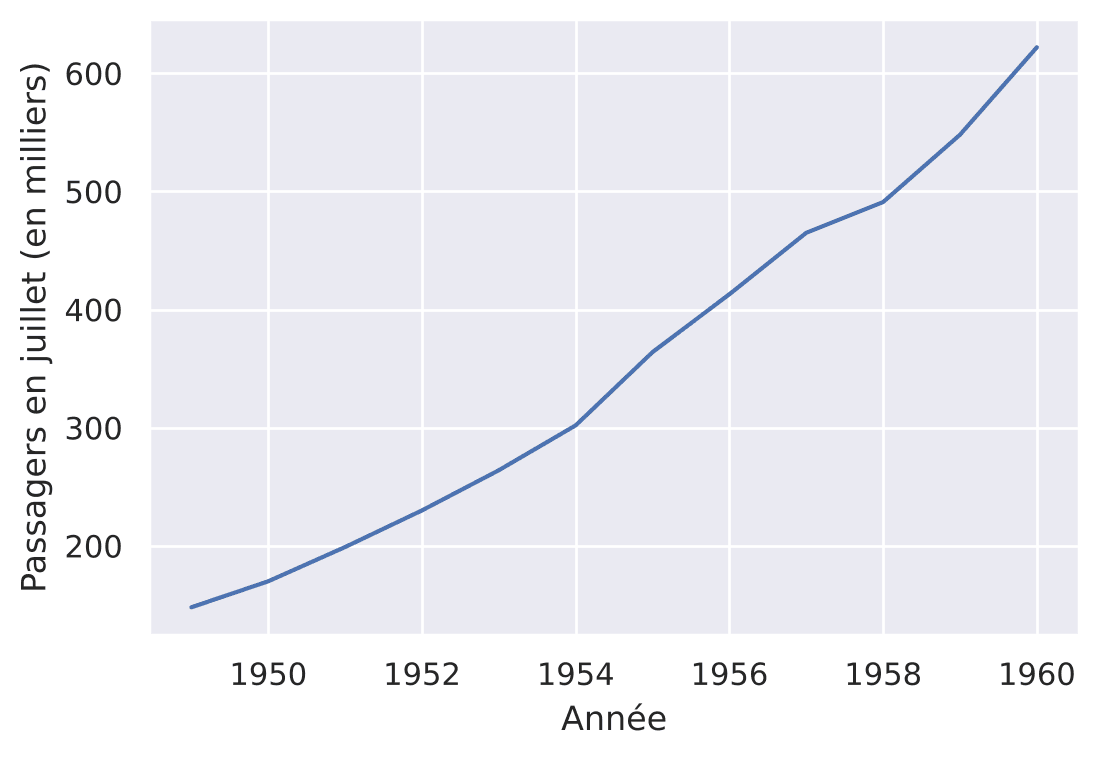
3. Diagramme à barres (bar plot)
Une variable catégorielle en x, une variable numérique en y. Souvent, la variable numérique est le comptage de la catégorie : c’est le rôle de sns.countplot(). Pour afficher une moyenne par catégorie, utilise sns.barplot().
fig, ax = plt.subplots(figsize=(6, 4))
sns.countplot(data=tips, x="day", ax=ax)
ax.set(xlabel="Jour", ylabel="Nombre d'additions")
plt.show()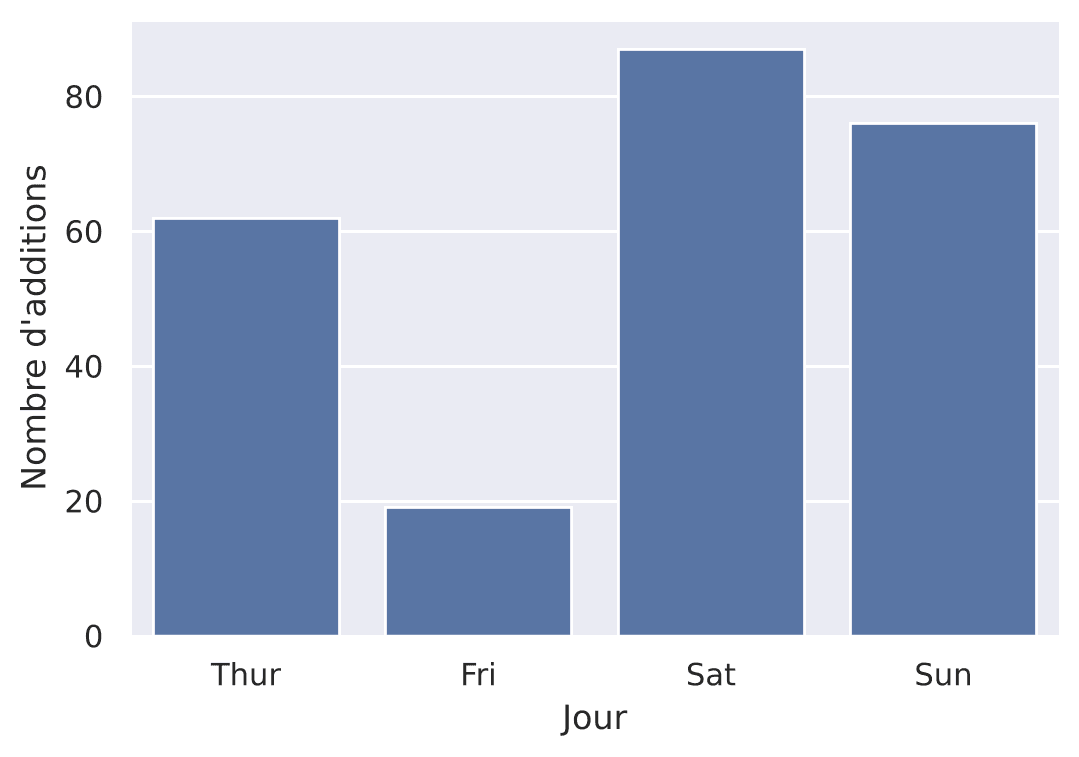
4. Histogramme
Une variable numérique découpée en intervalles (la variable devient catégorielle) ; l’axe y affiche le nombre d’observations par intervalle. Fonction : sns.histplot(). C’est elle qui remplace l’ancienne sns.distplot(), dépréciée et dont la suppression est annoncée pour Seaborn 0.14.
fig, ax = plt.subplots(figsize=(6, 4))
sns.histplot(data=tips, x="total_bill", bins=15, ax=ax)
ax.set(xlabel="Addition ($)", ylabel="Nombre d'additions")
plt.show()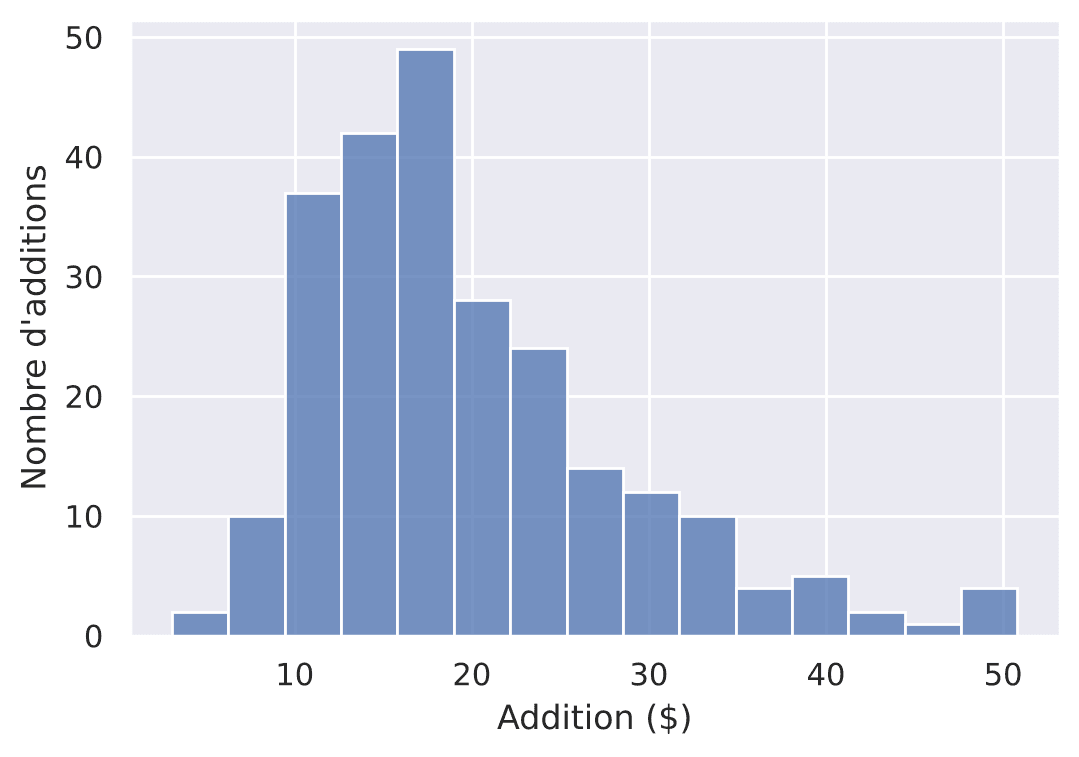
5. Densité du noyau (KDE)
Une variante lissée de l’histogramme : une courbe continue qui estime la distribution d’une variable numérique. Fonction : sns.kdeplot() (fill=True colore l’aire sous la courbe).
fig, ax = plt.subplots(figsize=(6, 4))
sns.kdeplot(data=tips, x="total_bill", fill=True, ax=ax)
ax.set(xlabel="Addition ($)", ylabel="Densité")
plt.show()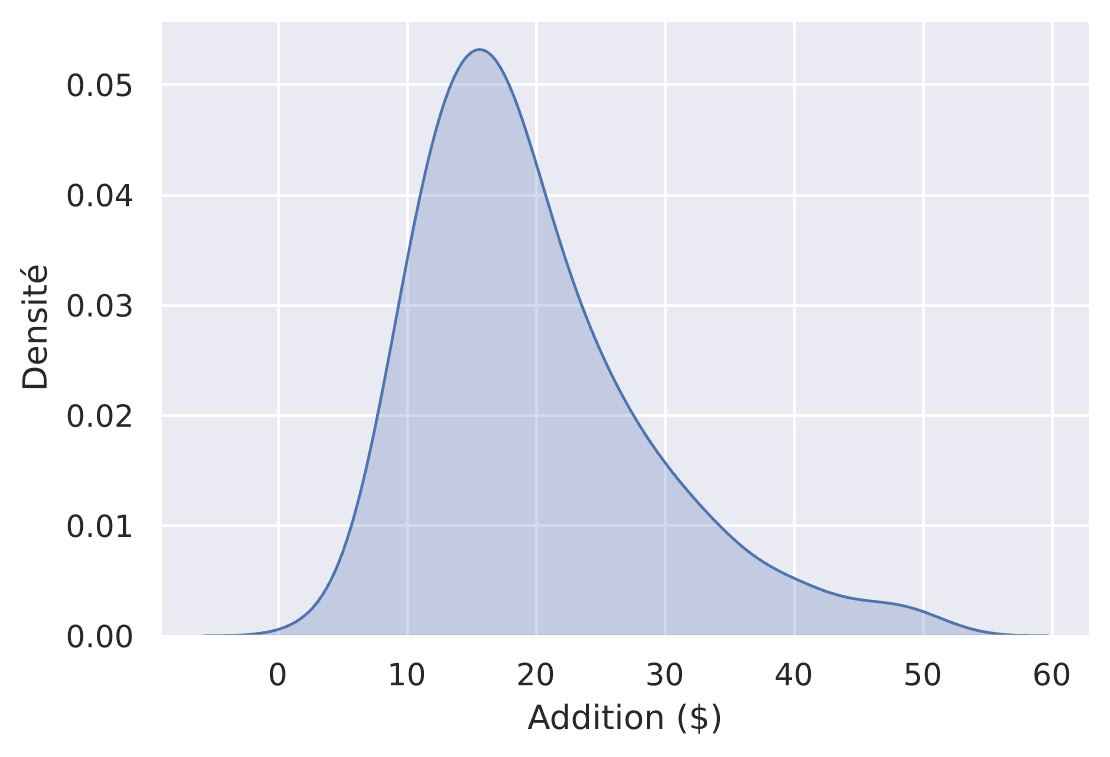
6. Densité du noyau en 2D
Deux variables numériques : la couleur indique la densité conjointe, c’est-à-dire où les points se concentrent. Voici un exemple avec des données aléatoires, dans une interface orientée objet.
np.random.seed(1)
numerical_1 = np.random.randn(100)
np.random.seed(2)
numerical_2 = np.random.randn(100)

fig, ax = plt.subplots(figsize=(5, 5))
sns.kdeplot(x=numerical_1, y=numerical_2, ax=ax, fill=True, color="blue")
plt.show()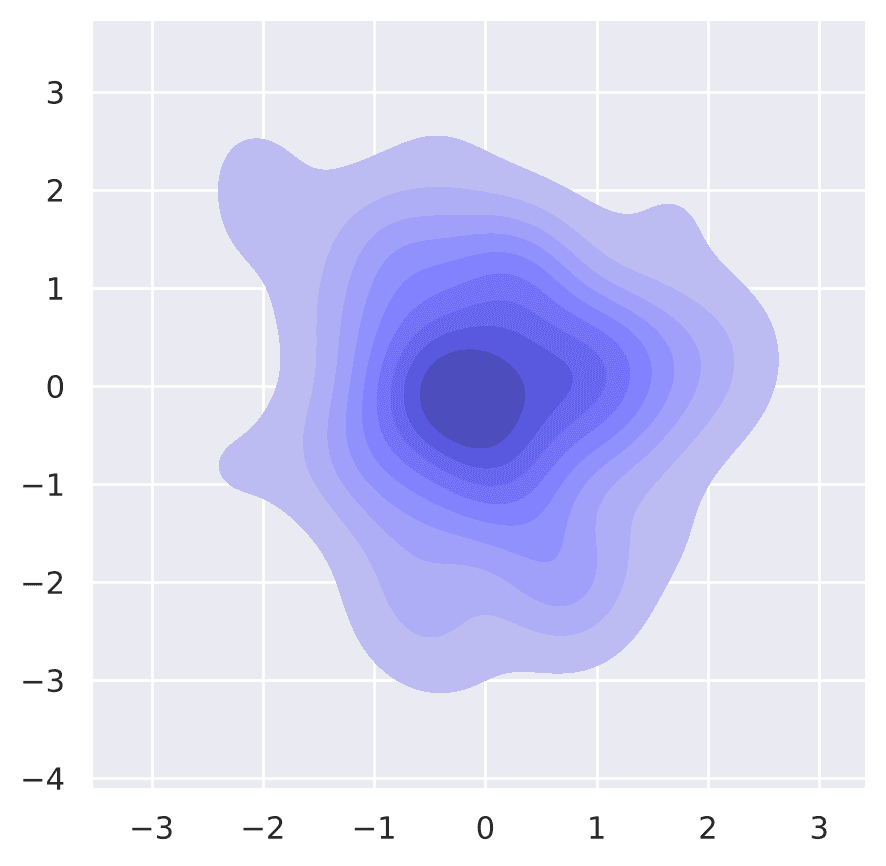
La clé est l’argument ax=ax : en exécutant sns.kdeplot(), Seaborn dessine dans l’objet ax. Cette syntaxe fonctionne avec toutes les fonctions Seaborn « au niveau des axes » (scatterplot, histplot, boxplot, etc.).
7. Boîte à moustaches (box plot)
Une variable catégorielle en x, une variable numérique en y. Pour chaque catégorie, la boîte résume la répartition : médiane, premier et troisième quartiles, étendue et valeurs extrêmes. Fonction : sns.boxplot().
fig, ax = plt.subplots(figsize=(6, 4))
sns.boxplot(data=tips, x="day", y="total_bill", ax=ax)
ax.set(xlabel="Jour", ylabel="Addition ($)")
plt.show()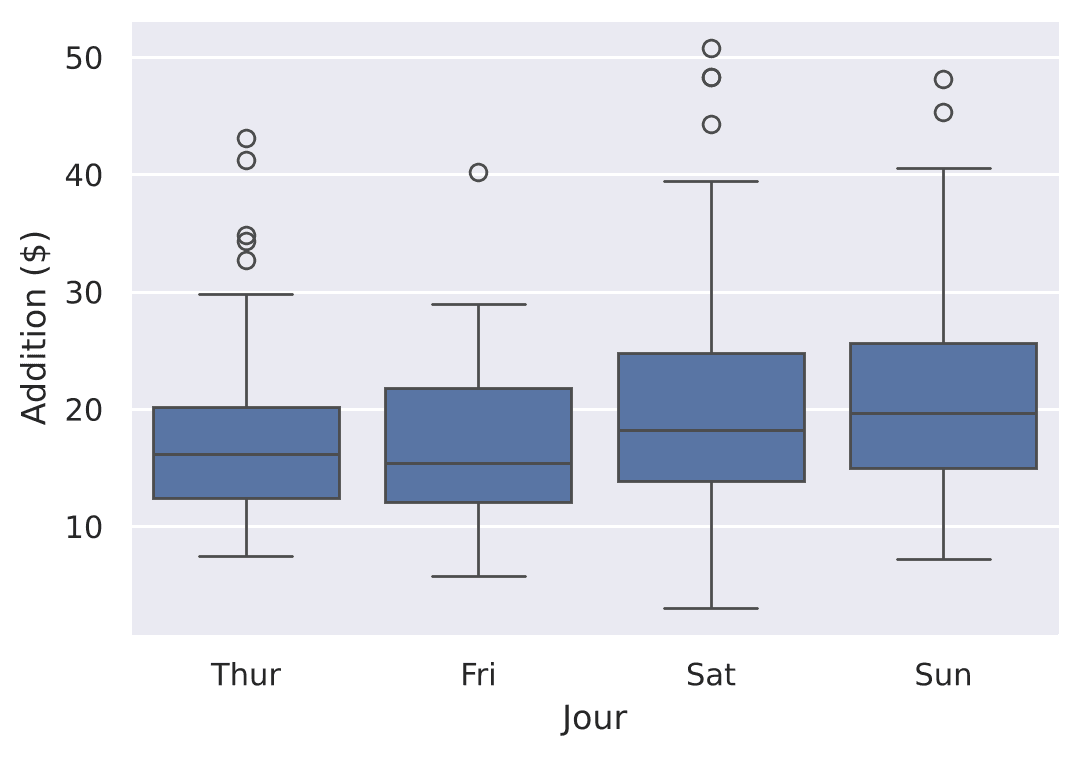
Avec Matplotlib 3.11, Seaborn 0.13 peut afficher un avertissement vert: bool was deprecated : il est sans conséquence sur le résultat.
8. Diagramme en violon (violin plot)
Même principe que la boîte à moustaches, mais le « violon » montre toute la forme de la distribution en plus des quartiles. Fonction : sns.violinplot().
fig, ax = plt.subplots(figsize=(6, 4))
sns.violinplot(data=tips, x="day", y="total_bill", ax=ax)
ax.set(xlabel="Jour", ylabel="Addition ($)")
plt.show()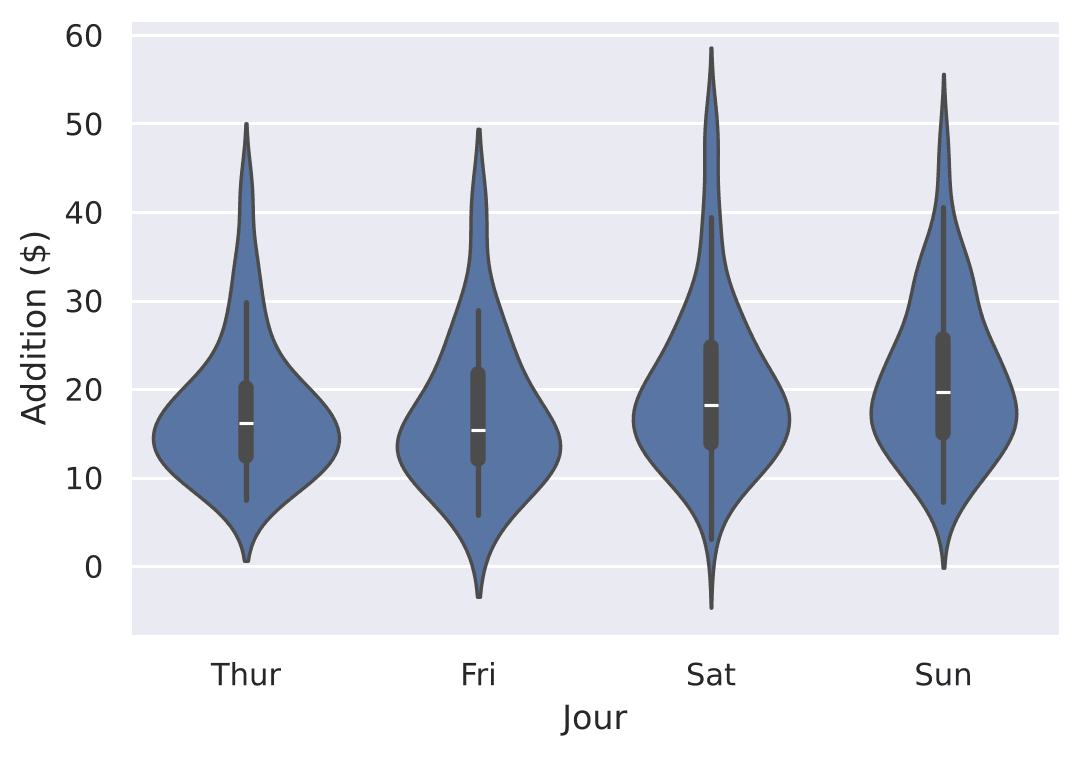
9. Carte de chaleur (heatmap)
Deux variables catégorielles (en x et en y) et une valeur numérique représentée par la couleur : par exemple le nombre d’observations de chaque paire de catégories. Il faut d’abord mettre les données au format « tableau croisé » avec pivot() : essaie d’afficher pivot_table pour voir à quoi il ressemble.
df = pd.DataFrame(dict(
    categorical_1=['apple', 'banana', 'grapes'] * 3,
    categorical_2=['A', 'A', 'A', 'B', 'B', 'B', 'C', 'C', 'C'],
    value=[10, 2, 5, 7, 3, 15, 1, 6, 8]))

pivot_table = df.pivot(index="categorical_1", columns="categorical_2", values="value")
print(pivot_table)

fig, ax = plt.subplots(figsize=(5, 4))
sns.heatmap(data=pivot_table, cmap="Blues", annot=True, ax=ax)
plt.show()categorical_2 A B C
categorical_1
apple 10 7 1
banana 2 3 6
grapes 5 15 8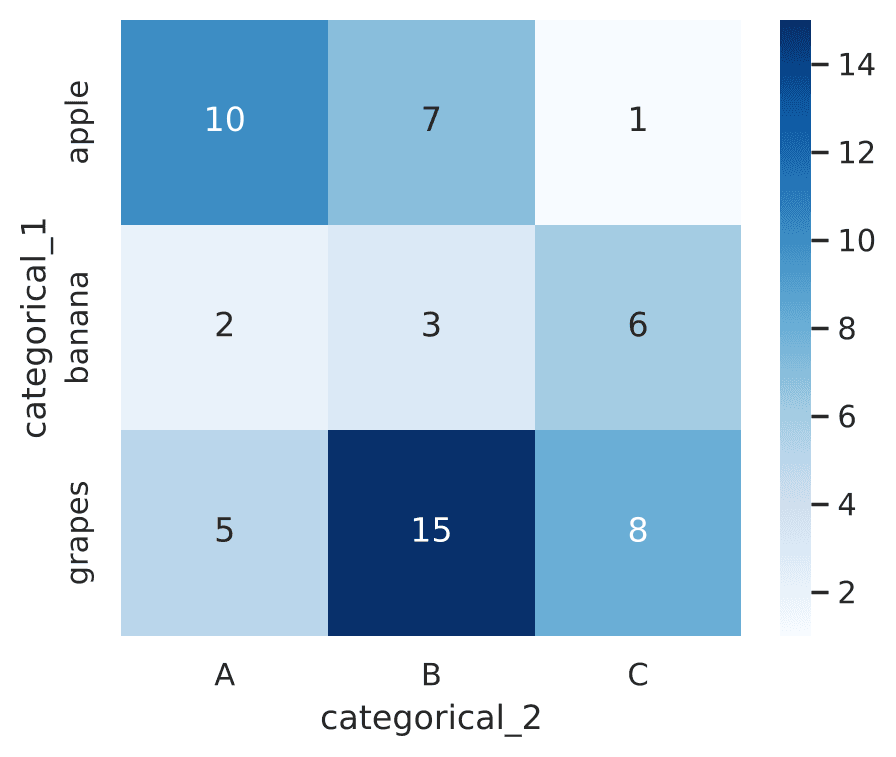
Pour tracer d’autres graphiques, consulte la page Overview of seaborn plotting functions de la documentation Seaborn.
Comment ajouter des dimensions à tes graphiques ?
Un graphique de base affiche 2 ou 3 variables. Et si tu veux montrer plus d’informations ? Voici plusieurs possibilités.
Superposer des tracés
Si plusieurs lignes partagent les mêmes variables x et y, appelle la fonction Seaborn plusieurs fois avec le même ax. Ici, on ajoute une variable catégorielle supplémentaire (alpha et beta) grâce à deux tracés superposés. L’argument label alimente la légende.
fig, ax = plt.subplots(figsize=(5, 4))
sns.lineplot(x=['A', 'B', 'C', 'D'], y=[4, 2, 5, 3], color='r', label='alpha', ax=ax)
sns.lineplot(x=['A', 'B', 'C', 'D'], y=[1, 6, 2, 4], color='b', label='beta', ax=ax)
plt.show()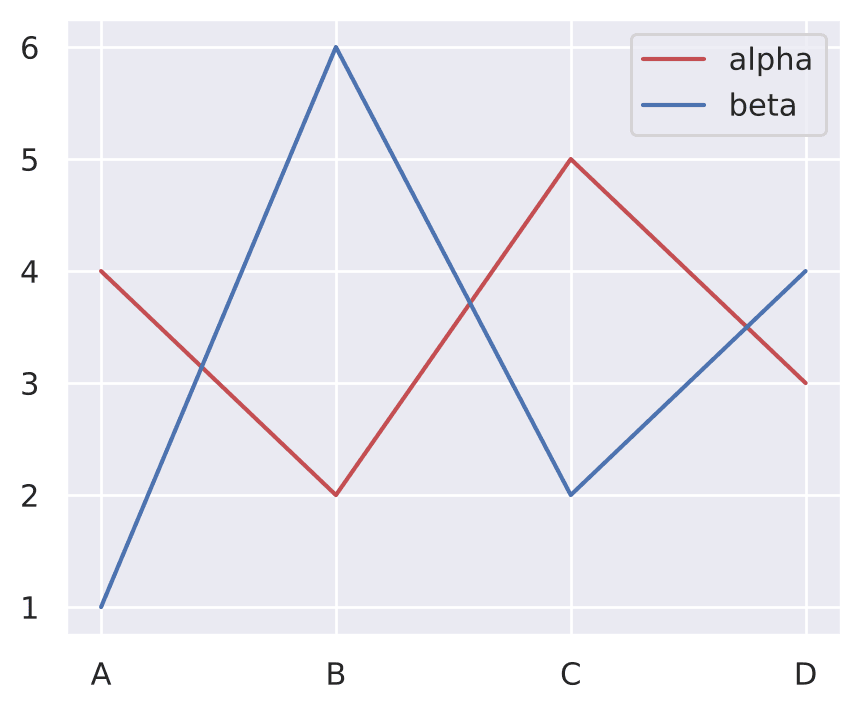
Tu peux aussi combiner un diagramme à barres et un tracé linéaire qui partagent le même axe x mais pas le même axe y :
sns.set_theme(style="white", rc={"lines.linewidth": 3})

fig, ax1 = plt.subplots(figsize=(5, 4))
ax2 = ax1.twinx()

sns.barplot(x=['A', 'B', 'C', 'D'], y=[100, 200, 135, 98], color='#004488', ax=ax1)
sns.lineplot(x=['A', 'B', 'C', 'D'], y=[4, 2, 5, 3], color='r', marker="o", ax=ax2)

ax1.set_ylabel("Ventes")
ax2.set_ylabel("Taux de retour (%)")
plt.show()

sns.set_theme()  # retour au style par défaut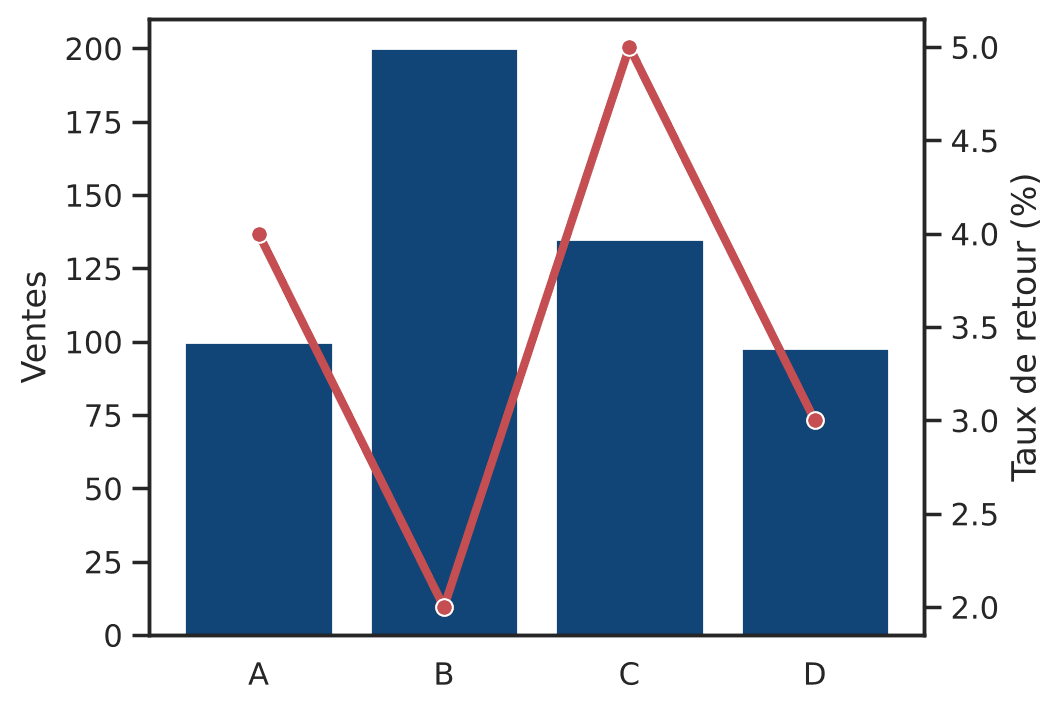
Comme les deux tracés n’ont pas la même échelle sur l’axe y, on crée un second objet « axes » partageant le même axe x avec twinx(), puis on trace chaque graphique sur son propre axe. La fonction sns.set_theme(...) définit un style pour le graphique, et on rappelle sns.set_theme() à la fin pour revenir au style par défaut.
Assembler plusieurs séries de barres en un diagramme à barres groupées ajoute aussi une dimension catégorielle. Voici la version « à la main », avec une boucle :
categorical_1 = ['A', 'B', 'C', 'D']
colors = ['green', 'red', 'blue', 'orange']
numerical = [[6, 9, 2, 7],
             [6, 7, 3, 8],
             [9, 11, 13, 15],
             [3, 5, 9, 6]]

number_groups = len(categorical_1)
bin_width = 1.0 / (number_groups + 1)

fig, ax = plt.subplots(figsize=(6, 5))

for i in range(number_groups):
    ax.bar(x=np.arange(len(categorical_1)) + i * bin_width,
           height=numerical[i],
           width=bin_width,
           color=colors[i],
           align='center')

# number_groups / (2 * (number_groups + 1)) : décalage des étiquettes de l'axe x
ax.set_xticks(np.arange(len(categorical_1)) + number_groups / (2 * (number_groups + 1)))
ax.set_xticklabels(categorical_1)
ax.legend(categorical_1)
plt.show()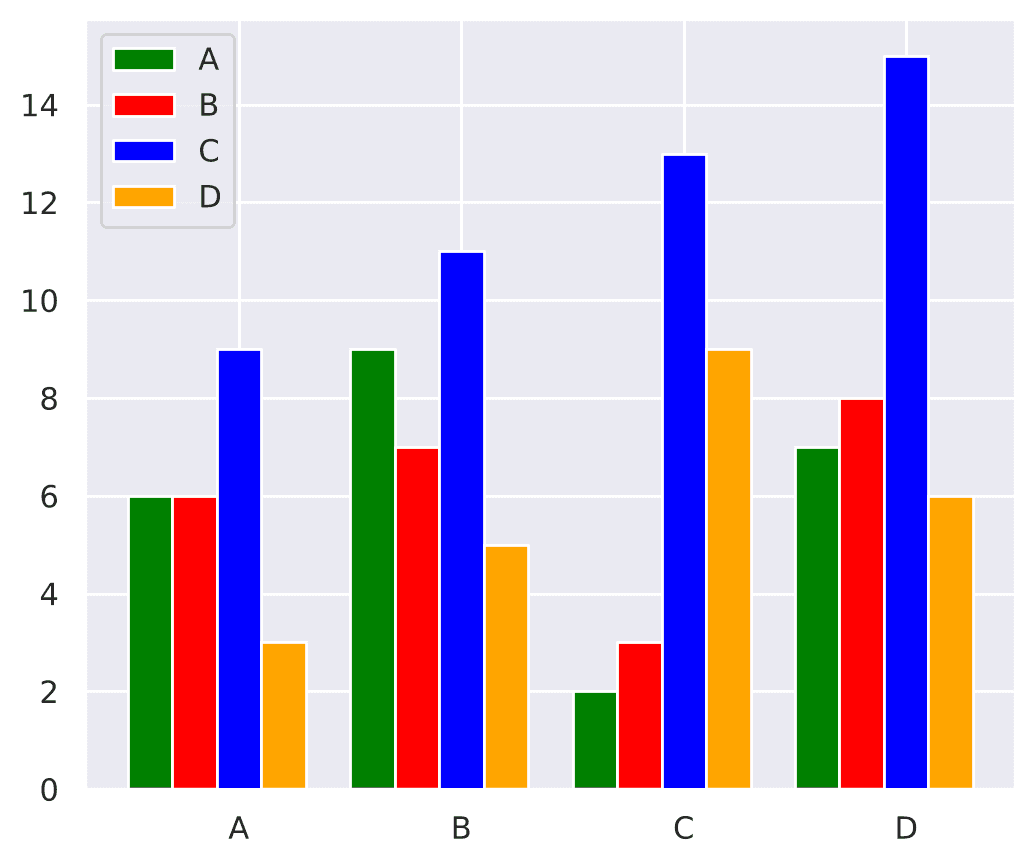
Dans ce code, tu peux personnaliser les noms, les couleurs et la taille de la figure. Les variables number_groups et bin_width se calculent à partir des données d’entrée. Une boucle trace les barres une couleur à la fois, et les graduations et la légende arrivent à la fin.
Quand tes données sont dans un DataFrame, Seaborn fait tout ce travail pour toi avec l’argument hue :
fig, ax = plt.subplots(figsize=(6, 4))
sns.barplot(data=tips, x="day", y="tip", hue="sex", ax=ax)
ax.set(xlabel="Jour", ylabel="Pourboire moyen ($)", ylim=(0, 4.8))
ax.legend(title="Sexe", ncol=2, loc="upper left")
plt.show()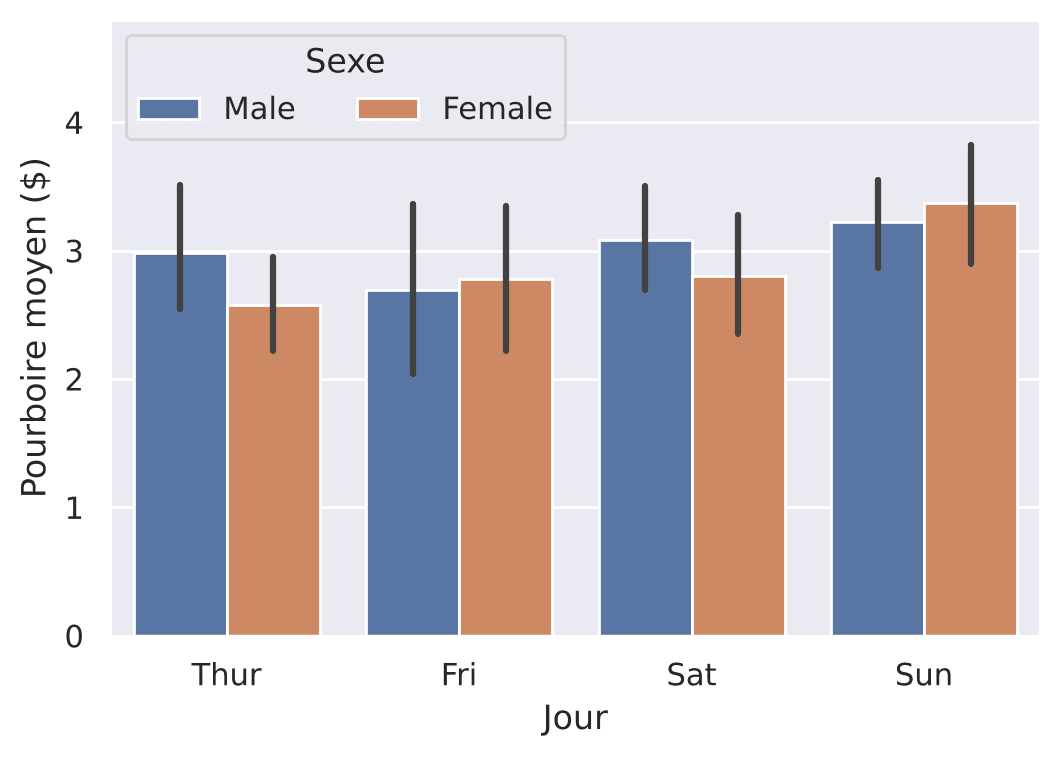
Facettes : une figure par catégorie
Un graphique à facettes (facet) découpe le jeu de données en plusieurs graphiques, un par valeur d’une ou deux variables catégorielles. Les fonctions Seaborn « au niveau de la figure » (relplot, displot, catplot) le font en une ligne :
g = sns.relplot(data=tips, x="total_bill", y="tip",
                col="time", hue="smoker", height=3.5)
plt.show()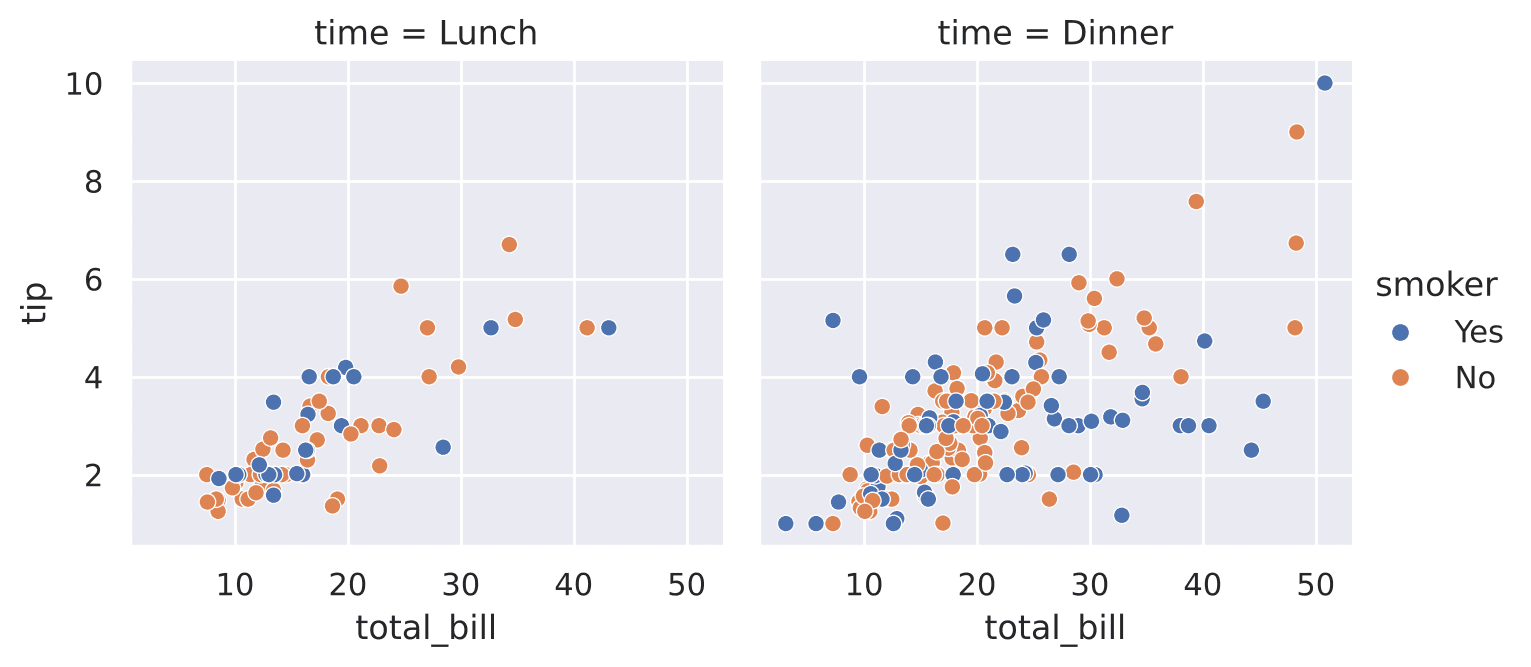
Ces fonctions créent leur propre figure : tu ne peux donc pas leur passer ax=ax. Pour construire une figure sur mesure, comme dans la dernière partie de ce guide, utilise les fonctions « au niveau des axes » (scatterplot, kdeplot, etc.). Tu trouveras beaucoup d’exemples dans la documentation de FacetGrid.
Couleur, forme et taille des points d’un nuage de points
Un nuage de points peut afficher jusqu’à cinq variables : x, y, la couleur (hue), la taille (size) et le style (style). L’exemple suivant, adapté de la documentation de sns.scatterplot, utilise la taille du groupe pour la couleur et la taille des points :
fig, ax = plt.subplots(figsize=(6, 4))
sns.scatterplot(data=tips, x="total_bill", y="tip",
                hue="size", size="size", sizes=(20, 200),
                hue_norm=(0, 7), legend="full", ax=ax)
plt.show()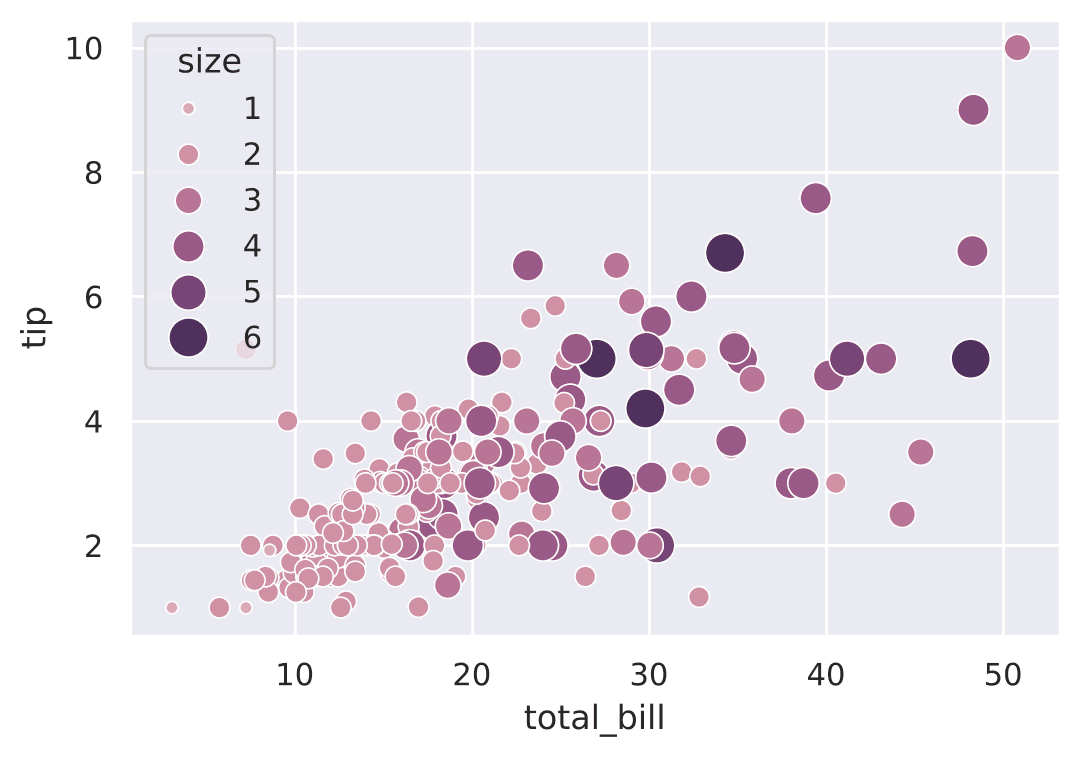
Comment partitionner une figure avec GridSpec ?
L’un des avantages de l’interface orientée objet est de pouvoir diviser la figure en plusieurs sous-graphiques et de manipuler chacun avec l’API « axes ».
import matplotlib.gridspec as gridspec

fig = plt.figure(figsize=(7, 7))

gs = gridspec.GridSpec(nrows=3, ncols=3, figure=fig,
                       width_ratios=[1, 1, 1],
                       height_ratios=[1, 1, 1],
                       wspace=0.3, hspace=0.3)

ax1 = fig.add_subplot(gs[0, 0])
ax1.text(0.5, 0.5, 'ax1: gs[0, 0]', fontsize=12, fontweight="bold", va="center", ha="center")

ax2 = fig.add_subplot(gs[0, 1:3])
ax2.text(0.5, 0.5, 'ax2: gs[0, 1:3]', fontsize=12, fontweight="bold", va="center", ha="center")

ax3 = fig.add_subplot(gs[1:3, 0:2])
ax3.text(0.5, 0.5, 'ax3: gs[1:3, 0:2]', fontsize=12, fontweight="bold", va="center", ha="center")

ax4 = fig.add_subplot(gs[1:3, 2])
ax4.text(0.5, 0.5, 'ax4: gs[1:3, 2]', fontsize=12, fontweight="bold", va="center", ha="center")

plt.show()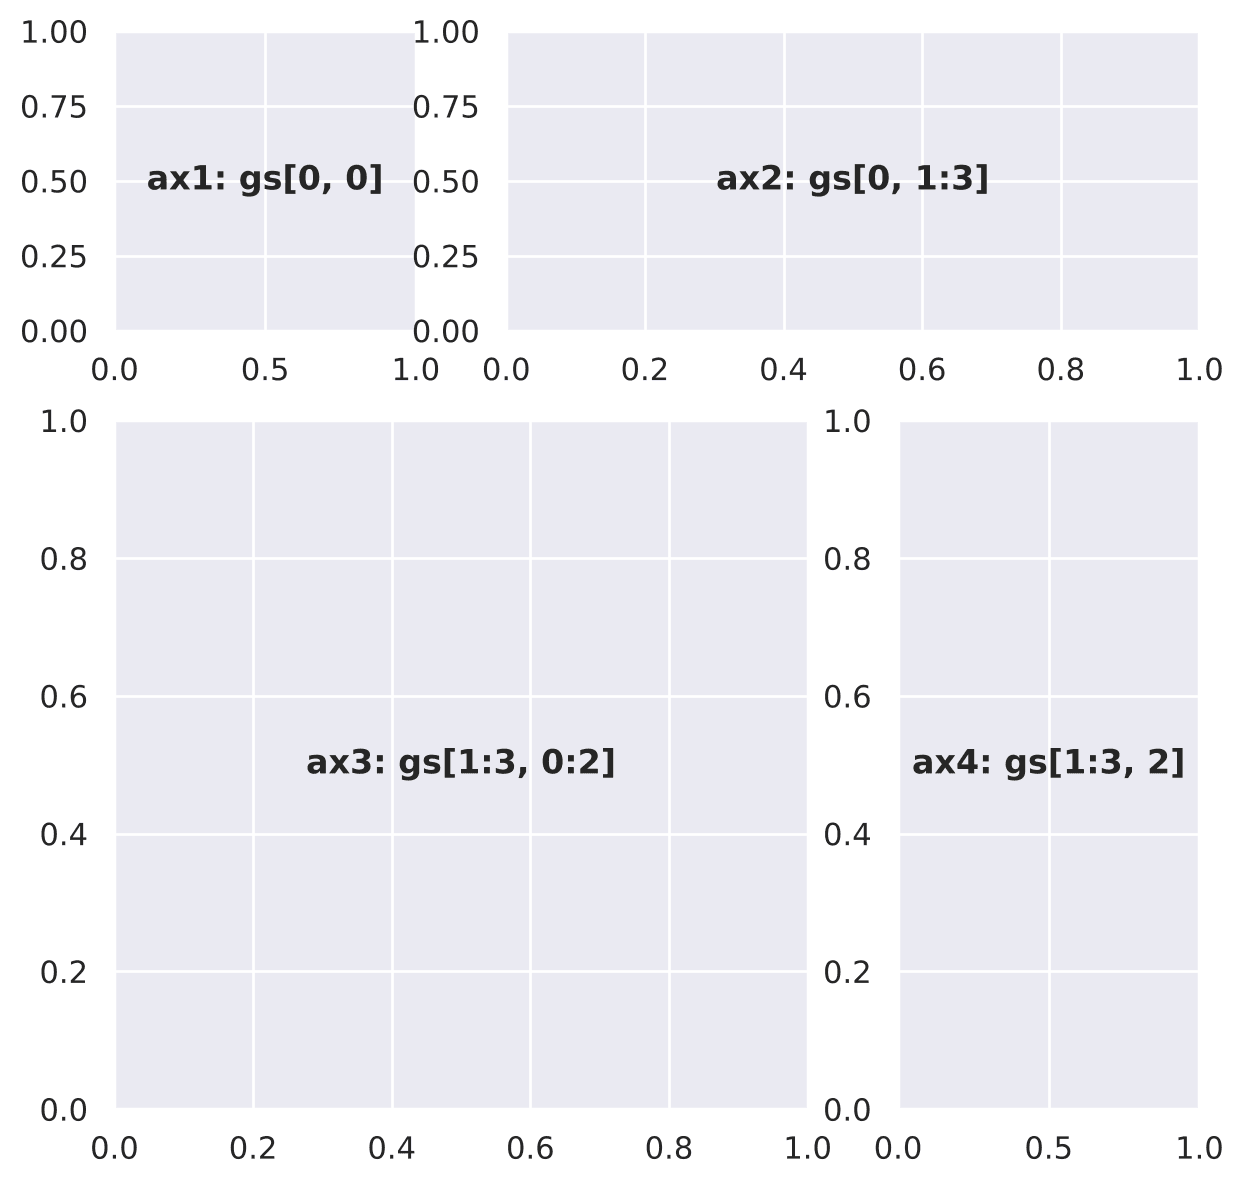
On divise d’abord la figure en 3 × 3 = 9 cases avec gridspec.GridSpec(), puis on définit quelques objets axes. Chaque objet peut occuper une ou plusieurs cases : par exemple, gs[0, 1:3] = gs[0, 1] + gs[0, 2] est attribué à ax2. Les paramètres wspace et hspace contrôlent l’espace entre les graphiques.
Depuis Matplotlib 3.3, subplot_mosaic() propose une écriture plus lisible : tu dessines la disposition avec des noms, et les cases qui portent le même nom fusionnent. Voici exactement la même disposition :
fig, axd = plt.subplot_mosaic([["ax1", "ax2", "ax2"],
                               ["ax3", "ax3", "ax4"],
                               ["ax3", "ax3", "ax4"]],
                              figsize=(7, 7), layout="constrained")

for nom, ax in axd.items():
    ax.text(0.5, 0.5, nom, fontsize=12, fontweight="bold", va="center", ha="center")

plt.show()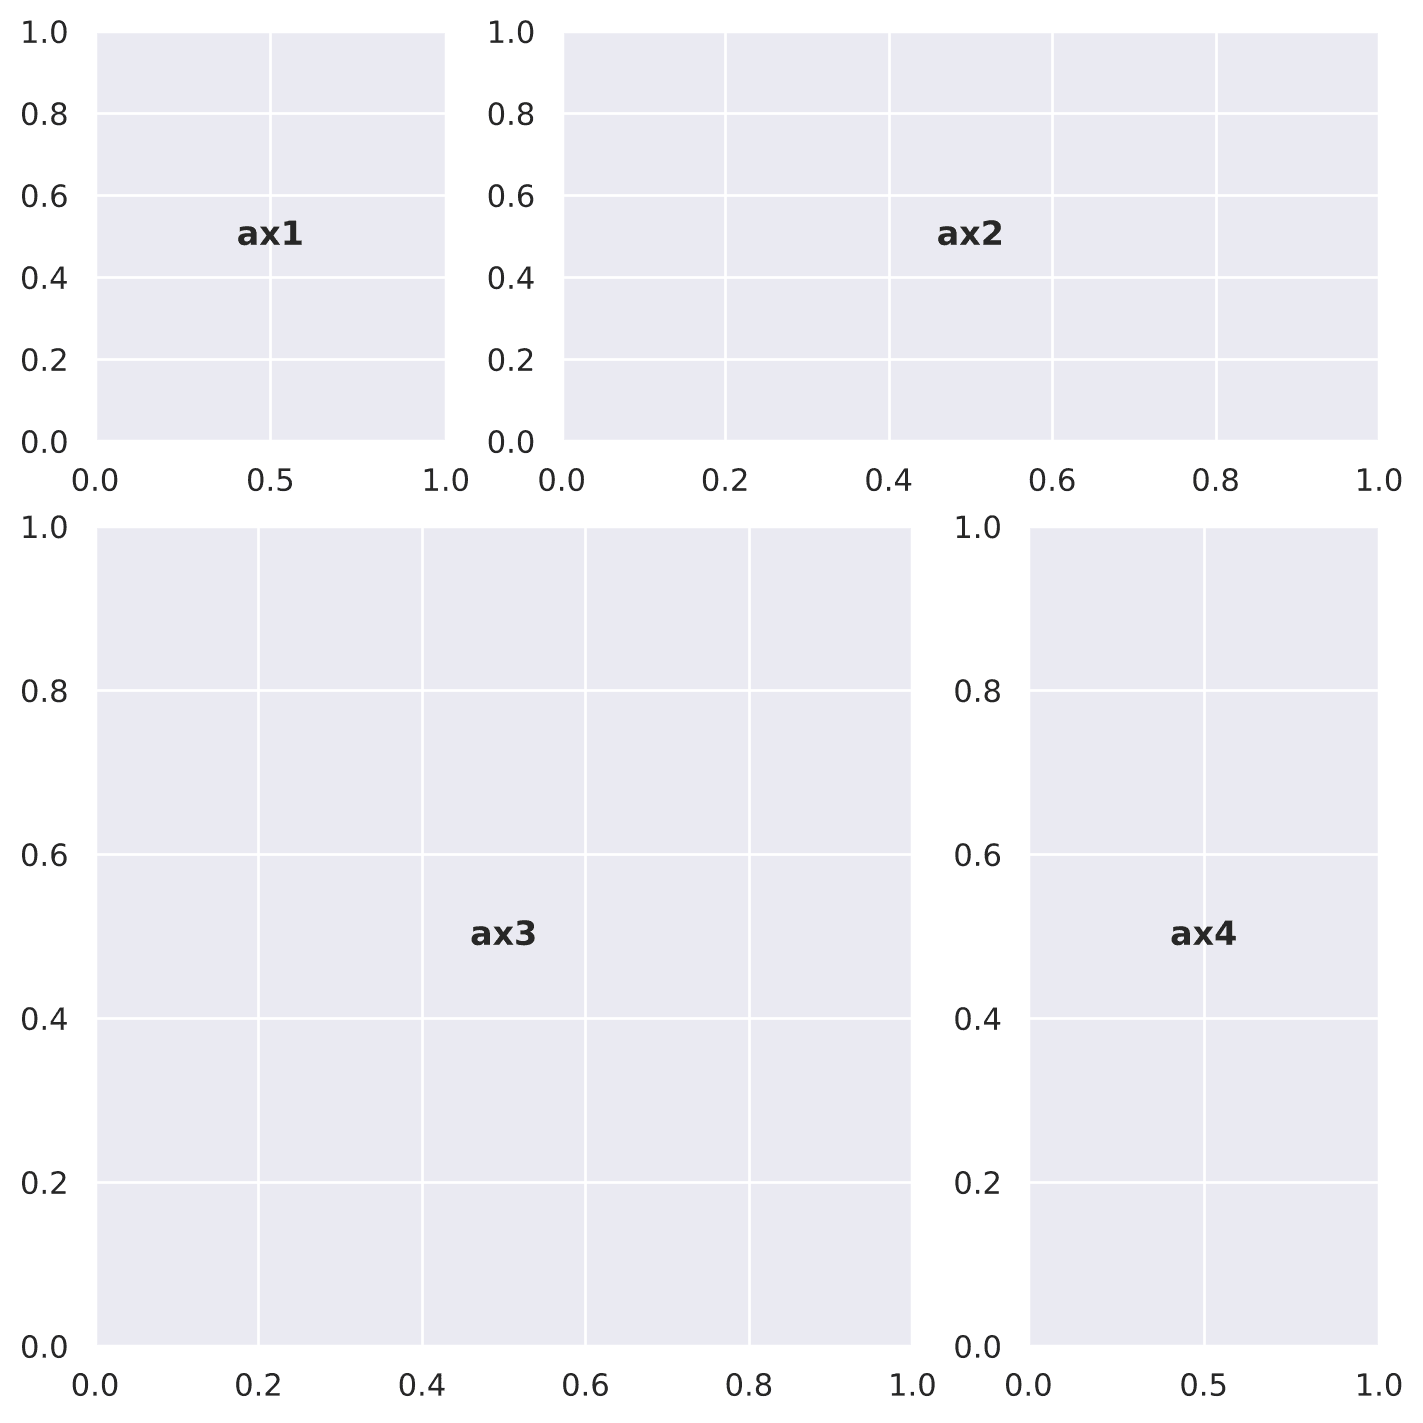
La documentation détaille les deux approches dans Arranging multiple Axes in a Figure.
Créer une visualisation de données Python avancée : les ventes du Black Friday
Avec les sections précédentes, tu as tout ce qu’il faut pour produire quelque chose d’intéressant. On utilise les données de ventes du Black Friday d’un magasin, issues d’un concours Analytics Vidhya : 550 068 achats, avec l’identifiant du client, son sexe, sa tranche d’âge et le montant de l’achat. Le fichier est hébergé sur GitHub : le code le lit directement depuis son adresse, sans rien télécharger.
url = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/guide-visualisations-de-donnees-python/black-friday.csv"
df = pd.read_csv(url, usecols=['User_ID', 'Gender', 'Age', 'Purchase'])
print(df.shape)
print(df.head())(550068, 4)
User_ID Gender Age Purchase
0 1000001 F 0-17 8370
1 1000001 F 0-17 15200
2 1000001 F 0-17 1422
3 1000001 F 0-17 1057
4 1000002 M 55+ 7969Chaque ligne est un achat, mais nous voulons analyser les clients. On regroupe donc les achats par client : le prix moyen de ses achats, son sexe et sa tranche d’âge.
# Un client = une ligne : prix moyen de ses achats, avec son sexe et sa tranche d'âge
df_gp = df.groupby('User_ID', as_index=False).agg(
    Purchase=('Purchase', 'mean'),
    Gender=('Gender', 'first'),
    Age=('Age', 'first'))

print(df_gp.shape)
print(df_gp.head())(5891, 4)
User_ID Purchase Gender Age
0 1000001 9545.514286 F 0-17
1 1000002 10525.610390 M 55+
2 1000003 11780.517241 M 26-35
3 1000004 14747.714286 M 46-50
4 1000005 7745.292453 M 26-35On a maintenant un tableau de 5 891 clients. Vérifions que le sexe et la tranche d’âge sont bien uniques pour chaque client (sinon, 'first' ne serait pas un bon choix) :
# Le sexe et l'âge sont-ils bien uniques pour chaque client ?
print(df.groupby('User_ID')[['Gender', 'Age']].nunique().max())Gender 1
Age 1
dtype: int64Chaque maximum vaut 1 : chaque client n’a bien qu’un seul sexe et une seule tranche d’âge.
Étape 1 : l’objectif
On veut savoir comment l’âge et le sexe influencent le montant moyen des achats pendant le Black Friday, et voir aussi la répartition de ces montants. On veut également connaître le poids de chaque tranche d’âge parmi les clients.
Étape 2 : les variables
Le graphique doit contenir la tranche d’âge (catégorielle), le sexe (catégorielle), le montant moyen par client (numérique) et sa distribution. Il faut aussi un second graphique avec le pourcentage de clients de chaque tranche d’âge.
Pour montrer le montant moyen et sa distribution, on peut choisir une densité du noyau (KDE), une boîte à moustaches ou un violon. La KDE montre le mieux la distribution. On trace deux KDE dans le même graphique (une pour les hommes, une pour les femmes), répétées pour chaque tranche d’âge, ce qui revient à un graphique à facettes. Pour le pourcentage par tranche d’âge, un diagramme à barres suffit.
print(df_gp.groupby('Gender')['Purchase'].mean().round(0))
print(df_gp['Age'].value_counts(normalize=True).sort_index().mul(100).round(1))Gender
F 8965.0
M 9807.0
Name: Purchase, dtype: float64
Age
0-17 3.7
18-25 18.1
26-35 34.8
36-45 19.8
46-50 9.0
51-55 8.2
55+ 6.3
Name: proportion, dtype: float64Étape 3 : la visualisation
Une fois les variables choisies, on réfléchit à la mise en page : on partitionne la figure, on masque certaines bordures et graduations, puis on ajoute un diagramme à barres sur la droite. Voici le graphique que nous allons construire :
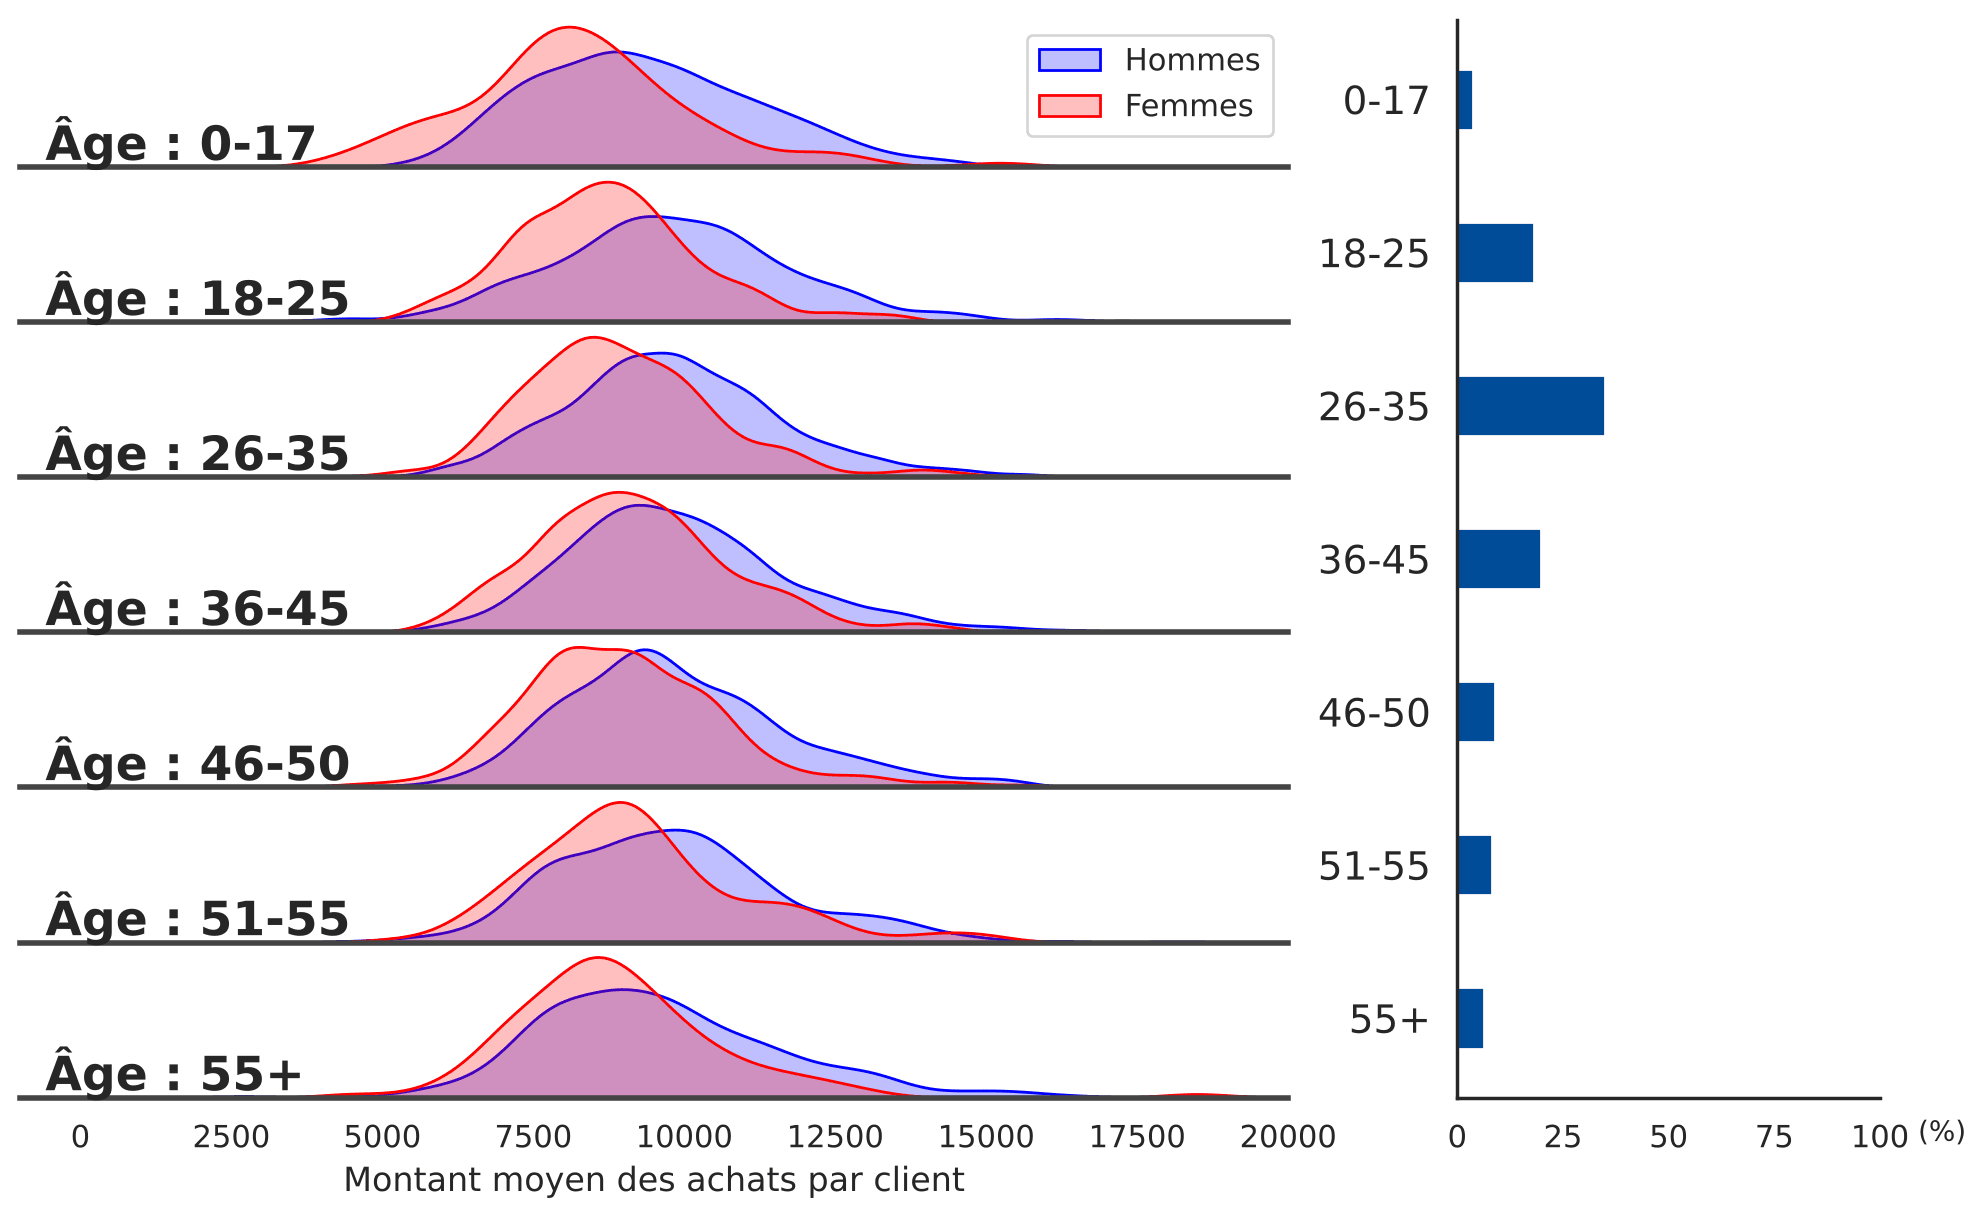
Le code ci-dessous génère ce graphique. Les commentaires expliquent chaque étape ; modifie les paramètres pour voir ce que fait chaque commande.
# Pourcentage de clients dans chaque tranche d'âge (7 tranches, triées)
freq = df_gp['Age'].value_counts(normalize=True).sort_index() * 100
age_groups = freq.index.tolist()
number_gp = len(age_groups)

def ax_settings(ax, var_name, x_min, x_max):
    ax.set_xlim(x_min, x_max)
    ax.set_yticks([])
    ax.set_ylabel('')

    ax.spines['left'].set_visible(False)
    ax.spines['right'].set_visible(False)
    ax.spines['top'].set_visible(False)

    ax.spines['bottom'].set_edgecolor('#444444')
    ax.spines['bottom'].set_linewidth(2)

    ax.text(0.02, 0.05, var_name, fontsize=17, fontweight="bold", transform=ax.transAxes)

# Figure découpée en 7 lignes x 2 colonnes (3/4 de la largeur pour les KDE, 1/4 pour les barres)
sns.set_theme(style="white")
fig = plt.figure(figsize=(12, 7))
gs = gridspec.GridSpec(nrows=number_gp, ncols=2, figure=fig,
                       width_ratios=[3, 1], height_ratios=[1] * number_gp,
                       wspace=0.2, hspace=0.05)

ax = [None] * (number_gp + 1)

# Une ligne par tranche d'âge : une KDE pour les hommes (bleu), une pour les femmes (rouge)
for i in range(number_gp):
    ax[i] = fig.add_subplot(gs[i, 0])
    ax_settings(ax[i], 'Âge : ' + age_groups[i], -1000, 20000)

    hommes = df_gp[(df_gp.Gender == 'M') & (df_gp.Age == age_groups[i])]
    femmes = df_gp[(df_gp.Gender == 'F') & (df_gp.Age == age_groups[i])]
    sns.kdeplot(data=hommes, x='Purchase', ax=ax[i], fill=True, color="blue", bw_adjust=0.8, label='Hommes')
    sns.kdeplot(data=femmes, x='Purchase', ax=ax[i], fill=True, color="red", bw_adjust=0.8, label='Femmes')

    ax[i].set_ylabel('')
    if i < number_gp - 1:
        ax[i].set_xticks([])

ax[0].legend()
ax[number_gp - 1].set_xlabel('Montant moyen des achats par client')

# Colonne de droite : diagramme à barres horizontales des pourcentages
ax[number_gp] = fig.add_subplot(gs[:, 1])
ax[number_gp].spines['right'].set_visible(False)
ax[number_gp].spines['top'].set_visible(False)
ax[number_gp].barh(age_groups, freq, color='#004c99', height=0.4)
ax[number_gp].set_xlim(0, 100)
ax[number_gp].invert_yaxis()
ax[number_gp].text(1.09, -0.04, '(%)', fontsize=10, transform=ax[number_gp].transAxes)
ax[number_gp].tick_params(axis='y', labelsize=14)

plt.show()Deux changements par rapport aux anciennes versions de ce code : shade=True s’écrit désormais fill=True, et le paramètre bw=300 (largeur de bande absolue) est remplacé par bw_adjust, un coefficient qui multiplie le lissage automatique. Plus il est grand, plus la courbe est lisse.
Que lit-on sur le graphique ? Dans toutes les tranches d’âge, la courbe des hommes (en bleu) est décalée vers la droite : les clients masculins dépensent en moyenne davantage par achat que les clientes (9 807 contre 8 965 en moyenne, soit 9 % de plus). L’effet de l’âge est plus discret : le montant moyen des femmes augmente globalement avec l’âge, de 0-17 ans à 51-55 ans, tandis que celui des hommes reste presque constant. Enfin, le diagramme de droite montre que les 18-45 ans représentent environ 73 % des clients, et les 26-35 ans à eux seuls 35 %.
Questions fréquentes
Quelle différence entre Matplotlib et Seaborn ?
Matplotlib est la bibliothèque de base : elle dessine tout, mais demande plus de code. Seaborn s’appuie sur Matplotlib et propose des fonctions de plus haut niveau (histogrammes, boîtes à moustaches, cartes de chaleur) avec de beaux styles par défaut. On les utilise ensemble : Seaborn pour tracer, Matplotlib pour assembler et personnaliser la figure.
Quelle différence entre l’interface fonctionnelle et l’interface orientée objet ?
L’interface fonctionnelle (plt.plot(), plt.title()) agit sur la figure courante : c’est rapide pour un graphique simple. L’interface orientée objet crée explicitement une figure et des axes (fig, ax = plt.subplots()) puis appelle leurs méthodes (ax.plot(), ax.set_title()). Elle donne un contrôle total et devient indispensable dès que la figure contient plusieurs graphiques.
Comment utiliser Seaborn et Matplotlib dans la même figure ?
Crée la figure et les axes avec Matplotlib (fig, ax = plt.subplots() ou GridSpec), puis passe l’objet ax à la fonction Seaborn avec l’argument ax=ax. Seaborn dessine alors dans cet axe, et tu peux continuer à le personnaliser avec les méthodes Matplotlib. Seules les fonctions « au niveau de la figure » (relplot, displot, catplot) n’acceptent pas ax.
Comment choisir le bon type de graphique ?
Pars de tes variables. Deux variables numériques : nuage de points. Une évolution dans le temps : tracé linéaire. Une catégorie et un nombre : diagramme à barres. Une distribution : histogramme ou KDE. Une distribution par catégorie : boîte à moustaches ou violon. Deux catégories et un nombre : carte de chaleur.
Pourquoi sns.distplot, shade, bw ou data2 provoquent-ils un avertissement ou une erreur ?
Ces éléments sont obsolètes dans Seaborn 0.13 : distplot, shade et bw affichent un avertissement (ils fonctionnent encore, mais ne vont pas durer), tandis que data2 et l’appel de pivot() avec des arguments positionnels provoquent une erreur. Voici les équivalents modernes : distplot() est remplacée par histplot() (ou displot() pour une figure à facettes), shade=True par fill=True, bw par bw_adjust et data2 par les arguments x et y. Avec pivot(), écris index=, columns= et values=.
Conclusion
Tu sais maintenant choisir une interface Matplotlib, nommer les éléments d’une figure, tracer les graphiques courants avec Seaborn, ajouter des dimensions et assembler une figure complète avec GridSpec. Pour aller plus loin, essaie de refaire le graphique du Black Friday en remplaçant l’âge par une autre variable du jeu de données, comme la ville ou le métier du client.
Savoir tracer un graphique, c’est bien ; savoir choisir celui qui raconte la bonne histoire, c’est mieux. Le cours Analyse et visualisation de données de DataXp t’entraîne sur des jeux de données réels (annonces eBay, trafic de l’autoroute I-94, taux de change de l’euro). Tu écris et exécutes ton code dans le navigateur, avec 128 exercices, et les 3 premiers chapitres sont gratuits.
Pour compléter ce guide, tu peux lire Visualisations de données Python : comparaison d’outils, Visualisations de données Python : nuage de points et Matplotlib : visualisation de données.
Bonjour, j’ai vu après que “Purchase” était une variable et non une fonction. thanks a lot
Bonjour et bonne année, j’ai apprécié votre article surtout sur l’étape de visualisation des données. Malheureusement, j’ai erreur avec l’argument “Purchase”. comment je peux éviter cette erreur de mon code “AttributeError: ‘DataFrame’ object has no attribute ‘Purchase'”, ça vient de quelle librairie svp. Merci beaucoup
Purchase est une colonne du dataframe, non un attribut