Cela fait peut-être un moment que tu programmes en Python, que tu crées des scripts et que tu résous des problèmes à droite à gauche. Tu penses être plutôt bon, n’est-ce pas ? Eh bien, accroche-toi, car tu pourrais déjà avoir un niveau de programmation avancée en Python sans même t’en rendre compte !
Des fonctions closure aux gestionnaires de contexte (context managers), voici une liste de fonctionnalités avancées de Python pour tester ton niveau. Même si certaines sont nouvelles pour toi, tu obtiens une excellente liste de contrôle à compléter pour passer au niveau supérieur.
Article mis à jour en novembre 2026 : j’ai exécuté tout le code dans un vrai notebook Jupyter avec Python 3.13 (et vérifié qu’il tourne aussi avec Python 3.12, la version de Google Colab). Les sorties affichées sont donc les résultats réels, y compris les temps d’exécution, qui dépendent de ta machine. J’ai aussi corrigé quelques exemples (le compteur n’écrase plus la fonction counter, la lecture de gros fichiers s’applique à un vrai fichier de logs) et ajouté un schéma de la règle LEGB, functools.cache, contextlib.contextmanager et une FAQ.
En bref : les 5 signes d’une programmation avancée en Python sont : (1) comprendre le scope et la règle LEGB, (2) savoir utiliser les closures, (3) écrire des décorateurs, (4) exploiter les générateurs pour traiter de gros volumes de données sans saturer la mémoire et (5) créer tes propres gestionnaires de contexte avec with. Chaque point est expliqué ci-dessous avec du code testé.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
1. Maîtrises-tu le scope (la règle LEGB) ?
Un aspect essentiel de la programmation avancée en Python est la connaissance approfondie du concept de portée (ou scope en anglais).
La portée définit l’ordre dans lequel l’interpréteur Python recherche les noms dans un programme. Elle suit la règle LEGB (scopes Local, Enclosing, Global et Built-in). Lorsque tu accèdes à un nom (une variable, une fonction ou une classe), Python le cherche dans les portées local, enclosing, global puis built-in, dans cet ordre, et s’arrête au premier nom trouvé.
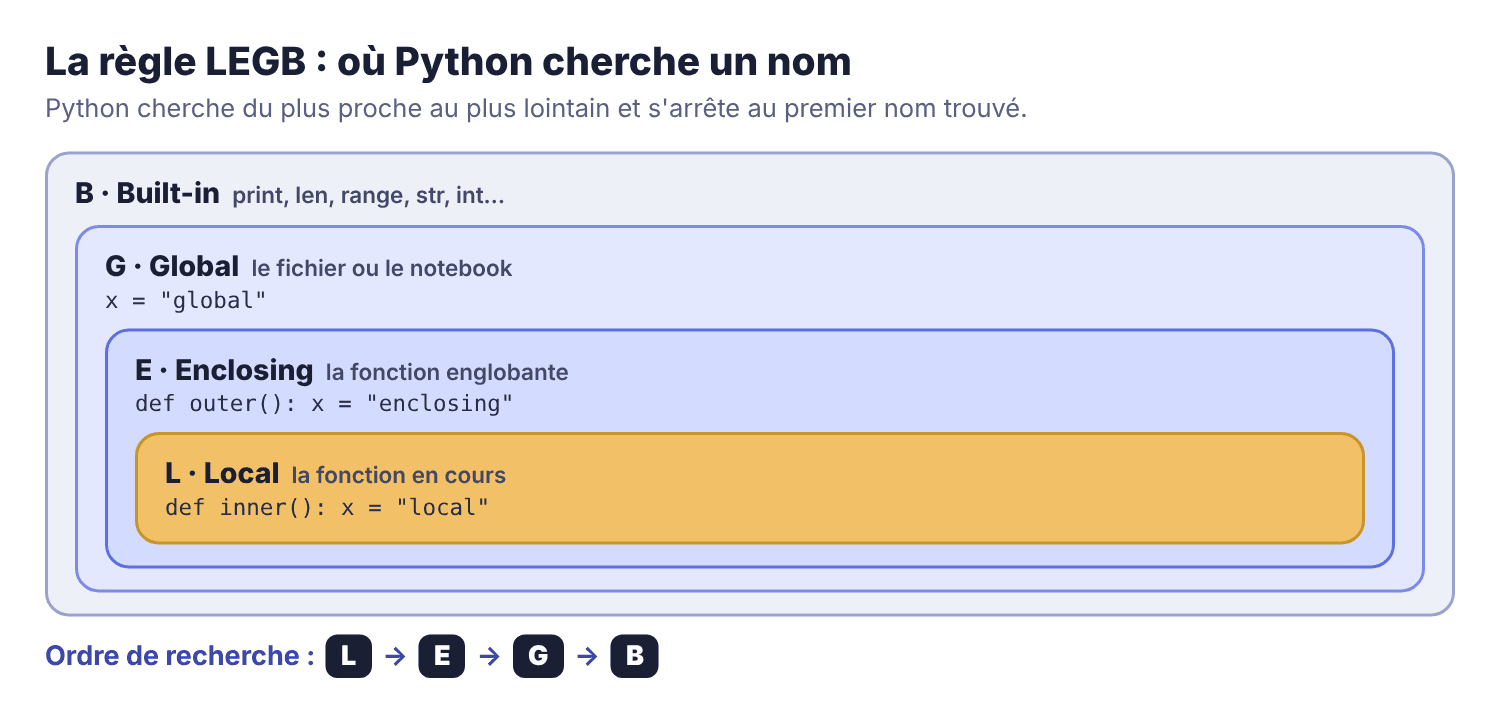
Voyons des exemples pour mieux comprendre chaque niveau.
Qu’est-ce que la portée locale (Local) ?
def func():
    x = 10
    print(x)

func()10print(x)NameError: name 'x' is not definedIci, x n’est défini que dans la portée locale de func. C’est pourquoi il n’est accessible nulle part ailleurs : en dehors de la fonction, Python lève une NameError.
Qu’est-ce que la portée englobante (Enclosing) ?
def outer_func():
    x = 20

    def inner_func():
        print(x)

    inner_func()

outer_func()20La portée englobante (enclosing en anglais) est la portée intermédiaire entre les portées locale et globale. Dans l’exemple ci-dessus, x est dans la portée locale de outer_func, mais dans la portée englobante de la fonction imbriquée inner_func. Une fonction interne peut donc lire une variable de la fonction englobante. Pour la modifier, il faut le mot-clé nonlocal, que nous verrons dans la partie sur les closures.
Qu’est-ce que la portée globale (Global) ?
x = 30

def func():
    print(x)

func()30Ici, x et func sont définis dans la portée globale : ils peuvent être lus depuis n’importe quel endroit du script en cours.
Pour modifier une variable globale depuis une fonction, il faut la déclarer avec le mot-clé global. Sans lui, Python créerait simplement une nouvelle variable locale du même nom :
def func2():
    global x
    x = 40
    print(x)

func2()
print(x)40
40À utiliser avec parcimonie : une fonction qui modifie des variables globales est plus difficile à tester et à comprendre.
Qu’est-ce que la portée intégrée (Built-in) ?
La portée intégrée (built-in en anglais) comprend toutes les fonctions, classes et variables déjà définies qui ne nécessitent pas d’instruction d’importation explicite : print, len, range, str, int, float, etc. Elles viennent du module builtins :
import builtins

print(builtins.len is len)
print(len("scope"))True
5Pour résumer les trois premiers niveaux, voici un même nom x défini à trois endroits. Python prend toujours le plus proche :
x = "global"

def outer():
    x = "enclosing"

    def inner():
        x = "local"
        print(x)

    inner()
    print(x)

outer()
print(x)local
enclosing
global2. Sais-tu ce qu’est une fonction closure ?
Une bonne compréhension du scope ouvre les portes à un autre concept important : la fonction closure.
Pourquoi une fonction oublie-t-elle ses variables ?
Par défaut, une fois que la fonction a terminé son exécution, ses variables locales sont détruites. Sa mémoire est vidée de tous ses arguments :
def carre(n):
    return n ** 2

carre(3)9print(n)NameError: name 'n' is not definedCi-dessus, nous avons attribué la valeur 3 à n, mais la fonction l’a oubliée après l’exécution. Que faire si nous ne voulons pas qu’elle oublie ?
Comment une closure garde-t-elle une variable en mémoire ?
C’est là que la fonction closure entre en jeu. En définissant une variable dans la portée d’une fonction englobante et en l’utilisant dans une fonction interne, tu la stockes dans la mémoire de la fonction interne, même après le return de la fonction englobante.
Voici un exemple simple de fonction qui compte le nombre de fois où elle a été exécutée. Le mot-clé nonlocal permet ici de modifier la variable count de la portée englobante :
def counter():
    count = 0

    def inner():
        nonlocal count
        count += 1
        return count

    return inner

compteur = counter()
print(compteur())
print(compteur())
print(compteur())1
2
3Selon les règles habituelles, nous aurions dû perdre la variable count après la première exécution. Mais elle se trouve dans le closure de la fonction interne, où elle reste tant que compteur existe. Tu peux même l’inspecter :
compteur.__closure__[0].cell_contents3compteur.__code__.co_freevars('count',)3. Sais-tu écrire un décorateur ?
Les fonctions closure ont des applications plus sérieuses que les simples compteurs. L’une d’entre elles est la création de décorateurs. Un décorateur est une fonction qui prend une fonction en argument et renvoie une version améliorée ou modifiée de celle-ci. Si tu veux aller plus loin, lis aussi Réduis ton code de moitié avec les décorateurs Python.
Comment créer un décorateur de cache ?
Par exemple, ci-dessous, nous créons un décorateur de cache qui se souvient du résultat de chaque appel, pour chaque combinaison d’arguments positionnels et nommés :
def stateful_function(func):
cache = {}
def inner(*args, **kwargs):
key = str(args) + str(kwargs)
if key not in cache:
cache[key] = func(*args, **kwargs)
return cache[key]
return innerLe décorateur stateful_function s’ajoute aux fonctions lourdes en calcul qui sont rappelées avec les mêmes arguments. Prenons la fonction récursive de Fibonacci, qui renvoie le n-ième nombre de la suite. Écrire @stateful_function au-dessus de la fonction revient à écrire fibonacci = stateful_function(fibonacci).
Dans un notebook Jupyter, la commande magique %%time mesure le temps d’exécution de la cellule. Comme Python limite par défaut la récursivité à 1000 appels, nous relevons cette limite avec sys.setrecursionlimit :
%%time
import sys
sys.setrecursionlimit(5000) # la limite par défaut (1000) est trop basse ici
@stateful_function
def fibonacci(n):
if n <= 0:
return 0
elif n == 1:
return 1
else:
return fibonacci(n - 1) + fibonacci(n - 2)
fibonacci(1000)CPU times: user 2.37 ms, sys: 691 μs, total: 3.06 ms
Wall time: 7.65 ms
43466557686937456435688527675040625802564660517371780402481729089536555417949051890403879840079255169295922593080322634775209689623239873322471161642996440906533187938298969649928516003704476137795166849228875Quel gain de temps apporte la mise en cache ?
Nous avons calculé l’énorme 1000e nombre de Fibonacci en quelques millisecondes. Voici le temps que prend le même calcul, pour le 40e nombre seulement, sans décorateur de cache :
%%time
def fibonacci(n):
if n <= 0:
return 0
elif n == 1:
return 1
else:
return fibonacci(n - 1) + fibonacci(n - 2)
fibonacci(40)CPU times: user 17.8 s, sys: 54.3 ms, total: 17.8 s
Wall time: 23.1 s
102334155Il faut ici plus de 15 secondes de calcul pour le 40e nombre (le temps exact dépend de ta machine), car la fonction recalcule des milliers de fois les mêmes valeurs. Sans la mise en cache, le calcul du 1000e nombre ne se terminerait pratiquement jamais.
Comment faire plus simple avec functools.cache ?
Python propose déjà ce décorateur dans sa bibliothèque standard : functools.cache (ou functools.lru_cache pour limiter la taille du cache). Voici le même résultat en deux lignes. Écrire ton propre décorateur te permet de comprendre ce qui se passe, mais en production, utilise la version standard :
%%time
from functools import cache
@cache
def fibonacci(n):
if n <= 0:
return 0
elif n == 1:
return 1
else:
return fibonacci(n - 1) + fibonacci(n - 2)
fibonacci(1000)CPU times: user 886 μs, sys: 9 μs, total: 895 μs
Wall time: 899 μs
434665576869374564356885276750406258025646605173717804024817290895365554179490518904038798400792551692959225930803226347752096896232398733224711616429964409065331879382989696499285160037044761377951668492288754. Utilises-tu les générateurs ?
Les générateurs sont des constructions puissantes de Python qui permettent de traiter efficacement de grandes quantités de données.
Pourquoi éviter de lire tout un fichier d’un coup ?
Supposons que tu disposes d’un fichier de logs de 10 Go après le plantage d’un logiciel. Pour savoir ce qui s’est passé, tu dois le parcourir efficacement. Pour tester, nous créons d’abord un petit fichier de logs de 50 000 lignes :
with open("logs.txt", "w") as f:
for i in range(1, 50_001):
niveau = "ERROR" if i % 10_000 == 0 else "INFO"
f.write(f"2026-11-04 12:00:{i % 60:02d} {niveau} requête {i} traitée\n")La pire façon de procéder est de tout lire d’un coup :
with open("logs.txt", "r") as f:
contents = f.read()
print(len(contents), "caractères chargés d'un coup en mémoire")2338899 caractères chargés d'un coup en mémoireAvec un fichier de 10 Go, ces 10 Go se retrouveraient en mémoire. Or tu n’as pas besoin de tout lire : seulement des morceaux, un à la fois.
Comment lire un gros fichier avec un générateur ?
C’est là que tu peux utiliser les générateurs. Une fonction qui utilise yield au lieu de return devient un générateur :
def read_large_file(filename):
with open(filename) as f:
while True:
chunk = f.read(1024)
if not chunk:
break
yield chunk # Les générateurs utilisent `yield` au lieu de `return`
nb_morceaux = 0
for chunk in read_large_file("logs.txt"):
nb_morceaux += 1 # ici, tu traiterais le morceau
print(nb_morceaux, "morceaux lus, un seul en mémoire à la fois")2285 morceaux lus, un seul en mémoire à la foisCi-dessus, nous avons défini un générateur qui lit le fichier 1024 caractères à la fois. À chaque itération de la boucle, un seul morceau est en mémoire ; les précédents sont jetés. Dans la pratique, on lit plus souvent un fichier ligne par ligne, car un fichier ouvert est déjà itérable. Voici un générateur qui ne renvoie que les lignes d’erreur :
def lignes_erreur(filename):
with open(filename) as f:
for ligne in f: # un fichier s'itère ligne par ligne
if "ERROR" in ligne:
yield ligne.strip()
for ligne in lignes_erreur("logs.txt"):
print(ligne)2026-11-04 12:00:40 ERROR requête 10000 traitée
2026-11-04 12:00:20 ERROR requête 20000 traitée
2026-11-04 12:00:00 ERROR requête 30000 traitée
2026-11-04 12:00:40 ERROR requête 40000 traitée
2026-11-04 12:00:20 ERROR requête 50000 traitéeLe même principe s’applique aux expressions génératrices, écrites avec des parenthèses au lieu de crochets. La différence de mémoire est spectaculaire :
import sys
liste = [i * i for i in range(1_000_000)]
generateur = (i * i for i in range(1_000_000))
print(sys.getsizeof(liste), "octets pour la liste")
print(sys.getsizeof(generateur), "octets pour le générateur")
print(sum(generateur))8448728 octets pour la liste
200 octets pour le générateur
333332833333500000Qu’est-ce que la fonction next() permet de faire ?
Une autre caractéristique des générateurs est la possibilité de produire un élément à la fois, même en dehors des boucles, avec la fonction next. Ci-dessous, nous définissons un générateur de la suite de Fibonacci. Il est infini, mais il ne calcule que ce que tu lui demandes. Pour le créer, tu appelles la fonction une fois, puis tu appelles next sur l’objet obtenu :
def suite_fibonacci():
a, b = 0, 1
while True:
yield a
a, b = b, a + b
fib = suite_fibonacci()
type(fib)generatorprint(next(fib))
print(next(fib))
print(next(fib))
print(next(fib))
print(next(fib))0
1
1
2
3Pour récupérer les n premiers éléments d’un générateur infini, itertools.islice est très pratique :
from itertools import islice

list(islice(suite_fibonacci(), 10))[0, 1, 1, 2, 3, 5, 8, 13, 21, 34]5. Écris-tu tes propres gestionnaires de contexte ?
Tu utilises probablement déjà des gestionnaires de contexte avec with open(...). Ils permettent de gérer proprement des ressources telles que les fichiers, les bases de données et les connexions réseau : ils les ouvrent et les ferment automatiquement, ce qui donne un code propre et sans oubli.
Mais il y a une grande différence entre utiliser des gestionnaires de contexte et écrire les tiens. Bien conçus, ils te permettent d’abstraire beaucoup de code répétitif (boilerplate).
Comment créer un gestionnaire de contexte de minuterie ?
Un exemple courant de gestionnaire de contexte personnalisé est la minuterie :
import time


class TimerContextManager:
    """Mesure le temps nécessaire à l'exécution d'un bloc de code."""

    def __enter__(self):
        self.start = time.perf_counter()
        return self

    def __exit__(self, exc_type, exc_value, traceback):
        end = time.perf_counter()
print(f"Le code a pris {end - self.start:.2f} seconde(s) pour s'exécuter.")Ci-dessus, nous définissons une classe TimerContextManager. Sa méthode __enter__ définit ce qui se passe lorsque nous entrons dans le contexte avec le mot-clé with : ici, nous démarrons la minuterie. Dans __exit__, nous sortons du contexte, nous arrêtons la minuterie et nous affichons le temps écoulé. Cette méthode est appelée même si une erreur survient dans le bloc.
with TimerContextManager():
    # Ce code est chronométré
time.sleep(1)Le code a pris 1.00 seconde(s) pour s'exécuter.Comment écrire plus court avec contextlib ?
Pour un gestionnaire simple, le décorateur contextlib.contextmanager évite d’écrire une classe : tout ce qui précède yield s’exécute à l’entrée, tout ce qui suit à la sortie.
from contextlib import contextmanager

@contextmanager
def minuterie():
    debut = time.perf_counter()
    try:
        yield
    finally:
        print(f"Le code a pris {time.perf_counter() - debut:.2f} seconde(s).")

with minuterie():
time.sleep(1)Le code a pris 1.00 seconde(s).Comment verrouiller une ressource entre plusieurs threads ?
Voici un exemple plus complexe, qui verrouille une ressource pour qu’elle ne soit utilisée que par un seul thread à la fois. Quatre threads incrémentent chacun 100 000 fois un compteur partagé :
import threading

lock = threading.Lock()
compteur_partage = 0


class LockContextManager:
    def __enter__(self):
        lock.acquire()

    def __exit__(self, exc_type, exc_value, traceback):
        lock.release()


def incrementer(n):
    global compteur_partage
    for _ in range(n):
        with LockContextManager():  # un seul thread à la fois dans ce bloc
            compteur_partage += 1


threads = [threading.Thread(target=incrementer, args=(100_000,)) for _ in range(4)]
for t in threads:
    t.start()
for t in threads:
    t.join()

print(compteur_partage)400000Le verrou est automatiquement libéré à la fin du bloc with, même en cas d’erreur : c’est exactement ce qui rend les gestionnaires de contexte si utiles. À noter que threading.Lock est déjà un gestionnaire de contexte, donc tu peux écrire directement with lock: :
with lock:  # threading.Lock est déjà un gestionnaire de contexte
    print("verrou acquis :", lock.locked())
print("verrou libéré :", not lock.locked())verrou acquis : True
verrou libéré : TrueQuestions fréquentes
Qu’est-ce que la règle LEGB en Python ?
LEGB est l’ordre dans lequel Python cherche un nom (variable, fonction, classe) : d’abord la portée Locale (la fonction en cours), puis Enclosing (la fonction englobante), puis Globale (le fichier), enfin Built-in (print, len, range…). Python s’arrête au premier nom trouvé.
À quoi sert une closure en Python ?
Une closure est une fonction interne qui garde en mémoire les variables de la fonction englobante, même après la fin de celle-ci. Elle sert à créer des compteurs, des fonctions préconfigurées et surtout des décorateurs.
Quelle est la différence entre global et nonlocal ?
Le mot-clé global permet de modifier une variable de la portée globale depuis une fonction. Le mot-clé nonlocal permet de modifier une variable de la fonction englobante depuis une fonction imbriquée. Sans l’un ou l’autre, l’affectation crée une nouvelle variable locale.
Pourquoi utiliser un décorateur de cache comme functools.cache ?
Il mémorise le résultat d’une fonction pour chaque jeu d’arguments, ce qui évite de recalculer les mêmes valeurs. Pour une fonction récursive comme Fibonacci, le temps passe de plus de 15 secondes pour le 40e nombre à quelques millisecondes pour le 1000e.
Quelle est la différence entre un générateur et une liste ?
Une liste stocke tous ses éléments en mémoire. Un générateur les produit un par un, à la demande, avec yield. Pour un million de carrés, la liste pèse environ 8,4 Mo alors que l’expression génératrice ne pèse que 200 octets. C’est idéal pour lire de gros fichiers.
Comment créer un gestionnaire de contexte en Python ?
Deux méthodes : écrire une classe avec les méthodes __enter__ et __exit__, ou utiliser le décorateur contextlib.contextmanager sur une fonction qui contient un yield. Le code après le yield (ou dans __exit__) s’exécute toujours à la sortie du bloc with, même en cas d’erreur.
Que retenir de ces 5 signes d’un niveau avancé ?
Voilà, c’est tout pour les 5 signes qui en disent beaucoup sur ton niveau de programmation avancée en Python. Fais le point :
- Scope : tu sais dans quel ordre Python cherche un nom (LEGB) et quand utiliser
globalounonlocal. - Closure : tu sais faire survivre une variable à la fonction qui l’a créée.
- Décorateurs : tu sais ajouter un comportement (comme un cache) sans toucher au code de la fonction.
- Générateurs : tu traites de gros volumes de données sans les charger en mémoire.
- Gestionnaires de contexte : tu gères tes ressources proprement avec
with.
Si tu en coches 3 sur 5, tu es déjà à l’aise ; pour les autres, reprends les exemples ci-dessus et modifie-les toi-même. Pour pratiquer régulièrement, sur DataXp, tu t’entraînes à Python et à la data science avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin, tu peux aussi consulter ces articles :