Dans presque tous les jeux de données réels, il manque des valeurs : un capteur tombe en panne, un client ne remplit pas un champ, une colonne est mal exportée. Si tu ne les traites pas, elles faussent tes moyennes, font planter certains algorithmes de Machine Learning et biaisent tes conclusions. Pandas fournit tout ce qu’il faut pour les repérer, les supprimer, les remplacer ou les estimer.
Dans ce guide, tu vas voir comment détecter les valeurs manquantes, quand utiliser dropna(), fillna(), ffill(), bfill() et interpolate(), comment les traiter dans une série temporelle, dans des données catégorielles et avant un modèle de Machine Learning, et comment choisir la bonne stratégie. Chaque exemple est du code que tu peux exécuter.
Article mis à jour en novembre 2026 : tout le code a été réécrit et exécuté avec pandas 3.1 et pandas 2.3 (la version de Google Colab), avec les vraies sorties. Les données sont maintenant générées dans le code. J’ai corrigé plusieurs points : l’exemple des séries temporelles, qui utilisait des valeurs aléatoires et ne contenait pas de vrais trous ; l’exemple avec fillna(method=...) et inplace=True, qui ne fonctionnent plus avec pandas 3 ; et l’imputation pour le Machine Learning, qui doit se faire après la séparation entre entraînement et test. J’ai aussi ajouté la représentation des valeurs manquantes, les valeurs manquantes « déguisées » et un guide pour choisir ta stratégie. Les résultats des modèles peuvent légèrement varier selon la version de scikit-learn.
En bref : pour repérer les valeurs manquantes d’un DataFrame, utilise df.isna().sum(). Pour les traiter, tu as trois familles de méthodes : supprimer avec dropna() (simple, mais sur mon exemple de 200 clients, dropna() fait perdre 74 lignes, soit 37 % des données), remplacer avec fillna() (valeur fixe, moyenne, médiane, mode, valeur par groupe), ffill() et bfill() (valeur voisine), et estimer avec interpolate() pour les séries ordonnées. Avec pandas 3, fillna(method=...) n’existe plus (utilise ffill() ou bfill()) et df['A'].fillna(0, inplace=True) ne modifie plus ton DataFrame. Pour le Machine Learning, impute avec SimpleImputer dans un pipeline, après la séparation entre entraînement et test.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : les données sont générées dans le code, il n’y a aucun fichier à télécharger.
Comment Pandas représente-t-il une valeur manquante ?
Pandas n’a pas un seul symbole pour dire « il manque une valeur » : cela dépend du type de la colonne. Dans les colonnes de nombres, une valeur manquante est un NaN (« not a number »). Dans les colonnes de dates, c’est NaT. Dans les types « nullables » comme Int64, c’est pd.NA. Voici les quatre cas côte à côte :
nombres = pd.Series([1.5, np.nan, 3.0])
texte = pd.Series(["chat", None, "chien"])
dates = pd.to_datetime(pd.Series(["2026-01-01", None]))
entiers = pd.Series([1, 2, None], dtype="Int64")

for nom, serie in [("nombres", nombres), ("texte", texte), ("dates", dates), ("entiers Int64", entiers)]:
    print(f"{nom:<14}: {serie.tolist()}")
nombres : [1.5, nan, 3.0]
texte : ['chat', nan, 'chien']
dates : [Timestamp('2026-01-01 00:00:00'), NaT]
entiers Int64 : [1, 2, <NA>]Pour le texte, il y a une différence entre les versions. Avec pandas 3, une colonne de texte a le nouveau type str et sa valeur manquante est un NaN, comme ci-dessus. Avec pandas 2.3 (Google Colab), la colonne est de type object et la valeur manquante reste le None que tu as saisi. Dans les deux cas, isna() les reconnaît.
Autre piège : une valeur manquante n’est égale à rien, pas même à elle-même. Il ne faut donc jamais comparer avec == np.nan, mais utiliser isna() :
print(np.nan == np.nan)
print(pd.NA == pd.NA)
print(pd.isna(np.nan), pd.isna(None), pd.isna(pd.NaT), pd.isna(pd.NA))False
<NA>
True True True TrueComment détecter les valeurs manquantes avec isna() ?
La première étape est toujours de mesurer le problème. Pour tout l’article, on utilise un jeu de données de 200 clients, généré dans le code, avec des trous placés au hasard : 10 % d’âges, 25 % de revenus, 5 % de villes et 2 % de notes sont effacés avant le calcul des chiffres ci-dessous (les pourcentages réels varient un peu). La colonne achat (0 ou 1) nous servira pour le Machine Learning.
rng = np.random.default_rng(42)
n = 200

clients = pd.DataFrame({
    "age": rng.integers(18, 70, n).astype(float),
    "revenu": rng.normal(42000, 9000, n).round(0),
    "ville": rng.choice(["Paris", "Lyon", "Lille", "Nantes"], n),
    "note": rng.integers(1, 6, n).astype(float),
})
clients["achat"] = (clients["revenu"] + rng.normal(0, 6000, n) > 44000).astype(int)

# On efface des valeurs au hasard : 10 % des âges, 25 % des revenus, 5 % des villes, 2 % des notes
for colonne, part in [("age", 0.10), ("revenu", 0.25), ("ville", 0.05), ("note", 0.02)]:
    clients.loc[rng.random(n) < part, colonne] = np.nan

print(clients.head()) age revenu ville note achat
0 22.0 45598.0 Lyon 1.0 1
1 58.0 NaN Lyon 4.0 0
2 52.0 38597.0 Paris 1.0 0
3 NaN 53693.0 Lyon NaN 1
4 40.0 38794.0 Lille 4.0 0isna() renvoie un tableau de booléens de la même forme que le DataFrame (True là où il manque une valeur). Combiné avec sum() et mean(), il donne le nombre et le pourcentage de valeurs manquantes par colonne. isnull() est un simple alias de isna(), et notna() fait l’inverse :
manquantes = pd.DataFrame({
    "nombre": clients.isna().sum(),
    "pourcentage": (clients.isna().mean() * 100).round(1),
})
print(manquantes) nombre pourcentage
age 26 13.0
revenu 47 23.5
ville 9 4.5
note 1 0.5
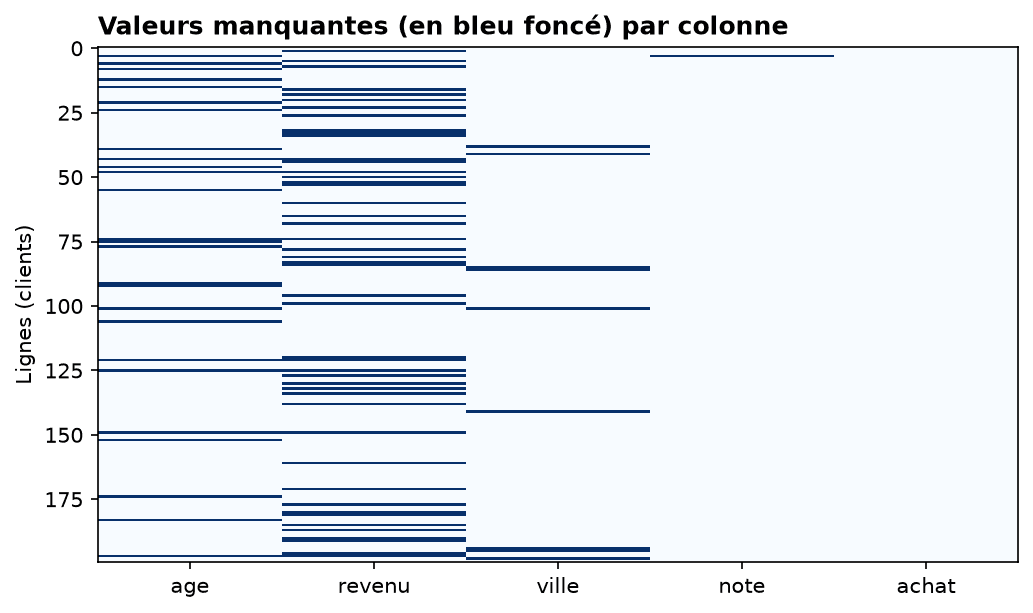
achat 0 0.0Le revenu est la colonne la plus touchée (23,5 %). Pour voir si les trous sont regroupés ou dispersés, une carte des valeurs manquantes est très parlante :
Tu peux aussi compter les lignes qui ont au moins un trou, afficher celles d’une colonne précise, ou compter les valeurs renseignées avec notna() :
lignes_incompletes = clients.isna().any(axis=1)
print(lignes_incompletes.sum(), "lignes incomplètes sur", len(clients))
print(clients[clients["age"].isna()].head(3))
print(clients["revenu"].notna().sum(), "revenus renseignés")74 lignes incomplètes sur 200
age revenu ville note achat
3 NaN 53693.0 Lyon NaN 1
6 NaN 33597.0 Lyon 4.0 0
8 NaN 33450.0 Lille 5.0 0
153 revenus renseignésSur 200 clients, 74 ont au moins une valeur manquante : plus d’un tiers du jeu de données. Garde ce chiffre en tête pour la partie suivante.
Comment repérer les valeurs manquantes « déguisées » ?
Pandas ne voit que les vraies valeurs manquantes. Si ton fichier contient -999, inconnu ou ? à la place d’un trou, Pandas les prend pour de vraies valeurs. Dans l’exemple ci-dessous, la colonne revenu contient le texte inconnu : elle est lue comme du texte, et la valeur -999 passe pour un âge. Seuls les champs vides et N/A sont reconnus automatiquement :
import io

fichier = io.StringIO("""id,age,revenu,ville
1,34,41000,Paris
2,-999,38000,Lyon
3,29,inconnu,
4,41,N/A,Lille""")

brut = pd.read_csv(fichier)
print(brut.isna().sum().to_dict())
print(brut.dtypes.astype(str).to_dict()){'id': 0, 'age': 0, 'revenu': 1, 'ville': 1}
{'id': 'int64', 'age': 'int64', 'revenu': 'str', 'ville': 'str'}Avec pandas 3, les colonnes de texte s’affichent en str ; avec pandas 2.3, en object. Le paramètre na_values de read_csv() règle le problème dès la lecture : la colonne revenu redevient numérique et l’âge -999 devient un vrai NaN :
fichier.seek(0)
propre = pd.read_csv(fichier, na_values=["inconnu", "-999"])
print(propre)
print(propre.dtypes.astype(str).to_dict()) id age revenu ville
0 1 34.0 41000.0 Paris
1 2 NaN 38000.0 Lyon
2 3 29.0 NaN NaN
3 4 41.0 NaN Lille
{'id': 'int64', 'age': 'float64', 'revenu': 'float64', 'ville': 'str'}Comment supprimer les données manquantes avec dropna() ?
La façon la plus simple de traiter les données manquantes est de supprimer les lignes ou les colonnes qui en contiennent, avec dropna(). Voici un petit DataFrame, avec un trou en colonne A et un autre en colonne B :
df = pd.DataFrame({"A": [1, 2, None, 4], "B": [5, None, 7, 8], "C": [9, 10, 11, 12]})

print(df.dropna())          # supprime les lignes avec au moins un trou
print(df.dropna(axis=1)) # supprime les colonnes avec au moins un trou A B C
0 1.0 5.0 9
3 4.0 8.0 12
C
0 9
1 10
2 11
3 12Par défaut, dropna() supprime les lignes qui ont au moins un trou (axis=0). Avec axis=1, elle supprime les colonnes. Trois paramètres permettent d’être plus précis : subset (ne regarder que certaines colonnes), thresh (garder les lignes qui ont au moins n valeurs renseignées) et how='all' (ne supprimer que les lignes entièrement vides). Voici l’effet sur nos 200 clients :
print("Départ                      :", len(clients), "lignes")
print("dropna()                    :", len(clients.dropna()))
print("dropna(subset=['age'])      :", len(clients.dropna(subset=["age"])))
print("dropna(thresh=4)            :", len(clients.dropna(thresh=4)))
print("dropna(how='all') :", len(clients.dropna(how="all")))Départ : 200 lignes
dropna() : 126
dropna(subset=['age']) : 174
dropna(thresh=4) : 191
dropna(how='all') : 200Le simple dropna() nous fait passer de 200 à 126 lignes. En ne supprimant que les clients dont l’âge est inconnu, on en garde 174. Avec thresh=4 (au moins 4 valeurs renseignées sur 5), 191 lignes restent.
Quand faut-il supprimer plutôt que remplacer ?
Supprimer est un bon choix quand les trous sont peu nombreux (quelques pour cent), répartis au hasard, et que tu as assez de données. C’est un mauvais choix quand les trous sont fréquents : ici, on perdrait plus d’un tiers des clients. Et si les valeurs manquent pour une raison précise (par exemple, les clients à hauts revenus refusent de répondre), supprimer ces lignes déforme tes résultats. Dans ces cas, remplace ou estime les valeurs.
Comment remplacer les données manquantes avec fillna() ?
fillna() remplace les valeurs manquantes par la valeur que tu choisis, sans réduire le nombre de lignes. On retrouve ici le petit DataFrame de la partie précédente.
Comment remplacer par une valeur constante ?
Le plus simple est de remplacer par une constante, la même pour tout le DataFrame, ou différente pour chaque colonne avec un dictionnaire :
df = pd.DataFrame({"A": [1, 2, None, 4], "B": [5, None, 7, 8], "C": [9, 10, 11, 12]})

print(df.fillna(0))
print(df.fillna({"A": 0, "B": -1})) # une valeur différente par colonne A B C
0 1.0 5.0 9
1 2.0 0.0 10
2 0.0 7.0 11
3 4.0 8.0 12
A B C
0 1.0 5.0 9
1 2.0 -1.0 10
2 0.0 7.0 11
3 4.0 8.0 12Attention : remplacer par 0 n’a de sens que si zéro est une vraie valeur possible (une quantité vendue, par exemple). Pour un âge ou une température, c’est une valeur fausse qui tire tes statistiques vers le bas.
Comment remplacer par la moyenne ou la médiane ?
Les valeurs de remplacement peuvent venir des données elles-mêmes. df.mean() et df.median() renvoient une valeur par colonne, que fillna() applique colonne par colonne :
print(df.fillna(df.mean()))      # moyenne de chaque colonne
print(df.fillna(df.median())) # médiane de chaque colonne A B C
0 1.000000 5.000000 9
1 2.000000 6.666667 10
2 2.333333 7.000000 11
3 4.000000 8.000000 12
A B C
0 1.0 5.0 9
1 2.0 7.0 10
2 2.0 7.0 11
3 4.0 8.0 12La médiane est moins sensible aux valeurs extrêmes que la moyenne, c’est souvent le meilleur choix pour des revenus ou des prix. Mais remplacer par une valeur unique a un effet secondaire : il réduit la variabilité de tes données. Sur la colonne revenu de nos clients :
revenu = clients["revenu"]
revenu_rempli = revenu.fillna(revenu.median())

print(f"écart-type avant : {revenu.std():.0f} | après : {revenu_rempli.std():.0f}")
print(f"moyenne avant : {revenu.mean():.0f} | après : {revenu_rempli.mean():.0f}")écart-type avant : 9197 | après : 8047
moyenne avant : 42045 | après : 41835La moyenne bouge à peine, mais l’écart-type baisse d’environ 12 % : les 47 revenus remplacés ont tous exactement la même valeur. Les statistiques calculées après remplissage sont donc un peu trop optimistes.
Comment remplacer par la valeur la plus fréquente (le mode) ?
Pour les colonnes catégorielles, ou pour des nombres qui se répètent, on utilise le mode. mode() peut renvoyer plusieurs valeurs en cas d’égalité : .iloc[0] (ou [0] sur une colonne) garde la première.
print(df.fillna(df.mode().iloc[0]))   # valeur la plus fréquente de chaque colonne

ville_mode = clients["ville"].mode()[0]
print(ville_mode, "->", clients["ville"].fillna(ville_mode).isna().sum(), "valeur manquante") A B C
0 1.0 5.0 9
1 2.0 5.0 10
2 1.0 7.0 11
3 4.0 8.0 12
Lille -> 0 valeur manquanteComment remplacer par la valeur de chaque groupe ?
Souvent, une valeur globale est trop grossière : le revenu médian n’est pas le même partout. On calcule alors la médiane de chaque groupe avec groupby() et transform() (qui renvoie une valeur par ligne), puis on remplit. Les clients sans ville n’ont pas de groupe : on les complète ensuite avec la médiane globale.
par_ville = clients.groupby("ville")["revenu"].transform("median")
revenu_par_ville = clients["revenu"].fillna(par_ville).fillna(clients["revenu"].median())

print(clients.groupby("ville")["revenu"].median().round(0).to_dict())
print(revenu_par_ville.isna().sum(), "valeur manquante"){'Lille': 39992.0, 'Lyon': 42248.0, 'Nantes': 40590.0, 'Paris': 42478.0}
0 valeur manquantePour maîtriser ces regroupements, lis GroupBy de Pandas : maîtriser cette fonction en 10 étapes.
Pourquoi fillna(inplace=True) ne marche-t-il plus sur une colonne ?
Beaucoup de tutoriels (et la première version de cet article) écrivent df['A'].fillna(0, inplace=True). Avec pandas 3, cette ligne ne modifie plus ton DataFrame : à cause du Copy-on-Write, df['A'] se comporte comme une copie, et Pandas affiche un avertissement. Avec pandas 2.3, la même ligne fonctionnait encore, avec un avertissement. L’écriture qui marche partout est l’affectation :
tableau = pd.DataFrame({"A": [1, None, 3]})

tableau["A"].fillna(0, inplace=True)   # à ne plus écrire
print(tableau["A"].tolist())

tableau["A"] = tableau["A"].fillna(0)  # la bonne façon
print(tableau["A"].tolist())[1.0, nan, 3.0]
[1.0, 0.0, 3.0]La première ligne affichée vient de pandas 3.1 : la colonne n’a pas changé. Avec pandas 2.3, elle affiche [1.0, 0.0, 3.0]. L’affectation df['A'] = df['A'].fillna(0) donne le même résultat dans les deux versions. Même logique pour fillna(method='ffill'), qui était déjà déconseillé et qui est supprimé avec pandas 3 : utilise ffill(), vu juste après.
Que font ffill() et bfill() ?
Le remplissage vers l’avant (ffill(), pour forward fill) complète chaque trou avec la valeur précédente. Le remplissage vers l’arrière (bfill(), pour backward fill) utilise la valeur suivante. Les deux ont du sens quand l’ordre des lignes compte (un historique, des mesures dans le temps) :
df = pd.DataFrame({"A": [1, 2, None, 4], "B": [5, None, 7, 8], "C": [9, 10, 11, 12]})

print(df.ffill())   # valeur précédente
print(df.bfill()) # valeur suivante A B C
0 1.0 5.0 9
1 2.0 5.0 10
2 2.0 7.0 11
3 4.0 8.0 12
A B C
0 1.0 5.0 9
1 2.0 7.0 10
2 4.0 7.0 11
3 4.0 8.0 12Dans la colonne B, le trou de la ligne 1 est rempli par 5 (valeur précédente) avec ffill(), et par 7 (valeur suivante) avec bfill(). Si le premier élément est manquant, ffill() ne peut rien faire : le trou reste. Pour éviter de répéter une vieille valeur trop longtemps, le paramètre limit fixe le nombre maximal de trous consécutifs à combler :
trous = pd.Series([1.0, None, None, None, 5.0])

print(trous.ffill().tolist())
print(trous.ffill(limit=1).tolist())[1.0, 1.0, 1.0, 1.0, 5.0]
[1.0, 1.0, nan, nan, 5.0]Le choix entre ffill() et bfill() dépend de ce que tu veux dire : un prix qui reste valable jusqu’au changement suivant se remplit vers l’avant ; une valeur qui s’applique à ce qui précède se remplit vers l’arrière. Il est important de choisir la bonne méthode en fonction du type de données.
Comment interpoler les valeurs manquantes avec interpolate() ?
L’interpolation estime une valeur manquante à partir de ses voisines. Par défaut, interpolate() est linéaire : il trace une droite entre la dernière valeur connue et la suivante.
df = pd.DataFrame({"A": [1, 2, None, 4], "B": [5, None, 7, 8], "C": [9, 10, 11, 12]})

print(df.interpolate()) # interpolation linéaire A B C
0 1.0 5.0 9
1 2.0 6.0 10
2 3.0 7.0 11
3 4.0 8.0 12Dans la colonne A, le trou entre 2 et 4 devient 3 ; dans la colonne B, entre 5 et 7, il devient 6. L’interpolation ne fonctionne que sur des nombres : sur une colonne de texte, pandas 3 renvoie une erreur TypeError (pandas 2.3 affiche un avertissement). C’est la méthode à privilégier pour une mesure qui évolue de façon continue, comme une température ou un cours de bourse, et à éviter pour des données qui n’ont pas d’ordre.
Comment traiter les valeurs manquantes dans une série temporelle ?
Dans une série temporelle, chaque valeur est associée à une date et l’ordre compte : remplacer un trou par la moyenne de toute la série n’aurait aucun sens. Il faut aussi distinguer deux situations : la valeur est vide (NaN), ou la ligne n’existe pas du tout. Voici un relevé de températures avec trois valeurs vides et deux jours absents :
jours = pd.date_range("2026-01-01", periods=14, freq="D")
temperature = pd.Series(
    [4.0, 5.5, 6.0, np.nan, np.nan, 9.5, 10.0, 8.5, np.nan, 7.0, 6.5, np.nan, 5.0, 4.5],
    index=jours, name="temperature",
)
# Deux jours sont totalement absents du relevé (pas de ligne du tout)
temperature = temperature.drop(pd.to_datetime(["2026-01-08", "2026-01-09"]))

print(len(temperature), "lignes,", temperature.isna().sum(), "valeurs manquantes")

reguliere = temperature.resample("D").asfreq()   # fait apparaître les jours absents
print(len(reguliere), "lignes,", reguliere.isna().sum(), "valeurs manquantes")12 lignes, 3 valeurs manquantes
14 lignes, 5 valeurs manquantesresample('D').asfreq() recrée une ligne pour chaque jour : les deux jours absents apparaissent maintenant comme des NaN, ce qui fait 5 valeurs à traiter au lieu de 3. C’est la première étape pour obtenir une série régulière. Ensuite, deux méthodes classiques :
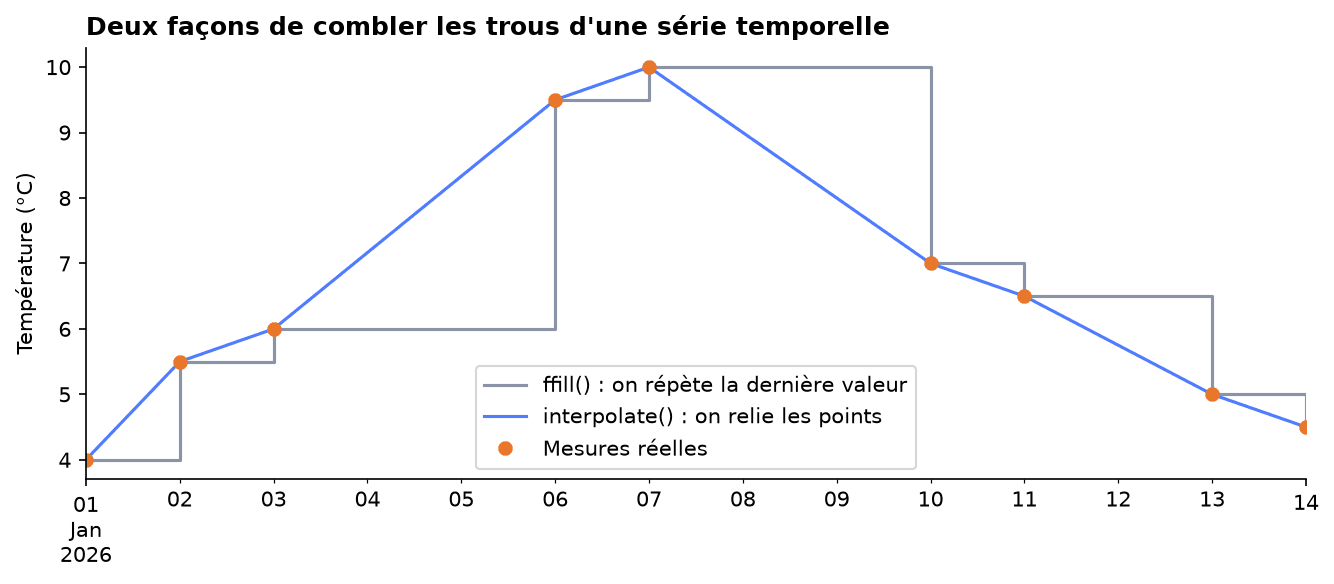
ffill() fait des paliers : la température reste constante jusqu’à la mesure suivante. interpolate() relie les points par une droite, ce qui est plus réaliste pour une grandeur qui varie progressivement. Quand les dates sont espacées de façon irrégulière, utilise method='time' : l’interpolation tient compte de l’écart réel entre les dates, alors que la méthode linéaire par défaut ne regarde que la position des lignes.
irreguliere = pd.Series(
    [10.0, np.nan, 20.0],
    index=pd.to_datetime(["2026-01-01", "2026-01-02", "2026-01-05"]),
)

print(irreguliere.interpolate().tolist())                 # ignore les dates
print(irreguliere.interpolate(method="time").tolist()) # tient compte des dates[10.0, 15.0, 20.0]
[10.0, 12.5, 20.0]Ici, le 2 janvier est à 1 jour du 1er et à 3 jours du 5 : la valeur logique est 12,5, pas 15. Enfin, pour ne pas inventer de longues séquences, limit plafonne le nombre de jours consécutifs comblés :
remplie = reguliere.interpolate(method="time", limit=1)   # au plus 1 jour consécutif comblé
print(remplie.isna().sum(), "valeurs encore manquantes")
print(remplie["2026-01-07":"2026-01-10"].round(2).tolist())2 valeurs encore manquantes
[10.0, 9.0, nan, 7.0]Il reste 2 valeurs manquantes : quand un trou dure plus de 1 jour, seul le premier jour est comblé. C’est volontaire, car estimer plusieurs jours d’affilée devient trop risqué. Pour aller plus loin sur ce type de données, lis les méthodes de séries temporelles avec Pandas.
Comment traiter les valeurs manquantes dans des données catégorielles ?
Les données catégorielles (une ville, un animal, un type de produit) n’ont ni moyenne ni médiane : il faut choisir une autre stratégie. Les valeurs manquantes peuvent aussi avoir un sens : un client qui ne donne pas sa ville le fait peut-être pour une raison précise. Voici un petit DataFrame, avec le nombre de valeurs de chaque catégorie, NaN compris (avec pandas 2.3, on y verrait None) :
animaux = pd.DataFrame({"A": ["chat", "chien", "chat", None, "chien", "oiseau", "chat"]})

print(animaux)
print(animaux["A"].value_counts(dropna=False)) A
0 chat
1 chien
2 chat
3 NaN
4 chien
5 oiseau
6 chat
A
chat 3
chien 2
NaN 1
oiseau 1
Name: count, dtype: int64On peut d’abord reporter la dernière valeur connue avec ffill(). Cela suppose que l’ordre des lignes a un sens :
print(animaux.ffill()) # dernière valeur connue A
0 chat
1 chien
2 chat
3 chat
4 chien
5 oiseau
6 chatSinon, on peut compléter par une nouvelle catégorie : « inconnu » devient une information à part entière, que l’on retrouve ensuite dans les analyses et les modèles. C’est souvent la solution la plus honnête :
print(animaux.fillna("inconnu")) # nouvelle catégorie A
0 chat
1 chien
2 chat
3 inconnu
4 chien
5 oiseau
6 chatSi la colonne est de type category, il faut d’abord déclarer la nouvelle valeur avec add_categories(), sinon fillna() refuse une valeur qui n’existe pas dans les catégories :
categories = animaux["A"].astype("category")

# Sur un type "category", il faut d'abord déclarer la nouvelle valeur
categories = categories.cat.add_categories("inconnu").fillna("inconnu")
print(categories.value_counts().to_dict()){'chat': 3, 'chien': 2, 'oiseau': 1, 'inconnu': 1}Le mode (vu plus haut) est une troisième option, à réserver aux cas où une catégorie domine nettement : dans le cas contraire, tu crées une information fausse.
Comment gérer les valeurs manquantes avant un modèle de Machine Learning ?
Beaucoup d’algorithmes de Machine Learning refusent les valeurs manquantes. Avec scikit-learn, la classe SimpleImputer du module sklearn.impute les remplace selon une stratégie : la moyenne, la médiane, la valeur la plus fréquente ou une constante. Avec .set_output(transform='pandas'), le résultat reste un DataFrame, et non un tableau NumPy :
from sklearn.impute import SimpleImputer

df_ml = pd.DataFrame({"A": [1, 2, None, 4], "B": [5, None, 7, 8], "C": [9, 10, 11, None]})

imputeur = SimpleImputer(strategy="mean").set_output(transform="pandas")
df_ml_imputed = imputeur.fit_transform(df_ml)
print(df_ml_imputed) A B C
0 1.000000 5.000000 9.0
1 2.000000 6.666667 10.0
2 2.333333 7.000000 11.0
3 4.000000 8.000000 10.0La colonne A est complétée par sa moyenne (2,33), la colonne B par la sienne (6,67), et la colonne C par la moyenne de 9, 10 et 11, soit 10.
Pourquoi imputer après la séparation entre entraînement et test ?
Voici l’erreur classique : calculer la moyenne ou la médiane sur tout le jeu de données, puis séparer entraînement et test. Les valeurs du test ont alors servi à calculer les remplacements : c’est une fuite de données (data leakage), et ton score est trop optimiste. La bonne méthode est de calculer les remplacements sur l’entraînement uniquement, puis de les appliquer au test. Un Pipeline le fait automatiquement. D’abord, voyons ce qui se passe sans imputation :
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

X = clients[["age", "revenu", "note"]]
y = clients["achat"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=0)

try:
    LogisticRegression().fit(X_train, y_train)
except ValueError as erreur:
print("ValueError :", str(erreur).splitlines()[0])ValueError : Input X contains NaN.Le modèle refuse les NaN. Avec un pipeline, l’imputeur est entraîné avec le modèle, sur les données d’entraînement. Le paramètre add_indicator=True ajoute en plus une colonne par variable incomplète, qui dit si la valeur était manquante : le modèle peut ainsi apprendre que « l’absence de réponse » est une information.
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

modele = make_pipeline(
    SimpleImputer(strategy="median", add_indicator=True),   # médianes calculées sur le train
    StandardScaler(),
    LogisticRegression(),
)
modele.fit(X_train, y_train)
print("précision sur le test :", round(modele.score(X_test, y_test), 3))
print("colonnes en sortie de l'imputeur :", modele[0].transform(X_test).shape[1])précision sur le test : 0.8
colonnes en sortie de l'imputeur : 6L’imputeur renvoie 6 colonnes : les 3 variables d’origine et 3 indicateurs. Avec 50 clients dans le test, l’écart de précision entre deux méthodes n’est pas significatif : ce qui compte ici, c’est la méthode propre, pas le score.
Certains modèles acceptent-ils les valeurs manquantes sans imputation ?
Oui : les modèles à base d’arbres de scikit-learn comme HistGradientBoostingClassifier acceptent directement les NaN et apprennent quoi en faire. C’est une bonne option quand tu veux éviter d’inventer des valeurs :
from sklearn.ensemble import HistGradientBoostingClassifier

arbres = HistGradientBoostingClassifier(random_state=0).fit(X_train, y_train)   # accepte les NaN
print("précision sur le test :", round(arbres.score(X_test, y_test), 3))précision sur le test : 0.78Comment remplacer avec les plus proches voisins (KNNImputer) ?
KNNImputer remplace un trou par la moyenne des valeurs des lignes les plus proches. C’est plus fin qu’une moyenne globale, mais plus lent et sensible à l’échelle des variables (pense à les normaliser sur de vraies données). Sur notre petit exemple, avec 2 voisins :
from sklearn.impute import KNNImputer

voisins = KNNImputer(n_neighbors=2).set_output(transform="pandas")
print(voisins.fit_transform(df_ml).round(2)) A B C
0 1.0 5.0 9.0
1 2.0 6.0 10.0
2 3.0 7.0 11.0
3 4.0 8.0 10.5Il est important de garder à l’esprit que l’imputation peut introduire un biais : choisis la stratégie en fonction du type de données et de l’analyse.
Quelle stratégie choisir pour tes valeurs manquantes ?
Il n’existe pas de méthode universelle. Voici comment choisir :
- Très peu de trous, répartis au hasard :
dropna()est acceptable. - Beaucoup de trous : ne supprime pas, remplace ou estime.
- Nombres sans ordre (âge, revenu) :
fillna()avec la médiane, ou avec la médiane de chaque groupe. - Mesures dans le temps :
interpolate()(avecmethod='time'si les dates sont irrégulières) ouffill(), aveclimit. - Catégories : une nouvelle catégorie « inconnu », ou le mode si une valeur domine.
- Machine Learning :
SimpleImputerdans un pipeline, après la séparation entre entraînement et test, ou un modèle qui accepte lesNaN. - Dans tous les cas : vérifie d’abord les valeurs « déguisées », compare tes statistiques avant et après, et garde une colonne qui indique quelles valeurs ont été remplacées quand c’est utile.
Questions fréquentes
Comment détecter les valeurs manquantes dans un DataFrame Pandas ?
Utilise df.isna().sum() pour compter les valeurs manquantes par colonne et (df.isna().mean() * 100) pour obtenir le pourcentage. df.isnull() est un alias de df.isna(). Vérifie aussi les valeurs déguisées (-999, inconnu, ?) avec le paramètre na_values de read_csv().
Faut-il supprimer ou remplacer les valeurs manquantes ?
Supprime avec dropna() seulement si les trous sont rares et répartis au hasard. Sur mon exemple de 200 clients, dropna() supprime 74 lignes (37 %). Quand les trous sont fréquents ou ont une raison précise, remplace avec fillna() ou estime avec interpolate(), en vérifiant l’effet sur tes statistiques.
Quelle est la différence entre NaN, None, NaT et pd.NA ?
NaN est la valeur manquante des colonnes de nombres, NaT celle des colonnes de dates, pd.NA celle des types nullables comme Int64, et None celle des colonnes d’objets (texte avec pandas 2). Avec pandas 3, une colonne de texte de type str utilise NaN. isna() reconnaît tous ces cas, alors que la comparaison == np.nan est toujours fausse.
Comment remplacer les valeurs manquantes par la moyenne ou la médiane ?
Écris df[‘col’] = df[‘col’].fillna(df[‘col’].median()), ou df.fillna(df.median()) pour toutes les colonnes numériques. La médiane est moins sensible aux valeurs extrêmes. Attention : le remplacement par une valeur unique réduit la variabilité (l’écart-type baisse de 12 % sur mon exemple de revenus).
Que remplace fillna(method=’ffill’) avec pandas 3 ?
Le paramètre method de fillna() est supprimé avec pandas 3 (il était déconseillé avec pandas 2.x). Utilise directement df.ffill() pour reporter la valeur précédente et df.bfill() pour la valeur suivante. Évite aussi df[‘col’].fillna(0, inplace=True), qui ne modifie plus le DataFrame : écris df[‘col’] = df[‘col’].fillna(0).
Comment gérer les valeurs manquantes avant d’entraîner un modèle scikit-learn ?
Sépare d’abord les données d’entraînement et de test, puis utilise un Pipeline avec SimpleImputer (par exemple strategy=’median’, et add_indicator=True pour garder l’information qu’une valeur manquait). Les remplacements sont ainsi calculés sur l’entraînement uniquement, sans fuite de données. Certains modèles, comme HistGradientBoostingClassifier, acceptent aussi les NaN directement.
Conclusion : que retenir du traitement des données manquantes avec Pandas ?
Le traitement des données manquantes se résume à trois temps : mesurer (isna(), la carte des trous, les valeurs déguisées), choisir (supprimer, remplacer ou estimer, selon le type de données) et vérifier (tes statistiques avant et après). Aucune méthode n’est parfaite : chacune a un coût, qu’il vaut mieux connaître avant de l’appliquer. Et pour le Machine Learning, imputer dans un pipeline évite de tricher sur ton propre score.
Pour appliquer ces techniques sur des cas concrets, le mieux est de s’entraîner. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec des exercices pratiques à faire directement en ligne.
Pour aller plus loin, voici d’autres articles qui pourraient te plaire :