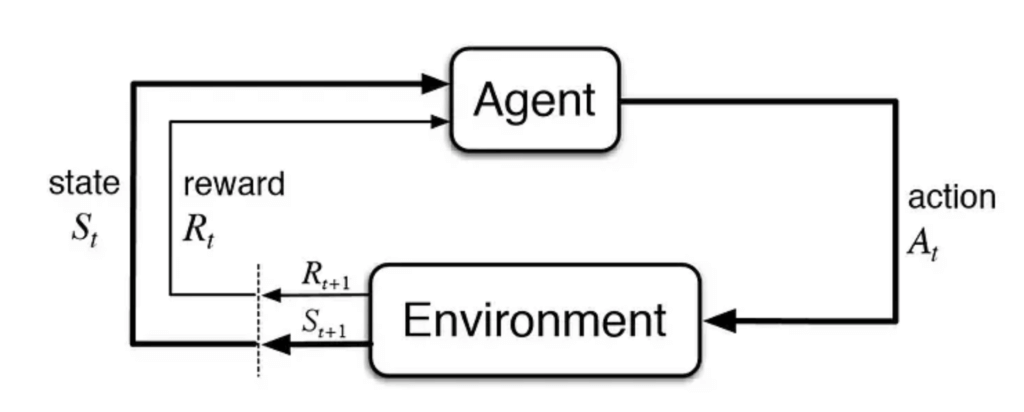
L’apprentissage par renforcement est une approche dans laquelle un agent apprend à prendre des décisions en interagissant avec un environnement. L’agent entreprend des actions, reçoit un retour sous forme de récompenses ou de punitions, et ajuste son comportement pour maximiser les récompenses à long terme. On l’utilise souvent en robotique, dans les jeux et dans les systèmes autonomes : c’est la méthode de l’essai et de l’erreur.
Le principe #
L’objectif global est de prédire la meilleure étape suivante pour obtenir la plus grande récompense finale. Prenons le jeu d’échecs :
- chaque action est un coup ;
- l’état est la situation actuelle de la partie ;
- les récompenses intermédiaires peuvent être, par exemple, la capture de pièces de l’adversaire ;
- la récompense finale, la plus grande, est de gagner la partie.
L’agent apprend donc tout par l’expérience.
Conclusion de la série #
Tu sais maintenant ce qu’est le Machine Learning, et tu retiens les quatre grandes familles d’apprentissage :
- supervisé : on fournit des données étiquetées ;
- non supervisé : on fournit des données sans aucune étiquette ;
- semi-supervisé : on fournit des données à moitié étiquetées, à moitié non étiquetées ;
- par renforcement : l’agent apprend par itérations, par essais et erreurs.
Ce sont les connaissances de base à avoir avant de te plonger dans l’étude des algorithmes. Les apprendre en détail est crucial en Data Science, et je suis moi-même passé par là ! Pour revoir l’ensemble, retourne au tutoriel Comment fonctionne le Machine Learning.
Pour aller plus loin, consulte aussi notre sélection des 10 meilleurs algorithmes d’apprentissage automatique pour les data scientists débutants.
Avant de faire apprendre un agent, il faut maîtriser Python et les données. C’est le parcours que propose DataXp, avec un coach IA à tes côtés.