Comme son nom l’indique, l’apprentissage non supervisé est l’opposé de l’apprentissage supervisé. En supervisé, chaque donnée d’entrée a une étiquette de sortie. En non supervisé, il y a des données d’entrée, mais elles ne sont pas explicitement étiquetées. Ces algorithmes apprennent à partir des données en trouvant des modèles implicites.
Prenons un algorithme à qui l’on montre différents fruits d’un panier : d’après leur forme, leur taille et leur couleur, il les répartit en groupes. Quand tu lui montres un nouveau fruit, il prédit à quel groupe il appartient.
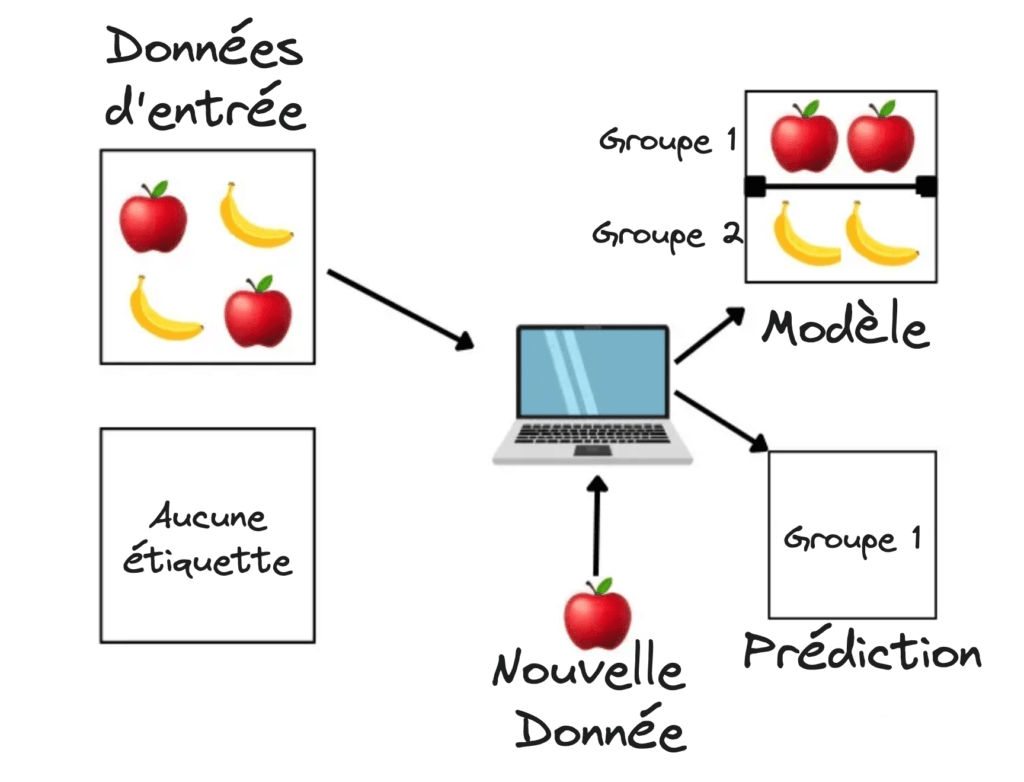
Les algorithmes non supervisés identifient les données selon divers facteurs : densité, structure, segments similaires et autres caractéristiques communes.
Quelques applications :
- les systèmes de recommandation ;
- l’analyse du comportement des clients ;
- le regroupement d’articles d’actualité ;
- et bien d’autres encore…
Types d’apprentissage non supervisé #
De manière générale, on les classe en 5 catégories :
- les algorithmes de clustering ;
- la réduction de la dimensionnalité ;
- la détection d’anomalies ;
- l’apprentissage par règles d’association ;
- les autoencodeurs.
Comprenons l’objectif de chaque catégorie et les algorithmes qui la composent.
Algorithmes de clustering #
Le clustering (ou segmentation) regroupe des objets similaires dans un même groupe, différent des autres groupes. C’est le cas du panier de fruits ci-dessus.
Algorithmes de clustering :
- K-Means
- DBSCAN
- Clustering hiérarchique
- Mean Shift (déplacement de la moyenne)
Exemple minimal avec K-Means : on regroupe 6 points en 2 clusters, sans leur donner aucune étiquette.
import numpy as np
from sklearn.cluster import KMeans

points = np.array([[1, 2], [1, 4], [2, 3], [8, 8], [9, 10], [10, 9]])

kmeans = KMeans(n_clusters=2, n_init=10, random_state=42).fit(points)
print("Cluster de chaque point :", kmeans.labels_)
print("Cluster d'un nouveau point [9, 9] :", kmeans.predict([[9, 9]]))Cluster de chaque point : [0 0 0 1 1 1]
Cluster d'un nouveau point [9, 9] : [1]Réduction de la dimensionnalité #
Réduire la dimensionnalité, c’est simplifier un problème complexe en se concentrant sur l’essentiel. Cette technique diminue le nombre de caractéristiques (features, ou dimensions) d’un jeu de données tout en conservant l’information importante. L’analyse devient plus efficace et la visualisation plus facile.
Algorithmes de réduction de la dimensionnalité :
- Analyse en composantes principales (ACP, ou PCA en anglais)
- t-SNE (t-Distributed Stochastic Neighbor Embedding)
Exemple : passer des 4 dimensions du jeu de données iris à 2 dimensions avec l’ACP.
from sklearn.datasets import load_iris
from sklearn.decomposition import PCA

X, _ = load_iris(return_X_y=True)
X_2d = PCA(n_components=2).fit_transform(X)
print("Avant :", X.shape, "-> Après :", X_2d.shape)Avant : (150, 4) -> Après : (150, 2)Détection d’anomalies #
La détection d’anomalies consiste à trouver l’intrus dans un groupe. Elle sert à repérer les points de données inhabituels ou rares, qui ne correspondent pas aux modèles attendus (les valeurs aberrantes). Elle est très utile dans de nombreux domaines, de la détection de fraudes dans les transactions financières à l’identification de dysfonctionnements dans des systèmes industriels. Le principe : on entraîne un modèle sur les données normales, et tout ce qui s’en écarte peut être une anomalie.
Algorithmes de détection d’anomalies :
- méthodes basées sur K-Means (distance aux centres)
- One-Class SVM
- Isolation Forest (forêt d’isolement)
Apprentissage par règles d’association #
L’apprentissage par règles d’association permet de trouver des liens intéressants entre les articles achetés dans un magasin (« ceux qui achètent du pain achètent souvent du beurre »). Cette technique découvre des relations, des tendances et des associations entre des éléments ou des événements. Elle est précieuse pour comprendre le comportement des consommateurs, optimiser les stocks et améliorer les recommandations personnalisées.
Algorithmes d’apprentissage par règles d’association :
- Apriori
- FP-Growth (croissance des motifs fréquents)
- Eclat
Autoencodeurs #
Les autoencodeurs sont un type de réseau de neurones qui prend des données complexes, les compresse en un code, puis tente de recréer les données d’entrée à partir de ce code résumé. Ce processus de compression-décompression peut servir à supprimer le bruit dans des données visuelles (images, vidéos, scanners médicaux) pour en améliorer la qualité.
La suite de la série : l’apprentissage semi-supervisé.
Pour aller plus loin, consulte aussi notre sélection des 10 meilleurs algorithmes d’apprentissage automatique pour les data scientists débutants.
Le clustering se comprend en le testant sur des données. Sur DataXp, tu progresses de Python et pandas vers le Machine Learning, exercice après exercice.


