L’apprentissage supervisé est la méthode la plus répandue en Machine Learning. Il s’utilise quand il existe une correspondance précise entre les données d’entrée et de sortie. Par exemple, pour une forme donnée, nous disposons d’une étiquette précise : « Pomme ». Nous montrons quelques-unes de ces formes à l’algorithme (via le code), et la prochaine fois que tu lui présenteras cette forme, il prédira qu’il s’agit d’une pomme.
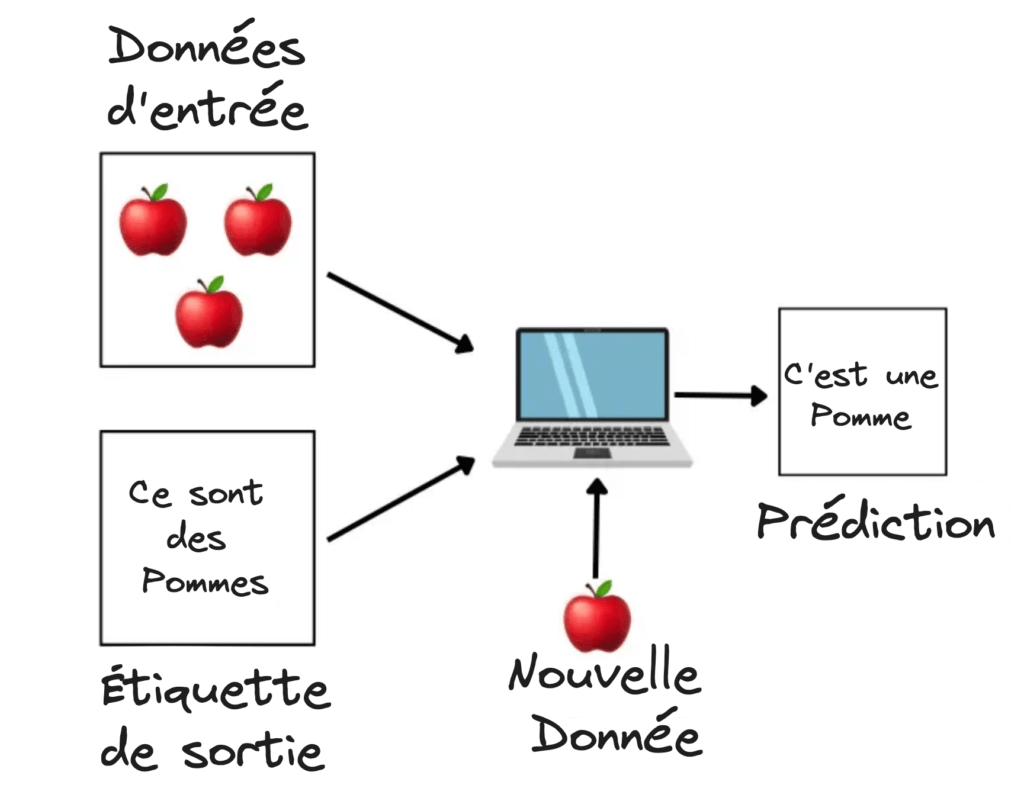
Tu envoies à l’algorithme des exemples accompagnés de leurs étiquettes et, au fil du temps, il trouve le modèle approximatif qui relie les exemples à leurs étiquettes. Une fois entièrement entraîné, tu peux lui envoyer de nouvelles données : il fait une prédiction.
Ces algorithmes supervisés sont dits « orientés tâches » : plus tu lui fournis de données, mieux il apprend et meilleures sont ses prédictions.
Quelques applications :
- la reconnaissance des visages ;
- la reconnaissance vocale ;
- la classification du spam ;
- et bien d’autres encore…
Types d’apprentissage supervisé #
De manière générale, l’apprentissage supervisé se classe en deux catégories : la régression et la classification.
Régression #
Pour simplifier, les algorithmes de régression prédisent une variable continue (entier ou flottant) à partir des variables d’entrée. L’exemple vu dans le tutoriel Comment fonctionne le Machine Learning est un algorithme de régression supervisée : il prédit la taille du père à partir de la taille d’un adulte. La taille prédite est bien une variable continue.
Algorithmes de régression #
- Régression linéaire
- Régression polynomiale
- Régression Lasso
- Régression Ridge (de crête)
- Régression exponentielle
- Régression logarithmique
Quelques applications :
- prédire les résultats d’étudiants à partir de leurs résultats d’examens précédents ;
- prédire le prix d’une maison selon la taille des pièces, la localité, etc.
Exemple minimal avec la régression linéaire de scikit-learn : on prédit le prix d’une maison (en milliers d’euros) à partir de sa surface (en m², valeurs fictives).
from sklearn.linear_model import LinearRegression

surfaces = [[50], [70], [90], [110], [130]]   # variable d'entrée (X)
prix = [150, 205, 255, 310, 360]              # étiquette continue (y)

modele = LinearRegression().fit(surfaces, prix)
print("Prix prédit pour 100 m² :", modele.predict([[100]]).round(1))Prix prédit pour 100 m² : [282.2]Classification #
Les algorithmes de classification prédisent des catégories, pas une variable continue. Par exemple, pour déterminer si un e-mail est un spam ou non, la variable à prédire n’est pas un nombre mais une catégorie (« spam » ou « non spam »).
Algorithmes de classification #
- Régression logistique
- K plus proches voisins (KNN)
- Arbres de décision
- Forêt aléatoire (Random Forest)
- Machine à vecteurs de support (SVM)
- Bayes naïf
- AdaBoost
- XGBoost
- Gradient Boosting
Quelques applications :
- détecter les e-mails indésirables à partir des e-mails précédents ;
- classer des images pour identifier un chat ou un chien.
Exemple minimal : classer des fleurs du jeu de données iris avec les K plus proches voisins.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

modele = KNeighborsClassifier(n_neighbors=3).fit(X_train, y_train)
print("Précision sur les données de test :", modele.score(X_test, y_test))Précision sur les données de test : 1.0Pour choisir parmi tous ces algorithmes, commence par les plus simples. La suite de la série : l’apprentissage non supervisé.
Pour aller plus loin, consulte aussi notre sélection des 10 meilleurs algorithmes d’apprentissage automatique pour les data scientists débutants.
Entraîner un modèle, c’est facile. Bien l’évaluer, c’est un métier. Sur DataXp, tu t’entraînes avec des exercices et un coach IA, de Python au Machine Learning.