Python est un langage scientifique très mature. On y trouve des bibliothèques pour tout un tas d’usages différents, notamment le Machine Learning et l’analyse de data.
La visualisation de données Python est une partie importante du travail : elle sert à explorer les données et à communiquer les résultats.
Au cours des dernières années, de nombreuses bibliothèques de visualisation de données ont vu le jour en Python pour combler son retard sur le langage R. Matplotlib est devenue la principale (voir aussi notre article sur la visualisation de données avec Matplotlib).
Mais il en existe d’autres, qui répondent à des besoins plus précis :
- vispy : visualisation scientifique accélérée par GPU ;
- Bokeh : graphiques interactifs dans le navigateur ;
- Seaborn : graphiques statistiques, construit sur Matplotlib ;
- pygal : graphiques SVG soignés ;
- folium : cartes interactives ;
- networkx : graphes et réseaux.
Dans cet article, nous utiliserons chacune de ces bibliothèques pour créer des graphiques, et nous découvrirons leurs forces et leurs faiblesses.
Quelle est la plus performante ? Comment tirer le meilleur de Python en termes de visualisation de données ?
En bref : en Python, Matplotlib est la bibliothèque de visualisation de référence : très flexible, mais il faut plus de commandes pour obtenir des graphiques attrayants. Seaborn est plus agréable par défaut et adapté aux graphiques statistiques, Bokeh et folium rendent graphiques et cartes interactifs, pygal soigne la présentation (SVG) et networkx dessine des réseaux. L’article les compare sur les données OpenFlights (routes, aéroports, compagnies aériennes). Code testé en octobre 2026 avec Python 3.13, Matplotlib 3.11, Seaborn 0.13, Bokeh 3.10, pygal 3.1, folium 0.20, Cartopy 0.26 et NetworkX 3.6.
Tu peux aussi exécuter tous les exemples dans ce notebook Google Colab : chaque extrait de code est dans sa propre cellule, prêt à être modifié.
Quelles données utilise-t-on pour comparer les bibliothèques ?
Avant de rentrer dans le vif du sujet, jetons un coup d’œil au dataset avec lequel nous allons travailler. Nous utiliserons les données d’OpenFlights (routes aériennes, aéroports et compagnies aériennes).
Les données sont publiques : le code ci-dessous lit directement les fichiers routes.dat, airports.dat et airlines.dat depuis le GitHub de MonCoachData, sans rien télécharger. Ce sont des copies des fichiers d’OpenFlights (licence Open Database License). Il te faut seulement les bibliothèques installées par la commande ci-dessous.
Chaque ligne du fichier des routes correspond à une route aérienne entre deux aéroports. Chaque ligne du fichier des aéroports correspond à un aéroport dans le monde, avec ses informations. Chaque ligne du fichier des compagnies représente tout simplement une compagnie aérienne.
Comment lire les données ?
pip install pandas matplotlib seaborn bokeh pygal folium cartopy networkximport pandas as pd
BASE = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/sqlite-python/"
# Les fichiers n'ont pas d'en-têtes : on les ajoute en affectant l'attribut columns.
# dtype=str : chaque colonne est lue comme du texte, ce qui facilite la comparaison des identifiants.
airports = pd.read_csv(BASE + "airports.dat", header=None, dtype=str)
airports.columns = ["id", "name", "city", "country", "code", "icao", "latitude", "longitude",
"altitude", "offset", "dst", "timezone", "type", "source"]
airlines = pd.read_csv(BASE + "airlines.dat", header=None, dtype=str)
airlines.columns = ["id", "name", "alias", "iata", "icao", "callsign", "country", "active"]
routes = pd.read_csv(BASE + "routes.dat", header=None, dtype=str)
routes.columns = ["airline", "airline_id", "source", "source_id", "dest", "dest_id",
"codeshare", "stops", "equipment"]
print(airports.shape, airlines.shape, routes.shape)(7698, 14) (6162, 8) (67663, 9)Les données n’ont pas d’en-têtes de colonne. Nous les ajoutons donc manuellement en les affectant à l’attribut columns.
Nous voulons lire chaque colonne en tant que chaîne de caractères : cela facilitera la comparaison des données plus tard, quand nous devrons faire correspondre les lignes à partir de leur identifiant (id). Pour cela, nous définissons le paramètre dtype lors de la lecture des données.
Nous obtenons 7 698 aéroports, 6 162 compagnies aériennes et 67 663 routes. Regardons les premières lignes de chaque DataFrame :
airports.head() id name city \
0 1 Goroka Airport Goroka
1 2 Madang Airport Madang
2 3 Mount Hagen Kagamuga Airport Mount Hagen
3 4 Nadzab Airport Nadzab
4 5 Port Moresby Jacksons International Airport Port Moresby
country code icao latitude longitude \
0 Papua New Guinea GKA AYGA -6.081689834590001 145.391998291
1 Papua New Guinea MAG AYMD -5.20707988739 145.789001465
2 Papua New Guinea HGU AYMH -5.826789855957031 144.29600524902344
3 Papua New Guinea LAE AYNZ -6.569803 146.725977
4 Papua New Guinea POM AYPY -9.443380355834961 147.22000122070312
altitude offset dst timezone type source
0 5282 10 U Pacific/Port_Moresby airport OurAirports
1 20 10 U Pacific/Port_Moresby airport OurAirports
2 5388 10 U Pacific/Port_Moresby airport OurAirports
3 239 10 U Pacific/Port_Moresby airport OurAirports
4 146 10 U Pacific/Port_Moresby airport OurAirportsairlines.head() id name alias iata icao callsign \
0 -1 Unknown \N - NaN \N
1 1 Private flight \N - NaN NaN
2 2 135 Airways \N NaN GNL GENERAL
3 3 1Time Airline \N 1T RNX NEXTIME
4 4 2 Sqn No 1 Elementary Flying Training School \N NaN WYT NaN
country active
0 \N Y
1 NaN Y
2 United States N
3 South Africa Y
4 United Kingdom Nroutes.head() airline airline_id source source_id dest dest_id codeshare stops equipment
0 2B 410 AER 2965 KZN 2990 NaN 0 CR2
1 2B 410 ASF 2966 KZN 2990 NaN 0 CR2
2 2B 410 ASF 2966 MRV 2962 NaN 0 CR2
3 2B 410 CEK 2968 KZN 2990 NaN 0 CR2
4 2B 410 CEK 2968 OVB 4078 NaN 0 CR2Nous pouvons faire de nombreuses explorations intéressantes avec chaque dataset, mais ce sera plus bénéfique en les combinant. La bibliothèque Pandas nous aide dans cette analyse, car elle permet de filtrer facilement les tableaux et d’appliquer des fonctions sur des colonnes.
Nous allons nous intéresser à quelques métriques, comme les compagnies aériennes et les itinéraires aériens.
Avant cela, nous devons faire un peu de nettoyage de données (data cleaning) :
# On ne garde que les routes dont l'identifiant de compagnie est numérique (OpenFlights note \N les valeurs inconnues)
routes = routes[routes["airline_id"] != "\\N"]
routes.shape(67184, 9)Cette ligne nous assure d’avoir uniquement des données numériques dans la colonne airline_id.
Comment réaliser un histogramme avec Matplotlib ?
Nous pouvons maintenant aller plus loin et faire des graphiques pour explorer nos données. Pour le premier, nous utiliserons Matplotlib.
Matplotlib est une bibliothèque assez basique pour tracer des graphiques avec Python. Il faut donc généralement plus de commandes pour faire des graphiques attrayants qu’avec d’autres bibliothèques.
D’un autre côté, tu peux faire presque n’importe quel type de graphique avec Matplotlib : cette flexibilité se paie en nombre de commandes nécessaires pour tracer un graphique un peu plus élaboré.
Nous allons d’abord faire un histogramme montrant la distribution des longueurs des routes aériennes. Pour rappel, un histogramme divise toutes les longueurs d’itinéraire en intervalles (ou « bins ») et compte le nombre d’itinéraires qui tombent dans chaque intervalle.
Cela nous indique si les compagnies aériennes effectuent plutôt des trajets courts ou plutôt des trajets longs.
Pour cela, nous devons d’abord calculer les longueurs des routes aériennes. La première étape est une formule de distance : nous utiliserons la formule d’haversine, qui calcule la distance entre deux points d’une sphère à partir de leurs longitudes et latitudes.
import math

def haversine(lon1, lat1, lon2, lat2):
    # Distance (en km) entre deux points d'une sphère, à partir de leurs longitudes et latitudes
    lon1, lat1, lon2, lat2 = map(math.radians, [lon1, lat1, lon2, lat2])
    dlon = lon2 - lon1
    dlat = lat2 - lat1
    a = math.sin(dlat / 2) ** 2 + math.cos(lat1) * math.cos(lat2) * math.sin(dlon / 2) ** 2
    c = 2 * math.asin(math.sqrt(a))
    km = 6367 * c
return kmEnsuite, nous écrivons une fonction qui calcule la distance entre les aéroports source et dest pour un seul itinéraire.
Pour cela, nous récupérons les source_id et dest_id des aéroports dans le DataFrame routes. Puis nous les faisons correspondre à la colonne id du DataFrame airports pour obtenir la latitude et la longitude de ces aéroports. Il ne reste plus qu’à appliquer la formule.
Voici la fonction :
def calc_dist(row):
    dist = 0
    try:
        # On récupère les aéroports de départ et d'arrivée à partir de leur identifiant
        source = airports[airports["id"] == row["source_id"]].iloc[0]
        dest = airports[airports["id"] == row["dest_id"]].iloc[0]
        dist = haversine(float(dest["longitude"]), float(dest["latitude"]),
                         float(source["longitude"]), float(source["latitude"]))
    except (ValueError, IndexError):
        pass
return distLa fonction peut échouer s’il y a une valeur invalide dans les colonnes source_id ou dest_id. D’où le bloc try / except pour éviter l’erreur.
Pour finir, nous utilisons la méthode apply de Pandas pour appliquer la fonction de calcul de la distance (calc_dist) à l’ensemble des routes. Cela nous donne un objet Series contenant toutes les longueurs de route, exprimées en kilomètres.
route_lengths = routes.apply(calc_dist, axis=1)
route_lengths.head()0 1505.879552
1 1039.785086
2 447.883531
3 770.024740
4 1337.791014
dtype: float64Maintenant que nous avons une série contenant la longueur des itinéraires, nous pouvons créer un histogramme. Il classe les valeurs dans des intervalles et compte le nombre d’itinéraires dans chacun.
import matplotlib.pyplot as plt
%matplotlib inline

plt.hist(route_lengths, bins=20)
plt.xlabel("Longueur de la route (km)")
plt.ylabel("Nombre de routes")
plt.show()Regardons le résultat :
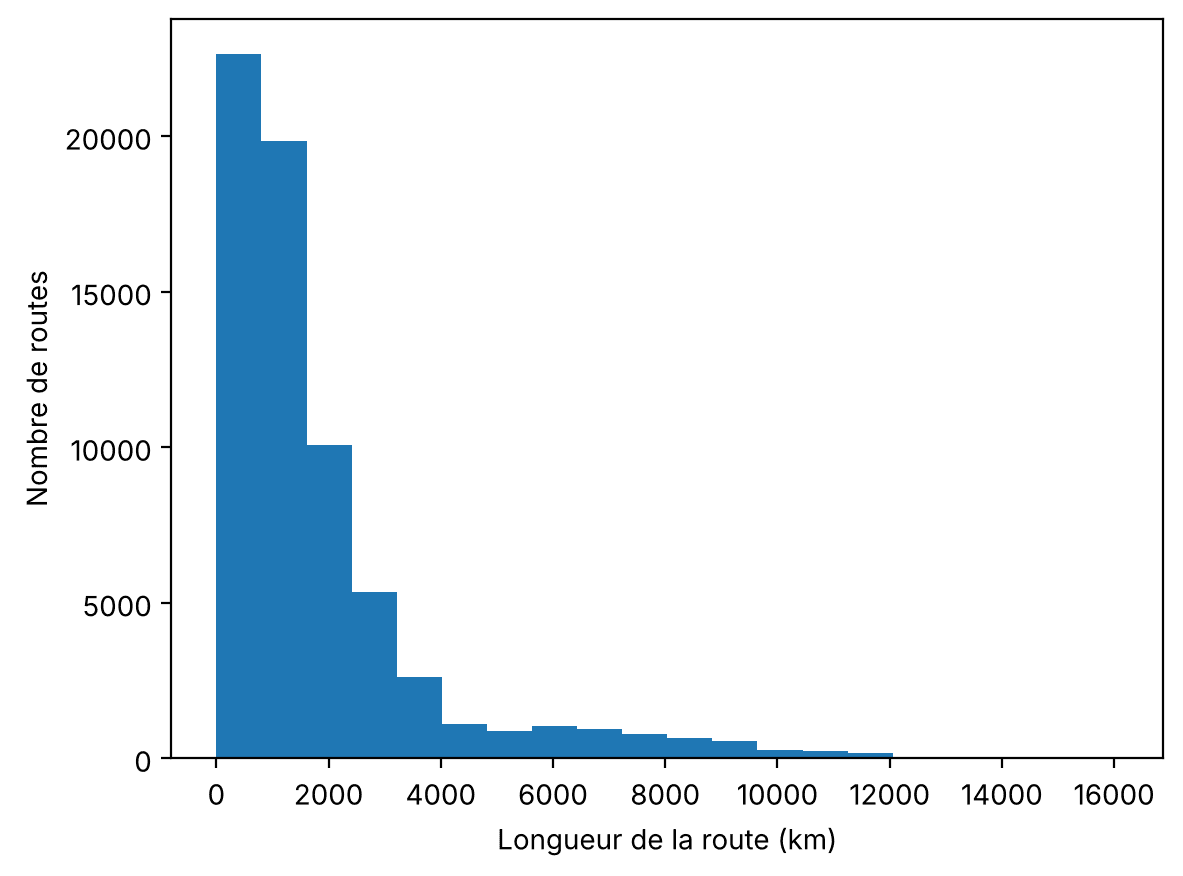
Nous importons pyplot depuis Matplotlib, que nous renommons plt. Nous configurons ensuite Matplotlib pour afficher les tracés dans le notebook Jupyter avec %matplotlib inline.
Finalement, nous traçons l’histogramme avec plt.hist(route_lengths, bins = 20). Comme tu peux le voir, les compagnies aériennes effectuent beaucoup plus de trajets courts que de trajets longs.
Comment faire un histogramme plus soigné avec Seaborn ?
Nous pouvons réaliser un graphique similaire avec Seaborn, une bibliothèque plus élaborée qui s’appuie sur Matplotlib et simplifie certains graphiques statistiques.
Nous utilisons la fonction histplot avec kde=True pour tracer un histogramme avec une estimation de densité de noyau (KDE) : une courbe qui est une version lissée de l’histogramme, plus facile à analyser.
Mise à jour : dans la version d’origine de cet article, nous utilisions distplot, déprécié depuis Seaborn 0.11. histplot(..., kde=True) (ou displot) le remplace.
import seaborn as sns

sns.histplot(route_lengths, bins=20, kde=True)
plt.xlabel("Longueur de la route (km)")
plt.ylabel("Nombre de routes")
plt.show()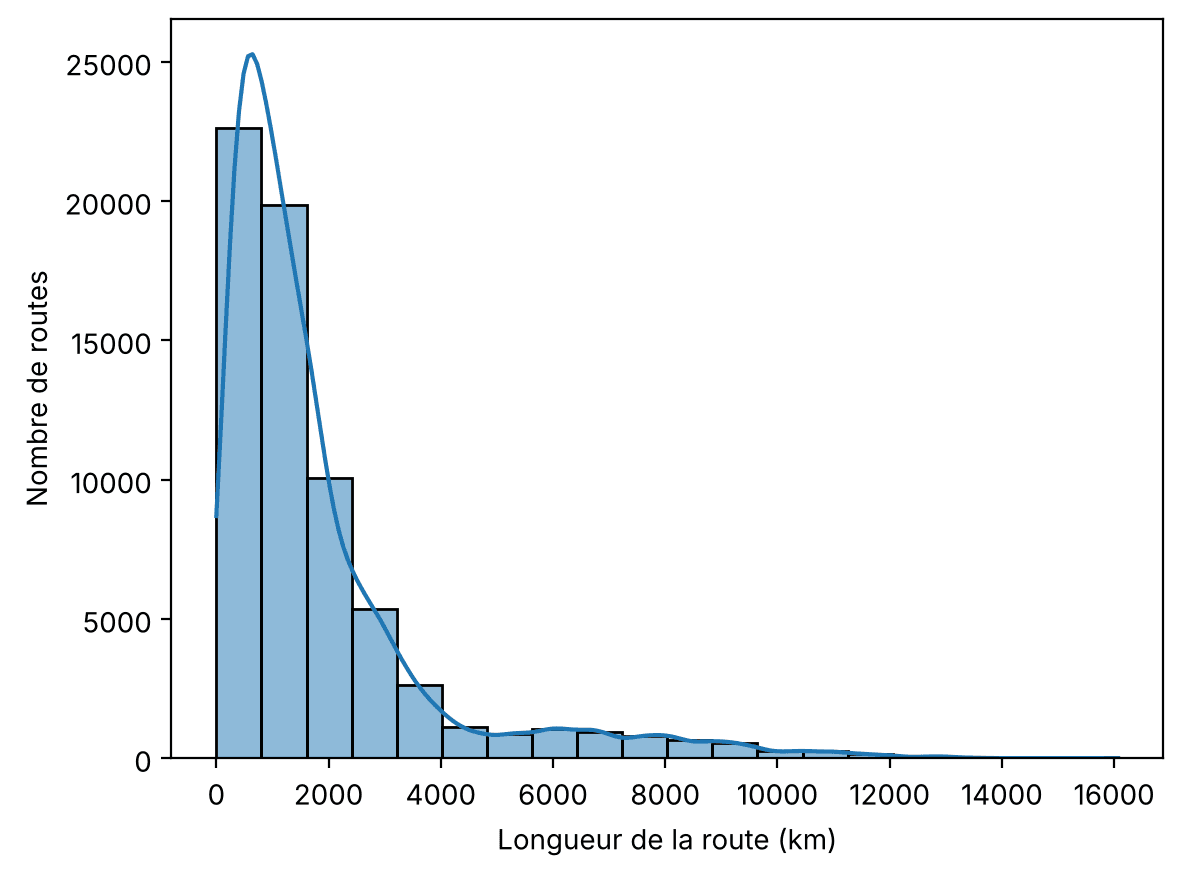
Comme tu peux le voir, Seaborn est par défaut esthétiquement plus agréable que Matplotlib : il permet d’obtenir rapidement de plus beaux graphiques. C’est aussi une bonne bibliothèque si tu as besoin d’approfondir ton travail avec un angle statistique.
Comment faire un diagramme en barres, puis le rendre interactif avec Bokeh ?
Les histogrammes, c’est bien… mais voir la longueur moyenne d’un itinéraire par compagnie aérienne, c’est mieux 🙂
Pour cela, nous utilisons un diagramme en barres, avec une barre par compagnie. Cela nous permet de voir quelles compagnies sont nationales et lesquelles sont internationales.
Nous utilisons d’abord Pandas pour déterminer la longueur moyenne d’un itinéraire par compagnie aérienne.
import numpy as np

route_length_df = pd.DataFrame({"length": route_lengths, "airline_id": routes["airline_id"]})

airline_route_lengths = route_length_df.groupby("airline_id").agg({"length": "mean"})
airline_route_lengths = airline_route_lengths.sort_values("length", ascending=False)
airline_route_lengths.head() length
airline_id
11806 7261.375734
3201 6332.122085
1008 5861.986606
1299 4943.942048
2183 4711.276359Nous créons d’abord un nouveau DataFrame avec les longueurs d’itinéraire et les identifiants des compagnies aériennes. Nous divisons route_length_df en groupes à partir de airline_id, ce qui crée un DataFrame par compagnie.
Nous utilisons ensuite la fonction agg de Pandas pour calculer la moyenne de la colonne length de chacun de ces DataFrames, puis nous ajoutons chaque résultat dans un nouveau DataFrame, airline_route_lengths. Nous trions enfin les données pour que les itinéraires les plus longs sortent en premier.
Nous pouvons enfin tracer notre diagramme en barres avec Matplotlib :
plt.bar(range(airline_route_lengths.shape[0]), airline_route_lengths["length"])
plt.xlabel("Compagnies aériennes (triées par longueur moyenne)")
plt.ylabel("Longueur moyenne des routes (km)")
plt.show()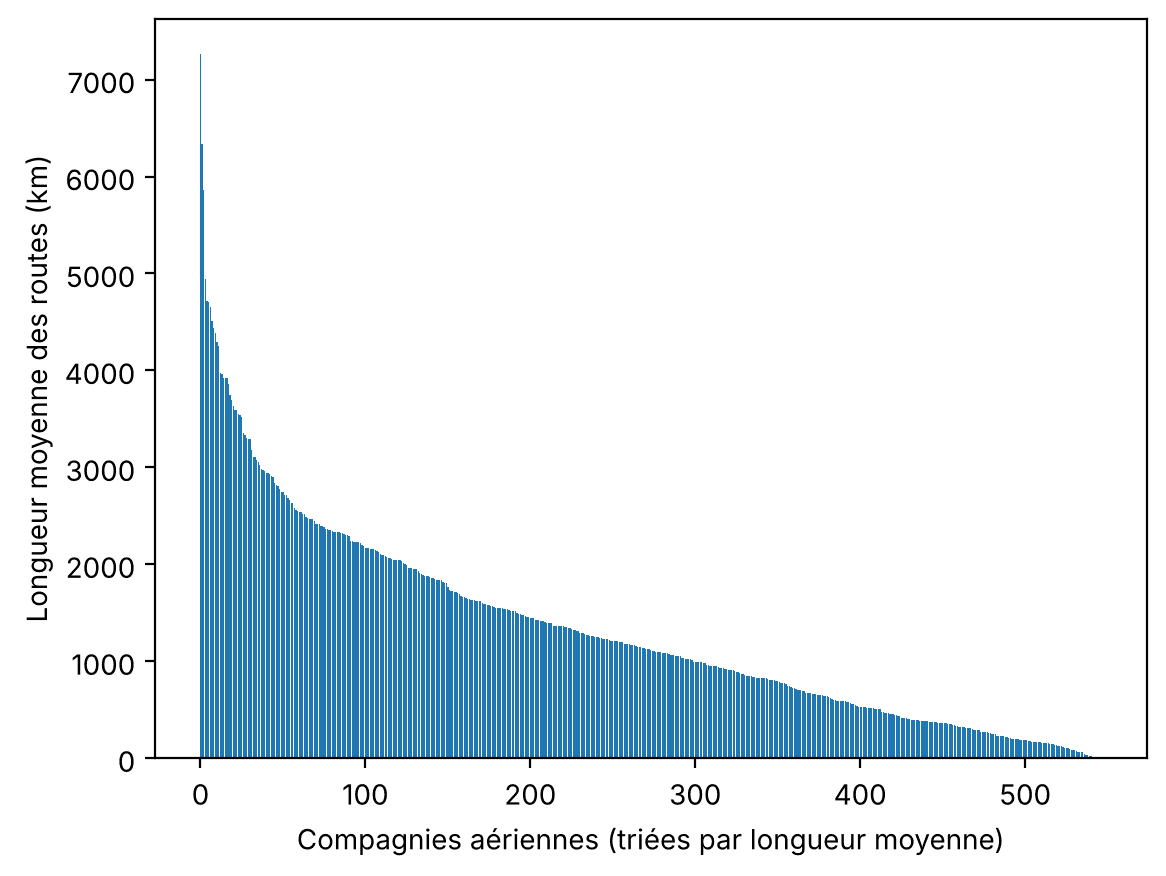
La méthode plt.bar de Matplotlib trace la longueur moyenne d’itinéraire de chaque compagnie aérienne (airline_route_lengths["length"]).
Le problème de ce graphique, c’est que nous ne pouvons pas déterminer facilement la longueur moyenne de vol d’une compagnie donnée. Il faudrait ajouter des intitulés sur l’axe horizontal, ce qui n’est pas évident au vu du nombre de compagnies.
Une solution est de rendre le graphique interactif, pour pouvoir zoomer et voir les noms des compagnies. Nous pouvons utiliser la bibliothèque Bokeh, qui rend la création de graphiques interactifs et zoomables assez facile.
Pour utiliser Bokeh, nous devons d’abord préparer nos données :
def lookup_name(airline_id):
    # Nom de la compagnie à partir de son identifiant
    try:
        return airlines.loc[airlines["id"] == airline_id, "name"].iloc[0]
    except IndexError:
        return "Inconnue"

airline_route_lengths["name"] = airline_route_lengths.index.map(lookup_name)
airline_route_lengths["id"] = airline_route_lengths.index
airline_route_lengths = airline_route_lengths.reset_index(drop=True)
airline_route_lengths.head() length name id
0 7261.375734 Compagnie Africaine d\\'Aviation 11806
1 6332.122085 LAN Argentina 3201
2 5861.986606 Albanian Airlines 1008
3 4943.942048 Arkefly 1299
4 4711.276359 Emirates 2183Le code ci-dessus récupère le nom de chaque ligne de airline_route_lengths et l’ajoute dans une colonne name. Nous ajoutons aussi une colonne id pour pouvoir faire cette recherche (la fonction apply ne s’applique qu’aux identifiants de l’index).
Enfin, nous réinitialisons l’index pour avoir des valeurs uniques : Bokeh ne fonctionne pas correctement sans cela.
Nous pouvons maintenant passer à la partie graphique :
from bokeh.plotting import figure, show, output_notebook
from bokeh.models import ColumnDataSource, HoverTool

output_notebook()

source = ColumnDataSource(airline_route_lengths.assign(rang=airline_route_lengths.index))
p = figure(title="Longueur moyenne des routes par compagnie aérienne", width=800, height=450,
           x_axis_label="Compagnies (triées par longueur moyenne)", y_axis_label="Longueur moyenne (km)",
           tools="pan,wheel_zoom,box_zoom,reset")
p.vbar(x="rang", top="length", width=0.9, source=source)
p.add_tools(HoverTool(tooltips=[("Compagnie", "@name"), ("Longueur moyenne (km)", "@length{0}")]))
show(p)Nous appelons output_notebook pour configurer Bokeh afin qu’il affiche le graphique interactif dans le notebook. Nous construisons ensuite le diagramme en barres avec bokeh.plotting : une barre par compagnie, et une info-bulle (HoverTool) qui affiche le nom de la compagnie et sa longueur moyenne au survol. Enfin, la fonction show affiche le graphique.
Mise à jour : dans la version d’origine, nous utilisions bkcharts, qui n’est plus maintenue et a été retirée de Bokeh. Le code ci-dessus utilise bokeh.plotting, compatible avec les versions récentes.
Le graphique généré n’est pas une image : c’est un widget JavaScript. C’est pourquoi la capture d’écran ci-dessous, contrairement au graphique réel, n’est pas interactive.
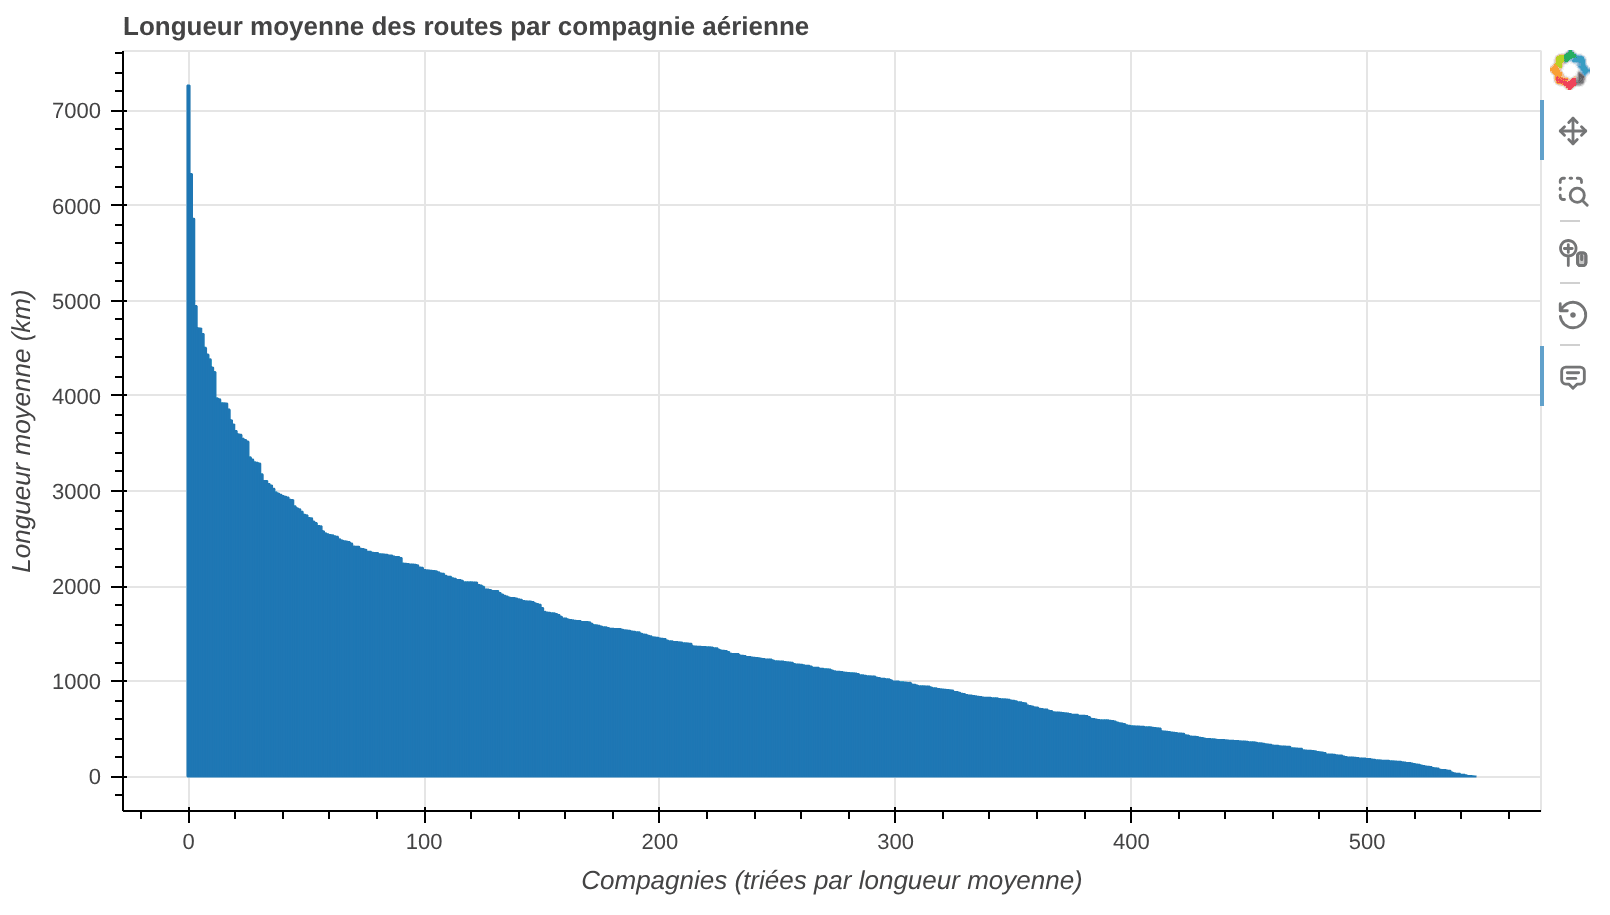
Avec ce graphique, nous pouvons zoomer et voir quelles compagnies aériennes effectuent les plus longs trajets. Sur l’image ci-dessus, les noms semblent se superposer, mais ils sont beaucoup plus faciles à lire quand tu zoomes.
Comment faire un graphique à barres horizontales avec Pygal ?
Pygal est une bibliothèque Python de visualisation qui rend nos graphiques rapidement attrayants. Nous pouvons l’utiliser pour faire une ventilation des itinéraires par longueur.
Nous séparons d’abord nos itinéraires en trois catégories : court, moyen et long. Puis nous calculons le pourcentage de chacune.
# Catégories : court (moins de 2000 km), moyen (2000 à 10000 km) et long (plus de 10000 km)
long_routes = len([k for k in route_lengths if k > 10000]) / len(route_lengths)
medium_routes = len([k for k in route_lengths if k < 10000 and k > 2000]) / len(route_lengths)
short_routes = len([k for k in route_lengths if k < 2000]) / len(route_lengths)

print(f"Long : {long_routes:.1%} | Moyen : {medium_routes:.1%} | Court : {short_routes:.1%}")Long : 0.9% | Moyen : 26.5% | Court : 72.6%Nous pouvons ensuite tracer chacune de ces catégories dans un graphique à barres horizontales Pygal :
import pygal
from IPython.display import SVG

chart = pygal.HorizontalBar()
chart.title = "Itinéraires aériens : courts, moyens et longs"
chart.add("Long", long_routes * 100)
chart.add("Moyen", medium_routes * 100)
chart.add("Court", short_routes * 100)
chart.render_to_file("routes.svg")
SVG(filename="routes.svg")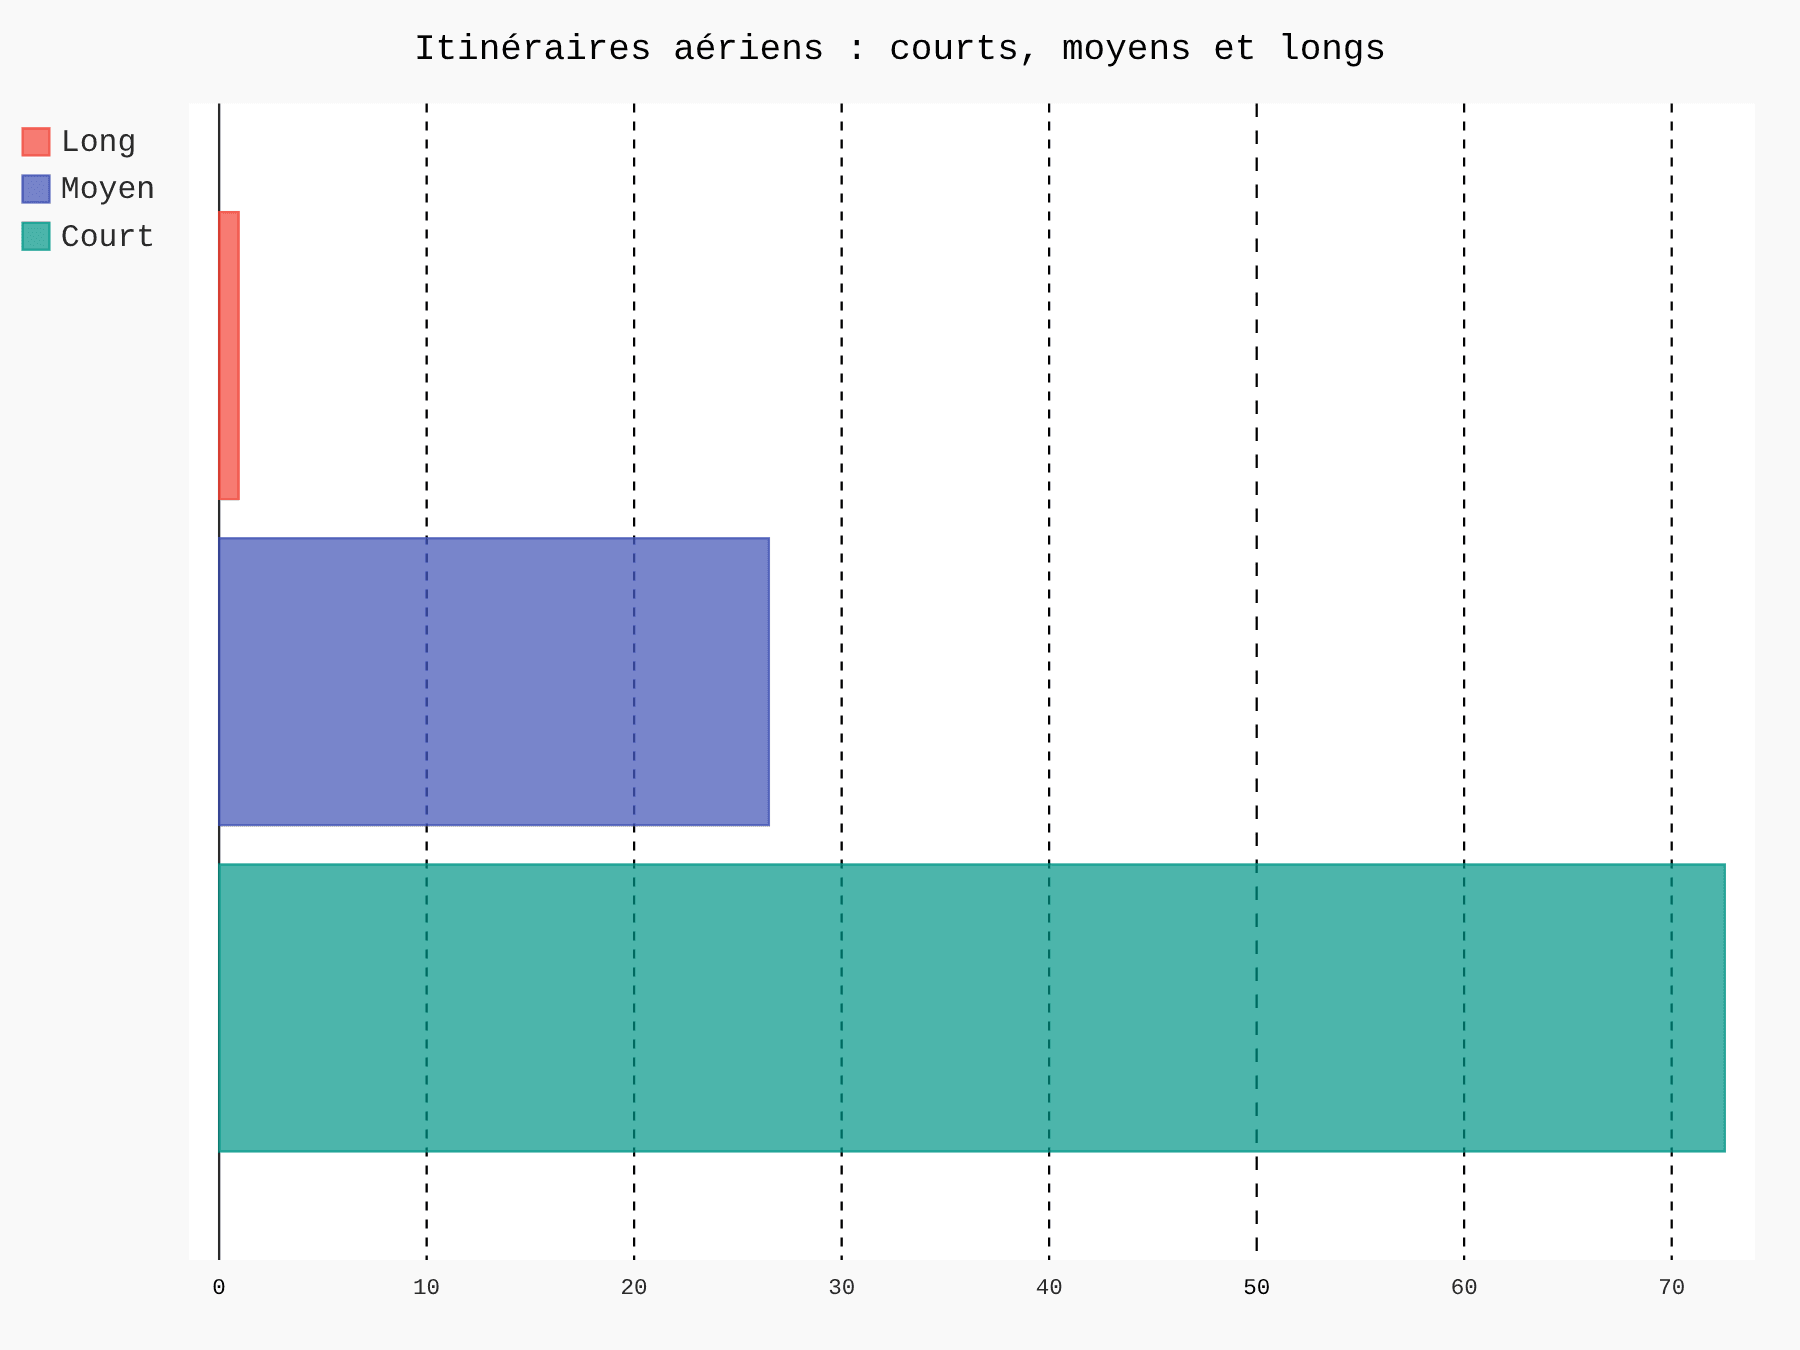
Ci-dessus, nous créons d’abord un graphique vide, puis nous ajoutons des éléments : un titre et des barres. Chaque barre a un pourcentage (sur 100) indiquant la fréquence de ce type de route.
Enfin, nous enregistrons le graphique dans un fichier et utilisons les capacités d’affichage SVG de Jupyter pour le charger et l’afficher.
Ce graphique est plus joli que les graphiques Matplotlib par défaut, mais nous avons dû écrire plus de code pour le créer. Pygal est très bon pour des graphiques nécessitant une qualité de présentation supérieure. Sur nos données, 72,6 % des routes sont courtes (moins de 2 000 km), 26,5 % sont moyennes (2 000 à 10 000 km) et seulement 0,9 % sont longues (plus de 10 000 km).
Comment faire un nuage de points avec Matplotlib et Seaborn ?
Les nuages de points permettent de comparer des colonnes de données. Nous pouvons par exemple faire un nuage de points simple pour comparer l’identifiant (id) de la compagnie aérienne à la longueur du nom de la compagnie :
name_lengths = airlines["name"].apply(lambda x: len(str(x)))

plt.scatter(airlines["id"].astype(int), name_lengths)
plt.xlabel("Identifiant de la compagnie")
plt.ylabel("Longueur du nom")
plt.show()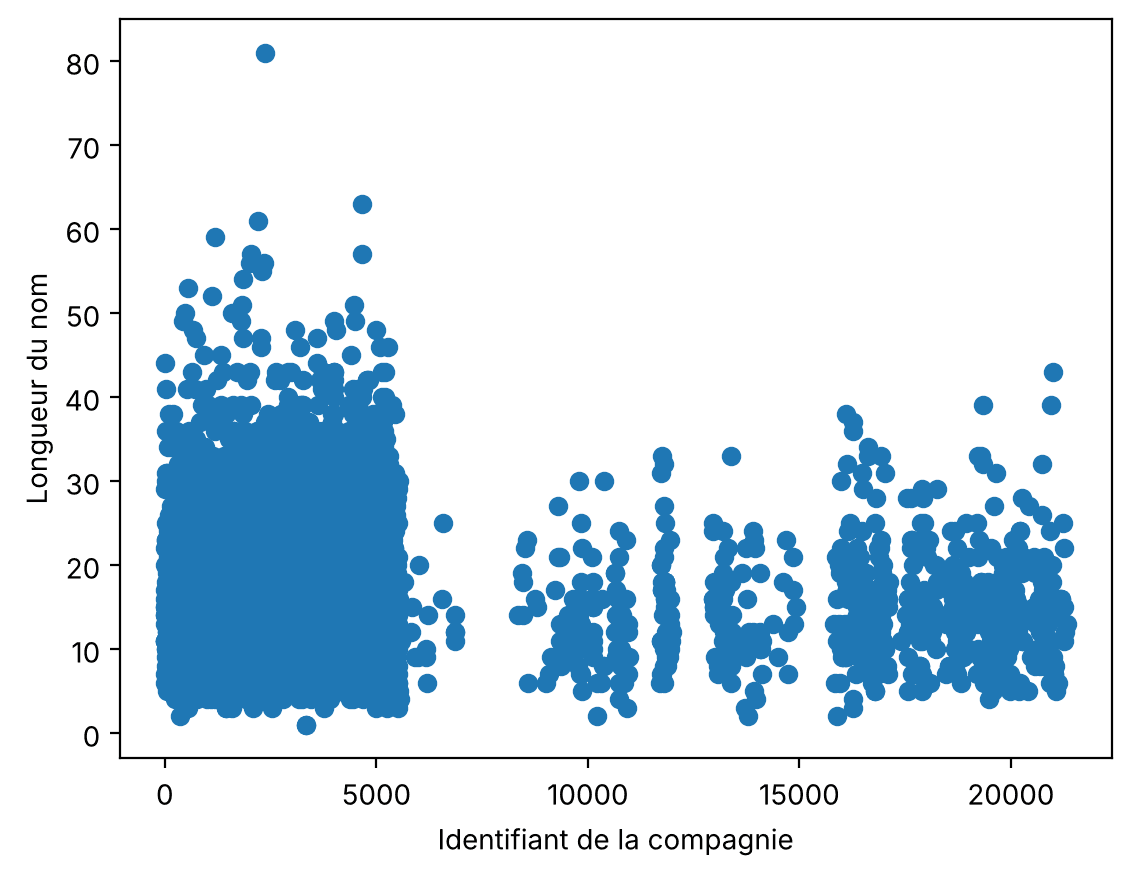
Nous calculons d’abord la longueur de chaque nom avec la méthode apply de Pandas, qui retourne le nombre de caractères de chaque nom de compagnie.
Nous réalisons ensuite un nuage de points (avec Matplotlib) comparant les identifiants des compagnies à la longueur de leur nom. Lors du tracé, nous convertissons la colonne id de airlines en entier, car le graphique a besoin de valeurs numériques sur l’axe des x.
Nous voyons qu’un certain nombre de noms plus longs apparaissent parmi les premiers identifiants. Cela pourrait signifier que les compagnies fondées il y a plus longtemps ont tendance à avoir des noms plus longs.
Nous pouvons vérifier cette intuition avec Seaborn. Il propose une version améliorée du nuage de points, le jointplot, qui montre à quel point deux variables sont corrélées, ainsi que la distribution de chacune.
data = pd.DataFrame({"lengths": name_lengths, "ids": airlines["id"].astype(int)})
sns.jointplot(x="ids", y="lengths", data=data)
plt.show()

# Coefficient de corrélation de Pearson (r) et son carré (r²)
from scipy.stats import pearsonr
r, p_value = pearsonr(data["ids"], data["lengths"])
print(f"r = {r:.3f}, r² = {r**2:.3f}")r = -0.049, r² = 0.002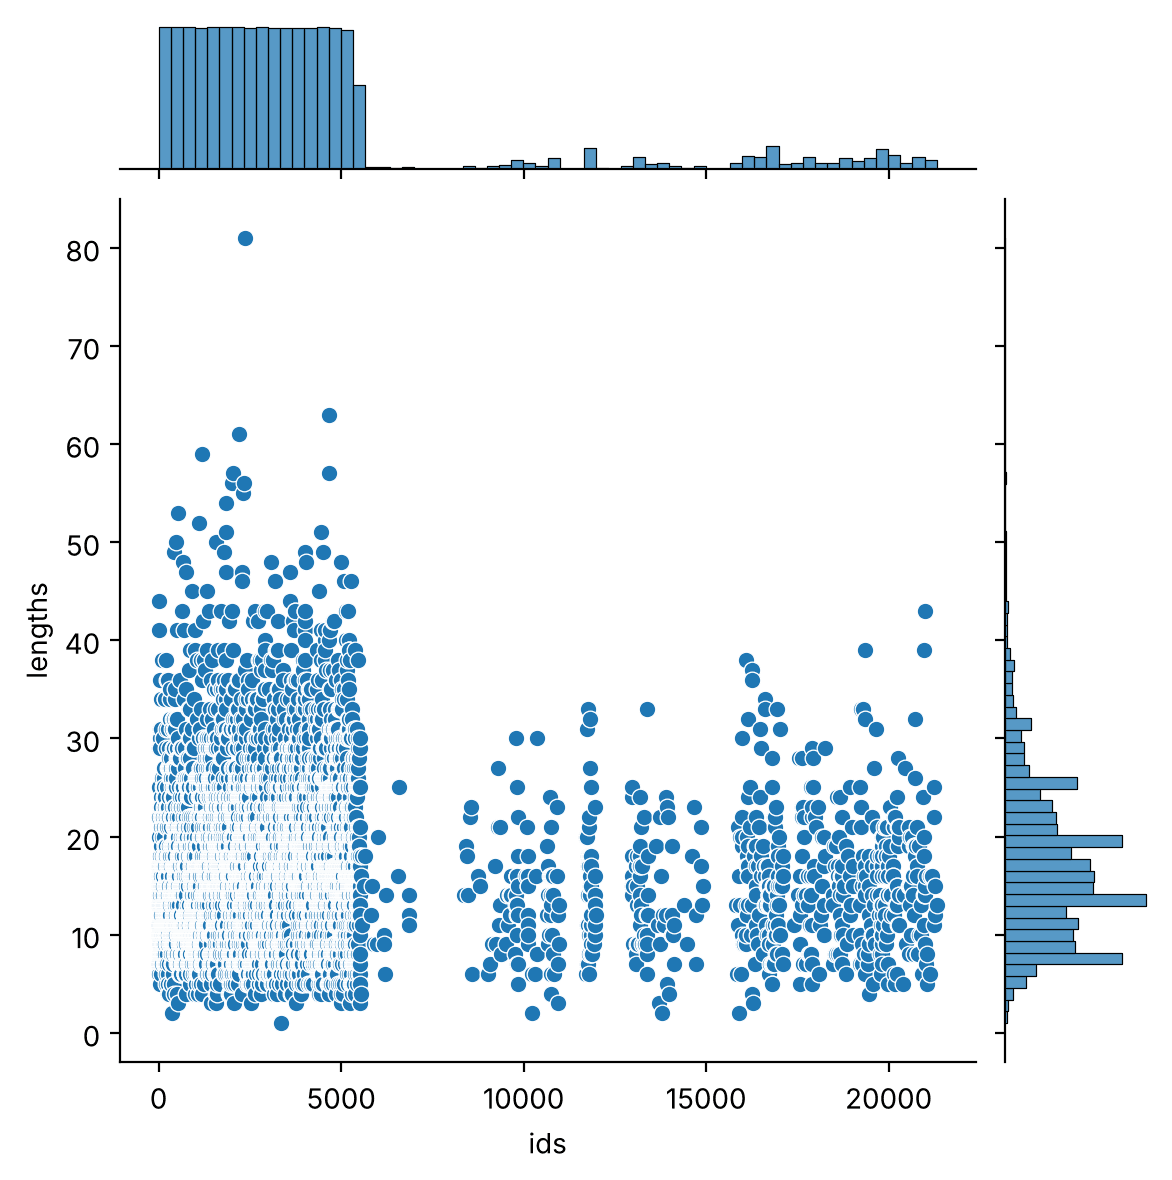
Le graphique ci-dessus montre qu’il n’y a pas de corrélation réelle entre les deux variables : la valeur de r² est faible (r ≈ -0,05 et r² ≈ 0,002).
Comment dessiner une carte des aéroports avec Cartopy et folium ?
Nos données se prêtent naturellement à la cartographie : nous avons des paires de latitude et de longitude pour les aéroports, ainsi que pour les points de départ et de destination.
La première carte montre les aéroports du monde entier. Nous la réalisons avec Cartopy, une bibliothèque qui s’intègre à Matplotlib pour dessiner des cartes du monde et y ajouter des points, tout en étant très personnalisable.
Mise à jour : dans la version d’origine, nous utilisions l’extension Basemap de Matplotlib, qui n’est plus maintenue. Cartopy la remplace pour les nouveaux projets.
import cartopy.crs as ccrs
import cartopy.feature as cfeature

airports["longitude"] = airports["longitude"].astype(float)
airports["latitude"] = airports["latitude"].astype(float)

fig = plt.figure(figsize=(14, 7))
ax = plt.axes(projection=ccrs.Mercator(min_latitude=-80, max_latitude=80))
ax.set_extent([-180, 180, -58, 80], crs=ccrs.PlateCarree())
ax.add_feature(cfeature.LAND, facecolor="#eeeeee")
ax.add_feature(cfeature.COASTLINE, linewidth=0.5)

ax.scatter(airports["longitude"], airports["latitude"], s=2, color="red", transform=ccrs.PlateCarree())
plt.show()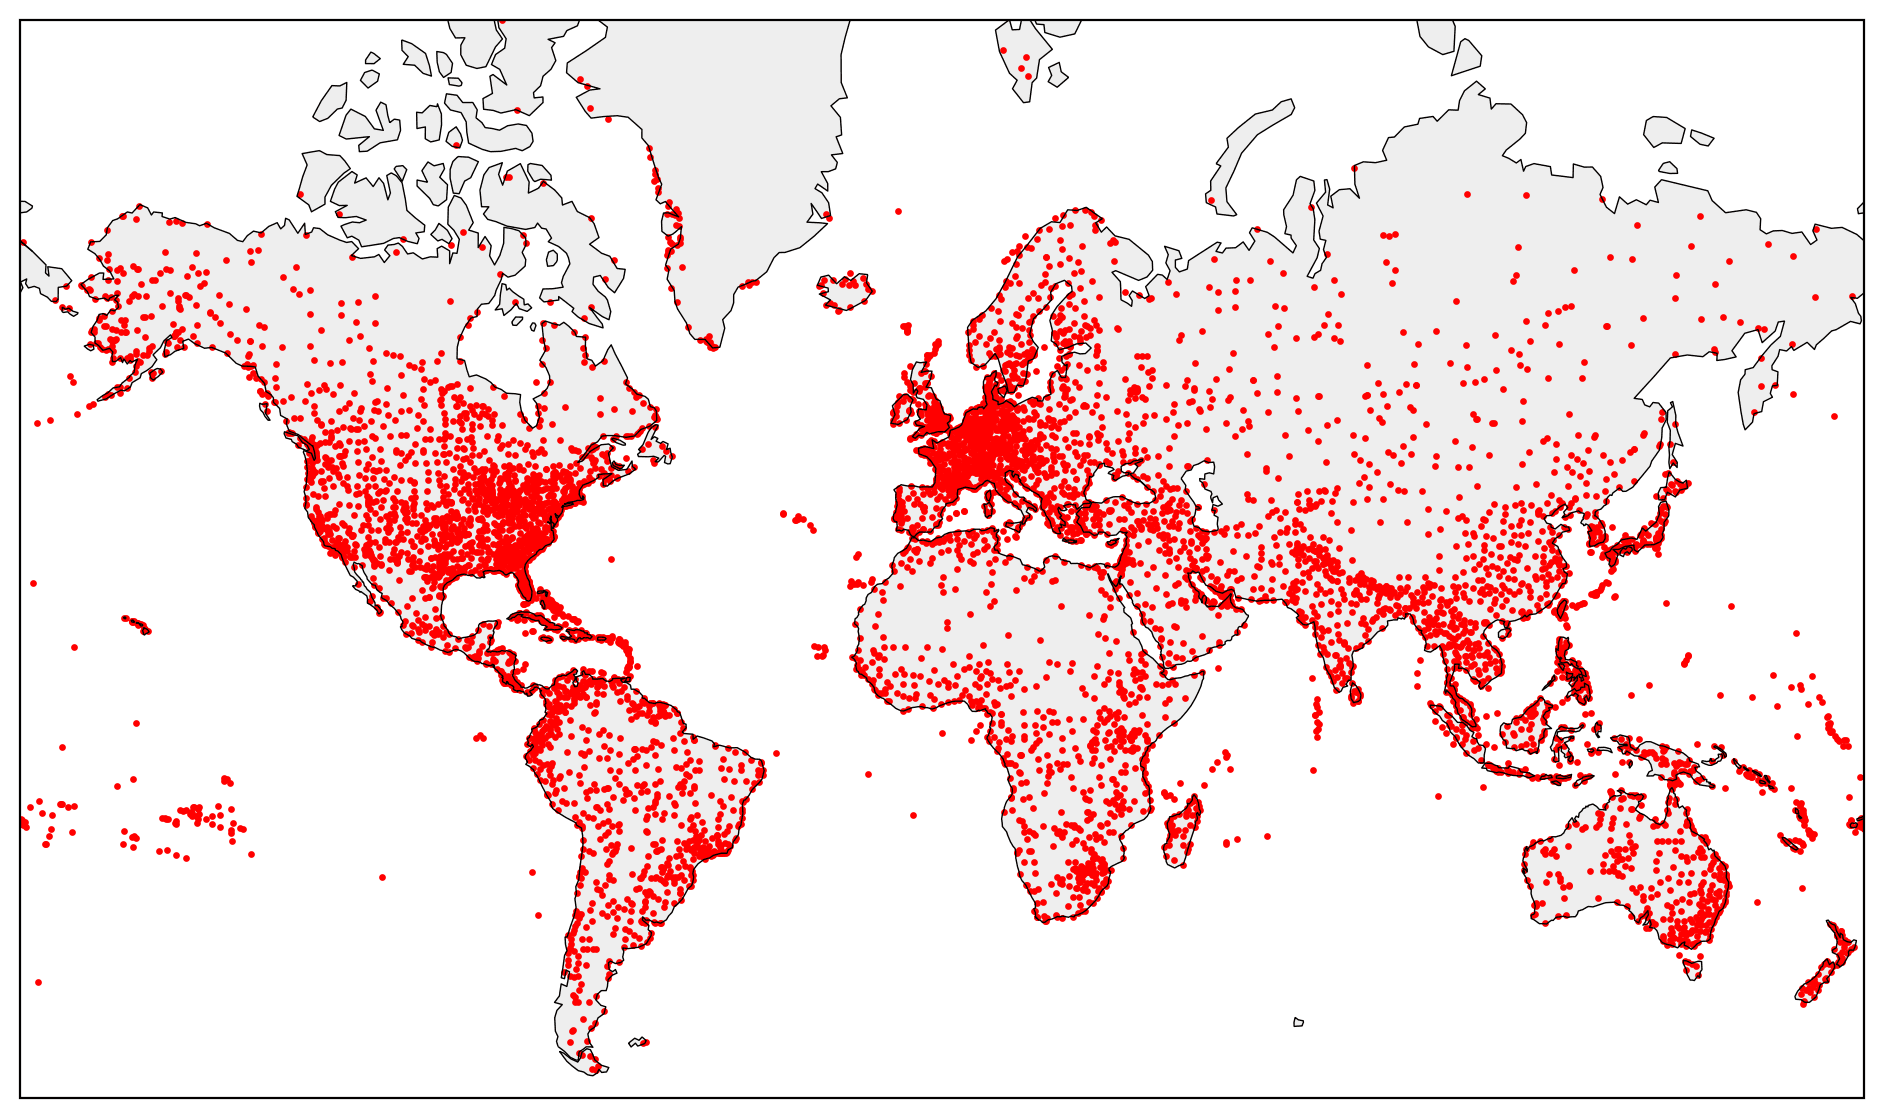
Dans le code ci-dessus, nous dessinons d’abord une carte du monde avec une projection de Mercator, une façon de projeter toute la carte du monde sur une surface 2D. Puis nous dessinons les aéroports sur la carte avec des points rouges.
Le problème de cette carte est qu’il est difficile de voir où se trouve chaque aéroport : dans les zones à forte densité, les points se fondent en une masse rouge.
Comme avec Bokeh, il existe une bibliothèque de cartographie interactive, folium, que nous pouvons utiliser pour zoomer sur la carte et trouver des aéroports individuels.
import folium

# Obtenir une carte du monde basique
airports_map = folium.Map(location=[30, 0], zoom_start=2)

# Dessiner des marqueurs sur la carte
for name, row in airports.iterrows():
    # problème avec cet aéroport sur la carte, on le supprime
    if row["name"] != "South Pole Station":
        folium.CircleMarker(location=[float(row["latitude"]), float(row["longitude"])],
                            popup=row["name"]).add_to(airports_map)

# Créer et afficher la carte
airports_map.save("airports.html")
airports_map
Folium utilise leaflet.js pour créer une carte entièrement interactive. Tu peux cliquer sur chaque aéroport pour voir son nom dans une fenêtre contextuelle.
Une capture d’écran est montrée ci-dessus, mais la carte réelle est beaucoup plus impressionnante. Folium permet aussi de modifier assez largement les options pour créer de meilleurs marqueurs ou ajouter d’autres éléments à la carte.
Comment dessiner les routes aériennes avec de grands cercles ?
Ce qui serait vraiment cool, c’est de voir toutes les routes aériennes sur une carte. Heureusement, nous pouvons utiliser Cartopy pour cela.
Nous dessinons de grands cercles (orthodromies) reliant les aéroports de départ et de destination : chaque cercle montre l’itinéraire d’un avion de ligne. Il y a malheureusement tellement de routes que toutes les montrer ferait une sacrée pagaille. Nous allons donc afficher les 3000 premières routes.
fig = plt.figure(figsize=(14, 7))
ax = plt.axes(projection=ccrs.Mercator(min_latitude=-80, max_latitude=80))
ax.set_extent([-180, 180, -58, 80], crs=ccrs.PlateCarree())
ax.add_feature(cfeature.LAND, facecolor="#eeeeee")
ax.add_feature(cfeature.COASTLINE, linewidth=0.5)

airports_idx = airports.set_index("id")

# On ne dessine que les 3000 premières routes
for _, row in routes.head(3000).iterrows():
    try:
        source = airports_idx.loc[row["source_id"]]
        dest = airports_idx.loc[row["dest_id"]]
    except KeyError:
        continue
    # Filtre : on évite les routes trop longues, qui masqueraient les autres
    if abs(source["longitude"] - dest["longitude"]) < 90:
        ax.plot([source["longitude"], dest["longitude"]], [source["latitude"], dest["latitude"]],
                color="b", linewidth=0.3, transform=ccrs.Geodetic())
plt.show()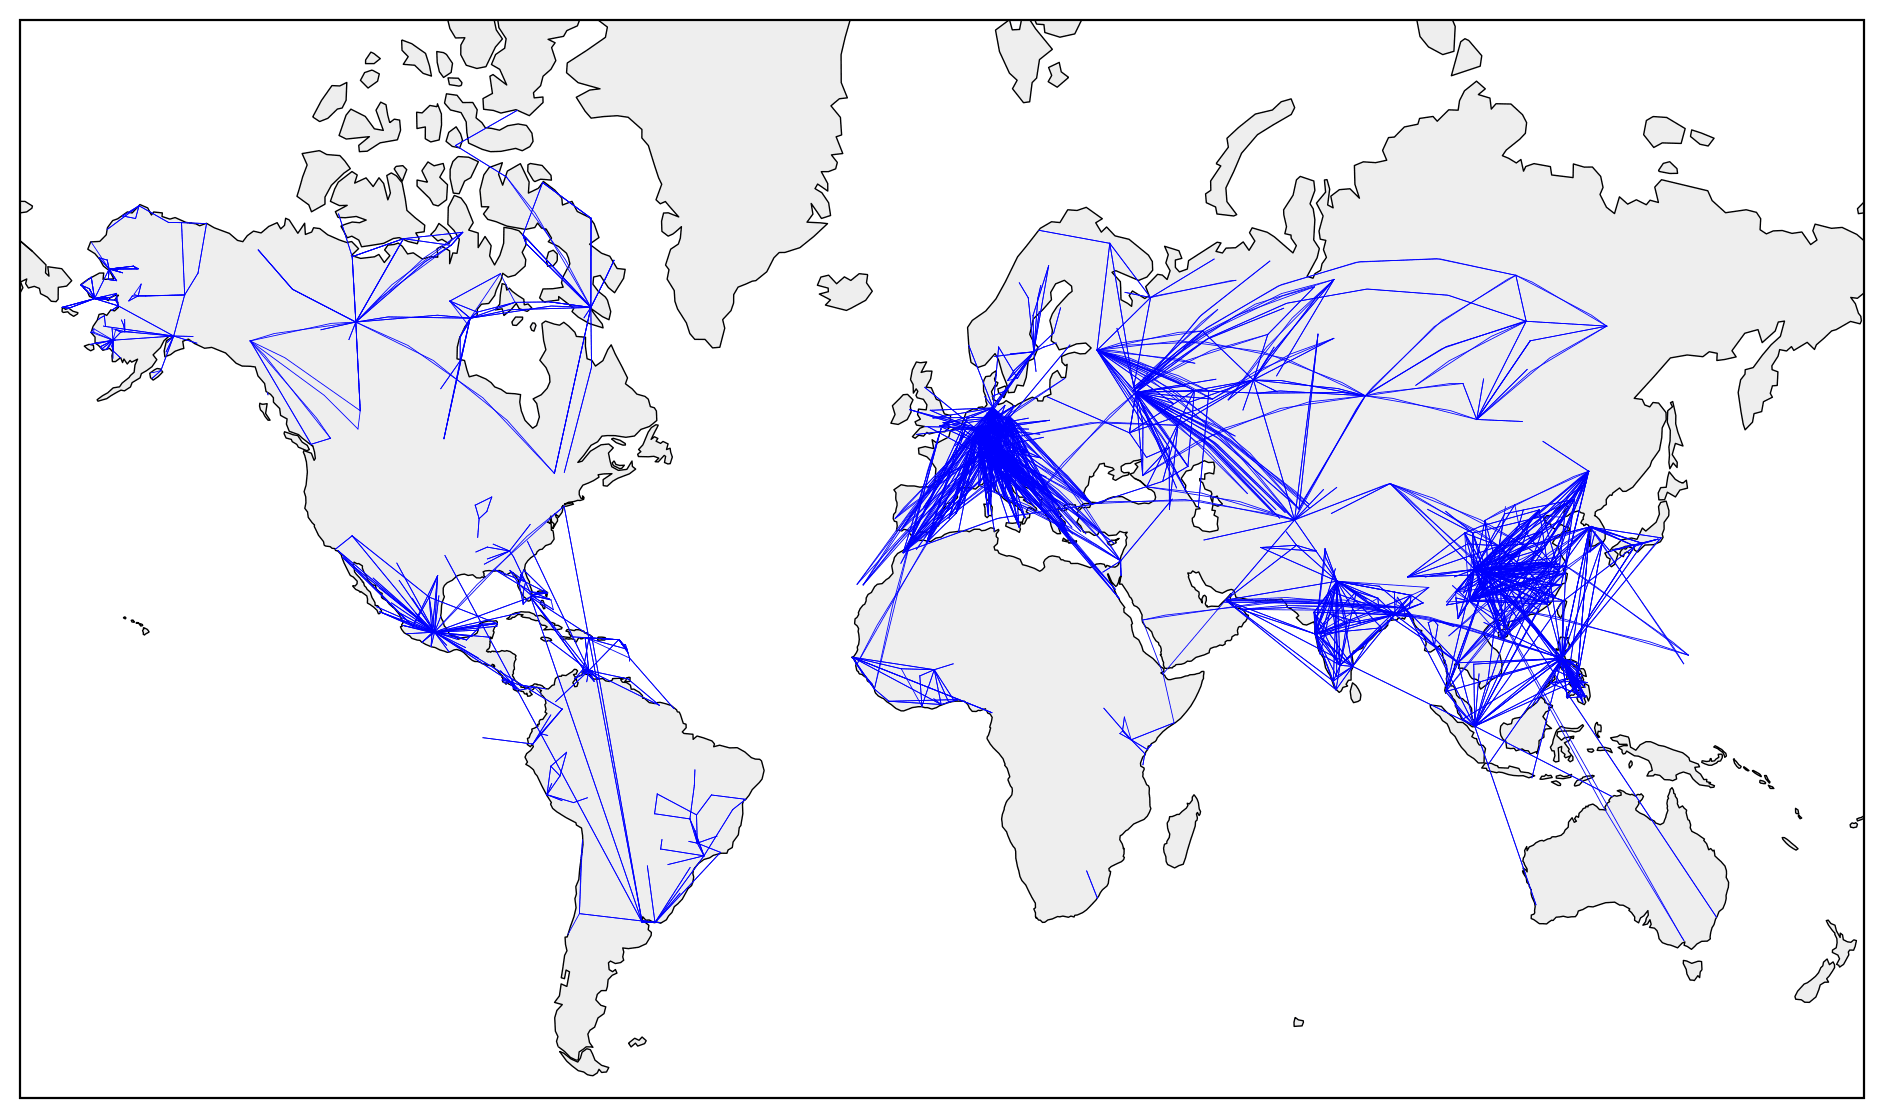
Le code ci-dessus dessine une carte, puis les routes par-dessus. Nous ajoutons des filtres pour éviter que les routes trop longues n’obscurcissent les autres.
Comment dessiner un diagramme de réseau avec networkx ?
La dernière exploration est un diagramme de réseau des aéroports. Chaque aéroport est un nœud du réseau, et nous traçons une liaison entre deux nœuds s’il existe une route entre les aéroports.
S’il y a plusieurs routes, nous ajoutons un poids à la liaison pour montrer que les aéroports sont plus connectés. Nous utilisons la bibliothèque networkx pour cela.
Tout d’abord, nous devons calculer les poids entre les aéroports :
# Initialisation du dictionnaire weights contenant les poids
weights = {}
# On garde une trace des clés qui ont été ajoutées une fois.
# Nous voulons seulement des liaisons avec un poids de plus de 1 pour garder une taille de réseau gérable.
added_keys = set()

# Itérer sur chaque itinéraire
for name, row in routes.iterrows():
    # Extraire les ids de source et dest des aéroports
    source = row["source_id"]
    dest = row["dest_id"]

    # Créer une clé pour le dictionnaire weights : elle correspond à une liaison (départ_arrivée)
    key = "{0}_{1}".format(source, dest)
    # Si la clé est déjà présente dans weights, incrémenter le poids
    if key in weights:
        weights[key] += 1
    # Si la clé est présente dans added_keys, initialiser la clé dans weights avec un poids de 2
    elif key in added_keys:
        weights[key] = 2
    # Si la clé n'est pas encore dans added_keys, on l'ajoute.
    # Cela nous assure de ne pas ajouter de liaisons avec un poids de 1
    else:
        added_keys.add(key)

len(weights)16381Une fois le code ci-dessus exécuté, le dictionnaire des poids contient toutes les liaisons desservies par au moins 2 routes : nous obtenons 16 381 liaisons. Les liaisons à une seule route sont écartées pour garder un réseau lisible.
Maintenant, traçons le graphique !
import networkx as nx

# Importer networkx et initialiser le graphe
graph = nx.Graph()
# On garde une trace des nœuds ajoutés dans cet ensemble pour ne pas les ajouter 2 fois
nodes = set()

# Itérer sur chaque liaison
for k, weight in weights.items():
    try:
        # Séparer les ids de source et dest et les convertir en entier
        source, dest = k.split("_")
        source, dest = [int(source), int(dest)]

        # Ajouter source et dest s'ils ne sont pas déjà dans le graphe
        if source not in nodes:
            graph.add_node(source)
        if dest not in nodes:
            graph.add_node(dest)

        # Ajouter à la fois source et dest à l'ensemble nodes (un ensemble n'autorise pas les doublons)
        nodes.add(source)
        nodes.add(dest)

        # Ajouter la liaison au graphe
        graph.add_edge(source, dest, weight=weight)
    except (ValueError, IndexError):
        pass

# Positions des nœuds (la graine seed rend le dessin reproductible)
pos = nx.spring_layout(graph, seed=42)

# Dessiner les nœuds et les liaisons
plt.figure(figsize=(8, 6))
nx.draw_networkx_nodes(graph, pos, node_color="red", node_size=10, alpha=0.8)
nx.draw_networkx_edges(graph, pos, width=1.0, alpha=1)

# Afficher le graphique
plt.show()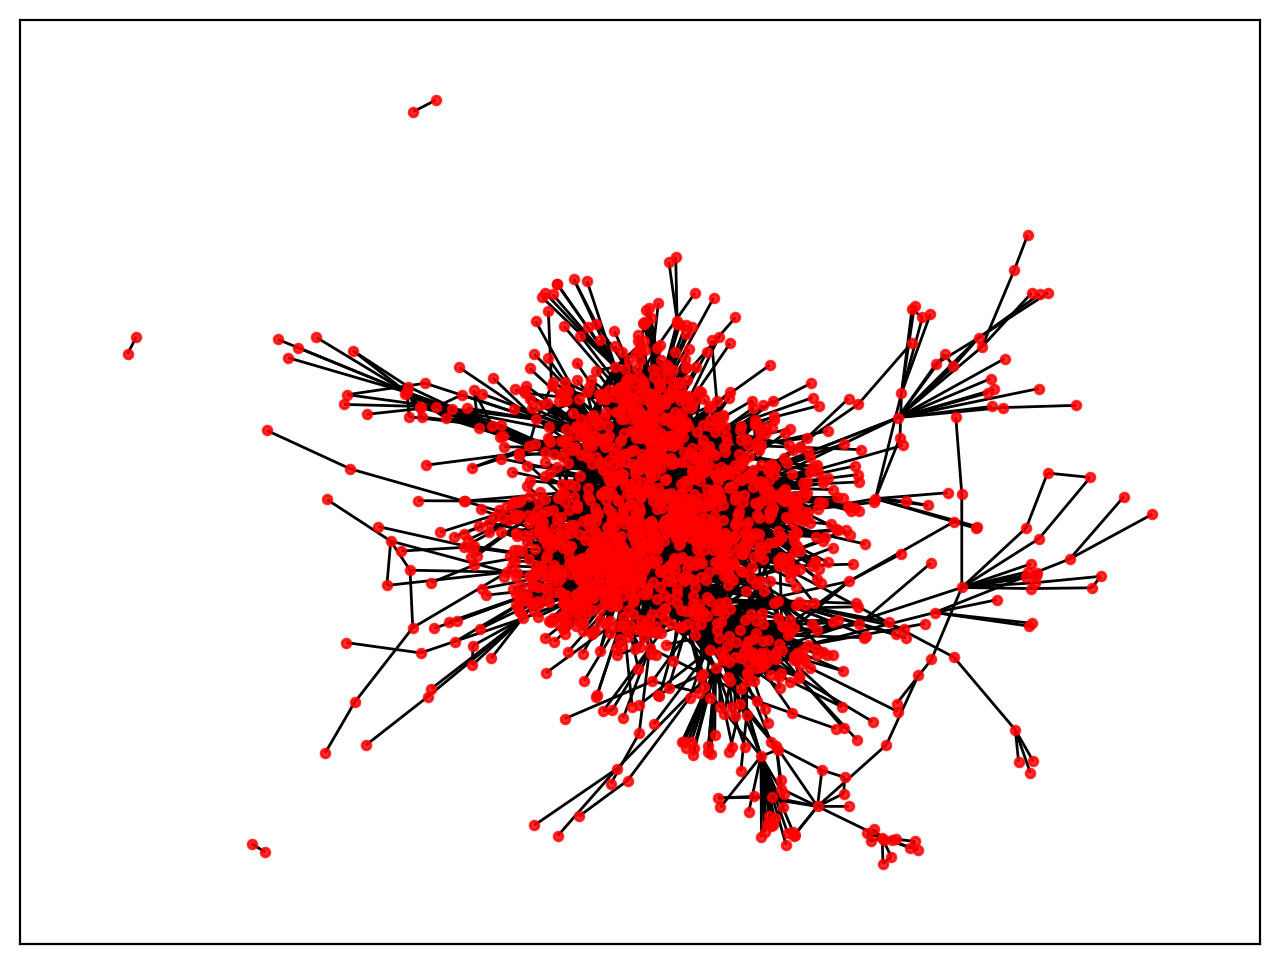
Pour pratiquer la visualisation de données en Python, le parcours Analyse et visualisation des données de DataXp te fait pratiquer sur des exercices corrigés, avec un coach IA qui t’aide quand tu bloques. Les premiers modules sont gratuits.
Questions fréquentes sur la visualisation de données avec Python
Quelle bibliothèque Python choisir pour la visualisation de données ?
Cela dépend du besoin : Matplotlib pour presque tout type de graphique (au prix de plus de code), Seaborn pour des graphiques statistiques plus jolis par défaut, Bokeh pour des graphiques interactifs dans le navigateur, folium pour des cartes interactives, pygal pour des graphiques SVG soignés et networkx pour des graphes et des réseaux.
Quelle différence entre Matplotlib et Seaborn ?
Matplotlib est une bibliothèque assez basique et très flexible : il faut généralement plus de commandes pour faire des graphiques attrayants. Seaborn s’appuie sur Matplotlib, simplifie certains graphiques statistiques et est esthétiquement plus agréable par défaut.
Que remplace distplot dans les versions récentes de Seaborn ?
distplot est déprécié depuis Seaborn 0.11. Dans une version récente, utilise histplot(..., kde=True) ou displot pour tracer un histogramme avec une estimation de densité de noyau (KDE).
Comment rendre un graphique ou une carte interactif en Python ?
Avec Bokeh pour un graphique zoomable (c’est un widget JavaScript, pas une image) et avec folium pour une carte interactive qui utilise leaflet.js : tu peux cliquer sur chaque point pour voir son nom.
Basemap est-il encore maintenu ?
Non. Basemap n’est plus maintenu : pour de nouveaux projets, l’article recommande Cartopy.
Conclusion
Ces dernières années, les bibliothèques Python de visualisation de données se sont multipliées. Il est maintenant possible de faire presque n’importe quel type de visualisation.
La plupart de ces bibliothèques s’appuient sur Matplotlib et simplifient certains cas d’utilisation. Si tu veux approfondir la bibliothèque de base, consulte notre guide complet sur Matplotlib.
Pour aller plus loin avec Python, consulte aussi notre guide des 21 astuces et concepts Python pour améliorer ton code.