De la voiture autonome à la reconnaissance faciale sur Facebook, la Data Science a attiré la lumière. Les Data Scientists sont ainsi devenus extrêmement recherchés, et pour une bonne raison : un Data Scientist qualifié peut ajouter une valeur incroyable à une entreprise.
Mais un Data Scientist n’est rien sans les données auxquelles il a accès. La plupart des entreprises stockent leurs données dans divers formats : dans des bases de données ou dans des fichiers texte.
C’est ici qu’interviennent les Data Engineers : ils construisent des pipelines qui transforment ces données en formats utilisables par les Data Scientists.
Les Data Engineers sont tout aussi importants que les Data Scientists, mais ils ont tendance à rester des travailleurs de l’ombre, parce qu’ils sont plus éloignés du produit final qu’est l’analyse des données.
Une bonne analogie est celle de l’écurie de F1 et du pilote de F1. Le pilote a l’adrénaline de la vitesse, puis le frisson de la victoire devant son public. Le constructeur, lui, a la lourde tâche (et le plaisir) de régler les moteurs, d’expérimenter différentes configurations d’échappement et de créer une voiture puissante et robuste, meilleure que celles des concurrents.
Si tu aimes construire et peaufiner des systèmes, la Data Engineering est faite pour toi.
Dans cet article, nous allons explorer le rôle d’un data engineer, son quotidien et les compétences requises pour ce poste.
En bref : un Data Engineer transforme les données en un format utile pour l’analyse : il construit les pipelines (ingestion, processing, storage, access) qui alimentent les Data Scientists. Il doit être bon en architecture de systèmes distribués, en création de pipelines fiables, en combinaison de sources de données et en architecture de bases de données. Selon la taille de l’entreprise, il est généraliste, spécialiste de pipeline ou spécialiste des bases de données.
Quel est le rôle d’un Data Engineer ?
Le domaine de la Data Science est très vaste : il englobe tout, du nettoyage des données au déploiement de modèles prédictifs. Il est pourtant rare qu’un seul spécialiste couvre l’ensemble du spectre. Les spécialistes des données se concentrent généralement sur quelques domaines et sont complétés par une équipe d’autres scientifiques et analystes.
La Data Engineering est elle aussi un vaste domaine, et chaque Data Engineer n’a pas besoin de posséder toutes les compétences.
Nous allons d’abord esquisser les grandes lignes de la Data Engineering, puis parcourir plus concrètement le rôle d’un Data Engineer à travers des exemples précis.
Un Data Engineer transforme les données en un format utile pour l’analyse.
Imagine que tu es Data Engineer sur un concurrent simple d’Uber. Tes utilisateurs ont une application sur leur appareil, grâce à laquelle ils accèdent à ton service. Ils demandent un trajet vers une destination via l’application, la demande est acheminée vers un chauffeur qui les récupère et les dépose. Après le trajet, ils sont facturés et peuvent évaluer leur chauffeur.
Pour faire fonctionner un service comme celui-ci, tu as besoin de :
- Une application mobile pour les utilisateurs ;
- Une application mobile pour les chauffeurs ;
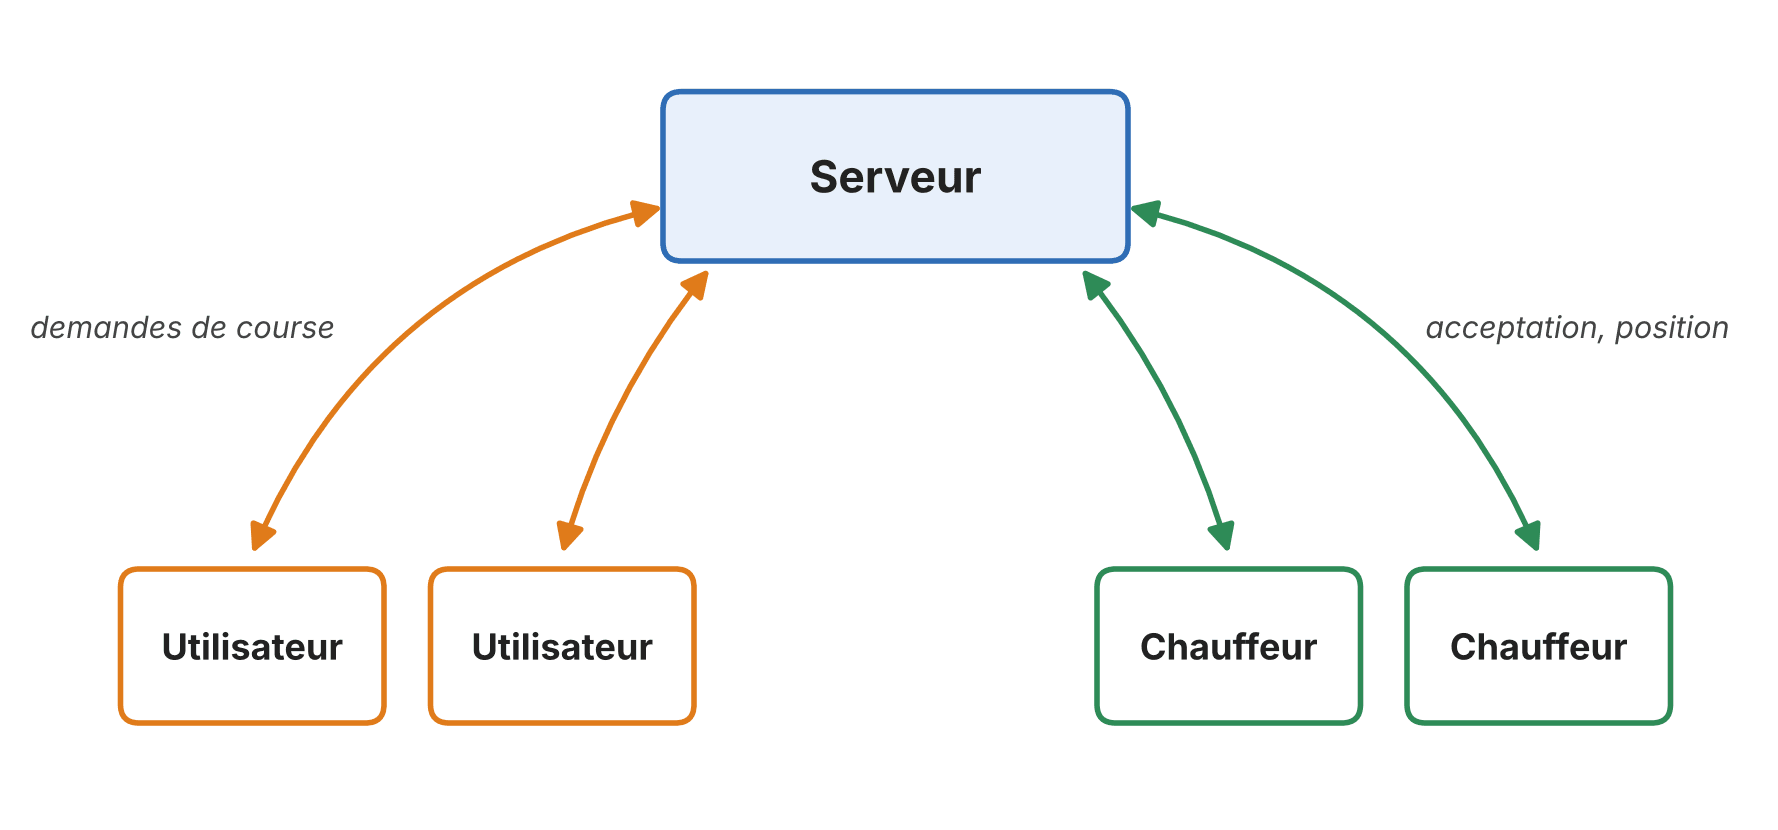
- Un serveur qui peut transmettre les demandes des utilisateurs aux chauffeurs et gérer d’autres détails, comme la mise à jour des informations de paiement
Voici un diagramme montrant la communication :
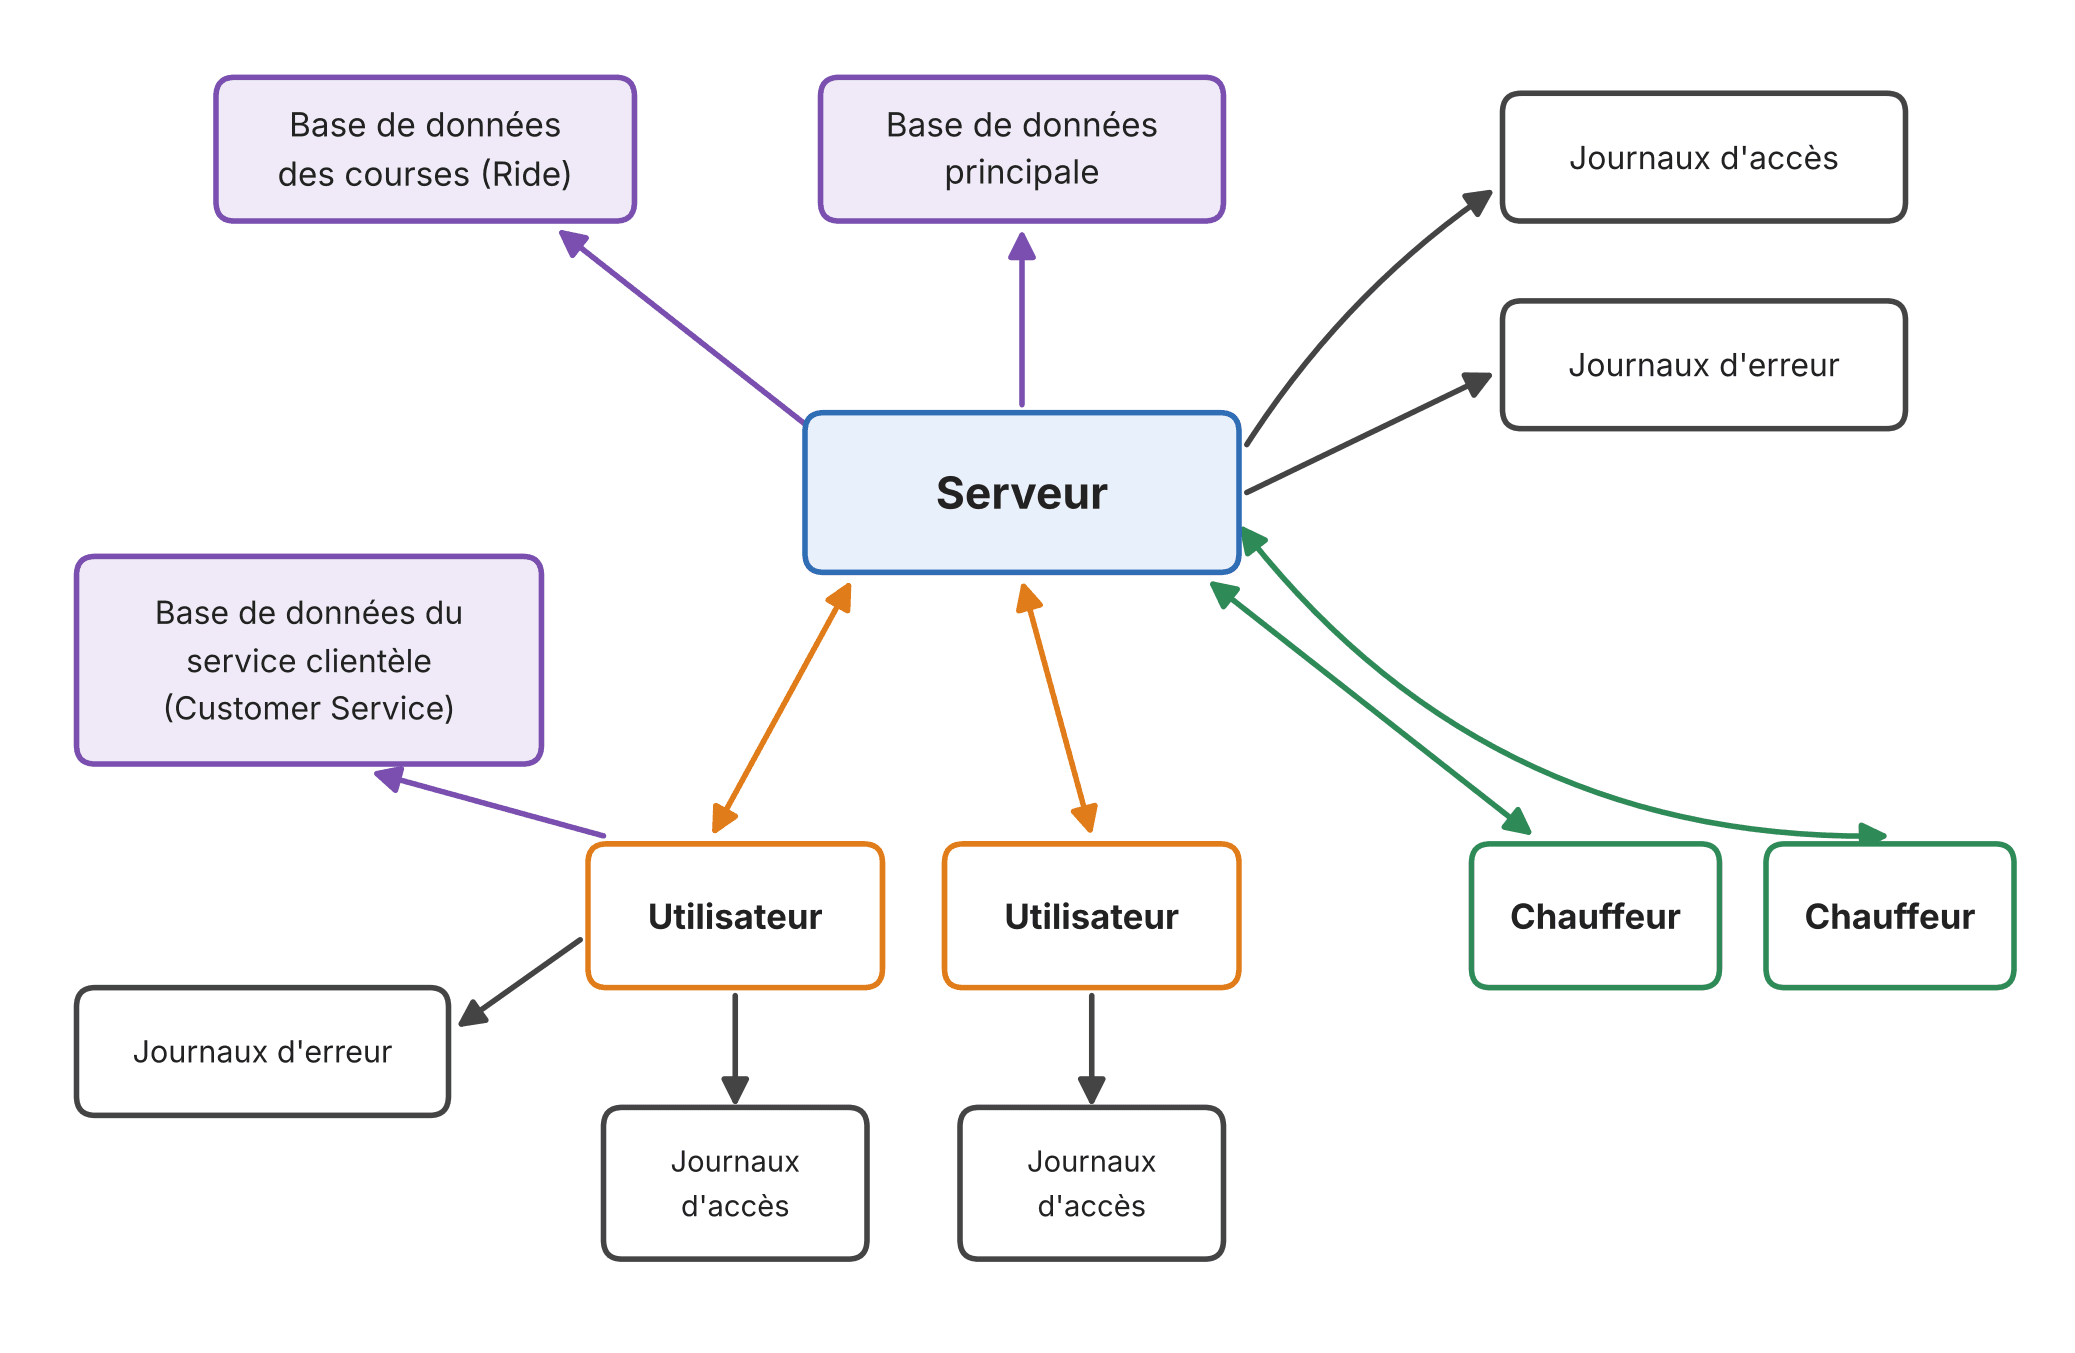
Comme tu peux t’y attendre, ce type de système génère d’énormes quantités de données. Tu auras plusieurs sources de stockage :
- La base de données principale de ton application. Elle contient les informations sur les utilisateurs et les chauffeurs.
- Les journaux (logs) du serveur :
- journaux d’accès : une ligne par demande faite au serveur à partir de l’application ;
- journaux d’erreur : toutes les erreurs côté serveur générées par ton application.
- Les journaux (logs) des applications :
- journaux d’événements : les actions que les utilisateurs et les chauffeurs ont réalisées dans l’application. Par exemple, un événement est enregistré lorsqu’ils cliquent sur un bouton ou mettent à jour leurs informations de paiement ;
- journaux d’erreur : les erreurs rencontrées dans l’application.
- La base de données des courses (Ride). Elle contient les informations sur une course unique pour une paire utilisateur / chauffeur, ainsi que l’état de la course.
- La base de données du service clientèle (Customer Service). Elle contient les interactions des clients avec les agents du service clientèle, et peut inclure des transcriptions vocales et des e-mails.
Voici le diagramme mis à jour montrant les sources de données :
Imaginons qu’un spécialiste des données veuille analyser l’historique des actions d’un utilisateur dans ton service, et voir quelles actions sont corrélées avec les utilisateurs qui dépensent le plus. Pour lui permettre de le faire, tu dois combiner les informations des journaux d’accès au serveur et des journaux d’événements de l’application.
Tu auras besoin de :
- Regrouper régulièrement les journaux d’analyse de l’application à partir des appareils des utilisateurs ;
- Combiner ces journaux avec les entrées du journal du serveur qui référencent l’utilisateur ;
- Créer un point de terminaison (endpoint) d’API qui renvoie l’historique des événements de n’importe quel utilisateur.
Pour cela, tu dois créer un pipeline capable d’ingérer en temps réel les journaux des applications mobiles et ceux du serveur, de les analyser et de les associer à un utilisateur précis. Tu stockes ensuite les journaux analysés dans une base de données, pour que l’API puisse les interroger facilement.
Tu devras aussi lancer plusieurs serveurs derrière un équilibreur de charge (load balancer, qui répartit le travail entre plusieurs serveurs) pour traiter les journaux entrants.
La plupart des problèmes que tu rencontreras concerneront la fiabilité et les systèmes distribués. Par exemple, si des millions d’appareils envoient des journaux et que le nombre de demandes varie (une tonne de journaux le matin, beaucoup moins à minuit), il te faut un système capable d’augmenter automatiquement le nombre de serveurs quand c’est nécessaire (auto scaling).
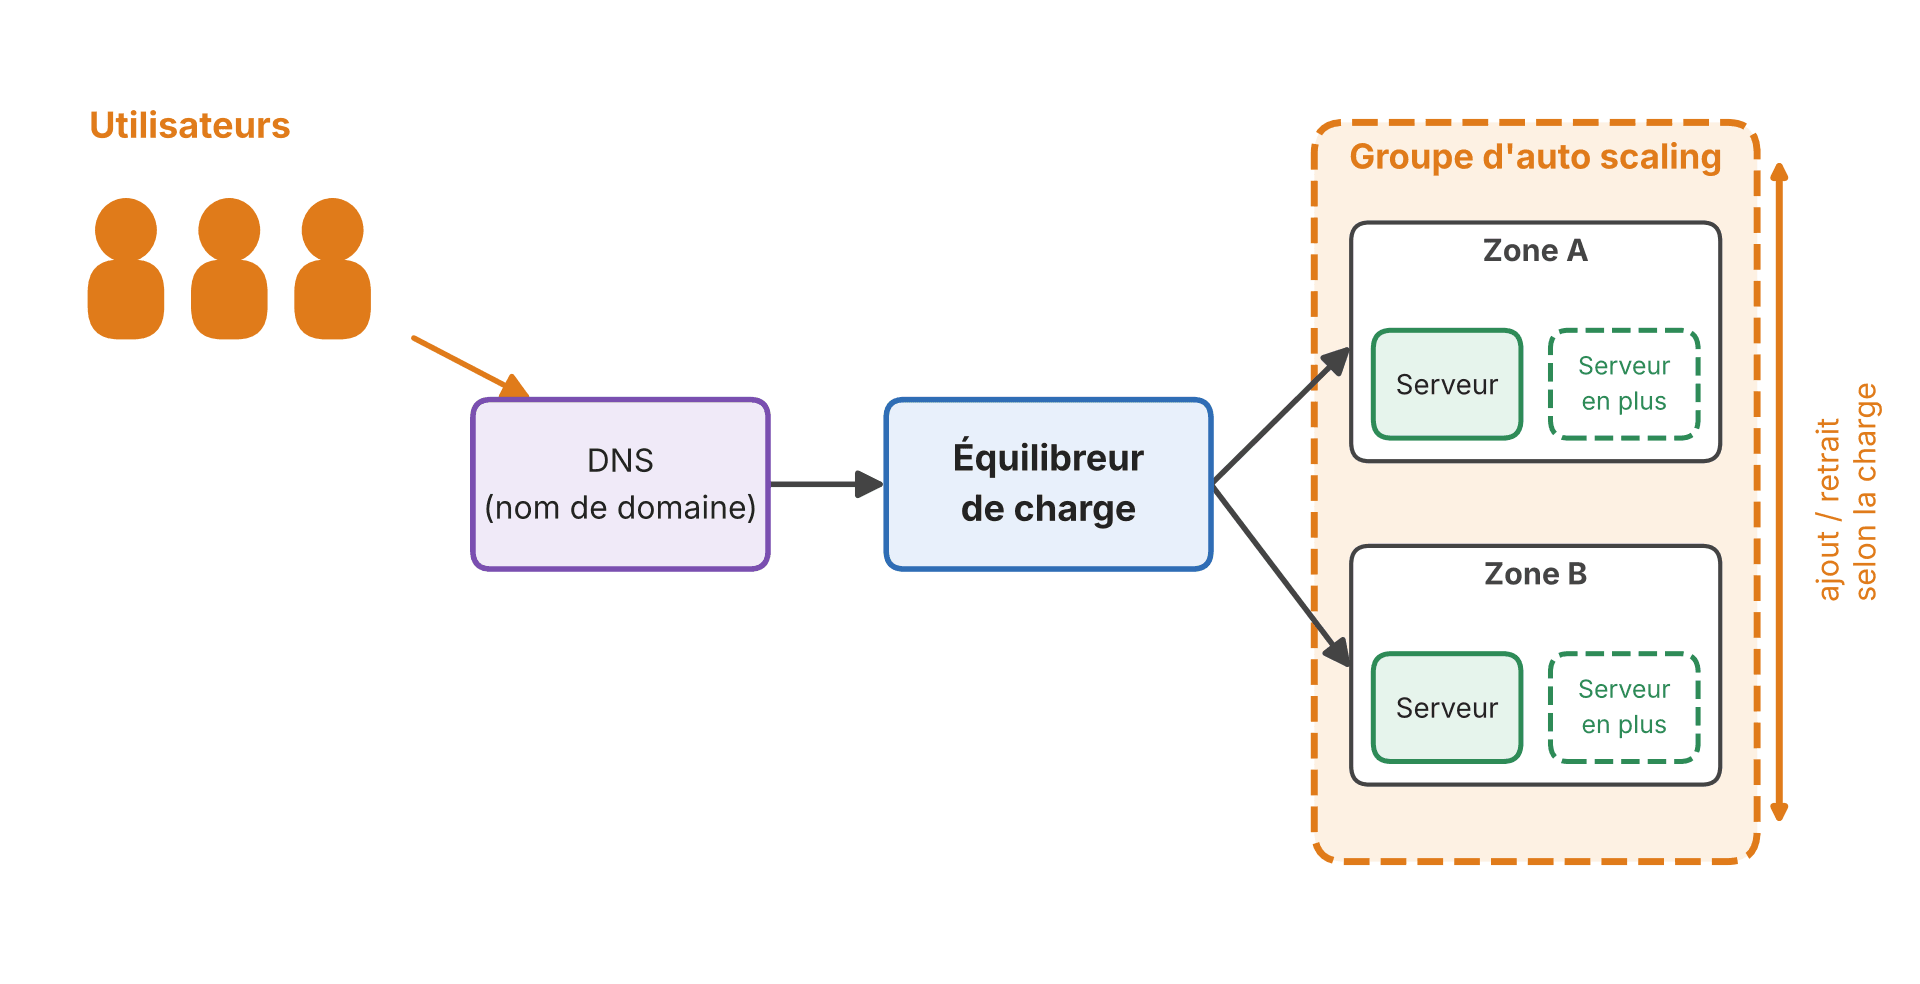
Ici, les serveurs s’exécutent derrière un équilibreur de charge. Ils sont enregistrés auprès de lui, et il leur envoie du trafic en fonction de leur niveau d’activité. Les serveurs peuvent ainsi être ajoutés ou supprimés au besoin.
En gros, les opérations d’un pipeline de données se composent de quatre phases :
- Ingestion : rassembler les données nécessaires ;
- Processing : traiter les données pour obtenir les résultats finaux souhaités ;
- Storage : stocker les résultats finaux pour une récupération rapide ;
- Access : permettre à un outil ou à un utilisateur d’accéder aux résultats finaux du pipeline.
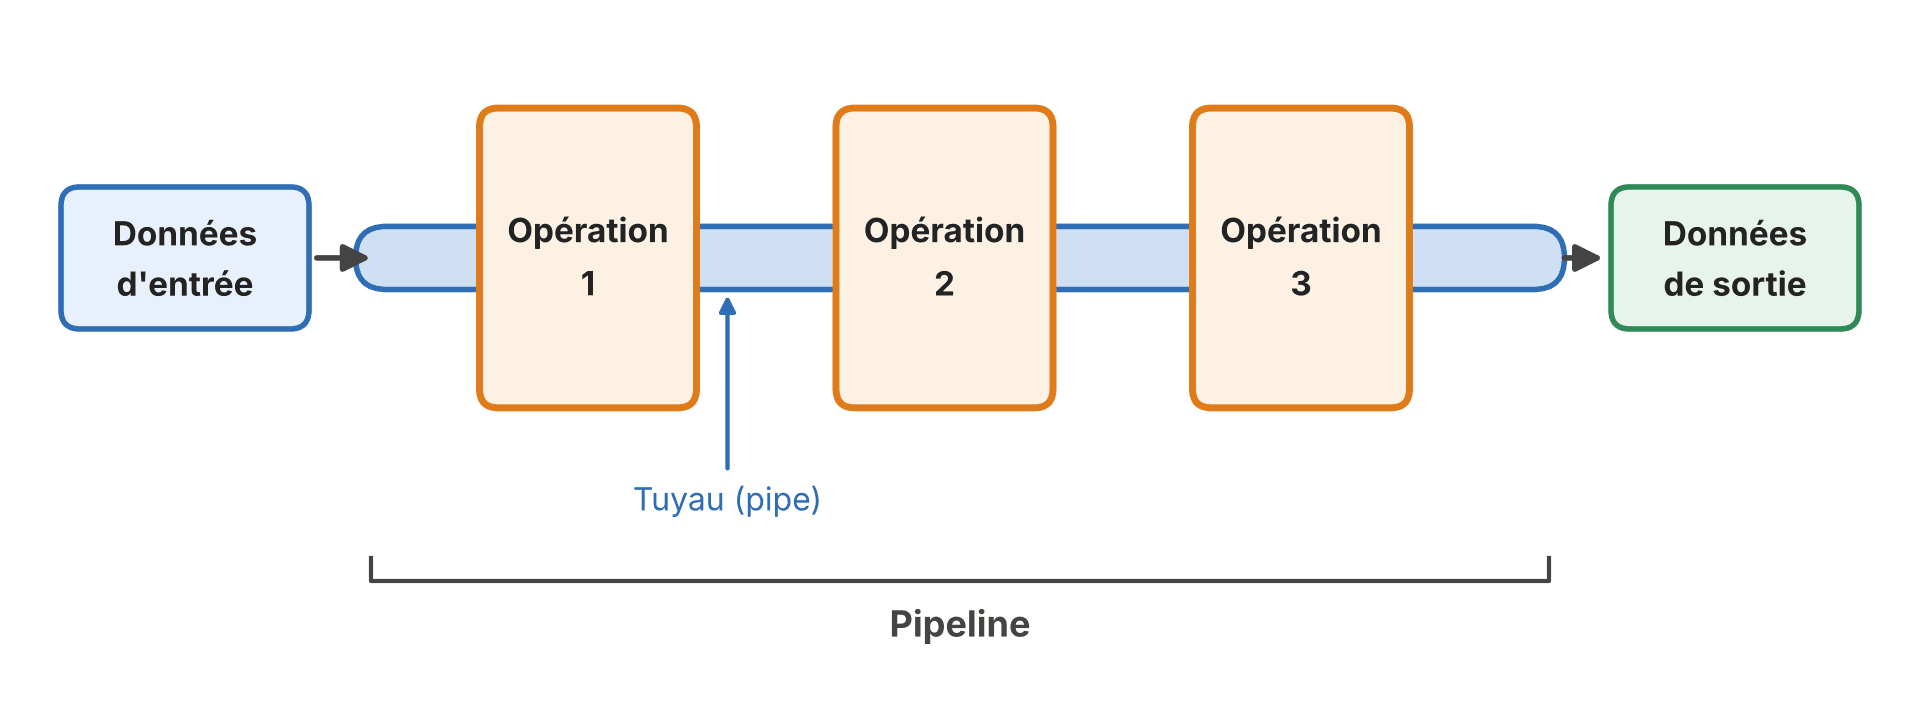
Un pipeline de données : les données d’entrée sont transformées par une série de phases en données de sortie.
Comment trouver les courses de mauvaise qualité ? Un exemple plus complexe
Pour un exemple plus complexe, imagine qu’un Data Scientist veuille créer un système qui trouve toutes les courses terminées prématurément à cause de problèmes d’application ou de chauffeur. Une façon d’y parvenir est de regarder dans la base de données du service clientèle quelles courses se sont terminées avec des problèmes, puis d’analyser leurs journaux avec les données de la course.
Avant de pouvoir le faire, le Data Scientist a besoin d’un moyen de faire correspondre les messages de la base de données du service clientèle avec des courses précises.
En tant que Data Engineer, tu dois donc créer un point de terminaison d’API qui lui permet d’interroger tous les messages du service client relatifs à une course particulière.
Pour cela, tu devras :
- Créer un système qui extrait les données de la base des courses et calcule des informations sur chaque course, comme sa durée et la correspondance entre la destination et la demande initiale de l’utilisateur ;
- Combiner ces statistiques avec les informations de l’utilisateur, comme son nom et son identifiant ;
- Extraire les informations d’erreur des journaux de l’application et du serveur concernant l’utilisateur pendant la course ;
- Trouver toutes les requêtes de service client d’un utilisateur ;
- Créer une heuristique pour faire correspondre les courses et les requêtes du service client (exemple simple : une requête de service client porte toujours sur la course précédente) ;
- Stocker les valeurs nécessaires pour que l’API reste rapide, même quand le volume augmente ;
- Créer une API qui renvoie tous les messages de service client liés à une course particulière.
Un Data Engineer qualifié sait construire un pipeline qui exécute chacune de ces étapes chaque fois qu’une nouvelle course est ajoutée. Cela garantit que les données fournies par l’API sont toujours à jour, et que toute analyse du Data Scientist est valide.
Quelles compétences faut-il pour être Data Engineer ?
Un Data Engineer doit être bon en :
- architecture des systèmes distribués ;
- création de pipelines fiables ;
- combinaison de sources de données ;
- architecture des bases de données ;
- collaboration avec les équipes de Data Scientists, pour construire les bonnes solutions.
Note que nous n’avons mentionné aucun outil ci-dessus. Des outils comme Hadoop et Apache Spark, ou des langages comme Scala et Python, sont importants pour la Data Engineering. Mais il est plus important de bien comprendre les concepts et de savoir construire des systèmes réels.
Quels sont les différents types de Data Engineer ?
Même si les Data Engineers doivent posséder les compétences énumérées ci-dessus, leur travail quotidien varie selon le type d’entreprise.
De manière générale, on peut les classer en trois catégories :
- généraliste ;
- spécialiste de pipeline ;
- spécialiste des bases de données.
Passons en revue chacune de ces catégories :
Que fait un Data Engineer généraliste ?
Un Data Engineer généraliste travaille généralement dans une petite équipe. Sans lui, les Data Analysts et les Data Scientists n’ont rien à analyser : il est l’élément fondateur de l’équipe.
Quand un Data Engineer est la seule personne orientée data dans une entreprise, il finit généralement par faire le travail de bout en bout, du rassemblement des données à leur traitement, puis à l’analyse finale.
Cela demande plus de compétences en Data Science que pour la plupart des Data Engineers, mais moins de connaissances en architecture de systèmes : dans de petites structures, l’ingénierie des données n’est pas aussi déterminante.
C’est un bon rôle pour un Data Scientist qui veut faire la transition vers la Data Engineering.
Tant que notre modèle d’Uber reste petit, un Data Engineer pourrait par exemple créer un tableau de bord indiquant le nombre de courses effectuées chaque jour du mois passé, avec une prévision pour le mois suivant.
Que fait un spécialiste de pipeline ?
Les Data Engineers spécialistes de pipeline sont surtout nécessaires dans les entreprises de taille moyenne, qui ont des besoins complexes en data science. Ils travaillent avec des équipes de spécialistes des données pour transformer les données en un format utile à l’analyse, ce qui demande une connaissance approfondie des systèmes distribués et de l’informatique en général.
Quand notre modèle Uber grandit, on pourrait demander à un spécialiste de pipeline de créer un outil permettant aux spécialistes des données d’interroger les métadonnées des courses, pour les utiliser dans un algorithme prédictif.
Que fait un spécialiste des bases de données ?
Un Data Engineer spécialiste des bases de données se concentre sur la configuration et le remplissage des bases de données analytiques. Cela implique un peu de travail sur les pipelines, mais surtout l’optimisation des bases pour une analyse rapide et la création de schémas de tables.
Il réalise aussi un travail d’ETL (Extract, Transform, Load, un processus d’intégration de données) pour alimenter les entrepôts de données (data warehouses). On le trouve généralement dans les grandes entreprises, avec de nombreux analystes dont les données sont réparties entre plusieurs bases.
Pour revenir à notre modèle Uber, il peut concevoir une base de données analytique, puis écrire des scripts qui extraient les informations de la base principale de l’application vers cette base analytique.
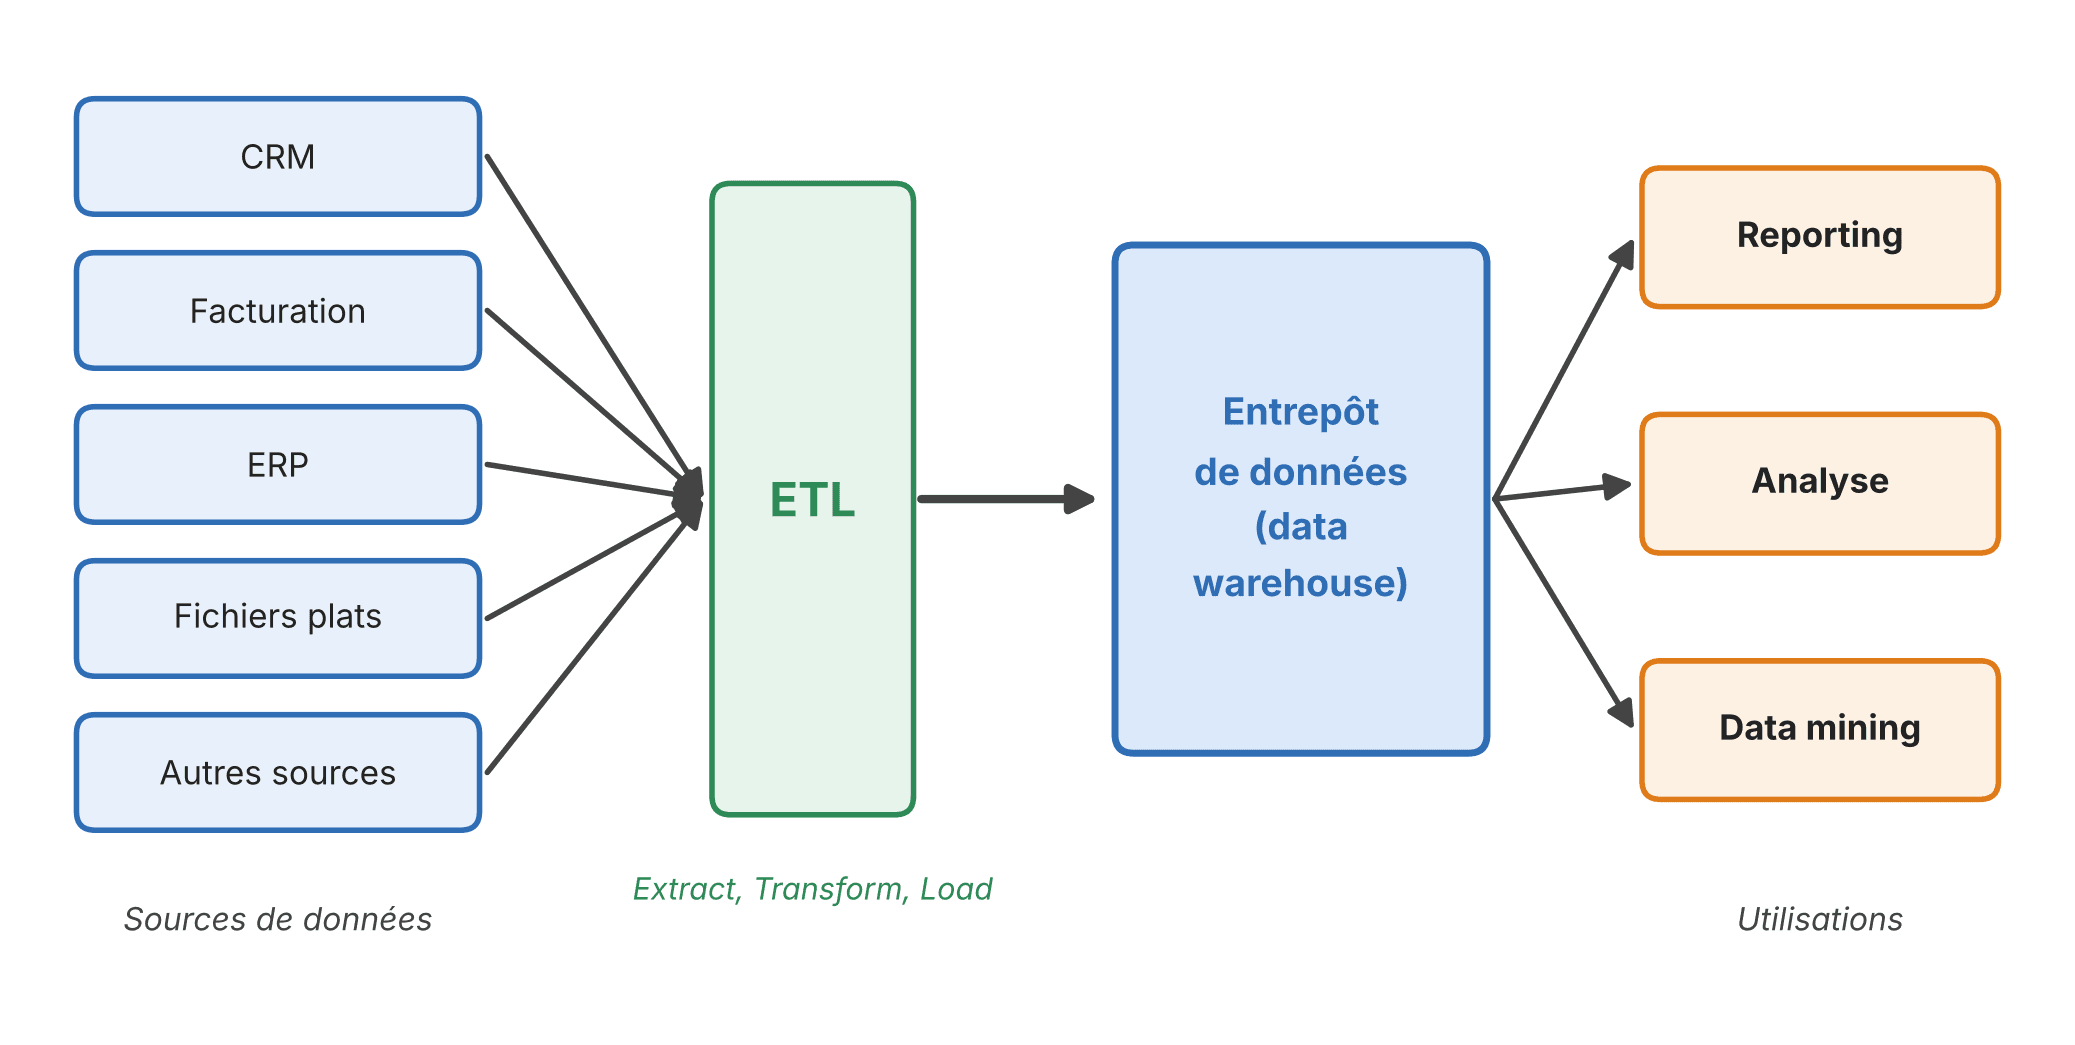
Un entrepôt de données (ou data warehouse) prend en charge les données, ce qui rend facile d’obtenir des informations via des requêtes.
Python est la base du métier de Data Engineer : pour l’apprendre pas à pas, le parcours Python de DataXp te fait pratiquer sur des exercices corrigés, avec un coach IA qui t’aide quand tu bloques. Les premiers modules sont gratuits.
Questions fréquentes sur le métier de Data Engineer
Que fait un Data Engineer ?
Il construit les pipelines qui transforment les données (stockées dans des bases de données ou des fichiers texte) en formats utilisables par les Data Scientists. Il crée aussi les points de terminaison d’API et les bases de données qui permettent d’accéder à ces données.
Quelles sont les quatre phases d’un pipeline de données ?
L’ingestion (rassembler les données nécessaires), le processing (traiter les données pour obtenir les résultats souhaités), le storage (stocker les résultats pour une récupération rapide) et l’access (permettre à un outil ou à un utilisateur d’accéder aux résultats).
Quelle différence entre un Data Engineer et un Data Scientist ?
Le Data Scientist analyse les données et construit les modèles. Le Data Engineer, plus éloigné du produit final, prépare ces données : sans lui, les Data Analysts et les Data Scientists n’ont rien à analyser. L’article compare cela à une écurie de F1 (le constructeur) et à son pilote.
Quels sont les différents types de Data Engineer ?
Trois catégories : le généraliste (petite équipe, travail de bout en bout), le spécialiste de pipeline (entreprises de taille moyenne, systèmes distribués) et le spécialiste des bases de données (grandes entreprises, bases analytiques, ETL et data warehouses).
Quels outils faut-il connaître pour être Data Engineer ?
Des outils comme Hadoop et Apache Spark, ou des langages comme Scala et Python, sont importants. Mais l’article insiste : il est plus important de bien comprendre les concepts (systèmes distribués, pipelines fiables, architecture de bases de données) et de savoir construire des systèmes réels.
Conclusion
Dans cet article, nous avons vu ce qu’est la Data Engineering et les compétences nécessaires pour la pratiquer à un niveau élevé. Si l’architecture de systèmes à grande échelle ou le travail sur d’énormes quantités de données t’intéressent, la Data Engineering est un bon domaine pour toi.
Il peut être très stimulant de voir ton pipeline gérer un pic de trafic grâce à la mise à l’échelle automatique, ou de travailler avec des machines dotées de téraoctets de RAM. Il y a aussi énormément de satisfaction à construire un système robuste, qui fonctionne pendant des mois ou des années avec un minimum d’entretien.
Comme la Data Engineering consiste à apprendre à gérer efficacement des projets à grande échelle, il peut être difficile de trouver du contenu de formation pratique. Mais il est tout à fait possible d’apprendre le métier de Data Engineer directement sur le terrain.
Sur MonCoachData, je travaillerai plus tard sur des contenus de formation en Data Engineering, qui est à mon sens une expertise aussi importante que l’analyse de données et l’Intelligence Artificielle.
Pour passer à la pratique, découvre comment utiliser Python pour la Data Engineering et consulte notre guide des 21 astuces et concepts Python pour améliorer ton code.