Python est utilisé en data science, en développement web et en automatisation, et les recruteurs vont vite au-delà de la syntaxe de base : ils veulent savoir si tu comprends ce qui se passe sous le capot. Je te présente ici 10 questions d’entretien Python courantes (et importantes), avec la réponse courte à donner à l’oral et du code que tu peux relancer.
Article mis à jour en novembre 2026 : j’ai exécuté chaque exemple avec Python 3.13 et ajouté les sorties. J’ai retiré de l’introduction deux chiffres (« 8 millions de développeurs » et « 10 à 20 % ») que je ne peux pas sourcer. J’ai aussi ajouté ce qui manquait : le .pyc observé dans __pycache__, les erreurs levées par les classes abstraites, un exemple complet pour les méthodes d’instance, de classe et statiques (il n’y avait pas de code), le risque de sécurité de pickle et la mesure de mémoire des générateurs.
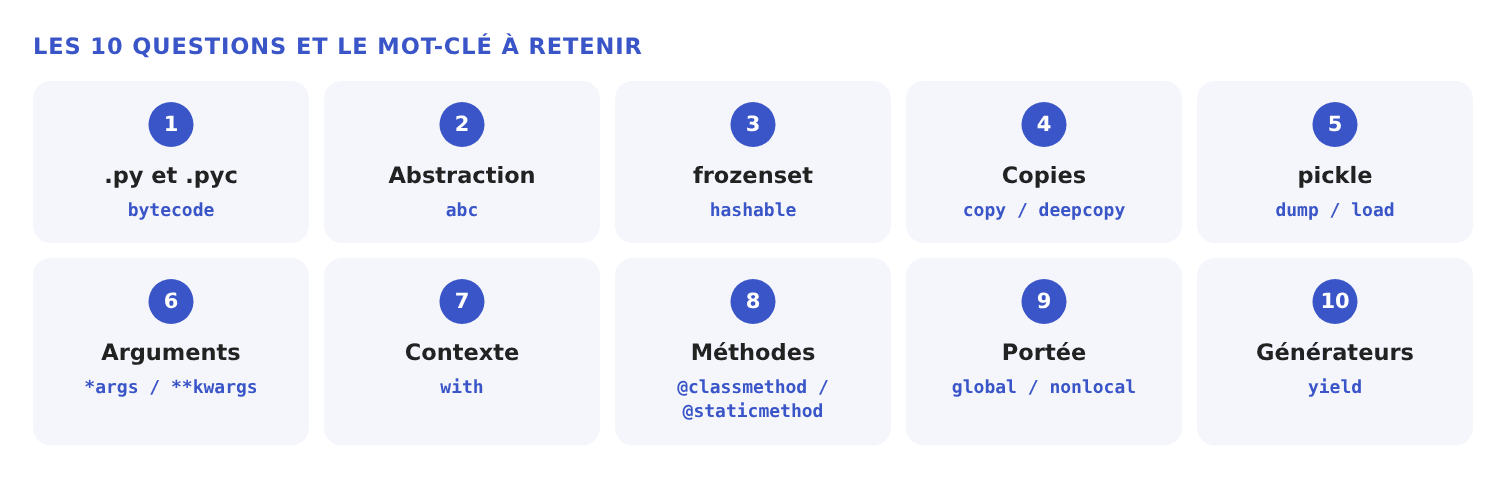
En bref : un fichier .pyc est du bytecode mis en cache à l’import ; une classe abstraite ne s’instancie pas ; un frozenset est un set immuable donc utilisable comme clé ; copy.copy ne copie que le premier niveau, deepcopy copie tout ; pickle sérialise des objets Python mais ne se charge que depuis une source de confiance ; *args et **kwargs reçoivent un nombre variable d’arguments ; with libère les ressources même en cas d’erreur ; @classmethod reçoit la classe et @staticmethod ne reçoit rien ; nonlocal modifie la variable d’une fonction englobante ; yield produit les valeurs une par une.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab, sans rien installer sur ton ordinateur.
Les exemples ci-dessous utilisent cette version de Python :
import sys, platform
print("Python", platform.python_version())Python 3.13.16Quelle est la différence entre les fichiers .py et .pyc ?
Les fichiers .py sont le code source du programme. Les fichiers .pyc contiennent le bytecode : une version compilée du code, que la machine virtuelle Python exécute.

Quand un module est importé, Python cherche son bytecode dans le dossier __pycache__. S’il existe et que le source n’a pas changé, il le réutilise. Sinon, il compile le .py et enregistre un nouveau .pyc. Voyons-le sur deux petits fichiers : calcul.py (une fonction) et main.py (qui l’importe).
import subprocess, sys, shutil, pathlib, importlib.util

d = pathlib.Path("pyc_demo")
shutil.rmtree(d, ignore_errors=True)
d.mkdir()
(d / "calcul.py").write_text("def carre(x):\n    return x * x\n")
(d / "main.py").write_text("import calcul\nprint(calcul.carre(7))\n")

def contenu():
    return sorted(str(p.relative_to(d)) for p in d.rglob("*"))

print("Au départ         :", contenu())
subprocess.run([sys.executable, "calcul.py"], cwd=d)
print("Après calcul.py   :", contenu())
r = subprocess.run([sys.executable, "main.py"], cwd=d, capture_output=True, text=True)
print("Résultat de main.py :", r.stdout.strip())
print("Après main.py     :", contenu())
print("Chemin du .pyc :", importlib.util.cache_from_source("calcul.py"))Au départ : ['calcul.py', 'main.py']
Après calcul.py : ['calcul.py', 'main.py']
Résultat de main.py : 49
Après main.py : ['__pycache__', '__pycache__/calcul.cpython-313.pyc', 'calcul.py', 'main.py']
Chemin du .pyc : __pycache__/calcul.cpython-313.pycDeux détails ressortent, et ce sont souvent ceux que les recruteurs attendent :
- Seuls les modules importés sont mis en cache. Lancer
python calcul.pydirectement n’a rien créé. Après l’import parmain.py, le fichier__pycache__/calcul.cpython-313.pycest apparu. Le nom contient la version de Python (cpython-313). - Un .pyc ne rend pas le programme plus rapide à l’exécution. Il évite seulement de recompiler le source à chaque import, donc il accélère le chargement.
Tu peux aussi regarder le bytecode avec le module dis (les instructions changent d’une version de Python à l’autre) :
import dis

def carre(x):
    return x * x

dis.dis(carre) 3 RESUME 0
4 LOAD_FAST_LOAD_FAST 0 (x, x)
BINARY_OP 5 (*)
RETURN_VALUEQu’est-ce que l’abstraction ? Comment l’implémenter en Python ?
L’abstraction cache les détails internes à l’utilisateur. Il interagit avec des fonctions sans savoir comment les résultats sont produits. En Python, on la réalise avec le module abc (Abstract Base Classes).
Une classe abstraite sert de base à d’autres classes. Tu ne peux pas créer d’objet à partir d’elle : le seul moyen de l’utiliser est l’héritage. Chaque méthode marquée @abstractmethod doit être redéfinie dans les classes filles.
from abc import ABC, abstractmethod


class Parent(ABC):
    @abstractmethod
    def show(self):
        pass


class Child(Parent):
    def show(self):
        print("Classe enfant")


obj = Child()
obj.show()Classe enfantQue se passe-t-il si tu essaies d’instancier la classe abstraite, ou une classe fille qui oublie une méthode abstraite ?
try:
    Parent()
except TypeError as e:
    print("TypeError :", e)


class Oubli(Parent):
    pass          # n'implémente pas show()


try:
    Oubli()
except TypeError as e:
print("TypeError :", e)TypeError : Can't instantiate abstract class Parent without an implementation for abstract method 'show'
TypeError : Can't instantiate abstract class Oubli without an implementation for abstract method 'show'Python refuse dans les deux cas avec une TypeError. C’est l’intérêt de l’abstraction : elle impose un contrat à toutes les classes filles. Pour aller plus loin sur l’héritage et les classes, lis la programmation orientée objet en Python.
Qu’est-ce qu’un frozenset et à quoi sert-il ?
Un frozenset est un set immuable. Tu peux modifier un set à tout moment, mais un frozenset ne change plus une fois créé : impossible d’y ajouter, supprimer ou mettre à jour un élément. Il prend un itérable en entrée (ici un dictionnaire, dont il garde les clés).
data = {"Name": "Roger", "Pin": 3056, "ActNo": 9892345112234565}
fSet = frozenset(data)
print(fSet)
print(sorted(fSet))frozenset({'Pin', 'Name', 'ActNo'})
['ActNo', 'Name', 'Pin']L’ordre des éléments n’est pas garanti et peut changer d’une exécution à l’autre : c’est pour cela que j’affiche aussi la version triée.
Parce qu’il est immuable, donc hashable, un frozenset peut servir de clé de dictionnaire ou d’élément d’un autre set, ce qu’un set ne peut pas faire :
s = {"a", "b"}
s.add("c")
print("set modifié :", sorted(s))

try:
    fSet.add("x")
except AttributeError as e:
    print("AttributeError :", e)

# un frozenset peut être une clé de dictionnaire (l'ordre n'a pas d'importance)
prix = {frozenset({"lait", "oeufs"}): 3.5}
print(prix[frozenset({"oeufs", "lait"})])

# un set ne peut pas
try:
    {{"a", "b"}: 1}
except TypeError as e:
print("TypeError :", e)set modifié : ['a', 'b', 'c']
AttributeError : 'frozenset' object has no attribute 'add'
3.5
TypeError : unhashable type: 'set'Quelle est la différence entre une copie superficielle et une copie profonde ?
La copie superficielle (shallow copy) crée un nouvel objet, mais ses éléments restent des références vers les mêmes objets que l’original. Les objets imbriqués (une liste dans une liste, par exemple) sont donc partagés : modifier l’un modifie l’autre. On l’obtient avec copy.copy().
La copie profonde (deep copy) copie aussi, de façon récursive, tous les objets imbriqués. Les changements dans la copie n’affectent pas l’original. On l’obtient avec copy.deepcopy().
L’opérateur is vérifie si deux noms pointent vers le même objet en mémoire (tu peux aussi comparer les id()). L’exemple montre aussi la différence avec une simple affectation (alias = data), qui ne crée aucune copie :
import copy

data = [[1, 2], [3, 4]]

# Affectation : pas de copie, deux noms pour le même objet
alias = data
print(alias is data)

# Copie superficielle : nouvelle liste externe, mais mêmes listes internes
shallow = copy.copy(data)
print(shallow is data)
print(shallow[0] is data[0])
shallow[0].append(99)
print(data)

# Copie profonde : les listes internes sont copiées aussi
deep = copy.deepcopy(data)
print(deep[0] is data[0])
deep[0].append(100)
print(deep)
print(data)True
False
True
[[1, 2, 99], [3, 4]]
False
[[1, 2, 99, 100], [3, 4]]
[[1, 2, 99], [3, 4]]Retiens la ligne shallow[0] is data[0] : elle vaut True, donc la liste interne est partagée, et c’est pour cela que data a changé quand on a modifié shallow. La copie profonde coûte plus cher en temps et en mémoire : n’y recours que si tu as des objets imbriqués à isoler.
Comment utiliser pickle ?
Le pickling convertit un objet Python en flux d’octets : c’est la sérialisation. Le unpickling fait l’inverse : c’est la désérialisation. On utilise pickle.dump et pickle.load (ou dumps et loads pour travailler en mémoire). J’utilise with pour que le fichier se ferme tout seul, ce que la première version de l’article ne faisait pas.
import pickle, os

data = {
    "Names": ["Noah", "Elio", "Summer"],
    "Id": ("G770531", "G770532", "G770533"),
    "Salary": [55600, 88900, 76000],
}
with open("data.pkl", "wb") as output:
    pickle.dump(data, output)
print(os.path.getsize("data.pkl"), "octets écrits")114 octets écritsimport pickle
with open("data.pkl", "rb") as stream:
data2 = pickle.load(stream)
print(data2)
print(data2 == data){'Names': ['Noah', 'Elio', 'Summer'], 'Id': ('G770531', 'G770532', 'G770533'), 'Salary': [55600, 88900, 76000]}
TrueLe dictionnaire est identique après rechargement, tuple compris. Mais il y a un piège de sécurité à connaître pour l’entretien : charger un fichier pickle peut exécuter du code. Voici une démonstration inoffensive, où le pickle fait simplement appeler print au chargement :
class Piege:
    def __reduce__(self):
        # pickle appellera print(...) au chargement
        return (print, ("Ce code s'est exécuté pendant le chargement !",))


octets = pickle.dumps(Piege())
pickle.loads(octets)Ce code s'est exécuté pendant le chargement !Un fichier malveillant pourrait appeler autre chose que print. Ne charge donc jamais un pickle dont tu ne connais pas l’origine. Pour échanger des données avec d’autres personnes ou d’autres programmes, préfère un format qui ne contient pas de code, comme JSON ou CSV.
Que sont *args et **kwargs ?
*args et **kwargs permettent de passer un nombre variable d’arguments à une fonction. Utilise-les quand tu ne sais pas à l’avance combien d’arguments seront fournis. Les noms args et kwargs sont une convention : ce sont les étoiles qui comptent.
*args regroupe les arguments positionnels dans un tuple :
def add_numbers(*numbers):
    total = 0
    for number in numbers:
        total = total + number
    print("Somme :", total)


add_numbers(3, 5)
add_numbers(5, 6, 7)Somme : 8
Somme : 18**kwargs regroupe les arguments nommés (mot-clé) dans un dictionnaire :
def add_numbers(**data):
    total = 0
    for key, value in data.items():
        total = total + value
    print("Somme :", total)


add_numbers(a=5, b=6)
add_numbers(a=5, b=8, c=10)Somme : 11
Somme : 23Tu peux combiner les deux. Les étoiles servent aussi à l’inverse, pour « déballer » une liste ou un dictionnaire au moment de l’appel :
def decrire(*args, **kwargs):
    print("args   :", args)
    print("kwargs :", kwargs)


decrire(1, 2, nom="Noah", age=30)

# L'étoile sert aussi à "déballer" une liste ou un dictionnaire à l'appel
nombres = [1, 2, 3]
options = {"sep": " | "}
print(*nombres, **options)args : (1, 2)
kwargs : {'nom': 'Noah', 'age': 30}
1 | 2 | 3Qu’est-ce qu’un gestionnaire de contexte en Python ?
Un gestionnaire de contexte gère une ressource : il l’acquiert au début d’un bloc et la libère à la fin, quoi qu’il arrive. L’exemple le plus courant est l’instruction with, surtout utilisée pour ouvrir et fermer des fichiers.
with open("data.txt", "w") as f:
    f.write("Hello")

print("Fichier fermé après le with :", f.closed)Fichier fermé après le with : TrueMême si une erreur survient dans le bloc, le fichier est fermé :
try:
    with open("data.txt") as f:
        1 / 0
except ZeroDivisionError:
print("Erreur interceptée. Fichier fermé :", f.closed)Erreur interceptée. Fichier fermé : TrueTu peux créer le tien de deux façons : avec une classe qui définit __enter__ et __exit__, ou avec le décorateur @contextmanager de contextlib (une fonction avec un yield) :
from contextlib import contextmanager


class Connexion:
    def __enter__(self):
        print("Ouverture")
        return self

    def __exit__(self, exc_type, exc, tb):
        print("Fermeture")


with Connexion():
    print("Travail dans le bloc with")


@contextmanager
def connexion():
    print("Ouverture")
    try:
        yield
    finally:
        print("Fermeture")


with connexion():
print("Travail dans le bloc with")Ouverture
Travail dans le bloc with
Fermeture
Ouverture
Travail dans le bloc with
FermetureLes deux versions affichent la même chose. Pour mieux comprendre les décorateurs, lis cet article sur les décorateurs Python.
Quelle différence entre méthode d’instance, de classe et statique ?
Une classe Python peut contenir trois types de méthodes :
- Méthode d’instance : la méthode ordinaire. Elle reçoit l’objet en premier argument (
self) et peut lire ou modifier ses attributs. - Méthode de classe : décorée par
@classmethod. Elle reçoit la classe (cls) et non l’objet. On s’en sert pour des opérations au niveau de la classe, par exemple un constructeur alternatif. - Méthode statique : décorée par
@staticmethod. Elle ne reçoit niselfnicls. C’est une fonction rangée dans la classe parce qu’elle s’y rattache logiquement.
La première version n’avait pas de code pour cette question. Voici un exemple avec des cercles :
import math


class Cercle:
    nb_cercles = 0                       # attribut de classe

    def __init__(self, rayon):
        self.rayon = rayon               # attribut d'instance
        Cercle.nb_cercles += 1

    def aire(self):                      # méthode d'instance
        return math.pi * self.rayon ** 2

    @classmethod
    def depuis_diametre(cls, diametre):  # méthode de classe
        return cls(diametre / 2)

    @staticmethod
    def rayon_valide(rayon):             # méthode statique
        return rayon > 0


c = Cercle(7)
print(round(c.aire(), 2))

c2 = Cercle.depuis_diametre(10)
print(c2.rayon, Cercle.nb_cercles)

print(Cercle.rayon_valide(-3))153.94
5.0 2
FalseDans depuis_diametre, cls vaut la classe appelante. Avec une classe fille, tu obtiens donc un objet de la classe fille, ce qu’une fonction qui écrirait Cercle(...) en dur ne ferait pas :
class Disque(Cercle):
    pass


d = Disque.depuis_diametre(4)
print(type(d).__name__)             # cls vaut Disque, pas Cercle
print(Cercle.aire(c) == c.aire()) # c.aire() est un raccourci pour Cercle.aire(c)Disque
TrueQuelle est la différence entre une variable globale et une variable non locale ?
Ces deux notions définissent la portée d’une variable, c’est-à-dire l’endroit du code où elle est visible. Une variable globale est définie en dehors de toute fonction. Elle peut être lue partout dans le programme.
pi = 3.14  # Variable globale


def circle(radius):
    area_of_circle = pi * (radius) ** 2
    print("L'aire du cercle est :", area_of_circle)


circle(7)L'aire du cercle est : 153.86Pour la modifier depuis une fonction, il faut le déclarer avec global. Sans cela, Python considère que compteur est une variable locale de la fonction, et lève une erreur :
compteur = 0


def incrementer_sans_global():
    compteur += 1


try:
    incrementer_sans_global()
except UnboundLocalError as e:
    print("UnboundLocalError :", e)


def incrementer():
    global compteur
    compteur += 1


incrementer()
incrementer()
print(compteur)UnboundLocalError : cannot access local variable 'compteur' where it is not associated with a value
2Les variables non locales, déclarées avec nonlocal, servent dans les fonctions imbriquées : elles permettent à la fonction interne de modifier une variable de la fonction englobante (mais pas une variable globale).
def outer_function():
    x = "local_variable"

    def inner_function():
        nonlocal x
        x = "nonlocal_variable"
        print("fonction interne :", x)

    inner_function()
    print("fonction externe :", x)


outer_function()fonction interne : nonlocal_variable
fonction externe : nonlocal_variableC’est le mécanisme des fermetures (closures). Cette fonction retourne un compteur qui garde son état entre deux appels :
def creer_compteur():
    n = 0

    def suivant():
        nonlocal n
        n += 1
        return n

    return suivant


cpt = creer_compteur()
print(cpt(), cpt(), cpt())1 2 3Qu’est-ce qu’un générateur ? Donne un exemple.
Un générateur est une fonction qui renvoie un itérateur, c’est-à-dire un objet que l’on parcourt élément par élément. Elle contient au moins une instruction yield. Contrairement à return, yield renvoie une valeur sans terminer la fonction : l’état et les variables locales sont conservés jusqu’à l’appel suivant. Pour un débutant, considère yield comme un return qui n’arrête pas la fonction.
def fibon(limit):
    a, b = 0, 1
    while a < limit:
        yield a
        a, b = b, a + b


for x in fibon(10):
print(x)0
1
1
2
3
5
8Chaque valeur n’est calculée qu’au moment où on la demande. On le voit avec next(), et on voit aussi qu’un générateur ne se rejoue pas : une fois épuisé, il est vide.
g = fibon(10)
print(next(g), next(g), next(g))   # 0 1 1
print(list(g))                     # le reste : 2 3 5 8
print(list(g)) # le générateur est épuisé0 1 1
[2, 3, 5, 8]
[]L’intérêt principal est la mémoire. Sur un million de carrés, la liste occupe 8 448 728 octets, le générateur 200 octets, pour la même somme :
import sys

liste = [x * x for x in range(1_000_000)]
gen = (x * x for x in range(1_000_000))

print("Liste       :", sys.getsizeof(liste), "octets")
print("Générateur  :", sys.getsizeof(gen), "octets")
print("Même somme :", sum(liste) == sum(gen))Liste : 8448728 octets
Générateur : 200 octets
Même somme : TrueLa taille indiquée par getsizeof dépend de ta version de Python et de ta machine, mais l’écart reste énorme. Pour aller plus loin, lis la programmation avancée en Python.
Comment te préparer à un entretien technique Python ?
- Explique à voix haute. Pour chaque question de cet article, essaie de répondre en deux phrases sans regarder, puis donne un exemple de code.
- Exécute le code. Relance les exemples, change une valeur, casse-les volontairement (instancier la classe abstraite, modifier un frozenset) et observe l’erreur.
- Donne la limite. Pour chaque notion, connais le piège : pickle et la sécurité, la copie superficielle et les objets imbriqués,
globaletUnboundLocalError. - Pratique régulièrement. Les entretiens testent souvent la capacité à écrire du code, pas seulement à réciter une définition.
Questions fréquentes
Quelles questions d’entretien Python faut-il préparer en priorité ?
Celles sur les structures de données (list, tuple, set, frozenset, dictionnaire), la copie d’objets, la portée des variables, les arguments de fonctions, les générateurs, les décorateurs et la programmation orientée objet. Elles reviennent dans la plupart des entretiens techniques.
Un fichier .pyc rend-il mon programme plus rapide ?
Non, pas à l’exécution. Le .pyc évite seulement de recompiler le source à chaque import, donc il accélère le démarrage. De plus, un script lancé directement (python script.py) n’est pas mis en cache : seuls les modules importés le sont.
Pourquoi ne faut-il pas charger un fichier pickle inconnu ?
Parce que le chargement d’un pickle peut exécuter du code arbitraire sur ta machine. Ne charge que des fichiers que tu as créés toi-même ou dont tu connais la source, et utilise JSON ou CSV pour échanger des données.
Faut-il toujours utiliser deepcopy ?
Non. copy.copy suffit quand ta structure n’a pas d’objets imbriqués modifiables, et elle est plus rapide. Utilise copy.deepcopy quand tu dois isoler complètement une copie d’une structure imbriquée (listes de listes, dictionnaires de listes).
Quelle différence entre un générateur et une liste ?
Une liste stocke tous ses éléments en mémoire et se parcourt autant de fois que tu veux. Un générateur calcule les éléments à la demande, occupe très peu de mémoire, mais ne se parcourt qu’une seule fois.
À quoi sert @staticmethod si une fonction normale suffit ?
À ranger dans la classe une fonction qui s’y rattache logiquement mais qui n’a besoin ni de l’objet ni de la classe. Cela garde le code organisé et permet de l’appeler avec le nom de la classe, par exemple Cercle.rayon_valide(7).
Pour t’entraîner, parcours aussi mes 25 extraits de code Python de référence pour ton travail quotidien.
Conclusion : par où commencer ?
Tu viens de voir 10 questions courantes d’entretien Python, avec du code exécuté pour chacune. Si tu n’as qu’une soirée, révise d’abord la copie (superficielle ou profonde), la portée des variables et les générateurs : ce sont les sujets où les erreurs sont les plus fréquentes et où un exemple clair fait la différence.
Pour progresser en Python, le mieux est de pratiquer. Sur DataXp, tu apprends Python et la data science avec des exercices pratiques à faire directement en ligne.
Pour aller plus loin, voici d’autres articles qui pourraient te plaire :