Tu veux apprendre le Machine Learning avec Python ? Tu es au bon endroit. En apprenant la programmation avec Python, tu te rendras vite compte du nombre croissant de techniques d’analyse et d’utilisation de données.
Le Machine Learning (ou apprentissage automatique) est sans doute l’un des domaines que tu souhaites maîtriser, puisque tu es sur cette page.
Le Machine Learning te permet de faire des prédictions en fournissant des données à des algorithmes. Ses usages sont très nombreux, ce qui en fait une compétence majeure à ajouter à ton CV.
Dans ce tutoriel, je t’explique les principes de base du Machine Learning et comment t’y familiariser avec Python. Heureusement, Python possède un écosystème de bibliothèques qui facilitent grandement son application.
On utilisera ici trois bibliothèques : Scikit-learn, Pandas et Matplotlib.
En bref : ce tutoriel t’apprend le Machine Learning avec Python (Pandas, Matplotlib et Scikit-learn) en prédisant la note moyenne de jeux de société de BoardGameGeek (81 312 jeux, 20 colonnes). Après exploration, nettoyage, clustering k-means et PCA, une régression linéaire donne une erreur quadratique moyenne d’environ 1,82, et un random forest d’environ 1,41 : le second est donc meilleur sur ce jeu de données.
Tu peux aussi exécuter tous ces exemples dans ce notebook Google Colab : chaque extrait de code est dans sa propre cellule, prêt à être modifié.
Pour approfondir le Machine Learning et pratiquer sur des exemples concrets, tu peux t’entraîner sur DataXp : des exercices pratiques et un coach IA t’accompagnent, et les premiers modules sont gratuits.
Quel jeu de données utilise-t-on pour apprendre le Machine Learning ?
Avant de se lancer dans le Machine Learning, on explore un dataset (ou jeu de données) pour déterminer ce qu’il serait intéressant de prédire.
Le dataset provient de BoardGameGeek et contient des données sur 80 000 jeux de société.
Voici un exemple de jeu de société sur le site.
Toutes ces données ont été récupérées (scrapées) au format CSV par Sean Beck. Tu peux les télécharger ici. Le dataset contient plusieurs informations sur chaque jeu.
Voici les colonnes les plus intéressantes :
name– nom du jeu de société.playtime– le temps de jeu (donné par le fabricant).minplaytime– le temps de jeu minimum (donné par le fabricant).maxplaytime– le temps de jeu maximum (donné par le fabricant).minage– l’âge minimum recommandé pour jouer.users_rated– le nombre d’utilisateurs qui ont évalué le jeu.average_rating– la note moyenne attribuée au jeu par les utilisateurs (de 0 à 10).total_weights– nombre de poids donnés par les utilisateurs. Le poids est une mesure subjective définie par BoardGameGeek : elle décrit la complexité d’un jeu. Tu trouveras l’explication complète ici.average_weight– la moyenne de tous les poids subjectifs (de 0 à 5).
Pourquoi utiliser Pandas et un DataFrame ?
La première étape consiste à lire les données et à afficher quelques statistiques sommaires.
Pour cela, on utilise la bibliothèque Pandas. Elle fournit des structures de données et des outils d’analyse qui permettent de manipuler les données beaucoup plus rapidement et efficacement qu’avec Python seul.
La structure de données la plus courante de Pandas est le DataFrame. C’est une extension de la matrice : voyons d’abord ce qu’est une matrice, avant de revenir aux DataFrames.
Notre fichier de données ressemble à ceci (j’ai supprimé certaines colonnes pour faciliter la lecture) :
id,type,name,yearpublished,minplayers,maxplayers,playingtime
12333,boardgame,Twilight Struggle,2005,2,2,180
120677,boardgame,Terra Mystica,2012,2,5,150Ce format s’appelle CSV, pour comma-separated values (valeurs séparées par des virgules).
Chaque ligne correspond à un jeu de société différent, et les informations de chaque jeu sont séparées par des virgules.
La première ligne est la ligne d’en-tête : elle décrit chaque information. L’ensemble des valeurs d’une même information, en descendant, forme une colonne.
On peut facilement se représenter un fichier CSV comme une matrice :
| id | type | name | yearpublished | minplayers | maxplayers | playingtime |
|---|---|---|---|---|---|---|
| 12333 | boardgame | Twilight Struggle | 2005 | 2 | 2 | 180 |
| 120677 | boardgame | Terra Mystica | 2012 | 2 | 5 | 150 |
J’ai supprimé certaines colonnes ici pour la lisibilité, mais ça te donne une idée de l’aspect des données.
Une matrice est une structure de données à deux dimensions, avec des lignes et des colonnes. On accède à ses éléments par leur position.
La première ligne commence par id, la deuxième par 12333 et la troisième par 120677.
La première colonne est id, la seconde est type, etc.
En Python, on manipule des matrices avec la bibliothèque NumPy. Mais une matrice a des inconvénients : on ne peut pas accéder facilement aux lignes et aux colonnes par leur nom, et toutes les colonnes doivent avoir le même type de données.
On ne peut donc pas stocker efficacement nos jeux de société dans une matrice : la colonne name contient des chaînes de caractères (string) et la colonne yearpublished des entiers (integer).
Un DataFrame, lui, accepte un type de données différent dans chaque colonne. Il offre de nombreuses fonctionnalités d’analyse, comme la recherche de colonnes par leur nom. Pandas nous donne accès à tout cela et simplifie le travail sur les données.
Comment lire un fichier CSV avec Pandas ?
On lit maintenant le fichier CSV dans un DataFrame Pandas avec la fonction read_csv :
# Importer la bibliothèque pandas.
import pandas as pd

# Lire les données (fichier games.csv hébergé sur GitHub).
URL = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/apprendre-machine-learning-avec-python/games.csv"
games = pd.read_csv(URL)

# Afficher les noms de colonnes du DataFrame games.
print(games.columns)Index(['id', 'type', 'name', 'yearpublished', 'minplayers', 'maxplayers',
'playingtime', 'minplaytime', 'maxplaytime', 'minage', 'users_rated',
'average_rating', 'bayes_average_rating', 'total_owners',
'total_traders', 'total_wanters', 'total_wishers', 'total_comments',
'total_weights', 'average_weight'],
dtype='str')Ce code lit les données et affiche tous les noms de colonnes. Celles que je n’ai pas listées plus haut sont assez explicites.
Pour obtenir les dimensions du DataFrame, on utilise shape :
print(games.shape)(81312, 20)Le DataFrame contient 81 312 lignes (des jeux de société) et 20 colonnes (ou features) qui décrivent chaque jeu.
Comment visualiser la variable à prédire ?
Il serait intéressant de prédire la note moyenne qu’un humain attribuerait à un nouveau jeu de société inédit. Cette note est stockée dans la colonne average_rating : c’est la moyenne de toutes les notes des utilisateurs pour un jeu.
Prédire cette variable pourrait aider, par exemple, les fabricants de jeux à choisir le type de jeu à créer.
On accède à une colonne d’un DataFrame avec games["average_rating"], qui extrait cette seule colonne.
Traçons un histogramme de cette colonne pour visualiser la distribution des notes, avec Matplotlib, la principale bibliothèque de visualisation en Python.
La plupart des autres bibliothèques de visualisation, comme seaborn, sont construites au-dessus de Matplotlib. On importe ses fonctions avec import matplotlib.pyplot as plt, puis on dessine et on affiche le graphique.
# Importer matplotlib
import matplotlib.pyplot as plt

# Histogramme de toutes les notes de la colonne average_rating.
plt.hist(games["average_rating"])

# Titre et noms des axes
plt.title("Distribution des notes moyennes des jeux de société")
plt.xlabel("Note moyenne")
plt.ylabel("Nombre de jeux")

# Afficher le graphique
plt.show()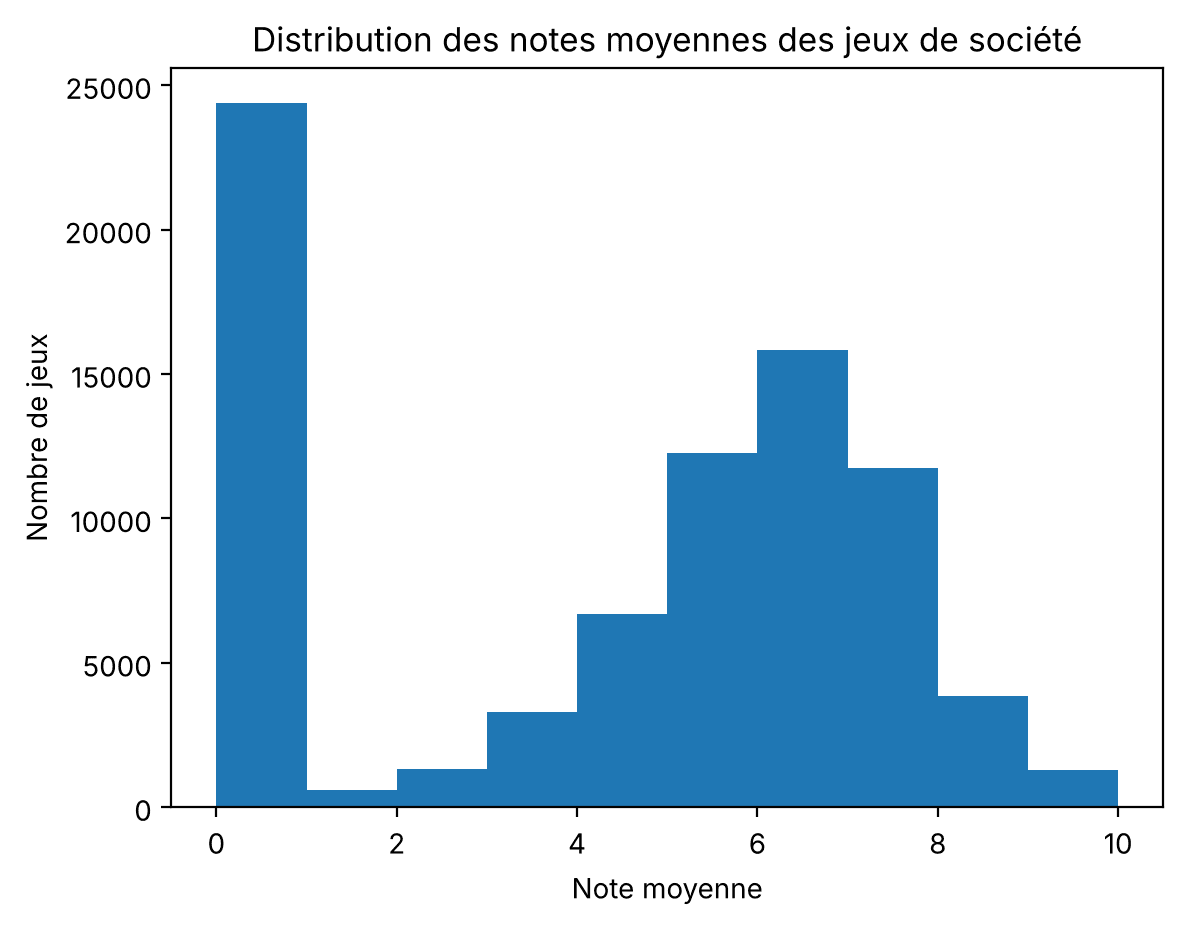
On voit qu’il y a pas mal de jeux de société avec une note de 0. Le reste de la distribution est assez proche d’une loi normale, légèrement asymétrique, avec une note moyenne autour de 6 (en retirant les zéros).
Pourquoi y a-t-il autant de notes de 0 ?
Y a-t-il vraiment autant de très mauvais jeux avec la note 0 ? Ou se passe-t-il autre chose ? Il faut creuser les données pour le savoir.
Avec Pandas, on sélectionne des sous-ensembles de données grâce à des Series de booléens (une colonne ou une ligne d’un DataFrame est un objet Series). Par exemple :
games[games["average_rating"] == 0]Ce code crée un nouveau DataFrame avec uniquement les lignes de games où average_rating vaut 0. On peut ensuite l’indexer pour obtenir les valeurs souhaitées.
Pandas propose deux façons d’indexer : par le nom de la ligne ou de la colonne, ou par la position.
L’indexation par nom ressemble à games["average_rating"] : elle retourne toute la colonne average_rating de games.
L’indexation par position ressemble à games.iloc[0] : elle retourne la première ligne du DataFrame.
On peut aussi passer plusieurs index à la fois : games.iloc[0, 0] retourne la première colonne de la première ligne de games. Pour en savoir plus, consulte le guide de l’indexation dans Pandas.
# Afficher la première ligne du DataFrame games avec des notes de 0.
# La méthode .iloc sur des dataframes nous permet d'indexer par position.
print(games[games["average_rating"] == 0].iloc[0])

# Afficher la première ligne de tous les jeux de sociétés dont la note est supérieure à 0.
print(games[games["average_rating"] > 0].iloc[0])id 318
type boardgame
name Looney Leo
yearpublished 0
minplayers 0
maxplayers 0
playingtime 0
minplaytime 0
maxplaytime 0
minage 0
users_rated 0
average_rating 0
bayes_average_rating 0
total_owners 0
total_traders 0
total_wanters 0
total_wishers 1
total_comments 0
total_weights 0
average_weight 0
Name: 13048, dtype: object
id 12333
type boardgame
name Twilight Struggle
yearpublished 2005
minplayers 2
maxplayers 2
playingtime 180
minplaytime 180
maxplaytime 180
minage 13
users_rated 20113
average_rating 8.33774
bayes_average_rating 8.22186
total_owners 26647
total_traders 372
total_wanters 1219
total_wishers 5865
total_comments 5347
total_weights 2562
average_weight 3.4785
Name: 0, dtype: objectOn voit que la principale différence entre un jeu noté 0 et un jeu noté plus que 0, c’est que le premier n’a aucun avis d’utilisateur.
La colonne users_rated vaut 0. En filtrant tous les jeux sans avis, on supprime une bonne partie du « bruit ».
Comment supprimer les jeux sans aucun avis ?
# Supprime chaque ligne sans aucun review utilisateur.
games = games[games["users_rated"] > 0]

# Supprime les lignes contenant des valeurs manquantes.
games = games.dropna(axis=0)On vient de filtrer les lignes sans aucun avis d’utilisateur. Au passage, on a aussi supprimé toutes les lignes contenant des valeurs manquantes, car de nombreux algorithmes de Machine Learning ne savent pas les traiter.
Filtrer est une technique courante, mais on peut perdre des données précieuses. Il existe d’autres techniques pour traiter les valeurs manquantes.
Qu’est-ce que le clustering k-means ?
On a vu qu’il peut exister des groupes de jeux bien distincts. L’un d’eux (que l’on vient de supprimer) était celui des jeux sans aucun avis. Un autre pourrait être celui des jeux très bien notés…
Une technique pour en savoir plus sur ces groupes s’appelle le clustering. Elle permet de repérer facilement des motifs dans les données en regroupant les lignes similaires (ici, des jeux de société).
On utilise un type particulier de clustering : le clustering k-means, dont Scikit-learn propose une excellente implémentation.
Scikit-learn est la principale bibliothèque de Machine Learning en Python. Elle contient les algorithmes les plus courants, comme les random forests, les support vector machines et la régression logistique, avec une API cohérente et robuste.
# Importer le modèle kmeans clustering.
from sklearn.cluster import KMeans

# Initialiser le modèle avec 2 paramètres : le nombre de clusters et le random state.
kmeans_model = KMeans(n_clusters=5, random_state=1)

# Seulement les colonnes numériques de games.
good_columns = games.select_dtypes(include="number")

# Adapter le modèle en utilisant les bonnes colonnes.
kmeans_model.fit(good_columns)

# Obtenir les labels des clusters.
labels = kmeans_model.labels_Pour utiliser k-means dans Scikit-learn, on l’initialise avec deux paramètres : n_clusters définit le nombre de clusters de jeux que l’on veut, et random_state fixe la graine aléatoire pour reproduire les mêmes résultats plus tard. Voici la documentation de l’implémentation de KMeans.
On ne garde ensuite que les colonnes numériques du DataFrame avec select_dtypes, car la plupart des algorithmes de Machine Learning ne prennent que des nombres en entrée. Cela supprime type et name, inutilisables par l’algorithme.
Enfin, on ajuste (fit) le modèle k-means aux données et on récupère les étiquettes (labels) qui indiquent le cluster de chaque ligne.
Comment tracer des clusters avec la PCA ?
Maintenant que l’on a les labels, on peut tracer les clusters. Problème : nos données ont beaucoup de colonnes, et on ne peut pas visualiser plus de trois dimensions.
Il faut donc réduire la dimensionnalité des données sans perdre trop d’information.
Une technique courante est l’analyse en composantes principales (Principal Component Analysis, ou PCA). Elle transforme plusieurs colonnes en un nombre réduit de colonnes, en conservant le plus possible l’information utile.
Prenons deux colonnes, total_owners et total_traders. Elles sont corrélées et se chevauchent. La PCA compresse cette information dans une seule colonne de nouvelles valeurs, en perdant le moins d’information possible.
Ici, on transforme nos données en deux dimensions (deux colonnes) pour les tracer facilement.
# Importer le modèle PCA.
from sklearn.decomposition import PCA

# Créer un modèle PCA.
pca_2 = PCA(2)

# Adapter le modèle PCA aux colonnes numériques précédentes.
plot_columns = pca_2.fit_transform(good_columns)

# Nuage de points des jeux de société, colorés selon leur cluster.
plt.scatter(x=plot_columns[:,0], y=plot_columns[:,1], c=labels)

# Titre et noms des axes
plt.title("Les 5 clusters de jeux de société (projection PCA)")
plt.xlabel("Composante principale 1")
plt.ylabel("Composante principale 2")

# Afficher le graphique
plt.show()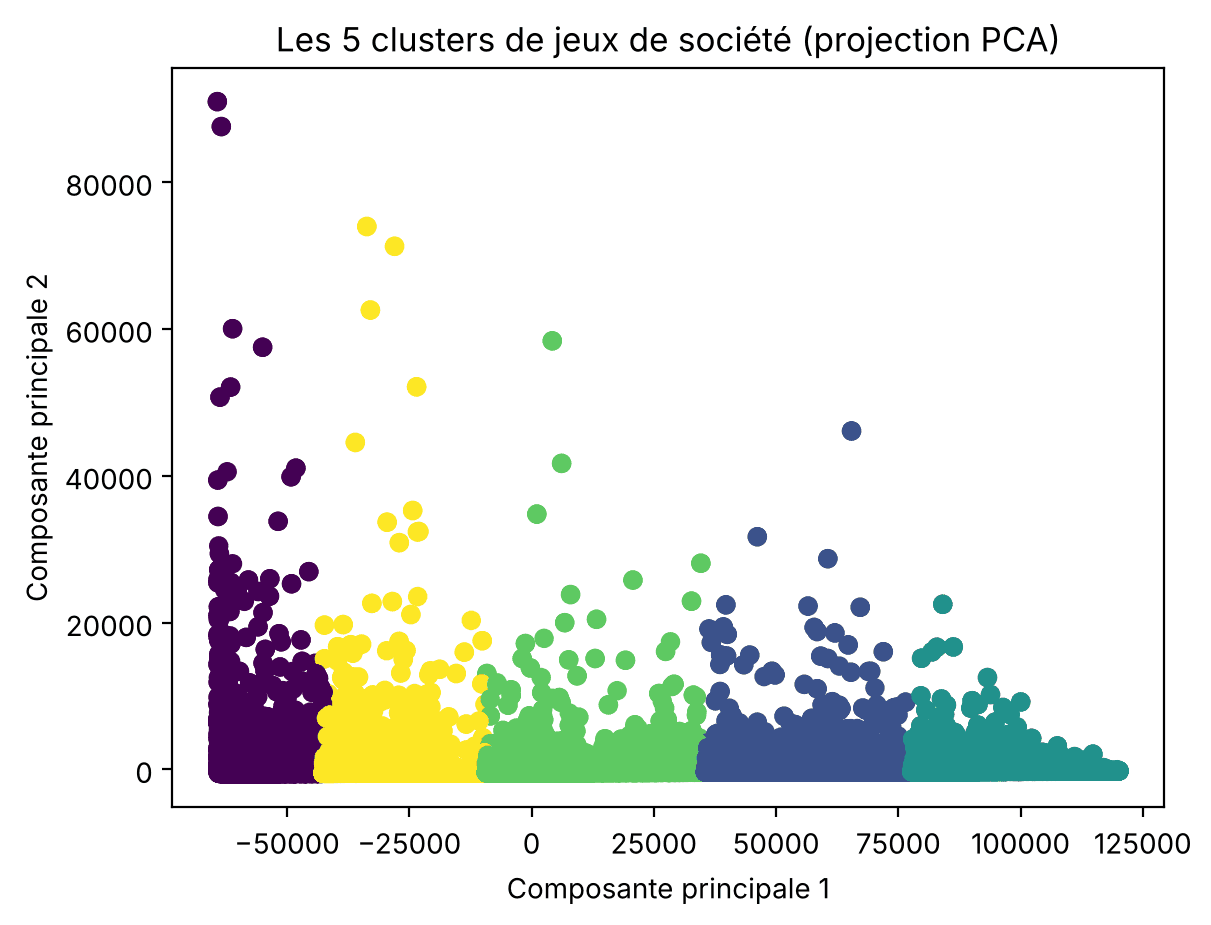
On initialise un modèle PCA de Scikit-learn. La PCA n’est pas un algorithme de Machine Learning à proprement parler, mais Scikit-learn contient aussi d’autres outils utiles. Les techniques de réduction de dimensionnalité comme la PCA sont très utilisées pour prétraiter les données avant un algorithme de Machine Learning.
On transforme ensuite les données en 2 colonnes et on les trace, en colorant chaque point selon son cluster.
Le graphique fait apparaître les 5 groupes demandés à l’algorithme (n_clusters=5). On pourrait explorer les jeux de chaque groupe pour comprendre ce qui les rassemble.
Que prédire et comment mesurer l’erreur ?
Avant de se lancer dans le Machine Learning, il faut décider de deux choses : comment mesurer l’erreur et quoi prédire.
average_rating semble être une bonne cible, et notre exploration le confirme. Il existe de nombreuses mesures d’erreur.
En règle générale, une régression (prédiction d’une variable continue) n’utilise pas la même mesure d’erreur qu’une classification (prédiction de valeurs discrètes).
Ici, on utilise l’erreur quadratique moyenne (Mean Squared Error, MSE) : elle est facile à calculer et à comprendre. Elle mesure l’écart moyen, au carré, entre nos prédictions et les valeurs réelles.
Quelles colonnes sont corrélées à la note moyenne ?
Puisque l’on veut prédire average_rating, cherchons les colonnes les plus utiles pour cela. Une solution consiste à calculer la corrélation entre average_rating et chacune des autres colonnes.
La méthode corr des DataFrames donne la corrélation entre chaque colonne et toutes les autres. Le résultat étant un DataFrame, on peut l’indexer pour ne garder que la colonne average_rating. Avec les versions récentes de Pandas, il faut préciser numeric_only=True car le DataFrame contient aussi des colonnes de texte.
games.corr(numeric_only=True)["average_rating"]id 0.304201
yearpublished 0.108461
minplayers -0.032701
maxplayers -0.008335
playingtime 0.048994
minplaytime 0.043985
maxplaytime 0.048994
minage 0.210049
users_rated 0.112564
average_rating 1.000000
bayes_average_rating 0.231563
total_owners 0.137478
total_traders 0.119452
total_wanters 0.196566
total_wishers 0.171375
total_comments 0.123714
total_weights 0.109691
average_weight 0.351081
Name: average_rating, dtype: float64Les colonnes average_weight et id sont les plus corrélées à la note.
Les identifiants (id) sont vraisemblablement attribués quand un jeu est ajouté à la base : les jeux ajoutés plus tard ont donc plutôt de meilleures notes. Peut-être que les avis étaient moins généreux aux débuts de BoardGameGeek, ou que les jeux plus anciens étaient de moins bonne qualité.
average_weight indique la « profondeur » ou la complexité d’un jeu : il est donc possible que les jeux plus complexes soient mieux notés.
Comment choisir les prédicteurs et éviter la fuite de données ?
Avant de prédire, on sélectionne les colonnes utiles à l’entraînement. On retire d’abord les colonnes non numériques.
On retire aussi les colonnes qui ne peuvent être calculées qu’en connaissant déjà la note moyenne : les garder irait à l’encontre de l’objectif, qui est de prédire la note sans la connaître à l’avance.
Utiliser de telles colonnes provoque une fuite de données (data leakage) : le modèle est excellent sur les données d’entraînement mais ne se généralise pas aux données futures.
La colonne bayes_average_rating semble dériver de average_rating : on la supprime aussi.
# Obtenir toutes les colonnes du DataFrame games.
columns = games.columns.tolist()

# Filtrer les colonnes pour supprimer celles que nous ne voulons pas.
columns = [c for c in columns if c not in ["bayes_average_rating", "average_rating", "type", "name"]]

# Stocker la variable que nous voulons prédire.
target = "average_rating"Pourquoi séparer les données en un set d’entraînement et un set de test ?
On veut mesurer la précision de l’algorithme avec notre métrique d’erreur. Mais l’évaluer sur les données qui ont servi à l’entraîner conduit au surentraînement (overfitting).
L’algorithme doit apprendre des règles générales, pas mémoriser des prédictions précises.
Prenons l’exemple des mathématiques. Si tu mémorises que 1 + 1 = 2 et 2 + 2 = 4, tu répondras parfaitement à ces deux questions, sans aucune erreur.
Mais si on te demande 3 + 3, une question hors de ton ensemble d’entraînement, tu seras incapable de répondre.
À l’inverse, si tu as appris à généraliser, tu feras parfois des erreurs, car tu n’as pas mémorisé les solutions : tu te tromperas peut-être sur 3453 + 353535. Mais tu sauras résoudre n’importe quel nouveau problème.
Si l’erreur de ton modèle semble étonnamment basse à l’entraînement, vérifie toujours qu’il n’y a pas de surentraînement.
Pour l’éviter, on entraîne l’algorithme sur 80 % des données et on le teste sur les 20 % restants. On échantillonne donc au hasard 80 % des lignes pour le set d’entraînement, et tout le reste va dans le set de test.
# Générer le set de training. On fixe random_state pour reproduire les résultats.
train = games.sample(frac=0.8, random_state=1)

# Sélectionner tout ce qui n'est pas dans le set de training et le mettre dans le set de test.
test = games.loc[~games.index.isin(train.index)]

# Afficher les dimensions des 2 sets.
print(train.shape)
print(test.shape)(45515, 20)
(11379, 20)Ici, on exploite le fait que chaque ligne d’un DataFrame a un index unique pour sélectionner, dans le set de test, les lignes absentes du set d’entraînement.
Comment adapter un modèle de régression linéaire ?
La régression linéaire est un algorithme de Machine Learning puissant et très utilisé. Elle prédit la variable cible à partir de combinaisons linéaires des variables prédictrices.
Avec deux valeurs, 3 et 4, une combinaison linéaire serait par exemple 3 * 0.5 + 4 * 0.5 : on multiplie chaque nombre par une constante et on additionne les résultats.
La régression linéaire ne fonctionne bien que si les prédicteurs et la cible sont corrélés linéairement.
On l’a vu plus haut : plusieurs prédicteurs sont corrélés à la cible, donc la régression linéaire est un bon point de départ.
On utilise l’implémentation de Scikit-learn, comme pour k-means.
# Importer le modèle LinearRegression.
from sklearn.linear_model import LinearRegression

# Initialiser la classe du modèle.
model = LinearRegression()

# Adapter le modèle aux données d'entraînement
model.fit(train[columns], train[target])Pour entraîner le modèle, on lui passe la matrice des prédicteurs (toutes les colonnes sélectionnées plus haut) et la variable cible à prédire.
Passer une liste de colonnes à un DataFrame renvoie un nouveau DataFrame contenant ces colonnes. Le modèle apprend l’équation qui relie les prédicteurs à la cible avec une erreur minimale.
Comment mesurer l’erreur des prédictions ?
Une fois le modèle entraîné, on peut faire des prédictions sur de nouvelles données.
Elles doivent avoir exactement le même format que les données d’entraînement, sinon les prédictions seront imprécises. Notre set de test a le même format que le set d’entraînement (avec d’autres jeux de société). On sélectionne donc les mêmes colonnes, puis on prédit.
# Importer la fonction de calcul d'erreur depuis scikit-learn.
from sklearn.metrics import mean_squared_error

# Générer des prédictions pour le set de test.
predictions = model.predict(test[columns])

# Calculer l'erreur entre les valeurs réelles et nos prédictions.
print(mean_squared_error(test[target], predictions))1.8239281903519866Une fois les prédictions obtenues, on calcule l’erreur entre celles du set de test et les valeurs réelles. L’erreur quadratique moyenne a pour formule :
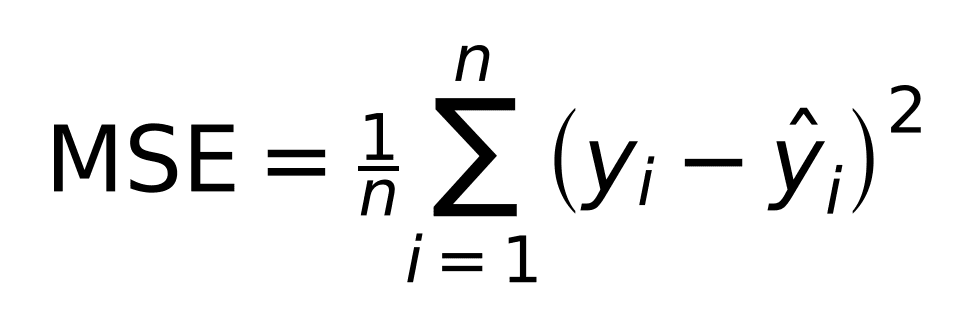
Concrètement, on soustrait chaque valeur prédite de la valeur réelle, on élève les écarts au carré, on les additionne, puis on divise par le nombre de valeurs prédites. On obtient l’erreur moyenne par prédiction.
Ici, l’erreur est d’environ 1,82. Pour retrouver une erreur dans l’unité de la note, on peut prendre sa racine carrée (environ 1,35 point). On peut chercher à la réduire.
Un random forest fait-il mieux qu’une régression linéaire ?
L’un des avantages de Scikit-learn est qu’il permet d’essayer très facilement des algorithmes plus puissants, comme le random forest. Celui-ci peut détecter des non-linéarités que la régression linéaire ne voit pas.
Supposons que, si la colonne minage d’un jeu est inférieure à 5, la note soit basse ; entre 5 et 10, élevée ; et entre 10 et 15, de nouveau basse.
Une régression linéaire ne peut pas capter cela, car il n’existe pas de relation linéaire entre ce prédicteur et la cible.
En général, les prédictions d’un random forest comportent moins d’erreurs que celles d’une régression linéaire.
# Importer le modèle random forest.
from sklearn.ensemble import RandomForestRegressor

# Initialiser le modèle avec certains paramètres.
model = RandomForestRegressor(n_estimators=100, min_samples_leaf=10, random_state=1)

# Adapter le modèle aux données.
model.fit(train[columns], train[target])

# Faire des prédictions.
predictions = model.predict(test[columns])

# Calculer l'erreur.
print(mean_squared_error(test[target], predictions))1.4144645379262684L’erreur est d’environ 1,41, soit moins que pour le modèle précédent. On vient donc de trouver un meilleur modèle pour prédire la note moyenne d’un jeu de société.
Exploration plus poussée
Tu es passé de données au format CSV à des prédictions, plutôt cool, non ? Voici quelques pistes pour aller plus loin. Tu peux essayer :
- le support vector machine ;
- d’assembler plusieurs modèles pour obtenir de meilleures prédictions ;
- de prédire une autre colonne, comme
average_weight; - de générer des caractéristiques à partir du texte, comme la longueur du nom du jeu ou son nombre de mots.
Questions fréquentes sur le Machine Learning avec Python
Comment prédire la note moyenne d’un jeu de société avec Python ?
En lisant le CSV avec Pandas, en supprimant les jeux sans aucun avis, en choisissant des colonnes numériques comme prédicteurs, puis en entraînant un modèle Scikit-learn sur 80 % des données et en le testant sur les 20 % restants. Ici, la régression linéaire donne une erreur quadratique moyenne d’environ 1,82 et le random forest d’environ 1,41.
Pourquoi sépare-t-on les données en un set d’entraînement et un set de test ?
Pour mesurer l’erreur sur des données que le modèle n’a jamais vues. Évaluer un modèle sur les données qui ont servi à l’entraîner conduit au surentraînement (overfitting) : il mémorise les réponses au lieu d’apprendre des règles générales. Ici, 80 % des lignes servent à l’entraînement et 20 % au test.
Qu’est-ce que la fuite de données (data leakage) ?
C’est l’utilisation de colonnes qui ne peuvent être calculées qu’en connaissant déjà la valeur à prédire, par exemple bayes_average_rating, qui dérive de average_rating. Le modèle paraît excellent à l’entraînement mais ne se généralise pas aux données futures.
À quoi sert la PCA dans ce tutoriel ?
À réduire le nombre de colonnes à deux dimensions sans perdre trop d’information, pour pouvoir tracer les clusters sur un graphique. La PCA (analyse en composantes principales) est aussi très utilisée pour prétraiter les données avant un algorithme de Machine Learning.
Régression linéaire ou random forest : lequel choisir ?
La régression linéaire fonctionne bien quand les prédicteurs sont corrélés linéairement à la cible. Le random forest peut détecter des non-linéarités qu’elle ne voit pas : ici, il obtient une erreur d’environ 1,41 contre 1,82, donc de meilleures prédictions.
Envie d’aller plus loin en Machine Learning avec Python ?
Pour comprendre les algorithmes derrière les modèles, lis notre article sur les principaux modèles de Machine Learning expliqués simplement. Pour aller plus loin avec Python, consulte aussi notre guide des 21 astuces et concepts Python pour améliorer ton code. Pour maîtriser Pandas, découvre aussi nos 10 astuces Pandas en Python.
Super article, en suivant pas à pas les étapes, il est facile de comprendre les différents points.