Voici 8 concepts de Python et data science à ne pas oublier : ce sont les détails de Python, NumPy et Pandas qu’on finit toujours par chercher sur Internet.
Après cet article, ils n’auront plus de secret pour toi.
En bref : ces 8 concepts Python et data science sont ceux qu’on finit toujours par rechercher sur Internet : les compréhensions de liste, les fonctions lambda, map et filter, arange et linspace de NumPy, les axes (axis=0 pour les lignes, axis=1 pour les colonnes), concat, merge et join, apply et pivot_table de Pandas. Chacun est expliqué avec une courte description et un exemple.
Tu peux aussi exécuter les exemples des 8 concepts dans ce notebook Google Colab : chaque extrait de code est dans sa propre cellule, prêt à être modifié.
Pourquoi finit-on toujours par rechercher les mêmes concepts ?
Si tu t’es déjà retrouvé à te poser plusieurs fois la même question, ou à rechercher sans cesse la réponse sur le même concept ou la même syntaxe en programmant en Python, tu n’es pas seul.
J’ai envie de lister ici les détails importants qu’on a tendance à oublier quand on arrête de coder pendant quelques semaines.
Il est tout à fait normal et sain de consulter les questions/réponses de Stack Overflow ou d’autres ressources. Mais cela te ralentit un peu, et peut soulever des doutes sur ta compréhension du langage.
Nous vivons dans un monde où les ressources gratuites sont presque infinies : en une recherche Google, tu obtiens un résultat. C’est à la fois une bénédiction et une malédiction.
Quand ces ressources sont mal gérées (mauvaise sélection, par exemple), une dépendance excessive crée très vite de mauvaises habitudes à long terme.
Une autre mauvaise habitude consiste à copier/coller du code trouvé ici et là, plutôt que de prendre le temps de consolider le concept pour pouvoir reproduire le code toi-même la prochaine fois.
Cette approche est géniale à court terme, mais elle finira par nuire à ta progression, à ta productivité et à ta capacité à retenir la syntaxe sur la durée.
Quel est l’objectif de cet article ?
Voyons les concepts et les points de syntaxe les plus souvent négligés lors de l’analyse de données en Python.
L’objectif : consolider ta compréhension de ces concepts une fois pour toutes, et t’épargner quelques recherches sur Stack Overflow. Voici ce qu’on oublie toujours en travaillant avec Python, NumPy et Pandas.
J’ai retenu 8 concepts qui, à mon sens, sont importants en programmation Python et qu’on a tendance à mettre de côté. Chacun est expliqué de façon concise : une courte description et un exemple.
1. Comment créer une liste en une seule ligne avec une compréhension de liste ?
Écrire une boucle for chaque fois que tu as besoin de définir une liste est fastidieux. Heureusement, Python permet de le faire en une seule ligne de code.
La syntaxe peut paraître difficile au début, mais une fois familiarisé avec cette technique, tu l’utiliseras très souvent.
Regarde l’exemple ci-dessous, qui présente les deux syntaxes : la création d’une liste en plusieurs lignes, puis la compréhension de liste en une seule ligne.
Dans cet exemple, on souhaite mettre au carré les nombres impairs d’une liste. Soit numbers une liste contenant quelques nombres :
numbers = [1, 2, 3, 4, 5]

squared_odds = []

for n in numbers:
    if n % 2 == 1:
squared_odds.append(n ** 2)Ce code fait plusieurs choses :
- on assigne une liste vide à la variable
squared_odds; - on y ajoute les valeurs correspondantes avec la méthode
append; - on exécute une boucle
forpour parcourir les éléments de la listenumbers; - on vérifie avec une condition
ifque le nombre est impair.
Avec une compréhension de liste, ce code devient :
numbers = [1, 2, 3, 4, 5]

squared_odds = [n ** 2 for n in numbers if n % 2 == 1]2. Qu’est-ce qu’une fonction lambda ?
En Python, une fonction lambda est une fonction « anonyme » : elle n’est pas définie par un nom.
Alors que les fonctions « normales » sont définies avec le mot-clé def suivi du nom de la fonction, les fonctions anonymes sont définies avec le mot-clé lambda.
À quoi elles servent ?
Les fonctions lambda servent à créer de petites fonctions ponctuelles et anonymes. Elles te permettent d’appliquer une fonction sans avoir à la définir.
La syntaxe de base des fonctions lambda est :
lambda arguments: expressionUne fonction lambda peut faire tout ce que fait une fonction normale, à condition de tenir en une seule expression.
Voici un exemple simple :
double = lambda x: x * 2
print(double(5))103. Comment utiliser map et filter avec une fonction lambda ?
Une fois que tu maîtrises les fonctions lambda, les associer aux fonctions map et filter est très puissant.
Que fait la fonction map ?
La fonction map prend une liste et la transforme en une nouvelle liste, en effectuant une opération sur chaque élément (à partir d’une fonction lambda).
Dans l’exemple ci-dessous, map parcourt chaque élément d’une liste et retourne une nouvelle liste dans laquelle chaque élément est multiplié par 2. Note que la fonction list convertit le résultat en objet de type liste.
# map
seq = [1, 2, 3, 4, 5]

result = list(map(lambda var: var*2, seq))
print(result)[2, 4, 6, 8, 10]Que fait la fonction filter ?
La fonction filter prend une liste et applique une règle (une condition). Comme map, sauf qu’elle renvoie un sous-ensemble de la liste d’origine : les éléments pour lesquels la règle est vraie.
Dans l’exemple ci-dessous, la règle est une fonction qui ne garde que les valeurs supérieures à 2. On obtient donc la sous-liste des valeurs plus grandes que 2.
# filtrer
seq = [1, 2, 3, 4, 5]

result = list(filter(lambda x: x > 2, seq))
print(result)[3, 4, 5]4. Quelle différence entre arange et linspace ?
Pour créer des tableaux NumPy rapidement, ne cherche pas plus loin que les fonctions arange et linspace. Chacune a un but précis, mais on les préfère à la fonction range car elles produisent des tableaux NumPy, plus faciles à utiliser en Data Science.
Que fait arange ?
arange renvoie des valeurs espacées uniformément dans un intervalle donné. En plus d’un point de départ (start) et d’arrêt (stop), tu peux définir une taille de pas (step) ou un type de données.
Note que le point d’arrêt est une valeur de « coupure » : il n’est pas inclus dans le tableau résultant.
import numpy as np

# np.arange(start, stop, step)
np.arange(3, 7, 2)array([3, 5])Que fait linspace ?
linspace est très similaire, avec une légère différence : il renvoie des nombres espacés uniformément sur un intervalle spécifié. Étant donné un point de départ (start), un point d’arrêt (stop) et un nombre de valeurs (num), il les espace équitablement et renvoie un tableau NumPy contenant exactement num valeurs.
Cette fois-ci, la valeur stop est présente dans le tableau résultant. C’est particulièrement utile pour les visualisations de données et les axes de graphiques.
import numpy as np

# np.linspace(start, stop, num)
np.linspace(2.0, 3.0, num=5)array([2. , 2.25, 2.5 , 2.75, 3. ])5. Que signifient axis=0 et axis=1 ?
Tu as peut-être déjà rencontré ce problème en supprimant une colonne d’un DataFrame Pandas ou en additionnant des valeurs dans une matrice NumPy. Sinon, tu y seras confronté un jour.
Prenons l’exemple de la suppression d’une ligne ou d’une colonne :
import pandas as pd

df = pd.DataFrame({'Column A': [1, 2, 3], 'Column B': [4, 5, 6]}, index=['Row A', 'Row B', 'Row C'])

# supprimer une ligne (axis=0)
print(df.drop('Row A', axis=0))

# supprimer une colonne (axis=1)
print(df.drop('Column A', axis=1))Combien de fois as-tu écrit cette ligne sans savoir ce qu’elle signifiait ? Comme tu peux le déduire, on définit axis=1 pour traiter les colonnes et axis=0 pour les lignes. Mais pourquoi ?
Voici une astuce pour s’en souvenir : regarde l’attribut shape.
df.shape(nombre de lignes, nombre de colonnes)L’attribut shape d’un DataFrame renvoie un tuple : le nombre de lignes en première position (indice 0), le nombre de colonnes en deuxième (indice 1). C’est exactement la logique de l’axe : axis=0 pour les lignes, axis=1 pour les colonnes.
6. Quelle différence entre concat, merge et join ?
Si tu es familier avec SQL, ces concepts te seront plus faciles. Ces fonctions sont des moyens de combiner des données de manière spécifique, et il n’est pas toujours évident de savoir laquelle utiliser et quand.
Concat
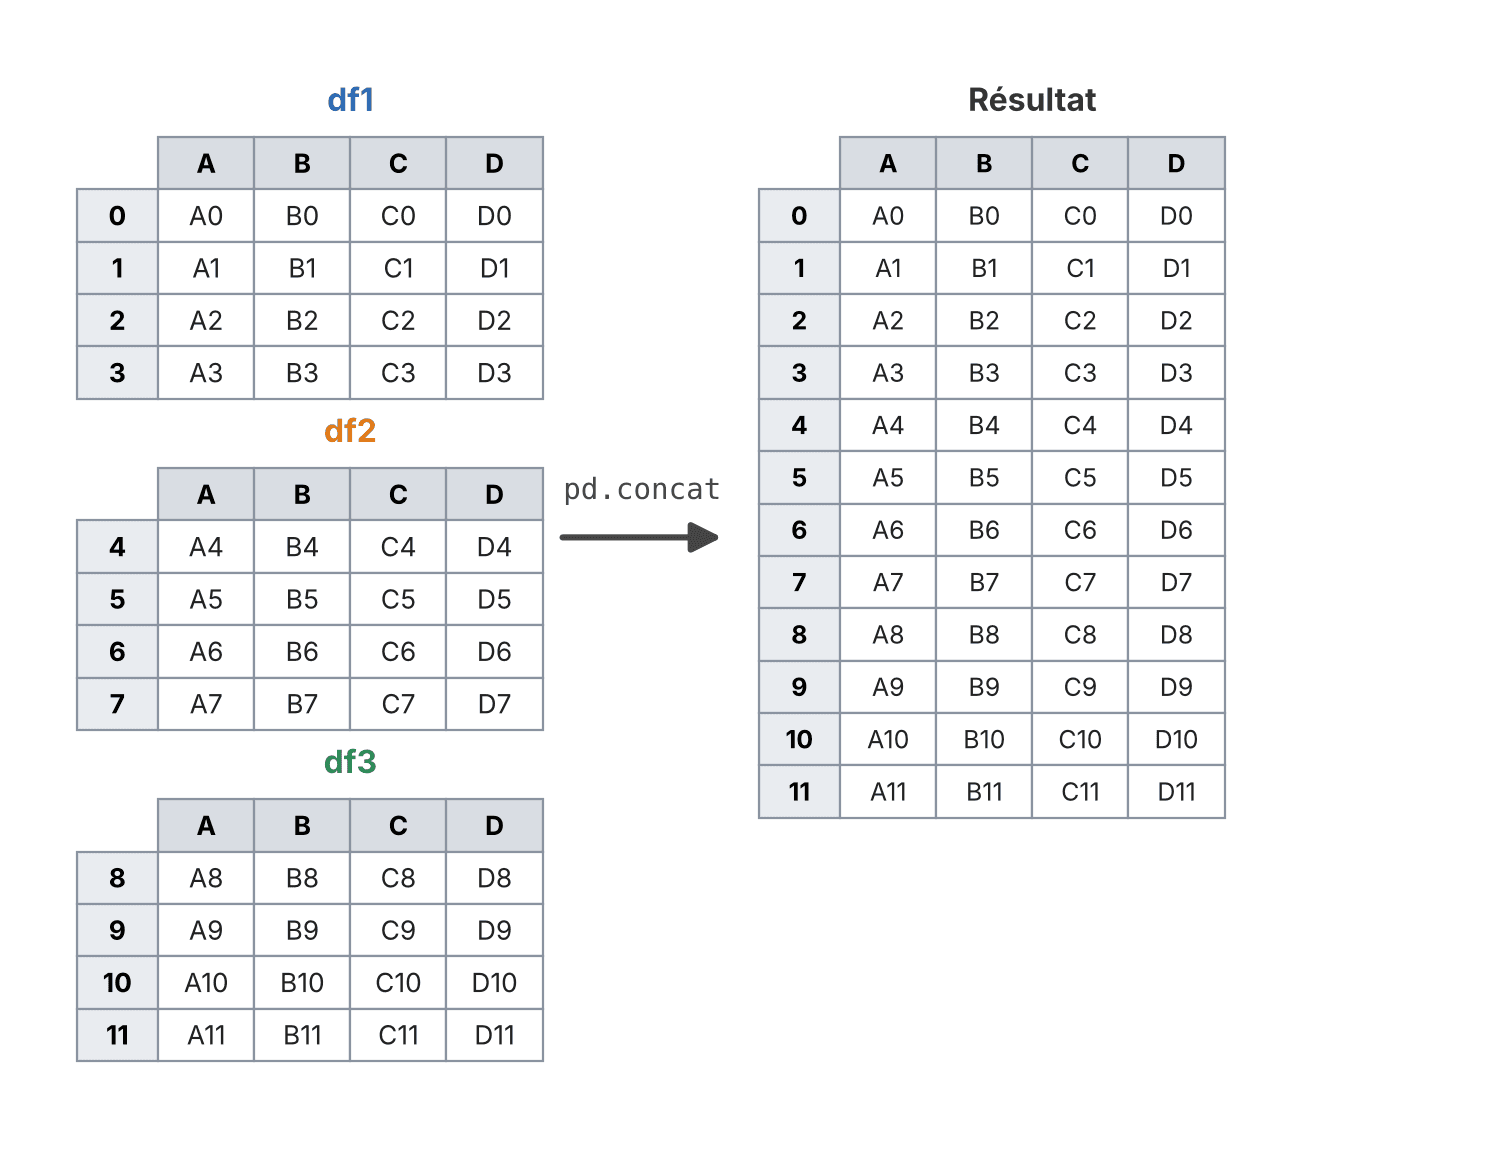
concat permet d’ajouter un ou plusieurs DataFrames les uns aux autres, en dessous ou à côté (selon la valeur de axis).
Merge
merge combine plusieurs DataFrames sur une ou plusieurs colonnes communes, qui servent de clé de jointure.
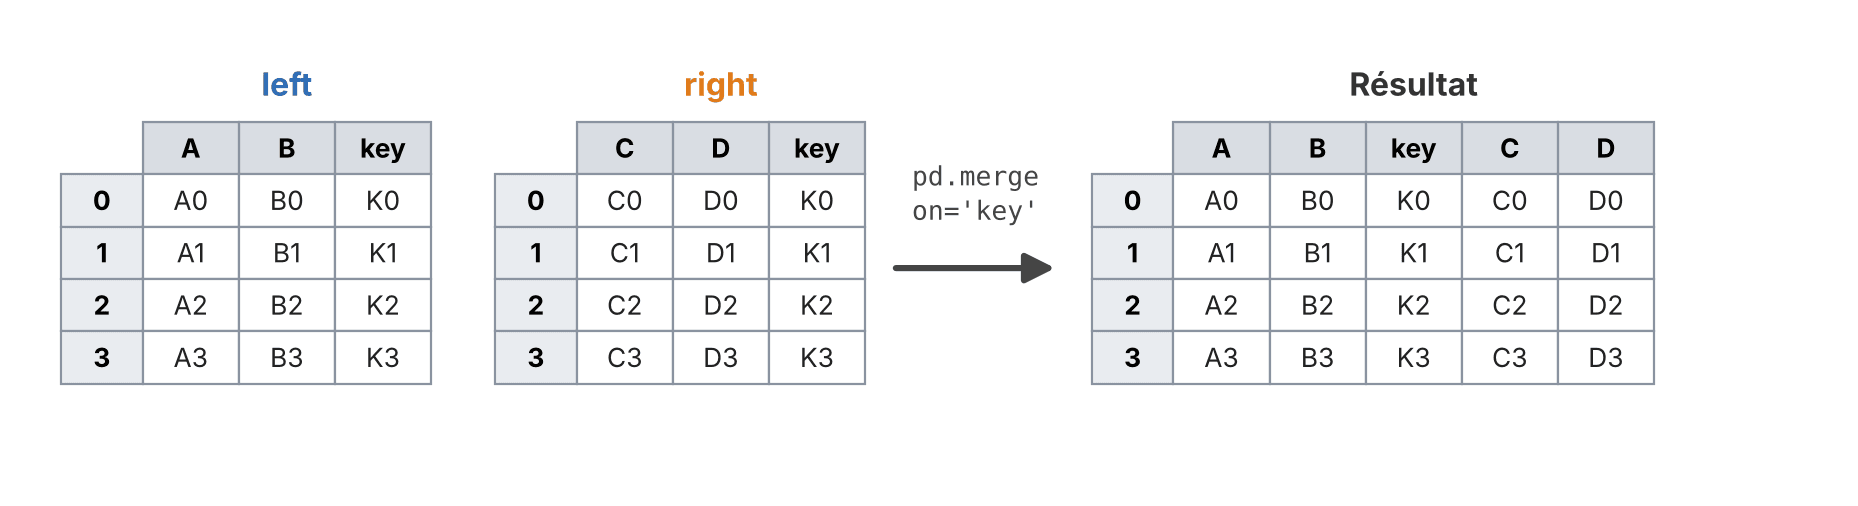
Join
join, tout comme merge, combine deux DataFrames. Mais il les joint en fonction de leurs index, plutôt que d’une colonne spécifiée.
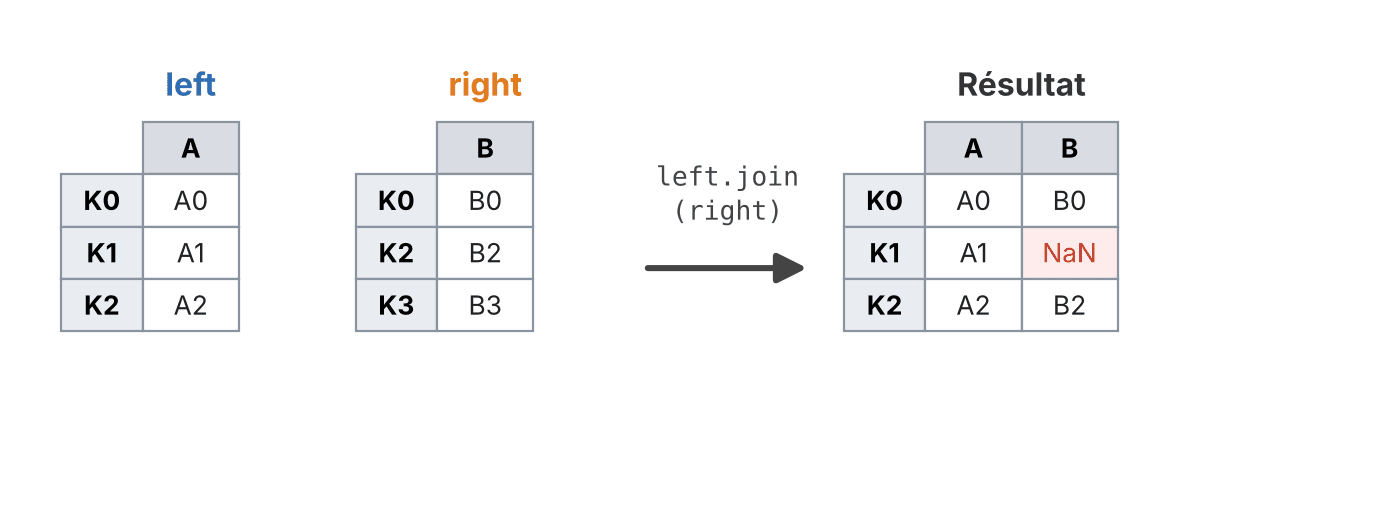
Par défaut, join garde toutes les lignes du DataFrame de gauche : l’index K1 n’existe pas à droite, d’où le NaN dans le résultat.
Pour d’autres syntaxes, des exemples plus concrets et des cas particuliers, consulte l’excellente documentation Pandas.
7. À quoi sert apply dans Pandas ?
apply ressemble à map, mais adaptée aux DataFrames Pandas, ou plus précisément aux objets Series (assez similaires aux tableaux NumPy).
apply applique une fonction à chaque élément d’une colonne ou d’une ligne, selon le paramètre axis. C’est très utile pour formater et manipuler les valeurs d’une colonne entière, sans écrire de boucle.
Pour plus de détails et d’exemples sur la méthode apply, consulte le parcours Analyse et visualisation des données de DataXp.
8. Comment créer un tableau croisé dynamique avec pivot_table ?
Dernier point, mais non des moindres : les tableaux croisés dynamiques. Si tu connais Microsoft Excel, tu en as sûrement déjà entendu parler.
La fonction Pandas pivot_table crée un tableau croisé dynamique, de type feuille de calcul, sous forme de DataFrame. Les niveaux du tableau sont stockés dans des objets MultiIndex sur l’index et les colonnes du DataFrame résultant.
Questions fréquentes sur ces concepts Python et data science
Quelle est la différence entre arange et linspace en NumPy ?
arange prend un point de départ, un point d’arrêt (exclu du résultat) et un pas. linspace prend un point de départ, un point d’arrêt (inclus) et un nombre de valeurs, et renvoie exactement ce nombre de valeurs espacées uniformément. linspace est utile pour les axes de graphiques.
Que signifient axis=0 et axis=1 dans Pandas et NumPy ?
axis=0 désigne les lignes et axis=1 les colonnes. Pour t’en souvenir, regarde l’attribut shape : c’est un tuple avec le nombre de lignes en position 0 et le nombre de colonnes en position 1.
Quelle est la différence entre concat, merge et join dans Pandas ?
concat ajoute des DataFrames les uns aux autres, en dessous ou à côté selon axis. merge les combine sur une ou plusieurs colonnes communes qui servent de clé. join les combine selon leurs index plutôt que selon une colonne.
Qu’est-ce qu’une fonction lambda en Python ?
C’est une fonction anonyme, définie avec le mot-clé lambda au lieu de def. Elle peut faire tout ce que fait une fonction normale, à condition de tenir en une seule expression, et sert à créer de petites fonctions ponctuelles.
Que font map et filter en Python ?
map applique une opération à chaque élément d’une liste et renvoie les résultats transformés. filter applique une condition et renvoie le sous-ensemble des éléments pour lesquels elle est vraie. On convertit le résultat avec list pour l’afficher.
Que retenir de ces 8 concepts Python et data science ?
C’est tout pour cet article. J’espère que ces quelques aperçus t’ont permis de te familiariser avec ces méthodes, fonctions et concepts importants, ou de les revoir.
Tu les rencontreras très fréquemment en utilisant Python pour la Data Science.
Pour aller plus loin avec Python, consulte aussi notre guide des 21 astuces et concepts Python pour améliorer ton code, ainsi que nos 10 astuces Pandas et notre article sur la Data Science avec Pandas.