Dans ce tutoriel, tu vas apprendre à scraper Amazon avec Python : construire un scraper qui extrait le nom, la catégorie, les prix et la disponibilité d’un produit à partir de l’URL de sa page. On utilise deux outils : Requests pour télécharger la page et SelectorLib pour en extraire les données.
Ce tutoriel est adapté de celui de ScrapeHero. Avant de coder, voyons à quoi servent ces données.
Avant de commencer : scraper un site, c’est automatiser des requêtes vers ses serveurs. Les conditions d’utilisation d’Amazon restreignent l’extraction automatisée de données, et son fichier robots.txt limite l’accès à de nombreuses pages. Consulte-les, et garde ce code pour apprendre et pour des volumes très modestes. Pour des usages sérieux, passe plutôt par l’API officielle d’Amazon ou par un fournisseur de données autorisé. Pour t’entraîner sans risque, utilise un site conçu pour ça comme books.toscrape.com. Et dans ce tutoriel, on teste le code sur une page locale.
En bref : pour scraper Amazon avec Python, tu décris les données à extraire (nom, catégorie, prix d’origine, prix de vente, disponibilité) dans un fichier YAML créé avec l’extension Chrome SelectorLib, puis tu télécharges la page avec Requests et tu en extrais les valeurs avec la bibliothèque selectorlib. Attention : les conditions d’utilisation d’Amazon restreignent l’extraction automatisée. Garde ce code pour apprendre et pour des volumes très modestes, et utilise l’API officielle ou un fournisseur de données autorisé pour un usage sérieux.
Tu peux aussi exécuter tous ces exemples dans ce notebook Google Colab : chaque extrait de code est dans sa propre cellule, prêt à être modifié.
À quoi servent les données des produits Amazon ?
- Récupérer des détails que l’API officielle ne fournit pas. Amazon propose une API de publicité des produits, mais, comme la plupart des API, elle ne donne pas toutes les informations affichées sur une page produit. Un scraper extrait tout ce que la page montre.
- Surveiller les changements de prix, de stock, de classement… En mettant à jour régulièrement tes données, tu suis l’évolution d’un produit. Ces flux t’aident à construire une stratégie de prix en observant tes concurrents, vendeurs ou marques.
- Analyser comment se vend une marque sur Amazon. Si tu es détaillant, tu peux suivre les produits de tes concurrents, ajuster tes prix et vérifier comment tes propres produits sont vendus par des revendeurs.
- Exploiter les avis clients. Les avis contiennent beaucoup d’informations : en les analysant sur les produits de vendeurs établis, tu repères ce qu’il faut éviter et ce que tu peux améliorer sur des produits similaires.
Les possibilités d’utilisation de ces données sont presque illimitées.
Quelles données peut-on extraire d’Amazon ?
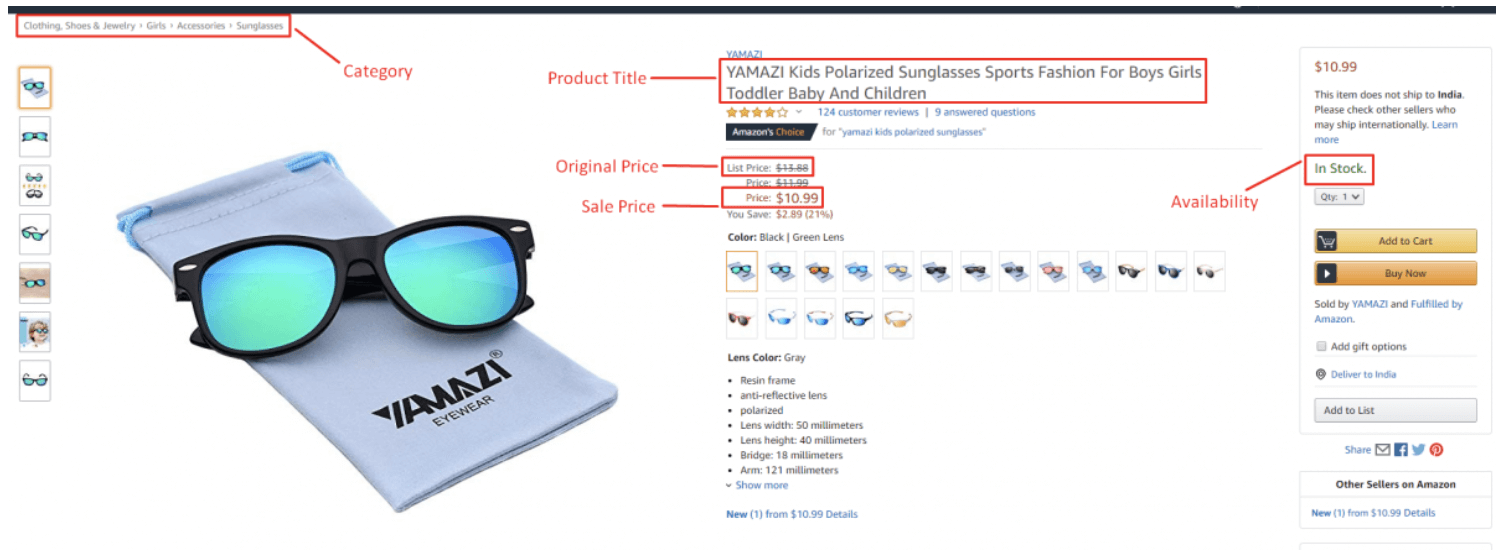
Ce tutoriel se limite à l’extraction des données suivantes, à partir d’une page produit :
- Nom du produit
- Catégorie
- Prix d’origine
- Prix de vente
- Disponibilité
Tu vas construire un scraper capable d’extraire ces détails à partir de l’URL de n’importe quelle page produit.
Comment préparer ton environnement pour scraper Amazon ?
Il te faut Python 3 et son gestionnaire de paquets pip. Vérifie ta version dans un terminal :
python3 --versionSi Python n’est pas installé, télécharge-le sur python.org. Installe ensuite les deux paquets nécessaires :
pip install requests selectorlibrequeststélécharge le contenu HTML des pages ;selectorliblit un fichier YAML qui décrit les données à extraire, puis les récupère dans le HTML.
Qu’est-ce que SelectorLib ?
SelectorLib est la combinaison de deux outils :
- une extension Chrome qui te permet de marquer des données sur une page web et d’exporter un fichier YAML ;
- une bibliothèque Python qui lit ce fichier YAML et extrait les données marquées.
Au lieu d’inspecter le HTML et d’écrire un sélecteur XPath pour chaque donnée, tu utilises le paquet Python SelectorLib et son extension Chrome.
Comment créer le fichier YAML avec SelectorLib ?
Le fichier YAML décrit où se trouve chaque donnée dans la page produit.
Installer l’extension et créer un modèle
Après avoir installé l’extension SelectorLib, ouvre Chrome et va sur la page du produit dont tu veux extraire les données. Fais un clic droit n’importe où, choisis « Inspecter » : la console des outils de développement s’ouvre. Clique ensuite sur l’onglet « Selectorlib ».
Sélectionne « Créer un modèle » et donne-lui un nom. Ici, on l’appelle amazon.
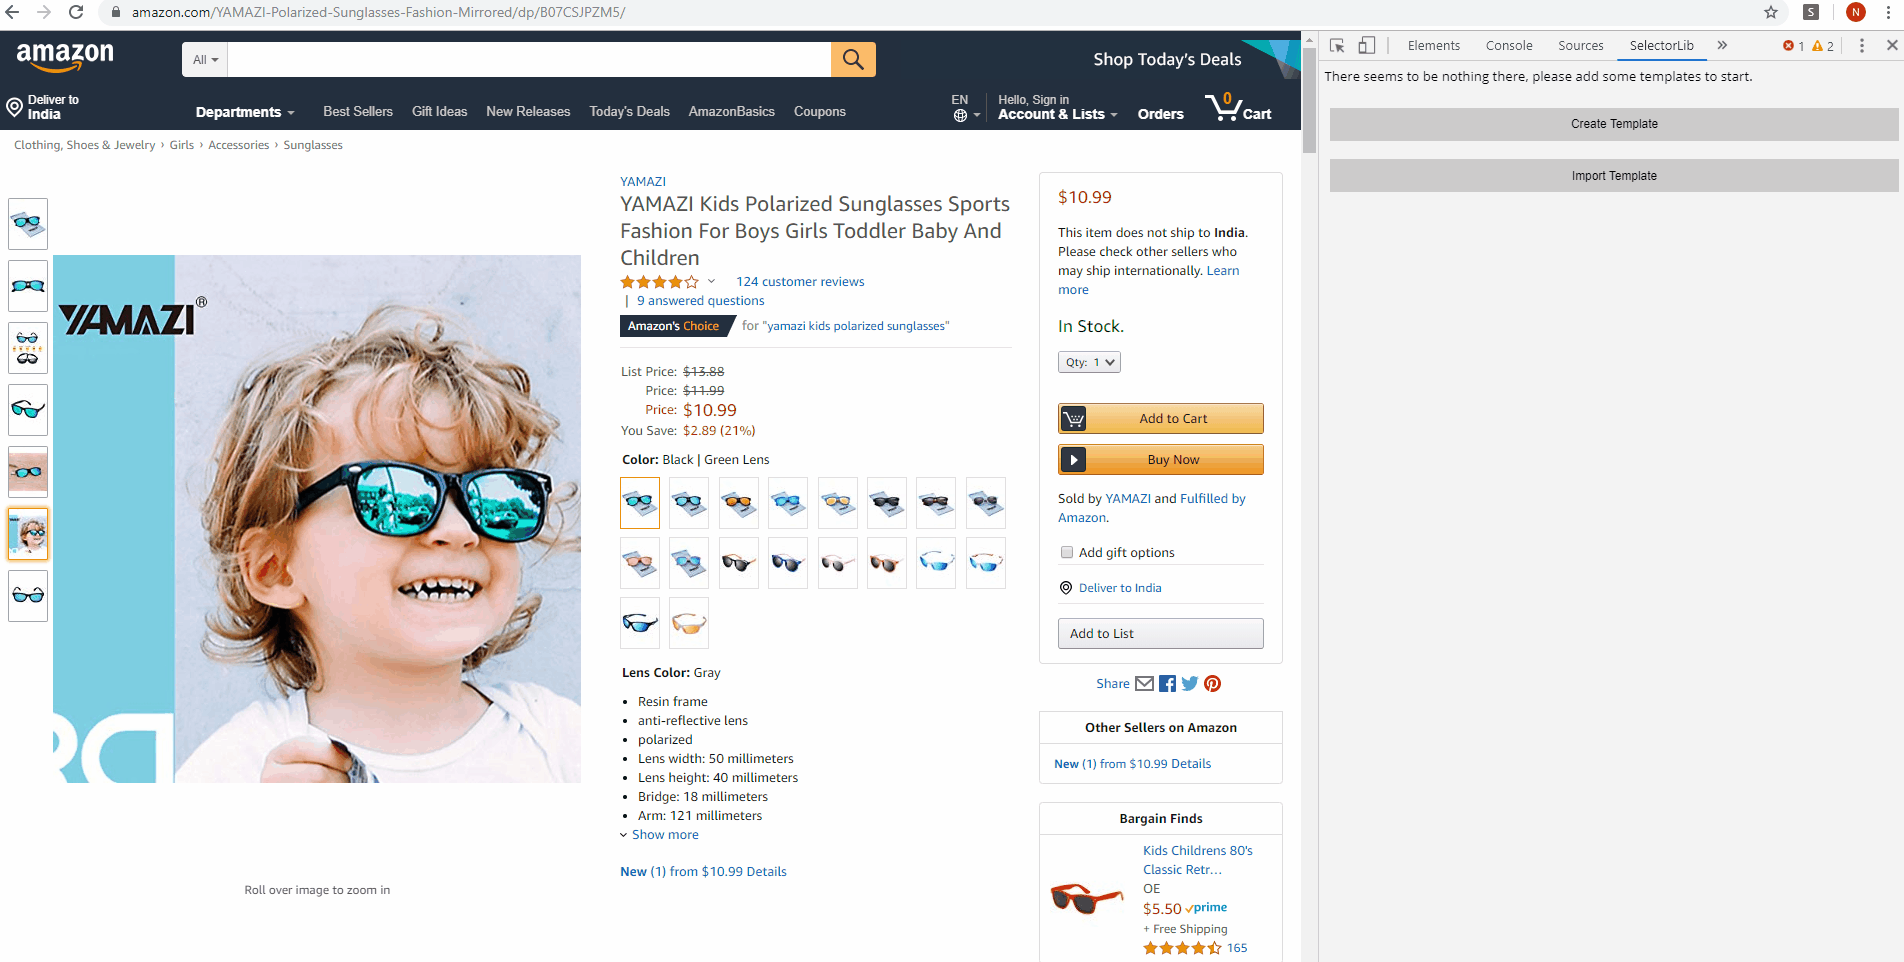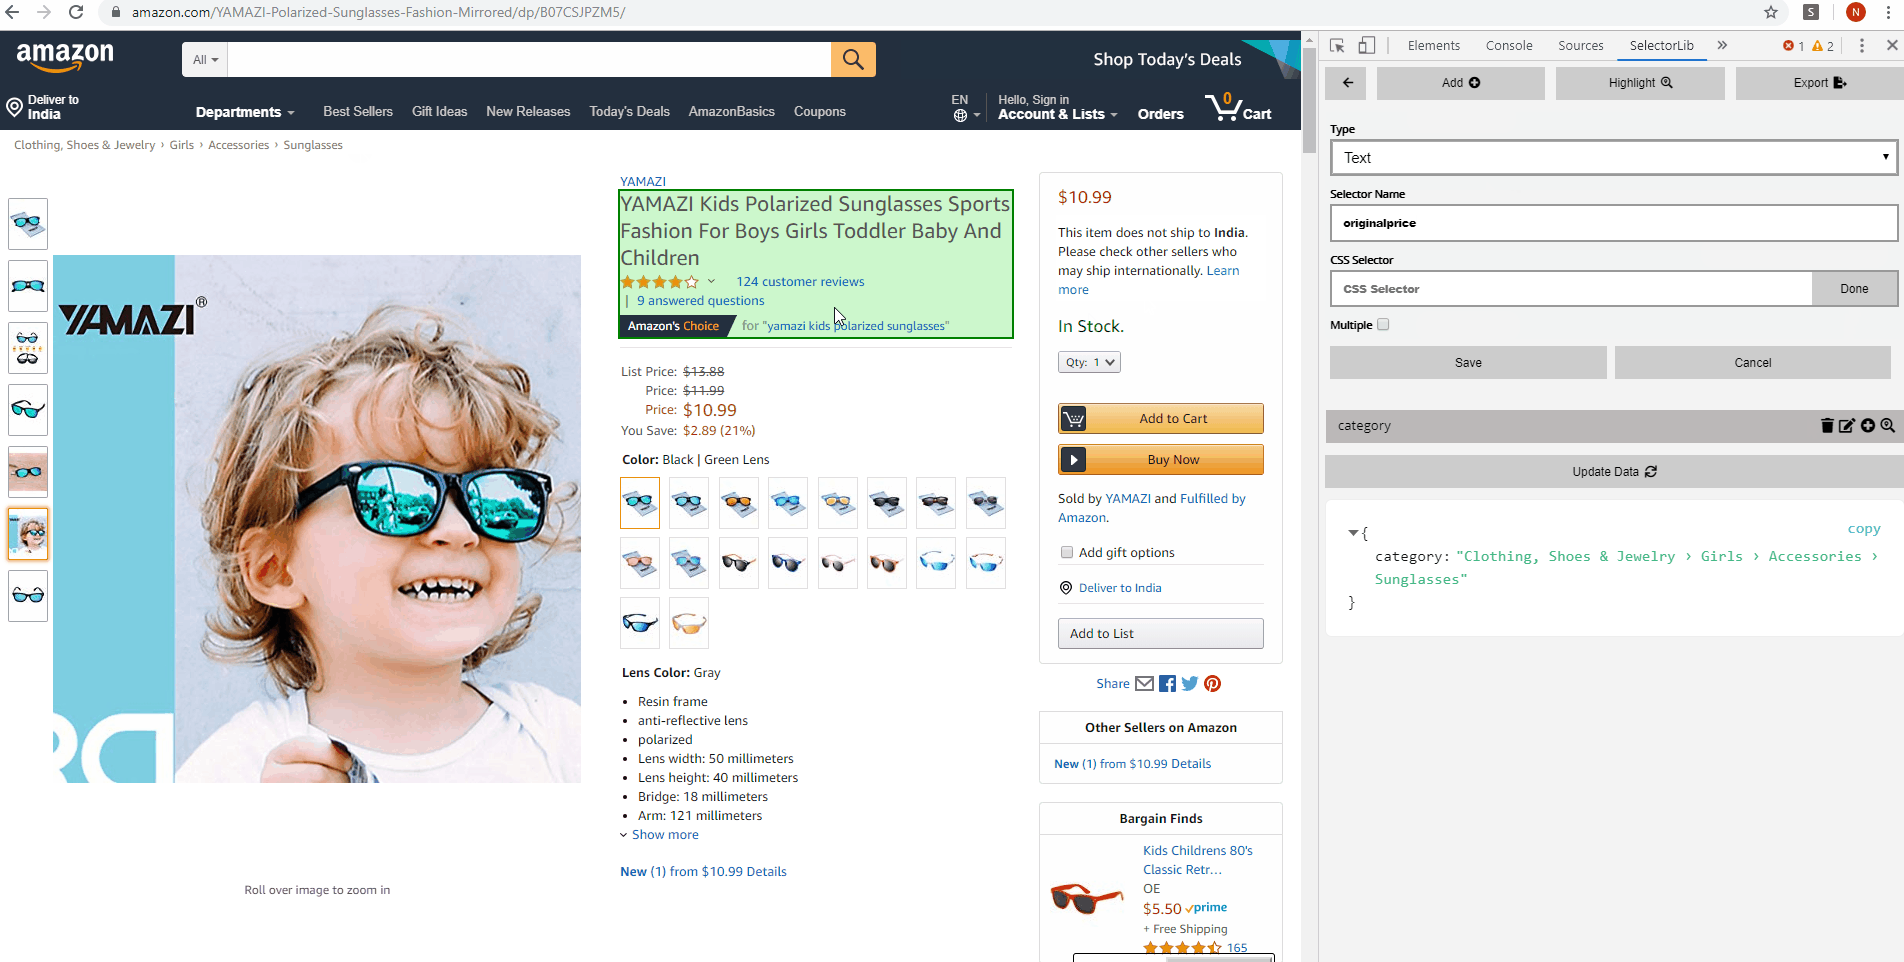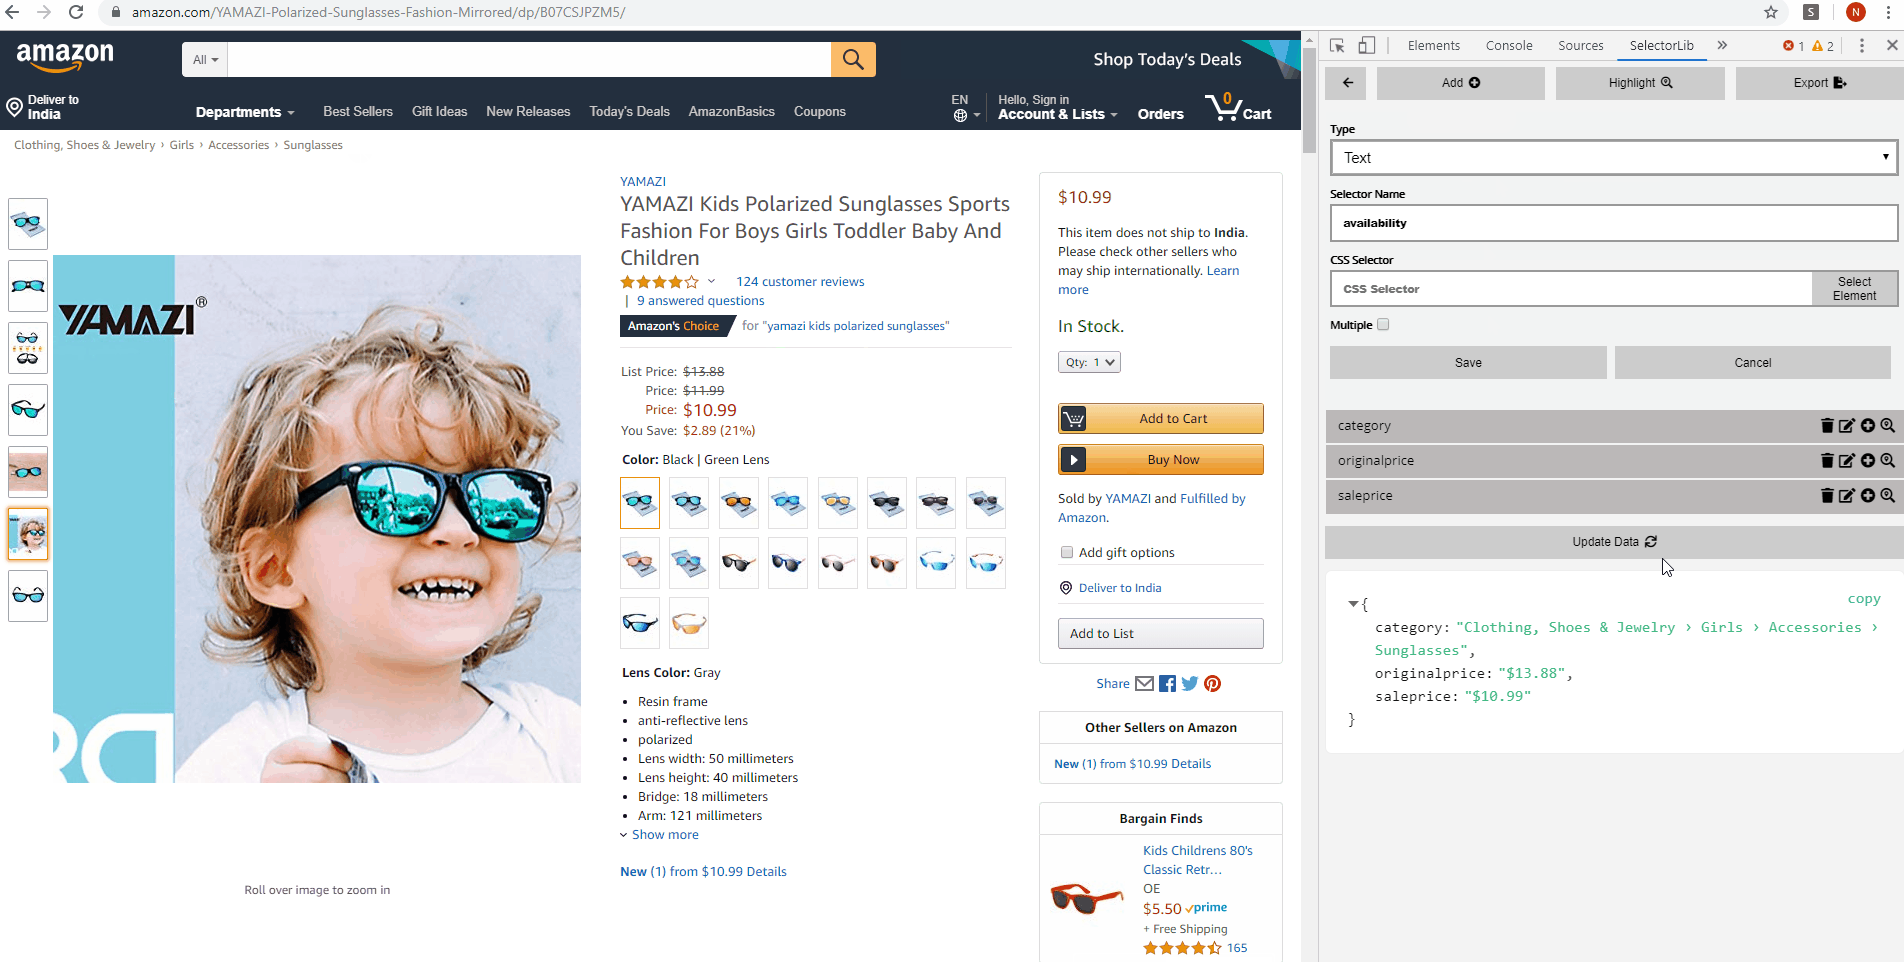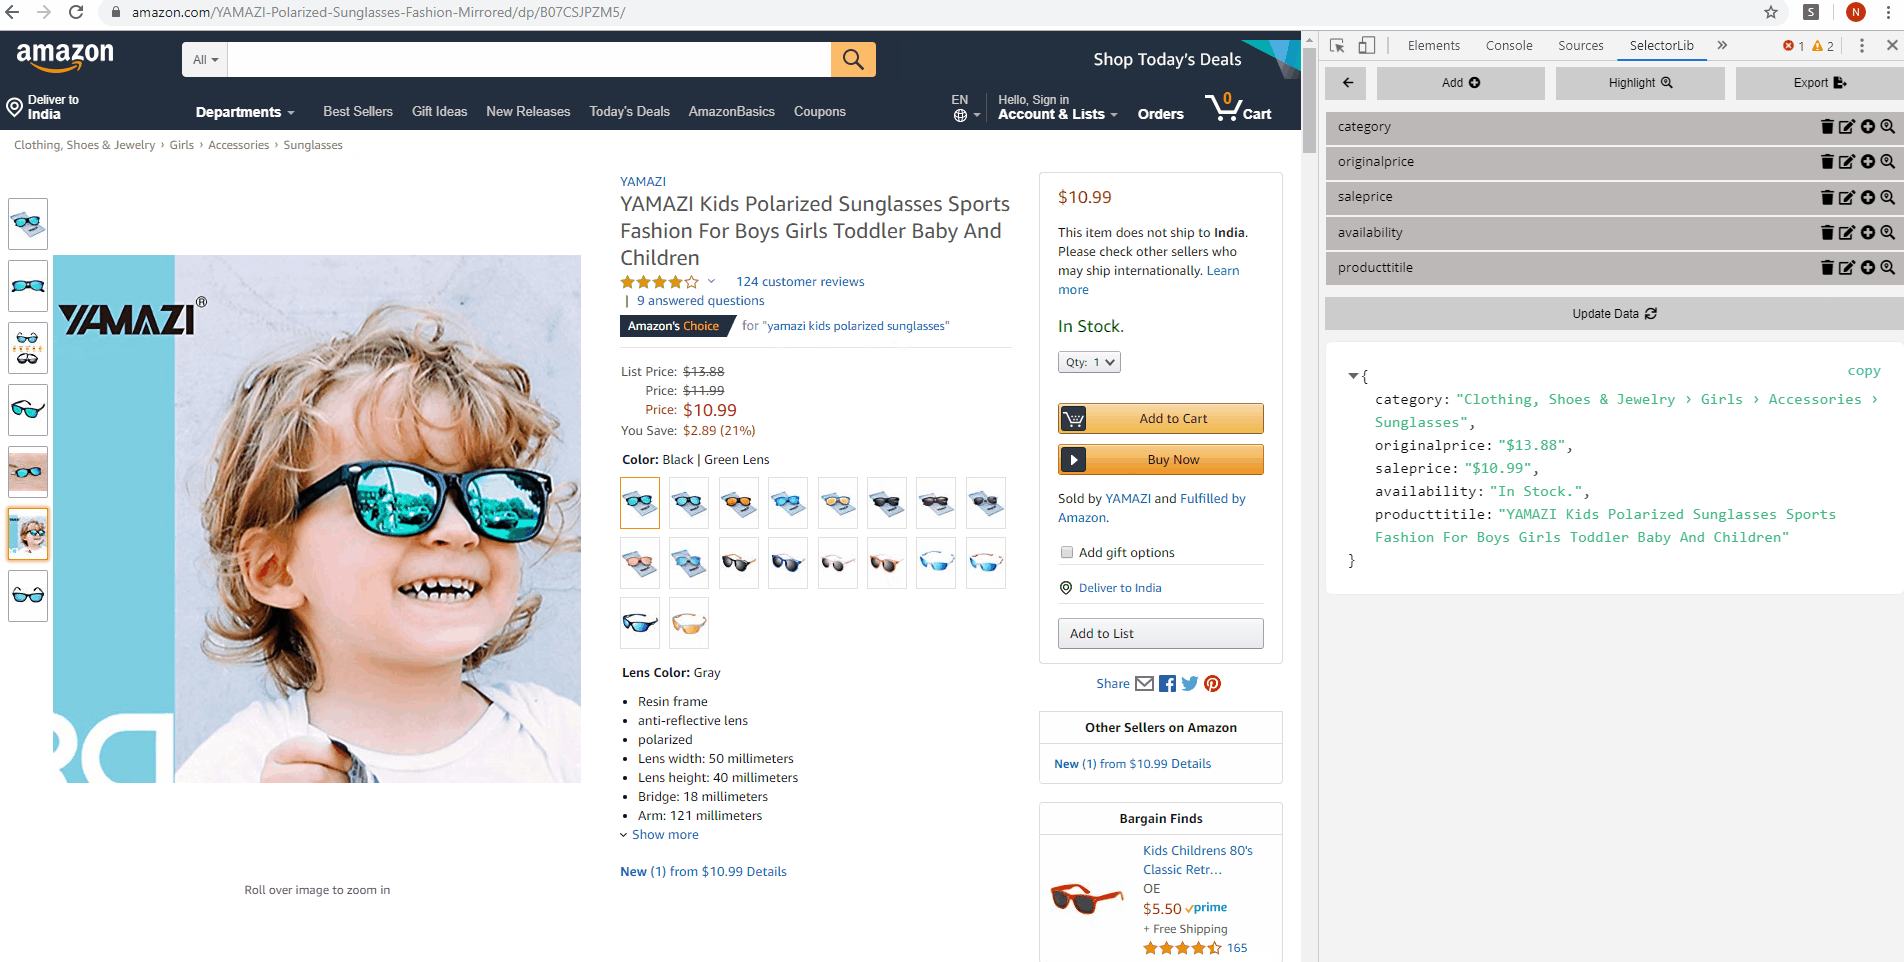
Ajoute ensuite les données une par une : choisis un type, saisis le nom du sélecteur, clique sur « Sélectionner un élément » et survole la page. Quand l’élément voulu est surligné en vert, clique dessus puis sur « Enregistrer ». Le GIF ci-dessus montre la manipulation.
Vérifier les données et exporter
Une fois le modèle créé, clique sur « Highlight » pour mettre en évidence et prévisualiser tous tes sélecteurs. Clique enfin sur « Exporter » et télécharge le fichier YAML.
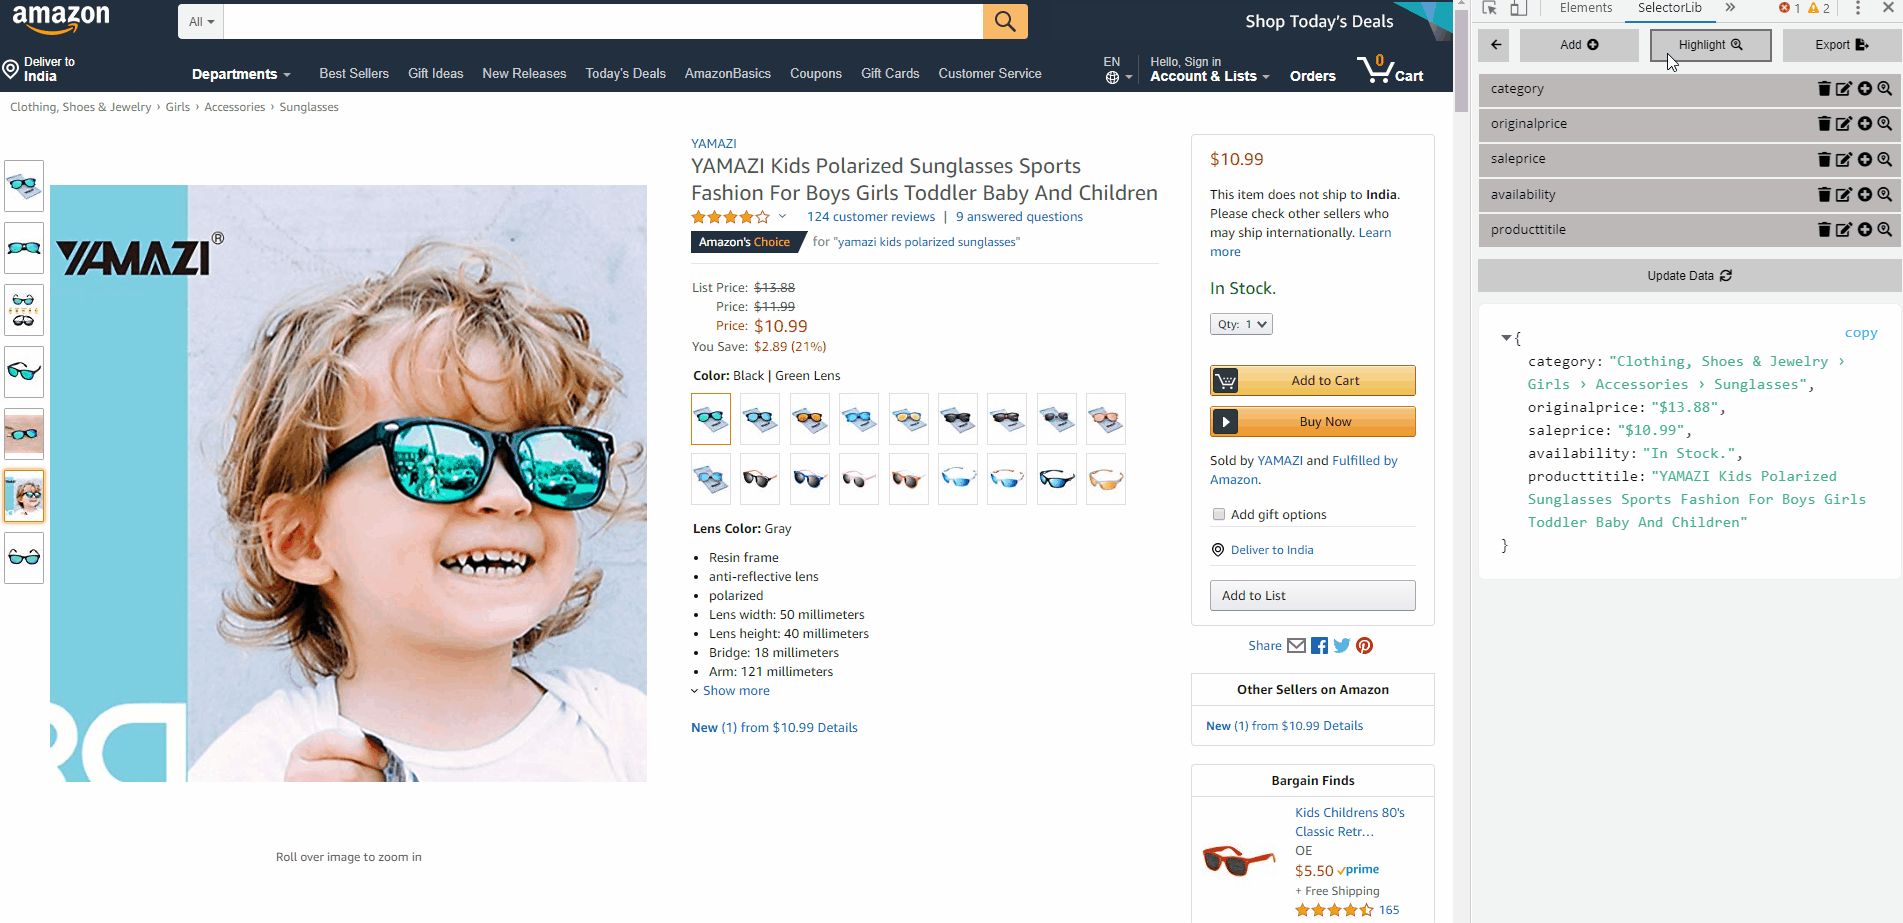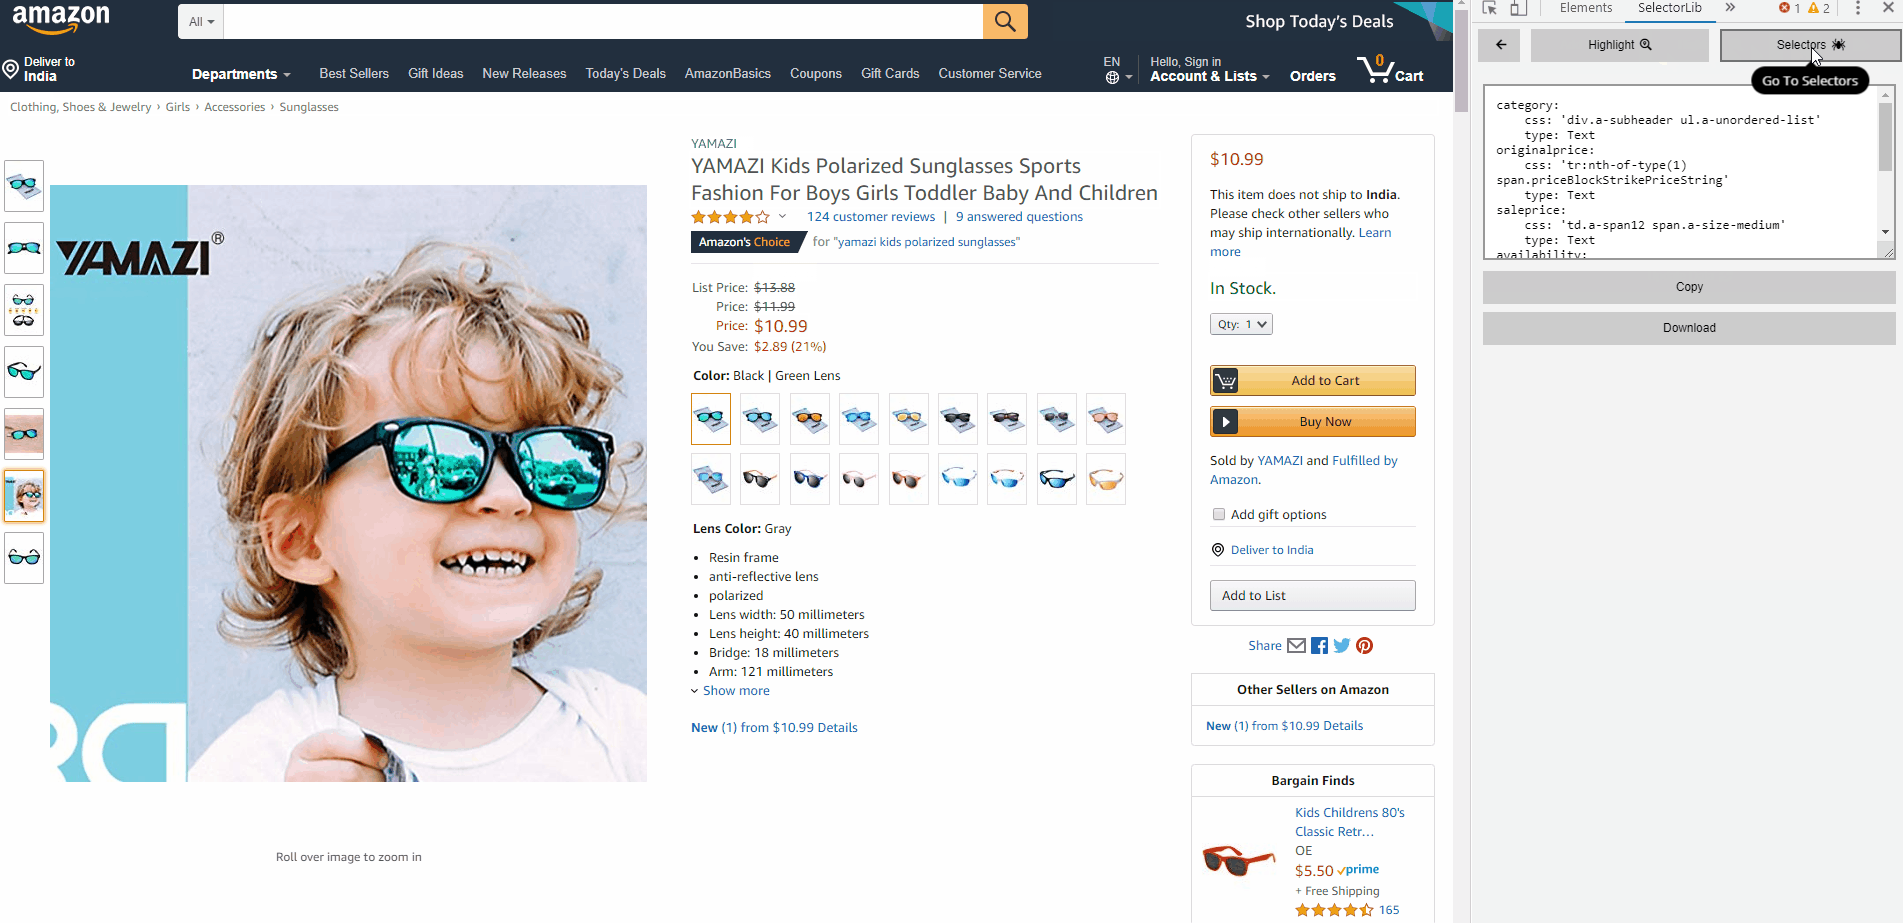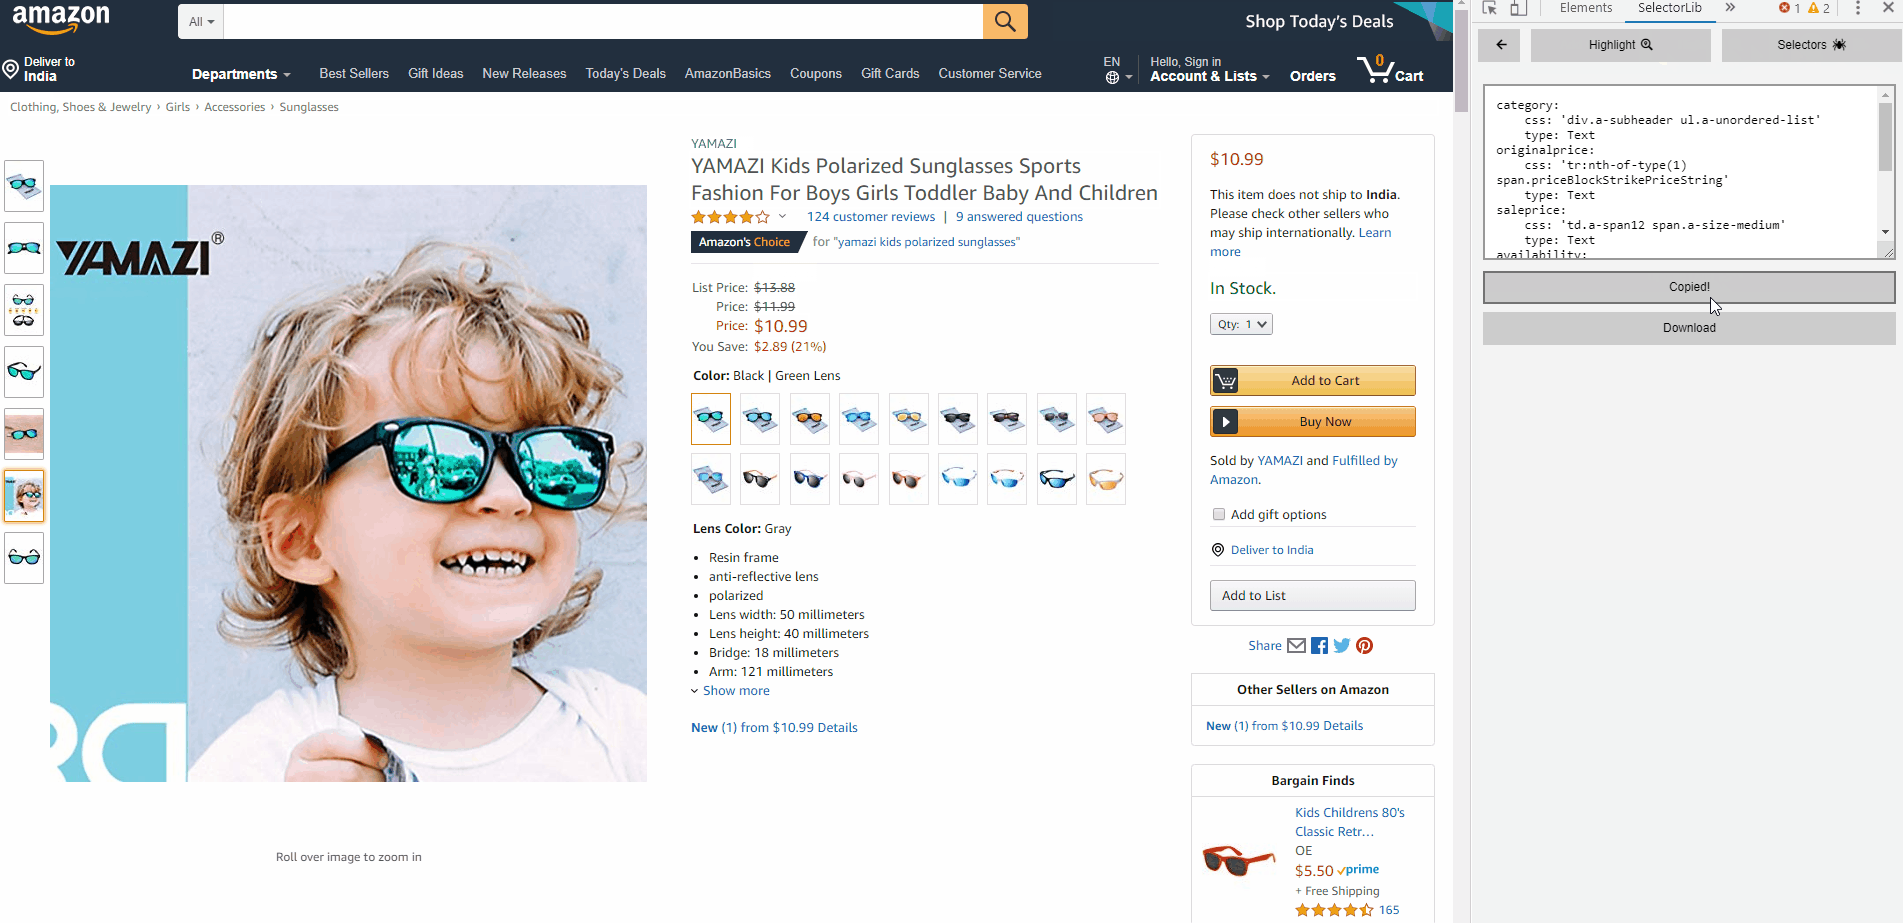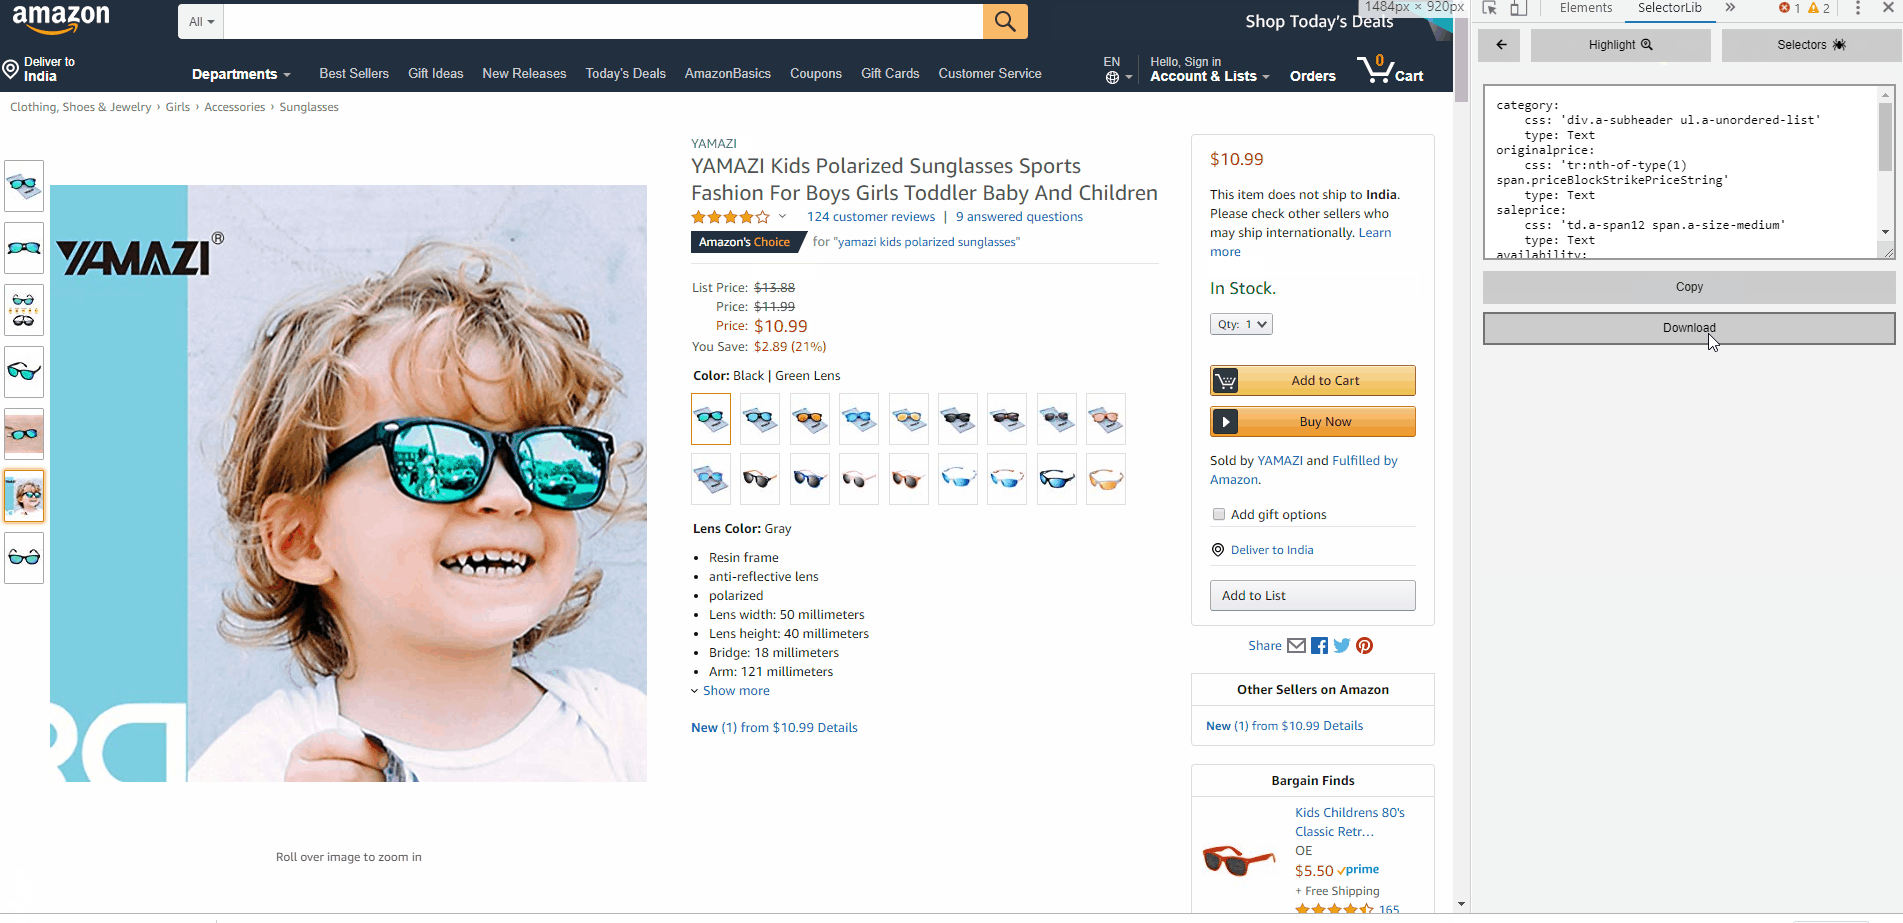
Pour en savoir plus sur l’extension, consulte le guide de démarrage de SelectorLib.
Voici à quoi ressemble le fichier, que l’on enregistre sous le nom selectors.yml :
category:
    css: 'div.a-subheader ul.a-unordered-list'
    type: Text
original_price:
    css: span.priceBlockStrikePriceString
    type: Text
name:
    css: span.a-size-large
    type: Text
sale_price:
    css: 'td.a-span12 span.a-size-medium'
    type: Text
availability:
    css: 'div.feature div.a-section div.feature div.a-section div.a-section span.a-size-medium'
type: TextAttention : Amazon modifie régulièrement le code HTML de ses pages. Les sélecteurs ci-dessus peuvent ne plus correspondre : si une valeur ressort vide, régénère le fichier avec l’extension.
Quel code Python pour scraper un produit Amazon ?
Le script est découpé en deux fonctions : telecharger() récupère le HTML de la page, et extraire() en tire les données décrites dans selectors.yml. Enregistre-le sous le nom scraper.py :
import argparse
import json

import requests
from selectorlib import Extractor

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                  "(KHTML, like Gecko) Chrome/124.0 Safari/537.36",
    "Accept-Language": "fr-FR,fr;q=0.9,en;q=0.8",
}


def telecharger(url):
    """Télécharge le HTML de la page."""
    reponse = requests.get(url, headers=HEADERS, timeout=10)
    reponse.raise_for_status()
    # Sans encodage indiqué par le serveur, requests suppose ISO-8859-1 : on force l'UTF-8
    reponse.encoding = "utf-8"
    return reponse.text


def extraire(html, fichier_yaml="selectors.yml"):
    """Extrait les données décrites dans le fichier YAML."""
    extracteur = Extractor.from_yaml_file(fichier_yaml)
    return extracteur.extract(html)


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="Extrait les détails d'un produit à partir de l'URL de sa page")
    parser.add_argument("url", help="URL de la page produit")
    args = parser.parse_args()

    donnees = extraire(telecharger(args.url))
print(json.dumps(donnees, indent=4, ensure_ascii=False))timeout=10évite que le script attende indéfiniment une réponse ;raise_for_status()déclenche une erreur si le serveur répond par un code d’échec (404, 503…) ;- l’en-tête
User-Agentindique quel navigateur envoie la requête ; reponse.encodingforce l’UTF-8, pour éviter des accents mal décodés quand le serveur n’indique pas d’encodage ;argparsepermet de passer l’URL en argument depuis le terminal.
Comment exécuter le scraper ?
Pour afficher l’aide du script, tape son nom suivi de -h dans le terminal :
python3 scraper.py -husage: scraper.py [-h] url
Extrait les détails d'un produit à partir de l'URL de sa page
positional arguments:
url URL de la page produit
options:
-h, --help show this help message and exitPour extraire les détails d’un produit, donne-lui l’URL de sa page :
python3 scraper.py https://www.amazon.com/dp/IDENTIFIANT-DU-PRODUITLe script affiche les données au format JSON dans le terminal.
Comment tester le scraper sans interroger Amazon ?
Pour vérifier que tout fonctionne sans envoyer de requêtes à Amazon, on peut utiliser une page de test fictive et simplifiée, dont la structure reprend les classes utilisées par notre fichier YAML. Enregistre-la sous le nom page_test.html :
<html>
  <body>
    <div class="a-subheader">
      <ul class="a-unordered-list">
        <li>Vêtements › Filles › Accessoires › Lunettes de soleil</li>
      </ul>
    </div>
    <span class="a-size-large">Lunettes de soleil polarisées pour enfant (produit fictif)</span>
    <table>
      <tr>
        <td class="a-span12">
          <span class="priceBlockStrikePriceString">$13.88</span>
          <span class="a-size-medium">$10.99</span>
        </td>
      </tr>
    </table>
    <div class="feature">
      <div class="a-section">
        <div class="feature">
          <div class="a-section">
            <div class="a-section">
              <span class="a-size-medium">En stock</span>
            </div>
          </div>
        </div>
      </div>
    </div>
  </body>
</html>Dans un premier terminal, lance un petit serveur web local dans le dossier qui contient le fichier :
python3 -m http.server 8000Dans un second terminal, lance le scraper sur cette page :
python3 scraper.py http://localhost:8000/page_test.html{
"category": "Vêtements › Filles › Accessoires › Lunettes de soleil",
"original_price": "$13.88",
"name": "Lunettes de soleil polarisées pour enfant (produit fictif)",
"sale_price": "$10.99",
"availability": "En stock"
}Les cinq données sont bien extraites. Sur une vraie page Amazon, tu obtiens le même type de dictionnaire. Les prix sont toujours du texte, avec leur symbole monétaire : on les nettoiera plus bas.
Que faire si Amazon bloque tes requêtes ?
Si tu envoies trop de requêtes, Amazon peut répondre par une erreur (503, 429) ou par une page de captcha à la place de la page produit. Voici les bonnes pratiques pour rester raisonnable.
1. Comment ralentir et espacer les requêtes ?
Ne lance jamais des centaines de requêtes d’affilée. Ajoute une pause aléatoire de quelques secondes entre deux pages, avec time.sleep(random.uniform(2, 5)). Moins tu sollicites le serveur, moins tu as de risques d’être bloqué.
2. Comment réessayer avec une attente croissante (backoff exponentiel) ?
Quand une requête échoue temporairement, réessaie après une pause qui double à chaque tentative (c’est le principe du backoff exponentiel), puis abandonne au bout de quelques essais :
import random
import time

import requests


def telecharger_avec_retries(url, essais=3, attente=2):
    for tentative in range(1, essais + 1):
        reponse = requests.get(url, headers=HEADERS, timeout=10)
        if reponse.status_code == 200:
            return reponse.text

        if tentative < essais:
            delai = attente * 2 ** (tentative - 1) + random.uniform(0, 1)
            print(f"Tentative {tentative} : code {reponse.status_code}, nouvel essai dans {delai:.1f} s")
            time.sleep(delai)

raise RuntimeError(f"Échec après {essais} tentatives : {url}")Avec un serveur qui renvoie deux erreurs 503 avant de répondre correctement, on obtient (les délais changent à chaque exécution à cause de la part d’aléa : le premier se situe entre 2 et 3 s, le second entre 4 et 5 s) :
Tentative 1 : code 503, nouvel essai dans 2.2 s
Tentative 2 : code 503, nouvel essai dans 4.1 s
OK page produit3. Comment détecter un blocage et t’arrêter ?
Une page de captcha est parfois renvoyée avec un code 200 : le téléchargement semble réussir, mais les données sont vides. Si tu vois apparaître un captcha, ne cherche pas à le contourner : arrête le scraping, attends et revois ton rythme de requêtes.
Tu trouveras parfois conseillés des pools de proxies, la rotation des identités du navigateur ou des outils de résolution automatique de captchas. Ces techniques visent à contourner les protections d’Amazon et vont à l’encontre de ses conditions d’utilisation : je ne les détaille donc pas ici. Si tu as besoin de grands volumes de données, utilise l’API officielle ou un fournisseur de données autorisé.
Comment passer à plus grande échelle ?
Ce code convient pour de petits projets et pour comprendre la démarche. Si tu veux construire un scraper plus ambitieux, voici les points à garder en tête.
1. Pourquoi utiliser un framework comme Scrapy ?
Pour parcourir beaucoup de pages, il vaut mieux s’appuyer sur un framework open source. Scrapy est le plus répandu en Python : sa communauté est active, il gère les erreurs sans interrompre tout le scraper, il exécute plusieurs requêtes en parallèle et respecte le fichier robots.txt si tu l’actives.
2. Comment distribuer le travail dans le cloud ?
Avec un seul ordinateur, le nombre de pages que tu peux traiter est limité. Pour des volumes importants, tu peux héberger ton scraper dans le cloud et utiliser une version distribuée du framework, comme Scrapy Redis, avec un gestionnaire de files de messages comme Redis, RabbitMQ ou Kafka.
3. Comment planifier l’exécution du scraper ?
Pour suivre des prix ou des stocks, il faut relancer le script à intervalles réguliers. Sous Linux et Mac, utilise cron ; sous Windows, le planificateur de tâches. Par exemple, pour lancer le script tous les jours à 8 h avec cron :
0 8 * * * cd /chemin/du/projet && python3 scraper.py URL_DU_PRODUIT >> scraper.log 2>&14. Où stocker les données scrapées ?
Écrire dans un fichier devient vite peu pratique dès que tu scrapes beaucoup de produits : la relecture est difficile, et plusieurs processus qui écrivent dans le même fichier peuvent l’abîmer. Une base de données règle le problème. Pour démarrer, SQLite est inclus dans Python et ne demande aucune installation. Si tu veux t’y exercer, lis SQLite avec Python.
Voici comment enregistrer un produit extrait. La variable produit est le dictionnaire renvoyé par extraire(telecharger(url)), par exemple sur notre page de test, et on y utilise la fonction nettoyer_prix(), définie juste après :
import sqlite3

connexion = sqlite3.connect("produits.db")
connexion.execute("""
    CREATE TABLE IF NOT EXISTS produits (
        nom TEXT,
        prix_vente REAL,
        disponibilite TEXT,
        date_scraping TEXT DEFAULT CURRENT_TIMESTAMP
    )
""")

connexion.execute(
    "INSERT INTO produits (nom, prix_vente, disponibilite) VALUES (?, ?, ?)",
    (produit["name"], nettoyer_prix(produit["sale_price"]), produit["availability"]),
)
connexion.commit()

for ligne in connexion.execute("SELECT nom, prix_vente, disponibilite FROM produits"):
print(ligne)('Lunettes de soleil polarisées pour enfant (produit fictif)', 10.99, 'En stock')5. Comment contrôler la qualité des données scrapées ?
Les données scrapées arrivent toujours en désordre. Un sélecteur qui fonctionne sur une page peut échouer sur une autre variante du même site, et Amazon a beaucoup de mises en page différentes. Une heure passée à écrire de petits contrôles (le prix est-il un nombre ? le titre fait-il moins de 250 caractères ?) est indispensable, surtout si tu alimentes un outil d’optimisation de prix. Voici deux fonctions pour nettoyer un prix et vérifier un produit :
def nettoyer_prix(texte):
    """Convertit un prix texte comme '$10.99' en nombre (None si absent)."""
    if not texte:
        return None
    return float(texte.replace("$", "").replace(",", "").strip())


def verifier_produit(produit):
    """Renvoie la liste des problèmes détectés dans un produit scrapé."""
    erreurs = []

    nom = produit.get("name")
    if not nom or len(nom) > 250:
        erreurs.append("nom absent ou trop long")

    try:
        prix = nettoyer_prix(produit.get("sale_price"))
        if prix is None or prix <= 0:
            erreurs.append("prix de vente absent ou négatif")
    except ValueError:
        erreurs.append("prix de vente illisible")

return erreursTeste-les sur le produit extrait plus haut, puis sur un produit défectueux :
print(nettoyer_prix(produit["sale_price"]))
print(verifier_produit(produit))
print(verifier_produit({"name": "", "sale_price": "N/A"}))10.99
[]
['nom absent ou trop long', 'prix de vente illisible']Attention aux formats : sur amazon.fr, un prix s’écrit 10,99 €, avec une virgule décimale. Adapte nettoyer_prix() au format de la boutique que tu scrapes.
Conclusion
Tu sais maintenant comment scraper Amazon avec Python et SelectorLib : décrire les données dans un fichier YAML, télécharger la page avec Requests, extraire les valeurs, puis les contrôler et les stocker. Tu as aussi vu comment rester raisonnable face aux blocages, et pourquoi le scraping à grande échelle demande des outils plus robustes.
Pour explorer d’autres approches, lis Le Web Scraping en pratique et Web Scraping avec Pandas.
Les données scrapées sont toujours en désordre : prix en texte, valeurs manquantes, doublons. Pour apprendre à les nettoyer proprement avant de les analyser, le cours Nettoyage de données de DataXp propose 3 projets guidés. Les 2 premiers chapitres sont gratuits.
Avertissement : Tout code fourni dans ce tutoriel est uniquement destiné à des fins d’illustration et d’apprentissage. Nous ne sommes pas responsables de la manière dont il est utilisé et n’assumons aucune responsabilité pour toute utilisation préjudiciable du code source. La simple présence de ce code sur notre site n’implique pas que nous encouragions le scraping. Respecte toujours les conditions d’utilisation et le fichier robots.txt des sites que tu scrapes.
Article adapté et inspiré par ScrapeHero : Comment scraper les produits et prix Amazon avec Python ?