Explorons ensemble des cas d’usage de la Data Science avec l’API GPT d’OpenAI et Python ! On va poser des questions pointues sur le Machine Learning et le Deep Learning, puis demander au modèle de générer du code Python et des données pour des tâches de Data Science. Et tout ça en écrivant nous-mêmes du code Python : promis, c’est fun !
Article mis à jour en novembre 2026 : cet article est né avec GPT-3 (le modèle text-davinci-003), retiré depuis par OpenAI. J’ai donc réécrit tout le code pour la bibliothèque openai actuelle (API Responses, modèle gpt-5.6-luna, noms vérifiés dans la documentation d’OpenAI) et j’ai exécuté les extraits de code générés par GPT (normalisation, données synthétiques) avec pandas 3 et pandas 2.3, la version de Google Colab. Les réponses citées plus bas sont celles de GPT-3, obtenues début 2023 : avec un modèle récent, tu obtiendras des réponses plus précises et un peu différentes. C’est justement ce qui rend la comparaison intéressante.
En bref : pour utiliser l’API OpenAI avec Python, tu installes la bibliothèque openai, tu crées un client avec ta clé d’API (lue dans une variable d’environnement, jamais écrite dans le code), puis tu appelles client.responses.create() avec un modèle et une question. En Data Science, GPT sert à répondre à des questions techniques, à proposer des idées de Feature Engineering, à écrire du code et à générer des données synthétiques. Mais ses réponses doivent toujours être vérifiées : dans cet article, un code demandé pour un modèle CatBoost est revenu avec un modèle SVC de scikit-learn, et sa précision de 68 % ne voulait rien dire.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab (il te faut ta propre clé d’API OpenAI).
Qu’est-ce que GPT-3 (et GPT) ?
GPT-3 est un modèle de langage développé par OpenAI et présenté en 2020. Il a vraiment attiré l’attention du grand public fin 2022, quand OpenAI a lancé ChatGPT, qui s’appuie sur la même famille de modèles. Ces modèles savent écrire des essais, des chansons, de la poésie et même du code.
GPT est un modèle de type « transformer ». Plus précisément, GPT signifie Generative Pre-trained Transformer. L’architecture transformer repose sur l’auto-attention (self-attention) pour modéliser le texte : le modèle prédit le mot suivant (plus exactement le « token » suivant) à partir de tous ceux qui précèdent. Les versions pensées pour le dialogue sont ensuite affinées avec du retour humain. Tu vois l’idée.
Les applications sont nombreuses : générer des scripts Python et SQL, orchestrer des services cloud, résumer des documents, et bien plus. Ces modèles ont aussi des limites (nous y reviendrons), mais leur éventail d’usages est impressionnant. J’ai donc voulu leur poser des questions sur la Data Science et le Machine Learning, pour voir s’ils peuvent compléter certains workflows.
Au programme : d’abord quelques questions simples, puis l’aide au Feature Engineering et au choix de modèle, la génération de code Python, la génération de données synthétiques, les datasets open source et enfin les cas d’usage du Machine Learning.
Comment utiliser l’API OpenAI avec Python ?
L’utilisation de l’API est payante, à l’usage : tu paies le volume de texte traité (en tokens). À titre d’ordre de grandeur, la documentation d’OpenAI indique pour gpt-5.6-luna 0,20 $ par million de tokens en entrée et 1,20 $ en sortie (tarifs de novembre 2026). Toutes les questions de cet article coûtent donc quelques centimes. ChatGPT propose de son côté une offre gratuite, mais c’est un produit différent de l’API.
Comment installer la bibliothèque OpenAI ?
Pour commencer, installe la bibliothèque OpenAI avec pip dans la première cellule du notebook :
!pip install openaiComment créer le client et protéger sa clé d’API ?
Crée une clé d’API sur le site d’OpenAI. Ne l’écris jamais en clair dans ton code (ni dans un notebook que tu partages, ni sur GitHub) : lis-la depuis une variable d’environnement, ou demande-la à la saisie dans un notebook. Voici le code qui crée le client :
import os
from getpass import getpass
from openai import OpenAI

# Lit la clé dans l'environnement, sinon la demande à la saisie
cle = os.environ.get("OPENAI_API_KEY") or getpass("Clé OpenAI : ")
client = OpenAI(api_key=cle)Comment poser une question à GPT avec une fonction ?
Avec la bibliothèque actuelle, on passe par un objet client : l’ancienne syntaxe openai.Completion.create(engine="text-davinci-003", ...) ne fonctionne plus. Pour ne pas répéter le même code à chaque question, créons une petite fonction demander :
MODELE = "gpt-5.6-luna"  # modèle économique d'OpenAI : vérifie le nom actuel dans leur documentation

def demander(question):
    reponse = client.responses.create(
        model=MODELE,
        input=question,
        reasoning={"effort": "low"},
    )
return reponse.output_textLa méthode client.responses.create reçoit le nom du modèle (model), la question (input) et un réglage de réflexion (reasoning={"effort": "low"}, pour des réponses rapides et peu coûteuses). On récupère le texte de la réponse avec output_text.
Deux précisions. D’abord, les noms de modèles évoluent régulièrement chez OpenAI : si gpt-5.6-luna n’est plus disponible quand tu lis ces lignes, remplace simplement la valeur de MODELE par un modèle actuel de leur documentation. Ensuite, je n’utilise pas l’ancien paramètre temperature : la documentation du modèle ne le mentionne pas, donc je règle plutôt la longueur et le style de la réponse directement dans la question.
GPT sait-il répondre aux questions de Data Science et de Machine Learning ?
A-t-on besoin de Python pour la Data Science ?
Testons avec une question très basique : « A-t-on besoin de Python pour la Data Science et le Machine Learning ? ». Voici le code, puis ce que répondait GPT-3 en 2023 :
reponse = demander(
    "A-t-on besoin de Python pour la Data Science et le Machine Learning ?"
)
print(reponse)Oui, Python est l’une des principales technologies utilisées dans la data science et le machine learning. C’est un des outils les plus populaires pour la programmation et l’analyse des données. Python est utilisé pour créer des algorithmes prédictifs puissants pour le traitement des données et la prise de décisions, ainsi que pour des applications de visualisation et de manipulation des données. Il est également utilisé pour créer des systèmes d’apprentissage par machine et des systèmes d’intelligence artificielle qui sont utiles pour le traitement des données et l’analyse prédictive.
La réponse est sans appel. Pour te former, tu peux commencer par les 15 bibliothèques Python à connaître pour la science des données.
Que sait GPT sur la bibliothèque pandas ?
Ensuite, posons des questions sur des bibliothèques Python bien connues. Si on demande « Qu’est-ce que la bibliothèque pandas ? », GPT-3 donnait cette réponse :
reponse = demander(
    "Qu'est-ce que la bibliothèque pandas ?"
)
print(reponse)La bibliothèque Pandas est une bibliothèque open source Python qui fournit des structures de données et des outils d’analyse destinés à rendre plus facile le traitement et l’analyse numérique des données. Elle offre une variété de fonctionnalités pour manipuler, filtrer, trier et fusionner des données facilement, comme la sélection, l’ajout et la suppression d’informations. Elle peut également être utilisée pour les diagrammes, la visualisation de données, l’analyse descriptive et prédictive et bien d’autres choses encore.
On peut même poser des questions plus spécifiques, comme « Quels sont les cas d’utilisation courants de Pandas ? ». Le modèle donne des réponses sensées : traitement, visualisation et agrégation de données, analyse de séries temporelles.
reponse = demander(
    "Quels sont les cas d'utilisation courants de Pandas ? (donne-moi 10 points précis)"
)
print(reponse)1. Analyse de données et préparation des données, notamment le nettoyage et l’agrégation.
2. Manipulation des données, notamment le filtrage et le tri.
3. Transformations des données, telles que le calcul de statistiques d'agrégation.
4. Visualisation de données complexes et génération de rapports.
5. Export des données dans des tableaux électroniques ou des bases de données.
6. Intégration avec d'autres bibliothèques Python pour le traitement plus approfondi des données.
7. Création et manipulation des dates et des heures.
8. Analyse des données temporelles.
9. Fusion de données, fusion par index et jointures.
10. Exportation de tableaux pivot et de tableaux croisés dynamiques.Quelles sont les bibliothèques de Deep Learning les plus courantes selon GPT ?
Demandons maintenant « Quelles sont les bibliothèques de Deep Learning les plus courantes ? ». Comme on n’utilise plus de limite de longueur, je précise la forme de la réponse dans la question :
reponse = demander(
    "Quelles sont les bibliothèques de Deep Learning les plus courantes ? Réponds avec une liste de 10 éléments maximum, sans explication."
)
print(reponse)Les bibliothèques de deep learning les plus courantes sont :
- TensorFlow
- Keras
- PyTorch
- Caffe
- Theano
- Microsoft Cognitive Toolkit (CNTK)
- Apache MXNet
- Deeplearning4j
- Chainer
- Caffe2À noter : cette réponse de GPT-3 (2023) est déjà datée. Caffe, Theano, CNTK ou Chainer ne sont plus vraiment utilisés aujourd’hui, alors que PyTorch domine largement. C’est une première limite à garder en tête : un modèle de langage reflète les données sur lesquelles il a été entraîné. Pour une vue à jour, lis les 12 bibliothèques pour Machine Learning et Deep Learning.
GPT sait-il expliquer un réseau de neurones ?
On peut même demander quelque chose comme « Qu’est-ce qu’un réseau de neurones de Deep Learning ? » :
reponse = demander(
    "Qu'est-ce qu'un réseau de neurones de Deep Learning ?"
)
print(reponse)Un réseau de neurones de deep learning est une forme d’intelligence artificielle qui imite le fonctionnement du cerveau humain en créant des “réseaux” de neurones artificiels interconnectés qui communiquent entre eux pour apprendre et prendre des décisions. Ces réseaux, basés sur des algorithmes de calcul d’apprentissage profond (deep learning), peuvent être très adaptables et s’utiliser dans des domaines très divers, comme le traitement du langage naturel, les réseaux sociaux ou la recherche d’images.
Comment utiliser GPT dans un workflow de Data Science ?
GPT peut-il aider pour le Feature Engineering ?
Un autre cas d’usage intéressant est de s’en servir comme aide pour guider ton travail de Data Science. Par exemple, le modèle peut-il donner des idées de transformations de features qui améliorent les performances ? Demandons-lui :
reponse = demander(
    "Donne-moi quelques idées sur les transformations de Features qui peuvent améliorer les performances d'un modèle de Machine Learning ou Deep Learning."
)
print(reponse)
- Catégorisation des variables : convertir les variables continues en catégories afin de les représenter sous forme de nombres entiers ou de noms.
- Réduction de Dimensionnalité : Utilisation de techniques comme l’ACP (Analyse en Composantes Principales) et LDA (Discriminant Linéaire Discriminant) pour réduire la dimension des variables et ainsi améliorer les performances du modèle.
- Normalisation des variables : Permet de mettre toutes les variables dans la même ligne de valeurs afin de les rendre plus compatibles pour l’apprentissage.
- Combiner et transformer des variables : Combiner et transformer des variables entre elles pour créer de nouvelles variables qui peuvent être plus prédictives.
- Régularisation des variables : Utilisation de la régularisation pour limiter les paramètres en les réduisant à des valeurs plus petites et plus stables.
- Ajouter un bruit aléatoire aux données : L’ajout de bruit aléatoire aux données peut aider à améliorer la performance en créant une distribution plus réaliste et plus riche qui se reflète dans les résultats.
Le modèle donne quelques bonnes suggestions de transformations, avec une explication pour chacune. Attention toutefois : la « régularisation des variables » est en réalité une technique qui s’applique au modèle, pas aux variables, et le « bruit aléatoire » n’est pas une transformation de features classique. Garde ton esprit critique !
GPT peut-il écrire du code Python de normalisation de données ?
Voyons si on peut aller plus loin : demandons-lui d’écrire du code Python qui effectue une normalisation.
reponse = demander(
    "Écris un exemple de code Python qui effectue de la normalisation de données"
)
print(reponse)On copie-colle le code obtenu dans une nouvelle cellule et on l’exécute. Il centre et réduit les données : chaque valeur devient son écart à la moyenne, divisé par l’écart type.
import numpy as np

# Données à normaliser
data = np.array([1.0, 2.0, 3.0, 4.0, 5.0])

# Moyenne et écart type
mean = np.mean(data)
std_dev = np.std(data)

# Normalisation (centrer-réduire)
normalized_data = (data - mean) / std_dev
print(normalized_data)[-1.41421356 -0.70710678 0. 0.70710678 1.41421356]GPT peut-il aider à choisir un modèle de Machine Learning ?
Autre cas d’usage cool : la sélection de modèles. Voyons si GPT peut nous guider dans le choix de nos modèles de Machine Learning. Demandons « Comment puis-je sélectionner un modèle de série temporelle ? ».
reponse = demander(
    "Comment puis-je sélectionner un modèle de série temporelle ?"
)
print(reponse)Pour sélectionner un modèle de série temporelle, vous devez d’abord examiner les données pour déterminer la tendance, le comportement saisonnier et les anomalies. Ensuite, vous devrez choisir le modèle qui mieux se convenir aux caractéristiques de vos données. Les modèles populaires incluent les régressions Linéaire, Exponentiel et Autorégressive. Une fois que vous aurez sélectionné le modèle approprié, vous devrez l’évaluer en utilisant des métriques telles que le coefficient de corrélation, l’erreur quadratique moyenne et l’erreur relative.
Les réponses sont correctes : vérification de la stationnarité, de la saisonnalité, des tendances, puis évaluation des performances du modèle. Posons une question plus spécifique, comme « Quand utiliser ARIMA vs Prophet ? » :
reponse = demander(
    "Quand utiliser ARIMA vs Prophet de Facebook ?"
)
print(reponse)ARIMA est une technique de prévision des séries chronologiques utilisée pour prédire des valeurs futures basées sur des informations passées. Elle est utile pour prévoir des informations comme le climat et les stocks, car elle permet d’utiliser des informations passées pour créer des prédictions futures précises.
Par contraste, Prophet FB est un modèle de prévision de séries chronologiques basé sur les séries temporelles. Il est principalement utilisé pour la prévision à court terme et les données à haute fréquence. Il est particulièrement bon pour les données sporadiques et saisonnières et peut prendre en compte des informations externes telles que les jours fériés, les points de données non observés et les régressions non linéaires. Il est utile pour prédire des informations telles que les ventes et la demande de produits.
En résumé, ARIMA est un outil de prévision de séries chronologiques plus général qui est utile lorsque des informations détaillées sont disponibles, tandis que Prophet FB est utile pour la prévision à court terme et permet de prendre en compte des informations externes. Chacune des deux méthodes est très précise et peut être utilisée pour obtenir des prédictions précises et fiables à des fins différentes.
Cette réponse est plutôt vague et répétitive : un bon rappel que le modèle donne un avis général, pas une recommandation adaptée à tes données. Pour voir ces deux outils à l’œuvre, lis le modèle ARIMA avec Python et la prédiction de la qualité de l’air avec Prophet.
GPT peut-il générer des données synthétiques ?
Peut-on utiliser GPT pour générer des données synthétiques ? C’est ce que nous allons voir, avec deux exemples classiques : des données de réadmission à l’hôpital et des données de transactions.
Données de réadmission de patients
Demandons au modèle d’écrire un code Python qui génère des données synthétiques de réadmission, stockées dans un DataFrame :
reponse = demander(
    "Donne-moi un exemple de code Python qui génère des données synthétiques sur les réadmissions de patients dans les services de santé. Stocke ces données dans un DataFrame."
)
print(reponse)Testons-le immédiatement (j’ai simplement remis le code en forme) :
import pandas as pd
import numpy as np

# Liste de données
data_list = [
    ['001', 'John', 'Admitted', '2020-01-01', '2020-01-19'],
    ['002', 'Sara', 'Admitted', '2020-03-10', '2020-04-19'],
    ['003', 'Grace', 'Not Admitted', '2020-05-01', '2020-05-09'],
    ['004', 'Jack', 'Admitted', '2020-06-20', '2020-07-09'],
]

# Conversion de la liste en DataFrame
readmission_data = pd.DataFrame(
    data_list,
    columns=["PatientID", "Name", "Status", "Admission Date", "Discharge Date"],
)

# Génération aléatoire de la colonne cible
np.random.seed(42)
readmission_data['Readmitted'] = np.random.choice(a=['Yes', 'No'], size=len(readmission_data))

readmission_data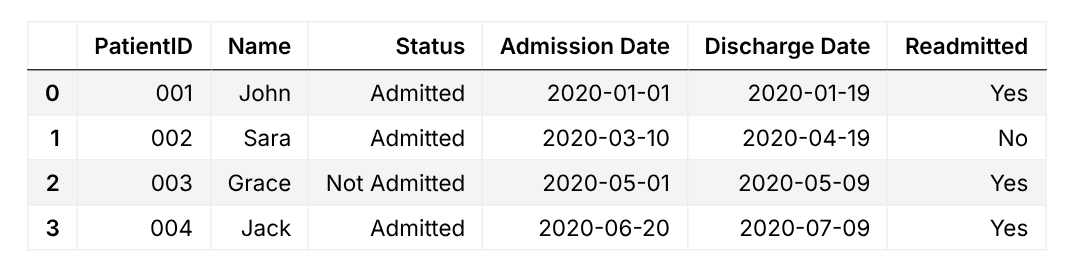
Voyons si on peut lui demander de construire un modèle de classification sur ces données synthétiques pour prédire la réadmission et évaluer la performance. Le prompt sera le suivant :
reponse = demander(
    "Donne-moi un exemple de code Python qui génère des données synthétiques sur les réadmissions de patients dans les services de santé, stockées dans un DataFrame. À partir de ces données, écris-moi un code Python qui construit un modèle CatBoost qui prédit les réadmissions. Écris également du code pour calculer et afficher les performances."
)
print(reponse)Et on copie-exécute le code obtenu :
import numpy as np
np.random.seed(1)

# Fonction qui génère les données
def generateData(num_examples):
    x_data = np.random.rand(num_examples, 3)                  # 3 variables aléatoires
    y_labels = np.random.randint(2, size=num_examples)        # étiquettes 0/1 aléatoires
    return x_data, y_labels

x_data, y_labels = generateData(100)

# Modèle de classification
from sklearn.svm import SVC
model = SVC()
model.fit(x_data, y_labels)

# Performance du modèle
from sklearn.metrics import accuracy_score
predicted_labels = model.predict(x_data)
performance = accuracy_score(y_labels, predicted_labels)
print(f"Le modèle a une précision de {performance*100:.2f}%")Le modèle a une précision de 68.00%Regarde bien ce résultat : on avait demandé un modèle CatBoost, et GPT-3 a utilisé un SVC de scikit-learn. De plus, les étiquettes sont tirées au hasard et la précision est mesurée sur les données d’entraînement : ce « 68 % » ne veut donc rien dire. Le code tourne, mais il ne répond pas vraiment à la demande. Toujours relire et tester le code généré !
Données de transaction
Demandons maintenant un code qui génère des données de transaction synthétiques dans un DataFrame :
reponse = demander(
    "Écris un exemple de code Python qui génère des données de transaction synthétiques stockées dans un DataFrame. Inclus le nom du client, l'ID du client et de la transaction, la date et le montant de la transaction."
)
print(reponse)On copie ce code et on l’exécute dans une nouvelle cellule :
import pandas as pd

data = {
    'client_name': ['John', 'Anna', 'Mark', 'Emily', 'Paul'],
    'client_id': [1, 2, 3, 4, 5],
    'transaction_id': [101, 102, 103, 104, 105],
    'date': ['21/05/2020', '25/05/2020', '28/05/2020', '30/05/2020', '02/06/2020'],
    'amount': [150.25, 400.31, 2000.56, 543.09, 12.50],
}

df = pd.DataFrame(data)
df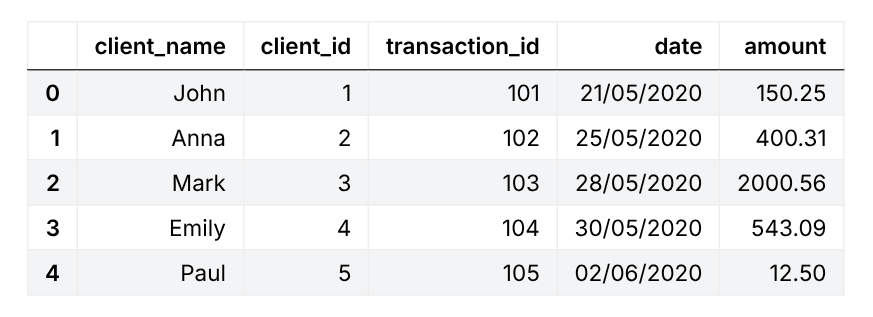
Assez impressionnant ! Pour t’entraîner avec des données plus réalistes, regarde aussi les meilleurs sites de datasets pour tes projets de Data Science.
GPT peut-il recommander des datasets open source ?
Une autre application consiste à demander au modèle des ensembles de données publiques. Demandons-lui d’en lister quelques-uns :
reponse = demander(
    "Liste-moi 10 bons sites pour trouver des ensembles de données publiques"
)
print(reponse)
- Kaggle Datasets
- UCI Machine Learning Repository
- FiveThirtyEight
- Reddit : r/datasets
- Data.gov
- Awesome-Public-Datasets (GitHub)
- Google Dataset Search
- The World Bank
- Harvard Dataverse
- Amazon Web Services Open Data Registry
Mine de rien, de nombreux sites proposés par GPT-3 font partie de ma liste des meilleurs sites de datasets pour nos projets de Data Science.
GPT peut-il aider à trouver des cas d’usage du Machine Learning ?
Pour notre dernier exemple, voyons si GPT peut nous aider à formuler des problèmes de Machine Learning, c’est-à-dire des « cas d’usage ». Posons la question : « Quels sont les cas d’utilisation émergents du Machine Learning dans les médias sociaux ? ».
reponse = demander(
    "Quels sont les cas d'utilisation émergents du Machine Learning dans les médias sociaux ?"
)
print(reponse)1. Détection de contenu inapproprié : Les réseaux sociaux peuvent utiliser des algorithmes de Machine Learning pour détecter automatiquement le contenu inapproprié et le supprimer.
2. Ciblage publicitaire : Les réseaux sociaux peuvent utiliser des algorithmes de Machine Learning pour cibler les publicités en fonction des intérêts et des préférences des utilisateurs.
3. Analyse des tendances : Les réseaux sociaux peuvent utiliser des algorithmes de Machine Learning pour analyser les tendances et les préférences des utilisateurs et ainsi mieux cibler leurs contenus.
4. Détection de la fraude : Les réseaux sociaux peuvent utiliser des algorithmes de Machine Learning pour détecter les comportements suspects et prévenir la fraude.
5. Analyse des sentiments : Les réseaux sociaux peuvent utiliser des algorithmes de Machine Learning pour analyser les sentiments des utilisateurs et ainsi mieux comprendre leurs préférences et leurs intérêts.
Voyons également la réponse pour les soins de santé :
reponse = demander(
    "Quels sont les nouveaux cas d'utilisation du Machine Learning dans le secteur des soins de santé ?"
)
print(reponse)1. Diagnostic précoce des maladies : Les algorithmes d’apprentissage automatique peuvent être utilisés pour analyser les données médicales et les symptômes pour détecter les maladies précocement.
2. Prédiction des réponses aux médicaments : Les algorithmes d’apprentissage automatique peuvent être utilisés pour prédire la réponse d’un patient à un médicament donné en fonction de ses antécédents médicaux et de ses caractéristiques génétiques.
3. Surveillance des patients à distance : Les algorithmes d’apprentissage automatique peuvent être utilisés pour surveiller les patients à distance et détecter les signes de détérioration de leur état de santé.
4. Prédiction des épidémies : Les algorithmes d’apprentissage automatique peuvent être utilisés pour prédire les épidémies et aider à prendre des mesures préventives.
5. Amélioration de la qualité des soins : Les algorithmes d’apprentissage automatique peuvent être utilisés pour améliorer la qualité des soins en analysant les données médicales et en identifiant les pratiques médicales les plus efficaces.
Pour d’autres idées de projets, tu peux lire 5 projets d’IA à réaliser rapidement avec Python ou comment construire un chatbot en Python.
Quelles sont les limites de GPT en Data Science ?
- Les réponses peuvent être fausses tout en paraissant très convaincantes : vérifie toujours les faits.
- Le code généré doit être relu et testé (comme le CatBoost devenu SVC plus haut).
- Les connaissances sont figées à la date d’entraînement du modèle (les bibliothèques de Deep Learning de 2023 en sont la preuve).
- Plus la question est précise (contexte, contraintes, format de réponse), plus la réponse est utile : un avis général ne remplace pas une analyse de tes données.
- Ne partage jamais de données sensibles (clients, patients, secrets) dans tes prompts, et ne publie jamais ta clé d’API.
Questions fréquentes
Comment utiliser l’API OpenAI avec Python ?
Installe la bibliothèque avec pip install openai, crée un client avec ta clé d’API (OpenAI(api_key=…)), puis appelle client.responses.create(model=…, input=…) et lis la réponse avec reponse.output_text. La clé se lit dans une variable d’environnement comme OPENAI_API_KEY, jamais directement dans le code.
L’API OpenAI est-elle gratuite ?
Non, l’API est payante à l’usage : tu paies le volume de texte traité, en tokens. Pour gpt-5.6-luna, la documentation d’OpenAI indique 0,20 $ par million de tokens en entrée et 1,20 $ en sortie (novembre 2026). ChatGPT propose une offre gratuite, mais c’est un produit différent de l’API.
Pourquoi l’ancien code avec text-davinci-003 ne fonctionne-t-il plus ?
OpenAI a retiré le modèle text-davinci-003, et l’ancienne syntaxe openai.Completion.create n’existe plus dans la bibliothèque depuis sa version 1.0. Il faut maintenant créer un client et appeler client.responses.create (ou client.chat.completions.create) avec un modèle actuel.
Peut-on faire confiance au code généré par GPT ?
Pas sans le relire. Dans cet article, un code demandé pour un modèle CatBoost est revenu avec un SVC de scikit-learn, avec une précision de 68 % mesurée sur les données d’entraînement et des étiquettes tirées au hasard : le code tourne, mais il ne répond pas à la demande. Relis, exécute et teste toujours le code généré.
Comment protéger sa clé d’API OpenAI ?
Ne l’écris jamais en clair dans un notebook ou un dépôt GitHub. Lis-la dans une variable d’environnement (OPENAI_API_KEY) ou demande-la à la saisie avec getpass, et révoque-la depuis le tableau de bord d’OpenAI si elle a fuité.
À quoi GPT peut-il servir concrètement en Data Science ?
À répondre à des questions techniques, proposer des idées de Feature Engineering, écrire des extraits de code (normalisation, graphiques), générer des données synthétiques pour tester un pipeline, suggérer des datasets ou des cas d’usage. Il fait gagner du temps, mais il ne remplace ni la vérification des résultats ni la connaissance du métier.
Conclusion : que retenir de GPT avec Python ?
Dans cet article, tu as utilisé l’API GPT d’OpenAI avec Python pour une variété de tâches de Data Science et de Machine Learning : des questions simples sur les bibliothèques Python, le Feature Engineering et la sélection de modèles, puis la génération de code et de données synthétiques (santé et transactions), les datasets open source et les cas d’usage émergents du Machine Learning.
GPT est un excellent assistant, à condition de rester le pilote : c’est toi qui poses la bonne question et qui vérifies la réponse. Pour acquérir ces bases solides en Python, sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin, voici des articles qui pourraient te plaire :