Quand on commence à apprendre le langage Python, on prend souvent de mauvaises habitudes de codage sans s’en rendre compte. C’est pourquoi je te partage 10 erreurs en Python que j’ai découvertes au cours de mes années de data scientist : pour chacune, tu vas voir la mauvaise pratique, la bonne pratique, et le code testé avec son résultat.
Il se peut que tu écrives du code qui fait le job une fois, mais qui risque d’échouer à l’avenir, ou que tu utilises des solutions de contournement alors qu’il existe une fonction intégrée qui te faciliterait la vie.
Article mis à jour en octobre 2026 : tout le code a été exécuté, avec son résultat. J’ai remplacé l’exemple Selenium de l’erreur 2 par un exemple que tu peux exécuter toi-même, ajouté un exemple de conflit de noms pour l’erreur 1, une vérification du PEP 8 avec pycodestyle, une mesure du temps pour l’erreur 3, zip(strict=True) et le formatage des nombres avec les f-strings. J’ai aussi corrigé deux affirmations qui n’étaient pas exactes : import * n’est pas plus lent qu’un import classique, et la concaténation avec + est surtout pénible à lire et provoque des erreurs avec les nombres.
En bref : évite from module import *, précise toujours l’exception dans except, utilise NumPy plutôt qu’une boucle pour les calculs sur de gros tableaux, ouvre tes fichiers avec with, respecte le PEP 8, parcours un dictionnaire avec .items(), utilise les compréhensions (sans en abuser), zip() plutôt que range(len()), les f-strings plutôt que +, et ne mets jamais une liste comme valeur par défaut d’une fonction.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Voici la version de Python utilisée pour tester le code (octobre 2026) :
import sys
print("Python", sys.version.split()[0])Python 3.13.16Quelles sont les 10 erreurs en Python les plus fréquentes chez les débutants ?
La plupart d’entre nous cumulent plusieurs de ces mauvaises habitudes, qui datent des premiers mois d’apprentissage. La bonne nouvelle, c’est que tu peux les corriger dès aujourd’hui avec les extraits de code ci-dessous. À chaque fois, je te donne deux fragments de code : la mauvaise pratique suivie de la bonne pratique à adopter, et parfois des solutions alternatives.
Erreur 1 : utiliser from module import *
Il est très tentant d’importer tout ce qui se trouve dans un module avec la commande from xyz import *. Ce n’est pas une bonne pratique, pour plusieurs raisons :
- Tu ne sais plus d’où vient chaque fonction quand tu relis ton code.
- Les noms peuvent s’écraser sans prévenir : si deux modules ont une fonction du même nom, c’est la dernière importée qui gagne.
- Les outils d’analyse de code comme flake8 ou Ruff le signalent.
Pour résoudre ce problème, importe soit l’objet précis que tu prévois d’utiliser, soit le module entier.
# Mauvaise pratique
from math import *

print(floor(2.4))
print(ceil(2.4))
print(pi)2
3
3.141592653589793# Bonne pratique
import math
from math import pi
print(math.floor(2.4))
print(math.ceil(2.4))
print(pi)Les deux versions affichent le même résultat. Mais voici un exemple où import * devient un piège. Les modules math et cmath ont chacun une fonction sqrt(). Importer les deux avec * écrase la première sans aucun avertissement :
import math
from math import *
from cmath import *  # écrase sqrt() de math sans prévenir

print(sqrt(-4))
try:
    print(math.sqrt(-4))
except ValueError as erreur:
print("math.sqrt() :", erreur)2j
math.sqrt() : math domain errorLa fonction sqrt() utilisée est celle de cmath (elle accepte les nombres complexes), pas celle de math. Avec des imports explicites, il n’y a aucun doute sur la fonction utilisée.
Erreur 2 : ne pas préciser l’exception dans la clause except
Cette erreur, je l’ai ignorée pendant longtemps. Je ne compte plus le nombre de fois où PyCharm m’a signalé, avec de vilains soulignements, que je ne devais pas utiliser un except seul, sans rien après. Ce n’est d’ailleurs pas recommandé par le PEP 8 (voir l’erreur 5).
Le problème avec un except tout nu, c’est qu’il attrape toutes les exceptions, y compris SystemExit et KeyboardInterrupt : le programme devient difficile à interrompre avec Ctrl-C, et les vraies erreurs de ton code (une faute de frappe dans un nom de variable, par exemple) restent cachées.
# Mauvaise pratique : un except tout nu
import sys

try:
    sys.exit("On quitte le programme")
except:
print("Le except tout nu a avalé sys.exit()")Le except tout nu a avalé sys.exit()Ici, le except a avalé sys.exit(), qui aurait dû arrêter le programme. La prochaine fois que tu utilises try/except, précise l’exception que tu attends (par exemple NoSuchElementException avec Selenium, ou ValueError ci-dessous) :
# Bonne pratique : on précise l'exception
try:
    int("abc")
except ValueError as erreur:
print("ValueError :", erreur)ValueError : invalid literal for int() with base 10: 'abc'Si tu veux vraiment tout attraper, écris except Exception. Cette version laisse passer SystemExit et KeyboardInterrupt, qui ne sont pas des sous-classes de Exception :
print(issubclass(SystemExit, Exception))
print(issubclass(KeyboardInterrupt, Exception))
print(issubclass(ValueError, Exception))False
False
TrueErreur 3 : ne pas utiliser NumPy pour les calculs mathématiques
On oublie souvent qu’il existe des bibliothèques qui rendent la vie plus facile et plus productive en Python. L’une d’elles, que tu devrais utiliser pour les calculs mathématiques, est NumPy : elle résout les opérations mathématiques bien plus vite que les boucles for.
Supposons que nous ayons un tableau random_scores de 10 millions de scores et que nous voulions obtenir le score moyen de ceux qui ont échoué à l’examen (score inférieur à 70). Commençons par générer les scores :
import numpy as np

rng = np.random.default_rng(42)
random_scores = rng.integers(1, 100, size=10_000_001)
random_scores[:5]array([ 9, 77, 65, 44, 43])Essayons d’abord de résoudre ce problème avec une boucle for :
# Mauvaise pratique : une boucle for
import time

debut = time.perf_counter()
count_failed = 0
sum_failed = 0
for score in random_scores:
    if score < 70:
        sum_failed += score
        count_failed += 1

print(sum_failed / count_failed)
temps_boucle = time.perf_counter() - debut
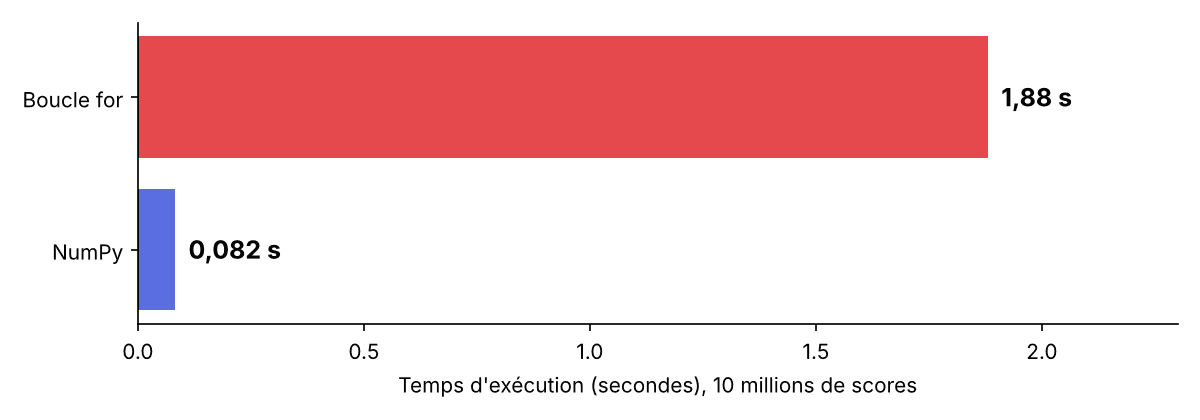
print(f"Boucle for : {temps_boucle:.2f} s")35.00104646941017
Boucle for : 1.88 sMaintenant, résolvons-le avec NumPy :
# Bonne pratique : une opération vectorielle
debut = time.perf_counter()
mean_failed = (random_scores[random_scores < 70]).mean()
print(mean_failed)
temps_numpy = time.perf_counter() - debut
print(f"NumPy : {temps_numpy:.3f} s")
print(f"NumPy est environ {temps_boucle / temps_numpy:.0f} fois plus rapide")35.00104646941017
NumPy : 0.082 s
NumPy est environ 23 fois plus rapideLes deux méthodes donnent exactement le même résultat (35,001…), mais NumPy est plus rapide. Pourquoi ? Parce que NumPy vectorise nos opérations : le calcul est fait sur tout le tableau d’un coup, sans passer par une boucle Python. Les temps dépendent de ton ordinateur, mais l’écart est net :
Pour comprendre la vectorisation en détail, lis l’article sur la vectorisation en Python, et pour d’autres idées d’optimisation, 10 astuces pour accélérer tes scripts Python.
Erreur 4 : ne pas fermer un fichier précédemment ouvert
Une bonne pratique que tout le monde connaît : chaque fichier ouvert avec Python doit être fermé. C’est pourquoi on utilise open(), write() ou read(), puis close(). Mais si write() ou read() lève une exception, close() n’est jamais exécuté et le fichier reste ouvert. Ici, write() reçoit un nombre au lieu de texte :
# Mauvaise pratique : open() puis close()
f = open("dataset.txt", "w")
try:
    f.write(123)  # write() attend du texte
except TypeError as erreur:
    print("Erreur :", erreur)

print("Fichier fermé ?", f.closed)
f.close()Erreur : write() argument must be str, not int
Fichier fermé ? FalsePour éviter ce problème, utilise l’instruction with. Elle ferme le fichier même s’il y a une exception :
# Bonne pratique : l'instruction with
try:
    with open("dataset.txt", "w", encoding="utf-8") as f:
        f.write(123)
except TypeError as erreur:
    print("Erreur :", erreur)

print("Fichier fermé ?", f.closed)Erreur : write() argument must be str, not int
Fichier fermé ? TrueVoici l’utilisation normale, pour écrire puis relire un fichier :
with open("dataset.txt", "w", encoding="utf-8") as f:
    f.write("new_data")

with open("dataset.txt", encoding="utf-8") as f:
print(f.read())new_dataPour lire ou écrire un petit fichier de texte, pathlib fait la même chose en une ligne, et ferme le fichier pour toi :
from pathlib import Path

Path("dataset.txt").write_text("new_data", encoding="utf-8")
print(Path("dataset.txt").read_text(encoding="utf-8"))new_dataErreur 5 : ne pas suivre le PEP 8
Le PEP 8 est un document que toute personne qui apprend Python devrait lire. Il donne des directives et des bonnes pratiques pour écrire du code Python (certains conseils de cet article en viennent). Ces directives peuvent être intimidantes au début. Heureusement, certaines règles sont intégrées dans les éditeurs de code (c’est ainsi que j’ai découvert la règle du except).
Avec PyCharm, si tu écris du code qui ne suit pas le PEP 8, tu verras des soulignements comme dans l’image ci-dessous. Si tu survoles les soulignements, tu verras des instructions pour les corriger.
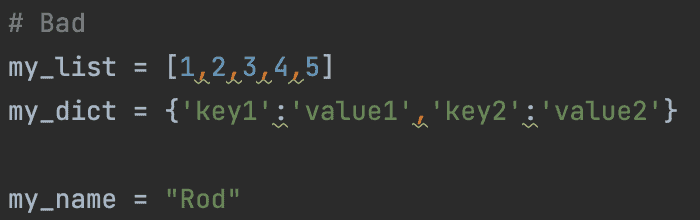
Tu n’utilises pas PyCharm ? Tu peux faire la même vérification avec l’outil pycodestyle, que tu installes avec pip install pycodestyle. Voici un code qui ne respecte pas le PEP 8 : il manque une espace après chaque virgule et après chaque deux-points.
import subprocess
import sys

code_mauvais = """my_list = [1,2,3,4,5]
my_dict = {'key1':'value1', 'key2':'value2'}
x = "Rod"
"""
with open("exemple_pep8.py", "w", encoding="utf-8") as f:
    f.write(code_mauvais)

verif = subprocess.run([sys.executable, "-m", "pycodestyle", "exemple_pep8.py"],
                       capture_output=True, text=True)
print(verif.stdout)exemple_pep8.py:1:13: E231 missing whitespace after ','
exemple_pep8.py:1:15: E231 missing whitespace after ','
exemple_pep8.py:1:17: E231 missing whitespace after ','
exemple_pep8.py:1:19: E231 missing whitespace after ','
exemple_pep8.py:2:18: E231 missing whitespace after ':'
exemple_pep8.py:2:35: E231 missing whitespace after ':'Chaque ligne indique le fichier, la ligne, la colonne, puis le code de l’erreur (ici E231) et son explication. Dans mon cas, je dois seulement ajouter une espace après , et :. J’ai aussi renommé ma variable x en my_name : ce n’est pas signalé par l’outil, mais le PEP 8 recommande des noms de variables faciles à comprendre. Voici la version corrigée :
code_bien = """my_list = [1, 2, 3, 4, 5]
my_dict = {'key1': 'value1', 'key2': 'value2'}
my_name = "Rod"
"""
with open("exemple_pep8.py", "w", encoding="utf-8") as f:
    f.write(code_bien)

verif = subprocess.run([sys.executable, "-m", "pycodestyle", "exemple_pep8.py"],
                       capture_output=True, text=True)
print(verif.stdout or "Aucun problème signalé")Aucun problème signaléDes outils comme Black ou Ruff peuvent aussi reformater ton code automatiquement selon ces règles.
Erreur 6 : mal utiliser les méthodes .keys() et .values() avec les dictionnaires
Tu sais sûrement ce que font les méthodes .keys() et .values() sur un dictionnaire. Au cas où, voici un exemple (population en millions d’habitants, chiffres approximatifs de 2021) :
dict_countries = {'France': 67.4, 'Spain': 47.3, 'Portugal': 10.3}

print(dict_countries.keys())
print(dict_countries.values())dict_keys(['France', 'Spain', 'Portugal'])
dict_values([67.4, 47.3, 10.3])Le problème, c’est que ces méthodes ne sont pas toujours bien utilisées. Imaginons que nous voulions parcourir le dictionnaire avec une boucle et obtenir les clés. Tu pourrais utiliser .keys(), mais savais-tu qu’on obtient les clés en parcourant directement le dictionnaire ? Dans ce cas, .keys() est inutile.
# Mauvaise pratique
for key in dict_countries.keys():
print(key)France
Spain
Portugal# Bonne pratique
for key in dict_countries:
print(key)Les deux boucles affichent les mêmes clés. De même, tu pourrais chercher des solutions de contournement pour obtenir les valeurs d’un dictionnaire, alors que la méthode .items() donne la clé et la valeur en même temps :
# Mauvaise pratique
for key in dict_countries:
print(dict_countries[key])67.4
47.3
10.3# Bonne pratique
for key, value in dict_countries.items():
print(key)
print(value)France
67.4
Spain
47.3
Portugal
10.3Et si tu n’as besoin que des valeurs, parcours .values() :
# Si tu n'as besoin que des valeurs
for value in dict_countries.values():
print(value)67.4
47.3
10.3Erreur 7 : ne jamais utiliser les compréhensions (ou les utiliser tout le temps)
Une compréhension offre une syntaxe plus courte pour créer une nouvelle séquence (liste, dictionnaire, etc.) à partir d’une séquence déjà définie. Supposons que nous voulions mettre en minuscules tous les éléments de la liste countries. Tu peux le faire avec une boucle for :
# Mauvaise pratique
countries = ['France', 'Spain', 'Portugal']

lower_case = []
for country in countries:
    lower_case.append(country.lower())

print(lower_case)['france', 'spain', 'portugal']ou simplifier avec une compréhension de liste :
# Bien (mais n'en abuse pas !)
lower_case = [country.lower() for country in countries]
print(lower_case)Le résultat est identique. Tu peux aussi ajouter une condition à la fin, ou créer un dictionnaire avec une compréhension de dictionnaire :
longs = [country.lower() for country in countries if len(country) > 5]
longueurs = {country: len(country) for country in countries}
print(longs)
print(longueurs)['france', 'portugal']
{'France': 6, 'Spain': 5, 'Portugal': 8}Les compréhensions sont très utiles, mais n’en abuse pas : dès qu’elle contient plusieurs boucles ou plusieurs conditions imbriquées, une compréhension devient difficile à lire et une boucle classique est préférable. Rappelle-toi le Zen de Python : « Simple is better than complex ».
Erreur 8 : utiliser range(len())
L’une des premières fonctions qu’on apprend en Python est range(), accompagnée de len(). Il n’est donc pas étonnant que beaucoup de débutants écrivent range(len()) pour boucler sur des listes. Supposons que nous ayons une liste de pays et une liste de populations, et que nous voulions les parcourir en même temps :
# Mauvaise pratique : range(len())
countries = ['France', 'Spain', 'Portugal']
populations = [67.4, 47.3, 10.3]

for i in range(len(countries)):
    country = countries[i]
    population = populations[i]
print(f"{country} a une population de {population} millions d'habitants")France a une population de 67.4 millions d'habitants
Spain a une population de 47.3 millions d'habitants
Portugal a une population de 10.3 millions d'habitantsCela fonctionne, mais tu peux simplifier ton code avec enumerate() :
# OK
for i, country in enumerate(countries):
    population = populations[i]
print(f"{country} a une population de {population} millions d'habitants")Ou, mieux encore, avec zip(), qui associe les éléments des deux listes :
# Bien mieux
for country, population in zip(countries, populations):
print(f"{country} a une population de {population} millions d'habitants")Les trois versions affichent exactement le même résultat. Depuis Python 3.10, zip() accepte aussi le paramètre strict=True, qui lève une erreur si les deux listes n’ont pas la même longueur, au lieu de s’arrêter silencieusement à la plus courte :
try:
    for country, population in zip(countries, [67.4, 47.3], strict=True):
        print(country, population)
except ValueError as erreur:
print("ValueError :", erreur)France 67.4
Spain 47.3
ValueError : zip() argument 2 is shorter than argument 1Erreur 9 : formater du texte avec l’opérateur +
L’une des premières choses qu’on apprend en Python est probablement de joindre des chaînes de caractères avec l’opérateur +. C’est un moyen simple, mais peu lisible : plus tu as de morceaux à joindre, plus tu écris de + et de guillemets. Au lieu de cet opérateur, utilise les f-strings :
name = "Rod"

# Mauvaise pratique
print("Bonjour, " + name + "!")

# Bonne pratique
print(f"Bonjour, {name}!")Bonjour, Rod!
Bonjour, Rod!Avec +, il faut aussi penser à convertir les nombres en texte, sinon Python lève une erreur. Avec une f-string, ce n’est pas nécessaire :
age = 30

try:
    print("Âge : " + age)
except TypeError as erreur:
    print("TypeError :", erreur)

print(f"Âge : {age}")TypeError : can only concatenate str (not "int") to str
Âge : 30Le meilleur dans les f-strings, c’est qu’elles ne servent pas seulement à concaténer : elles permettent aussi de formater les nombres, les dates, les pourcentages, etc. (la virgule comme séparateur de milliers suit le format anglais) :
from datetime import date

prix = 1234.5678
aujourd_hui = date(2026, 10, 24)

print(f"Prix : {prix:.2f} €")
print(f"Prix : {prix:,.2f} €")
print(f"Date : {aujourd_hui:%d/%m/%Y}")
print(f"Part : {0.256:.1%}")Prix : 1234.57 €
Prix : 1,234.57 €
Date : 24/10/2026
Part : 25.6%Et pour assembler une liste de morceaux avec un séparateur, utilise join() :
morceaux = ["a", "b", "c"]
print("-".join(morceaux))a-b-cErreur 10 : utiliser une valeur mutable par défaut
Si tu utilises une valeur mutable (comme une liste) comme paramètre par défaut d’une fonction, tu obtiens un comportement inattendu :
# Mauvaise pratique
def my_function(i, my_list=[]):
    my_list.append(i)
    return my_list

print(my_function(1))
print(my_function(2))
print(my_function(3))
print(my_function.__defaults__)[1]
[1, 2]
[1, 2, 3]
([1, 2, 3],)À chaque appel de my_function, la liste my_list continue de sauvegarder les valeurs des appels précédents. Pourquoi ? Parce que la valeur par défaut est créée une seule fois, quand la fonction est définie, et non à chaque appel : la dernière ligne montre cette liste unique, stockée dans __defaults__. Il est probable que tu voulais démarrer avec une liste vide à chaque appel.
Pour éviter ce comportement, mets le paramètre my_list à None et ajoute la clause if ci-dessous :
# Bonne pratique
def my_function(i, my_list=None):
    if my_list is None:
        my_list = []
    my_list.append(i)
    return my_list

print(my_function(1))
print(my_function(2))
print(my_function(3))
print(my_function.__defaults__)[1]
[2]
[3]
(None,)Comment corriger ces 10 mauvaises habitudes en Python ?
- Erreur 1 : importe le module (
import math) ou l’objet précis (from math import pi). - Erreur 2 : précise l’exception dans
except, par exempleexcept ValueError. - Erreur 3 : utilise des opérations vectorielles NumPy plutôt qu’une boucle
for. - Erreur 4 : ouvre les fichiers avec
with open(...). - Erreur 5 : respecte le PEP 8 et vérifie-le avec un outil comme
pycodestyle. - Erreur 6 : parcours un dictionnaire directement, avec
.items()ou.values(). - Erreur 7 : utilise les compréhensions, sans en abuser.
- Erreur 8 : utilise
zip()ouenumerate()plutôt querange(len()). - Erreur 9 : utilise les f-strings plutôt que l’opérateur
+. - Erreur 10 : mets
Nonecomme valeur par défaut, puis crée la liste dans la fonction.
Questions fréquentes
Pourquoi éviter from module import * en Python ?
Parce que tu ne sais plus d’où viennent les fonctions utilisées, et que les noms de plusieurs modules peuvent s’écraser sans avertissement : la dernière importation gagne. Importe plutôt le module entier (import math) ou l’objet précis (from math import pi).
Quelle est la différence entre except et except Exception ?
Un except tout nu attrape toutes les exceptions, y compris SystemExit et KeyboardInterrupt, ce qui empêche d’interrompre le programme avec Ctrl-C. except Exception laisse passer ces deux-là. Le mieux est de préciser l’exception attendue, par exemple except ValueError.
Pourquoi utiliser with open() plutôt que open() et close() ?
Parce que with ferme le fichier même si une exception se produit pendant l’écriture ou la lecture. Avec open() puis close(), une exception empêche close() de s’exécuter et le fichier reste ouvert.
Comment parcourir deux listes en même temps en Python ?
Utilise zip() : for country, population in zip(countries, populations). Depuis Python 3.10, zip(countries, populations, strict=True) lève une erreur si les listes n’ont pas la même longueur.
Pourquoi ne faut-il pas utiliser une liste comme valeur par défaut d’une fonction ?
Parce que la valeur par défaut est créée une seule fois, à la définition de la fonction, et conservée entre les appels : la liste garde les valeurs des appels précédents. Mets None par défaut, puis crée la liste dans la fonction avec if my_list is None.
Comment vérifier que son code respecte le PEP 8 ?
Utilise un éditeur qui souligne les écarts (PyCharm, VS Code), ou l’outil pycodestyle : après pip install pycodestyle, la commande python -m pycodestyle fichier.py liste les problèmes avec leur code, par exemple E231 pour une espace manquante après une virgule.
Conclusion
J’espère que cette lecture t’a plu ! N’hésite pas à me dire dans les commentaires combien de ces mauvaises habitudes (parmi les 10 citées) tu avais conservées de tes débuts avec Python 🙂 Pour t’entraîner, reprends un de tes anciens scripts et cherche ces 10 erreurs : tu en trouveras sûrement au moins une.
Corriger ses mauvaises habitudes, c’est le début ; écrire du code propre sur de vrais projets de données, c’est ce qui fait progresser. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin sur Python :