Tu connais les bases de la régression linéaire et de la descente de gradient ? Il est temps de les appliquer à des données réelles. Dans cet article, tu vas faire une régression linéaire sur un cas réel avec Scikit-Learn : prédire le prix des maisons en Californie, du chargement des données jusqu’à l’évaluation du modèle avec la RMSE et le score R².
Article mis à jour en octobre 2026 : le jeu de données Boston Housing a disparu de scikit-learn (il a été retiré dans la version 1.2, notamment à cause d’une de ses colonnes, qui repose sur la proportion de personnes afro-américaines). Je l’ai remplacé par California Housing, fourni directement par scikit-learn. Tout le code a été exécuté dans Google Colab (scikit-learn 1.6, pandas 2.2) et tous les résultats sont de vraies exécutions. J’ai aussi corrigé l’explication de la standardisation, et ajouté les coefficients du modèle, un modèle de comparaison, un graphique des prix réels et prédits et un test avec toutes les variables.
En bref : charge les données avec fetch_california_housing(), repère avec la matrice de corrélation que le revenu médian (MedInc) est la variable la plus liée au prix (corrélation de 0,69), sépare les données en entraînement et test avec train_test_split(), standardise-les avec StandardScaler puis entraîne un LinearRegression. Avec deux variables, on obtient un R² de 0,509 sur les données de test et une RMSE de 0,803 (environ 80 000 $). Avec les huit variables, le R² monte à 0,596.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys
import numpy, pandas, sklearn, seaborn
print("Python", sys.version.split()[0])
print("scikit-learn", sklearn.__version__)
print("pandas", pandas.__version__)
print("numpy", numpy.__version__)
print("seaborn", seaborn.__version__)Python 3.13.16
scikit-learn 1.6.1
pandas 2.2.3
numpy 2.1.3
seaborn 0.13.2Quel jeu de données utiliser pour une régression linéaire sur un cas réel ?
Nous allons utiliser le jeu de données California Housing, tiré du recensement américain de 1990. Chaque ligne décrit un quartier de Californie (un « block group » du recensement) : le jeu contient 20 640 quartiers et 8 variables explicatives (features). L’objectif est de prédire la valeur médiane des maisons du quartier à partir de ces variables. Comme c’est un recensement de 1990, les prix sont ceux de l’époque : ce qui compte ici, c’est la méthode, pas les montants.
Comment importer les bibliothèques ?
Importons d’abord les bibliothèques classiques d’un projet de Data Science :
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as snsComment charger les données ?
Scikit-learn fournit le jeu de données : fetch_california_housing() le télécharge au premier appel. Avec as_frame=True, on obtient directement un DataFrame pandas dans l’attribut frame :
from sklearn.datasets import fetch_california_housing

housing = fetch_california_housing(as_frame=True)
df = housing.frame
print(df.shape)(20640, 9)Le DataFrame a 20 640 lignes et 9 colonnes : 8 variables explicatives et la variable cible. Voici les colonnes :
MedInc: revenu médian des ménages du quartier (en dizaines de milliers de dollars) ;HouseAge: âge médian des maisons du quartier (en années) ;AveRooms: nombre moyen de pièces par logement ;AveBedrms: nombre moyen de chambres par logement ;Population: nombre d’habitants du quartier ;AveOccup: nombre moyen d’occupants par logement ;LatitudeetLongitude: position du quartier ;MedHouseVal: valeur médiane des maisons du quartier, en centaines de milliers de dollars. C’est notre variable cible.
Affichons les 5 premières lignes avec head() :
df.head()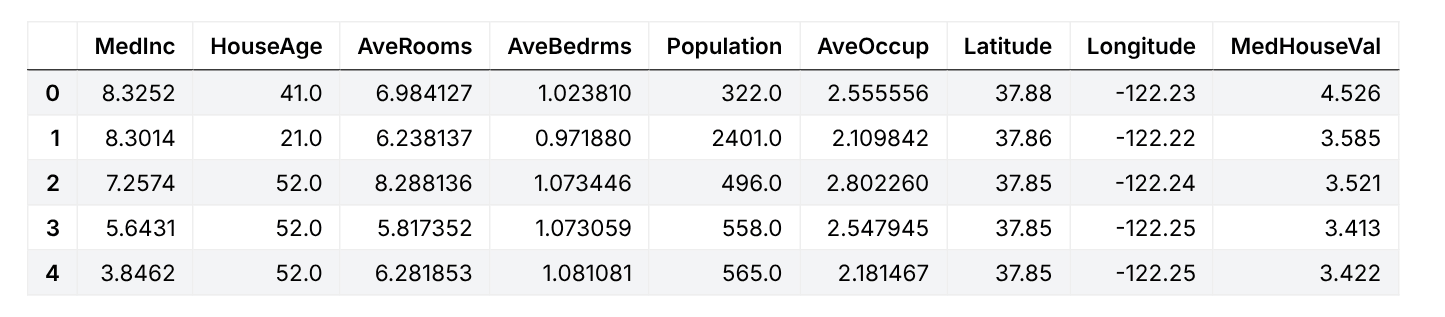
Le prix MedHouseVal de la première ligne vaut 4,526, soit environ 452 600 $. Résume ensuite chaque variable avec describe() :
df.describe().round(2)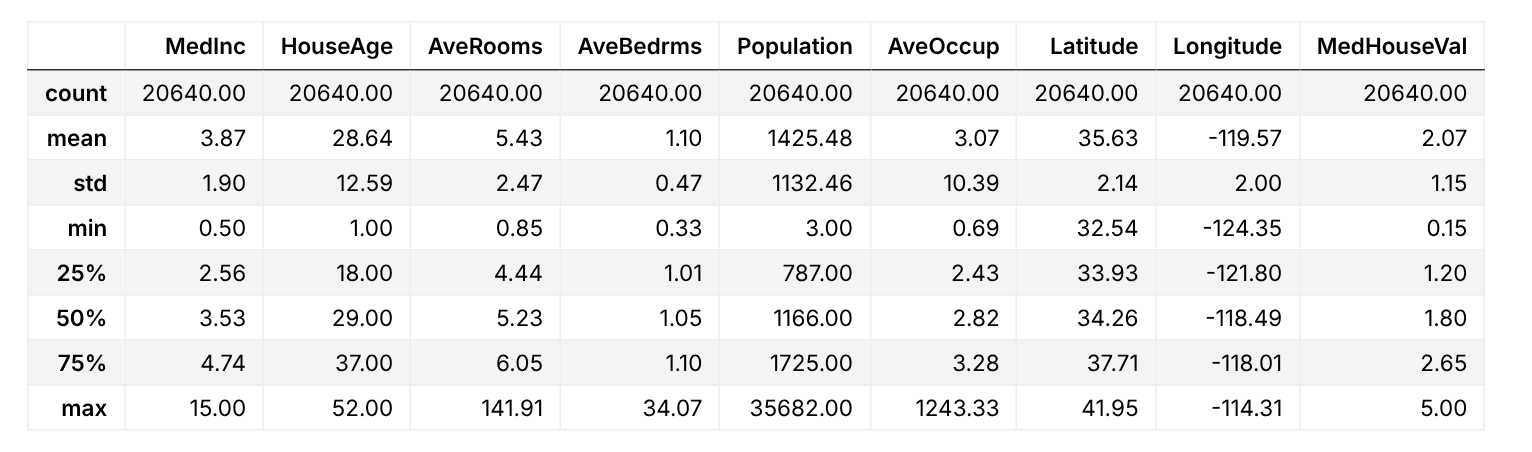
Deux choses à lire dans ce tableau. Le prix médian moyen est de 2,07 (environ 207 000 $) avec un écart type de 1,15. Et certaines variables ont des valeurs extrêmes : le nombre moyen de pièces par logement va jusqu’à 141,9 et le nombre moyen d’occupants jusqu’à 1 243, très loin des médianes (5,23 et 2,82). Ce sont des valeurs aberrantes dont il faut garder en tête l’existence.
Comment prétraiter les données avant la régression linéaire ?
Y a-t-il des valeurs manquantes ?
Après avoir chargé les données, vérifie s’il y a des valeurs manquantes. On compte les valeurs manquantes de chaque colonne avec .isnull().sum() :
df.isnull().sum()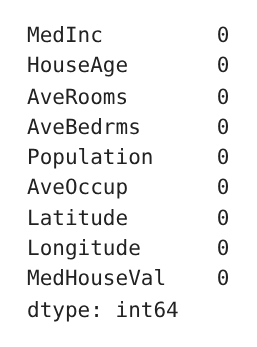
Il n’y en a aucune dans ce jeu de données. Si tu veux savoir quoi faire quand il y en a, lis le guide du traitement des données manquantes avec Pandas.
Comment explorer les données avant d’entraîner le modèle ?
L’analyse exploratoire est une étape essentielle avant l’entraînement (voir aussi l’analyse exploratoire de données avec Pandas). On utilise quelques visualisations pour comprendre le lien entre la variable cible et les autres variables.
Quelle est la distribution de la variable cible ?
Commençons par tracer la distribution du prix médian MedHouseVal avec la fonction displot() de seaborn :
g = sns.displot(data=df, x="MedHouseVal", bins=30, kde=True)
g.set_axis_labels("Prix médian des maisons (en 100 000 $)", "Nombre de quartiers")
plt.show()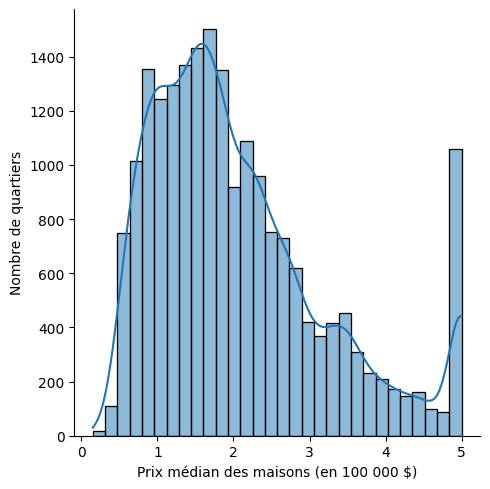
La distribution n’est pas normale : elle est étalée vers la droite, avec peu de quartiers très chers. Surtout, il y a un pic isolé tout à droite, à 5. Comptons les quartiers concernés :
prix_max = df["MedHouseVal"].max()
nb_plafonnes = (df["MedHouseVal"] == prix_max).sum()
print(f"Prix maximum : {prix_max}")
print(f"Quartiers au prix maximum : {nb_plafonnes} sur {len(df)}")Prix maximum : 5.00001
Quartiers au prix maximum : 965 sur 20640965 quartiers sur 20 640 (environ 4,7 %) ont le prix maximum de 5,00001, soit environ 500 000 $ : les prix sont plafonnés. Pour ces quartiers, le vrai prix est probablement plus élevé, ce qui limitera la qualité du modèle.
Quelles variables sont corrélées avec le prix ?
Ensuite, on calcule la matrice de corrélation, qui mesure les relations linéaires entre les variables, avec .corr() de pandas. On la trace avec la fonction heatmap() de seaborn :
plt.figure(figsize=(10, 7))
correlation_matrix = df.corr().round(2)
sns.heatmap(data=correlation_matrix, annot=True, cmap="coolwarm", center=0)
plt.title("Matrice de corrélation")
plt.show()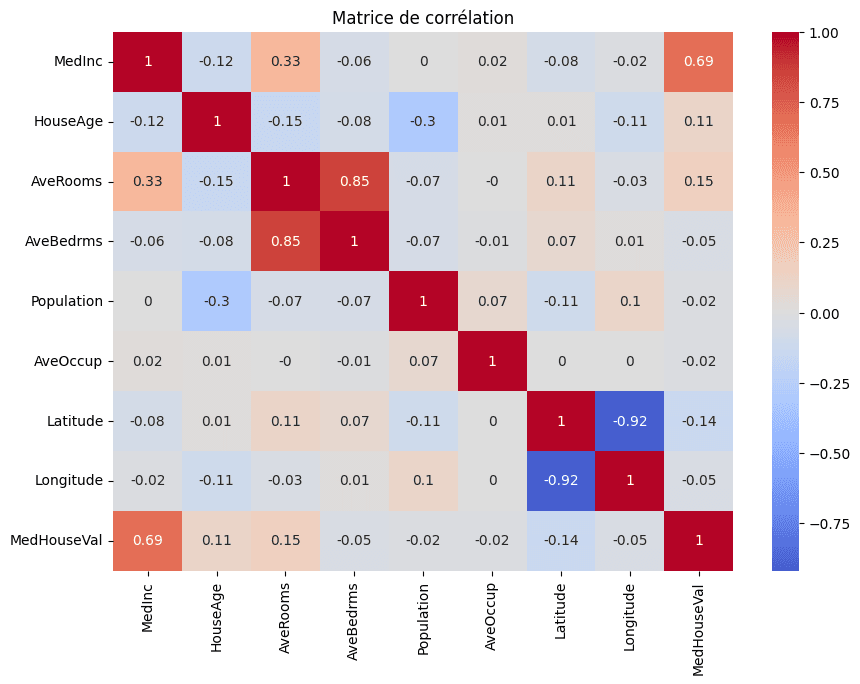
Le coefficient de corrélation varie de -1 à 1. Proche de 1, il indique une forte corrélation positive ; proche de -1, une forte corrélation négative. Pour lire directement la corrélation de chaque variable avec le prix :
df.corr()["MedHouseVal"].drop("MedHouseVal").sort_values(ascending=False).round(2)MedInc 0.69
AveRooms 0.15
HouseAge 0.11
AveOccup -0.02
Population -0.02
Longitude -0.05
AveBedrms -0.05
Latitude -0.14
Name: MedHouseVal, dtype: float64Ce que l’on observe :
- Seul le revenu médian
MedInca une forte corrélation positive avec le prix (0,69). Plus le quartier est aisé, plus les maisons sont chères. - Les autres variables ont une corrélation faible avec le prix :
AveRooms(0,15),HouseAge(0,11) etLatitude(-0,14). - Il faut aussi vérifier la multicolinéarité : deux variables explicatives très corrélées entre elles apportent la même information, et il vaut mieux n’en garder qu’une. C’est le cas de
AveRoomsetAveBedrms(0,85), et deLatitudeetLongitude(-0,92).
Nous gardons donc MedInc et HouseAge. La seconde est peu corrélée au prix (0,11), mais elle l’est très peu avec le revenu (-0,12) : elle apporte une information différente. On pourrait en choisir une autre, mais cela donne un exemple simple à deux variables.
Comment varient ces variables avec le prix ?
Voyons avec un nuage de points comment ces deux variables varient avec le prix :
features = ["MedInc", "HouseAge"]

plt.figure(figsize=(14, 5))
for i, col in enumerate(features):
    plt.subplot(1, len(features), i + 1)
    plt.scatter(df[col], df["MedHouseVal"], s=6, alpha=0.2)
    plt.title(col)
    plt.xlabel(col)
    plt.ylabel("MedHouseVal")
plt.tight_layout()
plt.show()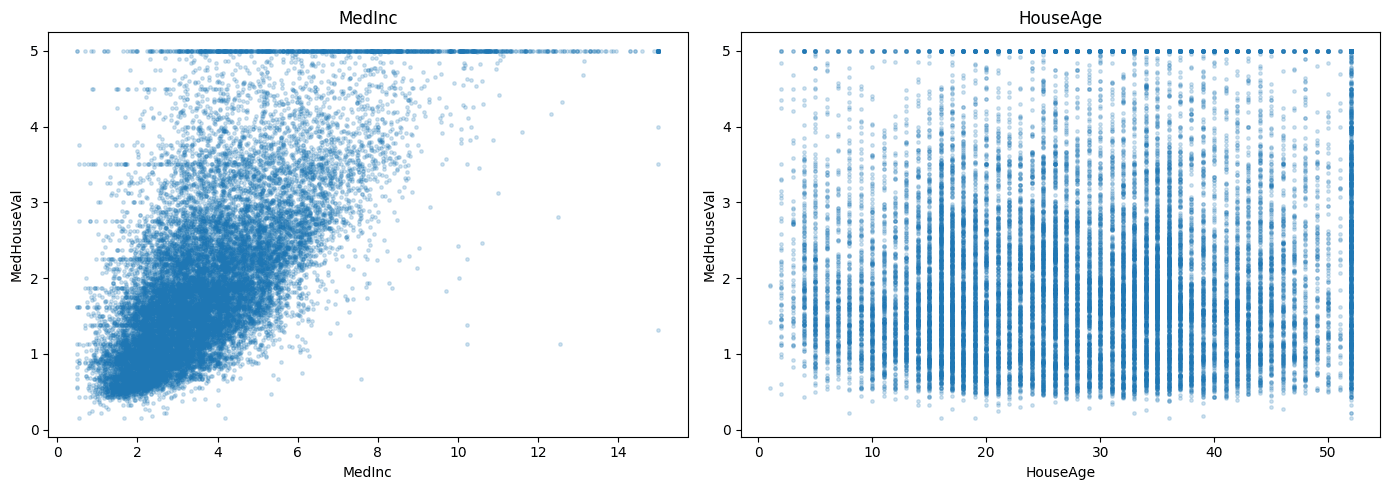
Les prix augmentent avec le revenu médian, à peu près en ligne droite. On voit aussi la ligne horizontale en haut : c’est le plafond de 5. En revanche, il n’y a pas de tendance claire entre l’âge des maisons et le prix. Les colonnes verticales viennent du fait que l’âge est un nombre entier d’années, avec un empilement à 52 ans, la valeur maximale.
Comment préparer les variables pour le modèle ?
Comment créer les variables X et y ?
On sépare les variables explicatives X (revenu médian et âge des maisons) de la variable cible y (le prix) :
X = df[["MedInc", "HouseAge"]]
y = df["MedHouseVal"]Comment séparer les données d’entraînement et de test ?
Ensuite, on divise les données en deux ensembles : entraînement et test. Nous entraînons le modèle avec 70 % des échantillons et le testons avec les 30 % restants, pour évaluer sa performance sur des données qu’il n’a jamais vues. On utilise la fonction train_test_split() de scikit-learn. Le paramètre random_state fixe le tirage au sort pour retrouver les mêmes résultats à chaque exécution :
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
print(X_train.shape)
print(X_test.shape)
print(y_train.shape)
print(y_test.shape)(14448, 2)
(6192, 2)
(14448,)
(6192,)On a 14 448 quartiers pour l’entraînement et 6 192 pour le test.
Pourquoi standardiser les données ?
Il y a plusieurs façons de mettre des variables à la même échelle. La standardisation, faite par StandardScaler, centre chaque variable sur 0 et lui donne un écart type de 1 (elle ne ramène donc pas les valeurs entre 0 et 1, contrairement à la normalisation). Pour la régression linéaire de scikit-learn, ce n’est pas obligatoire, mais cela rend les coefficients comparables entre eux, et c’est une bonne habitude. Ce qui est important : on ajuste le scaler sur les données d’entraînement uniquement, puis on applique la même transformation au jeu de test. Sinon, des informations du jeu de test fuiteraient dans l’entraînement.
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
scaler.fit(X_train)

X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test)

print("Moyenne des features (entraînement) :", (X_train.mean(axis=0).round(2) + 0.0))
print("Écart type des features (entraînement) :", X_train.std(axis=0).round(2))Moyenne des features (entraînement) : [0. 0.]
Écart type des features (entraînement) : [1. 1.]Sur l’entraînement, chaque variable a bien une moyenne de 0 et un écart type de 1.
Comment entraîner un modèle de régression linéaire avec Scikit-Learn ?
On crée le modèle avec LinearRegression et on l’entraîne avec la méthode fit() sur l’ensemble d’entraînement :
from sklearn.linear_model import LinearRegression

linear_model = LinearRegression()
linear_model.fit(X_train, y_train)Une fois entraîné, le modèle a trouvé ses paramètres : l’ordonnée à l’origine (intercept_) et un coefficient par variable (coef_) :
print("Ordonnée à l'origine :", round(linear_model.intercept_, 3))
for nom, coef in zip(["MedInc", "HouseAge"], linear_model.coef_):
print(f"Coefficient de {nom} : {coef:.3f}")Ordonnée à l'origine : 2.069
Coefficient de MedInc : 0.822
Coefficient de HouseAge : 0.220Comme les variables sont standardisées, l’ordonnée à l’origine (2,069) est le prix prédit pour un quartier moyen, soit environ 207 000 $. Chaque coefficient donne l’effet sur le prix d’une augmentation d’un écart type de la variable. Quand le revenu médian augmente d’un écart type (environ 1,9, soit 19 000 $), le prix prédit augmente de 0,822, soit environ 82 000 $. Quand l’âge des maisons augmente d’un écart type (environ 12,6 ans), il augmente de 0,220, soit environ 22 000 $. Attention : ce sont des associations observées dans les données, pas des relations de cause à effet.
Comment évaluer un modèle de régression linéaire ?
On évalue le modèle avec la racine de l’erreur quadratique moyenne (RMSE) et le score R². La RMSE s’exprime dans la même unité que la cible ; le R² indique la part de la variance du prix expliquée par le modèle (1 pour un modèle parfait, 0 pour un modèle qui prédit toujours la moyenne). Depuis scikit-learn 1.4, la fonction root_mean_squared_error() calcule directement la RMSE. On évalue le modèle sur l’entraînement et sur le test :
from sklearn.metrics import root_mean_squared_error, r2_score


def evaluer(titre, y_reel, y_predit):
    rmse = root_mean_squared_error(y_reel, y_predit)
    r2 = r2_score(y_reel, y_predit)
    print(titre)
    print(f"  RMSE : {rmse:.3f}")
    print(f"  R2   : {r2:.3f}")


evaluer("Ensemble d'entraînement", y_train, linear_model.predict(X_train))
evaluer("Ensemble de test", y_test, linear_model.predict(X_test))Ensemble d'entraînement
RMSE : 0.811
R2 : 0.509
Ensemble de test
RMSE : 0.803
R2 : 0.509Les deux ensembles donnent des résultats presque identiques (R² de 0,509 en entraînement et en test) : le modèle ne souffre pas de surapprentissage. La RMSE de test est de 0,803, soit une erreur typique d’environ 80 000 $ sur le prix d’un quartier. Le modèle explique à peu près la moitié de la variance des prix.
Est-ce bon ? Pour le savoir, comparons-le à un modèle naïf qui prédit toujours le prix moyen, avec DummyRegressor :
from sklearn.dummy import DummyRegressor

modele_naif = DummyRegressor(strategy="mean")
modele_naif.fit(X_train, y_train)
evaluer("Modèle naïf (prédit toujours la moyenne), test", y_test, modele_naif.predict(X_test))Modèle naïf (prédit toujours la moyenne), test
RMSE : 1.146
R2 : -0.000Le modèle naïf se trompe de 1,146 en moyenne (RMSE) et son R² est de 0 par définition. Notre régression ramène l’erreur à 0,803 : elle est environ 30 % plus précise. C’est un vrai progrès, mais l’erreur reste importante.
Pour comprendre où le modèle se trompe, traçons les prix prédits en fonction des prix réels sur l’ensemble de test. Si le modèle était parfait, tous les points seraient sur la droite rouge :
y_pred = linear_model.predict(X_test)

plt.figure(figsize=(6, 6))
plt.scatter(y_test, y_pred, s=6, alpha=0.3)
plt.plot([0, 5], [0, 5], color="red", label="Prédiction parfaite")
plt.xlabel("Prix réel (en 100 000 $)")
plt.ylabel("Prix prédit (en 100 000 $)")
plt.legend()
plt.show()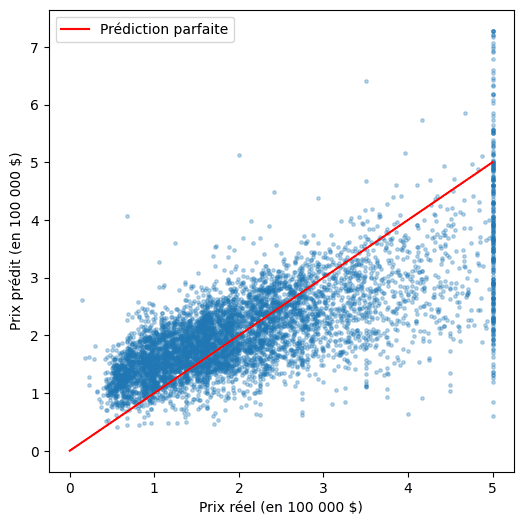
Les points sont très dispersés autour de la droite. Le modèle sous-estime souvent les quartiers chers, et il prédit parfois plus de 5, un prix qui n’existe pas dans les données. La colonne de points à 5 correspond aux prix plafonnés : le modèle y fait des prédictions très variées, car le vrai prix de ces quartiers est inconnu.
Comment améliorer le modèle de régression linéaire ?
Nous n’avons utilisé que deux variables sur huit. Que se passe-t-il avec toutes ? Pour éviter d’oublier la standardisation (et de la faire sur le test), on peut regrouper la mise à l’échelle et le modèle dans un Pipeline, qui applique les mêmes étapes à l’entraînement et à la prédiction :
from sklearn.pipeline import make_pipeline

toutes_les_features = [c for c in df.columns if c != "MedHouseVal"]
X_tout_train, X_tout_test, y_tout_train, y_tout_test = train_test_split(
    df[toutes_les_features], y, test_size=0.3, random_state=42
)

modele_complet = make_pipeline(StandardScaler(), LinearRegression())
modele_complet.fit(X_tout_train, y_tout_train)

evaluer("8 features, test", y_tout_test, modele_complet.predict(X_tout_test))8 features, test
RMSE : 0.728
R2 : 0.596Le R² de test passe de 0,509 à 0,596, et la RMSE de 0,803 à 0,728. Les variables ajoutées aident donc, même si deux d’entre elles sont fortement corrélées entre elles (Latitude et Longitude, AveRooms et AveBedrms). Il reste de la marge : pour aller plus loin, tu peux essayer d’autres modèles que la régression linéaire, ou créer de nouvelles variables à partir de celles qui existent. Pour situer la régression linéaire parmi les autres, lis les modèles de Machine Learning expliqués.
Questions fréquentes
Comment faire une régression linéaire avec Scikit-Learn ?
Charge tes données dans un DataFrame, sépare les variables explicatives X de la cible y, découpe-les avec train_test_split(), standardise X avec StandardScaler (ajusté sur l’entraînement), crée un LinearRegression, entraîne-le avec fit() puis évalue-le sur le jeu de test avec root_mean_squared_error() et r2_score().
Pourquoi le jeu de données Boston Housing a-t-il disparu de scikit-learn ?
Scikit-learn l’a retiré dans la version 1.2, notamment parce qu’une de ses colonnes (B) repose sur la proportion de personnes afro-américaines, ce qui pose un problème éthique. On peut le remplacer par California Housing, chargé avec fetch_california_housing(), qui permet de s’entraîner à la régression de la même façon.
Faut-il standardiser les données pour une régression linéaire ?
Ce n’est pas obligatoire avec LinearRegression de scikit-learn, qui donne les mêmes prédictions avec ou sans standardisation. Mais la standardisation rend les coefficients comparables entre eux. Il faut ajuster le StandardScaler sur l’entraînement uniquement, puis appliquer la transformation au test, pour éviter une fuite de données.
Comment choisir les variables d’une régression linéaire ?
On regarde la corrélation de chaque variable avec la cible, et on évite de garder ensemble deux variables très corrélées entre elles (multicolinéarité). Dans California Housing, le revenu médian est le plus corrélé au prix (0,69), alors que la latitude et la longitude sont corrélées entre elles (-0,92).
Comment interpréter un R² de 0,51 ?
Un R² de 0,51 signifie que le modèle explique environ la moitié de la variance de la variable cible. Pour savoir si c’est bon, compare-le à un modèle naïf qui prédit la moyenne (R² de 0). Ici, la RMSE passe de 1,146 pour le modèle naïf à 0,803 pour la régression avec deux variables, puis à 0,728 avec les huit variables.
Comment améliorer un modèle de régression linéaire ?
Ajoute des variables utiles : sur California Housing, passer de 2 à 8 variables fait monter le R² de test de 0,509 à 0,596. Tu peux aussi créer de nouvelles variables, traiter les valeurs aberrantes ou les prix plafonnés, ou essayer un modèle non linéaire.
Conclusion
Tu as appliqué une régression linéaire sur un cas réel : charger les données, les explorer, choisir des variables, séparer entraînement et test, standardiser, entraîner le modèle avec Scikit-Learn et l’évaluer. Avec deux variables, le modèle explique environ la moitié de la variance des prix ; avec huit, un peu plus de la moitié (R² de 0,596). Pour t’entraîner, change les variables choisies, ou refais l’exercice avec un autre jeu de données, par exemple sur Kaggle ou Google Dataset Search.
Savoir faire tourner un modèle, c’est un début ; savoir l’évaluer et l’améliorer, c’est le métier de data scientist. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin :