Transforme tes expérimentations sur Jupyter Notebook en applications prêtes pour la production grâce à ce guide complet.
Le déploiement de modèles de Machine Learning est la passerelle entre le développement et le monde réel. Les Data Scientists construisent et testent souvent leurs modèles dans des environnements comme Jupyter Notebook, mais la mise en production demande plusieurs étapes supplémentaires. Dans ce guide, je te montre comment extraire un modèle d’un notebook et le déployer, du fichier sauvegardé jusqu’à l’API, au conteneur Docker et au cloud.
Article mis à jour en novembre 2026 : j’ai exécuté chaque étape avec Python 3.13 et scikit-learn 1.9 (entraînement, sauvegarde, API Flask appelée avec curl, gunicorn, FastAPI, prédictions par lots, détection de dérive) et j’ai ajouté les sorties. Le fichier data.csv de la première version n’était pas fourni : j’utilise le jeu de données Iris, livré avec scikit-learn. Je n’ai pas pu lancer Docker ni déployer dans le cloud depuis mon environnement : ces blocs sont signalés comme non exécutés. J’ai aussi mis à jour l’image Docker (Python 3.9 n’est plus maintenu) et ajouté les pièges à connaître : versions de scikit-learn, sécurité des fichiers .pkl et debug=True.
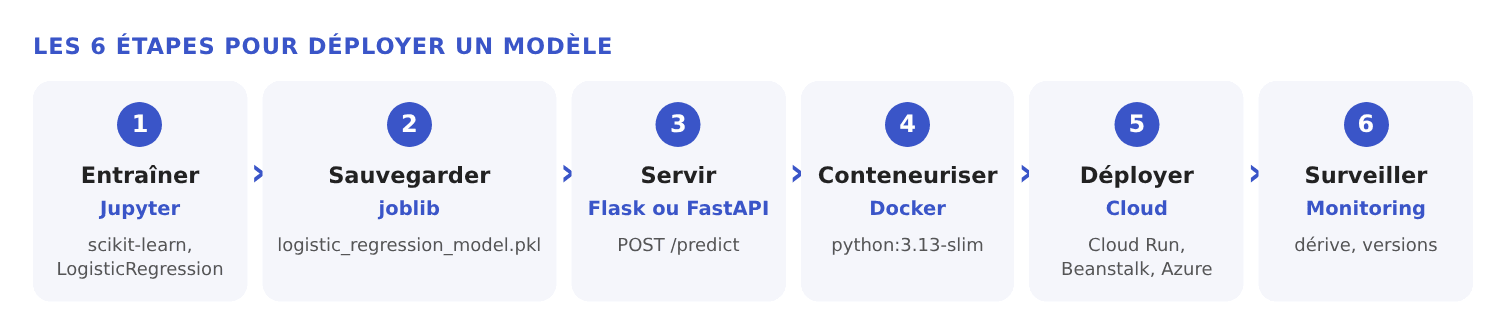
En bref : pour déployer un modèle de Machine Learning, entraîne-le, sauvegarde-le avec joblib, expose-le dans une API (Flask ou FastAPI) servie par gunicorn, mets l’API dans une image Docker, déploie cette image chez un fournisseur cloud, puis surveille la dérive des données. En local, mon API répond en environ 2,7 ms par requête.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : il entraîne le modèle, démarre l’API et la teste, sans rien installer sur ton ordinateur.
Voici les versions que j’utilise :
import json
import subprocess
import sys
import time
import warnings
from pathlib import Path

import joblib
import numpy as np
import pandas as pd
import requests
import sklearn

print("Python", sys.version.split()[0])
print("scikit-learn", sklearn.__version__)
print("joblib", joblib.__version__)

def sh(commande):
    """Lance une commande dans le terminal et affiche sa sortie."""
    resultat = subprocess.run(commande, shell=True, capture_output=True, text=True)
    sortie = (resultat.stdout + resultat.stderr).strip()
    if sortie:
print(sortie)Python 3.13.16
scikit-learn 1.9.1
joblib 1.6.0Pourquoi déployer un modèle de Machine Learning ?
L’entraînement d’un modèle ne représente que la moitié du travail. Tant qu’il reste dans ton notebook, personne d’autre ne peut s’en servir. Le déploiement permet de :
- Faire des prédictions en temps réel : moteurs de recommandation, détection de fraude, chatbots.
- Automatiser la prise de décision : intégrer l’IA aux flux de travail existants de l’entreprise.
- Rendre ton modèle accessible : permettre aux utilisateurs ou à d’autres applications d’interagir avec lui via une API ou une interface.
Voyons les étapes pour passer de Jupyter à la production.
Étape 1 : Comment entraîner le modèle dans Jupyter Notebook ?
Les notebooks Jupyter sont l’environnement préféré pour expérimenter : exécution interactive du code, visualisation facile et documentation en markdown (pour en tirer le meilleur, lis ces 10 fonctionnalités de Jupyter Notebook). La première version de l’article lisait un fichier data.csv absent. Je le crée donc à partir du jeu de données Iris (150 fleurs, 4 mesures, 3 espèces) :
from sklearn.datasets import load_iris

# Le jeu de données Iris (150 fleurs, 4 mesures, 3 espèces) est livré avec scikit-learn
load_iris(as_frame=True).frame.to_csv("data.csv", index=False)

df = pd.read_csv("data.csv")
print(df.shape)
print(df["target"].value_counts().sort_index().to_dict())
df.head(3)(150, 5)
{0: 50, 1: 50, 2: 50}
sepal length (cm) sepal width (cm) petal length (cm) petal width (cm) target
0 5.1 3.5 1.4 0.2 0
1 4.9 3.0 1.4 0.2 0
2 4.7 3.2 1.3 0.2 0Voici l’entraînement d’un modèle simple, une régression logistique, dans un notebook :
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# Charger un échantillon de données
df = pd.read_csv("data.csv")

# Séparer en features et target
X = df.drop("target", axis=1)
y = df["target"]

# Diviser en train / test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Entraîner un modèle de régression logistique
model = LogisticRegression()
model.fit(X_train, y_train)

# Évaluer le modèle
y_pred = model.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")Accuracy: 1.0Ce 1.0 est dû à la simplicité d’Iris : sur des données réelles, ne t’attends pas à un tel score. À ce stade, le modèle est entraîné et évalué dans Jupyter. Pour l’utiliser en dehors, il faut passer aux étapes suivantes.
Étape 2 : Comment sauvegarder le modèle entraîné ?
Avant de déployer le modèle, sauvegarde-le pour pouvoir le charger dans un environnement de production. L’approche courante consiste à le sérialiser avec pickle ou joblib. Pour un modèle scikit-learn, joblib est recommandé, car il gère efficacement les tableaux NumPy.
# Sauvegarder le modèle dans un fichier
joblib.dump(model, "logistic_regression_model.pkl")

taille = Path("logistic_regression_model.pkl").stat().st_size
print(f"Fichier : logistic_regression_model.pkl ({taille} octets)")

# Vérification : le modèle rechargé donne exactement les mêmes prédictions
modele_recharge = joblib.load("logistic_regression_model.pkl")
print("Mêmes prédictions après rechargement :", (modele_recharge.predict(X_test) == y_pred).all())Fichier : logistic_regression_model.pkl (1311 octets)
Mêmes prédictions après rechargement : TrueLe modèle tient dans un fichier de 1 311 octets, qui peut être rechargé plus tard pour prédire. Deux pièges méritent ton attention.
Piège 1 : la version de scikit-learn
Un fichier .pkl contient l’état interne du modèle, pas un format universel. Si tu le charges avec une autre version de scikit-learn que celle de l’entraînement, tu peux obtenir des résultats faux sans erreur. scikit-learn prévient avec un avertissement. Pour te le montrer, je sauvegarde un modèle en faisant comme si la version était 1.0.2 (j’ai modifié temporairement la version enregistrée, je n’ai pas installé l’ancienne version), puis je le recharge :
import sklearn.base

vraie_version = sklearn.base.__version__
sklearn.base.__version__ = "1.0.2"          # on fait comme si le modèle avait été sauvegardé avec une ancienne version
joblib.dump(model, "ancien_modele.pkl")
sklearn.base.__version__ = vraie_version

with warnings.catch_warnings(record=True) as avertissements:
    warnings.simplefilter("always")
    joblib.load("ancien_modele.pkl")

print(avertissements[0].category.__name__)
print(str(avertissements[0].message).split(" For more info")[0])InconsistentVersionWarning
Trying to unpickle estimator LogisticRegression from version 1.0.2 when using version 1.9.1. This might lead to breaking code or invalid results. Use at your own risk.En production, fige les versions de scikit-learn et des autres bibliothèques dans un fichier requirements.txt (étape 5), et réentraîne le modèle si tu en changes.
Piège 2 : la sécurité
Charger un fichier pickle ou joblib peut exécuter du code. Voici un fichier inoffensif qui le prouve : il se contente d’afficher un message au chargement, mais il aurait pu faire n’importe quoi :
class Piege:
    def __reduce__(self):
        # Dit à pickle : "pour reconstruire cet objet, appelle print(...)"
        return (print, ("Du code s'est exécuté pendant le chargement du fichier !",))

joblib.dump(Piege(), "inoffensif.pkl")
joblib.load("inoffensif.pkl")Du code s'est exécuté pendant le chargement du fichier !Ne charge jamais un fichier .pkl dont tu ne connais pas la provenance. Si tu dois échanger des modèles avec des tiers, regarde des formats comme ONNX ou la bibliothèque skops.
Étape 3 : Quelle stratégie de déploiement choisir ?
Plusieurs approches existent, selon ton cas d’usage et ton infrastructure.
Déploiement en API REST
Ton modèle devient un service : les autres applications lui envoient une requête HTTP et reçoivent la prédiction. C’est la solution pour les applications web et mobiles, et c’est celle que je détaille à l’étape 4.
Traitement par lots (batch)
Le modèle tourne périodiquement (chaque nuit, chaque semaine) sur un gros fichier ou une table, et les prédictions sont stockées pour plus tard. C’est courant en finance ou en santé, quand la décision n’a pas besoin d’être instantanée. Pas d’API nécessaire : un script suffit.
# Traitement par lots : le modèle tourne sur un fichier, sans API
nouveaux = df.drop(columns="target").sample(8, random_state=1)
nouveaux.to_csv("nouveaux.csv", index=False)

modele = joblib.load("logistic_regression_model.pkl")
lot = pd.read_csv("nouveaux.csv")
lot["prediction"] = modele.predict(lot)
lot.to_csv("predictions.csv", index=False)

print(lot.to_string(index=False)) sepal length (cm) sepal width (cm) petal length (cm) petal width (cm) prediction
5.8 4.0 1.2 0.2 0
5.1 2.5 3.0 1.1 1
6.6 3.0 4.4 1.4 1
5.4 3.9 1.3 0.4 0
7.9 3.8 6.4 2.0 2
6.3 3.3 4.7 1.6 1
6.9 3.1 5.1 2.3 2
5.1 3.8 1.9 0.4 0Données en continu (streaming)
Pour des prédictions en temps réel sur des données qui arrivent en flux, le modèle peut être intégré à un pipeline de streaming avec Apache Kafka ou Flink. Ce cas dépasse le cadre de cet article (voir Python pour la Data Engineering pour les pipelines de données).
Étape 4 : Comment déployer le modèle en API REST ?
L’approche la plus courante consiste à servir ton modèle en API REST avec un framework web léger comme Flask ou FastAPI.
Comment créer l’API avec Flask ?
Crée un fichier app.py qui charge le modèle et définit le point d’entrée /predict. Par rapport à la première version de l’article, j’ai ajouté une route /health (pratique pour vérifier que l’API tourne), la validation des données reçues (sinon une requête mal formée fait planter l’API) et le renvoi du nom de l’espèce. Je construis un DataFrame avec les mêmes noms de colonnes qu’à l’entraînement, sinon scikit-learn affiche un avertissement :
from flask import Flask, request, jsonify
import joblib
import pandas as pd

# Charger le modèle entraîné
model = joblib.load("logistic_regression_model.pkl")
ESPECES = ["setosa", "versicolor", "virginica"]

app = Flask(__name__)


@app.route("/health")
def health():
    return jsonify({"status": "ok"})


@app.route("/predict", methods=["POST"])
def predict():
    data = request.get_json(silent=True)   # None si le JSON est absent ou invalide
    features = data.get("features") if isinstance(data, dict) else None
    if not isinstance(features, list) or len(features) != 4 \
            or not all(isinstance(x, (int, float)) for x in features):
        return jsonify({"erreur": "envoie 4 nombres dans 'features'"}), 400
    # Même noms de colonnes qu'à l'entraînement, sinon scikit-learn affiche un avertissement
    X = pd.DataFrame([features], columns=model.feature_names_in_)
    classe = int(model.predict(X)[0])
    return jsonify({"prediction": classe, "espece": ESPECES[classe]})


if __name__ == "__main__":
app.run(port=5000) # surtout pas debug=True en productionComment lancer l’API ?
Pour lancer l’application en local, tape python app.py dans un terminal. Ici, je la démarre depuis le notebook (en arrière-plan) et je vérifie qu’elle répond :
log = open("flask.log", "w")
serveur = subprocess.Popen([sys.executable, "app.py"], stdout=log, stderr=subprocess.STDOUT)

# On attend que l'API réponde
for _ in range(100):
    try:
        print(requests.get("http://127.0.0.1:5000/health", timeout=1).json())
        break
    except requests.RequestException:   # pas encore prêt (connexion refusée ou réponse trop lente)
time.sleep(0.2){'status': 'ok'}Tu peux maintenant envoyer des requêtes à http://localhost:5000/predict. Voici la requête POST de l’article d’origine, avec les quatre mesures d’une fleur au format JSON :
sh("""curl -s -X POST http://localhost:5000/predict -H "Content-Type: application/json" -d '{"features": [5.1, 3.5, 1.4, 0.2]}'"""){"espece":"setosa","prediction":0}Le modèle répond prediction: 0, c’est-à-dire la classe 0 d’Iris : une setosa. Que se passe-t-il si on envoie une requête invalide ? Et combien de temps met l’API à répondre ?
# Une requête invalide reçoit une erreur claire, pas un plantage
reponse = requests.post("http://127.0.0.1:5000/predict", json={"features": [5.1, 3.5]})
print(reponse.status_code, reponse.json())

# Latence moyenne sur 200 requêtes (serveur de développement, sur ma machine)
session = requests.Session()
debut = time.perf_counter()
for _ in range(200):
    session.post("http://127.0.0.1:5000/predict", json={"features": [5.1, 3.5, 1.4, 0.2]})
print(f"Latence moyenne : {(time.perf_counter() - debut) / 200 * 1000:.1f} ms par requête")400 {'erreur': "envoie 4 nombres dans 'features'"}
Latence moyenne : 3.3 ms par requêteUne requête mal formée reçoit une erreur claire (code 400). Sur ma machine, une prédiction prend environ 3,3 ms en comptant l’aller-retour HTTP. Ce chiffre est indicatif : il dépend de ta machine, de la taille du modèle et du nombre de requêtes simultanées (mon test envoie les requêtes l’une après l’autre). Je coupe le serveur :
serveur.terminate()
serveur.wait()
log.close()
print("Serveur arrêté.")
print("Requêtes POST /predict dans le journal :", Path("flask.log").read_text().count("POST /predict"))Serveur arrêté.
Requêtes POST /predict dans le journal : 202Pourquoi ne pas utiliser debug=True et le serveur de Flask en production ?
La première version de l’article terminait avec app.run(debug=True). Le mode debug de Flask expose un débogueur interactif qui permet d’exécuter du code sur ton serveur : ne l’active jamais en production. Et le serveur intégré à Flask est un serveur de développement. En production, utilise un serveur WSGI comme gunicorn, qui lance plusieurs processus (« workers ») pour traiter des requêtes en parallèle :
gunicorn -w 2 -b 127.0.0.1:8000 app:appJe le lance pour de vrai, avec deux workers, et je refais le test :
log = open("gunicorn.log", "w")
prod = subprocess.Popen([sys.executable, "-m", "gunicorn", "-w", "2", "-b", "127.0.0.1:8000", "app:app"],
                        stdout=log, stderr=subprocess.STDOUT)
for _ in range(100):
    try:
        requests.get("http://127.0.0.1:8000/health", timeout=1)
        break
    except requests.RequestException:   # pas encore prêt (connexion refusée ou réponse trop lente)
        time.sleep(0.2)

print(requests.post("http://127.0.0.1:8000/predict", json={"features": [6.7, 3.0, 5.2, 2.3]}).json())

session = requests.Session()
debut = time.perf_counter()
for _ in range(200):
    session.post("http://127.0.0.1:8000/predict", json={"features": [6.7, 3.0, 5.2, 2.3]})
print(f"Latence moyenne : {(time.perf_counter() - debut) / 200 * 1000:.1f} ms par requête")

prod.terminate()
prod.wait()
log.close()
print("Workers gunicorn démarrés :", Path("gunicorn.log").read_text().count("Booting worker")){'espece': 'virginica', 'prediction': 2}
Latence moyenne : 2.7 ms par requête
Workers gunicorn démarrés : 2Même résultat, avec les mêmes 2,7 ms environ (mon test n’envoie qu’une requête à la fois, l’intérêt des workers apparaît quand plusieurs clients appellent l’API en même temps). Cette commande est celle que j’utilise dans le Dockerfile.
Et avec FastAPI ?
FastAPI est l’autre choix courant. Il valide les données automatiquement (avec Pydantic) et génère une documentation interactive sur /docs. Voici la même API en 17 lignes, que je teste sans démarrer de serveur grâce à TestClient :
from fastapi import FastAPI
from pydantic import BaseModel, Field
import joblib
import pandas as pd

model = joblib.load("logistic_regression_model.pkl")
app = FastAPI()


class Mesures(BaseModel):
    features: list[float] = Field(min_length=4, max_length=4)


@app.post("/predict")
def predict(mesures: Mesures):
    X = pd.DataFrame([mesures.features], columns=model.feature_names_in_)
return {"prediction": int(model.predict(X)[0])}import importlib
from fastapi.testclient import TestClient
importlib.invalidate_caches()
import app_fastapi
client = TestClient(app_fastapi.app)
valide = client.post("/predict", json={"features": [5.1, 3.5, 1.4, 0.2]})
print(valide.status_code, valide.json())
invalide = client.post("/predict", json={"features": [5.1, 3.5]})
print(invalide.status_code, invalide.json()["detail"][0]["msg"])
print("Documentation automatique (/docs) :", client.get("/docs").status_code)200 {'prediction': 0}
422 List should have at least 4 items after validation, not 2
Documentation automatique (/docs) : 200Pour la lancer en production : uvicorn app_fastapi:app --host 0.0.0.0 --port 8000. Pour choisir entre les deux, lis la réponse dans la FAQ plus bas.
Étape 5 : Comment conteneuriser l’API avec Docker ?
Les conteneurs sont un moyen populaire de déployer un modèle, car ils garantissent le même environnement partout (ton ordinateur, un serveur de test, la production). Les étapes :
- Installer Docker : assure-toi qu’il est installé sur ta machine.
- Figer les dépendances : un fichier
requirements.txtavec les versions exactes (voir plus bas). - Écrire un Dockerfile : il décrit l’environnement dans lequel ton API s’exécutera.
Voici le Dockerfile. Par rapport à la première version : une image Python récente (3.9 n’est plus maintenue), une installation des dépendances avant la copie du code (Docker réutilise alors son cache à chaque modification de app.py), et gunicorn à la place de python app.py.
# Image Python officielle, version légère
FROM python:3.13-slim

WORKDIR /app

# On copie d'abord requirements.txt : Docker réutilise le cache tant que les dépendances ne changent pas
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Puis le code et le modèle
COPY app.py logistic_regression_model.pkl ./

# Le port 5000 est celui de l'API
EXPOSE 5000

# gunicorn plutôt que le serveur de développement de Flask
CMD ["gunicorn", "-w", "2", "-b", "0.0.0.0:5000", "app:app"]Il lui faut un requirements.txt avec les versions exactes de l’entraînement (c’est ce qui évite le piège 1). Je génère les fichiers à partir des versions installées :
dependances = ["flask", "gunicorn", "joblib", "pandas", "scikit-learn"]
from importlib.metadata import version
Path("requirements.txt").write_text("\n".join(f"{nom}=={version(nom)}" for nom in dependances) + "\n")
Path(".dockerignore").write_text("__pycache__/\n*.log\ndata.csv\n")

print(sorted(p.name for p in Path(".").iterdir() if p.name in ("Dockerfile", "requirements.txt", ".dockerignore", "app.py")))
print(Path("requirements.txt").read_text())['.dockerignore', 'Dockerfile', 'app.py', 'requirements.txt']
flask==3.1.3
gunicorn==26.2.0
joblib==1.6.0
pandas==3.0.5
scikit-learn==1.9.1Non exécuté : mon environnement n’a pas de démon Docker. Les deux commandes ci-dessous sont celles de l’article d’origine, à lancer dans ton terminal, dans le dossier qui contient le Dockerfile, app.py et le modèle. Construire l’image :
docker build -t ml-model-api .Puis exécuter le conteneur, en reliant son port 5000 à celui de ta machine :
docker run -p 5000:5000 ml-model-apiL’API tourne maintenant dans un conteneur, et la même requête curl que plus haut doit répondre pareil. Elle est accessible depuis n’importe quel environnement qui sait exécuter Docker.
Étape 6 : Comment déployer le modèle dans le cloud ?
Une fois conteneurisée, l’API peut être déployée dans le cloud. Chaque fournisseur propose plusieurs options. Les noms des services évoluent vite : vérifie dans leur documentation avant de te lancer.
- AWS : AWS Elastic Beanstalk (avec une plateforme Docker), AWS Lambda (avec une image conteneur) ou Amazon SageMaker (service dédié au Machine Learning).
- Google Cloud : Cloud Run (pour déployer un conteneur sans gérer de serveur). L’ancien service « AI Platform » a été remplacé par Vertex AI, intégré depuis 2026 à la plateforme « Gemini Enterprise Agent Platform » de Google.
- Microsoft Azure : Azure Machine Learning, Azure Container Apps ou App Service.
Non exécuté (je n’ai pas de compte cloud branché à cet environnement) : voici deux exemples de déploiement du conteneur. Avec AWS Elastic Beanstalk, installe d’abord son outil en ligne de commande, puis initialise l’application et crée l’environnement :
pip install awsebcli
eb init -p docker ml-api
eb create ml-api-envUne fois l’application déployée, AWS fournit l’URL où ton API est hébergée. Avec Google Cloud Run, une seule commande construit l’image à partir du Dockerfile et la déploie (Cloud Run attend par défaut un conteneur sur le port 8080 : on précise donc le port 5000 de notre API) :
gcloud run deploy ml-model-api --source . --port 5000 --region europe-west1Dans les deux cas, pense à protéger l’API (authentification, limitation du débit) avant de l’ouvrir à Internet.
Étape 7 : Comment surveiller et mettre à jour le modèle ?
Le déploiement n’est pas la fin du voyage. Après la mise en production, surveille les performances du modèle, gère la charge et mets-le à jour quand de nouvelles données arrivent.
Monitoring : comment détecter la dérive des données ?
Surveille la latence et le taux d’erreurs de ton API, mais aussi la qualité des prédictions. Un modèle peut se dégrader en silence quand les données de production s’éloignent de celles de l’entraînement : c’est la dérive des données. Pour te le montrer, j’ai simulé un capteur qui se dérègle et mesure les pétales 40 % trop petits. Le test de Kolmogorov-Smirnov compare la distribution de chaque variable à celle de l’entraînement :
from scipy.stats import ks_2samp

# Scénario : un capteur se dérègle et mesure les pétales 40 % trop petits
prod_normale = X_test.copy()
prod_derivee = X_test.copy()
for colonne in ["petal length (cm)", "petal width (cm)"]:
    prod_derivee[colonne] = prod_derivee[colonne] * 0.6

print(f"Accuracy, données normales : {accuracy_score(y_test, model.predict(prod_normale)):.2f}")
print(f"Accuracy, capteur déréglé  : {accuracy_score(y_test, model.predict(prod_derivee)):.2f}")

# Test de Kolmogorov-Smirnov : la distribution a-t-elle changé par rapport à l'entraînement ?
print()
print(f"{'variable':<20}{'p normal':>10}{'p dérivé':>10}")
for colonne in X_train.columns:
    p_normal = ks_2samp(X_train[colonne], prod_normale[colonne]).pvalue
    p_derive = ks_2samp(X_train[colonne], prod_derivee[colonne]).pvalue
    alerte = "  ALERTE" if p_derive < 0.01 else ""
print(f"{colonne:<20}{p_normal:>10.3f}{p_derive:>10.4f}{alerte}")Accuracy, données normales : 1.00
Accuracy, capteur déréglé : 0.60
variable p normal p dérivé
sepal length (cm) 0.880 0.8799
sepal width (cm) 1.000 0.9998
petal length (cm) 0.880 0.0000 ALERTE
petal width (cm) 0.760 0.0000 ALERTEL’accuracy tombe de 1,00 à 0,60, et le test signale les deux variables touchées (p-value proche de 0) sans signaler les deux autres. Dans la vraie vie, tu n’as pas toujours les bonnes réponses immédiatement : surveiller les entrées (comme ici) est souvent le premier signal d’alerte. Des outils comme Evidently ou Prometheus et Grafana automatisent ce suivi.
Versioning : comment suivre les versions du modèle ?
Garde la trace de chaque version : le fichier, la version de scikit-learn, la performance et une empreinte du fichier pour vérifier qu’il n’a pas été modifié. Voici une fiche minimale enregistrée à côté du modèle :
import hashlib

Path("modeles").mkdir(exist_ok=True)
fichier = Path("modeles/iris-v1.joblib")
joblib.dump(model, fichier)

fiche = {
    "version": "v1",
    "sklearn": sklearn.__version__,
    "accuracy_test": float(accuracy_score(y_test, y_pred)),
    "empreinte_sha256": hashlib.sha256(fichier.read_bytes()).hexdigest()[:16],
}
Path("modeles/iris-v1.json").write_text(json.dumps(fiche, indent=2))
print(Path("modeles/iris-v1.json").read_text()){
"version": "v1",
"sklearn": "1.9.1",
"accuracy_test": 1.0,
"empreinte_sha256": "35a309ef2e979295"
}Pour aller plus loin, des outils comme MLflow et DVC (Data Version Control) suivent les versions de tes modèles et de tes données, et facilitent le retour à une version précédente si une mise à jour se passe mal (non testés ici).
Mise à l’échelle (scaling)
Si l’API doit gérer beaucoup de requêtes, la mise à l’échelle automatique de ton fournisseur cloud, ou Kubernetes, ajoute ou retire des conteneurs selon la charge. Comme ton API ne garde aucun état en mémoire, il suffit d’en lancer plusieurs copies.
Questions fréquentes
Joblib ou pickle pour sauvegarder un modèle scikit-learn ?
Pour scikit-learn, joblib est recommandé : il gère efficacement les gros tableaux NumPy. Dans les deux cas, le fichier dépend de la version de la bibliothèque et peut exécuter du code au chargement : fige les versions et ne charge que des fichiers de confiance.
Flask ou FastAPI pour servir un modèle ?
Flask est très simple et suffit pour un petit service. FastAPI valide les données automatiquement, génère la documentation (/docs) et gère mieux le code asynchrone. Pour un nouveau projet, FastAPI est un bon choix par défaut, mais les deux font très bien le travail.
Pourquoi ne pas utiliser debug=True en production ?
Le mode debug de Flask active un débogueur interactif qui permet d’exécuter du code sur le serveur à toute personne qui y accède. Il est réservé au développement. En production, utilise un serveur comme gunicorn.
Faut-il toujours utiliser Docker pour déployer un modèle ?
Non. Pour un petit service ou un test, un serveur avec un environnement virtuel peut suffire. Docker devient très utile dès que tu veux le même environnement partout, déployer dans le cloud ou monter en charge.
Comment savoir si mon modèle déployé se dégrade ?
Surveille les données qu’il reçoit (comparaison avec les données d’entraînement, test de Kolmogorov-Smirnov par exemple) et, dès que tu as les bonnes réponses, compare-les à ses prédictions. Une chute de performance ou un changement de distribution est le signal pour réentraîner le modèle.
Comment mettre à jour un modèle sans interrompre l’API ?
Construis une nouvelle image avec le nouveau modèle, démarre-la à côté de l’ancienne, puis bascule le trafic progressivement. La plupart des services cloud et Kubernetes le font pour toi (déploiement progressif) ; garde l’ancienne version pour pouvoir revenir en arrière.
Conclusion : par où commencer ?
Déployer un modèle, ce n’est pas seulement écrire du code : c’est s’assurer qu’il est robuste, évolutif et accessible. En sauvegardant le modèle, en le servant via une API, en le conteneurisant avec Docker et en le déployant dans le cloud, tu passes de l’expérimentation à une solution prête pour la production, à condition de surveiller le modèle et de figer les versions.
Pour ton premier déploiement, commence par l’étape 4 sur ton ordinateur : une API Flask ou FastAPI et un appel curl. Ajoute Docker ensuite. Pour bien structurer ton projet avant de le déployer, lis Comment structurer un projet Python.
Pour progresser en Python et en Machine Learning, le mieux est de pratiquer. Sur DataXp, tu apprends Python et la data science avec des exercices pratiques à faire directement en ligne.
Pour aller plus loin, voici d’autres articles qui pourraient te plaire :