Comment construire un chatbot en Python, c’est-à-dire un assistant qui comprend tes questions et y répond ? L’Intelligence Artificielle s’intègre très vite dans le quotidien des entreprises. Grâce aux progrès du traitement du langage naturel (NLP, pour Natural Language Processing), de la compréhension du langage naturel (NLU) et du Machine Learning, on sait aujourd’hui développer des technologies qui imitent les interactions humaines, comme la reconnaissance de la parole et du texte.
Dans cet article, nous construisons pas à pas un chatbot avec le NLP et un réseau de neurones de Deep Learning, en Python. Tout le code est testé, avec les vraies sorties.
Article mis à jour en octobre 2026 : code adapté à Keras 3 (keras.Input et plus d’argument decay dans l’optimiseur) et aux versions actuelles de NLTK (ressource punkt_tab). J’ai aussi corrigé trois défauts du code d’origine : le sac de mots était calculé autrement à l’entraînement et à l’utilisation, le texte n’était pas mis en minuscules, et le chatbot plantait quand aucune intention n’était reconnue.
En bref : un chatbot par intentions fonctionne en quatre étapes. 1) On écrit un fichier d’intentions : des tags, des exemples de phrases (patterns) et des réponses. 2) On transforme chaque phrase en vecteur de 0 et de 1 avec un « sac de mots » (après découpage en mots et lemmatisation avec NLTK). 3) On entraîne un réseau de neurones Keras à prédire le tag à partir de ce vecteur. 4) Pour répondre, on prédit le tag de la phrase de l’utilisateur et on tire au hasard une réponse de ce tag.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys, nltk, numpy as np
import keras

print("Python", sys.version.split()[0])
print("Keras ", keras.__version__, "- backend :", keras.backend.backend())
print("NLTK  ", nltk.__version__)
print("NumPy ", np.__version__)Python 3.13.16
Keras 3.15.1 - backend : tensorflow
NLTK 3.10.4
NumPy 2.5.3De quelles données un chatbot a-t-il besoin ?
Avant de coder, il faut un fichier JSON d’intentions (intents) : ce que l’utilisateur peut vouloir dire pendant la discussion. Pour cela, on crée d’abord des étiquettes (des tags) dans lesquelles les questions peuvent s’inscrire. Par exemple, un utilisateur peut vouloir connaître le prénom du chatbot : on crée une intention avec le tag name. Il peut vouloir connaître son âge : tag age. Et ainsi de suite.
Tags et patterns
Pour chaque tag, on donne des patterns (des modèles de phrases) : les différentes façons de poser la question. Sous le tag name, on peut demander le prénom de plusieurs manières : « Quel est ton prénom ? », « Qui es-tu ? », « Comment t’appelles-tu ? ».
Le chatbot utilise ces patterns comme données d’apprentissage. Le but est qu’il s’adapte aux façons de poser la question : l’utilisateur n’a pas besoin d’écrire exactement une phrase apprise. Remarque : notre robot ne sera pas très intelligent et ne reconnaîtra pas toujours ce qu’on lui dit. Mais avec suffisamment d’exemples, il fera un travail de décryptage intéressant. Notre objectif est surtout de mettre en place des techniques de NLP et de Deep Learning.
Réponses associées aux patterns
Dans le fichier d’intentions, à côté de chaque tag et de ses patterns, on enregistre des réponses. Notre chatbot est simple : ses réponses ne sont pas générées mais choisies au hasard parmi des réponses statiques, sans tenir compte du contexte. Voici notre fichier d’intentions, sous forme de dictionnaire Python. J’ai retiré le pattern « Salut » du tag goodbye : il figurait déjà dans greeting, et un même pattern dans deux tags rend l’entraînement ambigu.
# utilisation d'un dictionnaire pour représenter un fichier JSON d'intentions
data = {"intents": [
    {"tag": "greeting",
     "patterns": ["Hello", "La forme?", "yo", "Salut", "ça roule?"],
     "responses": ["Salut à toi!", "Hello", "Comment vas-tu?", "Salutations!", "Enchanté"]},
    {"tag": "age",
     "patterns": ["Quel âge as-tu?", "C'est quand ton anniversaire?", "Quand es-tu né?"],
     "responses": ["J'ai 25 ans", "Je suis né en 1996", "Ma date d'anniversaire est le 3 juillet et je suis né en 1996", "03/07/1996"]},
    {"tag": "date",
     "patterns": ["Que fais-tu ce week-end?", "Tu veux qu'on fasse un truc ensemble?", "Quels sont tes plans pour cette semaine"],
     "responses": ["Je suis libre toute la semaine", "Je n'ai rien de prévu", "Je ne suis pas occupé"]},
    {"tag": "name",
     "patterns": ["Quel est ton prénom?", "Comment tu t'appelles?", "Qui es-tu?"],
     "responses": ["Mon prénom est Miki", "Je suis Miki", "Miki"]},
    {"tag": "goodbye",
     "patterns": ["bye", "Au revoir", "see ya", "adios", "cya"],
     "responses": ["C'était sympa de te parler", "À plus tard", "On se reparle très vite!"]},
]}Comment coder un chatbot en Python ?
Quels modules et bibliothèques utiliser ?
Nous avons besoin de modules intégrés à Python (json, string, random), de NLTK pour le NLP, de Keras pour le réseau de neurones (installé avec pip install tensorflow) et de NumPy pour les tableaux. NLTK a besoin de deux ressources : le découpage en mots (punkt_tab) et le dictionnaire de lemmes (wordnet). Avec les versions récentes de NLTK, c’est punkt_tab qu’il faut télécharger, et non plus punkt.
import json
import string
import random

import nltk
import numpy as np
from nltk.stem import WordNetLemmatizer

import keras
from keras import layers

nltk.download("punkt_tab")
nltk.download("wordnet")Pour avoir les mêmes résultats à chaque exécution, on fixe les graines aléatoires :
keras.utils.set_random_seed(42)   # reproductibilité : mêmes poids initiaux à chaque exécution
random.seed(42) # mêmes réponses tirées au hasardComment séparer et nettoyer les données ?
Pour créer les données d’entraînement, on commence par quelques opérations :
- créer le vocabulaire de tous les mots utilisés dans les patterns (les questions posées par l’utilisateur) ;
- créer la liste des classes, c’est-à-dire les tags de chaque intention ;
- créer la liste de tous les patterns du fichier d’intentions ;
- créer la liste des tags associés à chaque pattern.
Tout d’abord, une fonction clean_text() qui nettoie un texte : elle le découpe en mots (tokens), les met en minuscules, retire la ponctuation et ramène chaque mot à sa forme de base avec un lemmatiseur. On utilisera cette même fonction à l’entraînement et pendant la discussion, c’est essentiel pour que les deux étapes voient les mots de la même façon.
# lemmatizer : ramène chaque mot à sa forme de base
lemmatizer = WordNetLemmatizer()

def clean_text(text):
    """Découpe le texte en mots, en minuscules, sans ponctuation, lemmatisés."""
    tokens = nltk.word_tokenize(text)
    return [lemmatizer.lemmatize(word.lower()) for word in tokens if word not in string.punctuation]

clean_text("Quels sont tes plans pour cette semaine?")['quels', 'sont', 'te', 'plan', 'pour', 'cette', 'semaine']Attention : le lemmatiseur WordNet de NLTK est conçu pour l’anglais. Sur du français, il ne change presque rien aux mots (il a transformé « tes » en « te », par exemple). Pour un vrai chatbot en français, utilise plutôt spaCy ou un « stemmer » français comme celui de NLTK (SnowballStemmer('french')). Pour notre démonstration, cela suffit.
On construit maintenant les listes :
classes = sorted({intent["tag"] for intent in data["intents"]})   # les tags, sans doublon

doc_X = []   # les patterns
doc_y = []   # le tag associé à chaque pattern
for intent in data["intents"]:
    for pattern in intent["patterns"]:
        doc_X.append(pattern)
        doc_y.append(intent["tag"])

# vocabulaire : tous les mots des patterns, sans doublon, triés
words = sorted({word for pattern in doc_X for word in clean_text(pattern)})Voici à quoi ressemble chaque liste. Le vocabulaire contient 46 mots :
print(len(words), "mots :", words)46 mots : ['adios', 'anniversaire', 'as-tu', 'au', 'bye', "c'est", 'ce', 'cette', 'comment', 'cya', 'ensemble', 'es-tu', 'est', 'fais-tu', 'fasse', 'forme', 'hello', 'la', 'né', 'plan', 'pour', 'prénom', "qu'on", 'quand', 'que', 'quel', 'quels', 'qui', 'revoir', 'roule', 'salut', 'see', 'semaine', 'sont', "t'appelles", 'te', 'ton', 'truc', 'tu', 'un', 'veux', 'week-end', 'ya', 'yo', 'âge', 'ça']print(classes)['age', 'date', 'goodbye', 'greeting', 'name']print(doc_X)['Hello', 'La forme?', 'yo', 'Salut', 'ça roule?', 'Quel âge as-tu?', "C'est quand ton anniversaire?", 'Quand es-tu né?', 'Que fais-tu ce week-end?', "Tu veux qu'on fasse un truc ensemble?", 'Quels sont tes plans pour cette semaine', 'Quel est ton prénom?', "Comment tu t'appelles?", 'Qui es-tu?', 'bye', 'Au revoir', 'see ya', 'adios', 'cya']print(doc_y)['greeting', 'greeting', 'greeting', 'greeting', 'greeting', 'age', 'age', 'age', 'date', 'date', 'date', 'name', 'name', 'name', 'goodbye', 'goodbye', 'goodbye', 'goodbye', 'goodbye']Comment transformer des phrases en nombres avec un sac de mots ?
Les réseaux de neurones attendent des valeurs numériques, pas des mots. Pour convertir chaque phrase, on utilise la technique du sac de mots (bag of words) : un vecteur qui a autant de cases que de mots dans le vocabulaire, avec un 1 si le mot est présent dans la phrase et un 0 sinon. L’ordre des mots est perdu, d’où le nom de « sac ». Voici le vecteur de « Quel est ton prénom ? » : il contient quatre 1, pour « est », « prénom », « quel » et « ton ».
def bag_of_words(text, vocab):
    """Vecteur de 0 et de 1 : 1 si le mot du vocabulaire apparaît dans le texte."""
    tokens = clean_text(text)
    return np.array([1 if word in tokens else 0 for word in vocab])

print(bag_of_words("Quel est ton prénom?", words))[0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 1 0 0 0 1 0 0 0 0 0 0 0 0 0 0 1
0 0 0 0 0 0 0 0 0]On l’applique à tous les patterns, pour obtenir les entrées du réseau (train_X). Les sorties (train_y) sont les tags sous forme one-hot : un 1 à la position du tag, des 0 ailleurs. Pas besoin de mélanger les données à la main : fit() le fait à chaque époque.
train_X = np.array([bag_of_words(doc, words) for doc in doc_X])
train_y = np.array([[1 if tag == c else 0 for c in classes] for tag in doc_y])   # one-hot encoding

print(train_X.shape, train_y.shape)(19, 46) (19, 5)Nous avons 19 phrases d’entraînement, décrites par 46 mots, réparties en 5 classes.
Comment construire le réseau de neurones avec Keras ?
Les données sont numériques : on peut construire le réseau, qui examine les variables et prédit le tag associé. Notre modèle est un réseau de neurones séquentiel : une entrée de 46 valeurs, deux couches cachées de 128 et 64 neurones (activation relu) et une couche de sortie de 5 neurones avec softmax, qui donne la probabilité de chaque tag. Avec Keras 3, on déclare la taille de l’entrée avec keras.Input, et l’optimiseur Adam n’a plus d’argument decay.
input_shape = (len(words),)
output_shape = len(classes)

model = keras.Sequential([
    keras.Input(shape=input_shape),
    layers.Dense(128, activation="relu"),
    layers.Dropout(0.5),
    layers.Dense(64, activation="relu"),
    layers.Dropout(0.3),
    layers.Dense(output_shape, activation="softmax"),
])

adam = keras.optimizers.Adam(learning_rate=0.01)
model.compile(loss="categorical_crossentropy", optimizer=adam, metrics=["accuracy"])

model.summary()Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type) ┃ Output Shape ┃ Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ dense (Dense) │ (None, 128) │ 6,016 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout (Dropout) │ (None, 128) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense) │ (None, 64) │ 8,256 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout_1 (Dropout) │ (None, 64) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_2 (Dense) │ (None, 5) │ 325 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
Total params: 14,597 (57.02 KB)
Trainable params: 14,597 (57.02 KB)
Non-trainable params: 0 (0.00 B)Nous avons utilisé des couches d’exclusion (Dropout), très efficaces contre le surapprentissage : elles éteignent au hasard une partie des neurones à chaque étape d’entraînement. Pour mieux comprendre ce qui se passe dans un réseau, lis Comment fonctionne le Deep Learning.
Comment entraîner le modèle ?
On entraîne le modèle pendant 200 époques. Je désactive l’affichage de chaque époque avec verbose=0 et je garde l’historique pour tracer les courbes.
history = model.fit(x=train_X, y=train_y, epochs=200, verbose=0)

print("Perte finale :", round(history.history["loss"][-1], 4))
print("Précision finale :", round(history.history["accuracy"][-1], 4))Perte finale : 0.0007
Précision finale : 1.0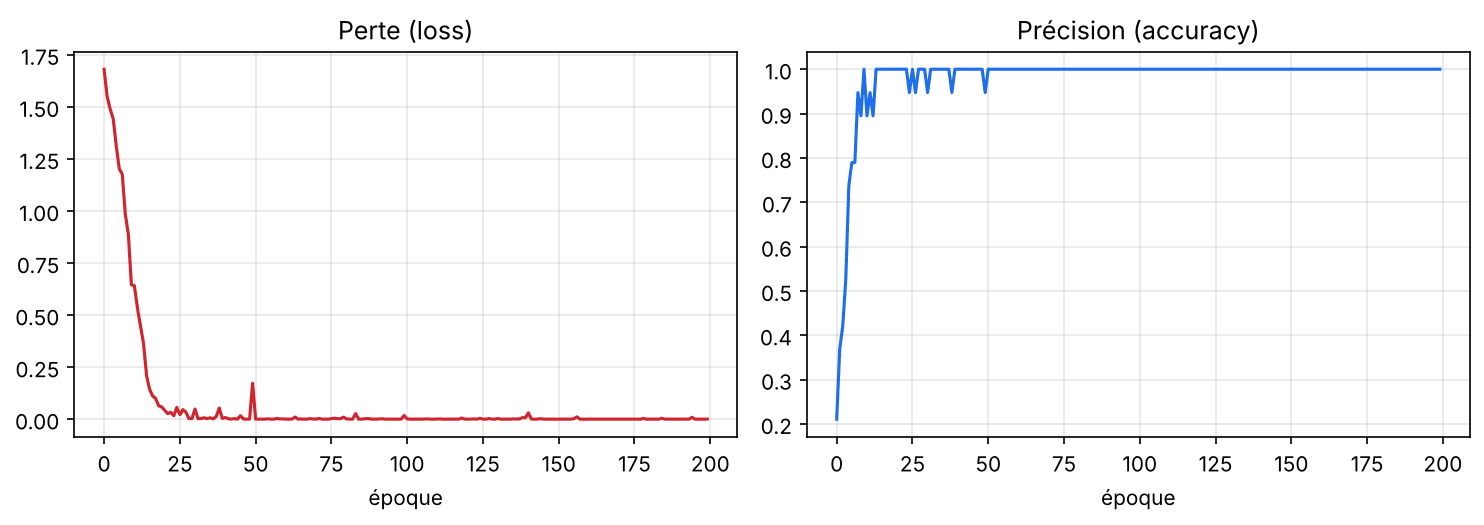
La précision atteint 100 % : le modèle reconnaît tous ses patterns d’entraînement. C’est normal sur 19 phrases, mais cela ne dit rien de sa capacité à comprendre des phrases nouvelles : c’est ce qu’on teste plus bas.
Comment créer les fonctions du chatbot ?
Le modèle est entraîné, mais il faut des fonctions pour l’utiliser dans une application. bag_of_words() existe déjà. pred_class() prédit les tags de la phrase de l’utilisateur : elle garde ceux dont la probabilité dépasse un seuil (0,2) et les classe du plus probable au moins probable. Si aucun mot de la phrase n’est dans le vocabulaire, elle ne devine pas et renvoie une liste vide. get_response() tire au hasard une réponse du tag le plus probable, ou s’excuse quand aucune intention n’est reconnue (le code d’origine plantait dans ce cas).
def pred_class(text, vocab, labels, seuil=0.2):
    bow = bag_of_words(text, vocab)
    if bow.sum() == 0:                        # aucun mot connu : on ne devine pas
        return []
    result = model.predict(np.array([bow]), verbose=0)[0]
    y_pred = [[idx, res] for idx, res in enumerate(result) if res > seuil]
    y_pred.sort(key=lambda x: x[1], reverse=True)
    return [labels[idx] for idx, res in y_pred]

def get_response(intents_list, intents_json):
    if not intents_list:                      # aucune intention reconnue
        return "Désolé, je n'ai pas compris."
    tag = intents_list[0]
    for intent in intents_json["intents"]:
        if intent["tag"] == tag:
return random.choice(intent["responses"])Voici les prédictions sur quelques phrases, dont deux formulations que le modèle n’a jamais vues :
for message in ["Quel est ton prénom?", "Comment t'appelles-tu?", "Quel âge as-tu?", "Que fais-tu ce week-end?"]:
print(message, "->", pred_class(message, words, classes))Quel est ton prénom? -> ['name']
Comment t'appelles-tu? -> ['name']
Quel âge as-tu? -> ['age']
Que fais-tu ce week-end? -> ['date']Comment lancer le chatbot ?
La dernière partie est simple : une boucle while qui permet à l’utilisateur de saisir une question. Le texte est nettoyé (découpé en mots et lemmatisé), converti en nombres avec le sac de mots, puis le modèle prédit le tag. On prend une réponse au hasard dans ce tag pour répondre. Exécute cette boucle dans un terminal ou dans Google Colab ; tape « stop » pour la quitter.
# lancement du chatbot (à exécuter dans un terminal ou dans Colab ; tape "stop" pour quitter)
while True:
    message = input("")
    if message.lower() == "stop":
        break
    intents = pred_class(message, words, classes)
print(get_response(intents, data))Pour tester le chatbot sans saisie au clavier, voici le même enchaînement sur une liste de messages. Les réponses tirées au hasard peuvent varier d’une exécution à l’autre :
random.seed(1)
for message in ["Salut", "Quel est ton prénom?", "Comment t'appelles-tu?", "Quel âge as-tu?", "Que fais-tu ce week-end?", "Bonjour", "bye"]:
    intents = pred_class(message, words, classes)
    print("Toi  :", message)
    print("Miki :", get_response(intents, data))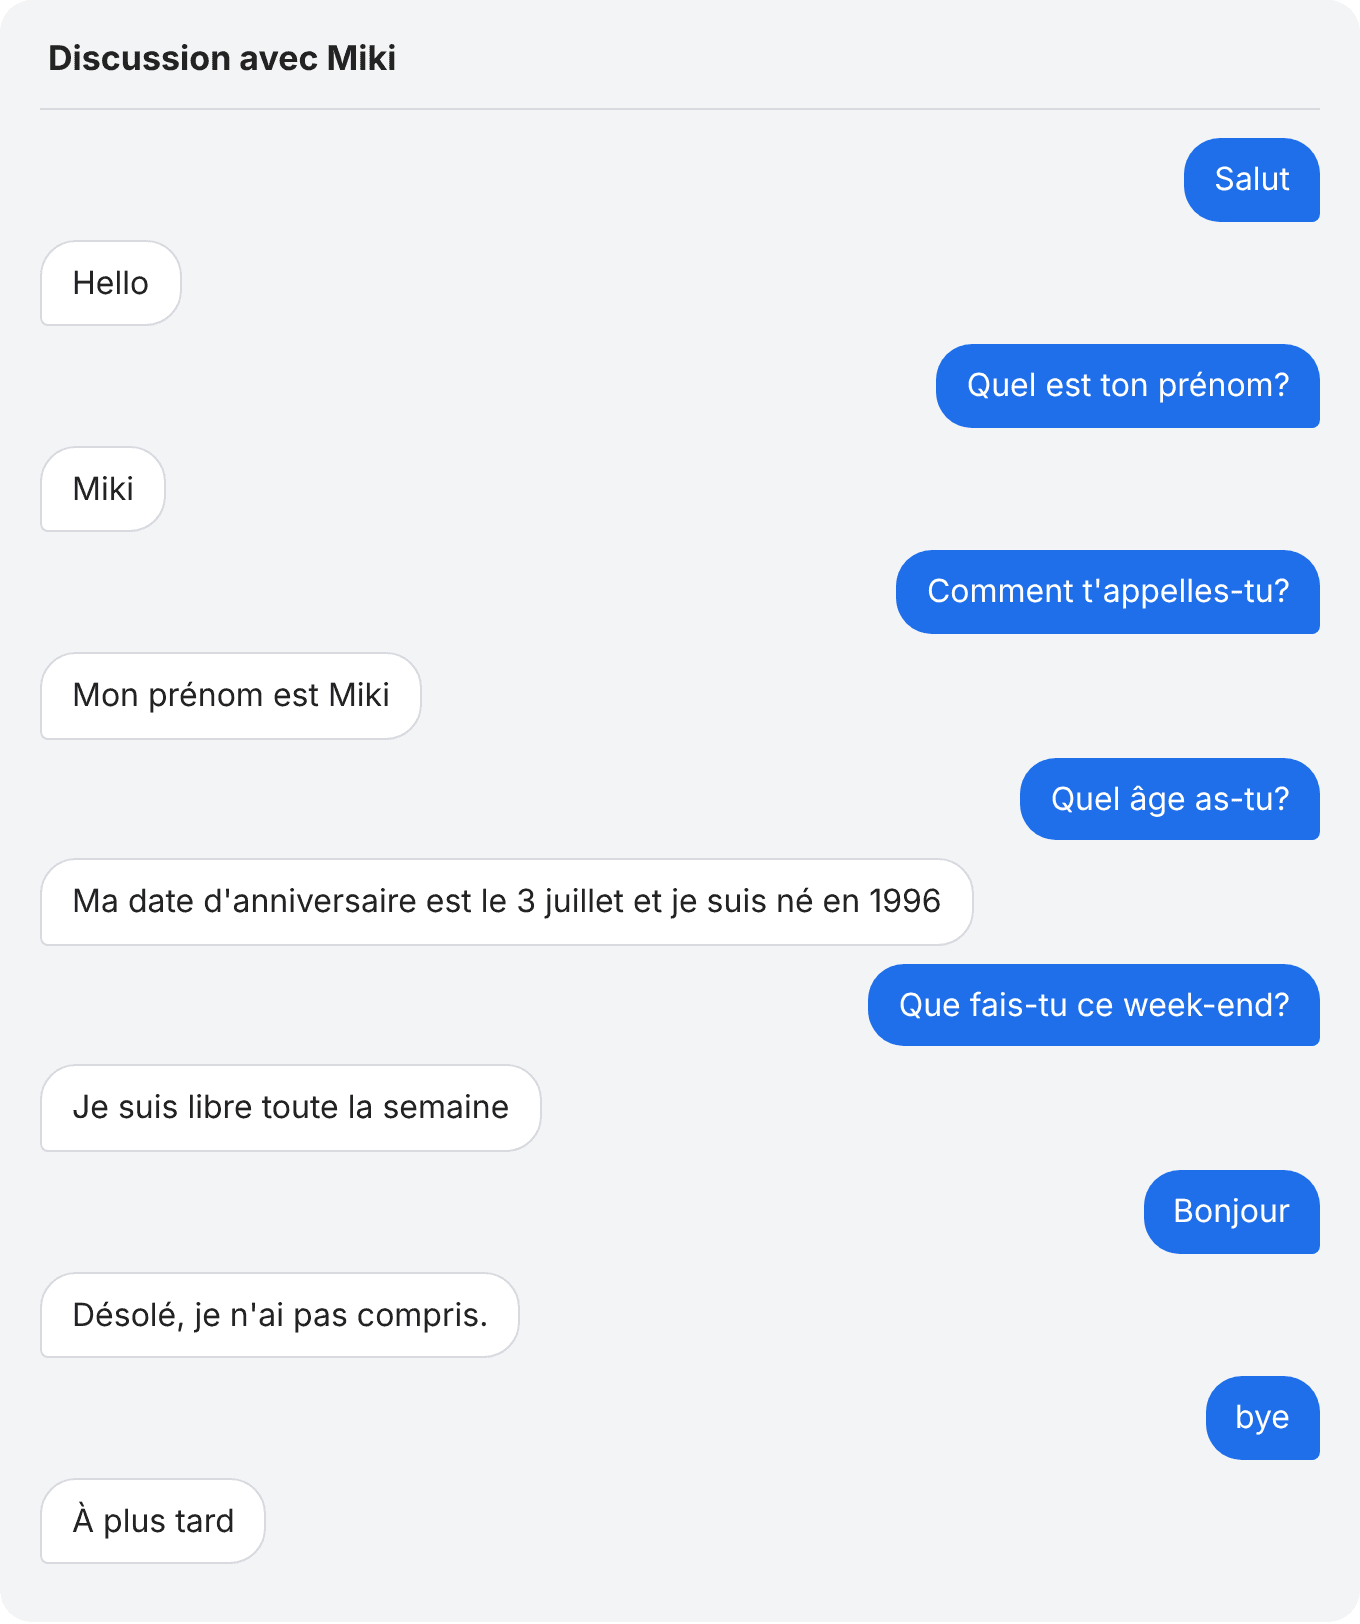
Toi  : Salut
Miki : Hello
Toi  : Quel est ton prénom?
Miki : Miki
Toi  : Comment t'appelles-tu?
Miki : Mon prénom est Miki
Toi  : Quel âge as-tu?
Miki : Ma date d'anniversaire est le 3 juillet et je suis né en 1996
Toi  : Que fais-tu ce week-end?
Miki : Je suis libre toute la semaine
Toi  : Bonjour
Miki : Désolé, je n'ai pas compris.
Toi  : bye
Miki : À plus tardVoilà notre nouvel ami Miki ! Remarque : « Bonjour » n’est pas dans notre vocabulaire, donc Miki s’excuse au lieu de deviner. Ajouter « Bonjour » aux patterns du tag greeting puis réentraîner le modèle règle le problème : c’est le principe d’un chatbot par intentions, plus il a d’exemples, mieux il comprend.
Quelles sont les limites de ce chatbot ?
Un chatbot par sac de mots ne comprend pas le sens des phrases : il reconnaît des mots. Preuve avec une question hors sujet dont deux mots (« la », « est ») figurent dans le vocabulaire :
random.seed(2)
message = "Quelle est la capitale de la France?"
print(pred_class(message, words, classes))
print(get_response(pred_class(message, words, classes), data))['greeting']
Salut à toi!Miki la prend pour une salutation, car « la » apparaît dans « La forme ? ». Plusieurs limites en découlent : le sac de mots ignore l’ordre des mots et le contexte, le fichier d’intentions doit être écrit à la main, et les réponses sont figées. Pour aller plus loin, on utilise des représentations de mots plus riches (plongements de mots) ou des modèles de langage, qui comprennent le sens des phrases et génèrent leurs réponses.
Questions fréquentes
Comment créer un chatbot en Python ?
Avec le NLP et un réseau de neurones : 1) écris un fichier d’intentions (tags, patterns, réponses) ; 2) nettoie les phrases avec NLTK (découpage en mots, minuscules, lemmatisation) et transforme-les en vecteurs avec un sac de mots ; 3) entraîne un réseau de neurones Keras à prédire le tag ; 4) pour répondre, prédis le tag de la phrase de l’utilisateur et renvoie une réponse choisie au hasard dans ce tag.
Qu’est-ce qu’un sac de mots (bag of words) ?
C’est une représentation d’un texte sous forme de vecteur : une case par mot du vocabulaire, avec 1 si le mot est présent dans le texte et 0 sinon. Elle permet de donner du texte à un réseau de neurones, mais elle ignore l’ordre des mots et leur sens.
À quoi sert la lemmatisation en NLP ?
La lemmatisation ramène chaque mot à sa forme de base (par exemple « plans » à « plan »), pour que les différentes formes d’un même mot soient comptées ensemble. Le lemmatiseur WordNet de NLTK est conçu pour l’anglais : pour le français, utilise spaCy ou un stemmer français.
Pourquoi utiliser un réseau de neurones pour un chatbot ?
Le réseau apprend à associer des phrases à des intentions à partir d’exemples, au lieu de reposer sur des règles écrites à la main. Il généralise à des formulations proches de celles apprises. Pour un petit chatbot par intentions, un réseau simple avec quelques couches Dense suffit.
Pourquoi mon chatbot ne comprend-il pas certaines phrases ?
Un chatbot par sac de mots ne reconnaît que les mots de son vocabulaire et ne comprend pas le sens. Ajoute des patterns variés à chaque intention (plus il y a d’exemples, mieux il généralise), puis réentraîne le modèle. Pour des phrases hors vocabulaire, prévois une réponse de secours.
Quelle différence entre ce chatbot et ChatGPT ?
Notre chatbot choisit une réponse prédéfinie parmi quelques intentions apprises : il ne génère aucun texte. Les assistants comme ChatGPT sont des modèles de langage de grande taille qui génèrent leurs réponses mot par mot et comprennent le contexte de la conversation, mais exigent des ressources sans commune mesure.
Conclusion
Tu as construit un chatbot complet en Python : un fichier d’intentions, un nettoyage du texte avec NLTK, un sac de mots, un réseau de neurones Keras et une boucle de discussion. Pour progresser, ajoute des intentions et des patterns, change la taille des couches ou le seuil de confiance, et observe l’effet sur les réponses de Miki.
Construire un modèle de bout en bout est la meilleure façon de comprendre le Deep Learning. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin :
Salut !!!
Vraiment merci beaucoup pour ce tutoriel instructif. J’aimerais savoir si c’est possible de l’intégrer dans un site WordPress.
Merci d’avance.
Bien sûr, tu peux tout intégrer sur un site wordpress ! (après je suis pas spécialiste intégration de code sur l’environnement wordpress, mais ça s’apprend aisément si tu as ce besoin là)
Salut !!!
Merci pour ce tutoriel. J’aimerais savoir comment je peux procéder pour permettre à mon chatbot de prédire exactement la bonne réponse. Comment je peux m’y prendre lui permettant de d’analyser la phrase comprendre le sens et prédire la réponse exacte ?
Tu peux lui donner beaucoup beaucoup de données d’apprentissage, regarder du côté des LLMs
bonjour j’aimerai l’intégrer dans une application django. Comment faire ?
Apprendre Django 🙂
j’ai suivi cet exemple pour en implementer mais il choisit les réponses qux hasard qu lieu de prendre la réponse exacte
Il n’y a pas de réponse exacte, le bot répond en fonction de l’intention (qu’il perçoit) du message qu’il reçoit
Et si l’utilisateur envoyait un message appartenant à deux tags différents ?
C’est pas possible avec ce chatbot. Il doit bien comprendre l’intention du message 🙂
Ca veut dire quoi tokenisé
Tokenizer ici consiste à remplacer le texte en tokens en fonction de l’intention (intents)