Une bonne partie du travail d’un data scientist consiste à transformer des données : changer des valeurs, filtrer des lignes, regrouper, combiner plusieurs listes. Python offre pour cela des outils simples, déjà intégrés au langage ou à pandas, que l’on utilise tous les jours. Dans cet article, je te présente 5 astuces de traitement de données avec Python, chacune avec un exemple de code testé que tu peux exécuter toi-même.
Article mis à jour en octobre 2026 : code testé avec Python 3.13 et pandas 3, exemple de zip() corrigé (il modifiait la liste d’origine), ajout du filtre sur plusieurs conditions, de zip(strict=True), de numeric_only pour groupby() et d’une mesure de vitesse pour les compréhensions de liste.
En bref : cinq outils suffisent pour traiter des données simplement. map() applique une fonction à chaque élément d’une liste. Un masque pandas filtre les lignes d’un DataFrame avec une condition. groupby() résume les données par catégorie. zip() parcourt plusieurs listes en parallèle. La compréhension de liste construit une nouvelle liste en une seule ligne.
Tu peux exécuter tous les exemples de cet article dans ce notebook Google Colab.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys, numpy, pandas

print("Python", sys.version.split()[0])
print("pandas", pandas.__version__)
print("NumPy ", numpy.__version__)Python 3.13.16
pandas 3.0.5
NumPy 2.5.3Comment appliquer une fonction à toute une liste avec map() ?
La fonction map() applique une fonction à chaque élément d’un itérable (une liste, par exemple). Elle prend deux arguments dans cet ordre : la fonction, puis l’itérable. Elle est très utile quand beaucoup de données sont en jeu, et reste simple à utiliser. Attention : la fonction passée à map() ne doit avoir qu’un seul argument.
Prenons cette liste :
data = [5, 10, 15, 20]Notre objectif est d’ajouter 5 à chaque valeur. Écrivons d’abord une fonction pour cela :
def add5(x):
return x + 5Si on essaie de passer directement la liste à cette fonction, Python refuse : on ne peut pas additionner un entier et une liste.
try:
    add5(data)
except TypeError as e:
print(type(e).__name__, ":", e)TypeError : can only concatenate list (not "int") to listC’est là qu’intervient map(), qui applique la fonction élément par élément :
newdata = map(add5, data)
print(type(newdata))<class 'map'>Le résultat n’est pas une liste mais un objet map, un itérateur « paresseux » : les valeurs ne sont calculées que quand on les demande. Pour obtenir les résultats, on le transforme en liste avec list() :
list(newdata)[10, 15, 20, 25]On peut aussi écrire tout cela en une ligne, sans définir de fonction, avec une expression lambda (une petite fonction anonyme) :
newdata = list(map(lambda x: x + 5, data))
print(newdata)[10, 15, 20, 25]Pour des données numériques, il existe plus simple et plus rapide : la vectorisation de NumPy applique l’opération à tout le tableau, sans map() ni boucle (voir mon article sur la vectorisation en Python).
import numpy as np

print(np.array(data) + 5)[10 15 20 25]Comment filtrer un DataFrame pandas avec un masque ?
Avec pandas, on peut filtrer un DataFrame en lui passant une condition : c’est un masque booléen, une série de True et de False (un par ligne) qui indique quelles lignes garder. C’est un excellent moyen d’extraire un échantillon de données en une ligne de code.
Considérons ce DataFrame :
import pandas as pd

df = pd.DataFrame({"A": [5, 10, 15, 20],
                   "B": ["grand", "petit", "grand", "petit"]})
df A B
0 5 grand
1 10 petit
2 15 grand
3 20 petitUne condition sur une colonne renvoie le masque :
df["A"] > 100 False
1 False
2 True
3 True
Name: A, dtype: boolEn passant ce masque entre crochets, on ne garde que les lignes où il vaut True :
a_filter = df[df["A"] > 10]
a_filter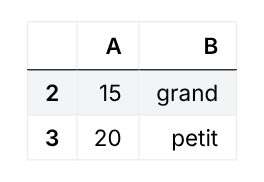
Pour combiner plusieurs conditions, utilise & (et), | (ou) et ~ (non), en entourant chaque condition de parenthèses. Les mots and et or ne fonctionnent pas sur des séries.
df[(df["A"] > 5) & (df["B"] == "grand")] A B
2 15 grandPour d’autres façons de filtrer, lis mon article sur les 8 façons de filtrer un DataFrame pandas.
Comment regrouper des données avec groupby() ?
En plus des masques, pandas propose de nombreuses méthodes sur les DataFrames. L’une des plus utiles est groupby() : elle regroupe les lignes selon les valeurs d’une colonne, puis calcule un résumé (une moyenne, un maximum, un total…) pour chaque groupe.
Considérons ce DataFrame :
df = pd.DataFrame({'Animal': ['Faucon', 'Faucon', 'Perroquet', 'Perroquet'],
                   'Vitesse Max': [380., 370., 24., 26.]})
df Animal Vitesse Max
0 Faucon 380.0
1 Faucon 370.0
2 Perroquet 24.0
3 Perroquet 26.0Condensons les faucons et les perroquets en une seule ligne chacun, en calculant la moyenne :
df.groupby(['Animal']).mean()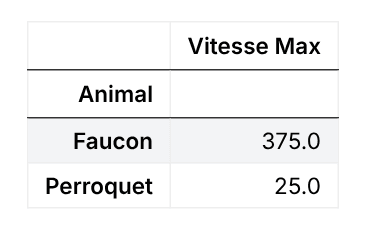
On voit tout de suite qu’un faucon vole bien plus vite qu’un perroquet. Sans groupby(), il aurait fallu séparer les lignes dans des listes ou des DataFrames distincts, puis calculer chaque moyenne à la main.
Pour calculer plusieurs résumés à la fois, utilise agg() :
df.groupby('Animal')['Vitesse Max'].agg(['mean', 'max']) mean max
Animal
Faucon 375.0 380.0
Perroquet 25.0 26.0Un point d’attention : si le DataFrame contient des colonnes de texte, mean() échoue (avec pandas 3, le texte a le type str). Sélectionne la colonne voulue, comme ci-dessus, ou ajoute numeric_only=True :
df2 = df.assign(Couleur=["brun", "brun", "vert", "vert"])
try:
    df2.groupby('Animal').mean()
except TypeError as e:
    print(type(e).__name__, ":", str(e)[:80])
print(df2.groupby('Animal').mean(numeric_only=True))TypeError : dtype 'str' does not support operation 'mean'
Vitesse Max
Animal
Faucon 375.0
Perroquet 25.0Pour aller plus loin, lis mon guide GroupBy de pandas en 10 étapes.
Comment parcourir deux listes en même temps avec zip() ?
On veut souvent combiner deux listes élément par élément. Pour cela, Python fournit zip() : il prend plusieurs itérables et renvoie des tuples qui associent le premier élément de chacun, puis le deuxième, et ainsi de suite. Comme c’est un itérateur, on l’utilise presque toujours dans une boucle for.
Considérons ces deux listes :
a = [5, 10, 15, 20]
b = [5, 10, 15, 20]Notre objectif est d’additionner les éléments de même position. Sans zip(), on passe par les indices :
somme = []
for i in range(len(a)):
    somme.append(a[i] + b[i])
print(somme)[10, 20, 30, 40]Cela fonctionne, mais l’indice i alourdit le code et il est facile de se tromper. Avec zip(), on parcourt les deux listes ensemble :
somme = []
for ai, bi in zip(a, b):
    somme.append(ai + bi)
print(somme)[10, 20, 30, 40]Deux détails à connaître. Quand les listes n’ont pas la même longueur, zip() s’arrête à la plus courte, sans prévenir :
print(list(zip([1, 2, 3], ["a", "b"])))[(1, 'a'), (2, 'b')]Depuis Python 3.10, l’option strict=True lève une erreur à la place, ce qui évite de perdre des données sans s’en apercevoir :
try:
    list(zip([1, 2, 3], ["a", "b"], strict=True))
except ValueError as e:
print(type(e).__name__, ":", e)ValueError : zip() argument 2 is shorter than argument 1Comment écrire une boucle sur une ligne avec une compréhension de liste ?
Dans la boucle zip() ci-dessus, on a d’abord créé une liste vide, puis on y a ajouté les résultats un par un. Une compréhension de liste (list comprehension) fait la même chose en une seule expression : on écrit entre crochets ce qu’on veut obtenir, suivi de la boucle.
somme = [ai + bi for ai, bi in zip(a, b)]
print(somme)[10, 20, 30, 40]On peut aussi ajouter une condition à la fin pour filtrer :
grands = [x for x in data if x > 10]
print(grands)[15, 20]La compréhension est plus courte, et en général plus rapide que la boucle avec append(), parce que Python n’a pas à rappeler la méthode append à chaque tour. Voici une mesure sur un million d’éléments (les durées dépendent de ta machine et le gain varie d’une exécution à l’autre) :
from timeit import timeit

n = 1_000_000
def avec_boucle():
    res = []
    for x in range(n):
        res.append(x + 5)
    return res

def avec_comprehension():
    return [x + 5 for x in range(n)]

t1 = timeit(avec_boucle, number=5) / 5
t2 = timeit(avec_comprehension, number=5) / 5
print(f"boucle + append : {t1:.3f} s")
print(f"comprehension   : {t2:.3f} s")
print(f"gain : {1 - t2 / t1:.0%}")boucle + append : 0.075 s
comprehension : 0.047 s
gain : 37%Ne la confonds pas avec une économie de mémoire : une compréhension de liste construit toute la liste en mémoire (ici environ 8 Mo pour un million de valeurs). Si tu n’as besoin de parcourir les valeurs qu’une fois (pour une somme, par exemple), remplace les crochets par des parenthèses : tu obtiens un générateur, qui calcule les valeurs à la demande.
import sys

liste = [x + 5 for x in range(1_000_000)]
generateur = (x + 5 for x in range(1_000_000))
print("liste       :", sys.getsizeof(liste), "octets")
print("générateur  :", sys.getsizeof(generateur), "octets")
print("même somme :", sum(liste) == sum(x + 5 for x in range(1_000_000)))liste : 8448728 octets
générateur : 200 octets
même somme : TrueLes compréhensions servent aussi à changer le type des valeurs d’une liste (par exemple [int(x) for x in valeurs]), même si pandas fait cela très bien pour une colonne. Pour approfondir les boucles et les structures de données, lis Boucles FOR en Python et Les structures de données Python.
Questions fréquentes
Quelle différence entre map() et une compréhension de liste ?
Les deux transforment chaque élément d’une liste. map() prend une fonction et renvoie un itérateur paresseux (à convertir avec list()). La compréhension de liste renvoie directement une liste et accepte une condition. Dans la pratique, la compréhension est plus lisible et c’est la forme la plus courante.
Comment filtrer un DataFrame pandas avec plusieurs conditions ?
Combine les conditions avec & (et), | (ou) et ~ (non), en mettant chaque condition entre parenthèses, par exemple df[(df["A"] > 5) & (df["B"] == "grand")]. Les mots and et or ne fonctionnent pas sur des séries pandas.
À quoi sert groupby() dans pandas ?
groupby() regroupe les lignes d’un DataFrame selon les valeurs d’une colonne, puis calcule un résumé par groupe : moyenne, somme, maximum, nombre de lignes… C’est l’outil de base pour comparer des catégories entre elles. Avec agg(), on calcule plusieurs résumés en même temps.
Que se passe-t-il si les listes passées à zip() n’ont pas la même longueur ?
zip() s’arrête à la fin de la liste la plus courte et ignore le reste, sans erreur. Depuis Python 3.10, zip(a, b, strict=True) lève une ValueError si les longueurs diffèrent.
Une compréhension de liste est-elle plus rapide qu’une boucle for ?
Oui, en général : sur un million d’éléments, la compréhension de liste est nettement plus rapide que la boucle avec append() (le gain varie selon la machine et l’opération). Elle ne réduit pas la mémoire utilisée : pour cela, utilise un générateur avec des parenthèses.
Faut-il utiliser map() ou NumPy pour appliquer une opération à des nombres ?
Pour des données numériques, utilise NumPy : l’opération vectorisée np.array(data) + 5 s’applique à tout le tableau sans boucle Python et reste la plus rapide. map() et les compréhensions conviennent aux listes Python ordinaires et aux transformations qui ne sont pas vectorisables.
Conclusion
Tu as maintenant cinq outils pour traiter des données avec Python : map(), les masques pandas, groupby(), zip() et les compréhensions de liste. Ils font partie des bases de la programmation Python et se combinent très bien entre eux. Pour t’entraîner, essaie de refaire chaque exemple avec tes propres données.
Connaître ces outils ne suffit pas : c’est en les utilisant sur de vrais jeux de données qu’ils deviennent des réflexes. Le cours Python pour la Data Science de DataXp te fait pratiquer Python et pandas avec des exercices corrigés dans le navigateur, et une partie est gratuite pour tester.
Pour aller plus loin :