NumPy et pandas sont au cœur de presque toutes les analyses de données en Python. On les utilise tous les jours, mais certaines de leurs fonctions restent méconnues alors qu’elles font gagner un temps précieux. Dans cet article, je te présente 12 fonctions NumPy et pandas pour la data science (6 pour chaque bibliothèque), plus une fonction bonus : pivot_table(). Chacune vient avec un exemple de code testé que tu peux exécuter toi-même.
Article mis à jour en octobre 2026 : code testé avec Python 3.13, NumPy 2 et pandas 3, vraies sorties à la place des anciennes (avec des graines pour les exemples aléatoires), exemple de allclose() précisé (le troisième argument est une tolérance relative), exemple de pivot_table() corrigé, ajout de DataFrame.map() et du comportement de copy() avec la copie sur écriture de pandas 3.
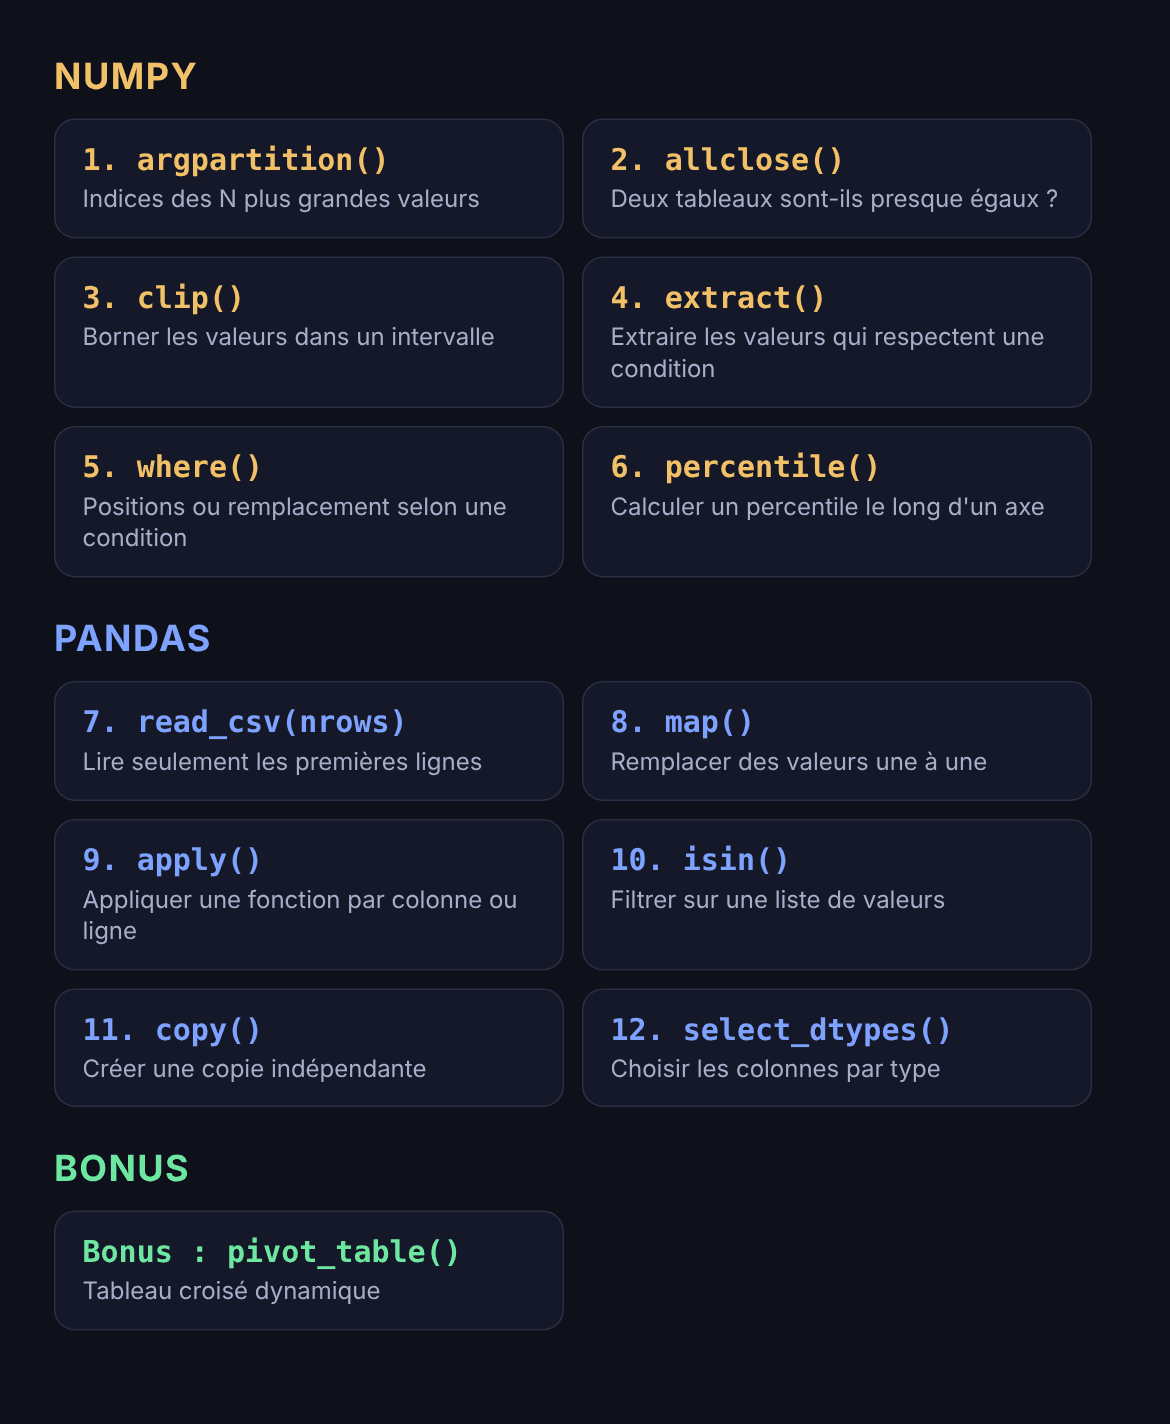
En bref : voici 12 fonctions Pandas et NumPy à ne pas manquer. Côté NumPy, argpartition() trouve les indices des plus grandes valeurs, allclose() compare deux tableaux avec une tolérance, clip() borne les valeurs, extract() et where() sélectionnent selon une condition et percentile() calcule les percentiles. Côté pandas, read_csv(nrows=) lit seulement les premières lignes d’un fichier, map() et apply() transforment les valeurs, isin() filtre sur une liste de valeurs, copy() duplique un objet et select_dtypes() choisit les colonnes par type. Le bonus pivot_table() construit un tableau croisé dynamique.
Tu peux exécuter tous les exemples de cet article dans ce notebook Google Colab.
Tous les exemples commencent par ces deux imports et utilisent ces versions (octobre 2026) :
import numpy as np
import pandas as pd

print("NumPy ", np.__version__)
print("pandas", pd.__version__)NumPy 2.5.3
pandas 3.0.5Quelles fonctions NumPy connaître pour la data science ?
NumPy est le paquet de base du calcul scientifique en Python : son objet ndarray est un tableau à N dimensions, avec des opérations vectorisées (sans boucle Python) très rapides. Presque toutes les autres bibliothèques de la data science s’appuient dessus. Pour aller plus loin, lis mon guide NumPy ou les 20 astuces NumPy les plus élégantes.
1. Comment trouver les N plus grandes valeurs avec argpartition() ?
La fonction np.argpartition(x, -4) place les 4 plus grandes valeurs à la fin et renvoie leurs indices. Elle ne trie pas tout le tableau, donc elle est plus rapide qu’un tri complet sur de grands tableaux. Attention : les 4 indices ne sont pas rangés par ordre de valeur. Si tu veux les valeurs triées, trie-les ensuite.
# Tableau arbitraire
x = np.array([12, 10, 12, 0, 6, 8, 9, 1, 16, 4, 6, 0])

index_val = np.argpartition(x, -4)[-4:]
print(index_val)[1 2 0 8]Les valeurs correspondantes, une fois triées :
# Les valeurs correspondantes, triées
print(np.sort(x[index_val]))[10 12 12 16]2. Comment comparer deux tableaux avec allclose() ?
np.allclose() renvoie True si tous les éléments de deux tableaux sont égaux à une tolérance près, et False sinon. C’est très utile avec des nombres décimaux, car deux calculs qui devraient donner la même valeur diffèrent souvent de quelques décimales : 0.1 + 0.2 == 0.3 est faux en Python.
Le troisième argument est la tolérance relative rtol : deux valeurs a et b sont considérées comme proches si |a - b| <= atol + rtol × |b|. Il existe aussi une tolérance absolue atol (par défaut 1e-08). Nommer l’argument rend le code plus clair :
array1 = np.array([0.12, 0.17, 0.24, 0.29])
array2 = np.array([0.13, 0.19, 0.26, 0.31])

# avec une tolérance relative de 0,1 : False
print(np.allclose(array1, array2, rtol=0.1))

# avec une tolérance relative de 0,2 : True
print(np.allclose(array1, array2, rtol=0.2))False
TruePour savoir quels éléments sont proches, utilise np.isclose(), qui compare élément par élément (ici, la deuxième paire n’est pas assez proche pour rtol=0.1) :
np.isclose(array1, array2, rtol=0.1)array([ True, False, True, True])3. Comment garder les valeurs dans un intervalle avec clip() ?
np.clip() force les valeurs d’un tableau à rester entre une borne basse et une borne haute : ce qui est en dessous devient la borne basse, ce qui est au-dessus devient la borne haute. C’est pratique pour limiter l’effet des valeurs aberrantes.
x = np.array([3, 17, 14, 23, 2, 2, 6, 8, 1, 2, 16, 0])

np.clip(x, 2, 5)array([3, 5, 5, 5, 2, 2, 5, 5, 2, 2, 5, 2])4. Comment extraire des valeurs selon une condition avec extract() ?
np.extract(condition, tableau) renvoie les éléments du tableau pour lesquels la condition est vraie. Pour combiner des conditions, utilise & (et) et | (ou), en mettant chaque condition entre parenthèses (les mots and et or ne fonctionnent pas sur des tableaux). Pour obtenir toujours les mêmes nombres aléatoires, l’exemple utilise une graine avec np.random.default_rng(42).
# Nombres entiers aléatoires (avec une graine pour obtenir toujours les mêmes)
rng = np.random.default_rng(42)
arr = rng.integers(20, size=12)
print(arr)

# Diviser par 2 et vérifier si le reste est égal à 1 (nombres impairs)
cond = np.mod(arr, 2) == 1
print(cond)

# Utiliser extract() pour obtenir les valeurs
print(np.extract(cond, arr))

# Appliquer directement une condition (| signifie « ou »)
print(np.extract((arr < 3) | (arr > 15), arr))[ 1 15 13 8 8 17 1 13 4 1 10 19]
[ True True True False False True True True False True False True]
[ 1 15 13 17 1 13 1 19]
[ 1 17 1 1 19]Sur un tableau à une dimension, extract() revient à filtrer avec un masque booléen, arr[cond] :
# extract() revient à filtrer avec un masque booléen
print(np.array_equal(np.extract(cond, arr), arr[cond]))True5. Comment trouver des positions ou remplacer des valeurs avec where() ?
np.where() a deux usages. Avec une seule condition, elle renvoie les positions (les indices) des valeurs qui la respectent, sous la forme d’un tuple de tableaux (un par dimension). C’est proche du WHERE de SQL.
y = np.array([1, 5, 6, 8, 1, 7, 3, 6, 9])

# Positions des valeurs supérieures à 5
np.where(y > 5)(array([2, 3, 5, 7, 8]),)Avec trois arguments, elle remplace chaque valeur : la deuxième si la condition est vraie, la troisième sinon.
# Avec trois arguments : une valeur si la condition est vraie, une autre sinon
np.where(y > 5, "OK", "NON")array(['NON', 'NON', 'OK', 'OK', 'NON', 'OK', 'NON', 'OK', 'OK'],
dtype='<U3')6. Comment calculer un percentile avec percentile() ?
np.percentile(a, q) calcule le q-ième percentile des valeurs : la valeur sous laquelle se trouvent q % des données. Pour un tableau à plusieurs dimensions, axis indique le sens du calcul : axis=0 pour chaque colonne, axis=1 pour chaque ligne. np.quantile() fait la même chose avec une proportion entre 0 et 1.
a = np.array([1, 5, 6, 8, 1, 7, 3, 6, 9])
print("50e percentile de a :", np.percentile(a, 50))

b = np.array([[10, 7, 4], [3, 2, 1]])
print("30e percentile de b, axis=0 :", np.percentile(b, 30, axis=0))
print("30e percentile de b, axis=1 :", np.percentile(b, 30, axis=1))50e percentile de a : 6.0
30e percentile de b, axis=0 : [5.1 3.5 1.9]
30e percentile de b, axis=1 : [5.8 1.6]print(np.quantile(a, 0.5))6.0Quelles fonctions pandas connaître pour la data science ?
pandas est la bibliothèque de référence pour manipuler des données tabulaires (comme un tableau SQL ou une feuille Excel) et des séries temporelles : DataFrame, valeurs manquantes, regroupements, fusions, lecture de fichiers… Pour aller plus loin, lis mon guide pandas ou les 22 astuces pandas.
7. Comment lire seulement les premières lignes d’un CSV avec read_csv(nrows=) ?
Quand on découvre un gros fichier CSV (imagine 10 Go), le lire en entier consomme beaucoup de mémoire et de temps, alors qu’on veut juste voir quelles colonnes et quelles données il contient. Avec nrows=n, read_csv() ne lit que les n premières lignes. Et pandas sait lire directement une adresse web : pas besoin de requests. L’exemple utilise le nombre mensuel de passagers aériens de 1949 à 1960, hébergé dans mon dépôt GitHub.
# Jeu de données en ligne : nombre mensuel de passagers aériens de 1949 à 1960
url = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/pandas-et-numpy-pour-la-data-science/AirPassengers.csv"

# On ne lit que les 10 premières lignes
df = pd.read_csv(url, nrows=10, index_col=0)
df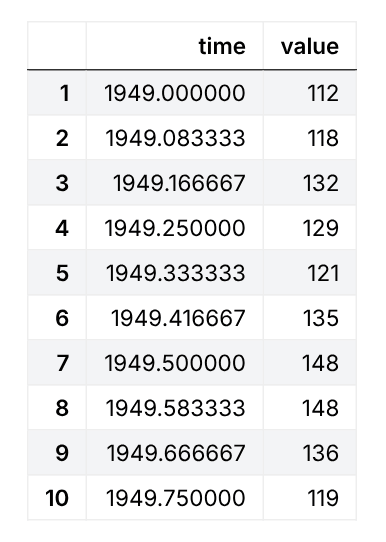
Pour ne garder que certaines colonnes, ajoute usecols. Pour traiter un fichier trop gros morceau par morceau, utilise chunksize.
# On peut aussi ne garder que certaines colonnes
pd.read_csv(url, usecols=["value"], nrows=3) value
0 112
1 118
2 1328. Comment remplacer des valeurs avec map() ?
La méthode map() des Series substitue chaque valeur par une autre, calculée par une fonction, un dictionnaire ou une autre série. Créons d’abord un DataFrame de nombres aléatoires :
# Un DataFrame de nombres aléatoires (avec une graine)
rng = np.random.default_rng(0)
dframe = pd.DataFrame(rng.standard_normal((4, 3)).round(2), columns=list("bde"),
                      index=["Inde", "USA", "Chine", "Russie"])
dframe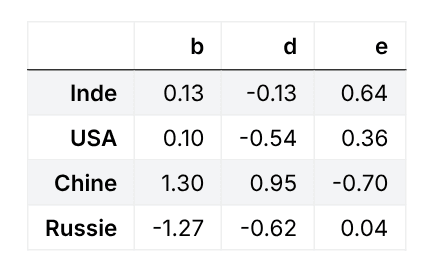
Avec une fonction, ici un formatage à deux décimales :
# Une fonction qui formate un nombre avec 2 décimales
changefn = lambda x: "%.2f" % x

# Changement valeur par valeur sur la colonne d
dframe["d"].map(changefn)Inde -0.13
USA -0.54
Chine 0.95
Russie -0.62
Name: d, dtype: strAvec un dictionnaire, chaque valeur est remplacée par sa correspondance (une valeur absente du dictionnaire devient NaN) :
# map() accepte aussi un dictionnaire
continents = {"Inde": "Asie", "USA": "Amérique", "Chine": "Asie", "Russie": "Europe"}
dframe.index.map(continents)Index(['Asie', 'Amérique', 'Asie', 'Europe'], dtype='str')Pour transformer toutes les cellules d’un DataFrame, utilise DataFrame.map() (qui remplace applymap(), obsolète depuis pandas 2.1) :
# Sur un DataFrame entier, on utilise DataFrame.map() (anciennement applymap())
dframe.map(changefn) b d e
Inde 0.13 -0.13 0.64
USA 0.10 -0.54 0.36
Chine 1.30 0.95 -0.70
Russie -1.27 -0.62 0.049. Comment appliquer une fonction à des colonnes ou des lignes avec apply() ?
Sur un DataFrame, apply() passe à ta fonction chaque colonne (par défaut, axis=0) ou chaque ligne (axis=1) et assemble les résultats. Sur une Series, elle l’applique à chaque valeur. Ici, on calcule l’écart entre le maximum et le minimum :
# Écart entre le maximum et le minimum
fn = lambda x: x.max() - x.min()

# Appliqué à chaque colonne du DataFrame
dframe.apply(fn)b 2.57
d 1.57
e 1.34
dtype: float64Avec axis=1, l’écart est calculé pour chaque pays :
# Appliqué à chaque ligne avec axis=1
dframe.apply(fn, axis=1)Inde 0.77
USA 0.90
Chine 2.00
Russie 1.31
dtype: float64Quand une opération existe déjà en version vectorisée (une somme, une moyenne…), préfère-la à apply() : elle est bien plus rapide, car apply() appelle ta fonction Python à chaque colonne ou ligne.
10. Comment filtrer sur plusieurs valeurs avec isin() ?
La méthode isin() renvoie True pour chaque ligne dont la valeur figure dans une liste. Placée entre crochets, elle filtre le DataFrame sur une ou plusieurs valeurs d’une colonne : c’est l’équivalent du IN de SQL, et un des filtres que j’utilise le plus. L’exemple réutilise le DataFrame df lu avec read_csv() :
# On réutilise le DataFrame lu avec read_csv
df[df["value"].isin([112, 118, 132])]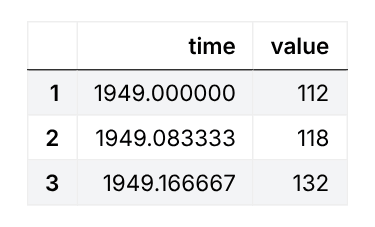
Le signe ~ inverse le filtre :
# ~ inverse le filtre : toutes les lignes sauf celles-ci
df[~df["value"].isin([112, 118, 132])] time value
4 1949.250000 129
5 1949.333333 121
6 1949.416667 135
7 1949.500000 148
8 1949.583333 148
9 1949.666667 136
10 1949.750000 119Pour d’autres méthodes de filtrage, lis mon article sur les 8 façons de filtrer un DataFrame pandas.
11. Comment copier un DataFrame ou une Series avec copy() ?
Écrire data1 = data ne crée pas de copie : data1 et data sont deux noms pour le même objet, donc modifier l’un modifie l’autre.
# Créer une série d'exemple
data = pd.Series(["Inde", "Pakistan", "Chine", "Mongolie"])

# Une simple affectation ne copie rien : data1 et data sont le même objet
data1 = data
print(data1 is data)

# Changer une valeur via data1 change aussi data
data1[0] = "USA"
print(data)True
0 USA
1 Pakistan
2 Chine
3 Mongolie
dtype: strPour obtenir un objet indépendant, on utilise copy() :
# Pour obtenir un objet indépendant, on utilise copy()
new = data.copy()

# attribution d'une nouvelle valeur dans la copie
new[1] = "Valeur changée"

print(new)
print(data)0 USA
1 Valeur changée
2 Chine
3 Mongolie
dtype: str
0 USA
1 Pakistan
2 Chine
3 Mongolie
dtype: strDepuis pandas 3.0, la copie sur écriture (copy-on-write) est active par défaut : un sous-ensemble ou le résultat d’une opération se comporte toujours comme une copie, et modifier l’un ne modifie jamais l’autre. Ça supprime le célèbre avertissement SettingWithCopyWarning. Mais l’affectation simple data1 = data reste la même référence : copy() reste donc nécessaire pour dupliquer un objet.
# Avec pandas 3, un sous-ensemble est lui aussi indépendant (copie sur écriture)
sous = data[:2]
sous[0] = "Autre"
print(sous)
print(data)0 Autre
1 Pakistan
dtype: str
0 USA
1 Pakistan
2 Chine
3 Mongolie
dtype: str12. Comment choisir des colonnes selon leur type avec select_dtypes() ?
select_dtypes() renvoie les colonnes d’un DataFrame selon leur type de données (dtype). Avec include, on garde certains types ; avec exclude, on retire certains types. Les noms génériques "number", "str" (pandas 3) ou "datetime" évitent de lister chaque type à la main.
# Les colonnes de type float64 uniquement
framex = df.select_dtypes(include="float64")
framex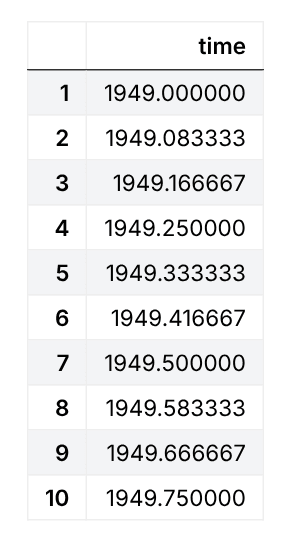
print(df.dtypes)
print(df.select_dtypes(include="number").columns.tolist())
print(df.select_dtypes(exclude="float64").columns.tolist())time float64
value int64
dtype: object
['time', 'value']
['value']Bonus : comment faire un tableau croisé dynamique avec pivot_table() ?
Pour moi, la fonction la plus utile de pandas est pivot_table(). Si tu as déjà fait un tableau croisé dynamique dans Excel, tu connais le principe : on choisit une colonne pour les lignes, une pour les colonnes et une opération (moyenne, somme, nombre…) pour remplir les cellules. Elle étend groupby() en mettant le résultat sous forme de tableau. Voici un DataFrame d’exemple :
# Un DataFrame d'exemple : prénom, diplôme, âge, ville
school = pd.DataFrame({
    "Prénom": ["Jay", "Usher", "Nicky", "Romero", "Will"],
    "Diplôme": ["Master", "Licence", "Licence", "Master", "Licence"],
    "Âge": [26, 22, 20, 23, 24],
    "Ville": ["Zurich", "Genève", "Zurich", "Zurich", "Genève"],
})
school Prénom Diplôme Âge Ville
0 Jay Master 26 Zurich
1 Usher Licence 22 Genève
2 Nicky Licence 20 Zurich
3 Romero Master 23 Zurich
4 Will Licence 24 GenèveUn premier tableau : l’âge moyen par diplôme. Passe l’opération sous forme de texte ("mean", "sum", "count"…) :
# Âge moyen par diplôme
pd.pivot_table(school, values="Âge", index="Diplôme", aggfunc="mean") Âge
Diplôme
Licence 22.0
Master 24.5Ajoutons les villes en colonnes. Les combinaisons sans étudiant (aucun Master à Genève) sont vides : fill_value=0 les remplace. Utilise une valeur de même type que les résultats : avec du texte, comme « Aucun », pandas affiche un avertissement de dépréciation.
# Diplômes en lignes, villes en colonnes, âge moyen dans les cellules
table = pd.pivot_table(school, values="Âge", index="Diplôme", columns="Ville",
                       aggfunc="mean", fill_value=0)
table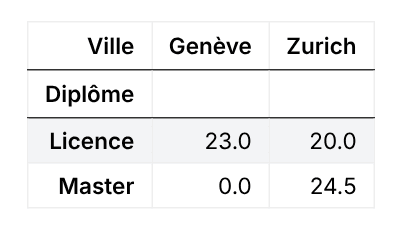
On peut aussi calculer plusieurs opérations à la fois et ajouter une ligne de totaux avec margins=True :
# Plusieurs agrégations, avec les totaux (margins)
pd.pivot_table(school, values="Âge", index="Diplôme", aggfunc=["mean", "count"], margins=True) mean count
Âge Âge
Diplôme
Licence 22.0 3
Master 24.5 2
All 23.0 5Pour un guide complet, lis Pivot de Pandas : un guide détaillé.
Questions fréquentes
Comment obtenir les indices des N plus grandes valeurs d’un tableau NumPy ?
Avec np.argpartition(x, -N)[-N:] : elle renvoie les indices des N plus grandes valeurs sans trier tout le tableau, donc plus vite qu’un tri complet. Ces indices ne sont pas ordonnés : applique np.sort(x[indices]) pour obtenir les valeurs triées.
Que signifie le troisième argument de np.allclose() ?
C’est la tolérance relative rtol. Deux valeurs sont jugées proches si |a - b| <= atol + rtol × |b|, avec atol (tolérance absolue) égal à 1e-08 par défaut. Écris rtol=0.1 pour que le code soit plus clair, et utilise np.isclose() pour voir quels éléments sont proches.
Quelle différence entre map(), apply() et DataFrame.map() dans pandas ?
Series.map() remplace chaque valeur d’une colonne avec une fonction ou un dictionnaire. apply() applique une fonction à chaque colonne ou ligne d’un DataFrame (axis choisit le sens), ou à chaque valeur d’une Series. DataFrame.map() applique une fonction à chaque cellule d’un DataFrame ; elle remplace applymap(), obsolète depuis pandas 2.1.
Comment lire seulement une partie d’un gros fichier CSV avec pandas ?
Avec pd.read_csv(fichier, nrows=n) pour les n premières lignes, usecols=[...] pour ne garder que certaines colonnes, ou chunksize=n pour lire le fichier par morceaux de n lignes sans tout charger en mémoire.
Pourquoi utiliser copy() avec pandas 3 ?
Parce que b = a ne copie rien : a et b sont le même objet. Depuis pandas 3.0, la copie sur écriture rend les sous-ensembles et les résultats d’opérations indépendants de l’original, mais seul copy() donne un objet distinct de celui d’origine quand tu veux le modifier sans toucher à l’autre.
Quelle différence entre pivot_table() et groupby() ?
groupby() regroupe les lignes et calcule un résumé par groupe, avec un résultat « en longueur ». pivot_table() fait le même calcul puis étale un des critères en colonnes, pour obtenir un tableau croisé dynamique comme dans Excel, avec margins=True pour les totaux et fill_value pour les cases vides.
Conclusion
Tu connais maintenant 12 fonctions NumPy et pandas, plus pivot_table(), qui simplifient des tâches courantes : trouver les plus grandes valeurs, borner des données, filtrer, transformer, copier sans risque ou résumer en tableau croisé. Pour les retenir, essaie de les utiliser sur un de tes propres jeux de données.
Une fonction qu’on a lue, on l’oublie ; une fonction qu’on a utilisée, on s’en souvient. Le cours Python pour la Data Science de DataXp te fait pratiquer NumPy et pandas avec des exercices corrigés dans le navigateur, et une partie est gratuite pour tester.
Pour aller plus loin :