Les crypto monnaies attirent autant d’investisseurs que de curieux, et la même question revient toujours : peut-on prédire leur prix ? Dans cet article, on réalise la prédiction du prix du Bitcoin en euros avec un réseau de neurones LSTM construit avec Keras : on prédit le prix de clôture du lendemain, puis on vérifie honnêtement ce que vaut le modèle.
Article mis à jour en octobre 2026 : le code utilise Keras 3, les données viennent de l’API publique de Binance (l’API CryptoCompare de l’ancienne version demande désormais une clé), j’ai corrigé les erreurs du code d’origine et ajouté une comparaison avec une référence naïve. Les résultats ont donc changé, et la conclusion aussi.
En bref : on entraîne un réseau LSTM sur des fenêtres de 5 jours de cours BTC/EUR pour prédire le prix du lendemain. La courbe prédite colle au prix réel, mais sur 419 jours de test l’erreur moyenne du LSTM (1 157 €) dépasse celle de la règle « demain = aujourd’hui » (1 083 €), et il devine le sens de variation du prix dans 48,9 % des cas. Un graphique qui colle au prix ne prouve presque rien : compare toujours ton modèle à une référence simple.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : les données sont chargées depuis GitHub, rien à télécharger. Le code est testé avec Python 3.13, Keras 3.15 (backend TensorFlow 2.21), pandas 3 et scikit-learn 1.9.
Il s’agit d’un exercice de Deep Learning sur des séries temporelles, pas d’un conseil en investissement. Si tu découvres les réseaux de neurones, commence par mon article sur le fonctionnement du Deep Learning : tu y trouveras les bases (couches, poids, entraînement) que je ne redétaille pas ici.
Le projet se déroule en quatre étapes :
- Récupérer l’historique des prix du Bitcoin en euros.
- Préparer les données : découpage chronologique, fenêtres de 5 jours, normalisation.
- Construire et entraîner un réseau LSTM avec Keras.
- Évaluer le modèle, et surtout le comparer à une référence naïve.
Quel défi relever ?
Le but est de prédire le prix de clôture du Bitcoin pour le jour suivant, à partir des cinq derniers jours. En Machine Learning, c’est un problème de régression sur une série temporelle : l’ordre des jours compte, ce qui est justement ce que savent exploiter les réseaux récurrents comme le LSTM.
Une remarque importante avant de coder : le prix d’un actif financier est notoirement difficile à prédire. Le meilleur « modèle » simple consiste à dire que demain ressemblera à aujourd’hui. Nous l’utiliserons comme référence pour juger notre réseau.
Quelles données utiliser pour prédire le prix du Bitcoin ?
Nous utilisons les cours journaliers de la paire BTC/EUR de Binance : 2 120 jours, du 1er janvier 2021 au 21 octobre 2026. Chaque ligne contient cinq variables :
open: le prix d’ouverture de la journée, en euros ;high: le prix le plus haut de la journée ;low: le prix le plus bas de la journée ;close: le prix de clôture, c’est la variable à prédire ;volume: la quantité de bitcoins échangés dans la journée.
J’ai commencé en 2021 parce qu’avant, la paire BTC/EUR de Binance était très peu échangée (en 2020, le volume quotidien médian est vingt fois plus faible qu’en 2021).
Les prix évoluent chaque jour, donc une API en direct donne à chaque exécution un historique différent, et des résultats qu’on ne peut pas comparer. Pour que ton code produise les mêmes chiffres que les miens, j’ai figé les données dans un fichier btc-eur-daily.csv hébergé sur GitHub. Si tu veux des données à jour, la fonction facultative de la fin de cette section les télécharge depuis l’API publique de Binance, qui ne demande pas de clé (voir sa documentation).
Comment réaliser la prédiction du prix du Bitcoin avec un LSTM en Python ?
Importation des bibliothèques
On importe NumPy et pandas pour les données, Matplotlib pour les graphiques, Keras pour le réseau et scikit-learn pour la mesure d’erreur. Avec Keras 3, on écrit simplement import keras (les anciens from keras.models import Sequential et la commande Colab %tensorflow_version 2.x ne sont plus nécessaires).
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import keras
from keras import layers
from sklearn.metrics import mean_absolute_error

print(keras.__version__, keras.backend.backend())3.15.1 tensorflowChargement des données
On lit le fichier CSV directement depuis GitHub, en transformant la colonne date en vraie date et en la mettant en index :
url = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/prediction-du-prix-des-crypto-monnaies/btc-eur-daily.csv"
hist = pd.read_csv(url, parse_dates=['date'], index_col='date')

target_col = 'close'
print(hist.shape)
print(hist.head())(2120, 5)
open high low close volume
date
2021-01-01 23713.67 24200.00 23501.00 24076.03 1912.1420
2021-01-02 24074.83 26997.76 23000.00 25925.69 5642.0274
2021-01-03 25925.70 27999.99 25385.80 26190.43 5685.8741
2021-01-04 26201.52 26646.38 23000.00 26048.40 6459.8552
2021-01-05 26048.40 28000.00 24439.79 27655.03 6178.2004Vérifions que l’historique est complet : pas de valeur manquante, et exactement un jour entre chaque ligne.
print(hist.index.min(), hist.index.max())
print(hist.isna().sum().sum(), 'valeurs manquantes')
print(hist.index.to_series().diff().value_counts())2021-01-01 00:00:00 2026-10-21 00:00:00
0 valeurs manquantes
date
1 days 2119
Name: count, dtype: int64Pour obtenir des données à jour à la place du fichier figé, voici une fonction qui interroge l’API de Binance (les cours sont renvoyés par lots de 1 000 jours maximum). Je ne l’exécute pas dans l’article, pour que les résultats restent reproductibles :
import requests

def telecharger_btc_eur(debut='2021-01-01', fin='2026-10-22', symbole='BTCEUR'):
    url = 'https://data-api.binance.vision/api/v3/klines'
    start = int(pd.Timestamp(debut, tz='UTC').timestamp() * 1000)
    end = int(pd.Timestamp(fin, tz='UTC').timestamp() * 1000) - 1
    lignes = []
    while start < end:
        res = requests.get(url, params={'symbol': symbole, 'interval': '1d', 'limit': 1000,
                                        'startTime': start, 'endTime': end}, timeout=30)
        res.raise_for_status()
        lot = res.json()
        if not lot:
            break
        lignes += lot
        start = lot[-1][0] + 86_400_000   # on repart du jour suivant
    df = pd.DataFrame(lignes).iloc[:, :6]
    df.columns = ['date', 'open', 'high', 'low', 'close', 'volume']
    df['date'] = pd.to_datetime(df['date'], unit='ms')
    return df.set_index('date').astype(float)

# hist = telecharger_btc_eur() # à décommenter pour obtenir des données à jourDécoupage entraînement et test
Contrairement à un jeu de données classique, on ne mélange pas les lignes : on garde l’ordre chronologique. Les 80 % de jours les plus anciens servent à l’entraînement, les 20 % les plus récents au test. C’est le seul découpage honnête : un tirage aléatoire laisserait le modèle « voir » des jours qui suivent ceux qu’il doit prédire.
def split_train_test(df, test_size=0.2):
    split_row = len(df) - int(test_size * len(df))
    train_data = df.iloc[:split_row]
    test_data = df.iloc[split_row:]
    return train_data, test_data

train, test = split_train_test(hist, test_size=0.2)
print(f"entraînement : {train.index.min():%d/%m/%Y} -> {train.index.max():%d/%m/%Y} ({len(train)} jours)")
print(f"test : {test.index.min():%d/%m/%Y} -> {test.index.max():%d/%m/%Y} ({len(test)} jours)")entraînement : 01/01/2021 -> 23/08/2025 (1696 jours)
test : 24/08/2025 -> 21/10/2026 (424 jours)Visualisation
Traçons le prix de clôture : en bleu la période d’entraînement, en orange la période de test.
def line_plot(line1, line2, label1=None, label2=None, title='', lw=2):
    fig, ax = plt.subplots(figsize=(13, 7))
    ax.plot(line1, label=label1, linewidth=lw)
    ax.plot(line2, label=label2, linewidth=lw)
    ax.set_ylabel('prix [EUR]', fontsize=14)
    ax.set_title(title, fontsize=16)
    ax.legend(loc='best', fontsize=16)

line_plot(train[target_col], test[target_col], 'entraînement', 'test', title='Bitcoin (BTC/EUR)', lw=2)
plt.show()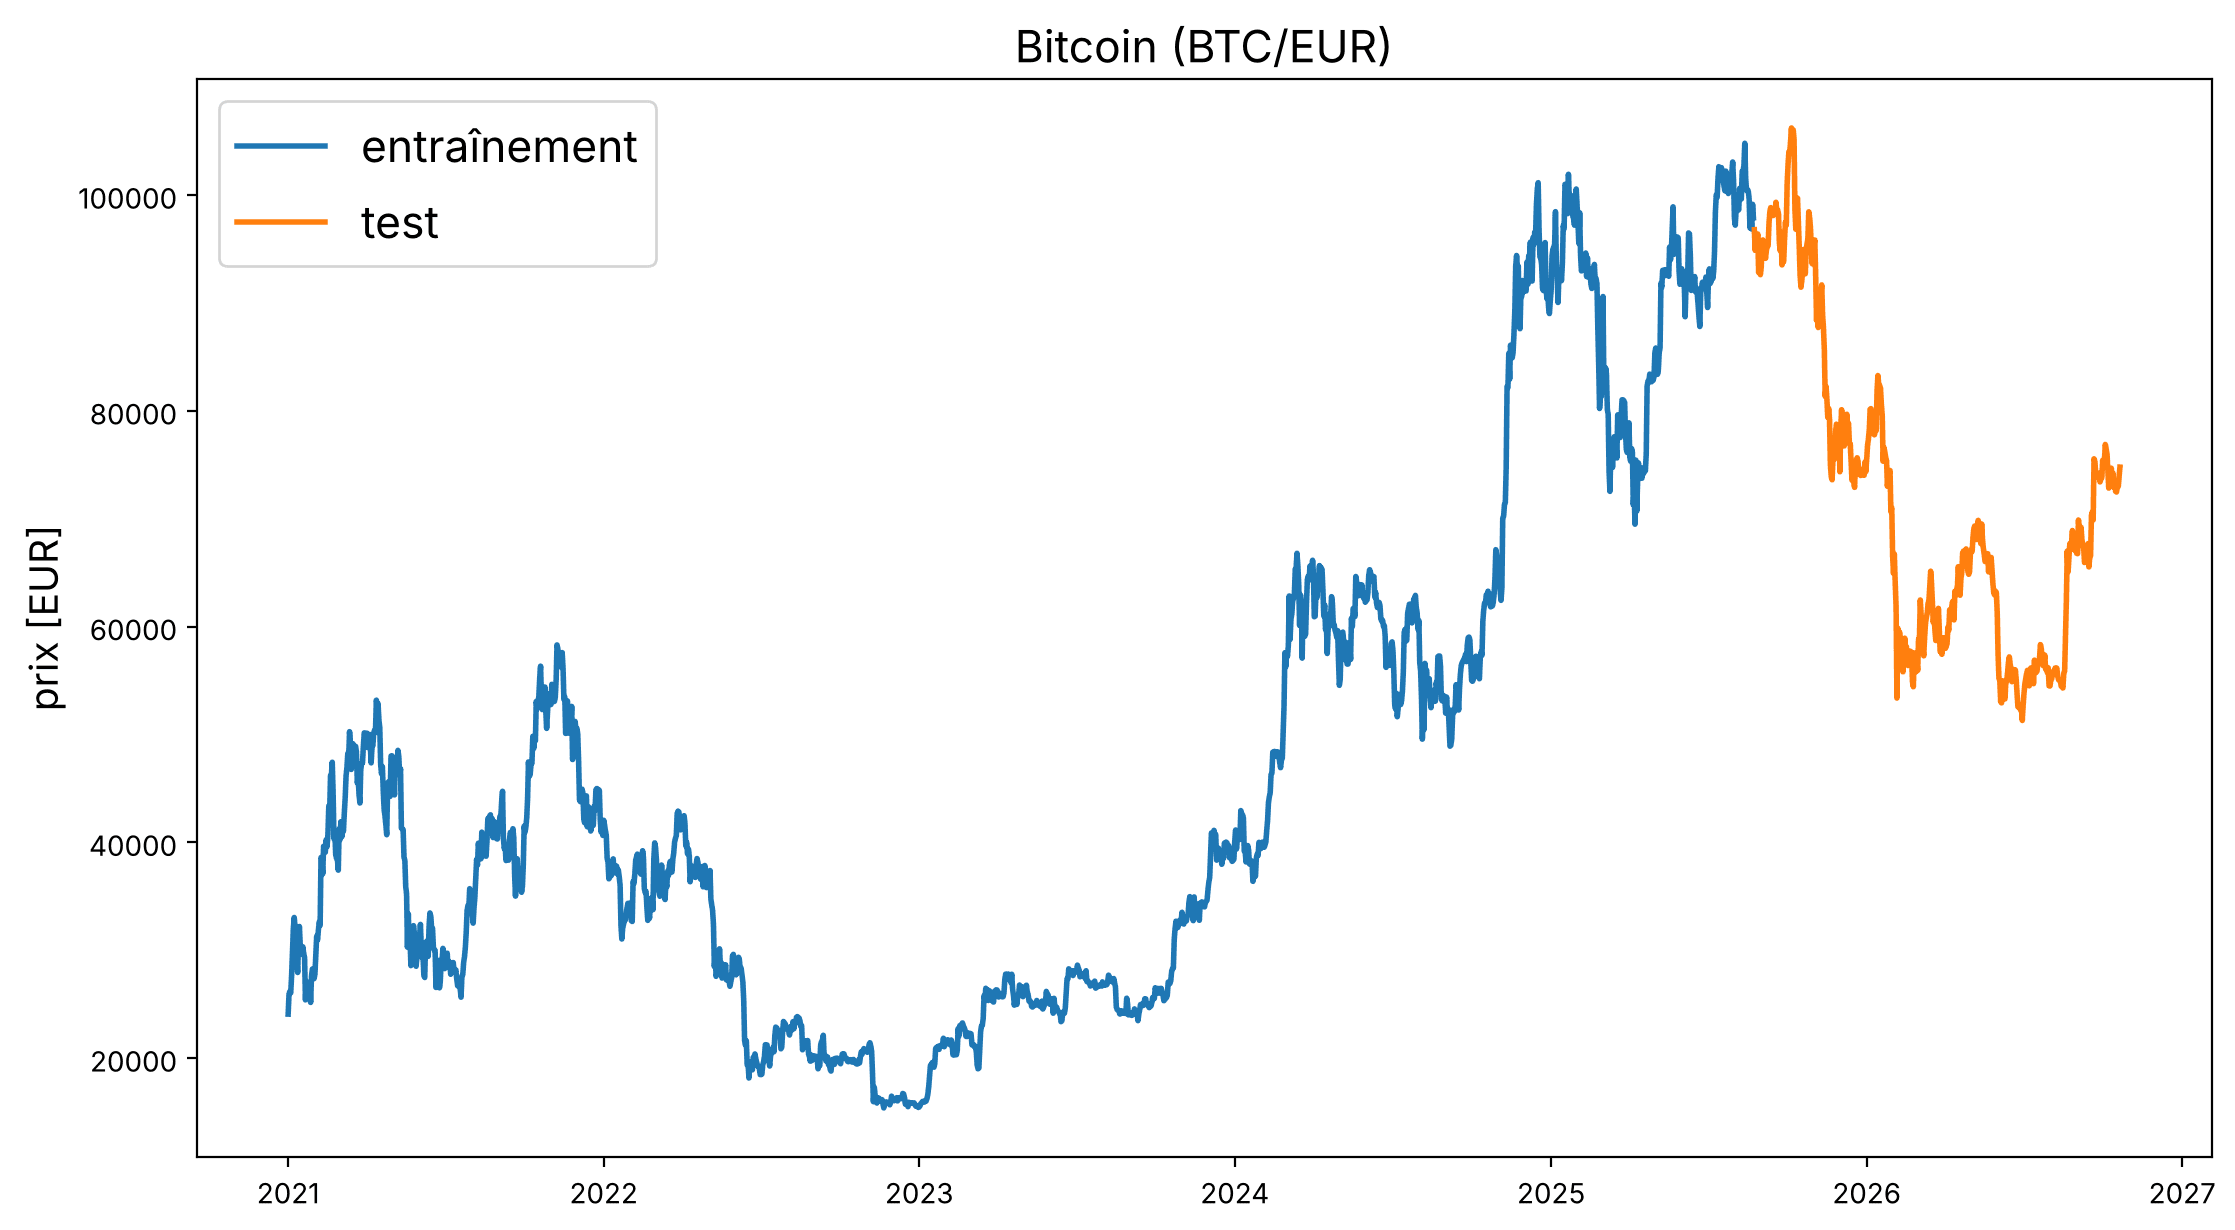
La période de test est loin d’être calme : le prix grimpe jusqu’à environ 106 000 € à l’automne 2025, puis s’effondre vers 51 000 €, avant de remonter vers 75 000 €. Notre modèle est entraîné sur des prix plus bas pour l’essentiel, ce qui rend l’exercice plus difficile : c’est pour cette raison que nous allons normaliser les données.
Normalisation et fenêtres glissantes
Un réseau de neurones travaille mal avec des valeurs aussi différentes que 20 000 € (en 2022) et 100 000 € (en 2025), et le volume est encore sur une autre échelle. On transforme donc chaque fenêtre de 5 jours : on divise chaque valeur par celle du premier jour de la fenêtre, puis on retire 1. Le réseau ne voit plus des prix absolus, mais des variations relatives (0,02 signifie +2 % par rapport au premier jour).
La fonction extract_window_data découpe la série en fenêtres glissantes de window_len jours. La fonction prepare_data fabrique les entrées X (les fenêtres) et les cibles y (le prix de clôture du jour suivant la fenêtre, exprimé lui aussi en variation relative par rapport au premier jour de la fenêtre).
def normalise_zero_base(df):
    return df / df.iloc[0] - 1

def extract_window_data(df, window_len=5, zero_base=True):
    window_data = []
    for idx in range(len(df) - window_len):
        tmp = df.iloc[idx: idx + window_len].copy()
        if zero_base:
            tmp = normalise_zero_base(tmp)
        window_data.append(tmp.values)
    return np.array(window_data)

def prepare_data(df, target_col, window_len=5, zero_base=True, test_size=0.2):
    train_data, test_data = split_train_test(df, test_size=test_size)
    X_train = extract_window_data(train_data, window_len, zero_base)
    X_test = extract_window_data(test_data, window_len, zero_base)
    y_train = train_data[target_col][window_len:].values
    y_test = test_data[target_col][window_len:].values
    if zero_base:
        y_train = y_train / train_data[target_col][:-window_len].values - 1
        y_test = y_test / test_data[target_col][:-window_len].values - 1
return train_data, test_data, X_train, X_test, y_train, y_testDans la version d’origine de cet article, une fonction normalise_min_max contenait une erreur (data.max() au lieu de df.max()) et n’était jamais utilisée : je l’ai supprimée.
Qu’est-ce qu’un réseau de neurones LSTM ?
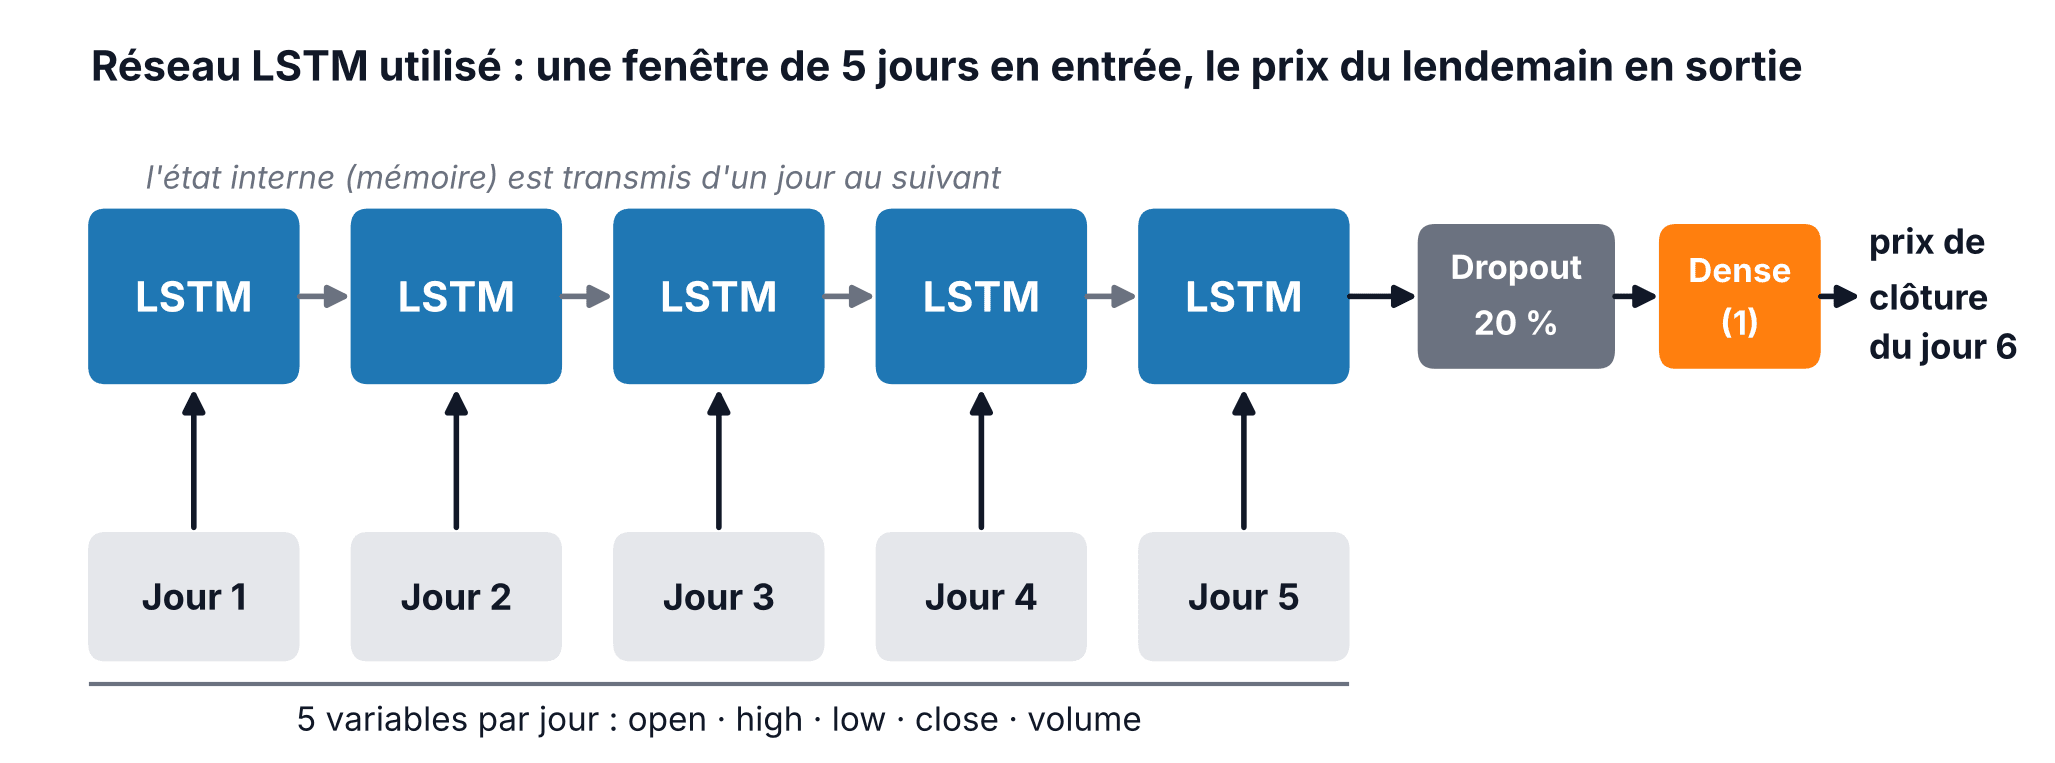
Un LSTM (Long Short-Term Memory, « mémoire à long et court terme ») est un réseau de neurones récurrent : il lit la fenêtre jour après jour et conserve un état interne, une sorte de mémoire, qu’il met à jour à chaque jour. Cette mémoire lui permet de tenir compte de l’ordre des données, ce qu’un réseau classique ne fait pas. Pour une explication détaillée des cellules LSTM, la référence est l’article Understanding LSTM Networks (en anglais), et la documentation Keras décrit la couche LSTM.
Notre réseau est volontairement simple : une couche LSTM de 100 neurones, une couche Dropout qui éteint au hasard 20 % des neurones pendant l’entraînement pour limiter le surapprentissage, et une couche Dense à un seul neurone qui renvoie la prédiction.
Construction du modèle
Avec Keras 3, on déclare la forme des entrées avec keras.Input (au lieu de l’ancien paramètre input_shape de la couche LSTM) et on fusionne Dense et Activation en une seule couche :
def build_lstm_model(input_data, output_size, neurons=100, activ_func='linear',
                     dropout=0.2, loss='mse', optimizer='adam'):
    model = keras.Sequential([
        keras.Input(shape=(input_data.shape[1], input_data.shape[2])),
        layers.LSTM(neurons),
        layers.Dropout(dropout),
        layers.Dense(units=output_size, activation=activ_func),
    ])
    model.compile(loss=loss, optimizer=optimizer)
return modelParamètres du modèle
keras.utils.set_random_seed(42) fixe les graines aléatoires de Python, NumPy et Keras, pour obtenir les mêmes résultats à chaque exécution sur la même machine. Sur une autre machine (ou avec un GPU), les chiffres peuvent différer légèrement.
keras.utils.set_random_seed(42)

window_len = 5
test_size = 0.2
zero_base = True
lstm_neurons = 100
epochs = 20
batch_size = 32
loss = 'mse'
dropout = 0.2
optimizer = 'adam'Entraînement du modèle
On prépare les données, on construit le modèle et on affiche sa structure avec model.summary() : il contient 42 501 paramètres à ajuster.
train, test, X_train, X_test, y_train, y_test = prepare_data(
    hist, target_col, window_len=window_len, zero_base=zero_base, test_size=test_size)
print(X_train.shape, y_train.shape)
print(X_test.shape, y_test.shape)

model = build_lstm_model(X_train, output_size=1, neurons=lstm_neurons,
                         dropout=dropout, loss=loss, optimizer=optimizer)
model.summary()(1691, 5, 5) (1691,)
(419, 5, 5) (419,)
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type) ┃ Output Shape ┃ Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ lstm (LSTM) │ (None, 100) │ 42,400 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout (Dropout) │ (None, 100) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense (Dense) │ (None, 1) │ 101 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
Total params: 42,501 (166.02 KB)
Trainable params: 42,501 (166.02 KB)
Non-trainable params: 0 (0.00 B)On entraîne ensuite le réseau pendant 20 époques, par lots de 32 fenêtres. Avec shuffle=True, Keras mélange les fenêtres à chaque époque : c’est sans danger ici, car chaque fenêtre contient déjà tout son contexte temporel.
history = model.fit(X_train, y_train, epochs=epochs, batch_size=batch_size,
verbose=2, shuffle=True)Epoch 1/20
53/53 - 2s - 31ms/step - loss: 0.0036
Epoch 2/20
53/53 - 0s - 5ms/step - loss: 0.0024
Epoch 3/20
53/53 - 0s - 5ms/step - loss: 0.0019
Epoch 4/20
53/53 - 0s - 5ms/step - loss: 0.0017
Epoch 5/20
53/53 - 0s - 6ms/step - loss: 0.0015
Epoch 6/20
53/53 - 0s - 6ms/step - loss: 0.0013
Epoch 7/20
53/53 - 0s - 6ms/step - loss: 0.0013
Epoch 8/20
53/53 - 0s - 4ms/step - loss: 0.0012
Epoch 9/20
53/53 - 0s - 6ms/step - loss: 0.0012
Epoch 10/20
53/53 - 0s - 5ms/step - loss: 0.0012
Epoch 11/20
53/53 - 0s - 6ms/step - loss: 0.0011
Epoch 12/20
53/53 - 0s - 4ms/step - loss: 0.0011
Epoch 13/20
53/53 - 0s - 5ms/step - loss: 0.0011
Epoch 14/20
53/53 - 0s - 5ms/step - loss: 0.0011
Epoch 15/20
53/53 - 0s - 5ms/step - loss: 0.0011
Epoch 16/20
53/53 - 0s - 6ms/step - loss: 0.0011
Epoch 17/20
53/53 - 0s - 5ms/step - loss: 0.0010
Epoch 18/20
53/53 - 0s - 5ms/step - loss: 0.0010
Epoch 19/20
53/53 - 0s - 5ms/step - loss: 0.0010
Epoch 20/20
53/53 - 0s - 7ms/step - loss: 0.0010L’erreur d’entraînement (MSE) passe de 0,0036 à 0,0010 : le réseau apprend. Voici la courbe :
fig, ax = plt.subplots(figsize=(10, 5))
ax.plot(range(1, epochs + 1), history.history['loss'], linewidth=2)
ax.set_xticks(range(1, epochs + 1, 2))
ax.set_xlabel('époque', fontsize=14)
ax.set_ylabel('erreur quadratique moyenne (MSE)', fontsize=14)
ax.set_title("Évolution de l'erreur pendant l'entraînement", fontsize=16)
plt.show()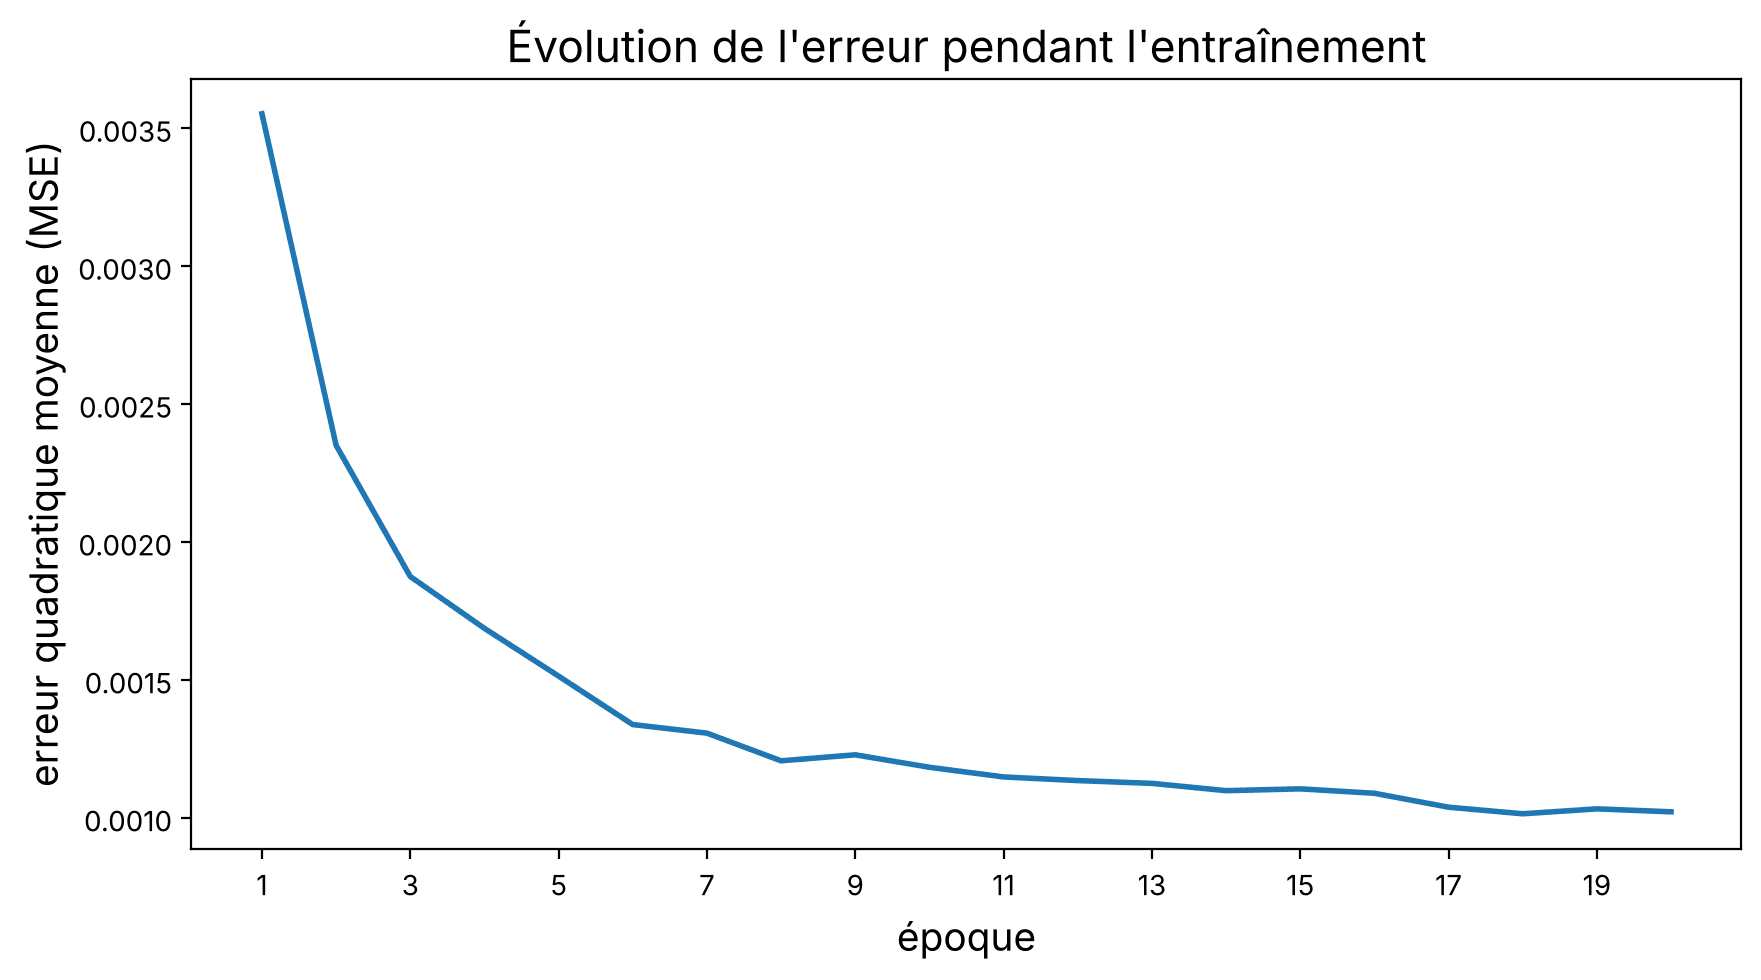
Le LSTM prédit-il bien le prix du Bitcoin ?
Pour évaluer le modèle, on utilise l’erreur absolue moyenne (MAE, Mean Absolute Error) : la moyenne des écarts entre la valeur réelle et la prédiction, sans tenir compte du signe. Plus elle est faible, meilleur est le modèle.
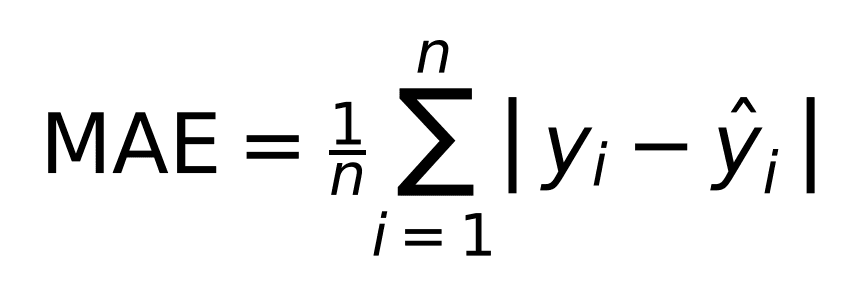
On prédit sur la période de test puis on calcule la MAE sur les variations relatives, celles que le réseau manipule :
targets = test[target_col][window_len:]
preds = model.predict(X_test, verbose=0).squeeze()
print(mean_absolute_error(y_test, preds))0.016369861096066154L’écart moyen est de 0,016 : le réseau se trompe en moyenne de 1,6 % du prix du premier jour de la fenêtre. C’est plus parlant en euros. On reconstitue donc les prix prédits en inversant la normalisation, puis on trace la prédiction contre le prix réel :
preds = test[target_col].values[:-window_len] * (preds + 1)
preds = pd.Series(index=targets.index, data=preds)
line_plot(targets, preds, 'réel', 'prédiction', title='Bitcoin (BTC/EUR) : prix réel et prédit sur la période de test', lw=3)
plt.show()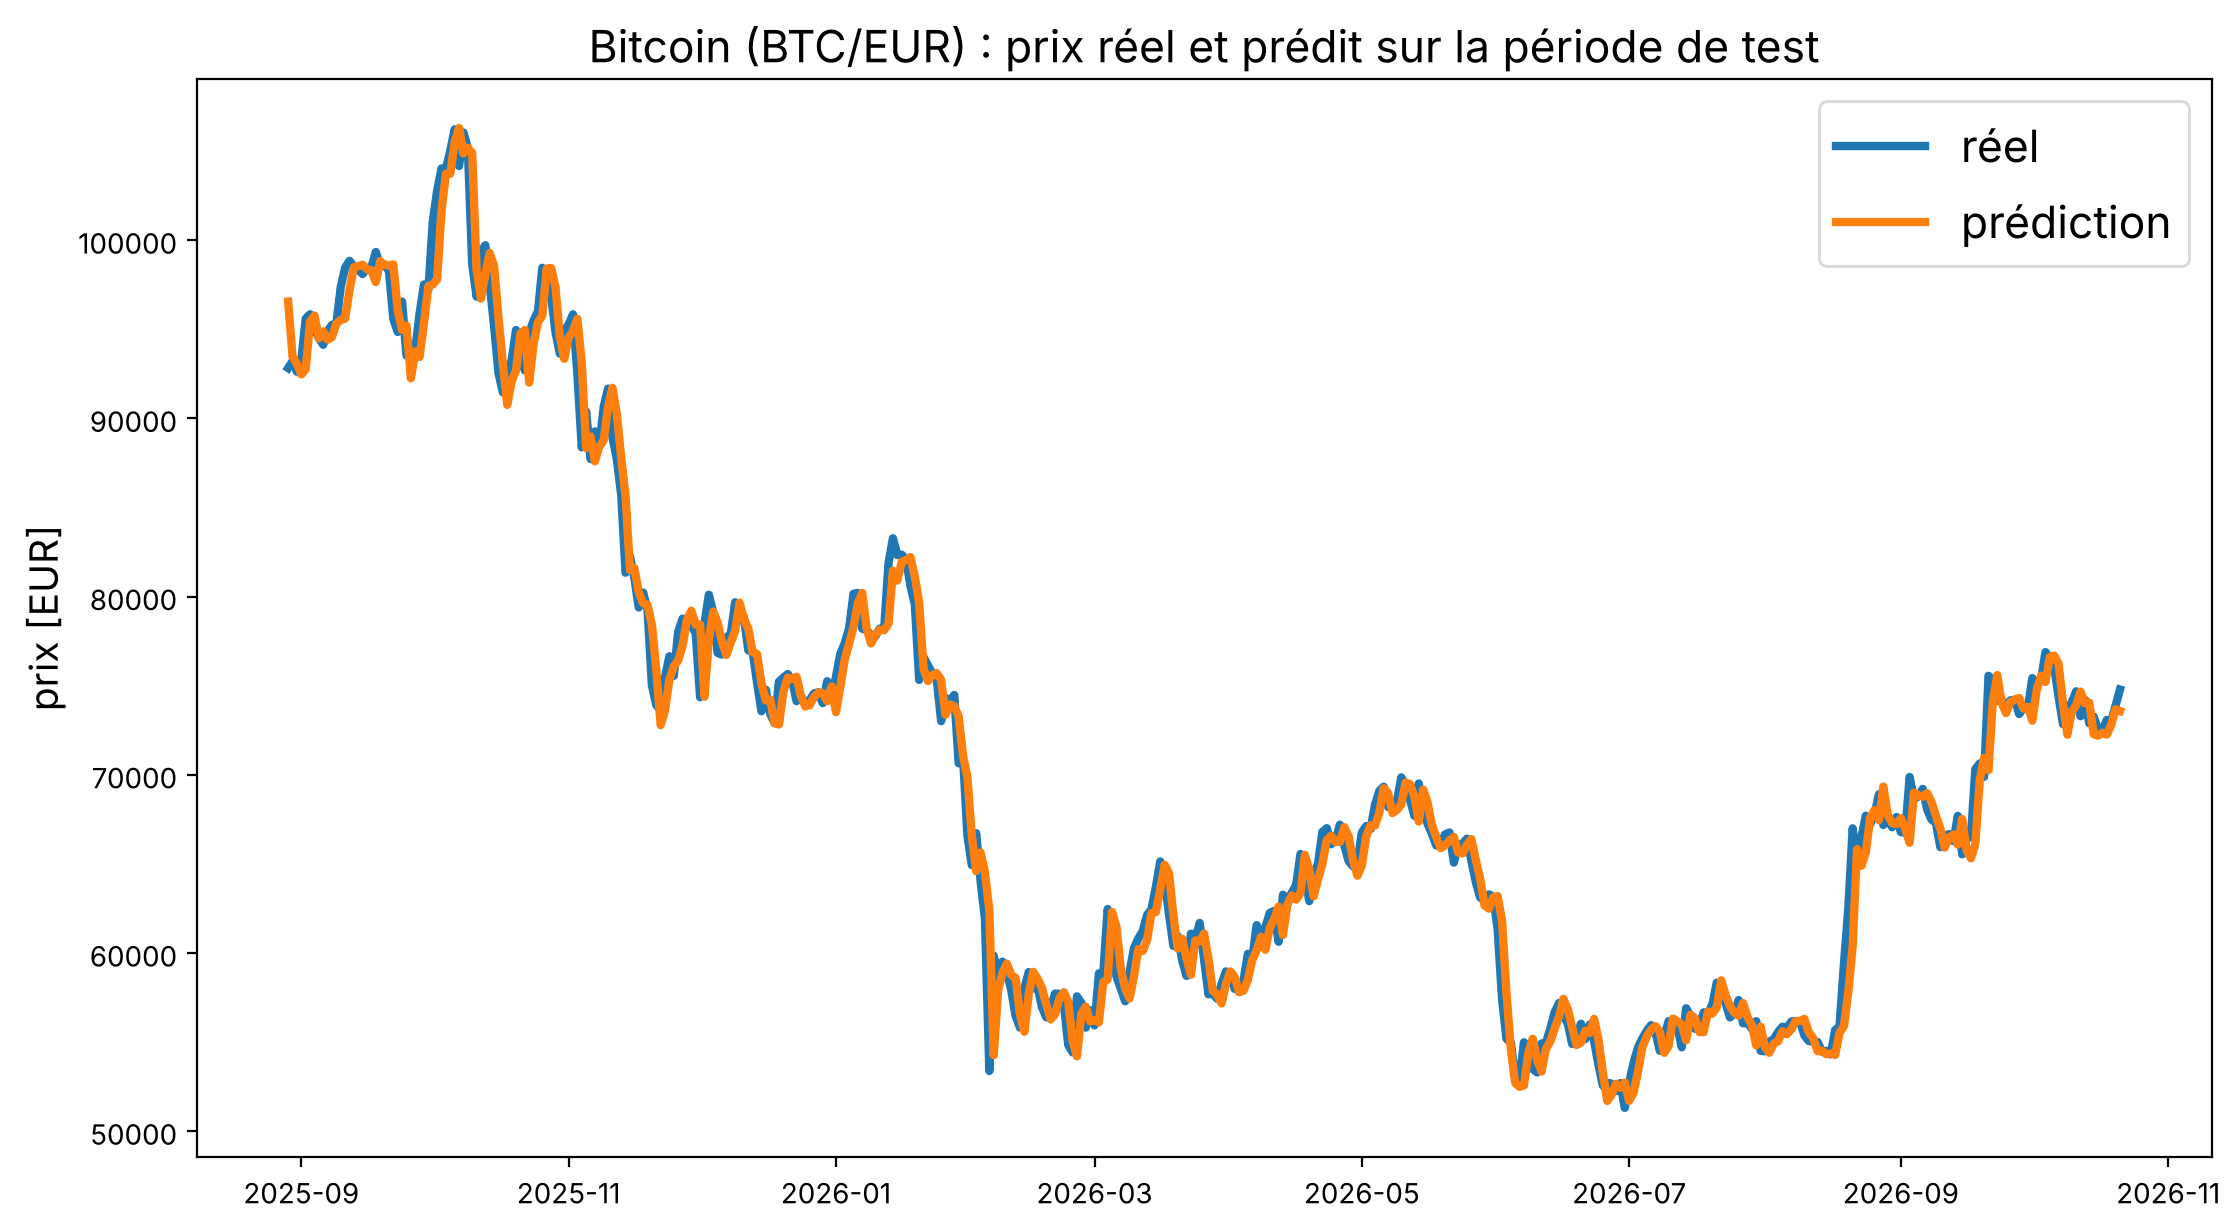
Le résultat paraît excellent : les deux courbes se superposent presque partout. Mais ce graphique est trompeur, et c’est le plus important à retenir de cet article.
La comparaison qui change tout : la référence naïve
Le prix du Bitcoin varie de quelques pour cent d’un jour à l’autre, alors qu’il s’étend sur une plage de plus de 50 000 € sur la période de test. Sur un graphique à cette échelle, n’importe quelle courbe proche du prix de la veille a l’air parfaite. Calculons l’erreur en euros du LSTM, puis celle d’une référence naïve qui prédit simplement que le prix de demain sera celui d’aujourd’hui :
print(f"MAE du LSTM : {mean_absolute_error(targets, preds):,.0f} EUR")MAE du LSTM : 1,157 EURveille = test[target_col].shift(1)[window_len:] # prix de la veille
print(f"MAE de la référence naïve : {mean_absolute_error(targets, veille):,.0f} EUR")MAE de la référence naïve : 1,083 EURLe LSTM se trompe en moyenne de 1 157 € par jour, contre 1 083 € pour la règle « demain = aujourd’hui » : notre réseau fait un peu moins bien qu’une règle qui ne demande aucun entraînement. Voyons s’il devine au moins le sens de variation du prix (hausse ou baisse par rapport à la veille) :
vrai_sens = np.sign(targets - veille)
pred_sens = np.sign(preds - veille)
print(f"Sens de variation correctement prédit : {(vrai_sens == pred_sens).mean():.1%}")Sens de variation correctement prédit : 48.9%48,9 %, soit à peu près autant que pile ou face (49,9 % des jours de la période de test sont des jours de hausse). Un zoom sur les 45 derniers jours montre ce qui se passe :
fin = targets.index[-45:]   # les 45 derniers jours
fig, ax = plt.subplots(figsize=(13, 7))
ax.plot(targets[fin], label='réel', linewidth=3)
ax.plot(preds[fin], label='prédiction du LSTM', linewidth=3)
ax.plot(veille[fin], label='prix de la veille', linewidth=2, linestyle='--', color='gray')
ax.set_ylabel('prix [EUR]', fontsize=14)
ax.set_title('Zoom sur les 45 derniers jours', fontsize=16)
ax.legend(loc='best', fontsize=16)
plt.show()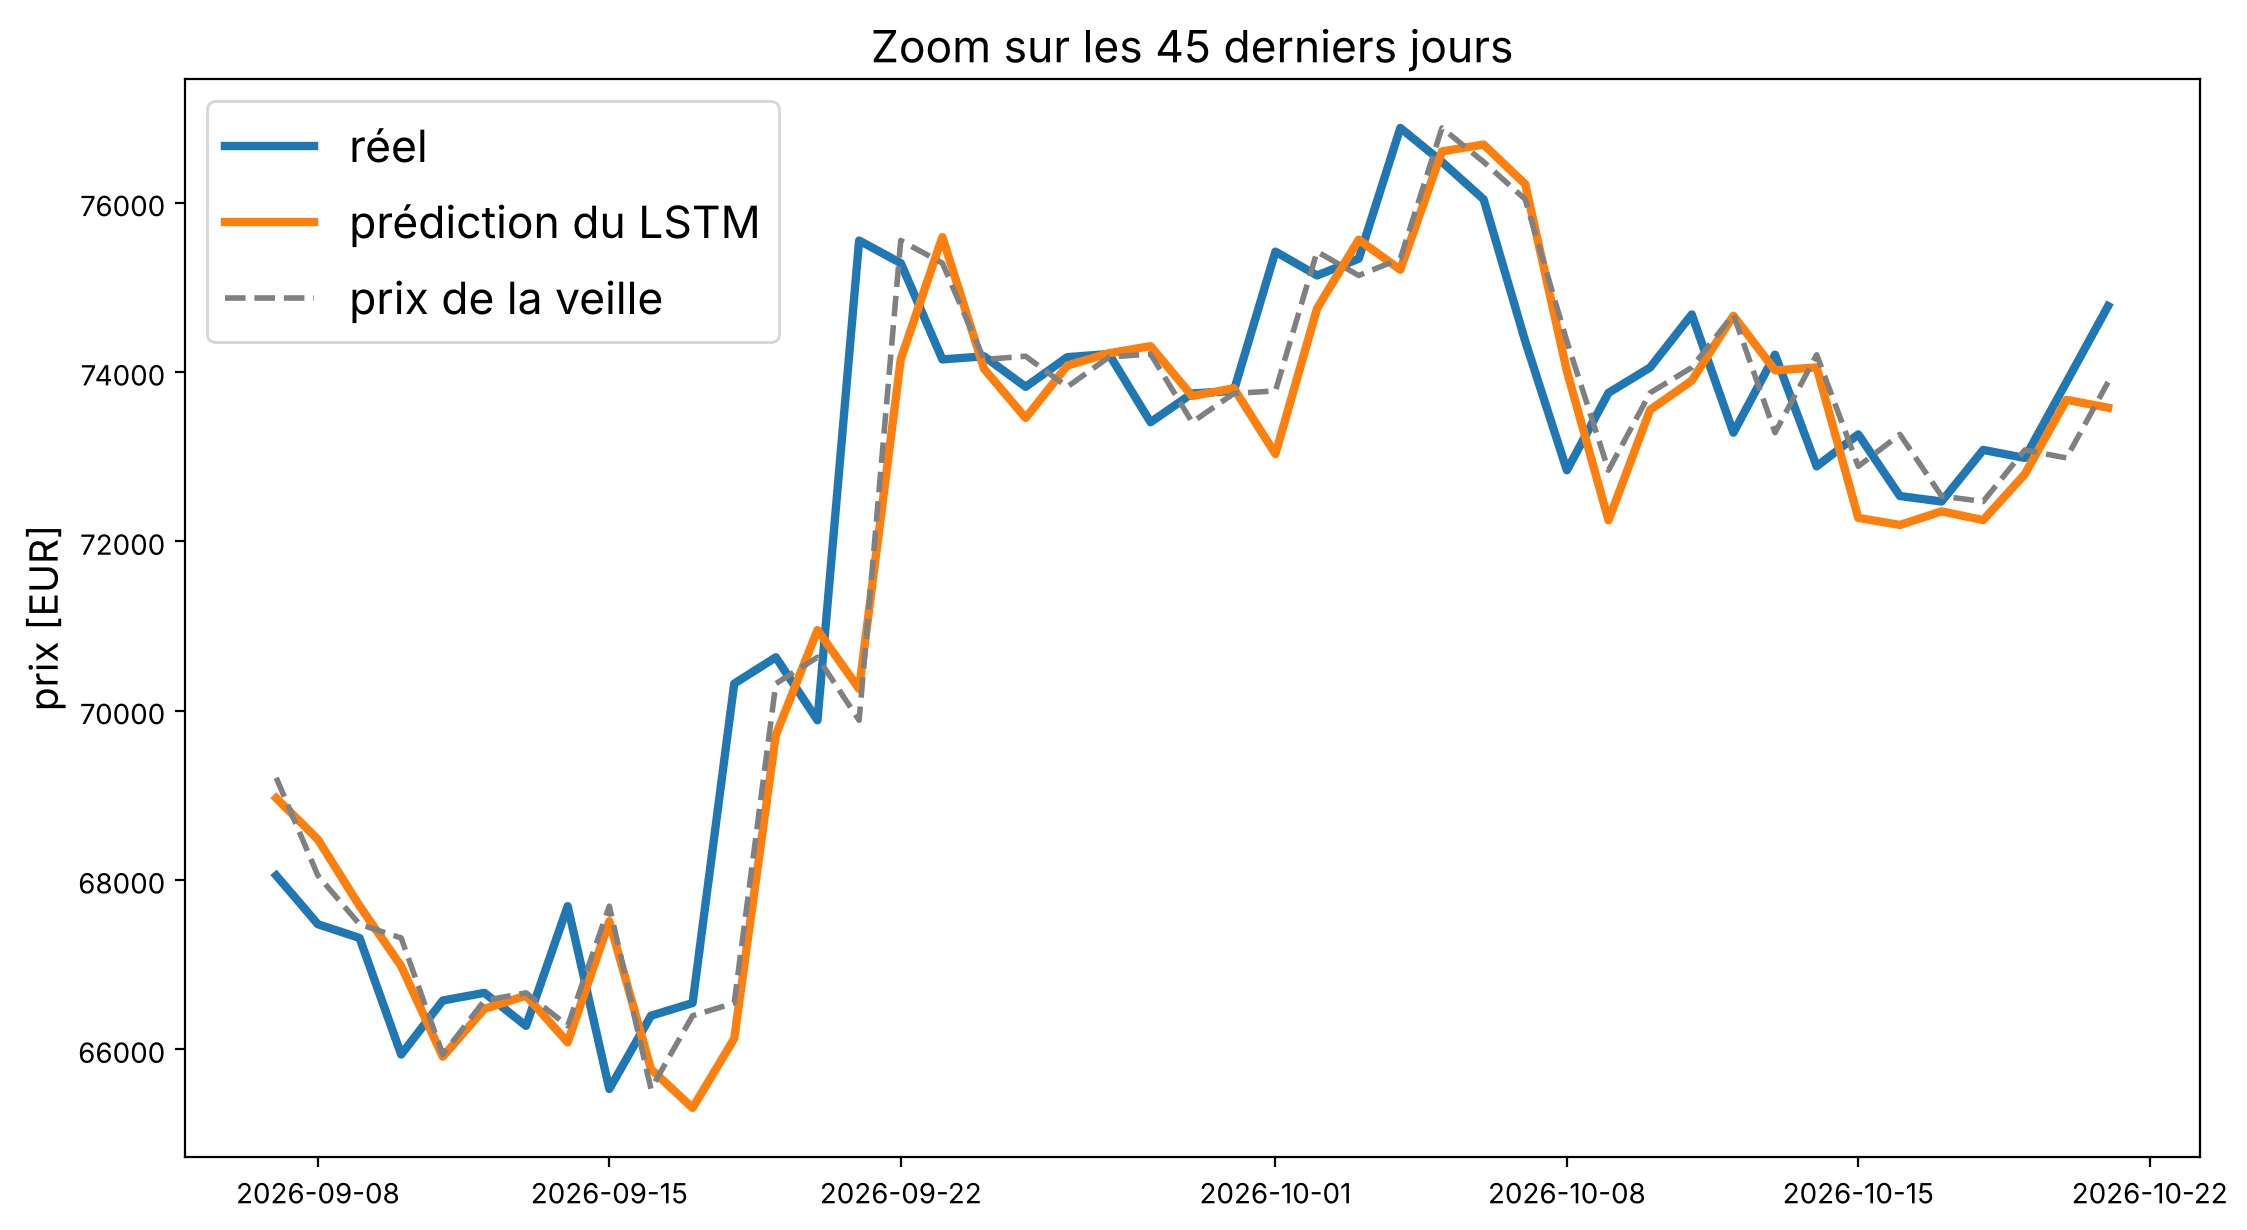
La prédiction (en orange) reproduit en grande partie la courbe grise en pointillés, celle du prix de la veille : le réseau a surtout appris à recopier le dernier prix connu, avec un jour de retard sur les variations brusques, sans anticiper les mouvements du lendemain.
Le résultat dépend-il de la graine aléatoire ?
L’entraînement d’un réseau de neurones contient une part de hasard. Pour vérifier que ce constat n’est pas dû à une graine malchanceuse, on relance tout l’entraînement avec cinq autres graines :
for seed in range(5):
    keras.utils.set_random_seed(seed)
    m = build_lstm_model(X_train, output_size=1, neurons=lstm_neurons, dropout=dropout)
    m.fit(X_train, y_train, epochs=epochs, batch_size=batch_size, verbose=0, shuffle=True)
    p = test[target_col].values[:-window_len] * (m.predict(X_test, verbose=0).squeeze() + 1)
    sens = (np.sign(targets - veille) == np.sign(p - veille)).mean()
print(f"graine {seed} : MAE = {mean_absolute_error(targets, p):,.0f} EUR | sens correct : {sens:.1%}")graine 0 : MAE = 1,246 EUR | sens correct : 50.6%
graine 1 : MAE = 1,130 EUR | sens correct : 53.0%
graine 2 : MAE = 1,095 EUR | sens correct : 49.9%
graine 3 : MAE = 1,151 EUR | sens correct : 50.1%
graine 4 : MAE = 1,105 EUR | sens correct : 50.1%Les résultats varient, mais aucune des cinq graines ne bat la référence naïve (1 083 €), et le sens de variation reste proche de 50 %. Le constat tient.
Comment améliorer le modèle ?
Ce résultat n’est pas une raison d’abandonner le Deep Learning sur les séries temporelles : c’est le point de départ d’un vrai travail de modélisation. Voici des pistes à tester, en gardant la référence naïve comme juge :
- Changer la cible : prédire le rendement du jour (la variation en %) plutôt que le prix. Le « retard d’un jour » disparaît du graphique, et on voit enfin ce que le modèle sait vraiment faire.
- Valider autrement : une seule coupure 80/20 donne un seul résultat. La validation « walk-forward » (on réentraîne sur des périodes successives) est plus fiable pour une série temporelle.
- Enrichir les variables : moyennes mobiles, volatilité, autres crypto monnaies, indicateurs de marché.
- Régler les hyperparamètres : longueur de la fenêtre, nombre de neurones, époques, ou tester un GRU, un réseau convolutif 1D ou un modèle statistique comme l’ARIMA.
- Prédire plusieurs jours au lieu d’un seul.
Dans tous les cas, ce type de modèle sert à apprendre et à explorer, pas à décider d’un achat ou d’une vente : les prix des crypto monnaies dépendent de bien plus que de leur historique récent.
Questions fréquentes
Peut-on prédire le prix du Bitcoin avec le Deep Learning ?
Pas de façon fiable avec ce type de modèle. Sur 419 jours de test, notre LSTM fait moins bien que la règle « demain = aujourd’hui » et devine le sens de variation du prix dans moins de la moitié des cas. Les modèles de Deep Learning peuvent servir à explorer des séries temporelles, mais le prix d’une crypto monnaie à un jour reste très proche d’un hasard.
Pourquoi la courbe prédite colle-t-elle autant au prix réel ?
Parce que le prix change peu d’un jour à l’autre par rapport à son niveau. Un modèle qui recopie le prix de la veille produit déjà une courbe quasi superposée à la courbe réelle. Pour juger un modèle de prévision, compare son erreur à celle de cette référence naïve et regarde un zoom sur quelques semaines plutôt que la courbe entière.
Pourquoi ne pas mélanger les données avant de les découper ?
Dans une série temporelle, un découpage aléatoire place dans l’entraînement des jours qui encadrent ceux du test : le modèle « connaît » donc l’avenir de chaque jour à prédire, et son score est artificiellement bon. On coupe toujours à une date : le passé pour entraîner, le futur pour tester.
Pourquoi normaliser chaque fenêtre par rapport à son premier jour ?
Cette normalisation (appelée zero-base dans le code) transforme les prix en variations relatives. Le réseau n’a plus à gérer des niveaux de prix très différents (20 000 € en 2022, plus de 100 000 € en 2025) : il apprend des formes de variation, valables quel que soit le niveau du prix.
Quelles données utiliser maintenant que l’API CryptoCompare demande une clé ?
L’ancienne version de cet article utilisait CryptoCompare, dont l’API nécessite aujourd’hui une clé. Dans cette version, on utilise le fichier de cours journaliers hébergé sur GitHub, et la fonction telecharger_btc_eur() qui récupère des données à jour depuis l’API publique de Binance, sans clé. Beaucoup d’autres plateformes proposent aussi des historiques gratuits, avec leurs propres conditions d’utilisation.
Conclusion
Tu sais maintenant préparer une série temporelle en fenêtres glissantes, construire un réseau LSTM avec Keras 3 et l’entraîner. Surtout, tu as vu pourquoi il faut comparer un modèle à une référence naïve avant de se féliciter d’une jolie courbe : ici, le réseau n’apporte rien par rapport à « demain = aujourd’hui ». Pour continuer, essaie de prédire le rendement journalier plutôt que le prix, et vérifie si le LSTM bat enfin la référence.
Un modèle qui a l’air bon n’est pas un modèle qui bat la référence. Sur DataXp, tu t’entraînes à ces réflexes d’évaluation en passant de Python et pandas au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin :
Bonjour Rod, merci pour ton article… J’ai une petite question comment dimensionner la fenêtre de prédiction une fois le modèle entrainé à partir des nouvelles données d’entrainement ? Merci d’avance. NB : Si on peut s’inscrire à un cours que tu dispenses alors je suis preneur ; ))
Hello Cyril, je suis pas sûr de comprendre ta question. Quelles nouvelles données d’entraînement ?
Merci beaucoup pour cet article, c’est très bien expliqué ! Je suis un peu débutant sur ce sujet et en lançant votre code je remarque que il n’y a que 13 échantillons traités pour chaque epoch. Auriez-vous une idée de la raison de ce petit problème ?
Hello Hugo,
“13 échantillons traités pour chaque epoch”, c’est à dire ? (je suis pas sûr de bien comprendre ton problème)
Bonjour, merci d’avoir pris le temps d’expliquer en détails ta manière de procéder ! J’ai une question par rapport à la fin lors que tu utilises :
preds = test[target_col].values[:-window_len] * (preds + 1)
Pourquoi te bases-tu sur :
test[target_col].values
Si on souhaite utiliser le modèle pour prédire l’évolution de la courbe du mois prochain, il n’est pas possible d’assigner cette valeur en utilisant “test[target_col]” étant donné qu’il nous est inconnu à l’instant t.
Par quoi test[target_col] doit-il être remplacé ?
Dans cet article, je souhaite construire un modèle et tester ses performances. D’où l’affichage actual vs. predictions.
Pour une prédiction sur le futur, tu le fais jour par jour, en prenant la valeur à l’ouverture égale à la valeur à la clôture de la veille. Et tu boucles tout ça, sur une fenêtre de temps 🙂
Bonjour, tout d’abord, merci pour votre code, il est très clair 🙂
J’avais une petite question sur la suite des choses, ici on entraine notre algorithme pour qu’il puisse prévoir le prix du bitcoin, puis on compare les données obtenue aux données réelles. Mais comment passer à l’étape supérieure et prédire pour de bon le prix du bitcoin demain par exemple ?
Je ne comprends pas comment appliquer l’algorithme entrainé à une situation réelle ? Dans le cas d’une situation réelle, à supposer que l’algorithme soit déjà bien entrainé, et sauvegardé (model.save()), nous n’aurions plus besoin de séparer les données en test et train mais d’utiliser toutes les données du passé ?
Tout à fait, si les performances du modèle te satisfont. Tu reprends ce même modèle de réseau de neurones. Et tu peux l’entraîner sur toutes les données disponibles (précédentes à la période à prédire) et prédire sur une petite fenêtre le prix d’une crypto.
Super, c’est plus clair dans ma tête maintenant 🙂 !
et merci pour ta réponse rapide ! Est-ce-que le fait de passer du test au “déploiement” (avec un modèle déjà bâti) à un nom particulier ? Je recherche sur internet depuis un quelques heures mais tous les tutos s’arrêtent à la comparaison entre la valeur initiale et la valeur prédite… Ou est-ce-que vous avez peut-être un chapitre dédié dans la formation ?
Pour le nom, je ne sais pas. On utilise un modèle entrainé pour faire des prédictions à partir de données nouvelles (et inconnues).
A noter que sur l’exemple précédent, les données sont des séries temporelles donc c’est un peu particulier.
Dans le cours de Deep Learning, on applique justement nos modèles à des données inconnues pour faire une prédiction. Mais celui de Machine Learning, on s’arrête simplement à la construction des modèles from scratch pour vraiment comprendre ce qui se passe à l’intérieur (sans utiliser toutes les bibliothèques pré-codées).
Mais le prochain cours de Data Science / Machine Learning en préparation traitera ce point 🙂 (mais il est pas prévu pour tout de suite, il devrait tourner autour de 50 heures de contenu :D)
Bonne journée à toi !
Super, merci de ta réponse, bonne journée à toi aussi !
Merci beaucoup pour ton code, ça m’a permis de comprendre beaucoup plus facilement le machine learning, avec un cas concret, il est simplifié et très bien expliqué :).
J’ai juste dû rajouter deux petites lignes de codes pour supprimer les deux dernières “colonnes” du dataframe :
del hist[‘conversionType’]
del hist[‘conversionSymbol’]
En effet, les deux dernières “colonnes” du df sont de type string
et ça donnait une erreur lors de la normalisation.
Bien vu pour les 2 colonnes string 🙂
L’API a un peu changé depuis l’écriture de ce tuto, et effectivement 2 colonnes string se sont ajoutés ^^ je vais corriger le code juste avant hist.head(5) comme ça tout le reste reste inchangé.
Merci à toi !