
Cet article te donne un aperçu des réseaux de neurones et de leurs concepts fondamentaux.
En bref : un réseau de neurones est un ensemble d’algorithmes mathématiques, inspiré des neurones biologiques, qui calcule une sortie à partir de données d’entrée. Il est composé de neurones répartis en couches (entrée, cachées, sortie), de poids et de biais, et de fonctions d’activation. Il apprend par rétro-propagation : l’erreur est renvoyée de la couche de sortie vers la couche d’entrée pour corriger les poids et les biais.
J’y réponds avec toi aux questions suivantes :
- Qu’est-ce qu’un réseau de neurones ?
- Quelles sont ses principales composantes ?
- Comment fonctionne-t-il ?
- Qu’est-ce qu’une fonction d’activation ?
- Qu’est-ce que la rétro-propagation ?
- Quels sont les différents types de réseaux de neurones ?
Pour passer de la théorie à la pratique, tu peux t’entraîner à coder des algorithmes de Machine Learning sur DataXp : des exercices pratiques et un coach IA t’accompagnent, et les premiers modules sont gratuits.
Qu’est-ce qu’un réseau de neurones ?
Le réseau de neurones est avant tout un concept : rien de physique là-dedans. Les réseaux de neurones artificiels (Artificial Neural Networks, ANN) sont inspirés des neurones biologiques.
Dans un réseau de neurones biologique, plusieurs neurones travaillent ensemble : ils reçoivent des signaux d’entrée, traitent l’information et déclenchent un signal de sortie.
Quelle différence entre un neurone biologique et un neurone artificiel ?
Les deux fonctionnent selon le même principe général :
- Neurone biologique : il reçoit des signaux par ses dendrites, les traite dans le corps cellulaire, puis transmet un signal par son axone si l’excitation est suffisante.
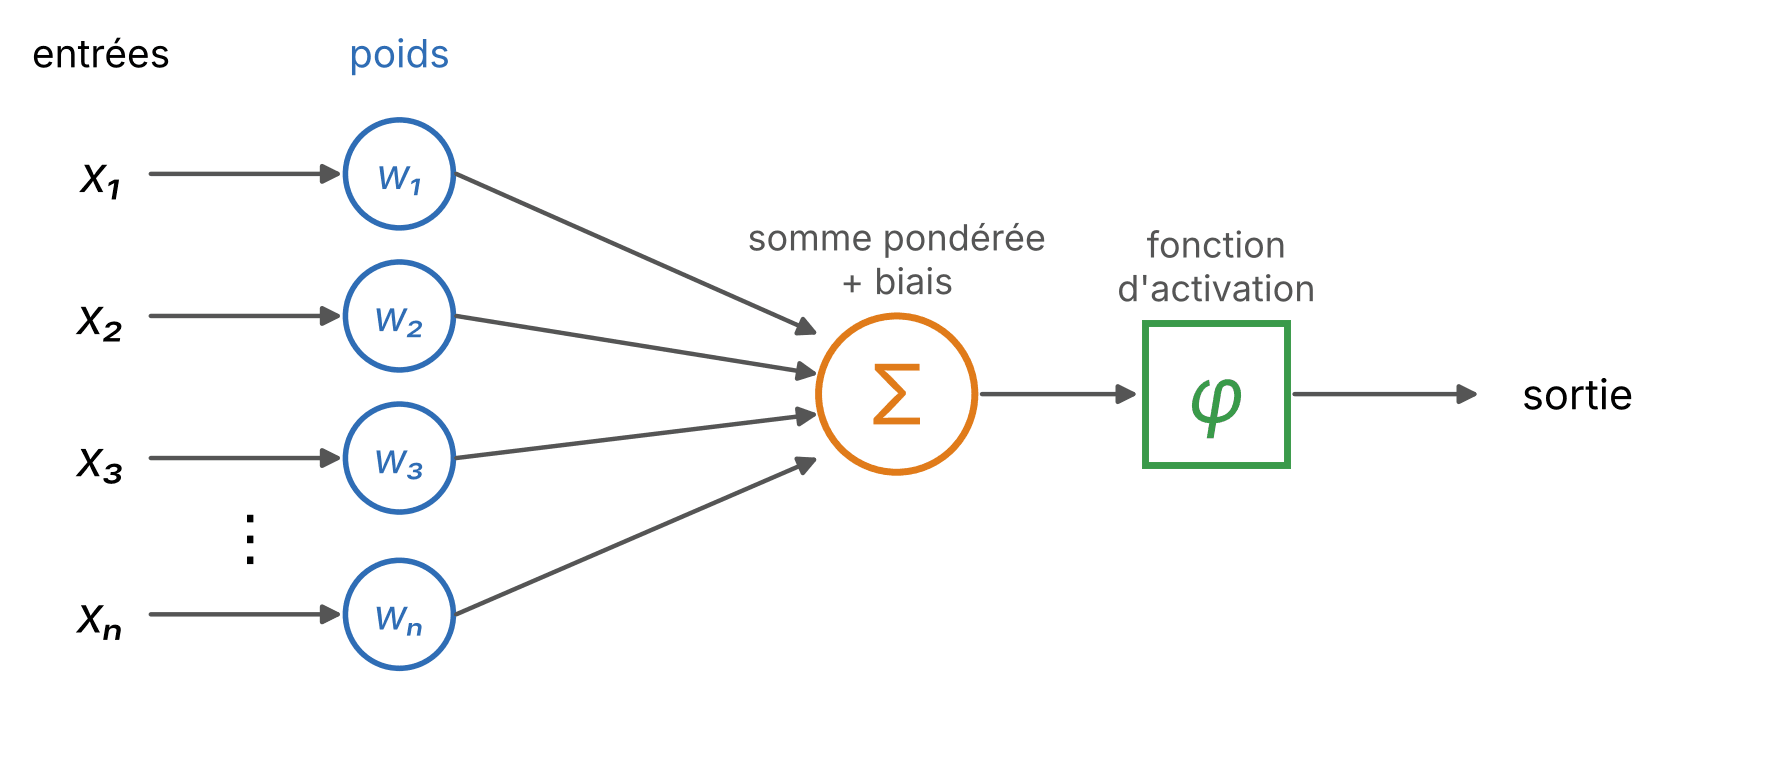
- Neurone artificiel : il reçoit des valeurs d’entrée, les multiplie par des poids, les additionne, puis applique une fonction d’activation pour produire une valeur de sortie.
Les réseaux de neurones tirent profit des expériences passées.
Comment fonctionne un réseau de neurones d’intelligence artificielle ?
Le réseau de neurones d’intelligence artificielle s’inspire du même modèle que le réseau de neurones biologique.
Même si le concept est le même, un réseau de neurones d’IA est un ensemble d’algorithmes mathématiques qui produisent une donnée de sortie (output) à partir de données d’entrée (input).
Ces algorithmes peuvent être regroupés pour produire les résultats souhaités.
Dans un réseau de neurones d’IA, plusieurs algorithmes travaillent ensemble pour effectuer des calculs sur les données d’entrée et produire une donnée de sortie. Cette sortie sert aussi à l’apprentissage : elle permet au réseau d’améliorer sa précision.
Un réseau de neurones est entraîné avec de nombreuses données d’entrée, chacune associée à sa donnée de sortie attendue. Il calcule sa propre sortie, la compare à la sortie réelle connue, puis se met à jour pour améliorer ses résultats si nécessaire.
Les réseaux de neurones apprennent d’eux-mêmes
Au fil du temps, la comparaison entre la sortie calculée et la sortie attendue améliore la précision du modèle.
Les réseaux de neurones aident les machines à identifier des motifs, à reconnaître des images et à prévoir des séries chronologiques.
Les données d’entrée doivent être des nombres. Un texte, par exemple, est d’abord converti en valeurs numériques avant d’être transmis aux neurones de la couche d’entrée.
Quelles sont les principales composantes du réseau de neurones ?
Un réseau de neurones est composé de quatre éléments principaux : les neurones, les couches, les poids et biais, et les fonctions d’activation.
Qu’est-ce qu’un neurone ?
Un neurone prend une donnée d’entrée et produit une donnée de sortie. Les neurones sont regroupés en couches (layers), et tous les neurones d’une même couche remplissent une fonction similaire.
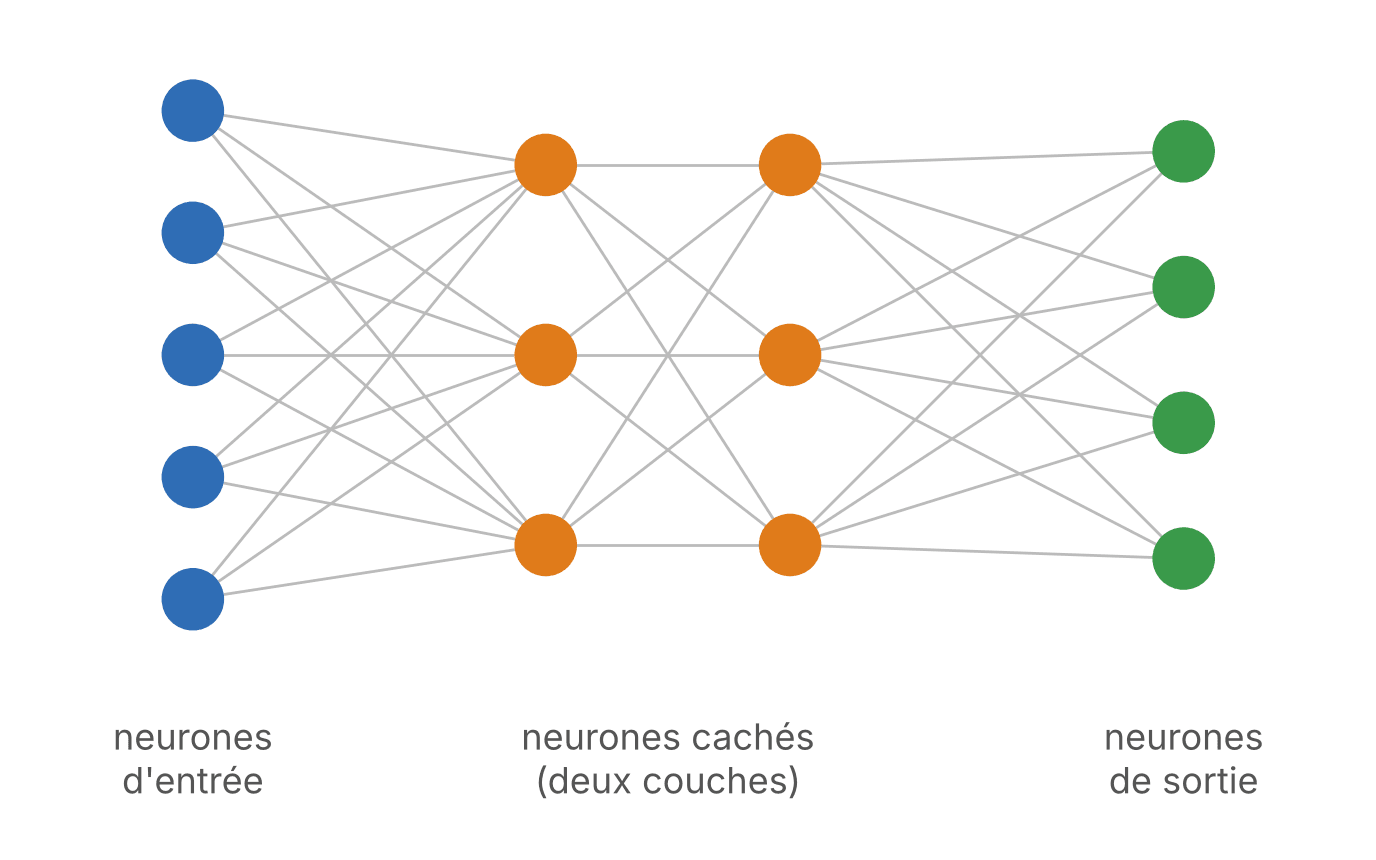
Les neurones d’entrée reçoivent les données, les traitent et les transmettent aux neurones de la couche suivante. Les neurones cachés prennent en entrée les sorties des neurones précédents, calculent de nouvelles sorties et les transmettent aux couches suivantes.
Dans un réseau de plus de trois couches (voir le schéma ci-dessus), les neurones de la dernière couche cachée (hidden layer) transmettent leurs sorties aux neurones de la couche de sortie (output layer). Ces derniers produisent alors les données de sortie finales.
Qu’est-ce qu’une couche de neurones ?
Les couches contiennent les neurones et font circuler l’information. Un réseau de neurones comporte au minimum deux couches : la couche d’entrée (input layer) et la couche de sortie (output layer).
Un réseau de neurones complexe peut avoir un très grand nombre de couches. Plus il y a de couches, plus le réseau est profond : c’est le deep learning.
Les couches autres que celles d’entrée et de sortie sont appelées les couches cachées (hidden layers).
Que sont les poids et les biais ?
Les poids et les biais sont les variables du modèle : ils sont mis à jour pendant l’entraînement pour améliorer la précision du réseau.
Un poids est associé à chaque connexion entre deux neurones. Il est multiplié par la valeur d’entrée pour calculer la sortie. Le réseau ajuste ces poids de manière continue, d’où une boucle de rétroaction dans la plupart des réseaux de neurones.
Le biais est une valeur numérique ajoutée à la somme des entrées pondérées. Les poids et les biais sont donc les valeurs que le réseau apprend par lui-même.
Considère le poids comme la donnée capitale d’un neurone.
Quel est le rôle de la fonction d’activation ?
Les fonctions d’activation transforment la sortie d’un neurone avant qu’elle ne soit transmise aux neurones suivants. En introduisant de la non-linéarité, elles permettent au réseau d’apprendre des relations complexes.
Le réseau de neurones est un concept d’apprentissage automatique inspiré du cerveau biologique.
Comment fonctionnent les réseaux de neurones ?
Le fonctionnement d’un réseau de neurones repose sur trois étapes principales :
- Pour chaque neurone d’une couche, multiplier chaque valeur d’entrée par son poids.
- Additionner ces valeurs pondérées, puis ajouter le biais.
- Appliquer la fonction d’activation à cette somme pour calculer la nouvelle sortie.
Comment un neurone calcule-t-il sa sortie ?
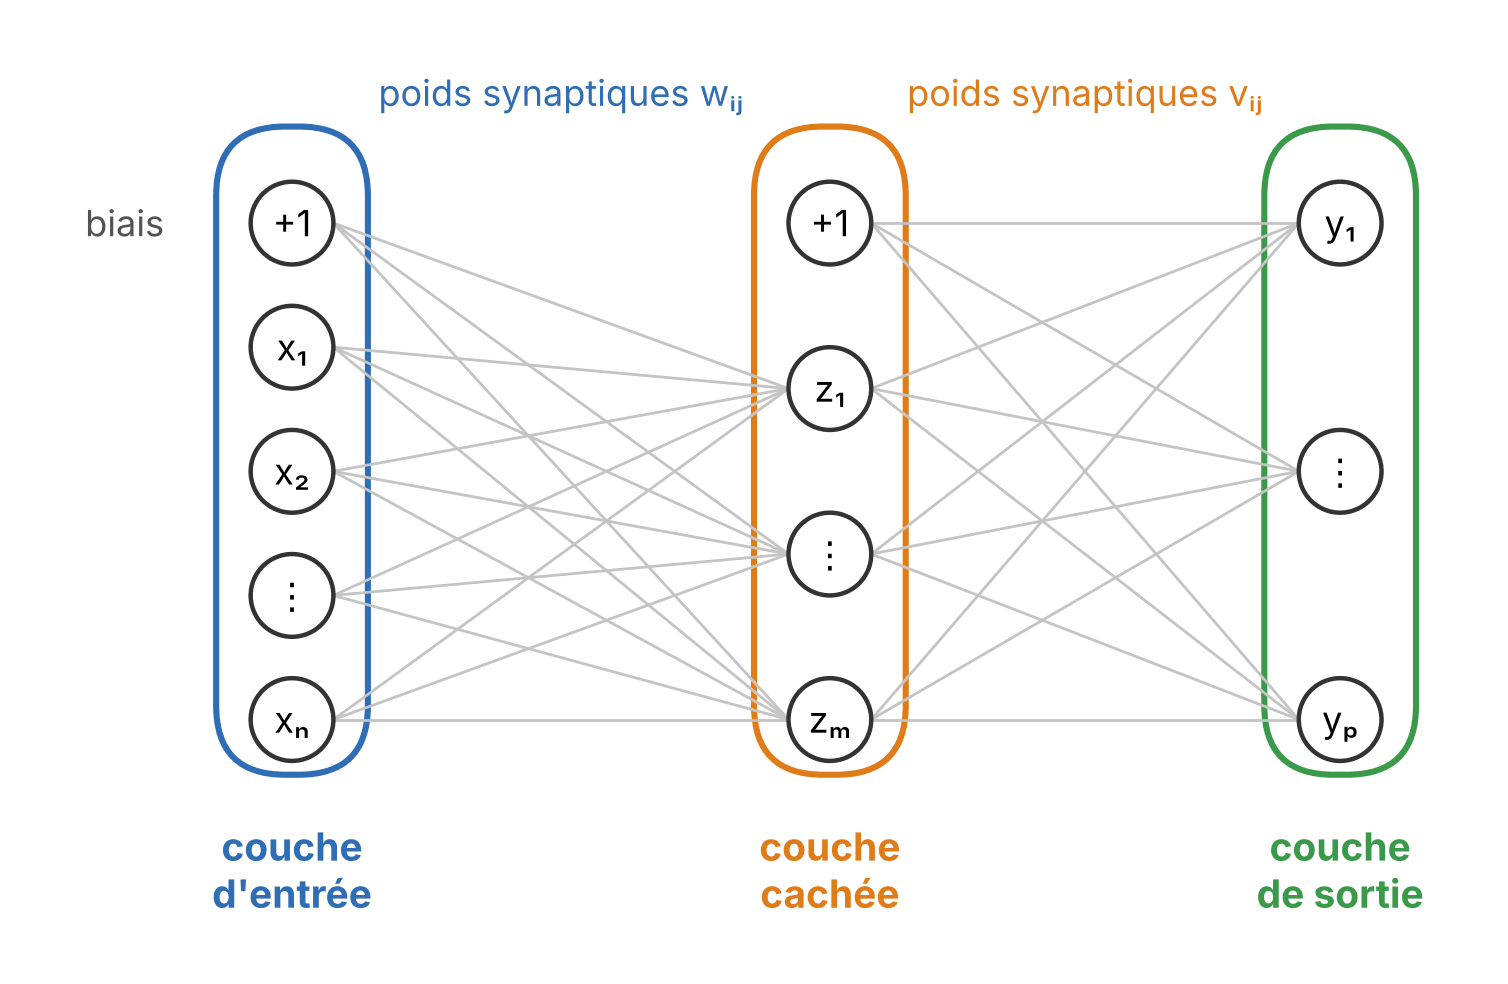
Notons X1, X2, …, Xn les n neurones de la couche d’entrée, Z1, …, Zm les m neurones de la couche cachée et Y1, …, Yp les p neurones de la couche de sortie. Le biais vaut 1 pour les couches d’entrée et cachée. Wij et Vij sont les poids synaptiques, respectivement entre la couche d’entrée et la couche cachée, et entre la couche cachée et la couche de sortie.
Chaque neurone Xn de la couche d’entrée (ainsi que le biais) est relié à chacun des m neurones de la couche cachée, et de même pour la couche suivante (voir le schéma ci-dessus). Pour obtenir la valeur de sortie d’un neurone :
- Chaque connexion est associée à un poids synaptique : lorsqu’une donnée entre dans un neurone, elle est multipliée par ce poids.
- On calcule la somme de ces produits, à laquelle on ajoute le biais.
- Une fonction d’activation (voir ci-dessous) est appliquée à cette somme pondérée. La valeur obtenue est ensuite transmise aux neurones de la couche suivante.
En notation mathématique, pour un neurone : sortie = f(w1·x1 + w2·x2 + … + wn·xn + b), où f est la fonction d’activation, w les poids, x les entrées et b le biais.
Qu’est-ce qu’une fonction d’activation ?
La fonction d’activation est une formule mathématique appliquée à la sortie d’un neurone. Une fois la somme pondérée des entrées plus le biais calculée, elle est transmise à la fonction d’activation. Dans sa version la plus simple, celle-ci vérifie si la valeur dépasse un seuil requis.
Si c’est le cas, le neurone est « activé » et une valeur de sortie est calculée.
Cette valeur est ensuite transmise à la couche suivante. Pendant l’entraînement, l’erreur qu’elle produit sert aussi à ajuster les poids des neurones.
Les fonctions d’activation introduisent de la non-linéarité dans les réseaux de neurones, ce qui est indispensable pour résoudre des problèmes complexes.
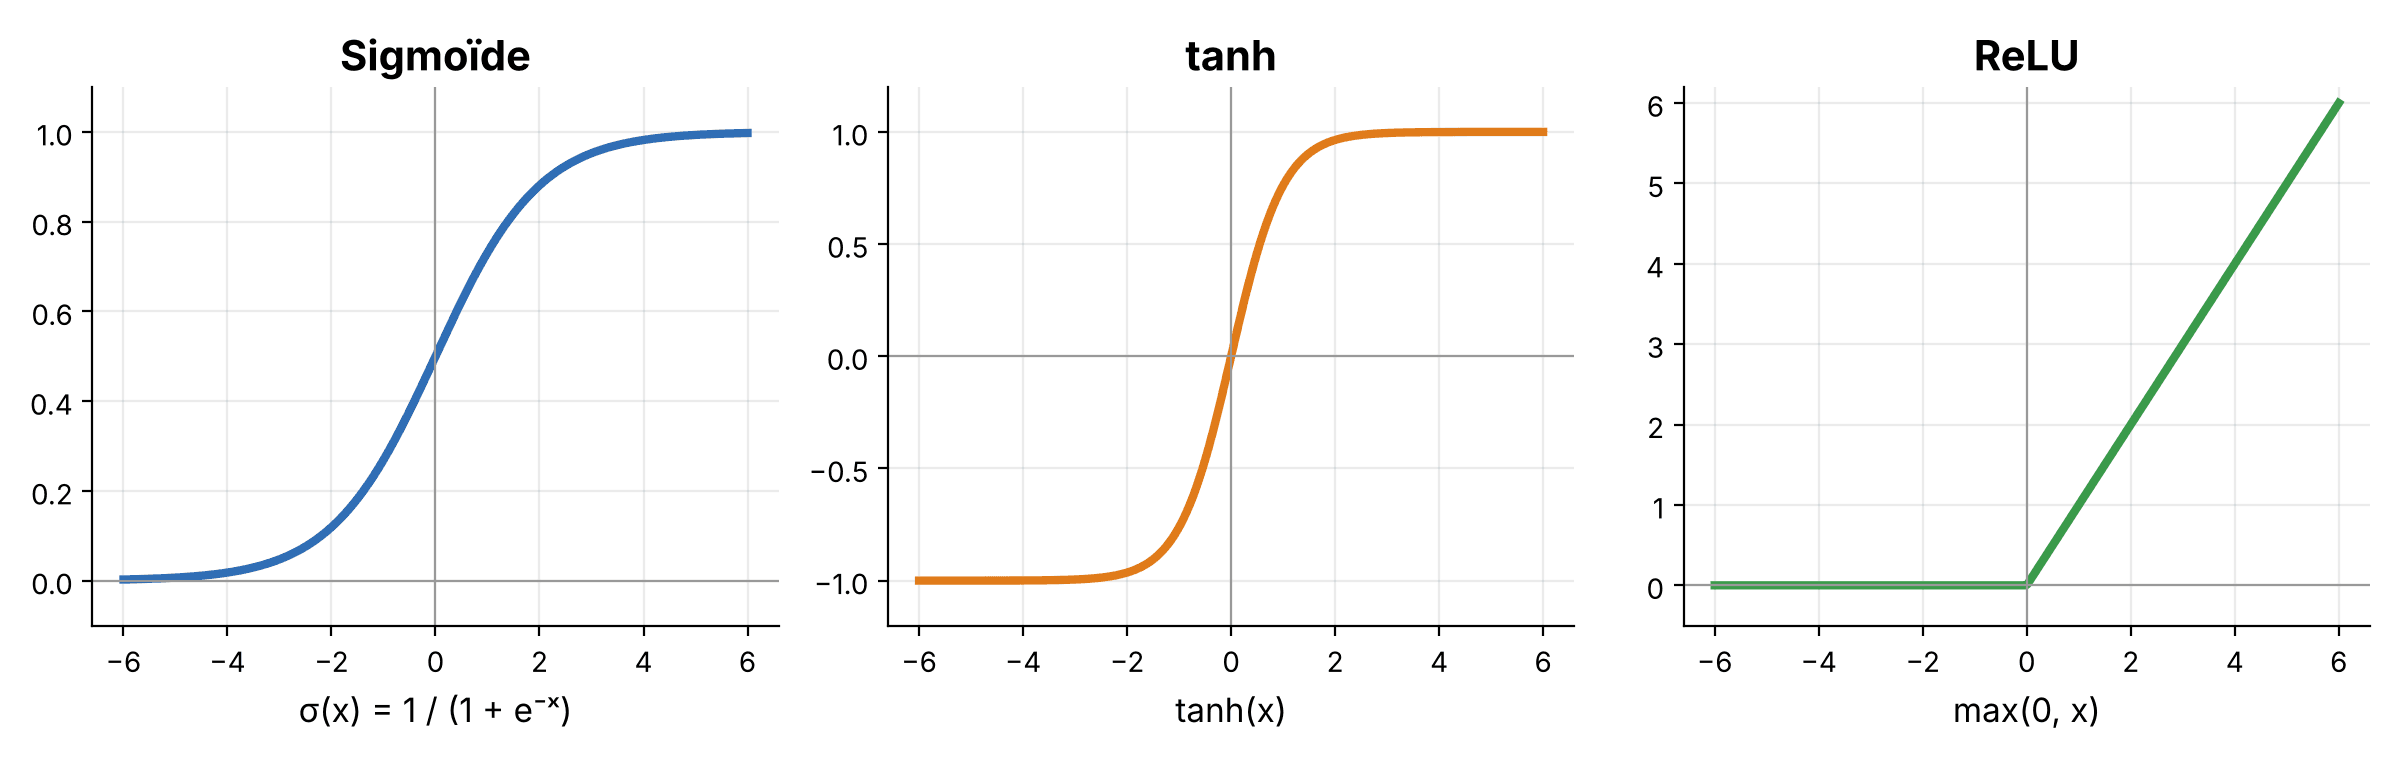
Si on trace les sorties non linéaires produites par ces fonctions, on obtient une courbe. La pente de cette courbe sert à calculer le gradient, qui indique comment la sortie varie quand une entrée change.
C’est à partir de ce gradient que les algorithmes sont optimisés et que les poids sont mis à jour.
Quelles sont les fonctions d’activation les plus courantes ?
Il existe de nombreuses fonctions d’activation. Voici les plus courantes :
- Sigmoïde : elle produit une courbe en forme de S et renvoie une valeur entre 0 et 1. Elle sature pour les valeurs d’entrée très grandes ou très petites, ce qui ralentit l’apprentissage.
- Tangente hyperbolique (tanh) : elle ressemble à la sigmoïde, mais renvoie une valeur entre -1 et 1, centrée sur 0. Elle sature aussi, mais converge en général mieux que la sigmoïde.
- Unité linéaire rectifiée (ReLU) : elle renvoie 0 pour les valeurs négatives et la valeur elle-même pour les valeurs positives. Elle converge plus rapidement et c’est de loin la fonction la plus utilisée dans les couches cachées des réseaux classiques ; les transformers utilisent plutôt des variantes plus douces, comme GELU.
- Softmax : utilisée dans la couche de sortie pour la classification, elle transforme les sorties en probabilités dont la somme vaut 1, c’est-à-dire une distribution catégorique.
Qu’est-ce que la rétro-propagation ?
La rétro-propagation (backpropagation) est le mécanisme qui permet aux réseaux de neurones d’améliorer leur précision.
Dans une application logicielle traditionnelle, les fonctions sont codées à l’avance : elles prennent des valeurs en entrée et produisent une sortie, mais les entrées ne modifient jamais les instructions.
Un réseau de neurones, lui, apprend et s’améliore.
Pendant l’entraînement, on lui fournit une série de valeurs d’entrée avec la sortie attendue correspondante. Les fonctions d’activation produisent alors une sortie à partir de ces entrées.
Rétro-propagation : aider le réseau de neurones à apprendre
Quand la sortie obtenue diffère de la sortie attendue, les poids sont mis à jour. Parfois, l’écart reste dans la limite d’erreur acceptable : le réseau est alors considéré comme optimal.
Sinon, l’erreur est renvoyée en sens inverse dans le réseau, de la couche de sortie vers la couche d’entrée, et les poids et biais sont corrigés. Ce processus se répète de façon itérative : c’est la rétro-propagation.
La rétro-propagation permet aux algorithmes d’apprendre par eux-mêmes.
C’est elle qui rend les réseaux de neurones « intelligents » : ils s’améliorent automatiquement au fil de l’entraînement.
Quels sont les différents types de réseaux de neurones ?
Il existe de nombreux types de réseaux de neurones. Les trois principaux sont :
- Le réseau de neurones récurrent (RNN, Recurrent Neural Network) :
Ce réseau spécialisé utilise le contexte des entrées pour calculer la sortie, qui dépend donc des entrées et des sorties calculées précédemment.
Les RNN conviennent aux applications où l’historique compte : prévision de séries chronologiques en entreprise, prédiction de mots dans un chatbot… Ils acceptent des entrées et des sorties de longueurs variables, mais demandent une grande quantité de données.
Pour le traitement du langage, ils ont été largement remplacés par les transformers. - Le réseau de neurones convolutif (CNN, Convolutional Neural Network) :
Ce réseau repose sur des filtres de convolution (des matrices numériques) appliqués aux entrées avant qu’elles ne soient transmises aux neurones.
Les CNN sont particulièrement utiles pour le traitement et la prédiction sur des images. Pour voir ce que « voit » un CNN, lis notre article sur la visualisation de l’activation intermédiaire d’un réseau de neurones convolutif. - Le transformer :
C’est l’architecture à la base des grands modèles de langage (LLM) des assistants IA actuels. Au lieu de lire une séquence pas à pas comme un RNN, il utilise un mécanisme d’attention qui mesure l’importance de chaque élément de la séquence par rapport aux autres, et il traite tous les éléments en parallèle.
Les transformers servent surtout pour le texte, mais aussi pour les images, l’audio et les séries chronologiques.
Questions fréquentes sur les réseaux de neurones
Qu’est-ce qu’un réseau de neurones artificiel ?
C’est un ensemble d’algorithmes mathématiques, inspiré des neurones biologiques, qui produit une donnée de sortie à partir de données d’entrée. Il est entraîné avec de nombreux exemples associés à leur sortie attendue, et se met à jour pour améliorer ses résultats.
Quelles sont les composantes d’un réseau de neurones ?
Quatre éléments : les neurones, les couches (entrée, cachées et sortie), les poids et biais, et les fonctions d’activation. Les poids et les biais sont les valeurs que le réseau apprend par lui-même pendant l’entraînement.
À quoi sert une fonction d’activation ?
Elle est appliquée à la somme pondérée des entrées plus le biais pour calculer la sortie du neurone. Elle introduit de la non-linéarité, indispensable pour résoudre des problèmes complexes. Les plus courantes sont la sigmoïde, tanh, ReLU (la plus utilisée dans les couches cachées) et softmax (couche de sortie pour la classification).
Qu’est-ce que la rétro-propagation ?
C’est le mécanisme qui permet à un réseau de neurones d’améliorer sa précision : quand la sortie obtenue diffère de la sortie attendue, l’erreur est renvoyée en sens inverse, de la couche de sortie vers la couche d’entrée, et les poids et biais sont corrigés. Le processus se répète de façon itérative.
Quels sont les principaux types de réseaux de neurones ?
Les trois principaux sont le réseau de neurones récurrent (RNN), adapté aux applications où l’historique compte (séries chronologiques, prédiction de mots), le réseau de neurones convolutif (CNN), particulièrement utile pour le traitement et la prédiction sur des images, et le transformer, l’architecture des grands modèles de langage (LLM), fondée sur un mécanisme d’attention.
Conclusion
Dans cet article, j’ai présenté le concept de réseau de neurones : ce que c’est et comment il fonctionne.
Tu as aussi vu un aperçu des composants qui les rendent artificiellement intelligents, puis les trois types de réseaux les plus utilisés : RNN, CNN et transformers.
Pour aller plus loin, lis notre guide sur le fonctionnement du Deep Learning, et découvre comment les réseaux de neurones se situent parmi les autres algorithmes dans l’article sur les principaux modèles de Machine Learning expliqués simplement.
Merci Ulrich, j’ai mis à jour le lien du cours sur l’article, mais sinon tous les cours sont présents sur la page : https://moncoachdata.com/formation-data-science/ 🙂
Merci Ulrich, j’ai mis à jour le lien du cours sur l’article, mais sinon tous les cours sont présents sur la page : https://moncoachdata.com/formation-data-science/ 🙂
Merci Ulrich, j’ai mis à jour le lien du cours sur l’article, mais sinon tous les cours sont présents sur la page : https://moncoachdata.com/formation-data-science/ 🙂
Merci Ulrich, j’ai mis à jour le lien du cours sur l’article, mais sinon tous les cours sont présents sur la page : https://moncoachdata.com/formation-data-science/ 🙂
Merci Ulrich, j’ai mis à jour le lien du cours sur l’article, mais sinon tous les cours sont présents sur la page : https://moncoachdata.com/formation-data-science/ 🙂