Tu as envie d’explorer un nouveau jeu de données ? Pourquoi pas celui de la Formule 1 : chaque course produit des milliers de temps au tour, de vitesses et de choix de pneus, que Python permet de récupérer et d’analyser en quelques lignes. Dans ce tutoriel d’analyse de données de Formule 1 avec Python, tu vas apprendre à charger les données d’une course avec la bibliothèque fastf1, puis à les analyser avec 5 astuces pandas.
Article mis à jour en octobre 2026 : tout le code a été exécuté dans Google Colab (Python 3.13, fastf1 3.9.0 et pandas 2.2) et tous les résultats sont de vraies exécutions. La méthode load_laps() de l’ancienne version n’existe plus : il faut charger la session avec load() puis lire session.laps. La fonction Cache.enable_cache() est dépréciée au profit de Cache.configure(). J’ai aussi ajouté un contrôle du nombre de pilotes et un filtre sur les tours rapides pour comparer le rythme des équipes.
En bref : installe fastf1 avec pip install fastf1, choisis une course avec fastf1.get_session(2021, "Abu Dhabi", "R"), charge-la avec load() et récupère un DataFrame pandas avec session.laps : une ligne par tour et par pilote. Tu peux ensuite explorer les données (head(), T, describe()), trouver le tour le plus rapide (loc[] ou pick_fastest()), compter les pneus (value_counts()), comparer le rythme des équipes (groupby()) et classer les pilotes au piège à vitesse. Attention : fastf1 n’est pas encore compatible avec pandas 3, mais Google Colab convient.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys
import fastf1
import pandas as pd

print("Python", sys.version.split()[0])
print("fastf1", fastf1.__version__)
print("pandas", pd.__version__)Python 3.13.16
fastf1 3.9.0
pandas 2.2.3Comment récupérer les données de la Formule 1 avec Python ?
La bibliothèque fastf1 donne accès aux données de chronométrage et de télémétrie de la F1, de la saison 2018 à aujourd’hui, et les range dans des DataFrames pandas. Elle a sa propre documentation, très complète mais pas toujours simple quand on débute. Voyons donc les bases : installer la bibliothèque, choisir une course et charger ses tours.
Comment installer fastf1 ?
Installe fastf1 avec pip. Il demande Python 3.10 ou plus récent.
pip install fastf1Un point important : fastf1 3.9.0 exige une version de pandas strictement inférieure à 3 (pandas>=2.1.1,<3). Dans un environnement local qui utilise déjà pandas 3, pip installera donc pandas 2 à la place. Sur Google Colab, qui fournit pandas 2, aucun souci.
Comment activer le cache et réduire les messages ?
Chaque week-end de course génère beaucoup de données : leur téléchargement prend du temps. fastf1 les garde donc dans un dossier de cache, pour que les chargements suivants soient beaucoup plus rapides. Crée un dossier (ici cache) puis indique-le avec Cache.configure() (le dossier doit déjà exister) :
import os

# dossier où fastf1 garde les données déjà téléchargées
os.makedirs("cache", exist_ok=True)
fastf1.Cache.configure(cache_dir="cache")fastf1 est aussi très bavard : à chaque chargement, il affiche des dizaines de lignes d'information. Au moment de mes tests, il cherche notamment un compte Formula 1 et affiche un avertissement quand il n'en trouve pas, puis continue sans authentification en récupérant les données sur un serveur miroir. Tout fonctionne quand même, et il n'est pas nécessaire d'avoir un compte. Pour ne garder que les erreurs, règle le niveau de messages du module :
import logging

# fastf1 est très bavard : on ne garde que les erreurs
logging.getLogger("fastf1").setLevel(logging.ERROR)Comment choisir une course ?
Pour désigner une session, fastf1.get_session() prend trois paramètres :
year: l'année du championnat ;gp: le Grand Prix, par son nom ou le numéro de la course dans la saison. Si tu passes un texte, fastf1 cherche la meilleure correspondance parmi les pays, les lieux et les noms des Grands Prix :"Turkey","Istanbul"ou"monza"fonctionnent par exemple ;identifier: la session, par son abréviation ("FP1","FP2","FP3","Q"pour les qualifications,"R"pour la course) ou son nom complet ("Qualifying").
Le numéro de la course dépend de la saison. Pour le vérifier, lis le calendrier avec get_event_schedule() : en 2021, le Grand Prix de Turquie est la 16e course et celui d'Abu Dhabi la 22e.
calendrier = fastf1.get_event_schedule(2021)
calendrier.loc[calendrier["RoundNumber"].isin([16, 22]), ["RoundNumber", "Country", "EventName"]]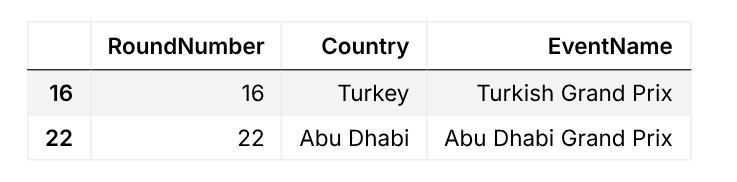
Comment charger les tours d'une session ?
Supposons que tu t'intéresses aux qualifications du Grand Prix de Turquie 2021. get_session() crée la session mais ne charge encore aucune donnée : il faut appeler load(). Par défaut, load() charge aussi la télémétrie, la météo et les messages de la direction de course. Comme on n'a besoin que des temps au tour, on désactive le reste pour gagner du temps :
quali = fastf1.get_session(2021, "Turkey", "Q")
quali.load(telemetry=False, weather=False, messages=False)

print(quali.event["EventName"], "-", quali.name)
print(len(quali.laps), "tours dans la session")Turkish Grand Prix - Qualifying
395 tours dans la sessionLes tours de la session sont dans l'attribut laps, un DataFrame pandas. Il y a 395 tours dans ces qualifications. Pour la suite, on charge la course d'Abu Dhabi 2021 de la même façon :
race = fastf1.get_session(2021, "Abu Dhabi", "R")
race.load(telemetry=False, weather=False, messages=False)

laps = race.laps
print(race.event["EventName"], "-", race.name)
print(laps.shape)Abu Dhabi Grand Prix - Race
(1000, 31)Le DataFrame laps a 1 000 lignes (une par tour et par pilote) et 31 colonnes. Je te conseille de l'inspecter : c'est le sujet de la première astuce.
Quelles astuces pandas pour analyser les tours d'une course de F1 ?
Voici cinq astuces, toutes appliquées au DataFrame laps de la course d'Abu Dhabi 2021.
Astuce 1 : comment explorer les données ?
Quand tu as devant toi un nouveau jeu de données, commence par te faire une idée de ses variables et de leur comportement. Pandas offre de nombreux outils pour cela. Commence par head(), qui affiche les 5 premières lignes (head(10) en affiche 10, et tail() affiche les dernières). Ici on se limite à quelques colonnes :
laps[["Driver", "Team", "LapNumber", "LapTime", "Compound", "TyreLife"]].head()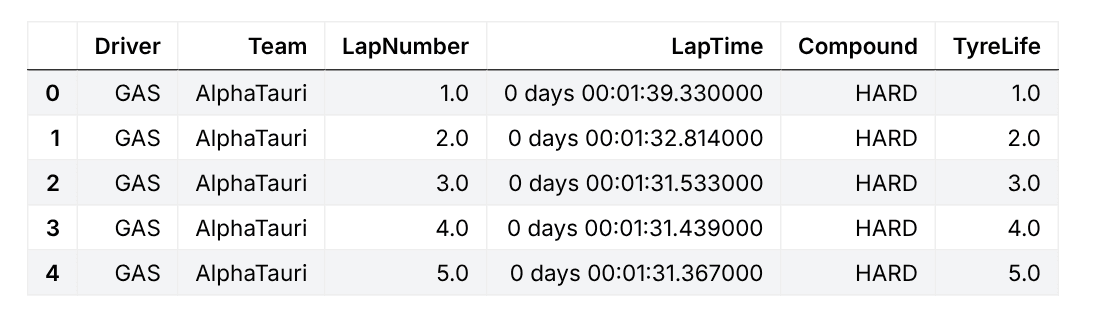
Le temps au tour (LapTime) est un Timedelta pandas : 0 days 00:01:39.330000 signifie 1 minute et 39,330 secondes. Les lignes sont rangées par pilote, en commençant ici par Gasly (n° 10). Le premier tour est plus lent que les suivants, car la course commence par un départ arrêté.
Une autre astuce utile pour explorer rapidement les données est .T. Le « T » signifie « transposée » : elle intervertit les lignes et les colonnes. Quand un jeu de données a beaucoup de colonnes, Jupyter en masque une partie ; avec .T, tu vois toutes les colonnes, avec leur contenu. On la combine ici avec head(3) pour afficher les trois premiers tours :
laps.head(3).T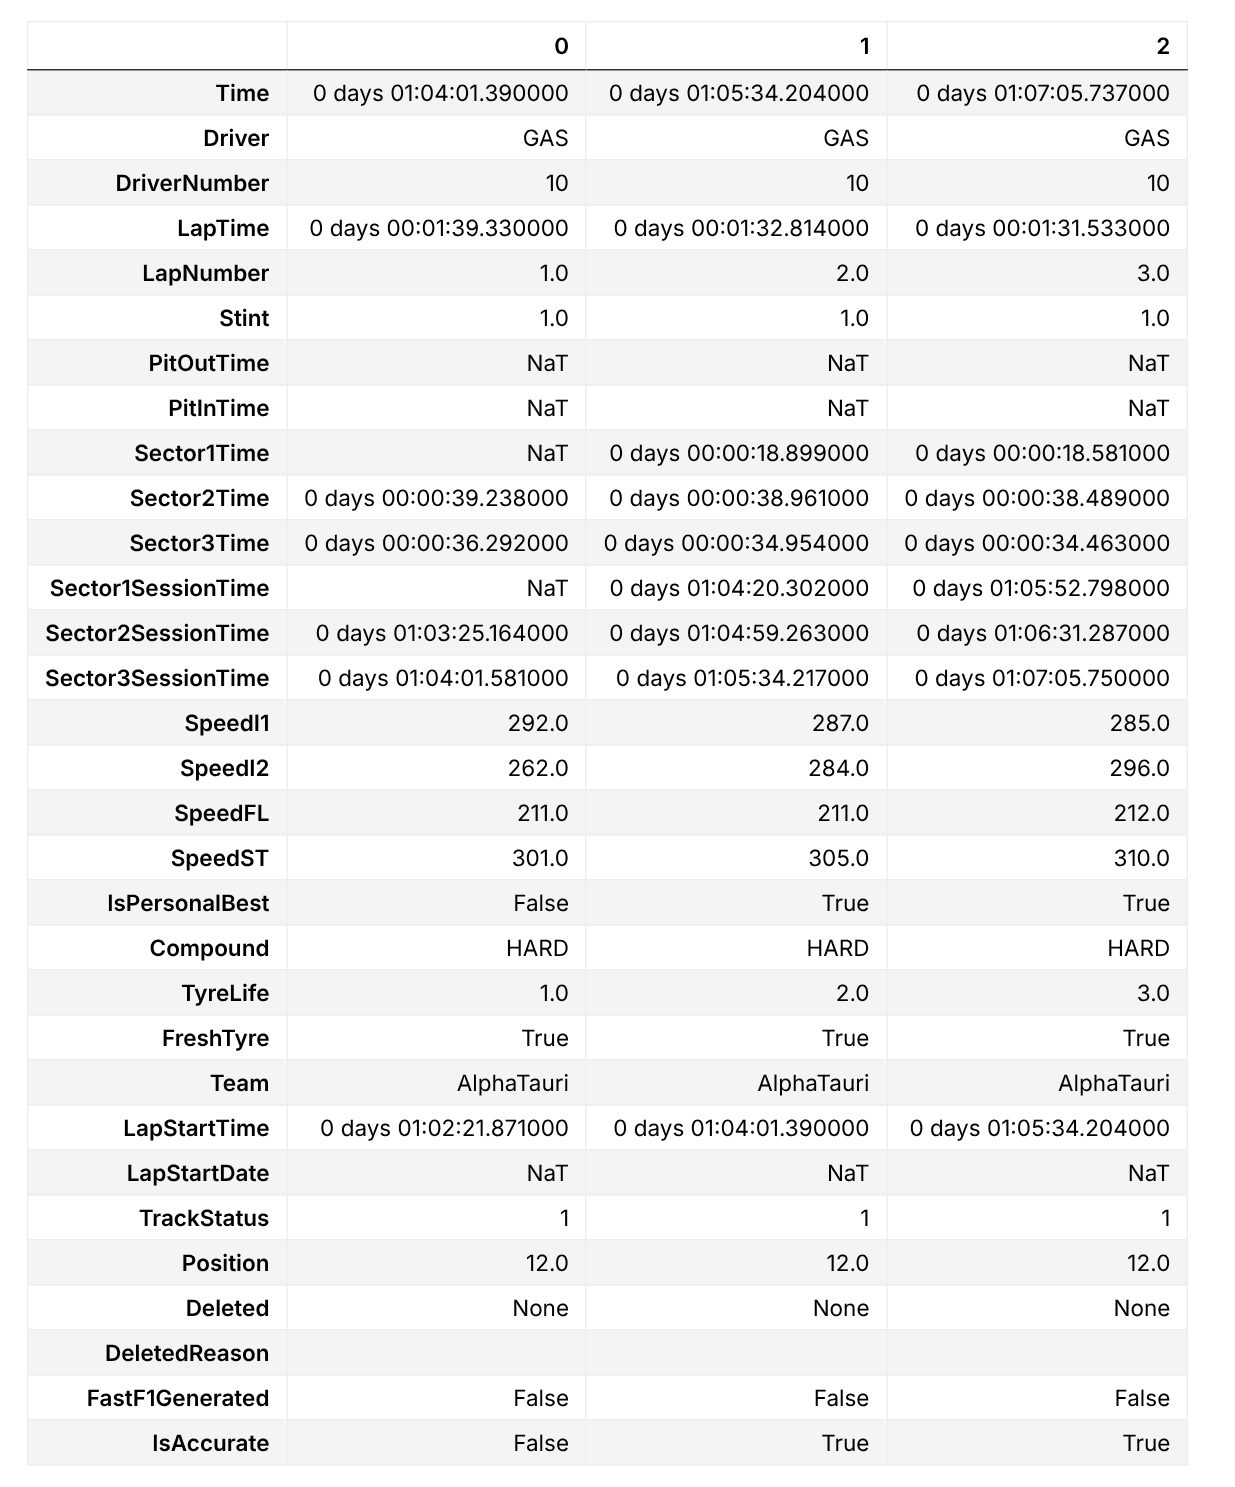
Tu y vois par exemple NaT (« Not a Time ») : c'est la valeur manquante d'une durée ou d'une date. Les colonnes SpeedI1, SpeedI2, SpeedFL et SpeedST donnent les vitesses mesurées en différents points du circuit : deux points intermédiaires, la ligne d'arrivée et le piège à vitesse.
Troisième méthode d'exploration : describe(), qui résume les variables numériques (nombre de valeurs, moyenne, écart type, minimum, quartiles et maximum). Je l'applique à quelques colonnes numériques :
colonnes_num = ["LapNumber", "TyreLife", "SpeedI1", "SpeedI2", "SpeedFL", "SpeedST"]
laps[colonnes_num].describe().round(1)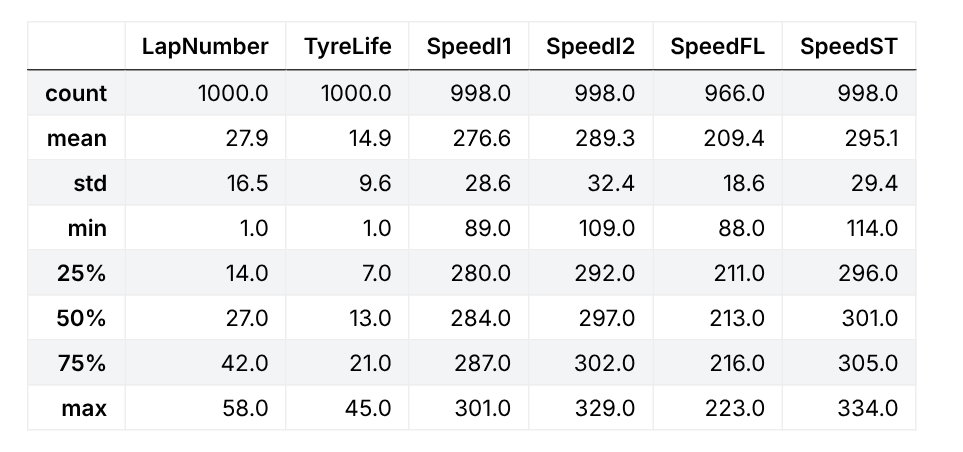
Deux choses à lire dans ce tableau. D'abord, count vaut 1 000 pour les tours mais seulement 998 pour la plupart des vitesses (et 966 pour SpeedFL) : certaines mesures manquent. Ensuite, le minimum de SpeedST est de 114 km/h, très loin du quartile à 296 km/h : ce sont sans doute des tours très lents, comme un passage aux stands ou un tour sous safety car. Le maximum de LapNumber (58) est le nombre de tours de la course.
Dernier réflexe : vérifier que les données sont complètes. Combien de tours a-t-on pour chaque pilote ?
tours_par_pilote = (
    laps.groupby("DriverNumber")["Driver"]
    .agg(Pilote="first", Tours="size")
    .sort_values("Tours")
)
tours_par_pilote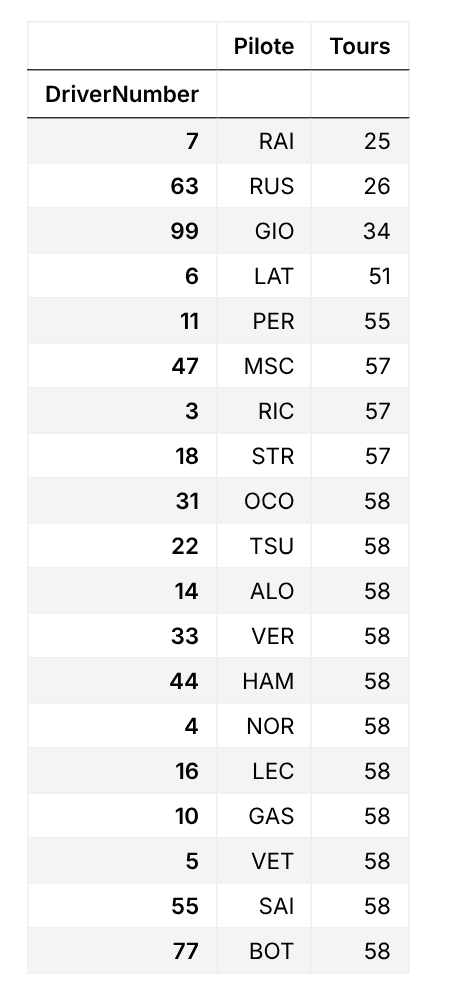
Les pilotes qui ont fini la course sur le même tour que le vainqueur ont 58 tours ; ceux qui ont abandonné ou ont été doublés en ont moins (Räikkönen 25, Russell 26, Giovinazzi 34). Surtout, il n'y a que 19 pilotes alors que 20 voitures étaient au départ : le numéro 9 (Nikita Mazepin, chez Haas) n'a aucun tour dans les données de fastf1 pour cette course. Je n'ai pas trouvé la cause de cette absence. Retiens la leçon : vérifie toujours le nombre de pilotes avant de comparer des équipes, car un pilote manquant fausse les comparaisons.
Astuce 2 : comment trouver le tour le plus rapide ?
Pour localiser des données précises dans un DataFrame, tu peux utiliser DataFrame.loc[] avec une condition (tu en trouveras d'autres exemples dans Filtrer un DataFrame pandas). On cherche le temps le plus bas avec min(), puis on demande à pandas les lignes dont le LapTime est égal à ce minimum. Les temps manquants (NaT) sont ignorés par min() :
colonnes = ["Driver", "Team", "LapNumber", "LapTime", "Compound"]
laps.loc[laps["LapTime"] == laps["LapTime"].min(), colonnes]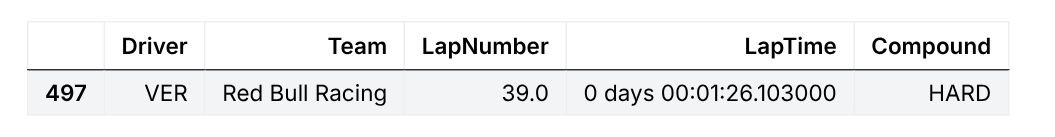
Ce que l'on demande à pandas : « donne-moi la ligne où le temps au tour est égal au plus petit temps au tour, avec les colonnes pilote, équipe, numéro de tour, temps et pneu ». Verstappen a signé le meilleur tour au 39e tour, sur pneus durs.
fastf1 propose aussi une méthode toute faite, pick_fastest(). Elle renvoie le tour le plus rapide parmi ceux que fastf1 marque comme meilleur tour personnel du pilote (colonne IsPersonalBest), alors que min() regarde seulement le temps. Pour l'afficher proprement, on ajoute une petite fonction qui convertit un Timedelta en minutes et secondes :
def format_temps(t):
    """Convertit un temps au tour (Timedelta) en minutes:secondes."""
    minutes, secondes = divmod(t.total_seconds(), 60)
return f"{int(minutes)}:{secondes:06.3f}"meilleur = laps.pick_fastest()
print(meilleur["Driver"], "au tour", int(meilleur["LapNumber"]), ":", format_temps(meilleur["LapTime"]))VER au tour 39 : 1:26.103Astuce 3 : comment compter l'utilisation des pneus ?
Une autre astuce simple et très utile est value_counts(). Imaginons que tu veuilles savoir quel pneu a été le plus utilisé pendant la course. Tu peux le mesurer en comptant le nombre de tours roulés avec chaque type de gomme, avec une seule ligne de code :
laps["Compound"].value_counts()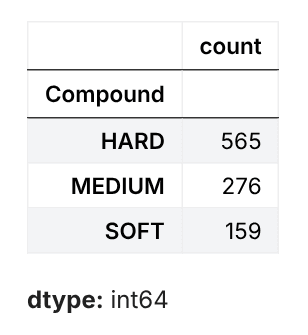
On demande à pandas : « donne-moi le nombre d'occurrences de chaque valeur unique de la colonne Compound ». Les pneus durs ont été utilisés pendant 565 tours sur 1 000 (56,5 %), les médiums pendant 276 tours et les tendres pendant 159 tours. Attention, on compte des tours et non des relais : un pneu usé deux fois plus longtemps pèse deux fois plus dans le total.
Astuce 4 : comment comparer le rythme de course des équipes ?
Et si tu veux connaître le temps moyen par tour de chaque pilote dans chaque équipe ? Pandas dispose d'une méthode très utile, groupby() (explorée en détail dans Groupby de pandas). Elle regroupe les lignes selon les colonnes que tu indiques, puis résume chaque groupe.
Il y a pourtant un piège. Si tu calcules la moyenne de tous les tours, elle inclut le premier tour, les tours de sortie des stands et les tours sous safety car, bien plus lents. Voici ce que cela donne pour Verstappen. On filtre d'abord les tours rapides avec pick_quicklaps(), qui garde les tours à moins de 107 % du meilleur temps :
tours_rapides = laps.pick_quicklaps()
print(len(laps), "tours au total,", len(tours_rapides), "tours rapides")

for nom, tours in {"tous les tours": laps, "tours rapides": tours_rapides}.items():
    moyenne = tours.loc[tours["Driver"] == "VER", "LapTime"].mean()
print(f"Verstappen, {nom} : {format_temps(moyenne)}")1000 tours au total, 802 tours rapides
Verstappen, tous les tours : 1:33.403
Verstappen, tours rapides : 1:27.936La moyenne passe de 1:33.403 à 1:27.936 : plus de 5 secondes d'écart ! On a gardé 802 tours sur 1 000. Pour comparer le vrai rythme de course, on utilise donc les tours rapides. On regroupe par équipe et par pilote, on calcule la moyenne des temps, puis on convertit en secondes avec .dt.total_seconds() et on trie :
cadence = (
    tours_rapides.groupby(["Team", "Driver"])["LapTime"]
    .mean()
    .dt.total_seconds()
    .round(3)
    .rename("Temps moyen (s)")
    .reset_index()
    .sort_values(["Team", "Temps moyen (s)"])
)
cadence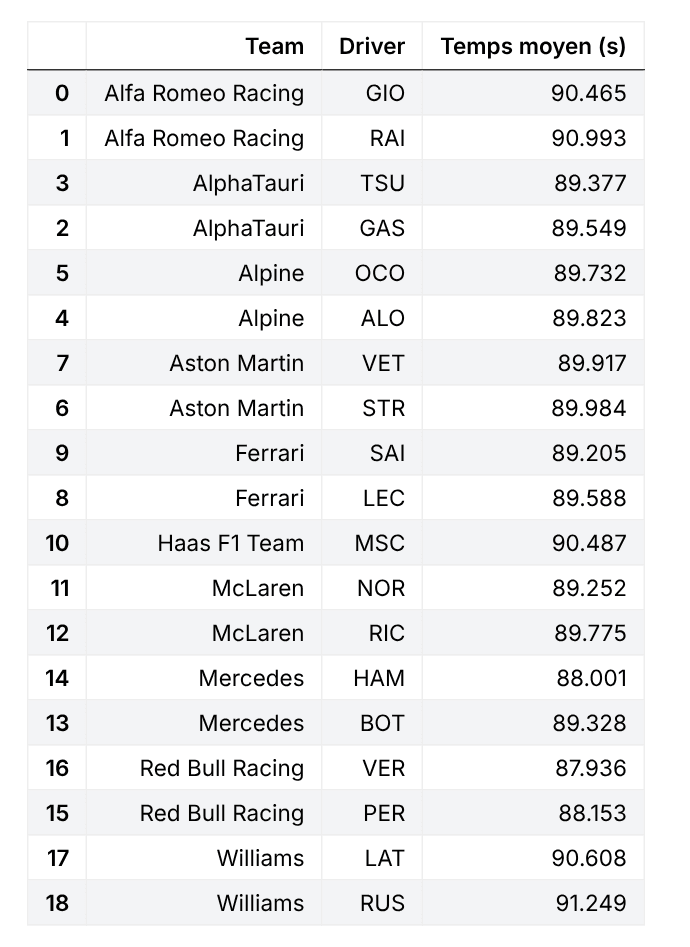
Ce que l'on demande à Python : « regroupe les tours rapides par équipe et par pilote, calcule la moyenne des temps au tour en secondes, puis trie par équipe et par temps croissant ». Verstappen (87,936 s) est en tête, mais Hamilton n'est qu'à 0,065 s (88,001 s) : un écart minuscule en rythme moyen. À lire avec prudence : les pilotes qui ont abandonné tôt (Räikkönen, Russell) ont une moyenne calculée sur très peu de tours, et un pilote en tête roule sans trafic, alors qu'un pilote qui remonte le peloton perd du temps derrière les autres. Et on l'a vu : un pilote est absent du tableau (19 pilotes).
Astuce 5 : quels pilotes sont les plus rapides au piège à vitesse ?
Comme groupby() est utile dans de nombreux cas, voici un autre exemple. À chaque tour, les pilotes passent devant un « piège à vitesse » : un point de mesure qui enregistre la vitesse de la voiture à chaque passage. Pour savoir quels pilotes ont enregistré les vitesses les plus élevées et lesquels les plus faibles, regroupe par pilote, prends la valeur maximale de la colonne SpeedST et trie par ordre décroissant :
vitesse_max = (
    laps.groupby("Driver")["SpeedST"]
    .max()
    .sort_values(ascending=False)
    .rename("Vitesse max (km/h)")
)
vitesse_max.to_frame()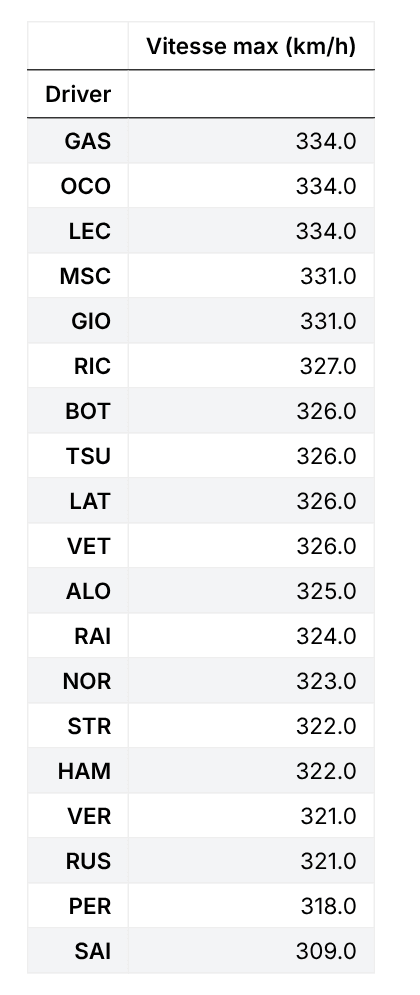
Gasly, Ocon et Leclerc sont à égalité en tête avec 334 km/h, et Sainz ferme la marche avec 309 km/h. Cette vitesse maximale dépend de nombreux facteurs, comme l'utilisation du DRS ou l'aspiration derrière une autre voiture : ne la prends donc pas pour la vitesse de pointe réelle de chaque voiture.
Questions fréquentes
Comment récupérer les données de la Formule 1 avec Python ?
Avec la bibliothèque fastf1 : installe-la avec pip install fastf1, crée une session avec fastf1.get_session(année, grand_prix, session), charge-la avec session.load() puis lis session.laps pour obtenir un DataFrame pandas avec un tour par ligne. Les données de chronométrage sont disponibles de la saison 2018 à aujourd'hui.
Pourquoi load_laps() ne fonctionne plus dans fastf1 ?
Parce que cette méthode a disparu avec fastf1 3. Il faut maintenant charger la session avec session.load(), puis lire les tours dans session.laps. On règle ce qui est chargé avec les arguments laps, telemetry, weather et messages de load().
À partir de quelle année peut-on analyser les données de la F1 avec fastf1 ?
Les données de chronométrage (temps au tour, pneus, télémétrie) sont disponibles de la saison 2018 à aujourd'hui. Pour les saisons plus anciennes, fastf1 ne propose que des données de résultats issues du projet Ergast, sans les temps au tour détaillés.
Comment trouver le tour le plus rapide d'une course avec pandas ?
Avec laps.loc[laps['LapTime'] == laps['LapTime'].min()], ou avec laps.pick_fastest() de fastf1. La seconde ne retient que les tours marqués comme meilleur tour personnel du pilote ; ici, les deux donnent le même résultat : Verstappen, tour 39, 1:26.103.
Pourquoi calculer la moyenne des temps au tour sur les tours rapides seulement ?
Parce que la moyenne de tous les tours inclut le premier tour, les tours de sortie des stands et les tours sous safety car, beaucoup plus lents. À Abu Dhabi 2021, la moyenne de Verstappen passe de 1:33.403 à 1:27.936 quand on garde seulement les tours rapides, obtenus avec laps.pick_quicklaps() (moins de 107 % du meilleur temps).
fastf1 fonctionne-t-il avec pandas 3 ?
Pas encore : fastf1 3.9.0 exige pandas 2.1.1 ou plus et strictement inférieur à 3. Utilise un environnement avec pandas 2, ou Google Colab, qui fournit pandas 2. Un compte Formula 1 n'est pas nécessaire : sans compte, fastf1 affiche un avertissement puis continue.
Conclusion
Tu sais maintenant charger les données d'une course de Formule 1 avec fastf1 et les analyser avec pandas : exploration, tour le plus rapide, pneus, rythme des équipes et vitesses au piège à vitesse. Chaque analyse est différente et demande ses propres approches ; ce tutoriel sert à t'aider à démarrer. Pour t'entraîner, refais ces astuces sur les qualifications de Turquie déjà chargées dans quali.laps, ou sur une autre course de ton choix : change simplement l'année, le Grand Prix et la session.
Analyser une course, c'est un bon terrain d'entraînement ; savoir mener une analyse complète, c'est un métier. Sur DataXp, tu t'entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin sur pandas :