Pandas et SQL sont deux outils très populaires pour manipuler des données, et leurs fonctionnalités se chevauchent souvent. Quel meilleur moyen de progresser dans les deux que de les mettre en concurrence sur les mêmes problèmes de Data Science ?
Dans ce guide, nous comparons côte à côte la façon de travailler avec pandas et SQL : d’abord comment sélectionner, filtrer, trier et limiter des données, puis comment les agréger et les regrouper, à partir d’un jeu de données bien connu. Toutes les requêtes SQL ont été exécutées avec SQLite et tous les résultats pandas viennent de vraies exécutions.
Article mis à jour en octobre 2026 : code testé avec Python 3.13, pandas 3 et pandas 2.3, requêtes SQL exécutées avec SQLite, jeu de données Titanic hébergé sur le GitHub de MonCoachData (plus besoin d’un compte Kaggle). Ajout de query(), des agrégations nommées, des pièges sur les valeurs manquantes et sur l’ordre des ex æquo, et d’une vérification automatique que SQL et pandas donnent le même résultat. Avec pandas 3, .copy() n’est plus nécessaire pour modifier une tranche. Le code fonctionne avec pandas 2.3 comme avec pandas 3 (par exemple dans Google Colab).
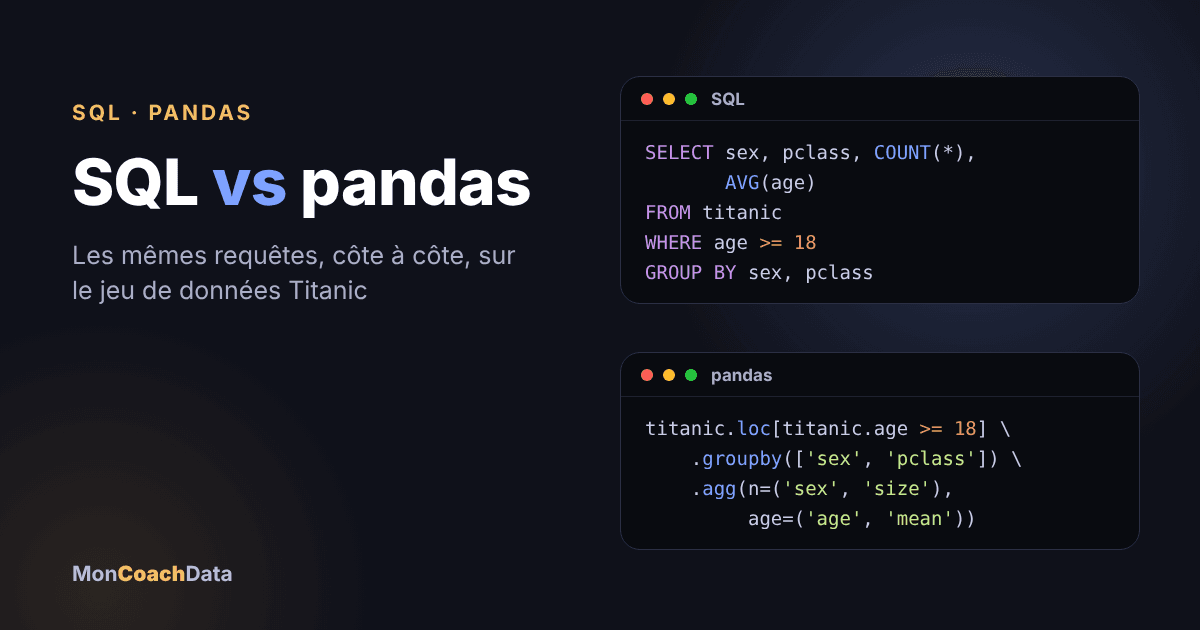
En bref : dans le match SQL vs pandas, les deux répondent aux mêmes questions avec des mots différents. SELECT correspond à la sélection de colonnes, WHERE à un masque booléen avec loc[], ORDER BY à sort_values(), LIMIT à head() et GROUP BY à groupby(). Deux pièges à connaître : SQL garde un groupe NULL dans un regroupement alors que pandas l’écarte par défaut, et l’ordre des ex æquo n’est pas le même d’un moteur à l’autre.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys, sqlite3, pandas as pd

print("Python", sys.version.split()[0])
print("pandas", pd.__version__)
print("SQLite", sqlite3.sqlite_version)Python 3.13.16
pandas 3.0.5
SQLite 3.45.1Pourquoi comparer SQL et pandas ?
Mon objectif est de t’aider à :
- Apprendre et comparer les fonctionnalités de pandas et de SQL
- Si tu connais déjà l’un des deux, apprendre l’autre
- Comprendre les forces et les faiblesses de chacun
- Disposer de plusieurs outils pour manipuler les données
À la fin, je te propose six problèmes pratiques à résoudre toi-même, avec leurs corrections. Pour d’autres exemples, lis aussi Travailler avec SQL et Pandas et SQLite avec Python.
Comment charger le jeu de données Titanic dans pandas et dans SQL ?
Pour les exemples, j’utilise le tristement célèbre jeu de données Titanic : une ligne par passager, avec sa classe (pclass), son sexe (sex), son âge (age), le prix de son billet (fare) et une colonne survived qui vaut 1 s’il a survécu et 0 sinon. Je le charge directement depuis le dépôt GitHub de MonCoachData (une copie du jeu de données public de seaborn), sans téléchargement ni compte Kaggle. Il contient 891 passagers et 15 colonnes.
url = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/sql-vs-pandas/titanic.csv"
titanic = pd.read_csv(url)

pd.set_option("display.max_rows", 8)
titanic.shape(891, 15)titanic.head()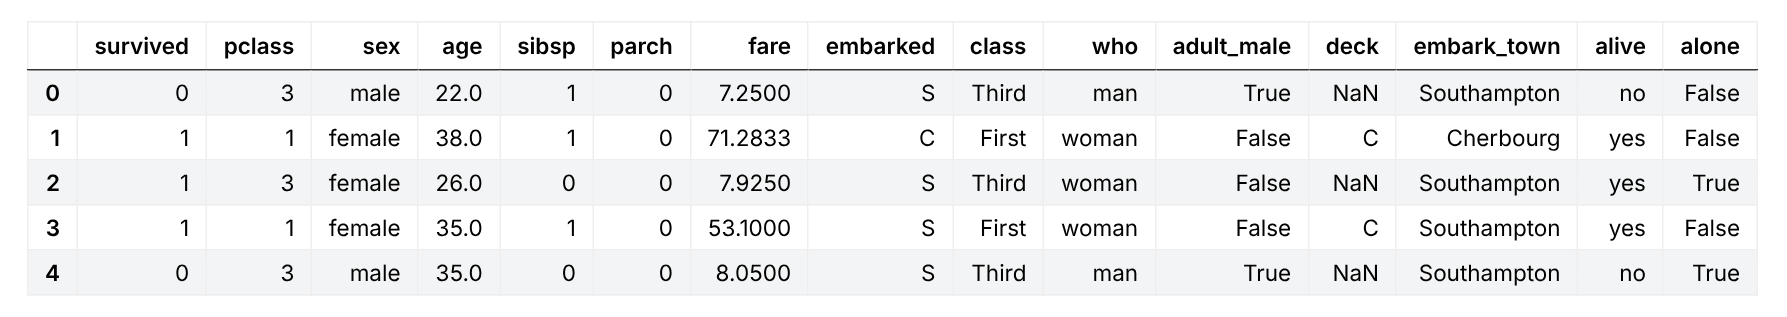
Pour exécuter du SQL sans installer de serveur, je crée une base SQLite en mémoire avec le module sqlite3 de Python, fourni avec Python, puis j’y copie le DataFrame dans une table titanic avec to_sql(). La petite fonction sql() exécute une requête et renvoie le résultat sous forme de DataFrame, grâce à read_sql_query().
conn = sqlite3.connect(":memory:")
titanic.to_sql("titanic", conn, index=False)

def sql(requete):
return pd.read_sql_query(requete, conn)Les requêtes de cet article sont du SQL courant : elles fonctionnent aussi avec PostgreSQL ou MySQL, à de petites différences près (le mot-clé LIMIT, par exemple, s’écrit autrement dans certains moteurs).
Comment sélectionner des colonnes en SQL et en pandas ?
Commençons par la fonctionnalité la plus élémentaire : sélectionner des colonnes et les afficher dans un certain ordre. Disons que nous voulons voir les colonnes pclass, fare, age et survived du jeu de données, dans cet ordre.
En SQL
L’instruction SELECT énumère les colonnes à afficher et leur ordre. Pour voir toutes les colonnes d’une table, on utilise SELECT *, mais ici nous nommons les colonnes voulues.
SELECT pclass, fare, age, survived
FROM titanicExécutée avec notre fonction sql(), cette requête renvoie le tableau suivant (pandas n’en affiche que le début et la fin) :
sql("""
SELECT pclass, fare, age, survived
FROM titanic
""") pclass fare age survived
0 3 7.2500 22.0 0
1 1 71.2833 38.0 1
2 3 7.9250 26.0 1
3 1 53.1000 35.0 1
.. ... ... ... ...
887 1 30.0000 19.0 1
888 3 23.4500 NaN 0
889 1 30.0000 26.0 1
890 3 7.7500 32.0 0
[891 rows x 4 columns]Avec pandas
Dans pandas, il suffit de découper les colonnes voulues dans le DataFrame, et il existe plusieurs façons d’obtenir le même résultat. La première passe par une liste de colonnes :
col_list = ['pclass', 'fare', 'age', 'survived']
titanic[col_list] pclass fare age survived
0 3 7.2500 22.0 0
1 1 71.2833 38.0 1
2 3 7.9250 26.0 1
3 1 53.1000 35.0 1
.. ... ... ... ...
887 1 30.0000 19.0 1
888 3 23.4500 NaN 0
889 1 30.0000 26.0 1
890 3 7.7500 32.0 0
[891 rows x 4 columns]Tu peux aussi placer la liste directement entre les crochets, sans créer de variable, ou utiliser loc[]. Ces trois écritures donnent le même résultat, ce que equals() permet de vérifier :
titanic[['pclass', 'fare', 'age', 'survived']].equals(titanic[col_list])Truetitanic.loc[:, ['pclass', 'fare', 'age', 'survived']].equals(titanic[col_list])TrueDans loc[:, colonnes], les deux points indiquent que nous voulons toutes les lignes ; après la virgule, nous indiquons les colonnes voulues et leur ordre. En général, je préfère créer une variable pour la liste de colonnes : c’est plus propre, avec moins de crochets imbriqués sur une seule ligne, et il est plus facile de respecter les directives PEP 8 puisque les lignes de code restent courtes. Dans la suite de cet article, j’utilise donc loc[] et des variables distinctes.
À noter : loc[] permet aussi de sélectionner une plage de lignes à partir de l’index. Pour n’examiner que les index 50 à 100, on met 50:100 en premier terme. Contrairement aux tranches Python habituelles, les deux bornes sont incluses : on obtient ici 51 lignes.
titanic.loc[50:100, col_list] pclass fare age survived
50 3 39.6875 7.0 0
51 3 7.8000 21.0 0
52 1 76.7292 49.0 1
53 2 26.0000 29.0 1
.. ... ... ... ...
97 1 63.3583 23.0 1
98 2 23.0000 34.0 1
99 2 26.0000 34.0 0
100 3 7.8958 28.0 0
[51 rows x 4 columns]Comment filtrer des lignes avec WHERE et avec un masque pandas ?
Imaginons maintenant que tu veuilles des résultats selon une condition précise. Avec le même exemple, nous voulons toujours pclass, fare, age et survived, mais seulement pour les hommes adultes.
En SQL
L’instruction WHERE filtre sur la valeur d’une colonne. Elle suit l’instruction FROM. Comme notre problème nécessite deux conditions, nous les énumérons avec un AND entre les deux. Tu peux aussi utiliser OR pour garder les lignes qui répondent à l’une ou l’autre condition.
SELECT pclass, fare, age, survived
FROM titanic
WHERE sex = 'male' AND age >= 18Avec pandas
Nous créons des variables qui contiennent les deux conditions, puis nous utilisons à nouveau loc[] pour sélectionner les lignes et les colonnes voulues.
male_mask = titanic.sex == 'male'
age_mask = titanic.age >= 18
col_list = ['pclass', 'fare', 'age', 'survived']
titanic.loc[male_mask & age_mask, col_list] pclass fare age survived
0 3 7.2500 22.0 0
4 3 8.0500 35.0 0
6 1 51.8625 54.0 0
12 3 8.0500 20.0 0
.. ... ... ... ...
884 3 7.0500 25.0 0
886 2 13.0000 27.0 0
889 1 30.0000 26.0 1
890 3 7.7500 32.0 0
[395 rows x 4 columns]Les deux variables de masque sont des séries de valeurs booléennes (True ou False) qui indiquent si chaque ligne remplit la condition. Souviens-toi : avec loc[], on indique d’abord les lignes voulues, puis, après la virgule, les colonnes à afficher. Avec le & entre les masques, seules les lignes vraies pour les deux conditions sont retournées. Pour une logique « ou », utilise le symbole pipe | à la place.
Petite fonctionnalité pratique : le tilde ~ inverse un masque. Avec ~male_mask, tous les True deviennent False et inversement : ici, cela revient à filtrer les femmes. C’est utile pour réutiliser la même variable en inversant la logique.
titanic.loc[~male_mask, 'sex'].value_counts()sex
female 314
Name: count, dtype: int64Une alternative plus proche de WHERE : la méthode query(), qui accepte la condition sous forme de texte.
titanic.query("sex == 'male' and age >= 18")[col_list] pclass fare age survived
0 3 7.2500 22.0 0
4 3 8.0500 35.0 0
6 1 51.8625 54.0 0
12 3 8.0500 20.0 0
.. ... ... ... ...
884 3 7.0500 25.0 0
886 2 13.0000 27.0 0
889 1 30.0000 26.0 1
890 3 7.7500 32.0 0
[395 rows x 4 columns]Dernier point, valable pour SQL comme pour pandas : une condition sur une valeur manquante n’est jamais vraie. Ici, 177 passagers n’ont pas d’âge connu, et ils ne sont retournés ni par age >= 18 ni par age < 18 :
print("Passagers dont l'âge est inconnu :", titanic.age.isna().sum())
print("Lignes avec age >= 18 :", (titanic.age >= 18).sum())
print("Lignes avec age < 18 :", (titanic.age < 18).sum())Passagers dont l'âge est inconnu : 177
Lignes avec age >= 18 : 601
Lignes avec age < 18 : 113Comment trier les résultats avec ORDER BY et sort_values() ?
Poursuivons : nous voulons maintenant trier les résultats d'abord par tarif (par ordre décroissant), puis par âge (par ordre croissant). Les entrées qui ont le même tarif seront donc triées avec les plus jeunes en premier.
En SQL
L'instruction ORDER BY se place après WHERE. Le tri par défaut est ascendant. Pour que les plus grandes valeurs apparaissent en premier, on ajoute le mot-clé DESC.
SELECT pclass, fare, age, survived
FROM titanic
WHERE sex = 'male' AND age >= 18
ORDER BY fare DESC, ageAvec pandas
Nous utilisons sort_values(). On lui passe la liste des colonnes à trier, la hiérarchie du tri suivant l'ordre de la liste. Le paramètre ascending vaut True par défaut : on peut lui passer une liste de booléens, un par colonne, dans le même ordre.
df_slice = titanic.loc[male_mask & age_mask, col_list]
df_slice.sort_values(['fare', 'age'], ascending=[False, True]) pclass fare age survived
737 1 512.3292 35.0 1
679 1 512.3292 36.0 1
27 1 263.0000 19.0 0
438 1 263.0000 64.0 0
.. ... ... ... ...
822 1 0.0000 38.0 0
806 1 0.0000 39.0 0
263 1 0.0000 40.0 0
597 3 0.0000 49.0 0
[395 rows x 4 columns]Les index à gauche (737, 679, 27…) sont ceux du DataFrame d'origine : pandas les conserve après un tri ou un filtre. Autre différence avec SQL : à égalité sur les colonnes du tri, l'ordre des lignes n'est pas garanti et peut différer d'un moteur à l'autre. Ne compte donc sur l'ordre que pour les colonnes que tu as listées dans le tri.
Une remarque sur les copies. Avec pandas 3, modifier une tranche de DataFrame ne modifie jamais le DataFrame d'origine (c'est la « copie sur écriture ») : tu n'as plus besoin d'enchaîner un .copy() après loc[]. Avec pandas 2 et les versions antérieures, la règle était moins claire et pandas affichait parfois un SettingWithCopyWarning. Voici la preuve avec pandas 3 : on remplace tous les tarifs de la tranche par 0, et le DataFrame d'origine reste intact.
df_slice = titanic.loc[male_mask & age_mask, col_list]
df_slice.loc[:, 'fare'] = 0
print("Tarif max dans la tranche :", df_slice.fare.max())
print("Tarif max dans titanic :", titanic.fare.max())Tarif max dans la tranche : 0.0
Tarif max dans titanic : 512.3292Comment limiter les résultats avec LIMIT et head() ?
Dernier élément de notre problème : limiter les résultats aux 10 premières entrées.
En SQL
C'est très simple : il suffit d'ajouter l'instruction LIMIT suivie du nombre d'entrées voulu, ici 10.
SELECT pclass, fare, age, survived
FROM titanic
WHERE sex = 'male' AND age >= 18
ORDER BY fare DESC, age
LIMIT 10Avec pandas
Enchaîne un head() à la fin, avec le nombre d'entrées voulu entre parenthèses.
df_slice = titanic.loc[male_mask & age_mask, col_list]
df_slice.sort_values(['fare', 'age'], ascending=[False, True]).head(10) pclass fare age survived
737 1 512.3292 35.0 1
679 1 512.3292 36.0 1
27 1 263.0000 19.0 0
438 1 263.0000 64.0 0
.. ... ... ... ...
332 1 153.4625 38.0 0
373 1 135.6333 22.0 0
660 1 133.6500 50.0 1
390 1 120.0000 36.0 1
[10 rows x 4 columns]Pandas propose aussi nlargest() et nsmallest(), qui trient et limitent en une seule méthode. Dans notre problème, une colonne est triée par ordre décroissant et l'autre par ordre croissant : elles ne conviennent donc pas. Mais pour trier fare et age tous les deux par ordre croissant, nsmallest() est un cas d'usage valide :
df_slice.nsmallest(10, ['fare', 'age']) pclass fare age survived
302 3 0.0000 19.0 0
271 3 0.0000 25.0 1
179 3 0.0000 36.0 0
822 1 0.0000 38.0 0
.. ... ... ... ...
597 3 0.0000 49.0 0
378 3 4.0125 20.0 0
872 1 5.0000 33.0 0
326 3 6.2375 61.0 0
[10 rows x 4 columns]Quelles fonctions d'agrégation utiliser en SQL et en pandas ?
Supposons que nous voulions des statistiques sur les données : le prix maximum et minimum payé, l'âge moyen des passagers et le nombre de survivants.
En SQL
Tu peux utiliser AVG(), COUNT(), MIN(), MAX() et SUM(), en mettant entre parenthèses la colonne à laquelle tu veux appliquer la fonction. Ces fonctions ignorent les valeurs nulles. Voici ce que cela donne pour notre problème :
SELECT MAX(fare), MIN(fare), AVG(age), SUM(survived)
FROM titanicLa colonne survived est codée 1 pour ceux qui ont survécu et 0 pour les autres : SUM() donne donc le total des survivants, ici 342. Pour des résultats plus lisibles, utilise ROUND() : ROUND(AVG(age), 1) arrondit l'âge moyen à une décimale.
Un inconvénient de SQL : les fonctions d'agrégation ci-dessus sont les seules fonctions standard. Il n'existe pas de moyen aussi direct de calculer la médiane ou l'écart type d'une colonne. Certains moteurs ajoutent leurs propres fonctions : renseigne-toi sur celui que tu utilises.
Avec pandas
Pandas ignore aussi les valeurs nulles par défaut (un paramètre permet de les inclure). Pour des agrégations précises, on calcule chacune individuellement. agg() accepte une liste : ici, le maximum et le minimum de fare en une ligne.
print(titanic.fare.agg(['max', 'min']))
print("Âge moyen :", titanic.age.mean())
print("Survivants :", titanic.survived.sum())max 512.3292
min 0.0000
Name: fare, dtype: float64
Âge moyen : 29.69911764705882
Survivants : 342Comme en SQL, tu peux arrondir, avec la méthode round() :
print(titanic.age.mean().round(1))29.7Pandas dispose de beaucoup plus de fonctions d'agrégation que le SQL standard : la médiane (median()), l'écart type (std()), la variance (var())…
print("Médiane de l'âge :", titanic.age.median())
print("Écart type de l'âge :", round(titanic.age.std(), 2))
print("Variance de l'âge :", round(titanic.age.var(), 2))Médiane de l'âge : 28.0
Écart type de l'âge : 14.53
Variance de l'âge : 211.02La méthode describe(), qui renvoie un tableau récapitulatif des colonnes numériques, est un atout majeur de pandas. Le code titanic.describe() renvoie le tableau ci-dessous :
titanic.describe()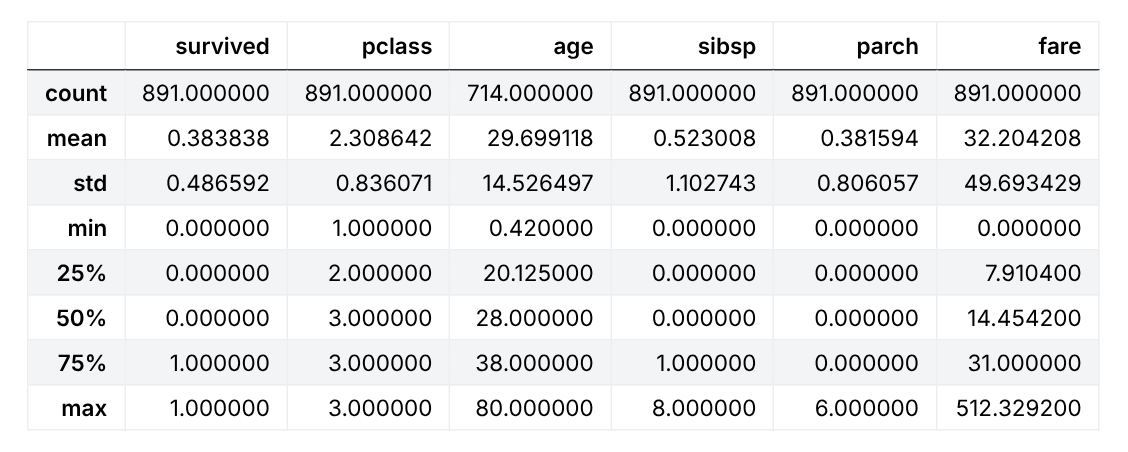
C'est plus d'informations que ce qui était demandé, mais cela ne coûte qu'une ligne de code. Tu peux obtenir les mêmes informations pour les colonnes de texte avec titanic.describe(include=["object", "string"]). Pourquoi deux types ? Avec pandas 2, les colonnes de texte ont le type object. Avec pandas 3, elles ont un type str dédié, que "string" sélectionne : cette écriture fonctionne donc dans les deux versions, sans avertissement.
titanic.describe(include=["object", "string"])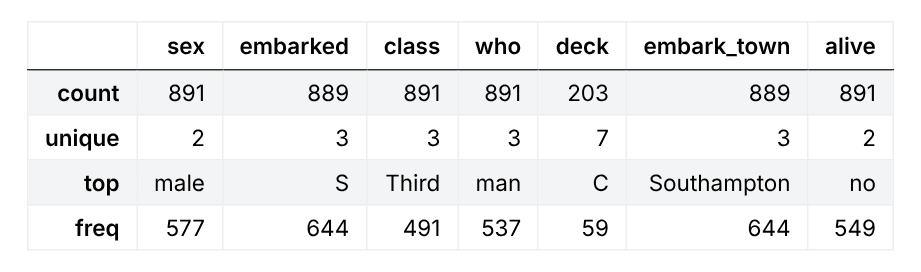
La méthode agg() offre aussi plus de flexibilité : tu peux agréger avec une fonction personnalisée si tu le souhaites.
Comment regrouper des données avec GROUP BY et groupby() ?
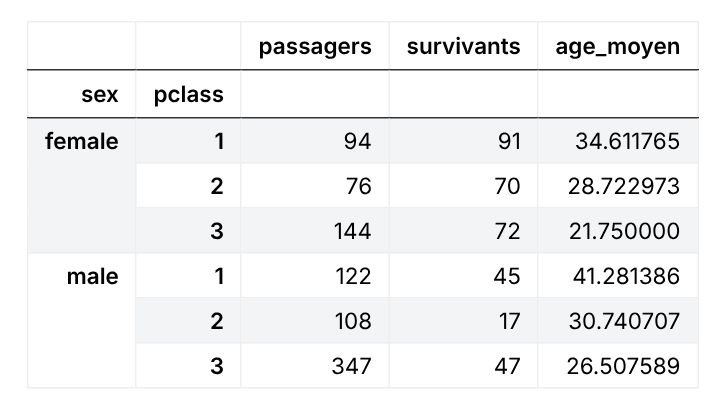
Disons que nous voulons des données agrégées pour les hommes et les femmes de chaque classe : le nombre de passagers, le nombre de survivants et l'âge moyen.
En SQL
La clause GROUP BY sert à cela. Voici à quoi elle ressemble :
SELECT sex, pclass, COUNT(*), SUM(survived), AVG(age)
FROM titanic
GROUP BY sex, pclassComme nous retournons des colonnes qui ne sont pas des valeurs agrégées (sex, pclass), la requête a besoin de la clause GROUP BY : avec un regroupement par sexe et par classe, les colonnes agrégées sont calculées pour chaque combinaison (femmes en première classe, hommes en première classe, femmes en deuxième classe, etc.). Voici le résultat, une fois la requête exécutée avec sql() :
sql("""
SELECT sex, pclass, COUNT(*), SUM(survived), AVG(age)
FROM titanic
GROUP BY sex, pclass
""") sex pclass COUNT(*) SUM(survived) AVG(age)
0 female 1 94 91 34.611765
1 female 2 76 70 28.722973
2 female 3 144 72 21.750000
3 male 1 122 45 41.281386
4 male 2 108 17 30.740707
5 male 3 347 47 26.507589Avec pandas
La méthode groupby() permet d'obtenir le résultat voulu. On peut obtenir chaque élément individuellement :
print(titanic.groupby(['sex', 'pclass']).survived.agg(['count', 'sum']))
print(titanic.groupby(['sex', 'pclass']).age.mean()) count sum
sex pclass
female 1 94 91
2 76 70
3 144 72
male 1 122 45
2 108 17
3 347 47
sex pclass
female 1 34.611765
2 28.722973
3 21.750000
male 1 41.281386
2 30.740707
3 26.507589
Name: age, dtype: float64On peut aussi générer un seul tableau en découpant d'abord les colonnes utiles, puis en appliquant plusieurs fonctions d'agrégation. Il contient plus d'informations que demandé :
new_df = titanic.groupby(['sex', 'pclass'])[['survived', 'age']]
new_df.agg(['count', 'sum', 'mean'])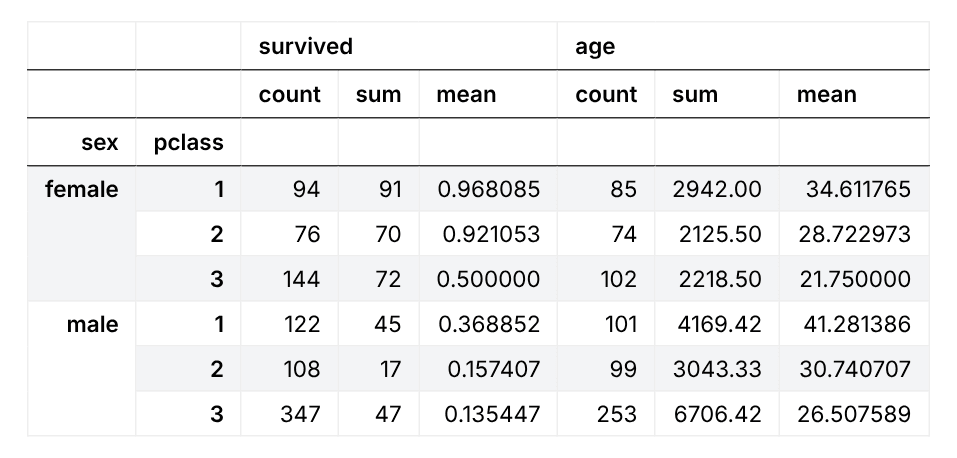
Parfois ces informations supplémentaires sont un bonus, parfois elles créent de la confusion. Par exemple, les comptes de survived et de age sont différents : c'est parce que la colonne age contient des valeurs nulles. Les comptes de survived sont donc les vrais effectifs de chaque groupe. En revanche, la moyenne de survived indique le pourcentage de survivants dans chaque groupe (96,8 % des femmes de première classe contre 13,5 % des hommes de troisième classe), une information qui ajoute de la valeur à l'analyse.
Pour obtenir exactement les colonnes demandées, avec le nom de ton choix, utilise les agrégations nommées : chaque argument de agg() a la forme nom=('colonne', 'fonction'). C'est l'équivalent pandas de SELECT COUNT(*) AS passagers. Pour compter les lignes comme COUNT(*), utilise la fonction 'size' ; 'count' ignore les valeurs nulles.
titanic.groupby(['sex', 'pclass']).agg(
    passagers=('survived', 'size'),
    survivants=('survived', 'sum'),
    age_moyen=('age', 'mean'),
)
Que deviennent les valeurs manquantes dans un regroupement ?
C'est la différence la plus piégeuse entre les deux outils. Dans la colonne embarked (le port d'embarquement), 2 passagers n'ont pas de valeur. SQL les regroupe dans un groupe NULL :
sql("""
SELECT embarked, COUNT(*)
FROM titanic
GROUP BY embarked
""") embarked COUNT(*)
0 NaN 2
1 C 168
2 Q 77
3 S 644Pandas, lui, écarte par défaut les lignes dont la clé de regroupement est manquante : ces 2 passagers disparaissent du résultat, sans aucun message.
titanic.groupby('embarked').size()embarked
C 168
Q 77
S 644
dtype: int64Pour obtenir le même comportement que SQL, ajoute dropna=False :
titanic.groupby('embarked', dropna=False).size()embarked
C 168
Q 77
S 644
NaN 2
dtype: int64Retiens ce réflexe : quand les totaux de ton groupby() ne tombent pas juste (ici 889 au lieu de 891), regarde d'abord les valeurs manquantes de la clé de regroupement.
Comment vérifier que SQL et pandas donnent le même résultat ?
Puisque nous avons les deux outils sous la main avec sql(), autant s'en servir pour contrôler nos réponses. La fonction ci-dessous exécute une requête SQL, la compare au résultat pandas avec pd.testing.assert_frame_equal() et renvoie True s'ils sont identiques (elle trie d'abord les lignes, car l'ordre des ex æquo peut différer).
import numpy as np

def meme_resultat(requete, resultat):
    a = sql(requete)
    b = resultat.copy()
    b.columns = a.columns
    # SQL renvoie None là où pandas met NaN : on harmonise avant de comparer
    a = a.where(a.notna(), np.nan)
    # à égalité sur la clé de tri, l'ordre des lignes peut différer : on compare les lignes triées
    a = a.sort_values(list(a.columns)).reset_index(drop=True)
    b = b.sort_values(list(b.columns)).reset_index(drop=True)
    pd.testing.assert_frame_equal(a, b, check_dtype=False)
return Truememe_resultat(
"SELECT pclass, fare, age, survived FROM titanic WHERE sex = 'male' AND age >= 18 ORDER BY fare DESC, age LIMIT 10",
df_slice.sort_values(['fare', 'age'], ascending=[False, True]).head(10))TrueJe l'ai utilisée pour vérifier les corrections des six problèmes ci-dessous : les six donnent True (le quatrième n'y arrive qu'avec dropna=False).
Exercices pratiques : à toi de jouer !
Voici six problèmes à résoudre en SQL et en pandas. Essaie de les résoudre avant de regarder les corrections plus bas.
Sélectionner, filtrer et trier
- Affiche les colonnes
age,sexetsurvivedpour les enfants de moins de 16 ans qui n'ont pas de parent voyageant avec eux (valeur 0 dans la colonneparch). Trie les résultats par âge croissant. - Affiche
pclass,ageetfarepour les femmes en classe 2 ou 3. Trie les résultats par âge décroissant, puis par tarif décroissant, et limite-toi aux 20 premières entrées. - Affiche toutes les colonnes pour les enfants (moins de 18 ans) en classe 3 qui ont survécu. Trie les résultats par âge croissant, puis par tarif décroissant. La colonne
survivedcontient 1 pour oui et 0 pour non.
Agréger et regrouper
- Trouve le prix moyen du billet et le nombre de passagers, regroupés par port d'embarquement et par classe.
- Trouve l'âge minimum, maximum et moyen des passagers, regroupés par classe et par survie.
- Trouve le prix moyen du billet, l'âge minimum et l'âge maximum des passagers, regroupés par survie.
Corrections des 6 problèmes
As-tu essayé de résoudre chaque problème avant de regarder la correction ? Tes réponses seront probablement un peu différentes des miennes : il y a souvent plusieurs façons de résoudre un problème.
Problème 1
SQL
SELECT age, sex, survived
FROM titanic
WHERE age < 16 AND parch = 0
ORDER BY agePandas
children = titanic.age < 16
parents = titanic.parch == 0
col_list = ['age', 'sex', 'survived']

titanic.loc[children & parents, col_list].sort_values('age') age sex survived
777 5.0 female 1
731 11.0 male 0
125 12.0 male 1
780 13.0 female 1
.. ... ... ...
111 14.5 female 0
22 15.0 female 1
830 15.0 female 1
875 15.0 female 1
[11 rows x 3 columns]Trois enfants de 15 ans apparaissent : à égalité d'âge, SQL et pandas peuvent les ranger dans un ordre différent, ce qui est normal.
Problème 2
SQL
SELECT pclass, age, fare
FROM titanic
WHERE sex = 'female' AND pclass != 1
ORDER BY age DESC, fare DESC
LIMIT 20Pandas
females = titanic.sex == 'female'
lower_class = titanic.pclass != 1
col_list = ['pclass', 'age', 'fare']

df_slice = titanic.loc[females & lower_class, col_list]
df_slice.nlargest(20, ['age', 'fare']) pclass age fare
483 3 63.0 9.5875
772 2 57.0 10.5000
15 2 55.0 16.0000
774 2 54.0 23.0000
.. ... ... ...
678 3 43.0 46.9000
432 2 42.0 26.0000
865 2 42.0 13.0000
638 3 41.0 39.6875
[20 rows x 3 columns]Ici nlargest() trie et limite en une seule méthode, car les deux colonnes sont triées dans le même sens (décroissant).
Problème 3
SQL
SELECT *
FROM titanic
WHERE age < 18 AND pclass = 3 AND survived = 1
ORDER BY age, fare DESCPandas
children = titanic.age < 18
low_class = titanic.pclass == 3
survival = titanic.survived == 1

df_slice = titanic.loc[children & low_class & survival, :]
df_slice.sort_values(['age', 'fare'], ascending=[True, False]) survived pclass sex age ... deck embark_town alive alone
803 1 3 male 0.42 ... NaN Cherbourg yes False
469 1 3 female 0.75 ... NaN Cherbourg yes False
644 1 3 female 0.75 ... NaN Cherbourg yes False
788 1 3 male 1.00 ... NaN Southampton yes False
.. ... ... ... ... ... ... ... ... ...
220 1 3 male 16.00 ... NaN Southampton yes True
208 1 3 female 16.00 ... NaN Queenstown yes True
156 1 3 female 16.00 ... NaN Queenstown yes True
68 1 3 female 17.00 ... NaN Southampton yes False
[29 rows x 15 columns]Sur 15 colonnes, pandas n'en affiche que les premières et les dernières, avec des points de suspension au milieu.
Problème 4
SQL
SELECT embarked, pclass, COUNT(*), AVG(fare)
FROM titanic
GROUP BY embarked, pclassPandas
titanic.groupby(['embarked', 'pclass'], dropna=False).agg(
    passagers=('fare', 'size'),
    prix_moyen=('fare', 'mean'),
) passagers prix_moyen
embarked pclass
C 1 85 104.718529
2 17 25.358335
3 66 11.214083
Q 1 2 90.000000
... ... ...
S 1 127 70.364862
2 164 20.327439
3 353 14.644083
NaN 1 2 80.000000
[10 rows x 2 columns]Deux remarques. 'size' compte toutes les lignes du groupe, comme COUNT(*). Et dropna=False garde les 2 passagers sans port d'embarquement, comme le fait SQL (leur groupe apparaît en dernier dans pandas, en premier avec SQLite).
Problème 5
SQL
SELECT pclass, survived, MIN(age), MAX(age), AVG(age)
FROM titanic
GROUP BY pclass, survivedPandas
titanic.groupby(['pclass', 'survived']).age.agg(['min', 'max', 'mean']) min max mean
pclass survived
1 0 2.00 71.0 43.695312
1 0.92 80.0 35.368197
2 0 16.00 70.0 33.544444
1 0.67 62.0 25.901566
3 0 1.00 74.0 26.555556
1 0.42 63.0 20.646118Problème 6
SQL
SELECT survived, AVG(fare), MIN(age), MAX(age)
FROM titanic
GROUP BY survivedPandas
titanic.groupby('survived').agg(
    prix_moyen=('fare', 'mean'),
    age_min=('age', 'min'),
    age_max=('age', 'max'),
) prix_moyen age_min age_max
survived
0 22.117887 1.00 74.0
1 48.395408 0.42 80.0Questions fréquentes
Quelle est la différence entre SQL et pandas ?
SQL est un langage pour interroger des bases de données : on décrit le résultat voulu et le moteur choisit comment le calculer. Pandas est une bibliothèque Python qui manipule des tableaux (DataFrames) en mémoire, avec des méthodes enchaînées. Les deux savent sélectionner, filtrer, trier, agréger et regrouper : SELECT, WHERE, ORDER BY, LIMIT et GROUP BY correspondent à loc[], sort_values(), head() et groupby().
Quel est l'équivalent de WHERE dans pandas ?
Un masque booléen passé à loc[], par exemple titanic.loc[titanic.age >= 18], ou la méthode query() : titanic.query("age >= 18"). Pour combiner plusieurs conditions, utilise & (et), | (ou) et ~ (non), avec des parenthèses autour de chaque condition.
Comment exécuter une requête SQL avec pandas ?
Ouvre une connexion à une base de données (avec sqlite3 pour SQLite, par exemple) puis appelle pd.read_sql_query(requete, connexion) : le résultat est un DataFrame. Pour envoyer un DataFrame dans une table, utilise df.to_sql('table', connexion, index=False).
Pourquoi mon groupby() pandas ne donne-t-il pas les mêmes totaux que GROUP BY ?
Parce que pandas écarte par défaut les lignes dont la clé de regroupement est manquante, alors que SQL les regroupe dans un groupe NULL. Ajoute dropna=False à groupby() pour obtenir le même comportement que SQL.
Pandas ou SQL : lequel choisir ?
SQL est le bon choix quand les données sont dans une base : le calcul se fait là où elles sont stockées, sans tout charger en mémoire. Pandas est plus souple pour explorer, nettoyer et transformer des données déjà chargées, avec beaucoup plus de fonctions statistiques (médiane, écart type, describe()…). En pratique, on combine les deux.
SQL peut-il calculer une médiane ou un écart type ?
Pas avec les fonctions standard, qui se limitent à AVG(), COUNT(), MIN(), MAX() et SUM(). Certains moteurs de bases de données ajoutent leurs propres fonctions statistiques, à chercher dans leur documentation. Avec pandas, median(), std() et var() sont disponibles directement.
Conclusion
SQL et pandas sont très différents, mais ils accomplissent les mêmes tâches. À retenir : pour sélectionner, filtrer, trier et limiter, ils se répondent presque terme à terme ; pour agréger, pandas propose beaucoup plus de fonctions que le SQL standard ; et pour les regroupements, pense aux valeurs manquantes (dropna=False) et à l'ordre des ex æquo. Pour t'entraîner, refais les exercices dans l'autre langage que celui que tu as utilisé en premier.
Lire des comparaisons aide, mais c'est en écrivant les requêtes toi-même que la syntaxe devient un réflexe. Sur DataXp, tu t'entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin :