
Pour exceller en analyse de données, en data science et en Machine Learning avec Python, pandas est la bibliothèque que tu dois maîtriser. Voici une antisèche, ou un glossaire, des syntaxes les plus utilisées, à connaître sur le bout des doigts. Utilise la table des matières pour aller directement à la partie qui t’intéresse.
Aujourd’hui, pandas est l’outil le plus fondamental du domaine de la data science et de l’analyse de données en Python. Les outils de Machine Learning et de visualisation attirent l’attention, mais tu n’iras pas loin sans de bonnes bases sur pandas. J’ai donc rassemblé les fonctions les plus utilisées : la création d’un DataFrame (une table de données), puis l’ajout et la suppression de lignes et de colonnes, les valeurs manquantes, le remodelage des données, l’observation, le tri et la recherche.
Article mis à jour en octobre 2026 : tout le code est testé avec Python 3.13, sous pandas 3 et sous pandas 2.3 (la version de Google Colab), et tous les résultats sont de vraies exécutions sous pandas 3. Avec pandas 2, seuls de petits détails d’affichage changent, par exemple le type object au lieu de str dans info(). df.append() n’existe plus (remplacé par pd.concat()), fillna(df.mean()) demande numeric_only=True dès qu’une colonne contient du texte, et les résultats aléatoires utilisent random_state. J’ai aussi corrigé la requête SQL équivalente de groupby() et le passage sur les gros fichiers.
En bref : ce mémo pandas rassemble l’essentiel pour traiter un DataFrame. Il se crée avec pd.DataFrame() à partir d’une liste ou d’un dictionnaire. On renomme avec rename(), on supprime avec drop(), on traite les valeurs manquantes avec isnull(), dropna() et fillna(), on remodèle avec melt(), concat() et groupby(), on observe avec head(), info() et describe(), puis on trie et on filtre avec sort_values(), query(), loc[] et les masques booléens.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys, pandas as pd

print("Python", sys.version.split()[0])
print("pandas", pd.__version__)Python 3.13.16
pandas 3.0.5Comment créer un DataFrame avec pandas ?
Dans pandas, chaque variable est stockée sous forme de colonne, et toutes les observations liées à cette variable sont stockées sous forme de lignes. Si tu as 20 observations pour une variable A, tu auras une « colonne A » de 20 lignes.
Création d’un DataFrame vide
# 4 îles des Canaries
col = ['Lanzarote', 'Fuerteventura', 'La Gomera', 'El Hierro']
df = pd.DataFrame(columns=col)
dfEmpty DataFrame
Columns: [Lanzarote, Fuerteventura, La Gomera, El Hierro]
Index: []Le résultat est un DataFrame sans ligne mais avec ses colonnes, comme le confirme shape : 0 ligne, 4 colonnes.
print(df.shape)
print(list(df.columns))(0, 4)
['Lanzarote', 'Fuerteventura', 'La Gomera', 'El Hierro']Création d’un DataFrame à partir d’une liste
Chaque sous-liste est une ligne. On donne les noms de colonnes avec columns et les étiquettes de lignes avec index.
col = ['Lanzarote', 'Fuerteventura', 'La Gomera', 'El Hierro']
ind = [2000, 2010, 2020]
data = [[98731, 34444, 99384, 654],
        [34323, 44243, 88543, 3451],
        [2222, 4324, 3432, 19344]]
df = pd.DataFrame(data, columns=col, index=ind)
df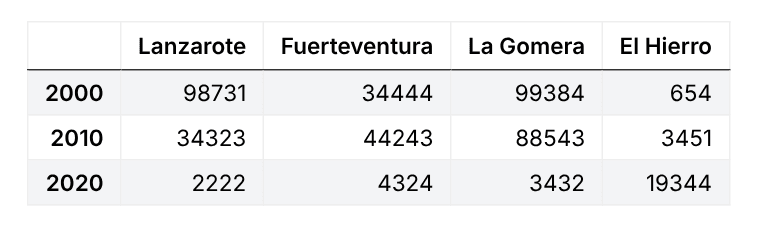
Création d’un DataFrame à partir d’un dictionnaire
Chaque clé du dictionnaire devient une colonne, et sa valeur est la liste des observations.
data = {'A': [98731, 34444, 99384],
        'B': [34323, 44243, 88543],
        'C': [2222, 4324, None]}
df = pd.DataFrame(data)
df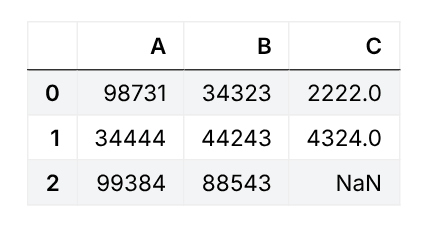
Pour représenter une valeur vide, on peut écrire None : dans une colonne numérique, pandas la convertit en NaN (Not a Number) et la colonne passe au type décimal float64, d’où le 2222.0 au lieu de 2222.
df.dtypesLanzarote int64
B int64
C float64
D str
dtype: objectJe te conseille d’écrire np.nan (avec import numpy as np) plutôt que None quand tu ajoutes une valeur vide dans une colonne numérique existante : tu verras pourquoi plus bas.
Comment renommer, insérer et supprimer des colonnes et des lignes ?
Renommer une colonne
df = df.rename(columns={'A': 'Lanzarote'})
df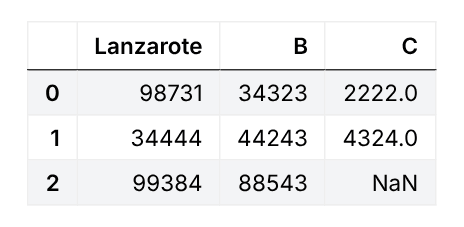
Insérer une colonne
Il suffit d’assigner une liste de même longueur à un nouveau nom de colonne.
# insertion de la colonne D
d = ['x', 'y', 'z']

df['D'] = d
df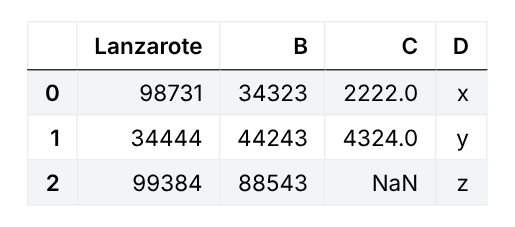
Insérer une ligne
Attention : la méthode df.append(), souvent utilisée dans les anciens tutoriels, a été supprimée de pandas (version 2.0). Elle lève maintenant une erreur :
try:
    df.append(new_row, ignore_index=True)
except AttributeError as e:
print(e)'DataFrame' object has no attribute 'append'On utilise pd.concat() à la place, en transformant la nouvelle ligne en DataFrame d’une ligne. Avec ignore_index=True, pandas renumérote les lignes de 0 à 3.
import numpy as np

# insertion d'une 4e ligne
new_row = {'Lanzarote': 98989, 'B': 77889, 'C': np.nan, 'D': 'z'}

df = pd.concat([df, pd.DataFrame([new_row])], ignore_index=True)
df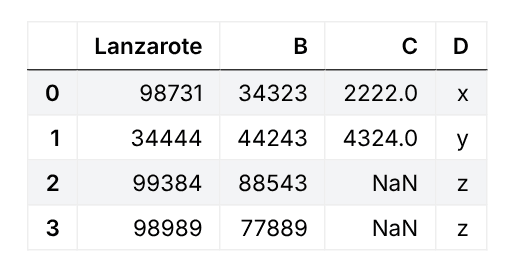
Pourquoi np.nan et pas None dans la nouvelle ligne ? Avec None, la colonne C perd son type float64 et devient de type object : les fonctions numériques comme mean() l’ignorent alors silencieusement, et fillna() ne fait pas ce que tu attends.
Retirer une colonne
Avec drop(), axis=1 désigne les colonnes. Pour changer le DataFrame de façon permanente, réaffecte la variable : df = df.drop(...).
# suppression de la colonne C uniquement
df.drop('C', axis=1)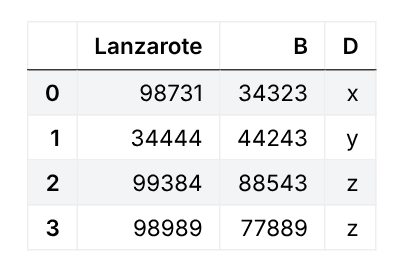
Pour retirer plusieurs colonnes, passe une liste :
df.drop(['C', 'B'], axis=1)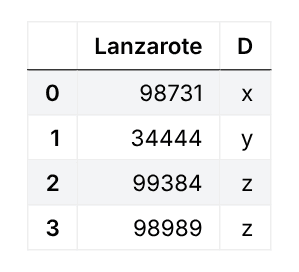
Retirer une ligne
Sans axis, drop() travaille sur les lignes, désignées par leur étiquette d’index.
# suppression de la ligne dont l'index est 0
df.drop(0)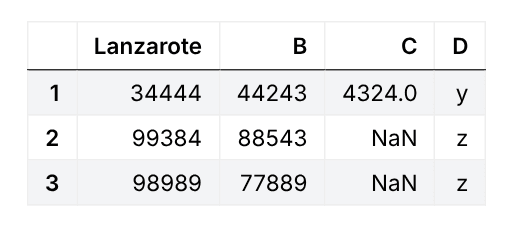
Éliminer les doublons
df.drop_duplicates()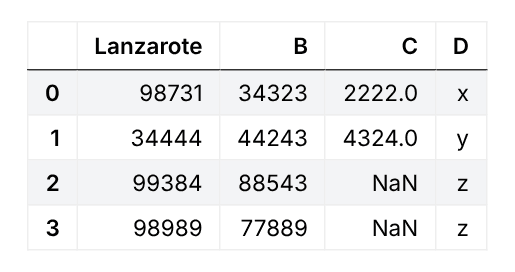
Notre DataFrame reste le même, car il n’a pas de doublon. duplicated() permet de les repérer : voici le test en ajoutant volontairement une ligne répétée.
print("Doublons :", df.duplicated().sum())
df2 = pd.concat([df, df.iloc[[0]]], ignore_index=True)
print("Avec une ligne répétée :", df2.duplicated().sum())
df2.drop_duplicates(ignore_index=True).shapeDoublons : 0
Avec une ligne répétée : 1
(4, 4)Comment traiter les valeurs manquantes avec pandas ?
Le plus souvent, les données contiennent des valeurs nulles (ou vides). En général, on les supprime ou on les remplace par une valeur significative, comme la moyenne de la colonne.
Vérifier les valeurs nulles
pd.isnull(df)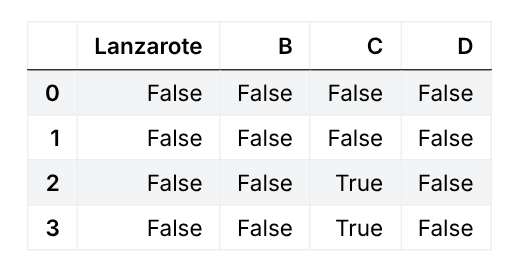
df.isnull() et df.isna() sont équivalents à pd.isnull(df). On voit 2 valeurs nulles dans la colonne C ; sum() les compte directement :
df.isnull().sum()Lanzarote 0
B 0
C 2
D 0
dtype: int64Repérer les valeurs nulles par colonne ou par ligne
Avec any(axis=0), on obtient une réponse par colonne : la colonne contient-elle au moins une valeur nulle ?
# une valeur par colonne : la colonne contient-elle au moins un NaN ?
pd.isnull(df).any(axis=0)Lanzarote False
B False
C True
D False
dtype: boolAvec any(axis=1), on obtient une réponse par ligne :
# une valeur par ligne : la ligne contient-elle au moins un NaN ?
pd.isnull(df).any(axis=1)0 False
1 False
2 True
3 True
dtype: boolSupprimer les lignes qui contiennent des valeurs nulles
df.dropna()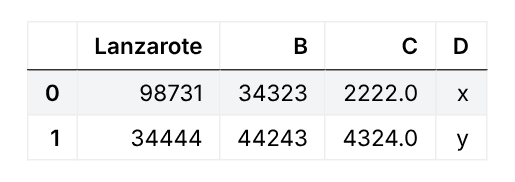
Remplir les valeurs manquantes avec des valeurs significatives
On peut remplir avec une constante (0), avec la moyenne de chaque colonne ou avec le maximum d’une colonne. Avec pandas 3, df.mean() échoue dès que le DataFrame contient une colonne de texte (ici D) : ajoute numeric_only=True.
df2 = df.copy()

df3 = df2.fillna(0)                                 # remplir avec 0
df4 = df2.fillna(df.mean(numeric_only=True))        # remplir avec la moyenne de chaque colonne
df5 = df2.fillna(df.B.max())                        # remplir avec le max de la colonne B

df4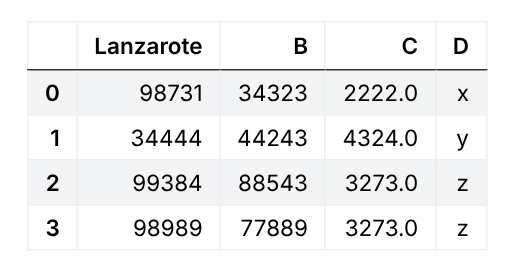
try:
    df2.fillna(df.mean())
except TypeError as e:
print(type(e).__name__, ":", e)TypeError : Cannot perform reduction 'mean' with string dtypeVoici ce que contient la colonne C selon la méthode de remplissage :
print(df3.C.tolist())
print(df4.C.tolist())
print(df5.C.tolist())[2222.0, 4324.0, 0.0, 0.0]
[2222.0, 4324.0, 3273.0, 3273.0]
[2222.0, 4324.0, 88543.0, 88543.0]Dans ce cas, le plus raisonnable est de remplir les NaN de la colonne C avec la moyenne de sa propre colonne (3273.0), la deuxième méthode.
Comment remodeler un DataFrame avec melt(), concat() et groupby() ?
La forme (ou dimension) des données est un autre problème courant. Chaque modèle de Machine Learning a ses exigences de forme : par exemple, un modèle LSTM prend des données tridimensionnelles, donc il faut souvent transformer des données bidimensionnelles en données tridimensionnelles.
Rassembler toutes les colonnes en une seule
pd.melt() rassemble toutes les colonnes et toutes les observations en deux colonnes : le nom de la variable et sa valeur.
pd.melt(df2)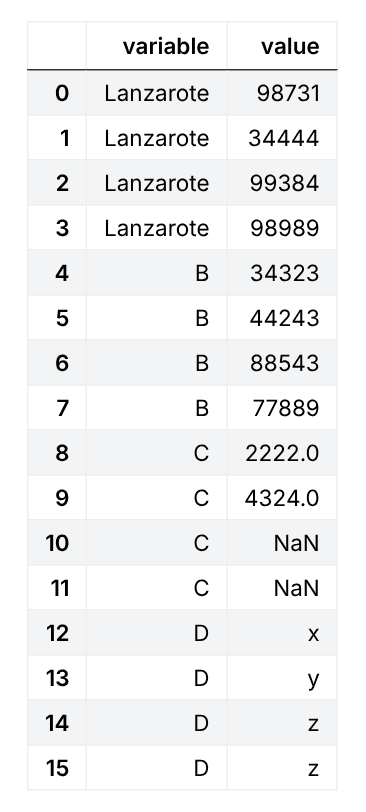
Pour aller plus loin sur ce sujet, lis 12 techniques utiles de manipulation de données avec la librairie Pandas.
Concat : empiler des DataFrames
Cette fonction est similaire à UNION ALL en SQL : elle empile les lignes qui ont le même nom de colonne.
pd.concat([df, df])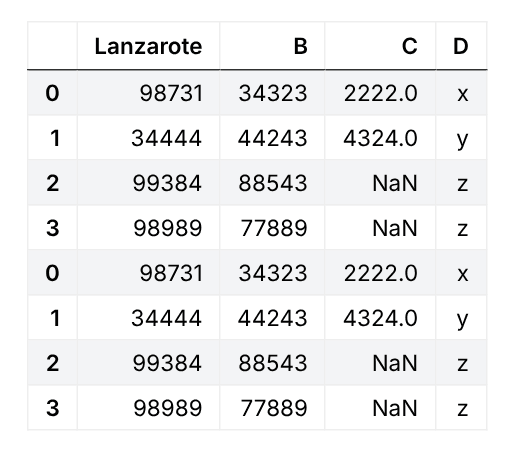
Les index sont répétés (0 à 3, puis 0 à 3). Pour les renuméroter, ajoute ignore_index=True :
pd.concat([df, df], ignore_index=True) Lanzarote B C D
0 98731 34323 2222.0 x
1 34444 44243 4324.0 y
2 99384 88543 NaN z
3 98989 77889 NaN z
4 98731 34323 2222.0 x
5 34444 44243 4324.0 y
6 99384 88543 NaN z
7 98989 77889 NaN zConcat : placer des DataFrames côte à côte
pd.concat([df, df], axis=1)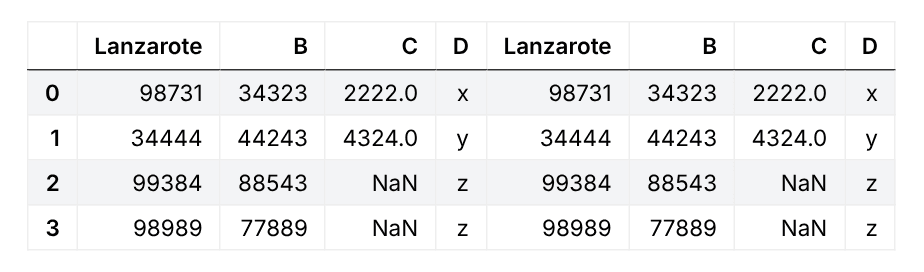
Groupby : regrouper et résumer
C’est une technique très populaire, que l’on retrouve dans de nombreux langages. Ici, on regroupe les lignes par les lettres de la colonne D et on affiche la somme de la colonne B pour chaque lettre. L’équivalent SQL est SELECT D, SUM(B) FROM df GROUP BY D.
# SELECT D, SUM(B) FROM df GROUP BY D
df.groupby('D')['B'].sum()D
x 34323
y 44243
z 166432
Name: B, dtype: int64Pour des exemples détaillés, lis GroupBy de pandas en 10 étapes.
Comment observer rapidement un DataFrame ?
Après avoir brassé et transformé les données, il est temps de vérifier ce que nous avons fait.
Afficher les premières lignes
head() affiche 5 lignes par défaut. Ici, nous demandons seulement les 3 premières.
df.head(3)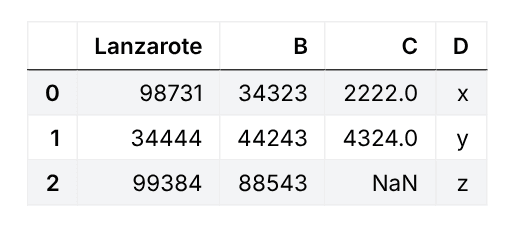
Afficher les dernières lignes
df.tail(2)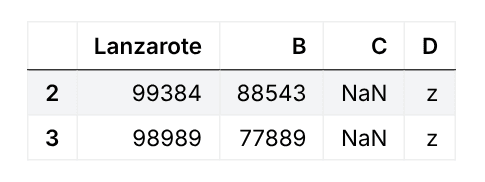
Afficher des lignes au hasard
Un échantillon aléatoire de 50 % des lignes. Avec random_state, le tirage est toujours le même : tu peux reproduire ton résultat. Sans lui, chaque exécution donne un résultat différent.
df.sample(frac=0.5, random_state=42)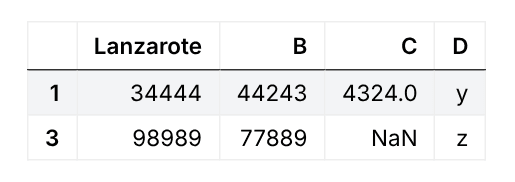
Afficher un résumé concis du DataFrame
info() donne le nombre de lignes, le type de chaque colonne et le nombre de valeurs non nulles : on y voit tout de suite que la colonne C n’a que 2 valeurs non nulles sur 4.
df.info()<class 'pandas.DataFrame'>
RangeIndex: 4 entries, 0 to 3
Data columns (total 4 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Lanzarote 4 non-null int64
1 B 4 non-null int64
2 C 2 non-null float64
3 D 4 non-null str
dtypes: float64(1), int64(2), str(1)
memory usage: 264.0 bytesGénérer des statistiques descriptives
C’est une méthode simple pour repérer visuellement les variables qui ont des valeurs aberrantes (outliers). Par défaut, describe() ne décrit que les colonnes numériques : la colonne D, qui contient du texte, n’apparaît pas. Pour les colonnes de texte, utilise describe(include="str").
df.describe()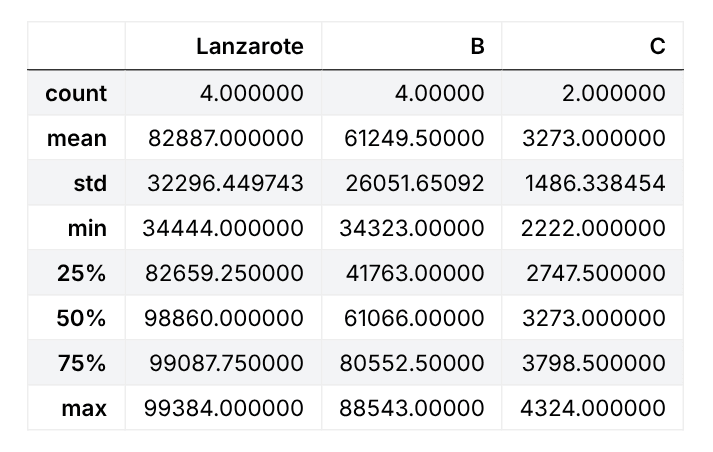
Comment trier et filtrer un DataFrame ?
Une fois le DataFrame dans la bonne forme, on veut en extraire des informations. Pandas partage plusieurs idées avec SQL.
Trier les valeurs
Le tri par défaut est ascendant, comme avec ORDER BY en SQL. Pour un tri décroissant, passe ascending=False.
df.sort_values('Lanzarote', ascending=False)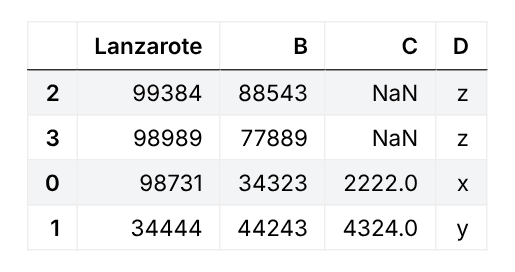
Réinitialiser l’index
Après un tri, l’index n’est plus dans l’ordre. reset_index(drop=True) le renumérote de 0 à n−1 :
df.sort_values('Lanzarote', ascending=False).reset_index(drop=True)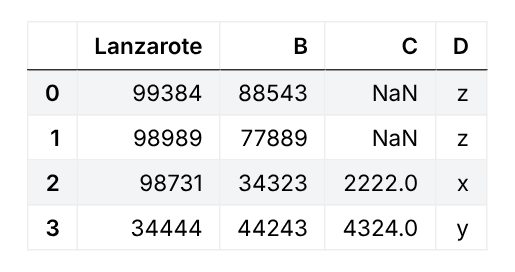
Sans drop=True, l’ancien index est conservé dans une nouvelle colonne index :
df.sort_values('Lanzarote', ascending=False).reset_index()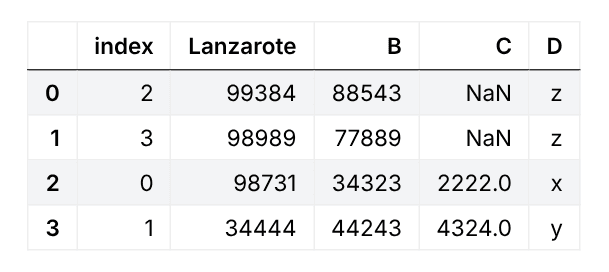
Filtrer avec une condition
La méthode query() accepte la condition sous forme de texte. Ici, B doit être supérieur ou égal à 50000.
# B doit être supérieur ou égal à 50000
df.query('B >= 50000')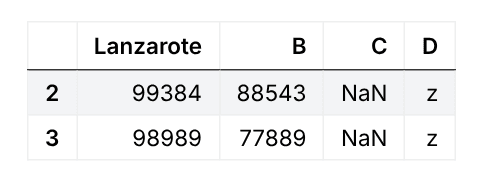
Cette écriture donne le même résultat, avec un masque booléen :
df[df['B'] >= 50000] Lanzarote B C D
2 99384 88543 NaN z
3 98989 77889 NaN zPour ne récupérer que la colonne C, utilise loc[] : la condition sur les lignes, puis le nom de la colonne.
df.loc[df['B'] >= 50000, 'C']2 NaN
3 NaN
Name: C, dtype: float64Seules 2 lignes de la colonne C sont affichées. Pour utiliser une variable Python dans query(), préfixe-la de @ :
seuil = 50000
df.query('B >= @seuil and Lanzarote < 99000') Lanzarote B C D
3 98989 77889 NaN zCombiner plusieurs conditions : ET, OU
Pour un « et », utilise & ; pour un « ou », utilise |. Les mots and et or ne fonctionnent pas sur des séries pandas, et chaque condition doit être entre parenthèses.
# B >= 50000 ET Lanzarote < 99000 : pas de "and", on utilise &
df[(df['B'] >= 50000) & (df['Lanzarote'] < 99000)]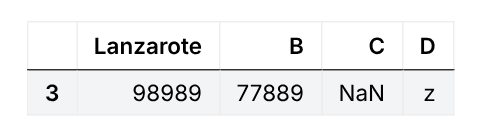
# B >= 50000 OU Lanzarote < 49000 : pas de "or", on utilise |
df[(df['B'] >= 50000) | (df['Lanzarote'] < 49000)]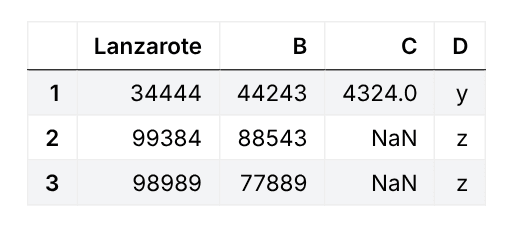
Rechercher du texte avec str.find() et str.contains()
Pour trouver une chaîne dans une colonne de texte, on utilise str.find() ou str.contains(). str.find() renvoie l’index de la première occurrence de la sous-chaîne, ou -1 si elle est absente. str.contains() renvoie True ou False. Ici, on cherche la lettre « z » dans la colonne D.
print(df['D'].str.find('z'))
print(df['D'].str.contains('z', case=False))0 -1
1 -1
2 0
3 0
Name: D, dtype: int64
0 False
1 False
2 True
3 True
Name: D, dtype: boolSélectionner des données avec loc et iloc
loc[] sélectionne avec les étiquettes (noms de lignes et de colonnes) et iloc[] avec les positions (numéros).
# toutes les lignes où D vaut 'z'
print(df.loc[df['D'] == 'z'])

# la ligne dont l'index est 0
print(df.loc[0])

# une valeur : étiquette de ligne et étiquette de colonne
print(df.loc[0, 'D'])

# une valeur : position de ligne et position de colonne
print(df.iloc[0, 3]) Lanzarote B C D
2 99384 88543 NaN z
3 98989 77889 NaN z
Lanzarote 98731
B 34323
C 2222.0
D x
Name: 0, dtype: object
x
xRechercher avec une expression régulière
De nombreuses méthodes de texte de pandas acceptent les expressions régulières : count(), replace(), contains(), extract(), findall(), match(), split() et rsplit(). Ici, on cherche les lignes dont la colonne D contient au moins une lettre minuscule.
# lignes dont la colonne D contient au moins une lettre minuscule
df[df['D'].str.contains(r'[a-z]+')]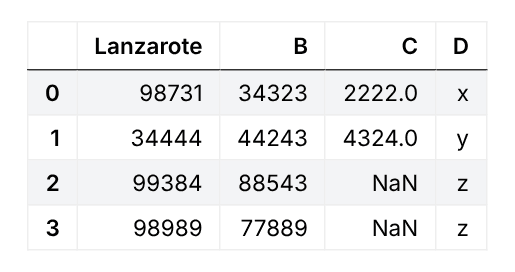
Il renvoie le DataFrame entier, car toutes les valeurs de la colonne D sont des lettres. Voici deux autres exemples, avec replace() et extract() :
print(df['D'].str.replace(r'[xy]', 'a', regex=True).tolist())
print(df['D'].str.extract(r'([a-z])')[0].tolist())['a', 'a', 'z', 'z']
['x', 'y', 'z', 'z']Trouver les plus grandes et les plus petites valeurs
nlargest() et nsmallest() trient et limitent en une seule méthode. Voici les 2 lignes qui ont les plus grandes valeurs de la colonne B :
df.nlargest(2, 'B')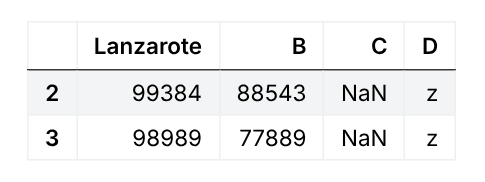
Et les 2 lignes qui ont les plus petites valeurs de la colonne B :
df.nsmallest(2, 'B')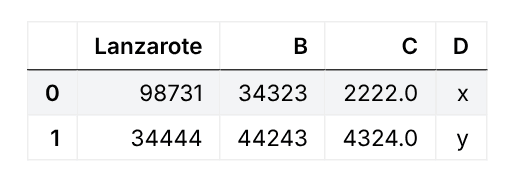
Comment lire un gros fichier CSV avec pandas ?
Excel est limité à 1 048 576 lignes par feuille, et il peut devenir lent bien avant. Pandas lit sans problème des millions de lignes, tant qu’elles tiennent dans la mémoire de ta machine. Pour les fichiers trop gros pour être chargés d’un coup, utilise chunksize : pandas lit alors le fichier par blocs, et tu traites un bloc à la fois. (Pour des volumes encore plus grands, il existe aussi des outils comme Dask ou Polars.)
Voici un test avec un fichier de 1 million de lignes (26 Mo), lu par blocs de 100 000 lignes pour calculer une moyenne :
import numpy as np, tempfile, os

rng = np.random.default_rng(0)
gros = pd.DataFrame({'id': np.arange(1_000_000), 'valeur': rng.random(1_000_000)})
chemin = os.path.join(tempfile.mkdtemp(), 'data.csv')
gros.to_csv(chemin, index=False)
print(round(os.path.getsize(chemin) / 1e6, 1), "Mo")26.2 Mototal, nb_lignes, nb_blocs = 0.0, 0, 0
for bloc in pd.read_csv(chemin, chunksize=100_000):
total += bloc['valeur'].sum()
nb_lignes += len(bloc)
nb_blocs += 1
print(nb_blocs, "blocs,", nb_lignes, "lignes")
print("Moyenne :", round(total / nb_lignes, 6))10 blocs, 1000000 lignes
Moyenne : 0.500159La moyenne obtenue par blocs est identique à celle d’un chargement complet :
print("Moyenne (chargement complet) :", round(pd.read_csv(chemin)['valeur'].mean(), 6))Moyenne (chargement complet) : 0.500159Autre astuce pour économiser la mémoire : ne charge que les colonnes utiles avec usecols et choisis des types plus légers avec dtype.
complet = pd.read_csv(chemin)
reduit = pd.read_csv(chemin, usecols=['valeur'], dtype={'valeur': 'float32'})

print("Tout charger :", round(complet.memory_usage(deep=True).sum() / 1e6, 1), "Mo")
print("Une colonne en float32 :", round(reduit.memory_usage(deep=True).sum() / 1e6, 1), "Mo")Tout charger : 16.0 Mo
Une colonne en float32 : 4.0 MoQuestions fréquentes
Comment créer un DataFrame pandas ?
Avec pd.DataFrame(). À partir d’une liste de lignes : pd.DataFrame(data, columns=col, index=ind). À partir d’un dictionnaire, dont chaque clé devient une colonne : pd.DataFrame({'A': [1, 2], 'B': [3, 4]}). Sans argument de données, pd.DataFrame(columns=col) crée un DataFrame vide avec ses colonnes.
Comment ajouter une ligne à un DataFrame pandas ?
Avec pd.concat([df, pd.DataFrame([nouvelle_ligne])], ignore_index=True). La méthode df.append() n’existe plus depuis pandas 2.0. Utilise np.nan pour une valeur manquante dans une colonne numérique, pour que la colonne garde son type.
Comment remplacer les valeurs manquantes dans pandas ?
Avec fillna() : df.fillna(0) remplit avec une constante, df.fillna(df.mean(numeric_only=True)) avec la moyenne de chaque colonne numérique. Pour supprimer plutôt que remplacer, utilise dropna(). df.isnull().sum() compte d’abord les valeurs manquantes de chaque colonne.
Quelle est la différence entre loc et iloc ?
loc[] sélectionne avec les étiquettes de lignes et de colonnes (par exemple df.loc[0, 'D']), alors que iloc[] sélectionne avec les positions numériques (par exemple df.iloc[0, 3]). Avec loc[], une plage comme 50:100 inclut les deux bornes ; avec iloc[], la borne de fin est exclue.
Comment filtrer un DataFrame avec plusieurs conditions ?
Combine les conditions avec & (et) et | (ou), en mettant chaque condition entre parenthèses : df[(df['B'] >= 50000) & (df['Lanzarote'] > 50000)]. Tu peux aussi écrire df.query('B >= 50000 and Lanzarote > 50000'). Les mots and et or ne fonctionnent pas sur des séries pandas.
Comment lire un très gros fichier CSV avec pandas ?
Avec le paramètre chunksize : pd.read_csv('data.csv', chunksize=100_000) renvoie un itérateur de blocs que tu traites un par un. Tu peux aussi réduire la mémoire en ne chargeant que les colonnes utiles avec usecols et des types plus légers avec dtype.
Conclusion
Voilà : tu as passé en revue les opérations de base de pandas, de la création d’un DataFrame jusqu’au filtrage et au traitement des gros fichiers. Garde ce mémo sous la main et exécute les exemples pour te les approprier. Tu retrouveras cette syntaxe en situation réelle dans l’analyse de données sur le Covid-19.
Une antisèche aide à se souvenir de la syntaxe, mais c’est en manipulant de vrais DataFrames qu’elle devient un réflexe. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin :
Un grand merci bon travail
Ravi que ça t’ait plu :))
Magnifique, merci !