On entend beaucoup parler du Deep Learning (ou apprentissage profond), mais qu’est-ce que c’est exactement ? Comment ça fonctionne ? Voici un guide simple pour y voir plus clair, sans mathématiques avancées.
Article mis à jour en octobre 2026 : j’ai corrigé les explications sur la fonction d’activation et sur la descente de gradient, ajouté la rétropropagation et un passage sur les IA génératives comme ChatGPT et Claude.
En bref : le Deep Learning est une branche du Machine Learning qui utilise des réseaux de neurones à plusieurs couches cachées. Le réseau apprend à partir d’exemples : il ajuste ses poids pour réduire l’écart entre ses prédictions et les résultats réels, grâce à la descente de gradient.
L’intelligence artificielle (IA) et le Machine Learning (ML, ou apprentissage automatique) sont des sujets omniprésents. Le terme « IA » est utilisé à tort et à travers : beaucoup de gens disent vouloir « faire de l’IA » sans savoir précisément ce que c’est.
Une fois cet article lu, tu comprendras les bases de l’IA et du Machine Learning. Surtout, tu comprendras comment fonctionne le Deep Learning, la famille de méthodes derrière la plupart des IA actuelles : reconnaissance d’images, traduction, assistants comme ChatGPT ou Claude.
Ce guide s’adresse à tout le monde : il n’y a pas de mathématiques avancées.
Contexte du Deep Learning
Pour comprendre le Deep Learning, il faut d’abord distinguer quelques termes qu’on confond souvent. Ils s’emboîtent comme des poupées russes : le Deep Learning est une partie du Machine Learning, qui est lui-même une partie de l’intelligence artificielle.
Intelligence artificielle vs Machine Learning
L’intelligence artificielle est la reproduction de l’intelligence humaine par des ordinateurs.
Quand la recherche sur l’IA a débuté, les chercheurs essayaient de reproduire l’intelligence humaine pour des tâches précises, comme jouer à un jeu. Ils écrivaient à la main un grand nombre de règles que l’ordinateur devait respecter : une liste d’actions possibles, et des règles pour choisir entre elles.
Le Machine Learning est la capacité d’une machine à apprendre à partir de grands ensembles de données.
Avec le Machine Learning, on n’écrit plus les règles : l’ordinateur les apprend lui-même à partir d’exemples. Cette approche profite de la puissance de calcul des ordinateurs modernes, capables de traiter de très grands ensembles de données.
Apprentissage supervisé vs apprentissage non supervisé
L’apprentissage supervisé utilise des données étiquetées : chaque exemple contient des entrées et la sortie attendue.
Avec l’apprentissage supervisé, la machine apprend une tâche en étudiant des exemples de cette tâche. Par exemple, elle peut apprendre à reconnaître un chat sur une photo après qu’on lui a montré des milliers de photos étiquetées « chat » ou « pas chat ».
Les applications sont nombreuses : reconnaissance vocale, vision par ordinateur, régression, classification, etc.
La grande majorité des projets de Machine Learning et de Deep Learning utilisent l’apprentissage supervisé. Il est donc essentiel de bien comprendre son fonctionnement.
L’apprentissage non supervisé cherche une structure dans des données sans étiquettes.
Avec l’apprentissage non supervisé, tu ne donnes pas de sortie attendue : tu laisses l’algorithme trouver lui-même des regroupements logiques dans les données.
Un exemple : sur un site de e-commerce, l’algorithme regroupe les clients selon leur comportement d’achat (clients occasionnels, acheteurs de promotions, clients fidèles…). Personne ne lui a dit à l’avance quels groupes chercher.
Il existe aussi l’apprentissage par renforcement, où un agent apprend par essais et erreurs en recevant des récompenses. Dans cet article, nous nous concentrons sur l’apprentissage supervisé.
Comment fonctionne le Deep Learning ?
Tu es maintenant prêt à comprendre ce qu’est le Deep Learning et comment il fonctionne.
Le Deep Learning est une méthode de Machine Learning. Elle permet d’entraîner une IA à prédire un résultat à partir d’un ensemble d’entrées. On l’entraîne le plus souvent par apprentissage supervisé.
Pour comprendre le principe, nous allons construire sur le papier un service qui estime le prix d’un billet d’avion. Nous l’entraînerons par apprentissage supervisé.
Notre estimateur doit prédire le prix à partir des entrées suivantes (nous excluons les allers-retours pour simplifier) :
- l’aéroport d’origine
- l’aéroport de destination
- la date de départ
- la compagnie aérienne
Les réseaux de neurones
Tu peux aussi lire mon article pour bien comprendre les réseaux de neurones.
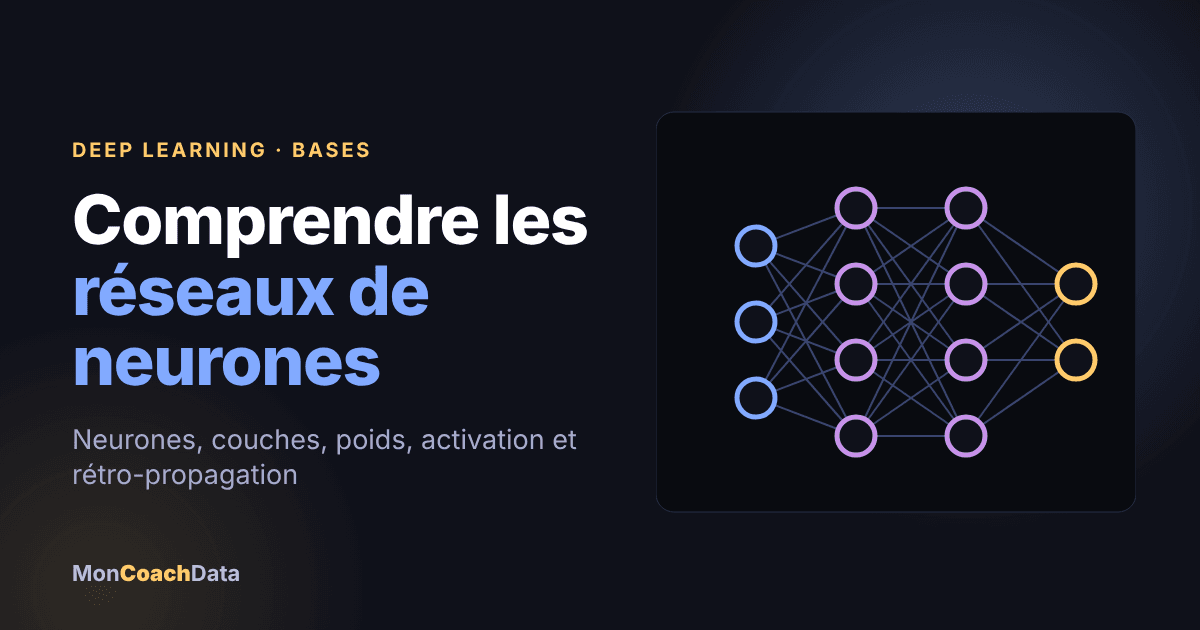
Regardons à l’intérieur du « cerveau » de notre IA. Comme dans le cerveau humain, il y a des neurones, représentés par des cercles, et ils sont interconnectés. Attention, l’analogie reste très lointaine : un neurone artificiel est une simple opération mathématique, bien plus simple qu’un neurone biologique.
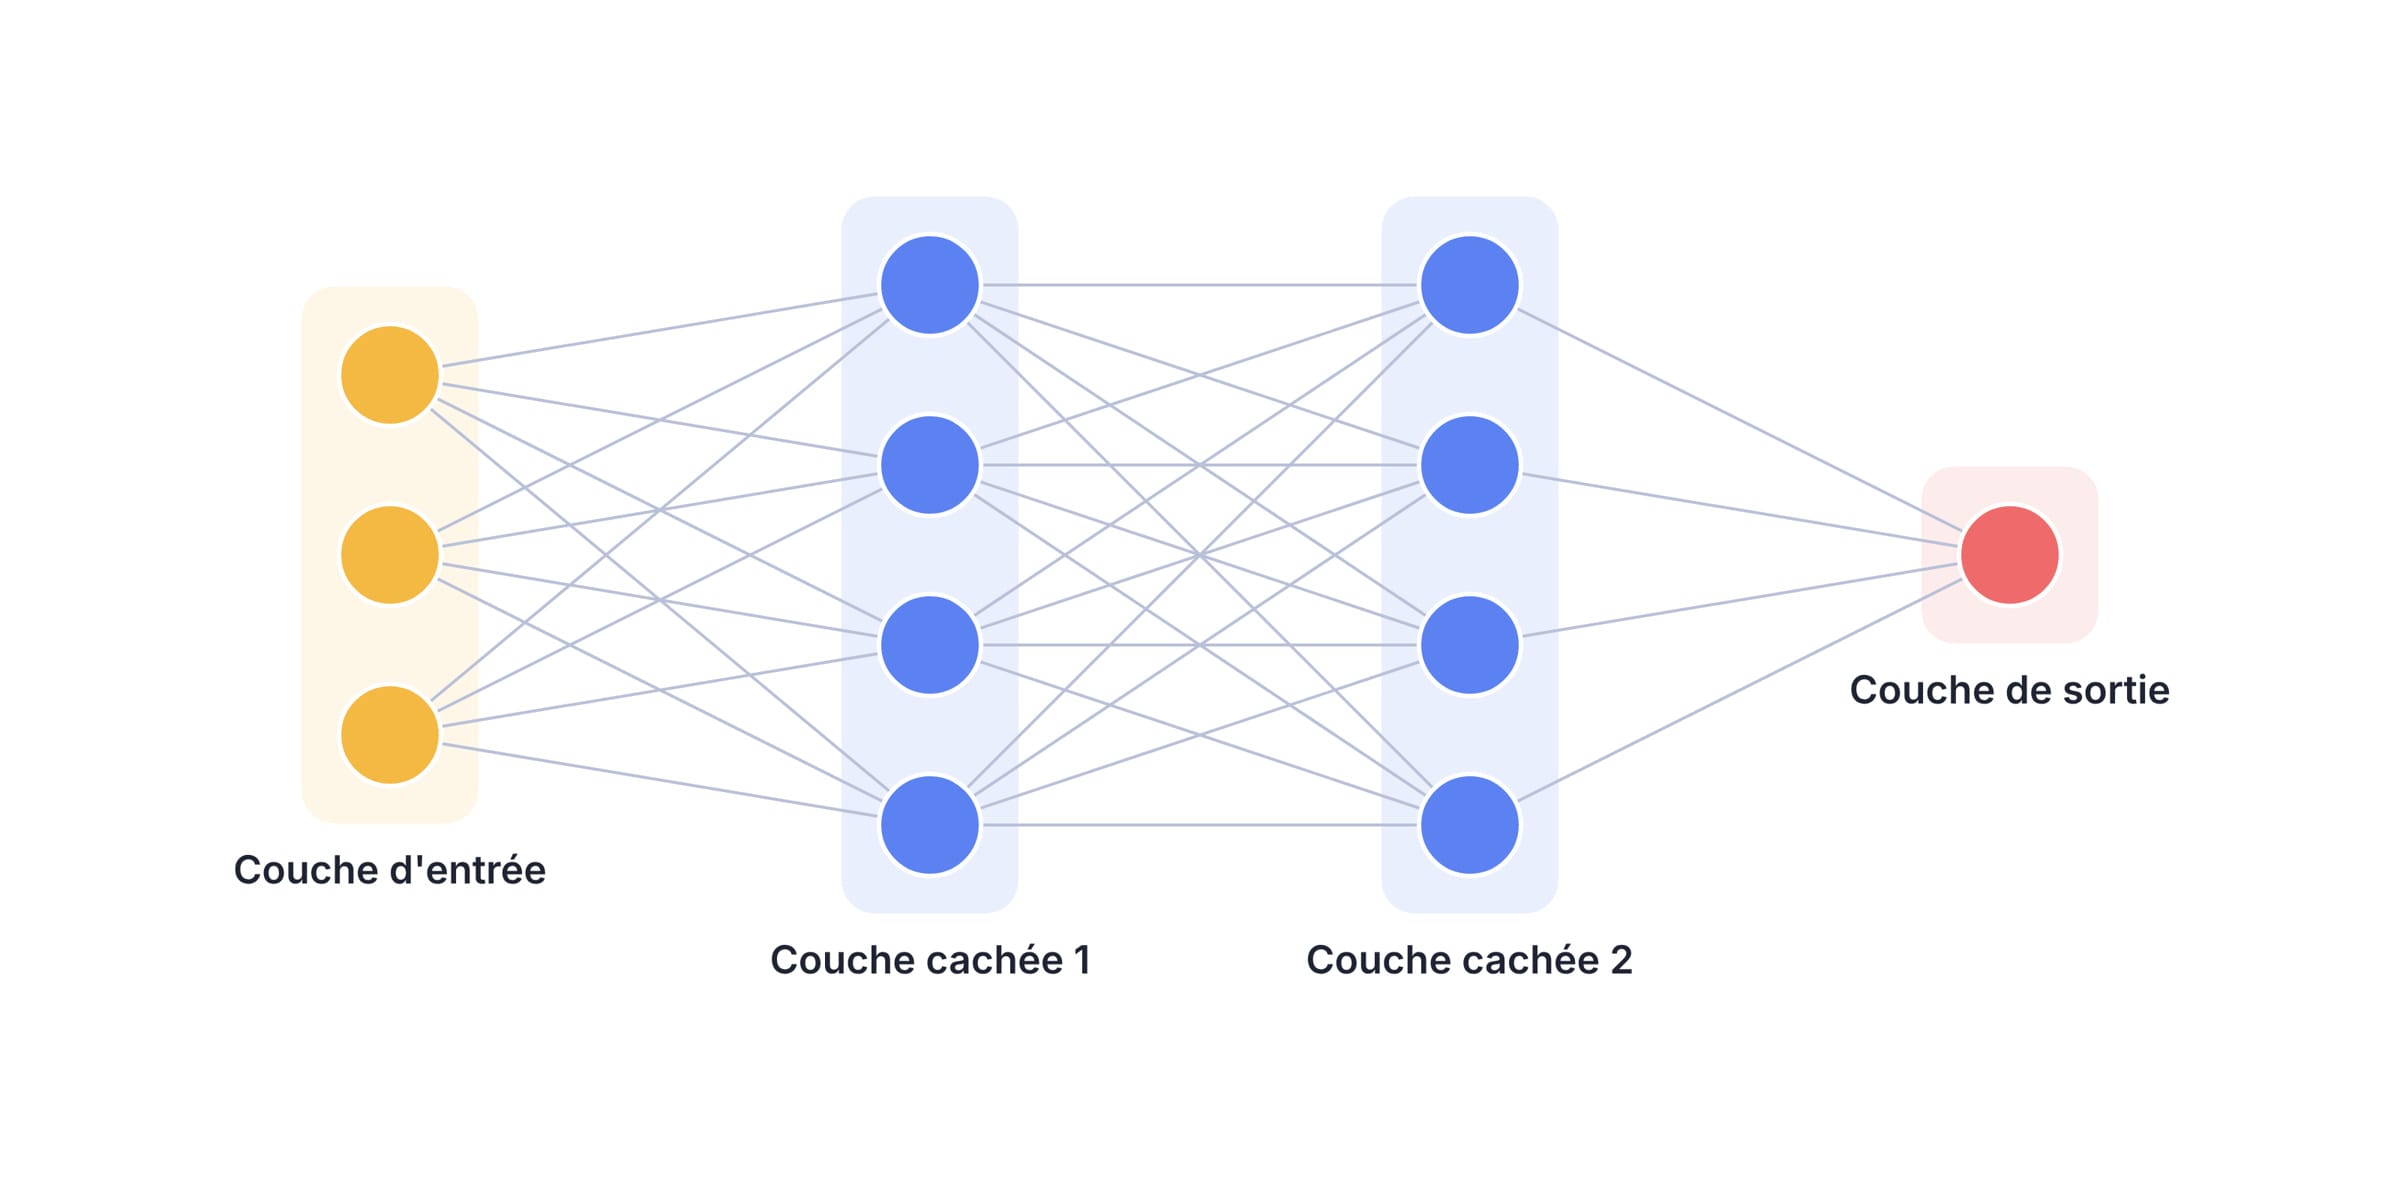
Les neurones sont regroupés en trois types de couches :
- la couche d’entrée (input layer)
- la ou les couches cachées (hidden layers)
- la couche de sortie (output layer)
La couche d’entrée reçoit les données. Dans notre cas, elle a quatre neurones : l’aéroport d’origine, l’aéroport de destination, la date de départ et la compagnie aérienne. Elle transmet ces données à la première couche cachée.
Une précision : un réseau de neurones ne manipule que des nombres. Dans la pratique, les aéroports et les compagnies sont donc transformés en nombres avant d’entrer dans le réseau, et la couche d’entrée compte bien plus que quatre neurones. Nous gardons quatre entrées pour que le schéma reste lisible.
Les couches cachées effectuent des calculs sur ces entrées. L’un des défis de la conception d’un réseau consiste à choisir le nombre de couches cachées et le nombre de neurones de chaque couche.
Le mot « deep » (profond) dans Deep Learning fait référence au fait d’avoir plusieurs couches cachées (au moins deux).
La couche de sortie renvoie le résultat. Dans notre cas, c’est la prédiction du prix.
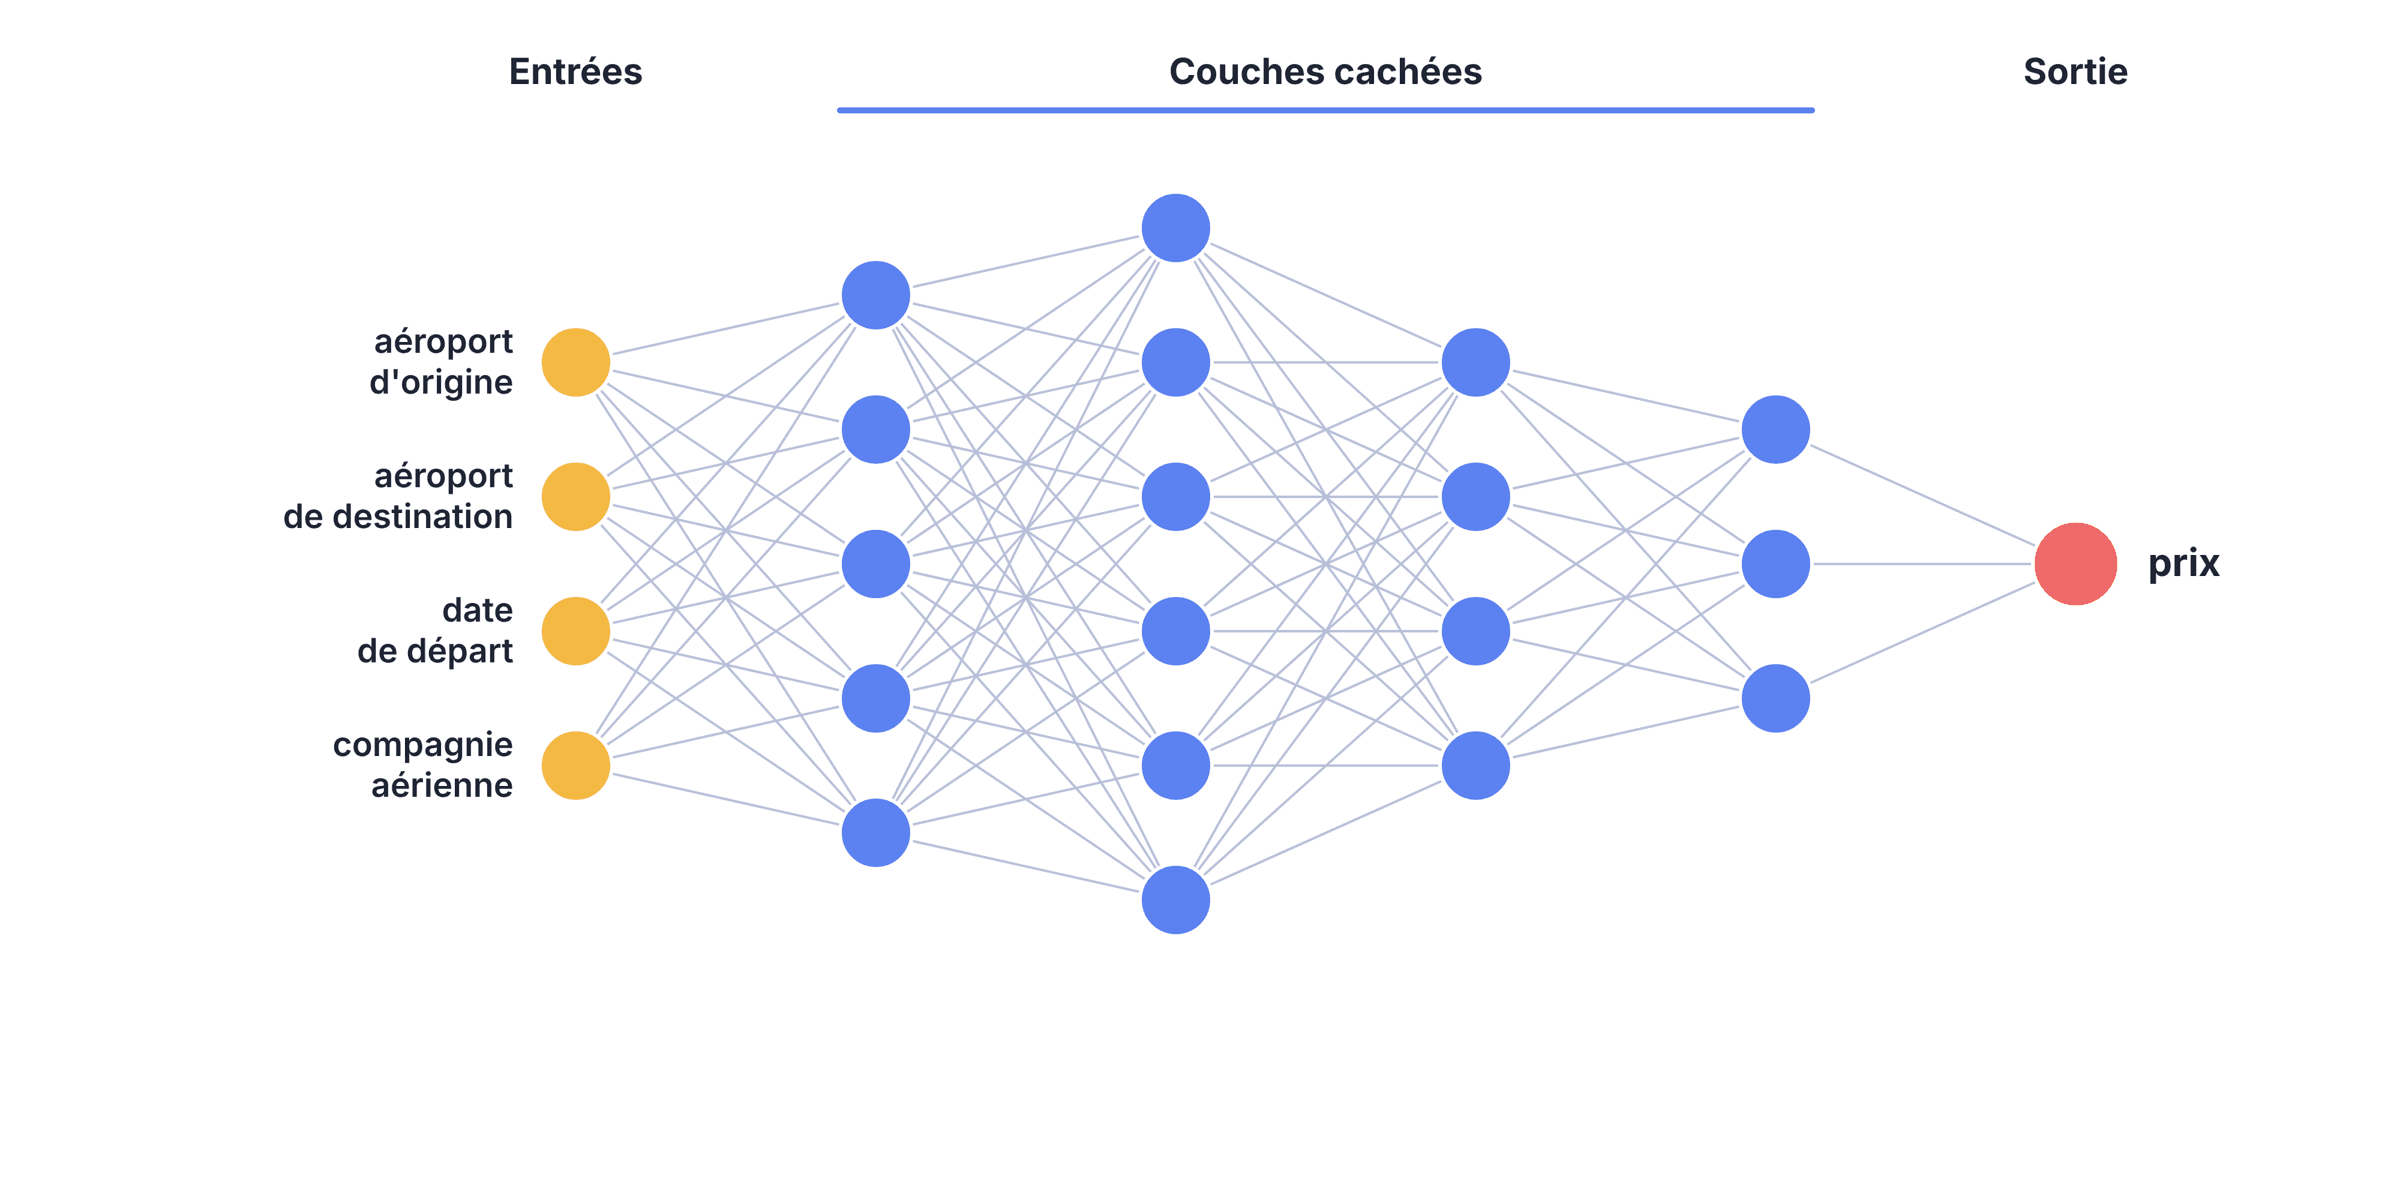
Comment ce réseau calcule-t-il la prédiction du prix ? C’est là que commence la magie du Deep Learning.
Les poids et la fonction d’activation
Chaque connexion entre deux neurones est associée à un poids (weight). Ce poids indique l’importance de la valeur qui circule sur cette connexion : plus il est grand (en valeur absolue), plus la valeur compte dans le calcul.
Un neurone fait deux choses : il calcule la somme de ses entrées multipliées par leurs poids, puis il applique à ce résultat une fonction d’activation. Les poids initiaux sont fixés de façon aléatoire : au départ, le réseau ne « sait » rien.
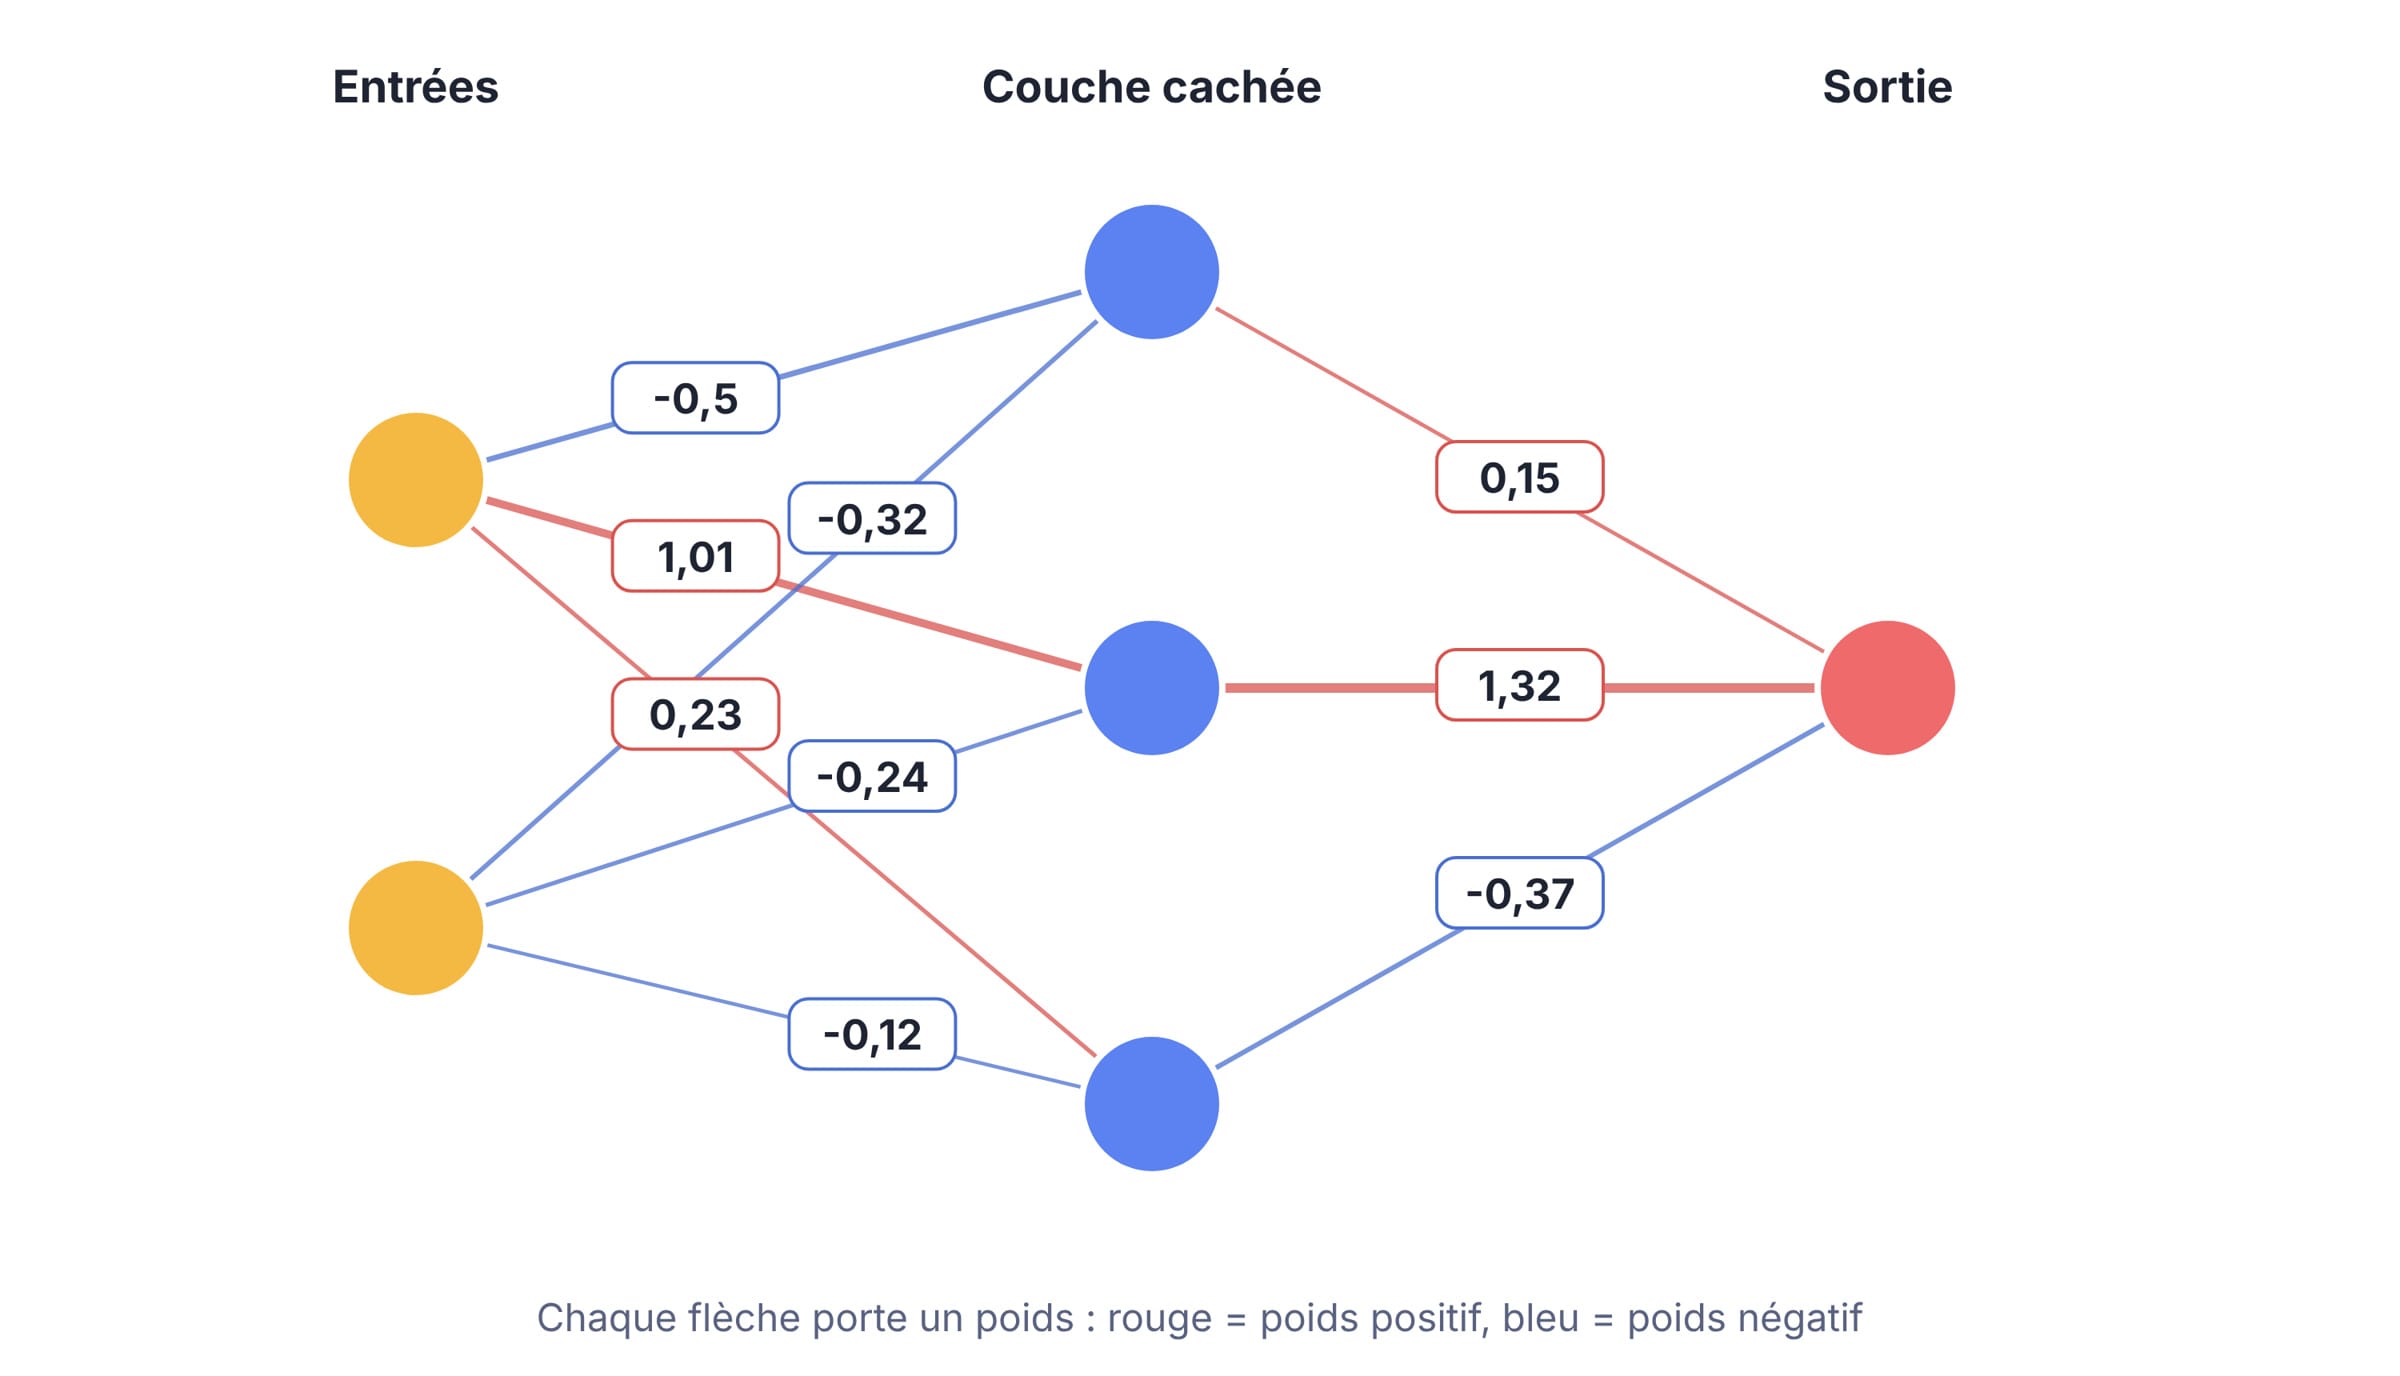
Ces poids ne sont pas choisis par nous : ils sont appris pendant l’entraînement. Pour notre estimateur, on peut s’attendre à ce que la date de départ finisse par peser lourd dans la prédiction, puisque c’est l’un des facteurs qui influencent le plus le prix d’un billet. Mais c’est le réseau qui le découvre, à partir des données.
La fonction d’activation a un rôle précis : elle introduit de la non-linéarité. Sans elle, empiler plusieurs couches reviendrait à faire une seule opération linéaire, et le réseau ne pourrait pas apprendre de relations complexes. Selon la fonction, elle peut aussi ramener la sortie du neurone dans un intervalle donné (c’est le cas de la fonction sigmoïde, entre 0 et 1), mais ce n’est pas son rôle principal. La plus utilisée aujourd’hui dans les couches cachées s’appelle ReLU.
Quand un ensemble de données d’entrée a traversé toutes les couches, le réseau renvoie sa prédiction par la couche de sortie. On appelle ce passage de gauche à droite la propagation avant (forward pass).
Rien de sorcier, n’est-ce pas ?
Entraîner le réseau de neurones
L’entraînement est la partie la plus difficile du Deep Learning. Pourquoi ?
- Il faut généralement un très grand ensemble de données.
- Il faut une grande puissance de calcul.
Pour notre estimateur, nous avons besoin de données historiques de prix de billets. Comme il existe un très grand nombre de combinaisons d’aéroports, de dates et de compagnies, il faut une très longue liste de prix.
Pour entraîner l’IA, on lui donne en entrée les exemples de notre ensemble de données, puis on compare ses sorties aux prix réels connus. Comme le réseau n’est pas encore entraîné, ses résultats sont faux.
On mesure alors l’écart entre les prédictions du réseau et les prix réels avec une fonction qui s’appelle la fonction de coût (cost ou loss). Par exemple, pour un prix à prédire, on peut calculer la moyenne des carrés des écarts.
Idéalement, on voudrait que la fonction de coût soit nulle, c’est-à-dire que les prédictions de l’IA soient les mêmes que les prix réels. En pratique, on cherche surtout à la rendre la plus petite possible.
Comment réduire la fonction de coût ?
Il faut modifier les poids entre les neurones. On pourrait les changer au hasard jusqu’à obtenir un coût faible, mais ce serait très inefficace : un réseau profond compte des milliers, voire des milliards de poids.
On utilise plutôt une technique appelée « gradient descent » ou descente de gradient.
La descente de gradient permet de trouver le minimum d’une fonction. Ici, nous cherchons le minimum de la fonction de coût.
Elle modifie les poids par petits pas. À chaque étape, on calcule la dérivée (le gradient) de la fonction de coût par rapport à chaque poids : elle indique dans quelle direction le coût augmente le plus vite. On déplace alors le poids dans la direction opposée, pour faire baisser le coût.
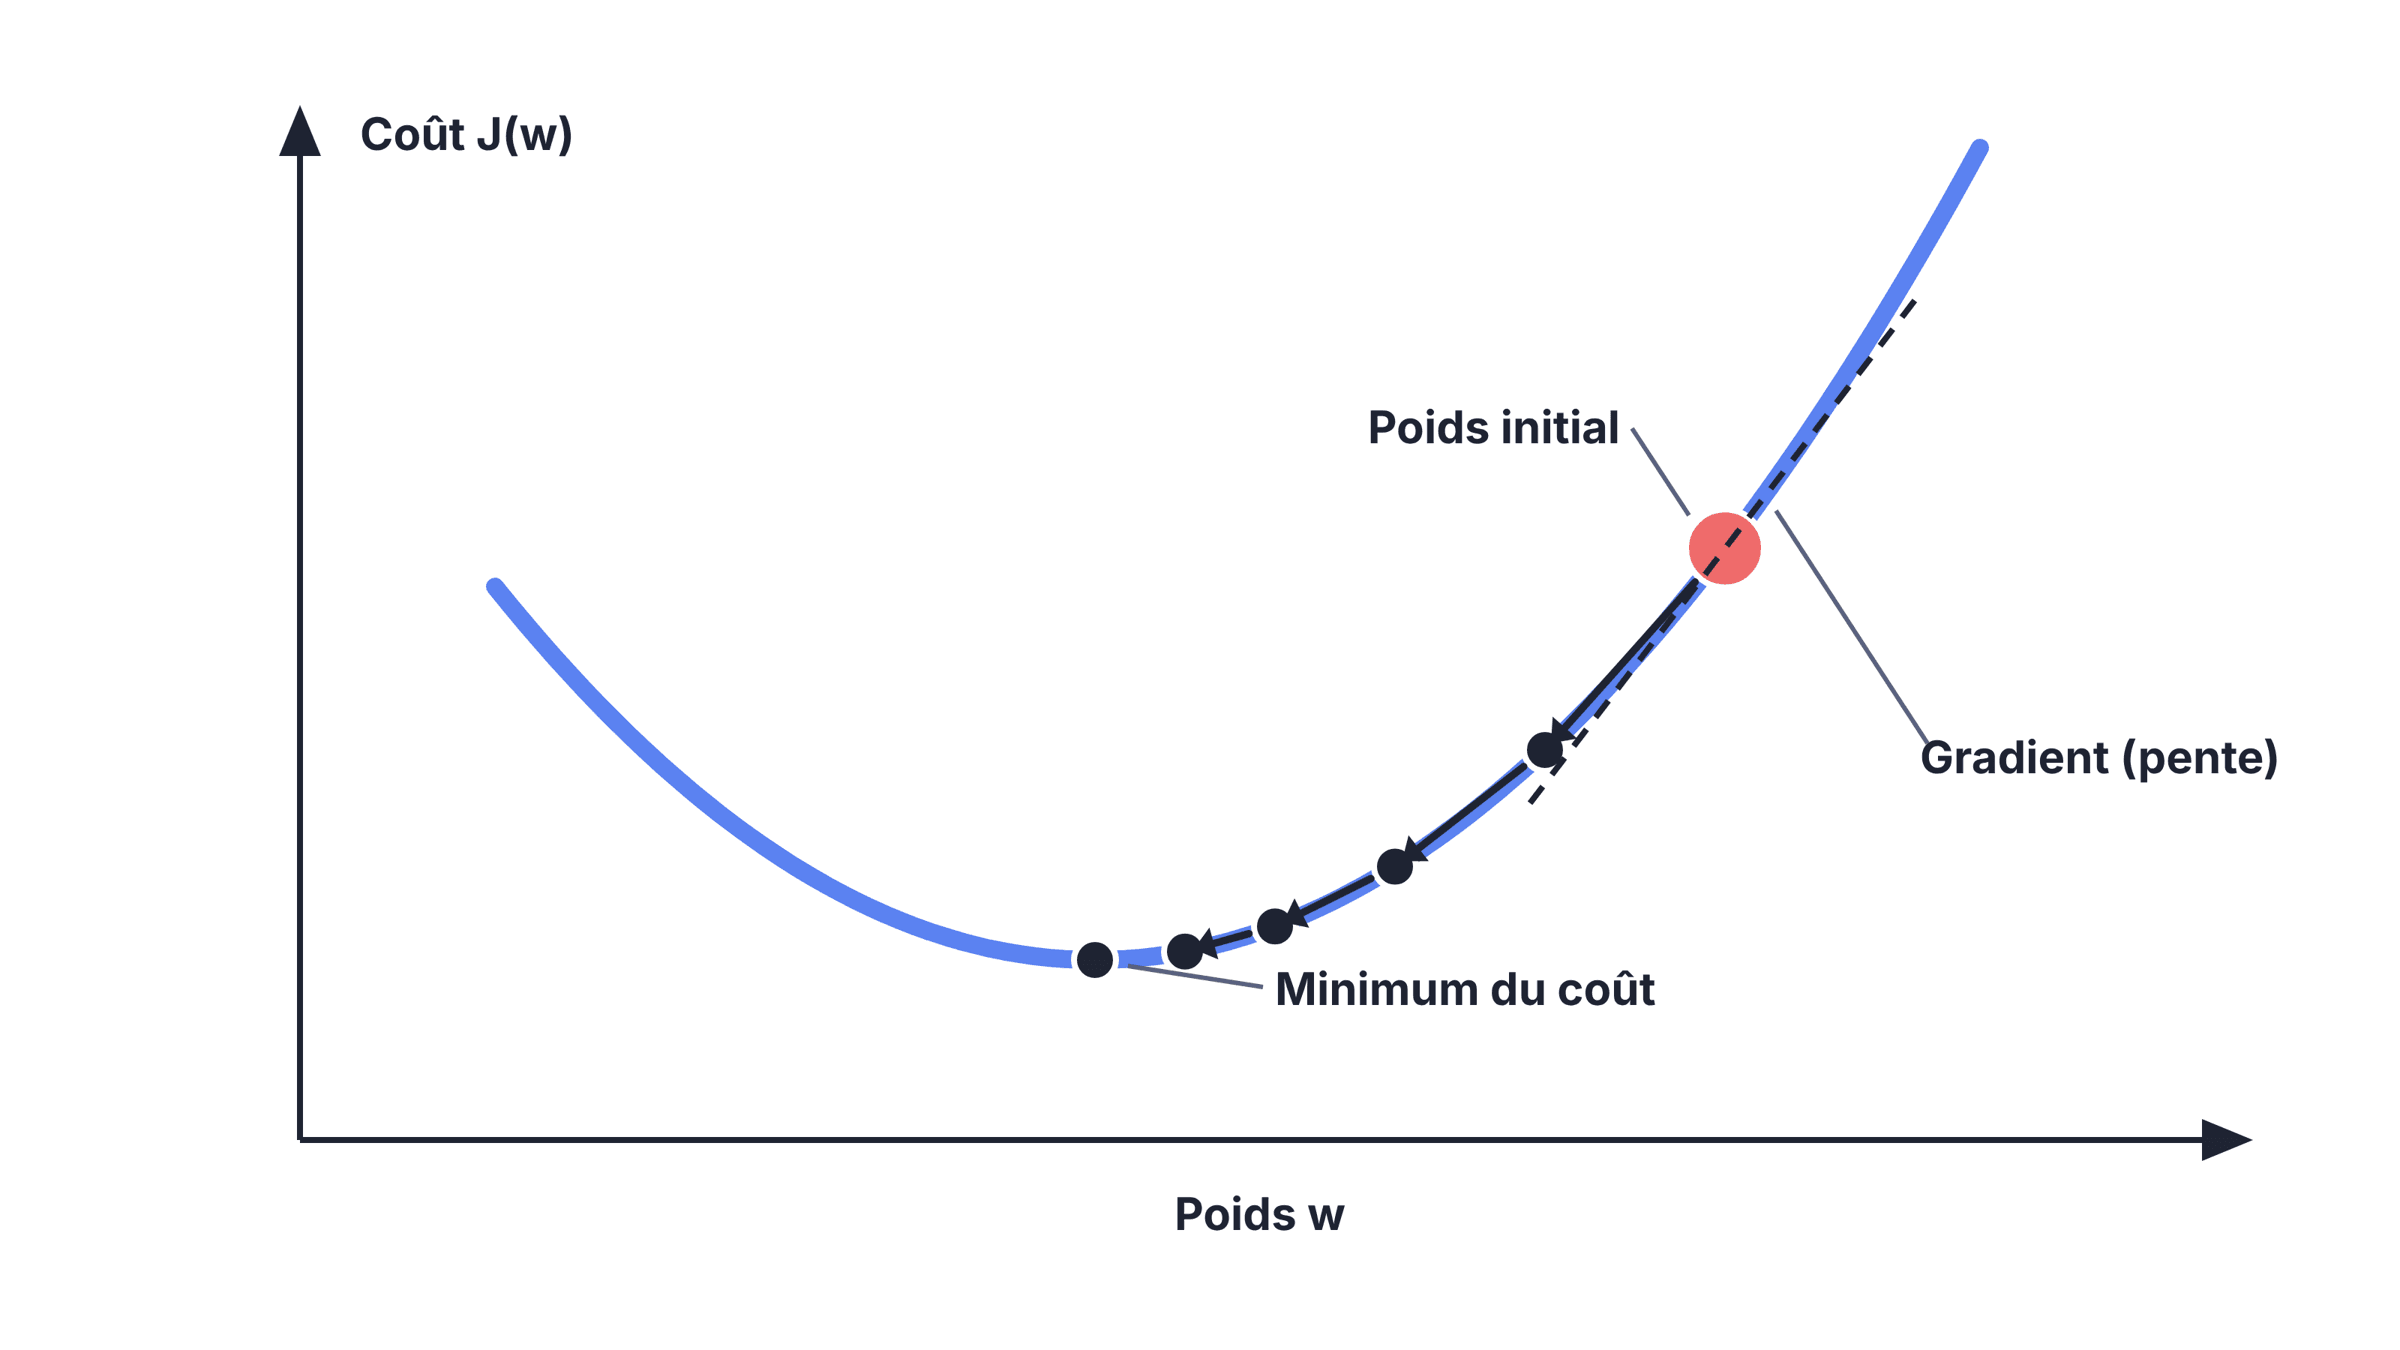
La taille de chaque pas est réglée par le taux d’apprentissage (learning rate). S’il est trop petit, l’entraînement est très lent. S’il est trop grand, on saute par-dessus le minimum et le coût ne baisse plus.
Il reste une question : comment calculer le gradient pour des milliers de poids répartis sur plusieurs couches ? C’est le rôle de la rétropropagation (backpropagation) : on part de l’erreur à la sortie et on remonte couche par couche, de droite à gauche, pour calculer la part de responsabilité de chaque poids dans l’erreur.
En pratique, on n’attend pas d’avoir parcouru tout l’ensemble de données pour modifier les poids : on les met à jour après chaque petit lot d’exemples (un « mini-batch »). Un passage complet sur toutes les données s’appelle une époque (epoch), et il faut en répéter beaucoup. C’est pour cela qu’il faut une grande puissance de calcul.
Tout ce calcul (rétropropagation et mise à jour des poids) est fait automatiquement par les bibliothèques comme Keras, TensorFlow ou PyTorch. C’est la magie du Deep Learning !
Une fois notre estimateur de prix entraîné, nous pouvons l’utiliser pour prédire les prix de futurs billets.
Et les IA génératives comme ChatGPT ou Claude ?
Les modèles de langage comme ChatGPT ou Claude sont eux aussi des réseaux de neurones profonds, avec des dizaines de couches et des milliards de poids. Le principe d’entraînement est le même que pour notre estimateur de prix : une fonction de coût mesure l’erreur du modèle, et la descente de gradient ajuste les poids pour la réduire.
La différence se trouve dans la tâche : le modèle apprend à prédire le mot (ou plus exactement le morceau de mot) suivant dans d’énormes quantités de texte. Il n’y a pas besoin d’étiqueter les données à la main, puisque la réponse attendue est le texte lui-même. On parle d’apprentissage auto-supervisé.
En résumé
- Le Deep Learning utilise des réseaux de neurones, vaguement inspirés du cerveau, pour apprendre à partir d’exemples.
- Un réseau de neurones comporte trois types de couches : la couche d’entrée, une ou plusieurs couches cachées et la couche de sortie. Il est « profond » quand il a plusieurs couches cachées.
- Les connexions entre neurones portent un poids, qui indique l’importance de la valeur transmise. Les poids sont appris, pas choisis à la main.
- Chaque neurone calcule une somme pondérée de ses entrées, puis applique une fonction d’activation qui introduit de la non-linéarité.
- Pour entraîner un réseau, il faut un grand ensemble de données.
- La fonction de coût mesure l’écart entre les prédictions du réseau et les résultats réels.
- La rétropropagation calcule le gradient du coût pour chaque poids, et la descente de gradient ajuste les poids par petits pas pour réduire ce coût.
Questions fréquentes
Quelle est la différence entre Machine Learning et Deep Learning ?
Le Machine Learning regroupe toutes les méthodes où la machine apprend à partir de données (arbres de décision, régression, k plus proches voisins, réseaux de neurones, etc.). Le Deep Learning est une partie du Machine Learning : il utilise uniquement des réseaux de neurones à plusieurs couches cachées.
Pourquoi parle-t-on d’apprentissage « profond » ?
Parce que le réseau de neurones comporte plusieurs couches cachées empilées les unes sur les autres. La « profondeur » désigne ce nombre de couches.
Faut-il beaucoup de données pour faire du Deep Learning ?
En général, oui : les réseaux profonds ont beaucoup de poids à apprendre et demandent de grands ensembles de données. Sur de petits jeux de données, des méthodes plus simples sont souvent aussi bonnes, voire meilleures. Quand on manque de données, on peut aussi repartir d’un réseau déjà entraîné (on parle de transfert d’apprentissage).
À quoi sert la descente de gradient ?
Elle sert à ajuster les poids du réseau pour réduire la fonction de coût. À chaque étape, elle déplace les poids dans la direction qui fait baisser le coût, par petits pas, jusqu’à ce que les prédictions du réseau soient suffisamment bonnes.
Le Deep Learning imite-t-il le cerveau humain ?
Pas vraiment. Les réseaux de neurones s’inspirent très vaguement du cerveau, mais un neurone artificiel est une opération mathématique simple, et l’entraînement par descente de gradient n’a rien à voir avec la façon dont le cerveau apprend.
Pour passer de la théorie à la pratique, tu peux construire un vrai réseau de neurones avec Keras dans mon article Prédiction des maladies cardiaques par Machine Learning, et comprendre la démarche générale avec Apprendre le Machine Learning avec Python. Sur DataXp, tu peux aussi t’entraîner à coder ces algorithmes pas à pas : plus de 350 exercices et un coach IA t’accompagnent, et les premiers modules sont gratuits.