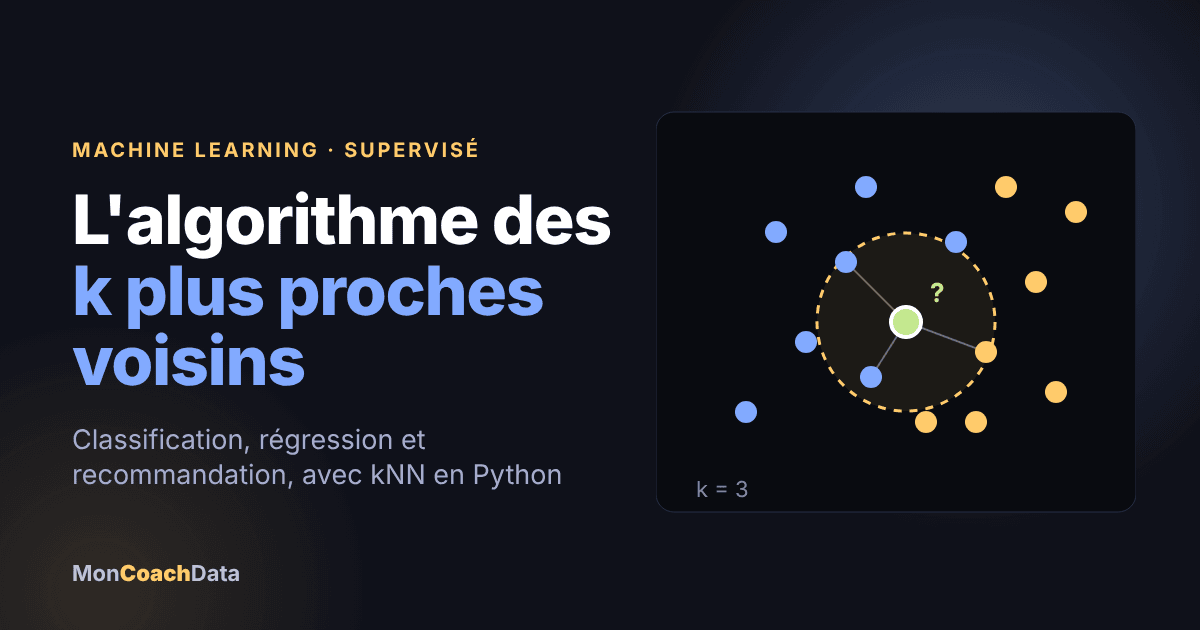
L’algorithme k plus proches voisins (k-nearest neighbors, ou kNN) est un algorithme d’apprentissage automatique (Machine Learning) supervisé, simple et facile à mettre en œuvre. Il sert à résoudre des problèmes de classification comme de régression.
En bref : l’algorithme des k plus proches voisins (kNN) est un algorithme de Machine Learning supervisé, simple, utilisable en classification comme en régression. Il calcule la distance entre une requête et toutes les observations, garde les k plus proches, puis renvoie la classe la plus fréquente (classification) ou la moyenne des étiquettes (régression). Son principal inconvénient : il ralentit nettement quand les données grossissent.
Tu peux aussi exécuter tous ces exemples dans ce notebook Google Colab : chaque extrait de code est dans sa propre cellule, prêt à être modifié.
Euh… attends, quoi ?! Pause.
Que signifient « supervisé », « classification » et « régression » ?
Qu’est-ce que le Machine Learning supervisé ?
Un algorithme de Machine Learning supervisé (par opposition à un algorithme non supervisé) repose sur des données d’entrée étiquetées. Il apprend à partir de ces données, puis produit une sortie appropriée quand on lui fournit de nouvelles données non étiquetées.
Imagine qu’un ordinateur soit un enfant, et que tu sois son superviseur (parent, tuteur ou enseignant). Tu veux que l’enfant (l’ordinateur) apprenne à quoi ressemble un cochon.
Tu lui montres plusieurs images : certaines sont des cochons, les autres des chats, des chiens, etc. Quand c’est un cochon, tu cries « cochon ! ». Sinon, tu cries « non, pas cochon ! ».
Après avoir répété cela plusieurs fois, tu lui montres une nouvelle photo et tu demandes : « cochon ou pas ? ». La plupart du temps, il identifie correctement la présence d’un cochon.
De façon imagée, c’est ça, le Machine Learning supervisé.
Les algorithmes supervisés servent à résoudre des problèmes de classification ou de régression.
Qu’est-ce qu’un problème de classification ?
Un problème de classification a une valeur discrète en sortie. Par exemple, « aime l’ananas sur la pizza » et « n’aime pas l’ananas sur la pizza » sont deux valeurs discrètes : il n’y a pas de juste milieu. L’exemple de l’enfant et du cochon est un autre problème de classification.
| Âge | Aime l’ananas sur la pizza (1 = oui, 0 = non) |
|---|---|
| 42 | 1 |
| 65 | 1 |
| 50 | 1 |
| 76 | 1 |
| 96 | 1 |
| 50 | 1 |
| 91 | 0 |
| 58 | 1 |
| 25 | 1 |
| 23 | 1 |
| 75 | 1 |
| 46 | 0 |
| 87 | 0 |
| 96 | 0 |
| 45 | 0 |
| 32 | 1 |
| 63 | 0 |
| 21 | 1 |
| 26 | 1 |
| 93 | 0 |
| 68 | 1 |
| 96 | 0 |
Ce tableau montre à quoi ressemblent des données de classification. Tu as un prédicteur (ou un ensemble de prédicteurs) et une étiquette. Ici, on prédit si quelqu’un aime l’ananas sur sa pizza (1) ou non (0) en fonction de son âge (le prédicteur).
On représente souvent l’étiquette d’une classification par un entier comme 1, -1 ou 0. Ces nombres sont purement symboliques : il ne faut pas faire d’opérations mathématiques dessus.
Quelle serait la valeur de « aime l’ananas » + « n’aime pas l’ananas » ? Cela n’a aucun sens. On n’additionne donc pas non plus leurs représentations numériques (1, -1 ou 0).
Qu’est-ce qu’un problème de régression ?
Un problème de régression a pour sortie un nombre réel (un nombre décimal). Par exemple, tu peux utiliser les données du tableau ci-dessous pour estimer le poids d’une personne en fonction de sa taille.
| Taille (pouces) | Poids (livres) |
|---|---|
| 65.78 | 112.99 |
| 71.52 | 136.49 |
| 69.40 | 153.03 |
| 68.22 | 142.34 |
| 67.79 | 144.30 |
| 68.70 | 123.30 |
| 69.80 | 141.49 |
| 70.01 | 136.46 |
| 67.90 | 112.37 |
| 66.78 | 120.67 |
| 66.49 | 127.45 |
| 67.62 | 114.14 |
| 68.30 | 125.61 |
| 67.12 | 122.46 |
| 68.28 | 116.09 |
Les données d’une régression ressemblent à celles du tableau ci-dessus. Tu as une variable indépendante (ou plusieurs) et une variable dépendante, celle que tu cherches à deviner. Ici, la taille est la variable indépendante et le poids la variable dépendante.
Chaque ligne s’appelle généralement un exemple, une observation ou un point de données. Chaque colonne (hors étiquette ou variable dépendante) s’appelle souvent un prédicteur, une dimension, une variable indépendante ou une entité (feature).
Qu’est-ce que le Machine Learning non supervisé ?
Un algorithme de Machine Learning non supervisé utilise des données d’entrée sans étiquette. Autrement dit, aucun enseignant ne dit à l’enfant (l’ordinateur) quand il a raison ou tort pour qu’il s’autocorrige.
L’apprentissage supervisé cherche une fonction qui permet de faire des prédictions sur de nouvelles données non étiquetées. L’apprentissage non supervisé, lui, cherche à apprendre la structure sous-jacente des données pour en tirer des informations.
Les deux ont donc des objectifs bien différents.
Pour coder et comprendre ces algorithmes pas à pas, tu peux t’entraîner sur DataXp : des exercices pratiques et un coach IA t’accompagnent, et les premiers modules sont gratuits.
Comment fonctionne l’algorithme des k plus proches voisins (kNN) ?
L’algorithme kNN part du principe que des objets similaires sont proches les uns des autres.
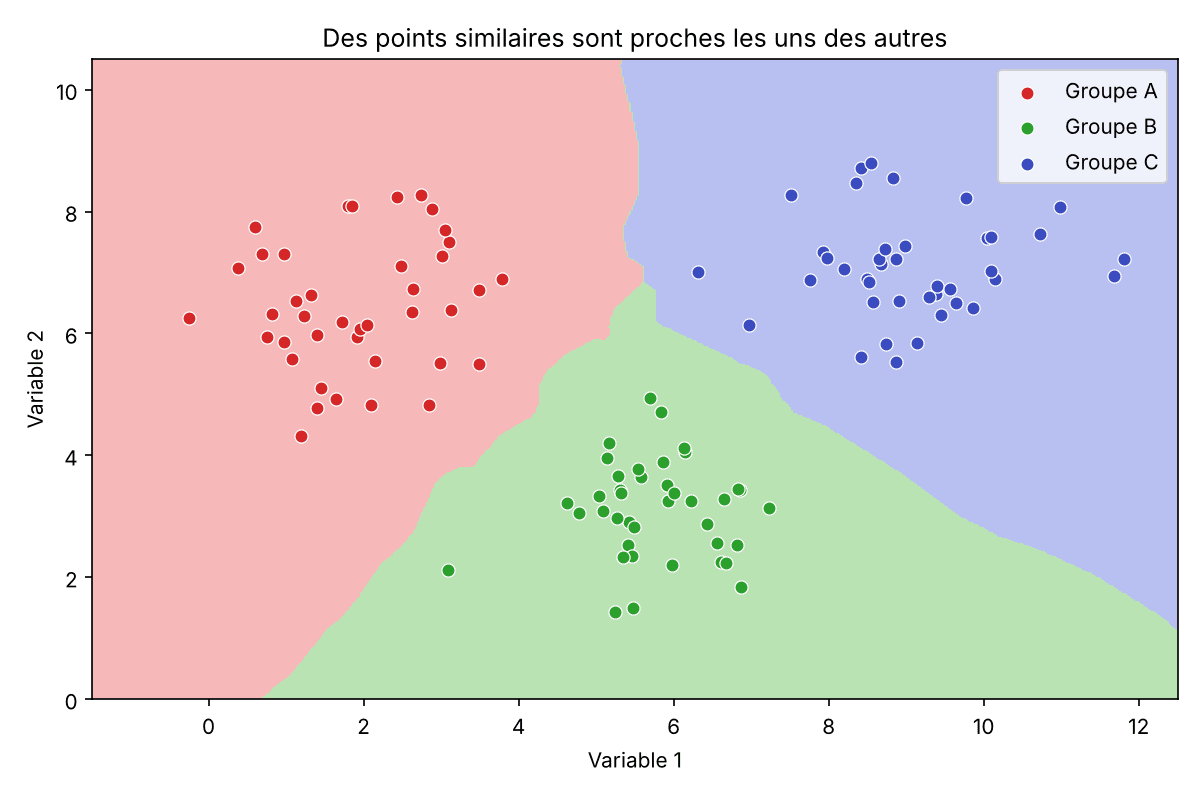
Sur l’image, des points de données similaires sont la plupart du temps proches les uns des autres. kNN repose sur le fait que cette hypothèse est suffisamment vraie pour être utile.
Il utilise l’idée de similitude (aussi appelée distance ou proximité), avec une notion de mathématiques de l’enfance : calculer la distance entre des points sur un graphique.
Remarque : avant de poursuivre, tu dois savoir calculer la distance entre deux points d’un graphique. Si tu as besoin d’un rappel, clique ici, puis reviens pour la suite 🙂
Il existe d’autres méthodes de calcul de la distance, et le choix dépend du problème à résoudre. La distance en ligne droite (la distance euclidienne) reste toutefois un choix sûr.
L’algorithme kNN
- Charger les données.
- Initialiser
kau nombre de plus proches voisins choisi. - Pour chaque exemple des données :
- calculer la distance entre la requête et l’observation courante de la boucle ;
- ajouter la distance et l’indice de l’observation à une collection ordonnée.
- Trier cette collection (distances et indices) de la plus petite distance à la plus grande (ordre croissant).
- Sélectionner les
kpremières entrées de la collection triée (leskplus proches voisins). - Obtenir les étiquettes des
kentrées sélectionnées. - Si régression, retourner la moyenne des
kétiquettes. - Si classification, retourner le mode (la valeur la plus fréquente) des
kétiquettes.
Implémentation de l’algorithme kNN (from scratch)
Voici l’algorithme codé en Python, sans bibliothèque externe. Les numéros dans les commentaires correspondent aux étapes de la liste ci-dessus :
from collections import Counter
import math

def knn(data, query, k, distance_fn, choice_fn):
    """Algorithme des k plus proches voisins kNN"""

    neighbor_distances_and_indices = []

    # 3. Pour chaque observation des données
    for index, example in enumerate(data):
        # 3.1 Calculer la distance entre la requête et l'observation courante
        distance = distance_fn(example[:-1], query)

        # 3.2 Ajouter la distance et l'indice de l'observation
        # à une collection ordonnée de données
        neighbor_distances_and_indices.append((distance, index))

    # 4. Trier cette collection de la plus petite distance à la plus grande
    sorted_neighbor_distances_and_indices = sorted(neighbor_distances_and_indices)

    # 5. Sélectionner les k premières entrées de la collection triée
    k_nearest_distances_and_indices = sorted_neighbor_distances_and_indices[:k]

    # 6. Obtenir les étiquettes (dernière colonne) des k entrées sélectionnées
    k_nearest_labels = [data[i][-1] for distance, i in k_nearest_distances_and_indices]

    # 7. Si régression (choice_fn = mean), retourner la moyenne des k étiquettes
    # 8. Si classification (choice_fn = mode), retourner le mode des k étiquettes
    return k_nearest_distances_and_indices, choice_fn(k_nearest_labels)

def mean(labels):
    """Calcul de la moyenne des k étiquettes"""
    return sum(labels) / len(labels)

def mode(labels):
    """Calcul du mode des k étiquettes"""
    return Counter(labels).most_common(1)[0][0]

def euclidean_distance(point1, point2):
    """Calcul de la distance euclidienne"""
    sum_squared_distance = 0
    for i in range(len(point1)):
        sum_squared_distance += math.pow(point1[i] - point2[i], 2)
    return math.sqrt(sum_squared_distance)

def main():
    # Données de régression
    # Colonne 0 : taille (en pouces)
    # Colonne 1 : poids (en livres)
    reg_data = [
        [65.75, 112.99],
        [71.52, 136.49],
        [69.40, 153.03],
        [68.22, 142.34],
        [67.79, 144.30],
        [68.70, 123.30],
        [69.80, 141.49],
        [70.01, 136.46],
        [67.90, 112.37],
        [66.49, 127.45],
    ]

    # Question : quelle est la meilleure estimation du poids
    # d'une personne mesurant 60 pouces ?
    reg_query = [60]
    reg_k_nearest_neighbors, reg_prediction = knn(
        reg_data, reg_query, k=3, distance_fn=euclidean_distance, choice_fn=mean
    )
    print(reg_k_nearest_neighbors)
    print(reg_prediction)

    # Données de classification
    # Colonne 0 : âge
    # Colonne 1 : aime l'ananas (1) ou non (0)
    clf_data = [
        [22, 1],
        [23, 1],
        [21, 1],
        [18, 1],
        [19, 1],
        [25, 0],
        [27, 0],
        [29, 0],
        [31, 0],
        [45, 0],
    ]

    # Question : une personne de 33 ans aime-t-elle l'ananas sur sa pizza ?
    clf_query = [33]
    clf_k_nearest_neighbors, clf_prediction = knn(
        clf_data, clf_query, k=3, distance_fn=euclidean_distance, choice_fn=mode
    )
    print(clf_k_nearest_neighbors)
    print(clf_prediction)

if __name__ == '__main__':
main()La fonction knn() renvoie les k voisins (distance et indice) ainsi que la prédiction. En lançant le script, tu obtiens :
[(5.75, 0), (6.489999999999995, 9), (7.790000000000006, 4)]
128.24666666666667
[(2.0, 8), (4.0, 7), (6.0, 6)]
0Pour la régression, une personne de 60 pouces (environ 1,52 m) a un poids estimé à environ 128 livres (environ 58 kg), la moyenne de ses 3 plus proches voisins. Pour la classification, une personne de 33 ans est prédite comme n’aimant pas l’ananas sur sa pizza (0), car ses 3 voisins les plus proches (31, 29 et 27 ans) ne l’aiment pas.
Avec scikit-learn
En pratique, tu n’as pas besoin de réécrire l’algorithme : scikit-learn propose KNeighborsRegressor et KNeighborsClassifier. Voici les mêmes exemples :
from sklearn.neighbors import KNeighborsClassifier, KNeighborsRegressor

# Régression : estimer le poids d'une personne de 60 pouces
X_reg = [[65.75], [71.52], [69.40], [68.22], [67.79], [68.70], [69.80], [70.01], [67.90], [66.49]]
y_reg = [112.99, 136.49, 153.03, 142.34, 144.30, 123.30, 141.49, 136.46, 112.37, 127.45]

reg = KNeighborsRegressor(n_neighbors=3)
reg.fit(X_reg, y_reg)
print(reg.predict([[60]]))

# Classification : une personne de 33 ans aime-t-elle l'ananas ?
X_clf = [[22], [23], [21], [18], [19], [25], [27], [29], [31], [45]]
y_clf = [1, 1, 1, 1, 1, 0, 0, 0, 0, 0]

clf = KNeighborsClassifier(n_neighbors=3)
clf.fit(X_clf, y_clf)
print(clf.predict([[33]]))[128.24666667]
[0]Tu retrouves exactement les mêmes résultats que dans l’implémentation from scratch.
Comment choisir la bonne valeur de k ?
Pour trouver la valeur de k adaptée à tes données, exécute plusieurs fois l’algorithme avec différentes valeurs de k. Choisis ensuite celle qui réduit le nombre d’erreurs tout en gardant de bonnes prédictions sur des données nouvelles, non vues auparavant.
Quelques points à garder en tête :
- Quand tu diminues
kjusqu’à 1, les prédictions deviennent moins stables. Imagine un point de requête entouré de plusieurs points rouges et d’un seul point vert (comme le point vert isolé, en bas à gauche du graphique coloré plus haut, tout près des points rouges). Si le point vert est le plus proche et quek = 1, kNN prédit à tort que la requête est verte. - À l’inverse, quand tu augmentes
k, les prédictions deviennent plus stables grâce au vote à la majorité ou à la moyenne, donc plus précises, jusqu’à un certain point. Au-delà, les erreurs augmentent : tu as poussé la valeur dektrop loin. - Pour un vote à la majorité (le mode, en classification) entre deux classes, choisis plutôt un nombre impair pour
k, afin d’éviter les égalités.
Quels sont les avantages de kNN ?
- L’algorithme est très simple et facile à mettre en œuvre.
- Il n’est pas nécessaire de construire un modèle, d’ajuster plusieurs paramètres ou de faire des hypothèses supplémentaires.
- Il est polyvalent : classification, régression et recherche d’informations (comme tu vas le voir dans la section suivante).
Quels sont les inconvénients de kNN ?
- L’algorithme ralentit considérablement quand le nombre d’observations ou de variables indépendantes augmente. En effet, il calcule la distance avec toutes les observations pour chaque prédiction.
- Il est sensible à l’échelle des variables. Si une variable a des valeurs beaucoup plus grandes que les autres, elle domine le calcul de la distance. Pense à normaliser ou standardiser tes données avant de l’appliquer.
À quoi sert kNN en pratique ?
Le ralentissement du kNN quand le volume de données augmente le rend peu pratique quand les prédictions doivent être rapides. De plus, certains algorithmes plus rapides donnent des résultats plus précis en classification et en régression.
Mais si tu disposes de ressources suffisantes pour traiter rapidement tes données, kNN reste utile pour les problèmes qui dépendent de l’identification d’objets similaires. Un exemple est le système de recommandation, une application de la kNN-search.
Comment utiliser kNN dans un système de recommandation ?
À grande échelle, cela ressemble à la recommandation de produits sur Amazon, d’articles sur Medium, de films ou séries sur Netflix ou de vidéos sur YouTube. Ces plateformes utilisent des méthodes bien plus efficaces, à cause du volume énorme de données qu’elles traitent.
Tu peux toutefois reproduire un tel système à plus petite échelle avec ce que tu viens d’apprendre. Construisons l’embryon d’un système de recommandation de films.
À quelle question essayons-nous de répondre ?
Compte tenu d’un ensemble de données de films, quels sont les 5 films les plus similaires à un film donné ?
Recueillir des données de films
Si tu travaillais chez Netflix, Hulu ou IMDb, tu pourrais récupérer les données dans leur entrepôt de données. Sinon, tu dois les obtenir autrement. Tu peux par exemple utiliser des données de films du repository UCI Machine Learning, le dataset d’IMDb, ou créer le tien minutieusement.
Exploration, nettoyage et préparation des données
Quelle que soit l’origine de tes données, il peut y avoir des problèmes à corriger avant de les passer à kNN : un format inattendu, des valeurs manquantes à renseigner ou des données à supprimer.
Notre implémentation kNN suppose des données structurées, sous forme de tableau. Elle suppose aussi que toutes les colonnes sont numériques et que la dernière colonne contient les étiquettes. Tes données doivent respecter ces contraintes.
Le tableau ci-dessous montre un exemple de données nettoyées. Le jeu complet contient trente films, avec pour chacun sept genres et sa note IMDB (le tableau n’en montre que cinq). La colonne « Label » ne contient que des zéros, car ce dataset ne sert ni à la classification ni à la régression. Les notes et les genres de ce fichier sont simplifiés : ce sont des données d’illustration, pas les valeurs exactes d’IMDB.
| Movie ID | Movie Name | IMDB Rating | Biography | Drama | Thriller | Comedy | Crime | Mystery | History | Label |
|---|---|---|---|---|---|---|---|---|---|---|
| 58 | The Imitation Game | 8 | 1 | 1 | 1 | 0 | 0 | 0 | 0 | 0 |
| 8 | Ex Machina | 7.7 | 0 | 1 | 0 | 0 | 0 | 1 | 0 | 0 |
| 46 | A Beautiful Mind | 8.2 | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| 62 | Good Will Hunting | 8.3 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| 97 | Forrest Gump | 8.8 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
Certaines relations entre les films (acteurs, réalisateurs, thèmes) ne seront pas prises en compte, car les données qui les décrivent sont absentes du dataset. La similarité sera donc basée uniquement sur les genres des films et leurs notes IMDB.
Utilisation de l’algorithme
Imagine que tu navigues sur le site « Recommande Moi un Film », un spin-off fictif d’IMDB, et que tu tombes sur le film Pentagon Papers. Tu hésites à le regarder, mais ce type de film t’intrigue, et tu veux connaître des films similaires. Tu fais défiler la section « More like this » pour voir les recommandations, et l’algorithme se met en marche.
Le site envoie une requête à son back-end pour obtenir les 5 films les plus similaires à Pentagon Papers. Le back-end dispose d’un ensemble de données exactement comme le tableau ci-dessus. Il crée d’abord la représentation de la ligne du film (le feature vector), puis exécute un programme semblable à celui ci-dessous et renvoie les résultats à l’écran.
Voici un exemple de système de recommandation (from scratch) à partir du fichier movies_recommendation_data.csv, pour le film Pentagon Papers. Le fichier est hébergé sur GitHub : ce premier bloc le télécharge dans ton dossier de travail.
import urllib.request

# Fichier d'exemple de 30 films (note IMDB et genres), hébergé sur GitHub
URL = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/algorithme-des-k-plus-proches-voisins/movies_recommendation_data.csv"
urllib.request.urlretrieve(URL, "movies_recommendation_data.csv")
import csv
# En utilisant les fonctions knn et euclidean_distance
# de l'algorithme kNN ci-dessus
def recommend_movies(movie_query, k_recommendations):
raw_movies_data = []
with open('movies_recommendation_data.csv', 'r', encoding='utf-8', newline='') as md:
reader = csv.reader(md)
# Éliminer la première ligne (en-têtes)
next(reader)
# Lire les données
for data_row in reader:
raw_movies_data.append(data_row)
# Préparer les données pour l'algorithme kNN : on garde les colonnes
# numériques (note, genres, étiquette) et on les convertit en nombres,
# car elles ont été lues sous forme de chaînes de caractères
movies_recommendation_data = []
for row in raw_movies_data:
data_row = list(map(float, row[2:]))
movies_recommendation_data.append(data_row)
# Utiliser kNN pour obtenir les k films les plus similaires à la requête
recommendation_indices, _ = knn(
movies_recommendation_data, movie_query, k=k_recommendations,
distance_fn=euclidean_distance, choice_fn=lambda x: None
)
movie_recommendations = []
for _, index in recommendation_indices:
movie_recommendations.append(raw_movies_data[index])
return movie_recommendations
if __name__ == '__main__':
# Feature vector pour Pentagon Papers : note IMDB, 7 genres, étiquette (0)
the_post = [7.2, 1, 1, 0, 0, 0, 0, 1, 0]
recommended_movies = recommend_movies(movie_query=the_post, k_recommendations=5)
# Afficher les titres des films recommandés
for recommendation in recommended_movies:
print(recommendation[1])Quand tu exécutes ce programme avec le dataset complet de l’article, « Recommande Moi un Film » recommande 12 Years A Slave, Hacksaw Ridge, Queen of Katwe, The Wind Rises et A Beautiful Mind.
Maintenant que tu comprends bien le fonctionnement de kNN, tu peux expliquer exactement comment l’algorithme est arrivé à ces recommandations. Félicitations d’être arrivé jusqu’au bout !
Questions fréquentes sur l’algorithme kNN
Qu’est-ce que l’algorithme des k plus proches voisins (kNN) ?
C’est un algorithme de Machine Learning supervisé, simple et facile à mettre en œuvre, qui sert à la classification comme à la régression. Il repose sur le principe que des objets similaires sont proches les uns des autres.
Comment fonctionne kNN étape par étape ?
Il charge les données, calcule la distance entre la requête et chaque observation, trie les distances de la plus petite à la plus grande et sélectionne les k plus proches voisins. Il renvoie ensuite le mode (la valeur la plus fréquente) de leurs étiquettes pour une classification, ou leur moyenne pour une régression.
Comment choisir la valeur de k dans kNN ?
Exécute l’algorithme avec plusieurs valeurs de k et garde celle qui réduit le nombre d’erreurs tout en restant bonne sur des données nouvelles. Avec k = 1, les prédictions sont instables. En augmentant k elles deviennent plus stables, jusqu’à un certain point au-delà duquel les erreurs augmentent. Pour un vote entre deux classes, choisis un k impair pour éviter les égalités.
Quels sont les inconvénients de kNN ?
Il ralentit considérablement quand le nombre d’observations ou de variables augmente, car il calcule la distance avec toutes les observations pour chaque prédiction. Il est aussi sensible à l’échelle des variables : une variable aux valeurs beaucoup plus grandes domine le calcul de la distance, il faut donc normaliser ou standardiser les données avant de l’appliquer.
Quelle est la différence entre classification et régression en Machine Learning supervisé ?
Un problème de classification a une valeur discrète en sortie (par exemple « aime l’ananas sur la pizza » ou non). Un problème de régression a pour sortie un nombre réel (par exemple le poids d’une personne estimé à partir de sa taille).
Conclusion
L’algorithme des k plus proches voisins (kNN) est un algorithme de Machine Learning supervisé simple, utilisable en classification comme en régression. Il est facile à mettre en œuvre et à comprendre, mais son principal inconvénient est un ralentissement important quand la taille des données augmente.
kNN calcule les distances entre une requête cible et toutes les observations, sélectionne les k plus proches, puis retourne l’étiquette la plus fréquente (classification) ou la moyenne des étiquettes (régression).
Pour choisir la bonne valeur de k, on essaie plusieurs valeurs et on garde celle qui fonctionne le mieux.
Enfin, tu as vu un exemple d’utilisation de kNN dans un système de recommandation, une application de la kNN-search.
Pour situer kNN parmi les autres algorithmes, lis notre article sur les principaux modèles de Machine Learning expliqués simplement. Pour aller plus loin avec Python, consulte aussi notre guide des 21 astuces et concepts Python pour améliorer ton code.
Précision
[1] Pour simplifier, le système de recommandation de cet article ne traite pas le cas où le film de la requête fait partie du dataset de recommandation. Dans un vrai système en production, ce cas serait absurde s’il n’était pas géré correctement.