Comment écrire du Python plus clair, plus court et plus rapide ? Python est facile à écrire, mais on peut vite l’utiliser de la mauvaise manière et passer à côté de ses meilleures fonctionnalités. Cet article rassemble 36 astuces et concepts tirés de projets perso, de revues de code et de discussions avec d’autres développeurs.
Tu peux le lire dans l’ordre ou aller directement à la section qui t’intéresse : elles sont indépendantes. Pour chaque astuce, tu as le code, et la vraie sortie de Python.
Article mis à jour en novembre 2026 : tout le code a été exécuté avec Python 3.13 et les vraies sorties sont affichées. J’ai corrigé plusieurs points de la version précédente : l’exemple de pprint dépendait d’une API externe (il utilise maintenant un dictionnaire local), le gestionnaire de contexte Timer ne renvoyait pas self, les méthodes __str__ et __repr__ avaient le même contenu, l’exemple psycopg2 est remplacé par sqlite3 (avec un piège que je détaille), et l’exemple de groupby était incomplet. J’ai ajouté zip(strict=True), total_ordering, @contextmanager et @cache.
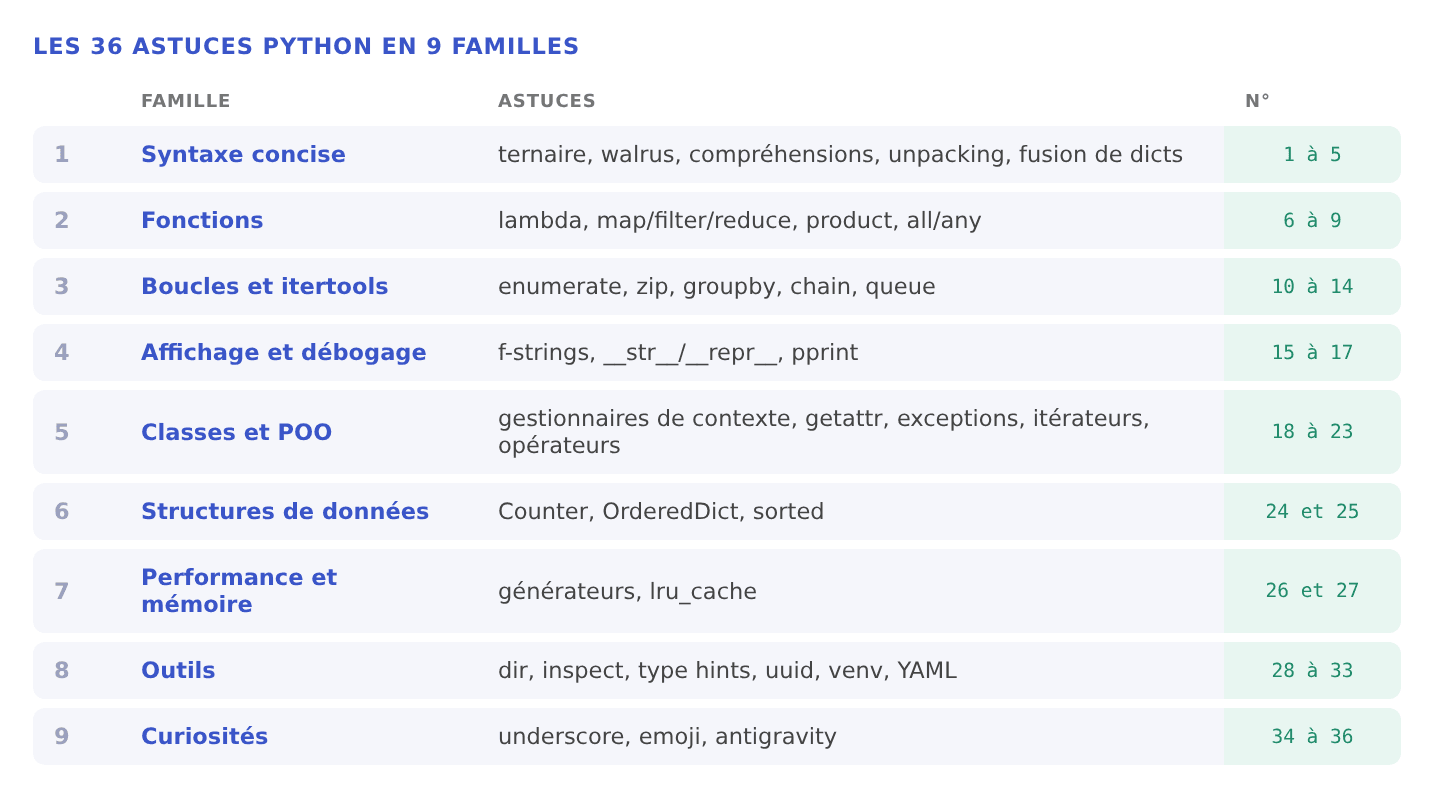
En bref : les 36 astuces se rangent en 9 familles. Syntaxe concise : ternaire, walrus :=, compréhensions, unpacking, fusion de dictionnaires avec |. Fonctions : lambda, map/filter/reduce, product(), all()/any(). Boucles : enumerate, zip, itertools, queue. Affichage : f-strings, __repr__, pprint. POO : with personnalisé, exceptions, itérateurs, surcharge d’opérateurs. Données : Counter, sorted. Performance : générateurs et lru_cache (de 200 ms à quelques microsecondes dans mon test). Outils : inspect, type hints, venv, YAML. Curiosités : _, emoji, antigravity.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : il n’y a aucun fichier à télécharger.
Comment écrire du code Python plus concis ?
1. Comment écrire un if/else sur une seule ligne ?
L’opérateur ternaire écrit une condition sur une ligne : valeur_si_vrai if condition else valeur_si_faux. Il est très utile dans une compréhension de liste.
age = 25
statut = "Adulte" if age >= 18 else "Mineur"
print(statut)

scores = [100, 46, 54, 23, 20, 99]
seuil = 50
resultats = ["admis" if score > seuil else "non admis" for score in scores]
print(resultats)Adulte
['admis', 'non admis', 'admis', 'non admis', 'non admis', 'admis']2. À quoi sert l’opérateur walrus := ?
Depuis Python 3.8, l’opérateur := (le « morse », à cause de sa forme) assigne une valeur à une variable à l’intérieur d’une expression. On ne peut pas écrire une affectation classique dans un appel à print() : Python croit que c’est un argument nommé. Avec le walrus, ça marche :
try:
    print(auteur = "Sun Tzu")
except TypeError as e:
    print("TypeError :", e)

print(auteur := "Sun Tzu")
print(auteur)TypeError : print() got an unexpected keyword argument 'auteur'
Sun Tzu
Sun TzuL’usage le plus utile est d’éviter de calculer deux fois une valeur dans une condition ou une boucle while :
donnees = [4, 8, 15, 16, 23, 42]

if (n := len(donnees)) > 5:
    print(f"La liste est longue ({n} éléments)")

texte = "Python"
while (lettre := texte[:1]):
    print(lettre, end=" ")
texte = texte[1:]La liste est longue (6 éléments)
P y t h o n3. Comment écrire une compréhension de liste, de dictionnaire ou d’ensemble ?
La compréhension construit une collection en une ligne. Dans la version précédente de cet article, les impairs étaient calculés avec y not in evens, ce qui reparcourt la liste à chaque élément : il est plus simple et plus rapide de tester directement x % 2 != 0. Le même principe existe pour les dictionnaires et les ensembles :
nombres = [1, 2, 3, 4, 5, 6, 7]

pairs = [x for x in nombres if x % 2 == 0]
impairs = [x for x in nombres if x % 2 != 0]
print(pairs, impairs)

carres = {x: x ** 2 for x in nombres}
mots_uniques = {mot.lower() for mot in ["Python", "python", "SQL", "sql"]}
print(carres)
print(mots_uniques)[2, 4, 6] [1, 3, 5, 7]
{1: 1, 2: 4, 3: 9, 4: 16, 5: 25, 6: 36, 7: 49}
{'sql', 'python'}4. Comment décomposer une séquence et échanger deux variables ?
L’unpacking assigne plusieurs valeurs en une ligne. Il permet aussi d’échanger deux variables sans variable temporaire, et de récupérer plusieurs valeurs de retour d’une fonction :
a = 10
b = 20
a, b = b, a
print(a, b)

point = (3, 4)
x, y = point


def get_name():
    return "John", "Doe"


prenom, nom = get_name()
print(x, y, prenom, nom)20 10
3 4 John DoeL’astérisque * fusionne plusieurs itérables de types différents dans une liste, ou capte « le milieu » d’une séquence :
A = [1, 2, 3]
B = (4, 5, 6)
C = {7, 8, 9}
L = [*A, *B, *C]
print(L)

premier, *milieu, dernier = [1, 2, 3, 4, 5, 6]
print(premier, milieu, dernier)[1, 2, 3, 4, 5, 6, 8, 9, 7]
1 [2, 3, 4, 5] 6Remarque : les éléments du set {7, 8, 9} sortent dans l’ordre 8, 9, 7. Un set n’a pas d’ordre garanti, ne compte pas dessus.
5. Comment fusionner deux dictionnaires ?
Deux solutions : l’unpacking {**d1, **d2} (Python 3.5+) ou l’opérateur union | (Python 3.9+), plus lisible. Quand une clé existe dans les deux, la valeur du dernier dictionnaire gagne. |= fusionne sur place :
dict1 = {"a": 1, "b": 2}
dict2 = {"b": 3, "c": 4}

print({**dict1, **dict2})
print(dict1 | dict2)        # Python 3.9+ : en cas de clé commune, la dernière gagne

villes_us = {"New York": "US", "Los Angeles": "US"}
villes_fr = {"Paris": "FR", "Biarritz": "FR"}
villes_us |= villes_fr      # fusion sur place
print(villes_us){'a': 1, 'b': 3, 'c': 4}
{'a': 1, 'b': 3, 'c': 4}
{'New York': 'US', 'Los Angeles': 'US', 'Paris': 'FR', 'Biarritz': 'FR'}Quelles astuces pour la programmation fonctionnelle en Python ?
6. Qu’est-ce qu’une fonction lambda ?
Une fonction lambda est une fonction anonyme, écrite en une expression. Elle sert surtout d’argument à une autre fonction (map, sorted…). La PEP 8 déconseille de l’affecter à un nom (add = lambda ...) : dans ce cas, écris plutôt un def. Je garde l’exemple ci-dessous pour illustrer la syntaxe, dont la récursion :
add = lambda x, y: x + y
print(add(10, 2))

fib = lambda n: n if n <= 1 else fib(n - 1) + fib(n - 2)
print([fib(n) for n in range(10)])

scores = [100, 46, 54]
print(list(map(lambda s: "admis" if s > 50 else "non admis", scores)))12
[0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
['admis', 'non admis', 'admis']Attention : cette version récursive de Fibonacci recalcule les mêmes valeurs, elle devient très lente dès n grand. Pour la suite, regarde @cache (astuce 27).
7. Comment utiliser map, filter et reduce ?
map applique une fonction à chaque élément, filter garde ceux qui respectent une condition, et reduce (du module functools) cumule les éléments en une seule valeur. map fonctionne aussi avec une fonction existante comme str.capitalize, sans lambda :
from functools import reduce

nombres = [1, 2, 3, 4, 5]
print(list(map(lambda x: x ** 2, nombres)))
print(list(filter(lambda x: x % 2 == 0, nombres)))
print(reduce(lambda x, y: x + y, nombres))

noms = ["rOd", "MARc", "thoMas", "LISA"]
print(list(map(str.capitalize, noms)))[1, 4, 9, 16, 25]
[2, 4]
15
['Rod', 'Marc', 'Thomas', 'Lisa']Pour savoir quand préférer une compréhension, une boucle ou map, lis 11 habitudes qui font de toi un mauvais programmeur Python, où je mesure les temps.
8. Comment éviter les boucles imbriquées avec product() ?
Des boucles for imbriquées sont difficiles à lire. itertools.product génère toutes les combinaisons en une seule boucle, et le résultat est identique :
from itertools import product

liste_a = [1, 2023, 88]
liste_b = [2, 4, 7, 2000]
liste_c = [3, 75, 9]

imbriquees = []
for a in liste_a:
    for b in liste_b:
        for c in liste_c:
            if a + b + c == 2097:
                imbriquees.append((a, b, c))

avec_product = [(a, b, c) for a, b, c in product(liste_a, liste_b, liste_c) if a + b + c == 2097]
print(imbriquees, avec_product, imbriquees == avec_product)[(88, 2000, 9)] [(88, 2000, 9)] True9. À quoi servent all() et any() ?
any() renvoie True si au moins un élément est vrai, all() si tous le sont. Avec une expression génératrice, elles remplacent bien des boucles. Piège : sur une liste vide, all([]) est True et any([]) est False.
x = [True, True, False]

if any(x):
    print("Au moins un True")
if all(x):
    print("Aucun False")
if any(x) and not all(x):
    print("Au moins un True et au moins un False")

notes = [12, 15, 9, 18]
print(all(note >= 10 for note in notes))
print(all([]), any([]))Au moins un True
Au moins un True et au moins un False
False
True FalseComment mieux parcourir des données avec les boucles et itertools ?
10. Comment obtenir l’index en parcourant une liste ?
enumerate renvoie l’index et la valeur. Le paramètre start choisit le premier numéro :
fruits = ["pomme", "banane", "orange"]
for index, fruit in enumerate(fruits, start=1):
print(f"{index}. {fruit}")1. pomme
2. banane
3. orange11. Comment parcourir plusieurs listes en même temps ?
zip associe les éléments de plusieurs séquences. Avec dict(zip(...)), tu crées un dictionnaire à partir de deux listes. Depuis Python 3.10, strict=True lève une erreur si les longueurs diffèrent, au lieu de couper en silence :
noms = ["Alice", "Bob", "Charlie"]
ages = [25, 30, 35]
for nom, age in zip(noms, ages):
    print(f"Prénom : {nom}, âge : {age}")

print(dict(zip(["a", "b", "c"], [1, 2, 3])))

try:
    list(zip([1, 2, 3], ["x", "y"], strict=True))
except ValueError as e:
print("ValueError :", e)Prénom : Alice, âge : 25
Prénom : Bob, âge : 30
Prénom : Charlie, âge : 35
{'a': 1, 'b': 2, 'c': 3}
ValueError : zip() argument 2 is shorter than argument 112. Comment regrouper des éléments avec itertools.groupby ?
groupby regroupe les éléments consécutifs qui ont la même clé. Il faut donc trier d’abord sur cette clé. Regarde la différence sur la liste d’employés : sans tri, « IT » apparaît deux fois, avec trois groupes d’un seul élément. Après le tri, les deux employés IT sont réunis :
from itertools import groupby
from operator import itemgetter

code = "AAAABBBBBCCCCDDDEEEE"
for cle, groupe in groupby(code):
    print(f"clé : {cle} | groupe : {list(groupe)}")

employes = [
    {"nom": "john", "service": "IT"},
    {"nom": "joe", "service": "finance"},
    {"nom": "alice", "service": "IT"},
]
print([(cle, len(list(g))) for cle, g in groupby(employes, key=itemgetter("service"))])
employes.sort(key=itemgetter("service"))
for service, groupe in groupby(employes, key=itemgetter("service")):
print(service, [e["nom"] for e in groupe])clé : A | groupe : ['A', 'A', 'A', 'A']
clé : B | groupe : ['B', 'B', 'B', 'B', 'B']
clé : C | groupe : ['C', 'C', 'C', 'C']
clé : D | groupe : ['D', 'D', 'D']
clé : E | groupe : ['E', 'E', 'E', 'E']
[('IT', 1), ('finance', 1), ('IT', 1)]
IT ['john', 'alice']
finance ['joe']13. Comment fusionner une liste de listes ?
chain enchaîne plusieurs itérables. chain.from_iterable évite l’étoile, et une compréhension à deux niveaux donne le même résultat :
from itertools import chain

liste_de_listes = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
print(list(chain(*liste_de_listes)))
print(list(chain.from_iterable(liste_de_listes)))
print([x for sous_liste in liste_de_listes for x in sous_liste])[1, 2, 3, 4, 5, 6, 7, 8, 9]
[1, 2, 3, 4, 5, 6, 7, 8, 9]
[1, 2, 3, 4, 5, 6, 7, 8, 9]14. À quoi sert le module queue avec les threads ?
Le module queue fournit des files d’attente sûres à utiliser entre plusieurs threads : Queue (FIFO, premier entré premier sorti), LifoQueue (dernier entré premier sorti) et PriorityQueue (par priorité) :
import queue

fifo = queue.Queue()
lifo = queue.LifoQueue()
priorite = queue.PriorityQueue()
for n in range(5):
    fifo.put(n)
    lifo.put(n)
for p, tache in [(3, "faible"), (1, "urgent"), (2, "normal")]:
    priorite.put((p, tache))

print("FIFO :", [fifo.get() for _ in range(5)])
print("LIFO :", [lifo.get() for _ in range(5)])
print("Priorité :", [priorite.get()[1] for _ in range(3)])FIFO : [0, 1, 2, 3, 4]
LIFO : [4, 3, 2, 1, 0]
Priorité : ['urgent', 'normal', 'faible']Cas d’usage classique : plusieurs threads « travailleurs » se partagent des tâches. On envoie None comme signal d’arrêt :
import threading

taches = queue.Queue()
resultats = queue.Queue()


def travailleur():
    while True:
        n = taches.get()
        if n is None:           # signal d'arrêt
            break
        resultats.put(n ** 2)


for n in range(8):
    taches.put(n)
fils = [threading.Thread(target=travailleur) for _ in range(3)]
for fil in fils:
    fil.start()
for _ in fils:
    taches.put(None)
for fil in fils:
    fil.join()
print(sorted(resultats.queue))[0, 1, 4, 9, 16, 25, 36, 49]Comment mieux formater, afficher et déboguer ?
15. Comment utiliser les f-strings ?
Les f-strings sont la méthode la plus lisible pour formater du texte. Elles évaluent n’importe quelle expression, y compris un appel de fonction, et {x = } affiche le nom et la valeur (pratique pour déboguer) :
from datetime import datetime

nom, age = "Alice", 25
print(f"Hello {nom}, tu as {age} ans !")


def additionner(a, b):
    return a + b


print(f"La somme de 5 et 3 est {additionner(5, 3)}.")
print(f"{age = }")Hello Alice, tu as 25 ans !
La somme de 5 et 3 est 8.
age = 25Le formatage précis se règle après les deux-points : décimales, zéros devant, séparateur de milliers, pourcentage, date. Python met une virgule comme séparateur de milliers : remplace-la par une espace pour un affichage français.
pi = 3.14159265359
print(f"La valeur de pi est environ {pi:.2f}.")

identifiant = 1
print(f"L'id est {identifiant:03d}")

fortune = 1000000000
print(f"Sa fortune est de {fortune:,d} €")
print(f"Sa fortune est de {fortune:,d} €".replace(",", " "))
print(f"Part : {0.256:.1%}")

aujourdhui = datetime(2026, 11, 9)
print(f"Nous sommes le {aujourdhui:%d/%m/%Y}")La valeur de pi est environ 3.14.
L'id est 001
Sa fortune est de 1,000,000,000 €
Sa fortune est de 1 000 000 000 €
Part : 25.6%
Nous sommes le 09/11/202616. Quelle différence entre __str__ et __repr__ ?
__str__ produit l’affichage lisible pour l’utilisateur (print()). __repr__ produit une représentation sans ambiguïté pour le développeur : elle est utilisée dans l’interpréteur, dans les listes et par le débogueur. La convention est de renvoyer un texte qui ressemble à l’appel du constructeur. Si tu n’en écris qu’une, écris __repr__ : __str__ s’appuie dessus par défaut.
class Personne:
    def __init__(self, prenom, nom, age):
        self.prenom = prenom
        self.nom = nom
        self.age = age

    def __str__(self):
        return f"{self.prenom} {self.nom} ({self.age} ans)"

    def __repr__(self):
        return f"Personne({self.prenom!r}, {self.nom!r}, {self.age!r})"


rod = Personne("Rod", "Paris", 30)
print(rod)          # utilise __str__
print(repr(rod))    # utilise __repr__
print([rod]) # une liste affiche le __repr__ de ses élémentsRod Paris (30 ans)
Personne('Rod', 'Paris', 30)
[Personne('Rod', 'Paris', 30)]17. Comment afficher proprement une structure imbriquée avec pprint ?
Un print() d’un dictionnaire imbriqué (une réponse d’API, un JSON) donne une ligne illisible :
import pprint

reponse = {"results": [{"gender": "female", "name": {"title": "Ms", "first": "Léa", "last": "Martin"}, "location": {"city": "Lyon", "country": "France", "coordinates": {"latitude": "45.76", "longitude": "4.83"}}, "email": "lea.martin@example.com"}], "info": {"seed": "abc123", "results": 1, "page": 1, "version": "1.4"}}

print(reponse){'results': [{'gender': 'female', 'name': {'title': 'Ms', 'first': 'Léa', 'last': 'Martin'}, 'location': {'city': 'Lyon', 'country': 'France', 'coordinates': {'latitude': '45.76', 'longitude': '4.83'}}, 'email': 'lea.martin@example.com'}], 'info': {'seed': 'abc123', 'results': 1, 'page': 1, 'version': '1.4'}}Le module pprint (pretty print) met en forme la structure sur plusieurs lignes. Il trie les clés par défaut ; ajoute sort_dicts=False pour garder l’ordre d’origine :
pprint.pprint(reponse, width=70){'info': {'page': 1,
'results': 1,
'seed': 'abc123',
'version': '1.4'},
'results': [{'email': 'lea.martin@example.com',
'gender': 'female',
'location': {'city': 'Lyon',
'coordinates': {'latitude': '45.76',
'longitude': '4.83'},
'country': 'France'},
'name': {'first': 'Léa',
'last': 'Martin',
'title': 'Ms'}}]}Comment aller plus loin avec les classes et la POO ?
18. À quoi servent les gestionnaires de contexte (with) ?
Le bloc with garantit qu’une ressource est libérée, même si une erreur survient. Le cas classique est open() :
import os
import tempfile

chemin = os.path.join(tempfile.gettempdir(), "notes.txt")
with open(chemin, "w", encoding="utf-8") as f:
    f.write("ligne 1\nligne 2\n")

with open(chemin, encoding="utf-8") as f:
    contenu = f.read()
print(repr(contenu), "| fichier fermé :", f.closed)'ligne 1\nligne 2\n' | fichier fermé : TrueIl fonctionne aussi pour les verrous (Lock). Ici, 4 threads incrémentent 10 000 fois le même compteur, et le verrou garantit que le total est exact :
import threading

etat = {"compteur": 0}
verrou = threading.Lock()


def incrementer():
    for _ in range(10_000):
        with verrou:                 # section critique
            etat["compteur"] += 1


fils = [threading.Thread(target=incrementer) for _ in range(4)]
for fil in fils:
    fil.start()
for fil in fils:
    fil.join()
print(etat["compteur"])40000Pour les bases de données, attention à un piège avec sqlite3 : le with valide ou annule la transaction, mais il ne ferme pas la connexion. Pour la fermer, utilise contextlib.closing :
import sqlite3
from contextlib import closing

with sqlite3.connect(":memory:") as conn:        # valide (commit) ou annule (rollback)
    conn.execute("CREATE TABLE t (x INTEGER)")
    conn.execute("INSERT INTO t VALUES (1)")
print("après with, la connexion répond encore :", conn.execute("SELECT COUNT(*) FROM t").fetchone())

with closing(sqlite3.connect(":memory:")) as conn2:   # closing() ferme vraiment
    conn2.execute("SELECT 1")
try:
    conn2.execute("SELECT 1")
except sqlite3.ProgrammingError as e:
print("ProgrammingError :", e)après with, la connexion répond encore : (1,)
ProgrammingError : Cannot operate on a closed database.19. Comment créer son propre gestionnaire de contexte ?
Définis une classe avec __enter__() et __exit__(). Le premier prépare la ressource (et renvoie l’objet à utiliser après as), le second la libère. Voici un chronomètre :
import time


class Chrono:
    def __enter__(self):
        self.debut = time.perf_counter()
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        self.duree = time.perf_counter() - self.debut
        print(f"Durée d'exécution : {self.duree:.1f} s")


with Chrono():
time.sleep(0.1)Durée d'exécution : 0.1 sPlus court : le décorateur @contextmanager transforme une fonction génératrice en gestionnaire de contexte. Ce qui précède yield joue le rôle d’__enter__, et le bloc finally celui d’__exit__ :
from contextlib import contextmanager


@contextmanager
def fichier_ecriture(chemin):
    f = open(chemin, mode="w", encoding="utf-8")
    try:
        yield f
    finally:
        f.close()
        print("fichier refermé")


with fichier_ecriture(chemin) as f:
    f.write("bonjour")
print(f.closed)fichier refermé
True20. Comment lire et écrire des attributs dynamiquement avec setattr et getattr ?
setattr définit un attribut à partir de son nom (une chaîne), getattr le lit. Avec une valeur par défaut, getattr évite une AttributeError. hasattr teste l’existence :
class Personne:
    pass


personne = Personne()
setattr(personne, "nom", "John")
setattr(personne, "age", 25)
print(personne.nom, personne.age)

print(getattr(personne, "adresse", "N/A"))
print(hasattr(personne, "adresse"))
try:
    personne.adresse
except AttributeError as e:
print("AttributeError :", e)John 25
N/A
False
AttributeError : 'Personne' object has no attribute 'adresse'21. Pourquoi créer ses propres classes d’exception ?
Une exception personnalisée rend les erreurs explicites et permet de les attraper précisément, au lieu d’un ValueError générique. Elle peut aussi transporter des informations utiles (ici la longueur maximale) :
class NomTropLongError(Exception):
    """Levée quand un nom dépasse la longueur autorisée."""

    def __init__(self, nom, longueur_max):
        self.nom = nom
        self.longueur_max = longueur_max
        super().__init__(f"Le nom '{nom}' est trop long (maximum {longueur_max} caractères).")


def traiter_nom(nom):
    longueur_max = 10
    if len(nom) > longueur_max:
        raise NomTropLongError(nom, longueur_max)
    return nom.title()


try:
    traiter_nom("UnNomVraimentTropLong")
except NomTropLongError as e:
    print("Erreur :", e)
print("Limite :", e.longueur_max)Erreur : Le nom 'UnNomVraimentTropLong' est trop long (maximum 10 caractères).
Limite : 1022. Comment créer son propre itérateur ?
Un itérateur implémente __iter__() et __next__(). Il lève StopIteration à la fin. Un itérateur ne se parcourt qu’une fois : la deuxième conversion en liste est vide. Une fonction génératrice avec yield donne le même résultat en 3 lignes :
class IterateurCarres:
    def __init__(self, nombres):
        self.nombres = nombres
        self.index = 0

    def __iter__(self):
        return self

    def __next__(self):
        if self.index >= len(self.nombres):
            raise StopIteration
        carre = self.nombres[self.index] ** 2
        self.index += 1
        return carre


carres = IterateurCarres([1, 2, 3, 4])
print(list(carres))
print(list(carres))        # l'itérateur est épuisé


def generateur_carres(nombres):
    for n in nombres:
        yield n ** 2


print(list(generateur_carres([1, 2, 3, 4])))[1, 4, 9, 16]
[]
[1, 4, 9, 16]23. Qu’est-ce que la surcharge d’opérateurs ?
Pourquoi + additionne des nombres et concatène des chaînes ? Parce que chaque classe définit ce que l’opérateur signifie pour elle, avec des méthodes spéciales (__add__, __lt__…). Avec @total_ordering, il suffit de définir __eq__ et __lt__ : Python déduit les autres comparaisons.
from functools import total_ordering


@total_ordering
class Chose:
    def __init__(self, valeur):
        self.valeur = valeur

    def __eq__(self, autre):
        return self.valeur == autre.valeur

    def __lt__(self, autre):
        return self.valeur < autre.valeur


un_truc, rien = Chose(100), Chose(0)
print(un_truc > rien, un_truc < rien, un_truc >= rien)


class Vecteur:
    def __init__(self, x, y):
        self.x, self.y = x, y

    def __add__(self, autre):
        return Vecteur(self.x + autre.x, self.y + autre.y)

    def __repr__(self):
        return f"Vecteur({self.x}, {self.y})"


print(Vecteur(1, 2) + Vecteur(3, 4))True False True
Vecteur(4, 6)Quelles structures de données utiliser ?
24. À quoi servent Counter et OrderedDict ?
Counter compte les éléments hachables, et most_common(n) renvoie les plus fréquents :
from collections import Counter, OrderedDict

ma_liste = [1, 2, 3, 2, 1, 3, 4, 5, 1]
compte = Counter(ma_liste)
print(compte)
print(compte.most_common(2))

print(Counter("abracadabra").most_common(3))Counter({1: 3, 2: 2, 3: 2, 4: 1, 5: 1})
[(1, 3), (2, 2)]
[('a', 5), ('b', 2), ('r', 2)]Depuis Python 3.7, un dictionnaire normal garde déjà l’ordre d’insertion. OrderedDict reste utile dans deux cas : move_to_end() et une égalité qui tient compte de l’ordre.
x = OrderedDict(a=1, b=2, c=3)
x.move_to_end("a")
print(list(x))

print({"a": 1, "b": 2} == {"b": 2, "a": 1})
print(OrderedDict(a=1, b=2) == OrderedDict(b=2, a=1))['b', 'c', 'a']
True
False25. Comment trier des objets complexes avec sorted ?
Le paramètre key indique selon quoi trier. operator.itemgetter et attrgetter sont des alternatives lisibles aux lambdas. Pour trier selon plusieurs critères, renvoie un tuple (le signe moins inverse l’ordre d’un nombre) :
from operator import attrgetter, itemgetter

personnes = [
    {"nom": "Alice", "age": 25},
    {"nom": "Bob", "age": 30},
    {"nom": "Charlie", "age": 20},
]
print([p["nom"] for p in sorted(personnes, key=lambda p: p["age"])])
print([p["nom"] for p in sorted(personnes, key=itemgetter("age"), reverse=True)])


class Employe:
    def __init__(self, nom, salaire):
        self.nom, self.salaire = nom, salaire


equipe = [Employe("Zoé", 3200), Employe("Max", 2800), Employe("Eva", 3200)]
tri = sorted(equipe, key=lambda e: (-e.salaire, e.nom))
print([e.nom for e in tri])
print([e.nom for e in sorted(equipe, key=attrgetter("salaire"))])['Charlie', 'Alice', 'Bob']
['Bob', 'Alice', 'Charlie']
['Eva', 'Zoé', 'Max']
['Max', 'Zoé', 'Eva']Comment gagner en performance et en mémoire ?
26. Pourquoi utiliser des générateurs ?
Un générateur produit les valeurs une par une avec yield, sans tout stocker. Il peut même être infini : on récupère les premières valeurs avec islice :
from itertools import islice


def fibonacci():
    a, b = 0, 1
    while True:
        yield a
        a, b = b, a + b


print(list(islice(fibonacci(), 12)))[0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89]Cas d’usage naturel : lire un gros fichier ligne par ligne sans le charger en mémoire (ici un petit fichier de 5 lignes pour l’exemple) :
import os
import tempfile

chemin_gros = os.path.join(tempfile.gettempdir(), "gros_fichier.txt")
with open(chemin_gros, "w", encoding="utf-8") as f:
    f.write("\n".join(f"ligne {i}" for i in range(1, 6)))


def lire_gros_fichier(nom_fichier):
    with open(nom_fichier, encoding="utf-8") as fichier:
        for ligne in fichier:
            yield ligne.strip()


for ligne in lire_gros_fichier(chemin_gros):
    if ligne.endswith(("2", "4")):
print(ligne)ligne 2
ligne 4La différence de mémoire est spectaculaire. Pour un million de carrés, la liste pèse environ 8,4 Mo (sans compter les entiers qu’elle contient), le générateur 200 octets, quelle que soit la taille :
import sys

liste = [n * n for n in range(1_000_000)]
generateur = (n * n for n in range(1_000_000))
print(f"liste       : {sys.getsizeof(liste):,} octets".replace(",", " "))
print(f"générateur : {sys.getsizeof(generateur):,} octets".replace(",", " "))liste : 8 448 728 octets
générateur : 200 octets27. Comment éviter de recalculer avec lru_cache ?
@lru_cache mémorise les résultats d’une fonction : si elle est rappelée avec les mêmes arguments, Python renvoie la valeur gardée en mémoire. J’ai simulé une requête réseau avec sleep(0.2) (les temps dépendent de ta machine) :
import time
from functools import lru_cache


@lru_cache(maxsize=128)
def recuperer(url):
    time.sleep(0.2)                  # simule une requête réseau
    return f"contenu de {url}"


for i in (1, 2):
    debut = time.perf_counter()
    recuperer("https://exemple.fr")
    print(f"appel {i} : {(time.perf_counter() - debut) * 1000:.3f} ms")
print(recuperer.cache_info())appel 1 : 200.313 ms
appel 2 : 0.003 ms
CacheInfo(hits=1, misses=1, maxsize=128, currsize=1)Le premier appel prend environ 200 ms, le second quelques microsecondes. cache_info() confirme 1 échec et 1 succès. Attention : n’utilise ce cache que pour des fonctions dont le résultat ne change pas pour les mêmes arguments. Depuis Python 3.9, @cache est la version sans limite de taille. Elle rend la suite de Fibonacci instantanée, là où la version récursive naïve explose :
from functools import cache


@cache
def fib(n):
    return n if n < 2 else fib(n - 1) + fib(n - 2)


print(fib(80))23416728348467685Quels outils pour explorer et fiabiliser ton code ?
28. Comment explorer un objet avec dir() ?
dir(objet) liste les attributs et méthodes d’un objet. Pratique dans un interpréteur ou un notebook pour découvrir ce qu’on peut faire. Voici les 8 premières méthodes publiques d’une chaîne :
print([m for m in dir("Hello World") if not m.startswith("_")][:8])
print("upper" in dir(str), "append" in dir(list))['capitalize', 'casefold', 'center', 'count', 'encode', 'endswith', 'expandtabs', 'find']
True True29. À quoi sert le module inspect ?
Le module inspect donne accès à la signature d’une fonction, à sa documentation, à son code source ou au numéro de ligne courant : utile pour du code auto-documenté ou du débogage. Voici un fichier outils.py :
import inspect


def saluer(nom: str, politesse: bool = True) -> str:
    """Renvoie un message de bienvenue."""
    return f"Bonjour {nom}" if politesse else f"Salut {nom}"


def ligne_courante():
    return inspect.currentframe().f_lineno
import inspect
import outils
print(inspect.signature(outils.saluer))
print(inspect.getdoc(outils.saluer))
print(inspect.getsource(outils.saluer))
print(inspect.getmodule(outils.saluer).__name__)
print(outils.ligne_courante())(nom: str, politesse: bool = True) -> str
Renvoie un message de bienvenue.
def saluer(nom: str, politesse: bool = True) -> str:
"""Renvoie un message de bienvenue."""
return f"Bonjour {nom}" if politesse else f"Salut {nom}"
outils
1030. À quoi servent les indications de type ?
Depuis Python 3.5, on peut annoter les types des arguments et du résultat. Python ne les vérifie pas à l’exécution (ici, un décimal passe sans erreur dans une fonction annotée int), mais ton éditeur et des outils comme mypy s’en servent pour détecter les erreurs avant l’exécution :
def ajouter_deux(x: int) -> int:
    return x + 2


print(ajouter_deux.__annotations__)
print(ajouter_deux(1.5)) # Python ne vérifie pas : aucune erreur{'x': <class 'int'>, 'return': <class 'int'>}
3.5Depuis Python 3.9, écris list[float] directement, sans importer List. Tu peux définir des alias pour les structures complexes. Cette version de l’addition de matrices, avec zip, remplace les quatre boucles de la version précédente :
Vecteur = list[float]
Matrice = list[Vecteur]


def additionner_matrices(a: Matrice, b: Matrice) -> Matrice:
    return [[x + y for x, y in zip(ligne_a, ligne_b)] for ligne_a, ligne_b in zip(a, b)]


print(additionner_matrices([[1.0, 2.0], [3.0, 4.0]], [[10.0, 20.0], [30.0, 40.0]]))[[11.0, 22.0], [33.0, 44.0]]31. Comment générer un identifiant unique avec uuid ?
Le module uuid génère des identifiants universellement uniques. uuid4() est aléatoire (donc différent à chaque exécution), uuid5() est déterministe à partir d’un nom : même nom, même identifiant.
import uuid

identifiant = uuid.uuid4()
print(len(str(identifiant)), identifiant.version)
print(uuid.uuid5(uuid.NAMESPACE_DNS, "moncoachdata.com"))36 4
ad3d936f-5745-5e96-8db9-1b5d8fae4da232. Pourquoi utiliser des environnements virtuels ?
Un environnement virtuel isole les bibliothèques d’un projet : deux projets peuvent avoir des versions différentes (parfois incompatibles) d’un même paquet sans se gêner. Il est indispensable dès que tu as plus d’un projet. Sous Windows, la commande d’activation est mon-projet\Scripts\activate.
python -m venv mon-projet
source mon-projet/bin/activate
python -c "import sys; print('environnement virtuel actif :', sys.prefix != sys.base_prefix)"
pip freeze | wc -l
deactivate
ls mon-projetenvironnement virtuel actif : True
0
bin
include
lib
lib64
pyvenv.cfgL’environnement est actif, et il est vide (pip freeze ne liste aucun paquet) : tu installes seulement ce dont le projet a besoin.
33. Pourquoi utiliser YAML pour les fichiers de configuration ?
YAML est un format lisible qui accepte les commentaires, ce que JSON ne permet pas. Il convient aux fichiers de configuration (hyperparamètres, chemins, options). Installe-le avec pip install pyyaml. Voici un fichier config.yaml :
# Configuration de l'application
modele:
  nom: random_forest
  parametres:
    n_estimators: 200
    max_depth: 8
donnees:
  chemin: data/clients.csv
  colonnes: [age, revenu, ville]
debug: trueUtilise yaml.safe_load pour le lire, jamais yaml.load sur un fichier que tu n’as pas écrit : il peut exécuter du code arbitraire.
import yaml

with open("config.yaml", encoding="utf-8") as f:
    config = yaml.safe_load(f)
print(config)
print(config["modele"]["parametres"]["n_estimators"])
print(yaml.dump({"debug": False, "seuil": 0.5, "villes": ["Paris", "Lyon"]}, allow_unicode=True)){'modele': {'nom': 'random_forest', 'parametres': {'n_estimators': 200, 'max_depth': 8}}, 'donnees': {'chemin': 'data/clients.csv', 'colonnes': ['age', 'revenu', 'ville']}, 'debug': True}
200
debug: false
seuil: 0.5
villes:
- Paris
- LyonQuelles sont les petites curiosités de Python ?
34. À quoi sert vraiment le underscore (_) ?
Par convention, _ désigne une valeur qu’on ignore : dans un unpacking, comme variable d’une boucle dont on n’utilise pas la valeur, ou pour ignorer une valeur de retour. Il sert aussi de séparateur dans les grands nombres (1_000_000) :
_, age, _ = ("John", 25, "USA")
print(age)

for _ in range(3):
    print("Bouclage...")

print(1_000_000 + 250_000)25
Bouclage...
Bouclage...
Bouclage...
125000035. Comment ajouter des emojis dans ses chaînes ?
Le module emoji (pip install emoji) convertit des codes comme :thumbs_up: en emojis, et inversement :
import emoji

print(emoji.emojize("Bravo :thumbs_up: :snake:"))
print(emoji.demojize("Python 🐍"))Bravo 👍 🐍
Python :snake:36. Que fait import antigravity ?
Python tire son nom des Monty Python, et la bibliothèque standard cache quelques clins d’œil. Écris import antigravity dans un interpréteur : le module ouvre dans ton navigateur la bande dessinée xkcd n°353, où un personnage découvre Python. Pour ne pas ouvrir de navigateur ici, j’ai remplacé webbrowser.open par un simple print et on voit l’adresse visée :
import webbrowser

webbrowser.open = lambda url, *a, **k: print("Ouvre :", url)   # on intercepte l'ouverture du navigateur
import antigravityOuvre : https://xkcd.com/353/Autre classique : import this affiche le « Zen de Python », les principes de conception du langage.
Questions fréquentes
Quelles sont les meilleures astuces Python pour écrire un code plus propre ?
Utiliser des compréhensions de liste, l’unpacking, les f-strings, enumerate et zip dans les boucles, le bloc with pour les ressources, les générateurs pour les gros volumes, et des indications de type. Les 36 astuces de cet article sont rangées en 9 familles, avec le code et sa sortie pour chacune.
À quoi sert l’opérateur walrus := en Python ?
Il assigne une valeur à une variable à l’intérieur d’une expression (Python 3.8+). On l’utilise surtout pour éviter de calculer deux fois la même valeur, par exemple dans un if ou une boucle while : if (n := len(donnees)) > 5: …
Comment fusionner deux dictionnaires en Python ?
Avec l’opérateur union d1 | d2 (Python 3.9+) ou l’unpacking {**d1, **d2}. Si une clé existe dans les deux, la valeur du dernier dictionnaire l’emporte. d1 |= d2 fusionne sur place.
Quelle différence entre __str__ et __repr__ ?
__str__ produit l’affichage lisible destiné à l’utilisateur, utilisé par print(). __repr__ produit une représentation non ambiguë destinée au développeur, utilisée dans l’interpréteur, les listes et le débogueur. Si tu n’en écris qu’une, écris __repr__ : __str__ l’utilise par défaut.
Pourquoi utiliser un générateur plutôt qu’une liste ?
Un générateur produit les valeurs à la demande, sans les stocker. Dans mon test, un million de carrés occupe environ 8,4 Mo dans une liste (hors entiers contenus) contre 200 octets avec un générateur. Il se parcourt en revanche une seule fois.
Comment accélérer une fonction qui recalcule les mêmes résultats ?
Avec le décorateur @lru_cache (ou @cache depuis Python 3.9) du module functools : le résultat est mémorisé pour chaque jeu d’arguments. Dans mon test, un appel simulé à 200 ms tombe à quelques microsecondes au second appel. À réserver aux fonctions dont le résultat ne dépend que des arguments.
Conclusion : par où commencer avec ces astuces Python ?
Tu n’as pas à tout retenir d’un coup. Commence par celles qui changent le plus ton quotidien : les compréhensions, l’unpacking, les f-strings, enumerate et zip, le bloc with, puis les générateurs et @cache quand tes données grossissent. Les autres viendront quand tu en auras besoin. Pour des habitudes à éviter, regarde 11 habitudes qui font de toi un mauvais programmeur Python.
Pour appliquer ces astuces et progresser en Python, le mieux est de pratiquer. Sur DataXp, tu apprends Python et la data science avec des exercices pratiques à faire directement en ligne.
Pour aller plus loin en Python, voici d’autres articles qui pourraient te plaire :