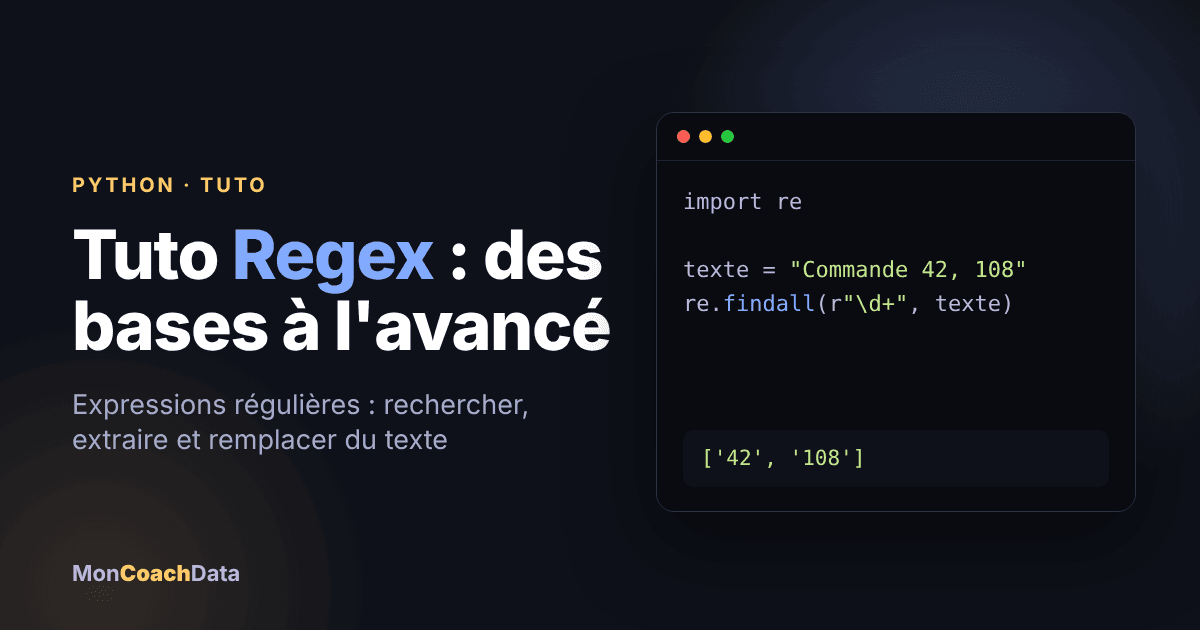
Les expressions régulières (regex ou regexp) sont extrêmement utiles pour extraire des informations d’un texte : elles recherchent une ou plusieurs correspondances à l’aide d’un modèle de recherche spécifique (une séquence de caractères ASCII ou Unicode). Voici un rapide tuto regex pour avoir une vision d’ensemble de ce domaine.
Les domaines d’application vont de la validation à l’analyse et au remplacement de chaînes de caractères, en passant par la transposition de données vers d’autres formats, mais aussi par le web scraping (lire l’article).
L’une des fonctionnalités les plus intéressantes : une fois la syntaxe apprise, tu peux l’utiliser dans (presque) tous les langages de programmation (JavaScript, Java, VB, C#, C/C++, Python, Perl, Ruby, Delphi, R, Tcl et bien d’autres). Il existe de légères différences pour les fonctionnalités avancées et les versions de syntaxe prises en charge par les moteurs.
En bref : une expression régulière (regex) est un modèle de recherche qui permet de valider, extraire ou remplacer du texte. Une fois la syntaxe apprise (ancres ^ et $, quantificateurs, classes de caractères, groupes de capture, références arrières, recherches avant et après), tu peux l’utiliser dans presque tous les langages de programmation, dont Python.
Tu peux aussi exécuter les exemples de regex dans ce notebook Google Colab : chaque extrait de code est dans sa propre cellule, prêt à être modifié.
Si tu es débutant, je te recommande ce tuto sur les regex sur Google Sheets.
Commençons par quelques exemples et explications.
Tuto regex : quelles sont les bases à connaître ?
Que font les ancres ^ et $ ?
^Alorscorrespond à toute chaîne de caractères qui commence par “Alors” → Je teste !fin$correspond à toute chaîne de caractères qui se termine par “fin“^la fin$correspond exactement à la chaîne de caractères “la fin“oncorrespond à toute chaîne de caractères qui a “on” à l’intérieur
Exemple de code Python :
import re

regex = r"^Alors"

test_str = "Alors on danse !!!"

matches = re.finditer(regex, test_str)

for matchNum, match in enumerate(matches):
    matchNum = matchNum + 1

    print ("Match {matchNum} was found at {start}-{end}: {match}".format(matchNum = matchNum, start = match.start(), end = match.end(), match = match.group()))

    for groupNum in range(0, len(match.groups())):
        groupNum = groupNum + 1

print ("Group {groupNum} found at {start}-{end}: {group}".format(groupNum = groupNum, start = match.start(groupNum), end = match.end(groupNum), group = match.group(groupNum)))Les quantificateurs *, +, ? et {}
abc*correspond à une chaîne de caractères qui possède “ab” suivi de zéro ou plusieurs “c” → Je teste !abc+correspond à une chaîne de caractères qui possède “ab” suivi d’un ou plusieurs “c“abc?correspond à une chaîne de caractères qui possède “ab” suivi de zéro ou un “c“abc{2}correspond à une chaîne de caractères qui possède “ab” suivi de 2 “c“abc{2,}correspond à une chaîne de caractères qui possède “ab” suivi de 2 (ou plus) “c“abc{2,5}correspond à une chaîne de caractères qui possède “ab” suivi de 2 à 5 “c“a(bc)*correspond à une chaîne de caractères qui possède un “a” suivi de zéro ou plusieurs séquences “bc“a(bc){2,5}correspond à une chaîne de caractères qui possède un “a” suivi de 2 à 5 copies de la séquence “bc“
L’opérateur OU : | ou []
a(b|c)correspond à une chaîne de caractères qui possède un “a” suivi de “b” ou “c” → Je teste !a[bc]exactement même résultat, toutes les lettres entre crochet sont une alternative, retourne donc les chaînes de caractères correspondant à “ab” ou “ac“
Les classes de caractère : \d, \w, \s et .
\dcorrespond à un seul caractère qui est un chiffre → Je teste !\wcorrespond à un caractère de mot (comprend lettres, chiffres et underscore) → Je teste !\scorrespond à un caractère d’espace (comprend les tabulations et les sauts de ligne).correspond à n’importe quel caractère → Je teste !
Utilise l’opérateur . avec précaution : la classe de caractères ou la classe de caractères inversée (traitée plus bas) sont souvent plus rapides et plus précises.
\d, \w et \s ont aussi leurs négations : \D, \W et \S.
Par exemple, \D effectue la correspondance inverse de \d :
\Dcorrespond à un seul caractère non numérique → Je teste !
Pour que ces caractères soient pris littéralement, tu dois annuler leur effet avec une barre oblique inversée \ : ^ . [ $ ( ) | * + ? { \. Ils ont en effet une signification particulière. À l’inverse, \d, \w et \s deviennent spéciaux avec la barre oblique inversée.
\$\dcorrespond à une chaîne qui a un $ avant un chiffre → Je teste !
Note que tu peux aussi faire correspondre des caractères non affichables : les tabulations \t, les nouvelles lignes \n et les retours chariot \r.
À quoi servent les indicateurs (flags) ?
Pour construire un regex efficacement, il faut connaître un concept fondamental : les indicateurs (flags).
Une expression régulière s’écrit généralement sous la forme /abc/, où le motif de recherche est délimité par deux barres obliques /. À la fin, nous pouvons ajouter un ou plusieurs indicateurs (ils sont combinables) :
g(global) ne s’arrête pas à la première correspondance : les recherches suivantes repartent de la fin du match précédentm(multi line) : lorsqu’il est activé^et$correspondront au début et à la fin d’une ligne, au lieu de la chaîne de caractères entièrei(insensitive) rend l’expression entière insensible à la casse (par exemple,/aBc/icorrespondrait àAbC)
Tuto regex : comment grouper et capturer du texte ?
Comment regrouper et capturer avec () ?
a(bc)crée un groupe de capture avec la valeurbc→ Je teste !a(?:bc)*en utilisant?:nous désactivons le groupe de capture → Je teste !a(?<foo>bc)en utilisant?<foo>nous donnons un nom au groupe → Je teste !
Cet opérateur est très utile pour extraire des informations de chaînes de caractères ou de données dans ton langage de programmation préféré.
Les occurrences capturées par plusieurs groupes sont exposées sous la forme d’un tableau classique : on accède à leurs valeurs avec un index sur le résultat de la correspondance.
Si nous nommons les groupes (avec (?<Foo>...)), nous récupérons leurs valeurs depuis le résultat de la correspondance, comme dans un dictionnaire dont les clés sont les noms des groupes.
Attention : en Python, un groupe nommé s’écrit (?P<foo>...) et la référence arrière (?P=foo). La syntaxe (?<foo>...) fonctionne en JavaScript, Java ou PCRE, mais pas avec le module re de Python.
Expressions entre crochets : []
[abc]correspond à une chaîne de caractères qui a unaou unbou unc(est identique àa|b|c) → Je teste ![a-c]exactement la même chose, littéralement tout caractère deaàc.[a-fA-F0-9]une chaîne de caractères représentant un seul caractère d’un chiffre hexadécimal, sans distinction de case → Je teste ![0-9]%une chaîne de caractères qui a un chiffre de 0 à 9 avant le signe %[^a-zA-Z]une chaîne de caractères qui ne contient aucune lettre de a à z ou de A à Z. Dans ce cas, le^est utilisé comme négation de l’expression → Je teste !
Rappelle-toi que dans les expressions entre crochets, tous les caractères spéciaux (y compris la barre oblique inverse \) perdent leurs pouvoirs spéciaux. Nous n’appliquons donc pas la règle d’annulation.
Quelle différence entre correspondance généreuse et sélective ?
Les quantificateurs (* + {}) sont des opérateurs généreux : ils étendent la correspondance aussi loin que possible dans le texte fourni.
Par exemple, <.+> correspond à <div>simple div</div> dans Ceci est un test d'un <div>simple div</div>.
Pour attraper uniquement la balise div, nous ajoutons un ? pour rendre le quantificateur plus sélectif : <.+?> correspond à tout caractère, une ou plusieurs fois, entre < et > → Je teste !
Une meilleure solution évite . au profit d’un regex plus strict : <[^<>]+> correspond à n’importe quel caractère sauf < ou >, une ou plusieurs fois, entre < et > → Je teste !
Tuto regex : quelles fonctionnalités avancées utiliser ?
À quoi servent les limites \b et \B ?
\babc\beffectue une recherche “mots entiers uniquement” → Je teste !
\b représente une ancre (comme $ et ^) qui correspond aux positions où un côté est un caractère de mot (comme \w) et l’autre côté n’en est pas un (début ou fin de chaîne, espace, etc.).
Sa négation, \B, correspond à toutes les positions où \b ne correspond pas. C’est utile pour trouver un motif entièrement entouré de caractères de mot :
\Babc\Bne correspond que si le motif est entièrement entouré de caractères de mot → Je teste !
Comment utiliser les références arrières \1 ?
([abc])\1en utilisant\1, il correspond au même texte que le premier groupe de capture → Je teste !([abc])([de])\2\1nous pouvons utiliser\2(\3, \4, etc.) pour identifier le même texte correspondant au deuxième (troisième, quatrième, etc.) groupe de capture. → Je teste !(?<foo>[abc])\k<foo>nous donnons le nom foo au groupe et nous le référençons plus tard (\k<foo>). Le résultat est le même que celui du premier regex → Je teste !
Observation avant et après : (?=) Et (?<=)
d(?=r)ne correspond à d que s’il est suivi de r, mais r ne fait pas partie du résultat → Je teste !(?<=r)dne correspond à d que s’il est précédé d’un r, mais r ne fait pas partie du résultat → Je teste !
Tu peux aussi utiliser la négation :
d(?!r)ne correspond à d que s’il n’est pas suivi de r → Je teste !(?<!r)dne correspond à d que s’il n’est pas précédé d’un r → Je teste !
À quoi servent les regex en pratique ?
Comme tu l’as vu dans ce tuto regex, les champs d’application des regex sont multiples. Voici une liste rapide des usages les plus courants :
- Validation des données : par exemple, vérifier qu’une date est bien formée.
- Scraping de données : par exemple, trouver sur le Web toutes les pages contenant un ensemble de mots dans un ordre précis.
- Correspondance de données : transformer des données « brutes » dans un autre format.
- Analyse de chaînes de caractères : par exemple, capturer tous les paramètres GET d’une URL ou le texte entre parenthèses.
- Remplacement de chaînes de caractères : y compris dans un IDE, par exemple pour transformer une classe Java ou C# en objet JSON (remplacer
;par,, passer en minuscules, supprimer la déclaration de type, etc.). - Autres usages : mise en évidence de la syntaxe, renommage de fichiers, détection de paquets et bien d’autres applications impliquant des chaînes de caractères.
Pour pratiquer le traitement de texte en Python, le parcours Python de DataXp te fait pratiquer sur des exercices corrigés, avec un coach IA qui t’aide quand tu bloques. Les premiers modules sont gratuits.
Questions fréquentes sur les regex
Qu’est-ce qu’une expression régulière (regex) ?
C’est un modèle de recherche, une séquence de caractères, qui permet de rechercher une ou plusieurs correspondances dans un texte. Elle sert à valider, extraire ou remplacer des chaînes de caractères.
Quelle est la différence entre correspondance généreuse et sélective ?
Les quantificateurs (*, +, {}) sont généreux : ils étendent la correspondance aussi loin que possible. Ajouter un ? les rend sélectifs. Par exemple, <.+> capture tout <div>simple div</div>, alors que <.+?> ne capture que la première balise. Une solution plus stricte est <[^<>]+>.
Comment écrire un groupe nommé en Python ?
En Python, un groupe nommé s’écrit (?P<foo>...) et la référence arrière (?P=foo). La syntaxe (?<foo>...) fonctionne en JavaScript, Java ou PCRE, mais pas avec le module re de Python.
À quoi servent les classes de caractères \d, \w et \s ?
\d correspond à un chiffre, \w à un caractère de mot (lettres, chiffres et underscore) et \s à un espace (y compris tabulations et sauts de ligne). Leurs négations sont \D, \W et \S.
Pour quels usages utilise-t-on les regex ?
Pour la validation de données (par exemple une date bien formée), le scraping, la transformation de données brutes vers un autre format, l’analyse de chaînes (paramètres GET d’une URL, texte entre parenthèses) et le remplacement de chaînes, y compris dans un IDE.
Pour aller plus loin avec Python, consulte aussi notre guide des 21 astuces et concepts Python pour améliorer ton code.
Excellent article. bravo simple et complet !!
Merci Jul 🙂
super. on se sert de ce site souvent pour trouver des mots dans des phrases
La puissance du regex :))
Bonjour, merci pour ce superbe article qui résume clairement l’usage et la puissance des Regex. Ça me permet de réviser sans me prendre la tête !