Un réseau de neurones convolutif (CNN) apprend tout seul à reconnaître des formes dans des images, mais on ne voit pas ce qu’il fait à l’intérieur. Il existe pourtant un moyen simple de regarder : afficher ce que produit chaque couche pour une image donnée. Dans cet article, tu vas entraîner un petit CNN avec Keras pour distinguer des cercles, des carrés et des triangles, puis visualiser les activations intermédiaires de chacune de ses couches de convolution et de pooling.
Article mis à jour en octobre 2026 : code testé avec Python 3.13 et Keras 3, ImageDataGenerator et les fichiers .hdf5 remplacés par image_dataset_from_directory et le format .keras, jeu d’images généré par le code (plus besoin de Kaggle), et résultats, graphiques et interprétations refaits (le jeu étant différent, la précision n’est plus celle de l’ancienne version).
En bref : visualiser les activations intermédiaires d’un CNN consiste à créer un second modèle keras.Model qui renvoie la sortie de chaque couche de convolution et de pooling, puis à afficher chaque canal de ces sorties comme une image. Les premières couches conservent presque toute l’image, et plus on avance, plus les cartes deviennent petites, abstraites et liées à la classe prédite plutôt qu’à l’aspect de l’image.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Voici les versions utilisées pour tester le code (octobre 2026) :
import sys, PIL

print("Python    ", sys.version.split()[0])
print("NumPy     ", np.__version__)
print("Keras     ", keras.__version__, "- moteur :", keras.config.backend())
print("Pillow ", PIL.__version__)Python 3.13.16
NumPy 2.5.3
Keras 3.15.1 - moteur : tensorflow
Pillow 12.3.0Cet article s’inspire d’une démarche présentée par François Chollet, le créateur de Keras, dans son livre Deep Learning with Python : afficher les cartes de caractéristiques (feature maps) produites par les couches de convolution et de pooling pour une image donnée. La sortie d’une couche est souvent appelée son activation. Cette visualisation aide à comprendre comment les couches successives transforment l’image d’entrée, et à se faire une première idée de ce que détecte chaque filtre.
Je vais vite sur la construction du modèle, car l’objectif est la visualisation. Pour comprendre les CNN en détail, lis d’abord Comprendre les réseaux de neurones et Comment fonctionne le Deep Learning.
Comment construire un réseau de neurones convolutif avec Keras ?
Commençons par importer les bibliothèques nécessaires. Avec Keras 3, plus besoin d’importer chaque couche une par une, ni ImageDataGenerator (supprimé) :
from pathlib import Path

import numpy as np
import matplotlib.pyplot as plt
from PIL import Image, ImageDraw

import keras
from keras import layers

keras.utils.set_random_seed(42)D’où viennent les images d’entraînement ?
L’ancienne version de cet article utilisait un jeu de dessins hébergé sur Kaggle, qui demande un compte. Pour que tu puisses tout reproduire sans rien télécharger, le code ci-dessous génère lui-même 300 dessins de 28 × 28 pixels : 100 cercles, 100 carrés et 100 triangles, tracés au trait noir sur fond blanc, avec une taille, une position, une épaisseur, une rotation et un léger bruit aléatoires. La fonction dessiner() dessine une forme :
def dessiner(forme, rng, taille=28, zoom=4):
    """Dessine une forme au trait noir sur fond blanc (taille x taille pixels)."""
    n = taille * zoom                                   # on dessine en grand, puis on réduit
    img = Image.new("L", (n, n), 255)
    d = ImageDraw.Draw(img)
    r = rng.uniform(0.2, 0.4) * n                       # taille de la forme
    cx, cy = rng.uniform(0.4, 0.6, size=2) * n          # centre
    epaisseur = int(rng.uniform(1.0, 2.5) * zoom)

    if forme == "cercle":
        rx, ry = r * rng.uniform(0.7, 1.3), r * rng.uniform(0.7, 1.3)
        d.ellipse([cx - rx, cy - ry, cx + rx, cy + ry], outline=0, width=epaisseur)
    else:
        sommets = 4 if forme == "carre" else 3
        depart = rng.uniform(0, 2 * np.pi)              # rotation aléatoire
        pts = []
        for k in range(sommets):
            angle = depart + 2 * np.pi * k / sommets
            rayon = r * 1.2 * rng.uniform(0.85, 1.15)   # des sommets inégaux, comme à la main
            pts.append((cx + rayon * np.cos(angle), cy + rayon * np.sin(angle)))
        d.line(pts + [pts[0]], fill=0, width=epaisseur, joint="curve")

    img = img.resize((taille, taille), Image.LANCZOS)
    bruit = rng.normal(0, 12, size=(taille, taille))     # un peu de bruit sur les pixels
    img = Image.fromarray(np.clip(np.asarray(img) + bruit, 0, 255).astype("uint8"))
return img.convert("RGB")La fonction creer_jeu() range les images dans les dossiers training_set (70 images par forme) et test_set (30 images par forme), avec un sous-dossier par classe : circles, squares et triangles. Le paramètre graine rend le jeu identique à chaque exécution.
def creer_jeu(racine="formes", par_forme=100, n_entrainement=70, graine=42):
    """Crée formes/training_set et formes/test_set, avec un dossier par classe."""
    rng = np.random.default_rng(graine)
    for forme, dossier in [("cercle", "circles"), ("carre", "squares"), ("triangle", "triangles")]:
        for i in range(par_forme):
            sous_ensemble = "training_set" if i < n_entrainement else "test_set"
            chemin = Path(racine) / sous_ensemble / dossier
            chemin.mkdir(parents=True, exist_ok=True)
            dessiner(forme, rng).save(chemin / f"dessin_{i + 1:03d}.png")

creer_jeu()

for sous_ensemble in ["training_set", "test_set"]:
    for dossier in ["circles", "squares", "triangles"]:
        n = len(list((Path("formes") / sous_ensemble / dossier).glob("*.png")))
print(f"{sous_ensemble}/{dossier} : {n} images")training_set/circles : 70 images
training_set/squares : 70 images
training_set/triangles : 70 images
test_set/circles : 30 images
test_set/squares : 30 images
test_set/triangles : 30 imagesPour vérifier que les dessins sont corrects, affichons les dix premiers de chaque forme.
def afficher_exemples(dossier, nb=10, colonnes=5):
    chemins = sorted(Path(dossier).glob("*.png"))[:nb]
    plt.figure(figsize=(8, 3.4))
    for i, chemin in enumerate(chemins):
        plt.subplot(int(np.ceil(nb / colonnes)), colonnes, i + 1)
        plt.imshow(plt.imread(chemin))
        plt.axis("off")
    plt.tight_layout()
plt.show()Cercles
afficher_exemples('formes/training_set/circles')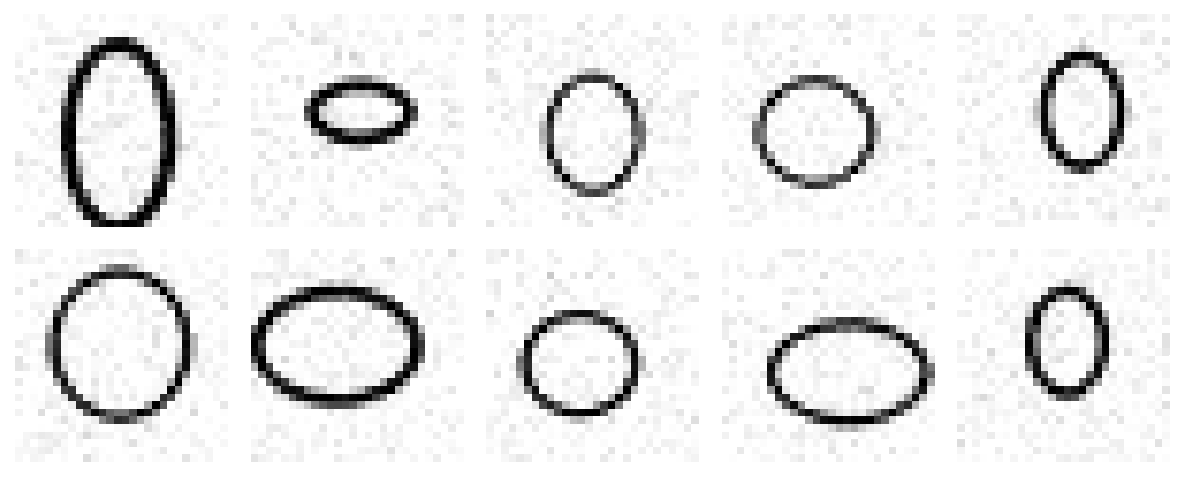
Carrés
afficher_exemples('formes/training_set/squares')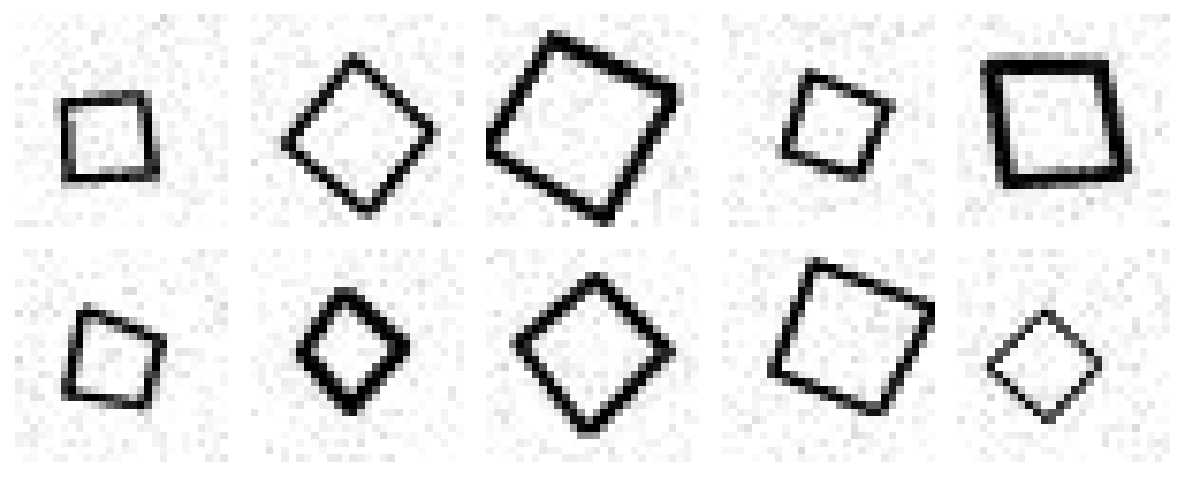
Triangles
afficher_exemples('formes/training_set/triangles')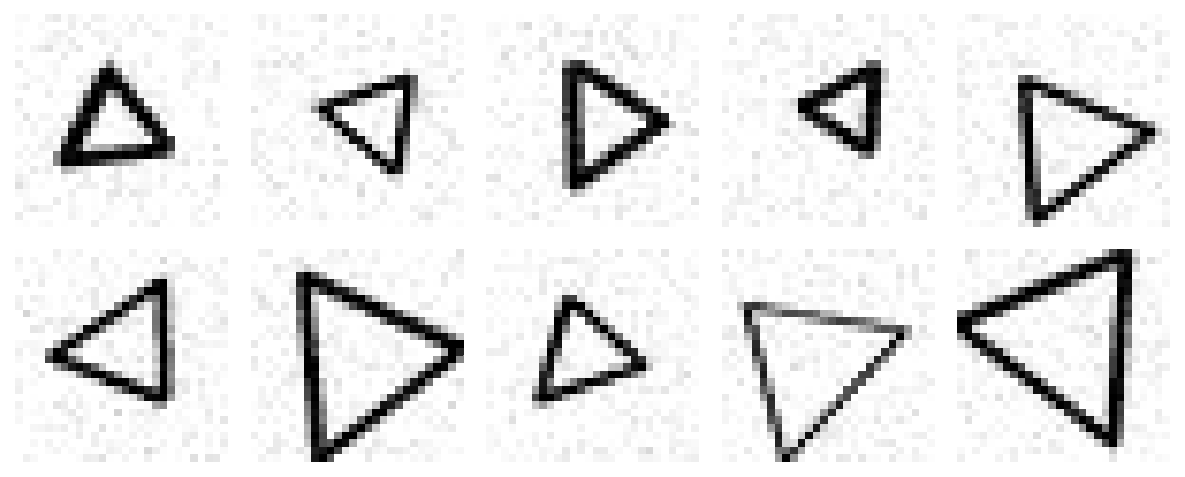
Chaque image fait 28 pixels par 28 pixels et possède 3 canaux (RGB), même si elle est en noir et blanc :
img = plt.imread("formes/training_set/circles/dessin_001.png")
print(img.shape, img.dtype, img.min(), img.max())(28, 28, 3) float32 0.0 1.0Quelle architecture de CNN utiliser pour classer des formes ?
Le modèle est un Sequential composé de trois blocs. Chaque bloc contient deux couches de convolution Conv2D (avec padding="same" pour garder la taille de l’image), une couche MaxPooling2D qui réduit la taille par deux et une couche Dropout qui limite le surapprentissage. On termine avec Flatten, une couche Dense de 512 neurones et une couche Dense de 3 neurones avec la fonction softmax : une probabilité pour chaque classe (cercle = 0, carré = 1, triangle = 2).
model = keras.Sequential([
    keras.Input(shape=(28, 28, 3)),

    # Bloc 1
    layers.Conv2D(32, (3, 3), padding="same", activation="relu"),
    layers.Conv2D(32, (3, 3), padding="same", activation="relu"),
    layers.MaxPooling2D(pool_size=(2, 2)),
    layers.Dropout(0.25),

    # Bloc 2
    layers.Conv2D(64, (3, 3), padding="same", activation="relu"),
    layers.Conv2D(64, (3, 3), padding="same", activation="relu"),
    layers.MaxPooling2D(pool_size=(2, 2)),
    layers.Dropout(0.25),

    # Bloc 3
    layers.Conv2D(64, (3, 3), padding="same", activation="relu"),
    layers.Conv2D(64, (3, 3), padding="same", activation="relu"),
    layers.MaxPooling2D(pool_size=(2, 2)),
    layers.Dropout(0.25),

    # Classification
    layers.Flatten(),
    layers.Dense(512, activation="relu"),
    layers.Dropout(0.5),
    layers.Dense(3, activation="softmax"),
])Regardons le résumé du modèle :
model.summary()Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type) ┃ Output Shape ┃ Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ conv2d (Conv2D) │ (None, 28, 28, 32) │ 896 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_1 (Conv2D) │ (None, 28, 28, 32) │ 9,248 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d (MaxPooling2D) │ (None, 14, 14, 32) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout (Dropout) │ (None, 14, 14, 32) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_2 (Conv2D) │ (None, 14, 14, 64) │ 18,496 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_3 (Conv2D) │ (None, 14, 14, 64) │ 36,928 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d_1 (MaxPooling2D) │ (None, 7, 7, 64) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout_1 (Dropout) │ (None, 7, 7, 64) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_4 (Conv2D) │ (None, 7, 7, 64) │ 36,928 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_5 (Conv2D) │ (None, 7, 7, 64) │ 36,928 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d_2 (MaxPooling2D) │ (None, 3, 3, 64) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout_2 (Dropout) │ (None, 3, 3, 64) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ flatten (Flatten) │ (None, 576) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense (Dense) │ (None, 512) │ 295,424 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout_3 (Dropout) │ (None, 512) │ 0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense) │ (None, 3) │ 1,539 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
Total params: 436,387 (1.66 MB)
Trainable params: 436,387 (1.66 MB)
Non-trainable params: 0 (0.00 B)On voit la taille des cartes diminuer à chaque MaxPooling2D (28 × 28, puis 14 × 14, 7 × 7 et 3 × 3), tandis que le nombre de canaux passe de 32 à 64. Retiens ces tailles : on les retrouvera dans les visualisations.
On compile le modèle avec l’optimiseur rmsprop, la perte categorical_crossentropy et la précision (accuracy) comme métrique :
model.compile(optimizer="rmsprop",
              loss="categorical_crossentropy",
metrics=["accuracy"])Comment charger les images avec Keras 3 ?
La fonction keras.utils.image_dataset_from_directory lit les images d’un dossier et utilise le nom des sous-dossiers comme classes. Elle remplace ImageDataGenerator, qui n’existe plus dans Keras 3. Comme elle renvoie des pixels entre 0 et 255, on les ramène entre 0 et 1 avec map(). L’ordre des classes est fixé avec class_names, pour que cercle = 0, carré = 1 et triangle = 2.
classes = ["circles", "squares", "triangles"]    # cercle = 0, carré = 1, triangle = 2

def charger(dossier, melanger):
    ds = keras.utils.image_dataset_from_directory(
        dossier, class_names=classes, label_mode="categorical",
        image_size=(28, 28), batch_size=16, shuffle=melanger, seed=42)
    # les pixels passent de 0-255 à 0-1
    return ds.map(lambda x, y: (x / 255.0, y))

training_set = charger("formes/training_set", melanger=True)
test_set = charger("formes/test_set", melanger=False)Found 210 files belonging to 3 classes.
Found 90 files belonging to 3 classes.Comment entraîner le modèle et garder les meilleurs poids ?
Le ModelCheckpoint enregistre le modèle chaque fois que la précision sur le jeu de test (val_accuracy) s’améliore. On utilise le format .keras, qui remplace .hdf5 et .h5 (obsolètes avec Keras 3). Le paramètre verbose=0 de fit() masque les barres de progression, et on lance l’entraînement sur 30 epochs.
checkpointer = keras.callbacks.ModelCheckpoint(
    filepath="meilleur_modele.keras",
    monitor="val_accuracy",
    save_best_only=True,
    verbose=1)

history = model.fit(training_set,
                    epochs=30,
                    validation_data=test_set,
                    callbacks=[checkpointer],
                    shuffle=False,        # image_dataset_from_directory mélange déjà les images
verbose=0)Voici les epochs où le modèle s’améliore (j’ai retiré les autres lignes du journal pour que l’affichage reste lisible) :
Epoch 1: val_accuracy improved from None to 0.33333, saving model to meilleur_modele.keras
Epoch 2: val_accuracy improved from 0.33333 to 0.41111, saving model to meilleur_modele.keras
Epoch 6: val_accuracy improved from 0.41111 to 0.47778, saving model to meilleur_modele.keras
Epoch 7: val_accuracy improved from 0.47778 to 0.53333, saving model to meilleur_modele.keras
Epoch 9: val_accuracy improved from 0.53333 to 0.60000, saving model to meilleur_modele.keras
Epoch 10: val_accuracy improved from 0.60000 to 0.67778, saving model to meilleur_modele.keras
Epoch 12: val_accuracy improved from 0.67778 to 0.78889, saving model to meilleur_modele.keras
Epoch 13: val_accuracy improved from 0.78889 to 0.81111, saving model to meilleur_modele.keras
Epoch 14: val_accuracy improved from 0.81111 to 0.82222, saving model to meilleur_modele.keras
Epoch 15: val_accuracy improved from 0.82222 to 0.88889, saving model to meilleur_modele.keras
Epoch 19: val_accuracy improved from 0.88889 to 0.93333, saving model to meilleur_modele.keras
Epoch 22: val_accuracy improved from 0.93333 to 0.95556, saving model to meilleur_modele.keras
Epoch 23: val_accuracy improved from 0.95556 to 0.97778, saving model to meilleur_modele.keras
Epoch 26: val_accuracy improved from 0.97778 to 0.98889, saving model to meilleur_modele.kerasLa précision de validation progresse par à-coups et atteint son maximum à l’epoch 26, avec 98,9 %. Les deux courbes ci-dessous montrent l’évolution de la précision et de la perte.
acc, val_acc = history.history["accuracy"], history.history["val_accuracy"]
loss, val_loss = history.history["loss"], history.history["val_loss"]
epochs = range(1, len(acc) + 1)

plt.plot(epochs, acc, "bo", label="Précision d'entraînement")
plt.plot(epochs, val_acc, "b", label="Précision de validation")
plt.title("Précision d'entraînement et de validation")
plt.xlabel("Epoch")
plt.legend()
plt.show()

plt.plot(epochs, loss, "bo", label="Perte d'entraînement")
plt.plot(epochs, val_loss, "b", label="Perte de validation")
plt.title("Perte d'entraînement et de validation")
plt.xlabel("Epoch")
plt.legend()
plt.show()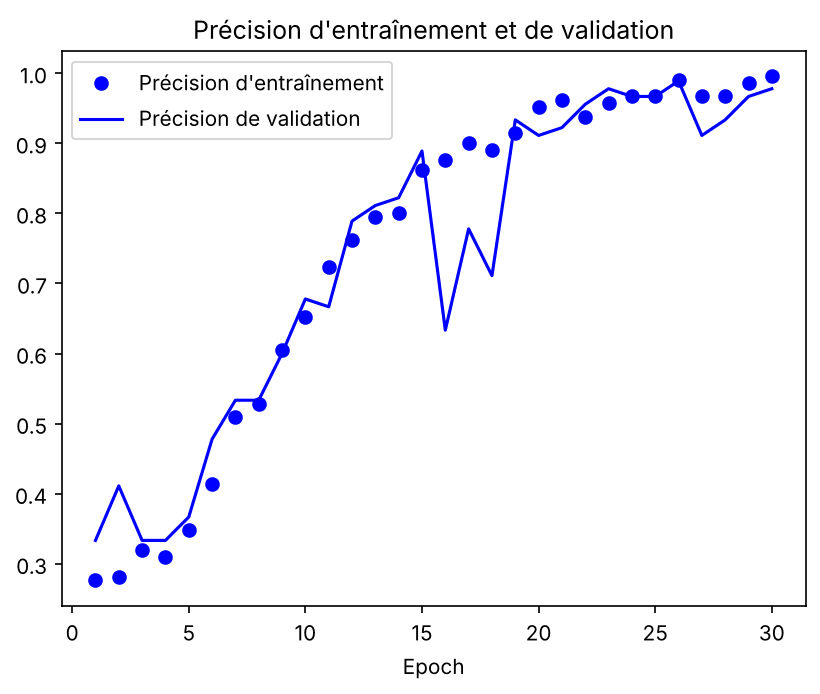
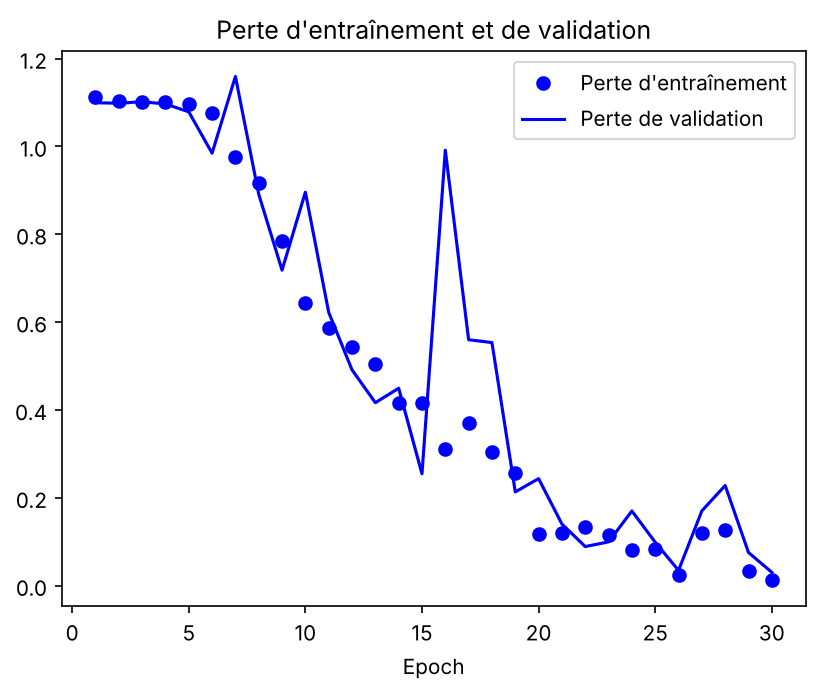
Les deux courbes se suivent de près, ce qui indique que le modèle ne mémorise pas simplement les images d’entraînement. Le creux de l’epoch 16 est un à-coup d’entraînement fréquent avec rmsprop : il se résorbe ensuite. À la fin, la précision de validation (environ 98 %) est un peu inférieure au meilleur point (98,9 %), et c’est justement ce point que le checkpoint a conservé.
Comment recharger le meilleur modèle ?
Avec le format .keras, load_model() recharge à la fois l’architecture et les poids du meilleur epoch. Il n’y a plus de load_weights() ni de sauvegarde séparée :
model = keras.models.load_model("meilleur_modele.keras")

perte, precision = model.evaluate(test_set, verbose=0)
print(f"Meilleur modèle : précision sur le jeu de test = {precision:.1%}")Meilleur modèle : précision sur le jeu de test = 98.9%Comment prédire la classe d’une nouvelle image ?
Chargeons une image du jeu de test, un triangle que le modèle n’a pas vu pendant l’entraînement, et mettons-la au bon format : un tenseur de forme (1, 28, 28, 3) avec des pixels entre 0 et 1.
img_path = "formes/test_set/triangles/dessin_071.png"

img = keras.utils.load_img(img_path, target_size=(28, 28))
img_tensor = keras.utils.img_to_array(img)
img_tensor = np.expand_dims(img_tensor, axis=0)
img_tensor /= 255.0

plt.imshow(img_tensor[0])
plt.axis("off")
plt.show()

print(img_tensor.shape)(1, 28, 28, 3)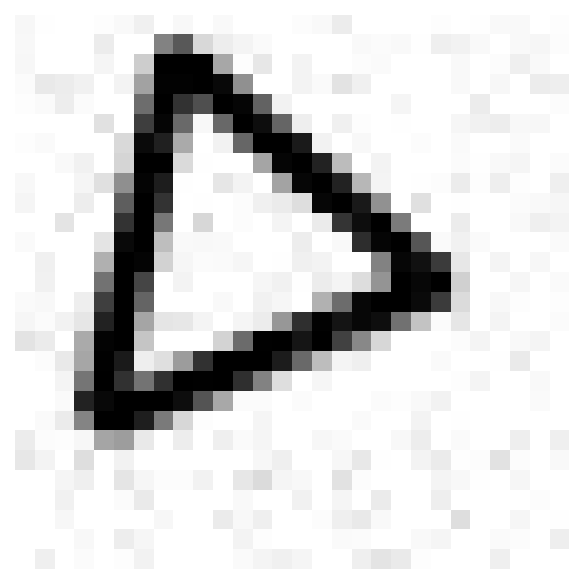
Demandons maintenant au modèle sa prédiction :
probas = model.predict(img_tensor, verbose=0)[0]
print("Probabilités :", dict(zip(classes, probas.round(3).tolist())))
print("La classe prédite est :", np.argmax(probas), "->", classes[np.argmax(probas)])Probabilités : {'circles': 0.0, 'squares': 0.0, 'triangles': 1.0}
La classe prédite est : 2 -> trianglesLe modèle prédit la classe 2, un triangle, avec une probabilité arrondie à 1. Jusqu’ici, tout va bien : passons à la partie principale de l’article.
Comment visualiser les activations intermédiaires d’un CNN ?
Pour extraire les cartes de caractéristiques, on crée un second modèle Keras qui prend la même entrée que le premier, mais renvoie la sortie de chaque couche de convolution et de pooling. On passe model.inputs en entrée et la liste des sorties layer.output en sortie. Les couches Dropout, Flatten et Dense sont ignorées, car elles ne produisent pas d’images.
# On ne garde que les couches de convolution et de pooling
couches = [c for c in model.layers if isinstance(c, (layers.Conv2D, layers.MaxPooling2D))]

# Un modèle qui renvoie la sortie de chacune de ces couches
activation_model = keras.Model(inputs=model.inputs, outputs=[c.output for c in couches])Quand on lui donne une image, ce modèle renvoie les activations de toutes les couches retenues :
activations = activation_model.predict(img_tensor, verbose=0)

for couche, activation in zip(couches, activations):
print(f"{couche.name:16s} {activation.shape}")conv2d (1, 28, 28, 32)
conv2d_1 (1, 28, 28, 32)
max_pooling2d (1, 14, 14, 32)
conv2d_2 (1, 14, 14, 64)
conv2d_3 (1, 14, 14, 64)
max_pooling2d_1 (1, 7, 7, 64)
conv2d_4 (1, 7, 7, 64)
conv2d_5 (1, 7, 7, 64)
max_pooling2d_2 (1, 3, 3, 64)Chaque tableau a quatre dimensions : l’image du lot (une seule ici), la hauteur, la largeur et le nombre de canaux. Par exemple, l’activation de la première couche de convolution est une carte de 28 × 28 pixels avec 32 canaux :
first_layer_activation = activations[0]
print(first_layer_activation.shape)(1, 28, 28, 32)Traçons le quatrième canal de cette première couche :
plt.matshow(first_layer_activation[0, :, :, 4], cmap="viridis")
plt.axis("off")
plt.show()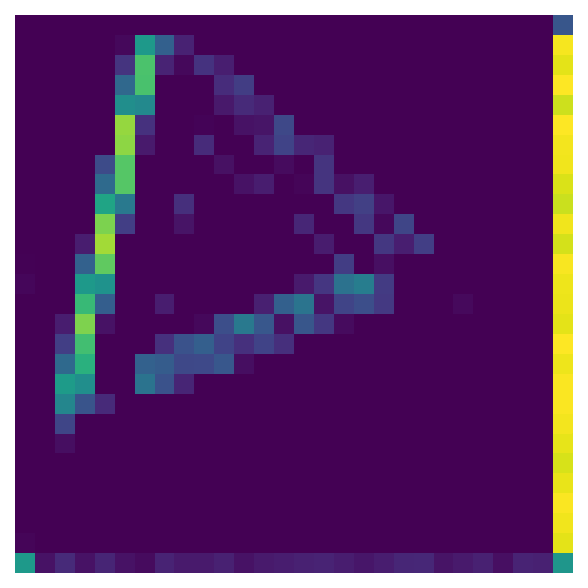
Chaque canal est la réponse d’un filtre différent : ici, le filtre met en valeur certains bords du triangle. Plutôt que d’interpréter un seul canal, affichons tous les canaux de toutes les couches. La fonction afficher_canaux() les range dans une grille, et chaque canal est ramené entre 0 et 1 pour que les filtres peu actifs restent lisibles.
def afficher_canaux(activation, titre, par_ligne=8):
    taille, n_canaux = activation.shape[1], activation.shape[-1]
    lignes = int(np.ceil(n_canaux / par_ligne))
    grille = np.full((lignes * (taille + 1), par_ligne * (taille + 1)), np.nan)
    for k in range(n_canaux):
        canal = activation[0, :, :, k]
        if canal.max() > 0:
            canal = canal / canal.max()          # chaque canal est ramené entre 0 et 1
        i, j = divmod(k, par_ligne)
        grille[i * (taille + 1): i * (taille + 1) + taille,
               j * (taille + 1): j * (taille + 1) + taille] = canal
    plt.figure(figsize=(par_ligne * 0.9, lignes * 0.9 + 0.5))
    plt.title(titre)
    plt.imshow(grille, cmap="viridis", vmin=0, vmax=1)
    plt.axis("off")
    plt.show()

for couche, activation in zip(couches, activations):
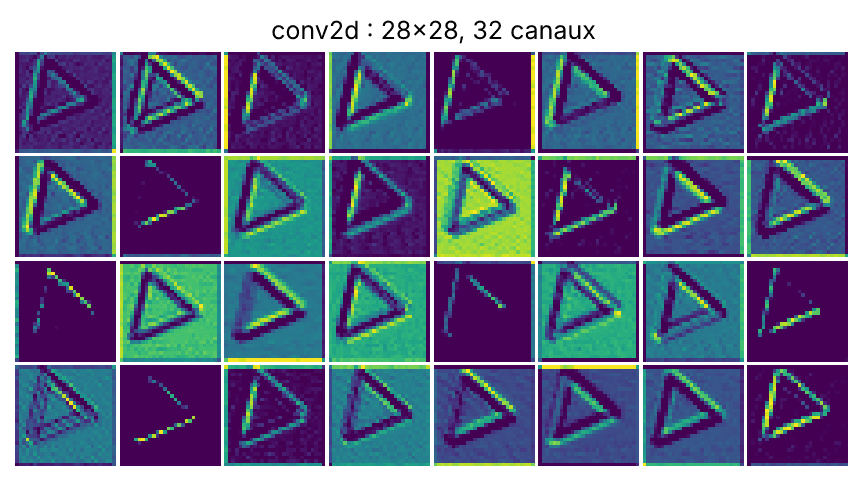
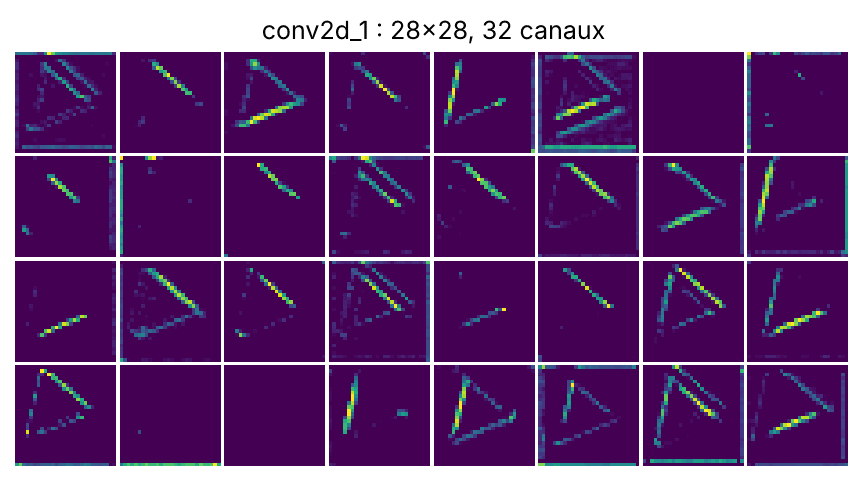
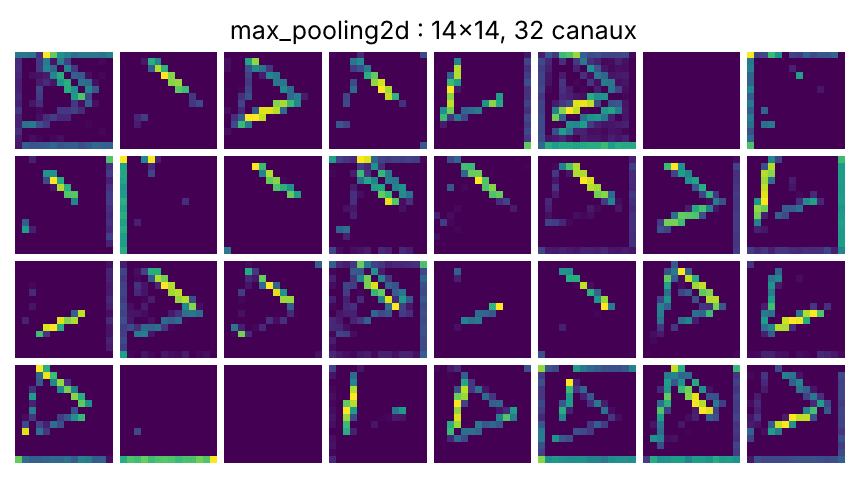
afficher_canaux(activation, f"{couche.name} : {activation.shape[1]}x{activation.shape[2]}, {activation.shape[-1]} canaux")Que montrent les 9 couches ?
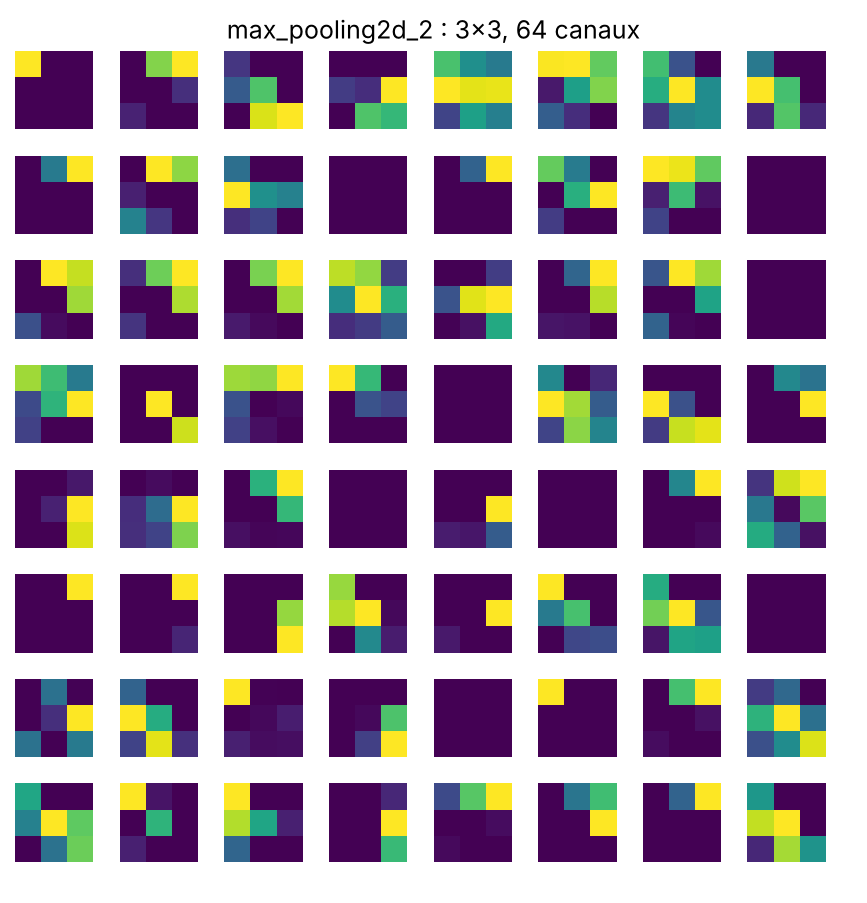
Voici les activations de l’image de test, couche par couche. Les zones jaunes sont les plus actives, les zones violettes les moins actives (et les cases entièrement violettes sont des filtres qui ne réagissent pas du tout à cette image).
Première couche de convolution (28 × 28, 32 canaux). Le triangle est encore bien visible dans presque tous les canaux, avec chacun son style : certains gardent tout le contour, d’autres ne réagissent qu’à un côté ou à une orientation.
Deuxième couche de convolution (28 × 28, 32 canaux). Chaque canal isole déjà un côté du triangle selon son orientation (oblique vers la droite, vers la gauche, quasi verticale…), et la plupart des pixels valent 0.
Premier MaxPooling (14 × 14, 32 canaux). L’image est deux fois plus petite et les traits sont plus nets : beaucoup de canaux ne gardent qu’un segment dans une direction précise, et quelques-uns ne s’activent pas du tout.
Troisième couche de convolution (14 × 14, 64 canaux). Les canaux isolent des bords orientés et quelques angles, comme un coin du triangle.
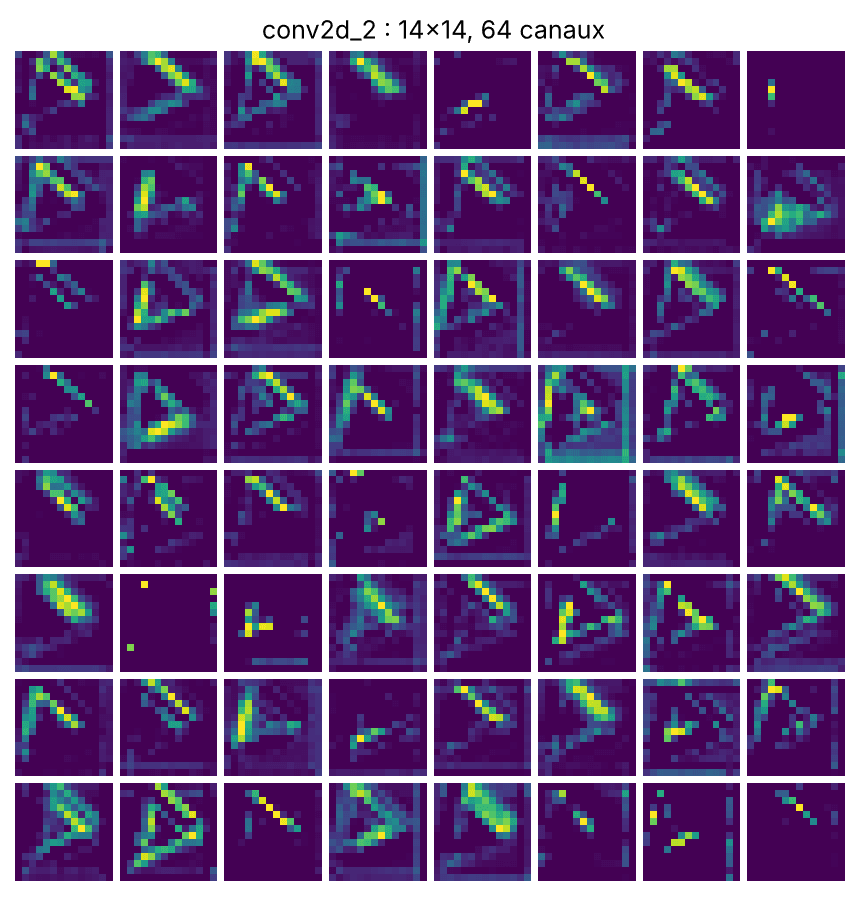
Quatrième couche de convolution (14 × 14, 64 canaux). Les segments et les coins sont recombinés.
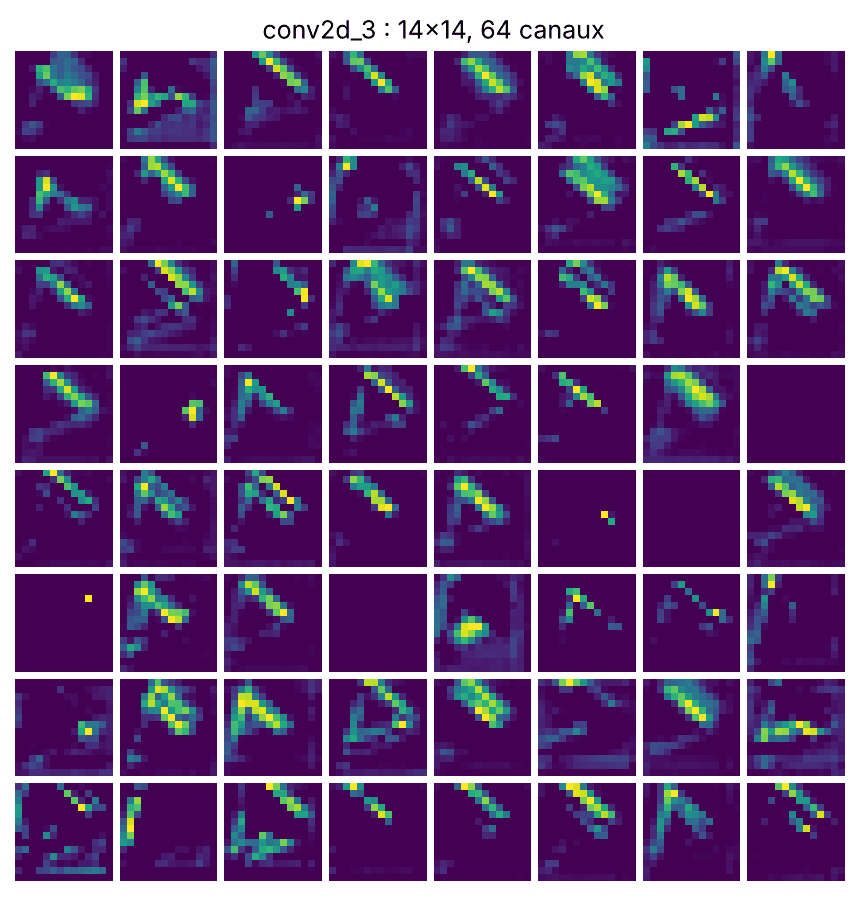
Deuxième MaxPooling (7 × 7, 64 canaux). Les cartes ne contiennent plus que quelques pixels actifs : on ne reconnaît plus la forme du triangle, seulement la position approximative de ses bords.
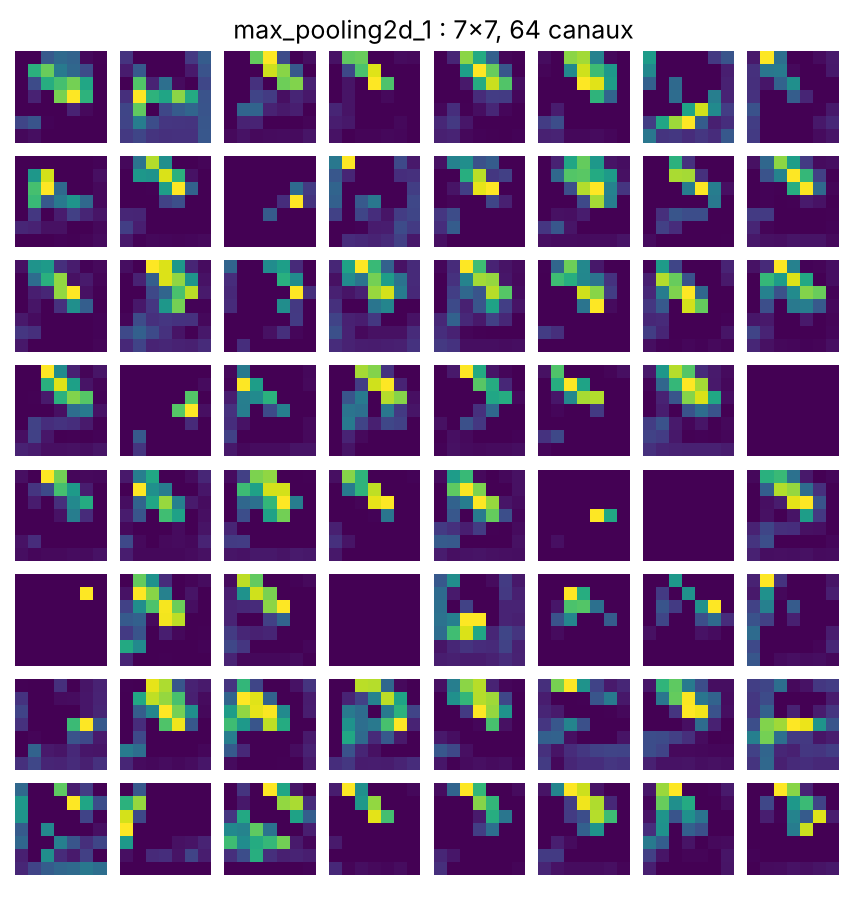
Cinquième couche de convolution (7 × 7, 64 canaux). Les activations sont plus grossières et plus spécialisées.
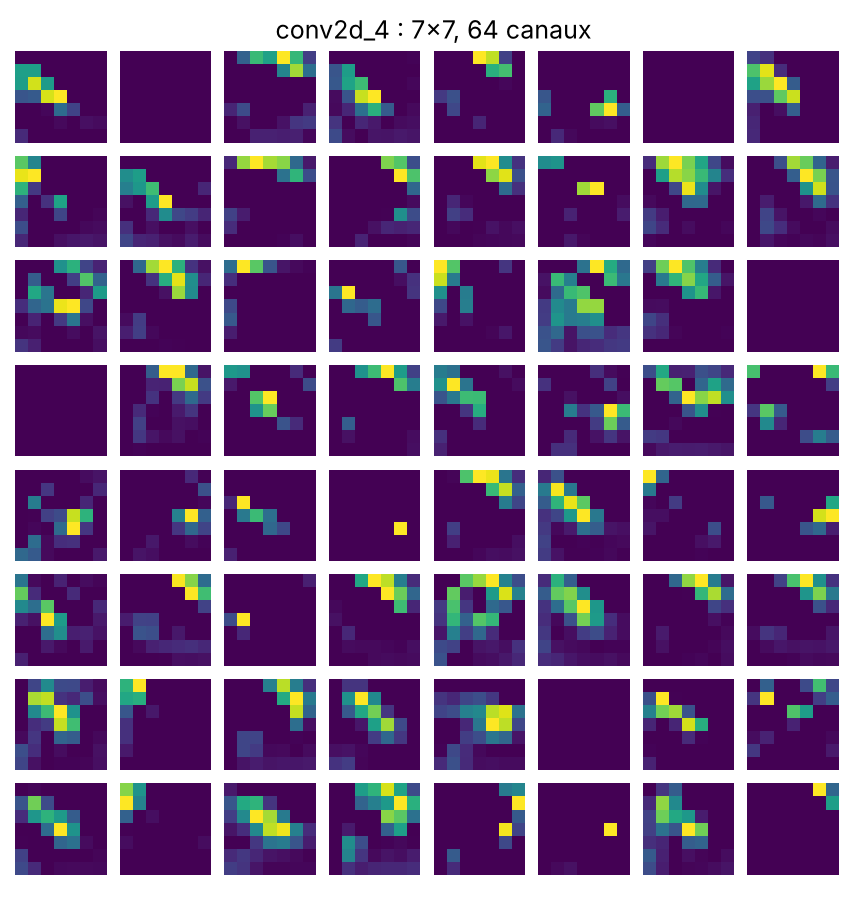
Sixième couche de convolution (7 × 7, 64 canaux). Davantage de canaux restent éteints.
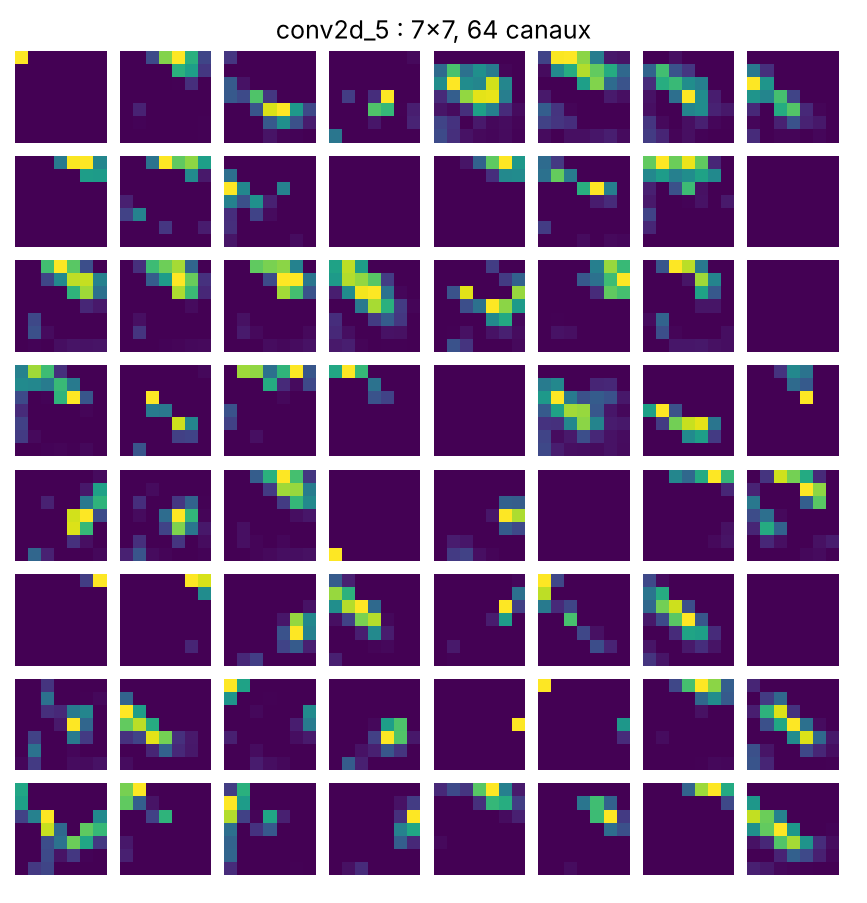
Troisième MaxPooling (3 × 3, 64 canaux). Chaque canal ne compte plus que 9 pixels : on ne peut plus lire l’image, mais ce sont ces 576 valeurs (9 × 64) qui alimentent la couche dense de classification.
Comment interpréter ces visualisations ?
- Les premières couches conservent presque toute l’information. Les activations ressemblent encore à l’image d’origine : chaque filtre met en valeur un aspect différent du contour (un côté, une orientation, l’épaisseur du trait).
- Plus on avance, plus les cartes sont abstraites. Elles encodent des éléments simples comme des segments et des coins, et ne ressemblent plus à un triangle. Les couches profondes portent de moins en moins d’information sur l’aspect visuel de l’image et de plus en plus d’information sur sa classe.
- Davantage de canaux restent éteints dans les couches profondes. Avec la fonction ReLU, un canal complètement violet signifie que son filtre ne trouve rien à détecter dans cette image. Ce n’est pas un défaut : ce filtre réagira à d’autres images (un cercle ou un carré, par exemple), et ces visualisations ne montrent qu’une seule entrée.
Tu as donc vu comment un réseau de neurones convolutif extrait des motifs d’une image et comment l’information circule d’une couche à l’autre, des pixels vers une représentation de plus en plus liée à la classe. Pour aller plus loin, refais l’expérience avec une image de cercle ou de carré, et compare quels canaux s’activent.
Questions fréquentes
Qu’est-ce que l’activation d’une couche dans un CNN ?
L’activation d’une couche est sa sortie, c’est-à-dire ce que la couche renvoie après avoir appliqué ses filtres (et sa fonction d’activation) à l’image. Pour une couche de convolution, c’est un ensemble de cartes de caractéristiques : une par filtre, aussi appelée canal.
Comment obtenir la sortie d’une couche intermédiaire avec Keras ?
Crée un second modèle avec keras.Model(inputs=model.inputs, outputs=[couche.output for couche in couches]) puis appelle predict() sur une image : tu obtiens un tableau par couche demandée, de forme (lot, hauteur, largeur, canaux).
Pourquoi certains canaux sont-ils entièrement éteints ?
Avec la fonction d’activation ReLU, toutes les valeurs négatives deviennent 0. Un canal éteint signifie que son filtre n’a rien trouvé de son motif dans cette image précise. Il peut s’activer avec une autre image.
Pourquoi les activations deviennent-elles moins lisibles dans les couches profondes ?
Chaque couche combine les motifs trouvés par la précédente, et le pooling réduit la taille des cartes. Les couches profondes encodent donc des concepts de plus haut niveau, plus liés à la classe prédite qu’à l’apparence de l’image.
Pourquoi sauvegarder au format .keras plutôt que .h5 ?
Avec Keras 3, le format .keras est le format standard : il enregistre l’architecture, les poids et la configuration d’entraînement dans un seul fichier. Les formats .h5 et .hdf5 sont considérés comme anciens.
Par quoi remplacer ImageDataGenerator dans Keras 3 ?
Utilise keras.utils.image_dataset_from_directory pour lire les images depuis des dossiers, et map() pour les mettre à l’échelle entre 0 et 1. Pour l’augmentation de données, ajoute des couches comme RandomFlip ou RandomRotation dans le modèle.
Conclusion
Pour comprendre ce que fait un CNN, il suffit d’un second modèle Keras qui renvoie les sorties des couches de convolution et de pooling. Tu as vu les cartes de caractéristiques passer de l’image presque complète à des motifs abstraits, ce qui explique pourquoi les couches profondes sont plus utiles à la classification qu’à l’œil humain. Essaie avec d’autres images, d’autres couches, ou ton propre jeu de données.
Comprendre un réseau de neurones passe par l’expérimentation. Sur DataXp, tu t’entraînes à la data science en passant de Python et pandas aux statistiques et au Machine Learning, avec plus de 350 exercices et un coach IA à tes côtés. Les premiers modules sont gratuits.
Pour aller plus loin :
Premièrement, merci pour ce code et les explications.
Je souhaiterais simplement pourquoi dans une couche de convolution on appelle deux fois la fonction add. Conv2D (une fois avec un padding et l’autre fois sans) ? Que se passerait t-il si on appelai que la première ligne (Conv2D avec le padding uniquement).
Et en lien avec la precedente question, j’ai l’impression que les deux autres couches de convolution sont identiques, quel est donc le but de faire les 2e et 3e couches de convolution ?
Merci d’avance pour votre retour.
Bonne journée 🙂
Hello Lauryn,
Je te recommande de regarder le summary du réseau pour voir l’effet de chaque couche ajoutée 🙂
En gros, pour capturer le plus de features possibles, on ajoute plusieurs couches de convolution. Mais plus on ajoute de couches de convolution, plus on rencontre un problème de taille de sortie. Exemple : première couche convolutive passe de 28*28 pixels à 26*26. Cela se produit pour un padding par défaut fixé à ‘valid’ (qui peut être considéré sans padding autour). Pour pallier à ce problème de réduction de taille de sortie, mais en même temps capturer suffisamment de features/paramètres, sur chaque couche convolutive, on ajoute 2 couches, l’une avec padding=’same’ (on met un padding de 0 autour), puis une convolutive par défaut (regarde le summary pour les détails). Puis on les passe dans la couche de Pooling.
Et l’ajout d’une 2e et d’une 3e couches identiques permet d’augmenter le nombre de features/paramètres et donc d’augmenter l’accuracy du modèle.
Est-ce que c’est toujours le cas ? Non
L’ajout de couches supplémentaires t’aidera à extraire davantage de features. Mais on peut le faire seulement jusqu’à un certain point. Il y a une limite. Après cela, au lieu d’extraire des features, on aura tendance à sur-apprendre sur les données. Et cet overfitting peut entraîner des erreurs de faux positifs par exemple.
Alors à noter qu’il n’y a pas de règle sur le “meilleur” nombre de couches. La plupart du temps, on expérimente avec différentes profondeurs de réseaux et on choisit ce qui fonctionne le mieux.
juste un petit truc Rod, si vous voulez, les images n’ont pas besoin de “rescale” par 1/255 (dans le generator…), car déjà les arrays des images ont des valeurs entre 0 et 1
Hello Abir 🙂
Je ne suis pas sur de te suivre, les images sont normalement des arrays de valeurs de 0 à 255 (du moins les données images que j’ai pris)
oui, je ne comprends pas pourquoi, quand je fais imread, pour explorer les valeurs des pixels en utilisant (par exemple):
imread(‘/content/drive/MyDrive/train_set/squares/drawing(28).png’)
ça me donne un array avec des valeurs entre 0 et 1,(en appliquant .min(), ça me donne 0.18039216 et en appliquant .max(), ça me donne: 1,
mais en utilisant votre dernier bout du code(pour tester le modèle): en choisissant une image par exemple du dossier test:
from keras.preprocessing import image
img_path= os.path.join(TEST_DIR,’triangles’,’drawing(22).png’)
image_test= image.load_img(img_path, target_size=(28,28))
image_tensor= image.img_to_array(image_test)
image_tensor
en testant image_tensor, ça me donne un array avec des valeurs entre 31 et 255 !