Écrire des requêtes SQL claires, lisibles et performantes fait partie du quotidien d’un data scientist ou d’un data analyst, surtout quand on construit des pipelines ETL. Après avoir comparé plusieurs guides de style SQL (listés en fin d’article), j’ai fait le point sur mes propres pratiques et j’en ai retenu 16, surtout des erreurs que j’ai commises moi-même.
Pour chaque pratique, j’ai exécuté le code sur une petite base de clients et de commandes, et tu vois les vraies sorties. Les bénéfices attendus : un code plus lisible, moins d’ambiguïtés, un débogage plus rapide et de meilleures performances.
Article mis à jour en novembre 2026 : j’ai testé toutes les requêtes avec DuckDB (et SQLite pour un cas précis), ce qui m’a permis d’ajouter des démonstrations qui manquaient : le résultat identique de distinct et group by, le gain mesuré de union all, la duplication de lignes avec une jointure mal orientée, les pièges de not in avec les valeurs NULL, et un outil pour faire respecter ces règles automatiquement.
En bref : écris en minuscules (ou choisis une casse et garde-la), préfère select distinct, union all et les CTE aux sous-requêtes, nomme tes clés primaires id, joins avec on en partant de la table « many », liste les colonnes au lieu de select *, gère les NULL avec coalesce et utilise les fonctions de fenêtrage pour classer.
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab : les tables sont créées dans le notebook, il n’y a aucun fichier à télécharger.
Sur quelles données les exemples sont-ils testés ?
Je crée deux petites tables dans une base DuckDB en mémoire, customers (5 clients) et orders (7 commandes), avec volontairement quelques cas difficiles : un client sans commande, des frais de port manquants (NULL) et un compte de test. La fonction sql() exécute une requête et renvoie un DataFrame Pandas.
import duckdb
import pandas as pd

con = duckdb.connect()          # base DuckDB en mémoire

def sql(requete):
    """Exécute une requête SQL et renvoie le résultat sous forme de DataFrame."""
    return con.sql(requete).df()

print("DuckDB", duckdb.__version__)DuckDB 2.0.0con.sql("""
create table customers as
select * from (values
(1, 'Lydia', 'lydia@exemple.fr', timestamp '2024-01-15 10:00:00'),
(2, 'John', 'john@domain.com', timestamp '2024-01-20 09:30:00'),
(3, 'Enzo', 'enzo@domain.com', timestamp '2024-02-03 14:10:00'),
(4, 'Laury', 'laury@exemple.fr', timestamp '2024-02-18 16:45:00'),
(5, 'Test', 'test@domain.com', timestamp '2024-03-01 08:00:00')
) as t(id, name, email, created_at)
""")
con.sql("""
create table orders as
select * from (values
(1, 1, timestamp '2024-02-01 10:15:00', 120.0, 5.0),
(2, 1, timestamp '2024-02-01 18:40:00', 80.0, null),
(3, 2, timestamp '2024-02-05 11:00:00', 45.5, 4.5),
(4, 3, timestamp '2024-02-10 15:20:00', 210.0, 0.0),
(5, 3, timestamp '2024-03-12 09:05:00', 60.0, 5.0),
(6, 3, timestamp '2024-03-12 20:30:00', 35.0, null),
(7, 5, timestamp '2024-03-02 12:00:00', 999.0, 0.0)
) as t(id, customer_id, created_at, amount, shipping_fee)
""")
print(sql("select * from customers"))
print(sql("select * from orders")) id name email created_at
0 1 Lydia lydia@exemple.fr 2024-01-15 10:00:00
1 2 John john@domain.com 2024-01-20 09:30:00
2 3 Enzo enzo@domain.com 2024-02-03 14:10:00
3 4 Laury laury@exemple.fr 2024-02-18 16:45:00
4 5 Test test@domain.com 2024-03-01 08:00:00
id customer_id created_at amount shipping_fee
0 1 1 2024-02-01 10:15:00 120.0 5.0
1 2 1 2024-02-01 18:40:00 80.0 NaN
2 3 2 2024-02-05 11:00:00 45.5 4.5
3 4 3 2024-02-10 15:20:00 210.0 0.0
4 5 3 2024-03-12 09:05:00 60.0 5.0
5 6 3 2024-03-12 20:30:00 35.0 NaN
6 7 5 2024-03-02 12:00:00 999.0 0.01. Faut-il écrire le SQL en minuscules ou en majuscules ?
Les mots-clés et les noms de fonctions en minuscules sont plus faciles à lire pour un humain. Tu croiseras souvent le conseil inverse (mots-clés en majuscules : SELECT, FROM, WHERE), et les deux conventions se défendent. Ce qui compte, c’est de choisir une règle et de la tenir dans toute ton équipe. Ici, on part sur les minuscules. Pour le moteur SQL, la casse ne change rien au résultat :
/* Bon */
select count(*) as customers_count
from customers customers_count
0 5/* Mauvais */
SELECT COUNT(*) AS customers_count
FROM customers customers_count
0 52. Pourquoi préférer select distinct à un group by sur toutes les colonnes ?
Utilise select distinct pour dédupliquer des lignes, plutôt que de regrouper toutes les colonnes. Le résultat est identique, mais l’intention est beaucoup plus claire : on veut des lignes uniques, pas un calcul par groupe.
/* Bon */
select distinct
    customer_id
    , date_trunc('day', created_at) as purchase_date
from orders
order by customer_id, purchase_date customer_id purchase_date
0 1 2024-02-01
1 2 2024-02-05
2 3 2024-02-10
3 3 2024-03-12
4 5 2024-03-02/* Mauvais */
select
customer_id
, date_trunc('day', created_at) as purchase_date
from orders
group by 1, 2
order by customer_id, purchase_date customer_id purchase_date
0 1 2024-02-01
1 2 2024-02-05
2 3 2024-02-10
3 3 2024-03-12
4 5 2024-03-02Les deux requêtes renvoient exactement les mêmes 5 lignes (je les ai triées pour pouvoir les comparer). Garde group by pour quand tu calcules un agrégat.
3. Quand utiliser union all plutôt que union ?
Utilise union all sauf si tu veux vraiment supprimer les doublons. union doit comparer les lignes pour dédupliquer le résultat, alors que union all se contente de les mettre bout à bout. Voici la différence de résultat sur nos commandes :
select customer_id from orders where amount > 100
union
select customer_id from orders where amount > 50
order by customer_id customer_id
0 1
1 3
2 5select customer_id from orders where amount > 100
union all
select customer_id from orders where amount > 50
order by customer_id customer_id
0 1
1 1
2 1
3 3
4 3
5 3
6 5
7 5union renvoie 3 lignes (les doublons sont supprimés), union all en renvoie 8. Et sur le plan des performances ? Mesure sur deux fois 5 millions de lignes :
import time

def chrono(requete):
    debut = time.perf_counter()
    resultat = con.execute(requete).fetchall()[0][0]
    return resultat, time.perf_counter() - debut

n, t_union = chrono("""select max(i) from (
    select i from range(5_000_000) t(i)
    union
    select i from range(5_000_000) t(i))""")
m, t_all = chrono("""select max(i) from (
    select i from range(5_000_000) t(i)
    union all
    select i from range(5_000_000) t(i))""")

print(f"union     : max = {n} en {t_union:.3f} s")
print(f"union all : max = {m} en {t_all:.3f} s")union : max = 4999999 en 0.554 s
union all : max = 4999999 en 0.005 sDans ce test, union all est plus de 100 fois plus rapide, car il évite entièrement la déduplication. Les temps dépendent du moteur et de la machine, mais le sens de l’écart reste le même.
4. Comment écrire un bon CTE ?
Un CTE (common table expression, introduit par with) doit effectuer une seule unité logique de travail. Son nom doit être aussi explicite que nécessaire pour indiquer ce qu’il fait, sans préfixe ni suffixe cte. Et les CTE dont la logique est surprenante doivent être commentés. Exemple avec deux CTE enchaînés :
with orders_per_customer as (
    select
        customer_id
        , count(*) as orders_count
        , sum(amount) as total_amount
    from orders
    group by customer_id
),

big_customers as (
    -- seuil métier : plus de 200 d'achats cumulés
    select customer_id
    from orders_per_customer
    where total_amount > 200
)

select
    customers.name
    , orders_per_customer.orders_count
    , orders_per_customer.total_amount
from big_customers
inner join customers on big_customers.customer_id = customers.id
inner join orders_per_customer on big_customers.customer_id = orders_per_customer.customer_id
order by orders_per_customer.total_amount desc name orders_count total_amount
0 Test 1 999.0
1 Enzo 3 305.0Chaque CTE a un rôle clair (orders_per_customer agrège, big_customers filtre avec un seuil métier commenté). Si tu veux creuser le sujet, regarde l’ordre d’exécution des requêtes SQL, qui explique pourquoi une requête se lit dans cet ordre.
5. Pourquoi utiliser des CTE plutôt que des sous-requêtes ?
Les CTE rendent la requête plus facile à lire et à raisonner : on la lit de haut en bas, un CTE peut être référencé plusieurs fois, et il est plus simple à refactoriser ensuite. Voici la même logique avec une sous-requête, puis avec un CTE :
/* Mauvais : une sous-requête dans le from */
select customer_id, total_amount
from (
    select customer_id, sum(amount) as total_amount
    from orders
    group by customer_id
) as t
where total_amount > 100
order by customer_id customer_id total_amount
0 1 200.0
1 3 305.0
2 5 999.0/* Bon : un CTE avec un nom explicite */
with revenue_per_customer as (
select
customer_id
, sum(amount) as total_amount
from orders
group by customer_id
)
select
customer_id
, total_amount
from revenue_per_customer
where total_amount > 100
order by customer_id customer_id total_amount
0 1 200.0
1 3 305.0
2 5 999.0Le résultat est identique, mais la seconde version se lit comme une suite d’étapes nommées.
6. Comment nommer les clés primaires à colonne unique ?
Nomme-les toujours id. On voit ainsi d’un coup d’œil qu’une colonne est une clé primaire, ce qui aide à savoir si une jointure est de type one-to-many ou many-to-one (voir la pratique 10). C’est aussi plus court que customers.customer_id dans les conditions de jointure. Les clés étrangères, elles, portent le nom de la table référencée (customer_id).
/* Bon : la clé primaire s'appelle id */
select
    orders.id as order_id
    , customers.name
from orders
left join customers on orders.customer_id = customers.id
order by orders.id order_id name
0 1 Lydia
1 2 Lydia
2 3 John
3 4 Enzo
4 5 Enzo
5 6 Enzo
6 7 Test7. Pourquoi mettre les virgules en tête de ligne ?
Quand une liste de colonnes s’étend sur plusieurs lignes, place les virgules au début des lignes suivantes, suivies d’un espace. Pendant le débogage, tu peux commenter une ligne entière sans provoquer d’erreur, tu repères plus facilement une virgule manquante, et les différences dans Git sont plus propres quand on ajoute une colonne à la fin.
/* Bon : virgules en tête */
select
    id
    , email
    , date_trunc('month', created_at) as signup_month
from customers
order by id id email signup_month
0 1 lydia@exemple.fr 2024-01-01
1 2 john@domain.com 2024-01-01
2 3 enzo@domain.com 2024-02-01
3 4 laury@exemple.fr 2024-02-01
4 5 test@domain.com 2024-03-01Teste ce qui se passe quand on commente la dernière colonne. Je le fais avec SQLite, qui refuse la virgule finale. Attention : certains moteurs comme DuckDB l’acceptent, mais la plupart des bases ne le font pas.
import sqlite3

lite = sqlite3.connect(":memory:")
lite.execute("create table customers (id, email, signup_month)")

# Virgules à la fin : la dernière colonne commentée laisse une virgule orpheline
try:
    lite.execute("""
    select
        id,
        email,
        -- signup_month,
    from customers
    """)
except sqlite3.OperationalError as erreur:
    print("virgules à la fin :", erreur)

# Virgules en tête : la même ligne commentée ne casse rien
lite.execute("""
select
    id
    , email
    -- , signup_month
from customers
""")
print("virgules en tête : aucune erreur")virgules à la fin : near "from": syntax error
virgules en tête : aucune erreur8. Pourquoi utiliser des guillemets simples pour les chaînes de caractères ?
Certains dialectes comme BigQuery acceptent les guillemets doubles pour les chaînes, mais dans la plupart des moteurs, les guillemets doubles désignent un identifiant (un nom de colonne ou de table). Avec des guillemets simples, tu es sûr de ton résultat partout :
/* Bon */
select id, name
from customers
where email like '%@domain.com'
order by id id name
0 2 John
1 3 Enzo
2 5 TestEt voici ce qui arrive avec des guillemets doubles :
try:
    sql("""
    select id, name
    from customers
    where email like "%@domain.com"
    """)
except duckdb.Error as erreur:
    print(type(erreur).__name__)
print(str(erreur).splitlines()[0])BinderException
Binder Error: Referenced column "%@domain.com" not found in FROM clause!Le moteur cherche une colonne qui s’appellerait %@domain.com, et ne la trouve pas.
9. Faut-il éviter using dans les jointures ?
Utiliser on pour toutes les jointures est plus cohérent : si tu dois ajouter une condition plus tard, on s’adapte facilement, alors que using ne permet que l’égalité de colonnes de même nom. De plus, le comportement de using avec les jointures externes peut varier d’un moteur à l’autre. Voici la différence sur un full join :
con.sql("create table a as select * from (values (1, 'x'), (2, 'y')) as t(k, va)")
con.sql("create table b as select * from (values (2, 'p'), (3, 'q')) as t(k, vb)")

print(sql("select * from a full join b using (k) order by 1"))
print(sql("select * from a full join b on a.k = b.k order by a.k")) k va vb
0 1 x NaN
1 2 y p
2 3 NaN q
k va k_1 vb
0 1 x <NA> NaN
1 2 y 2 p
2 <NA> NaN 3 qAvec using (k), la clé est fusionnée en une seule colonne. Avec on, les deux colonnes sont conservées (k et k_1), et la colonne de la table sans correspondance est vide. Le format du résultat n’est donc pas le même, et il est plus prévisible avec on.
10. Dans quel ordre écrire les conditions de jointure ?
Dans la condition d’une jointure, place la table référencée en premier juste après on, et pars de la table « many » (celle qui contient la clé étrangère). Il est ainsi plus facile de voir si la jointure peut dupliquer des lignes. Mesurons-le :
many_to_one = sql("""
    select orders.id
    from orders
    left join customers on orders.customer_id = customers.id
""")

one_to_many = sql("""
    select orders.id
    from customers
    left join orders on orders.customer_id = customers.id
""")

print("lignes dans orders          :", sql("select count(*) as n from orders")["n"][0])
print("orders left join customers  :", len(many_to_one))
print("customers left join orders :", len(one_to_many))lignes dans orders : 7
orders left join customers : 7
customers left join orders : 8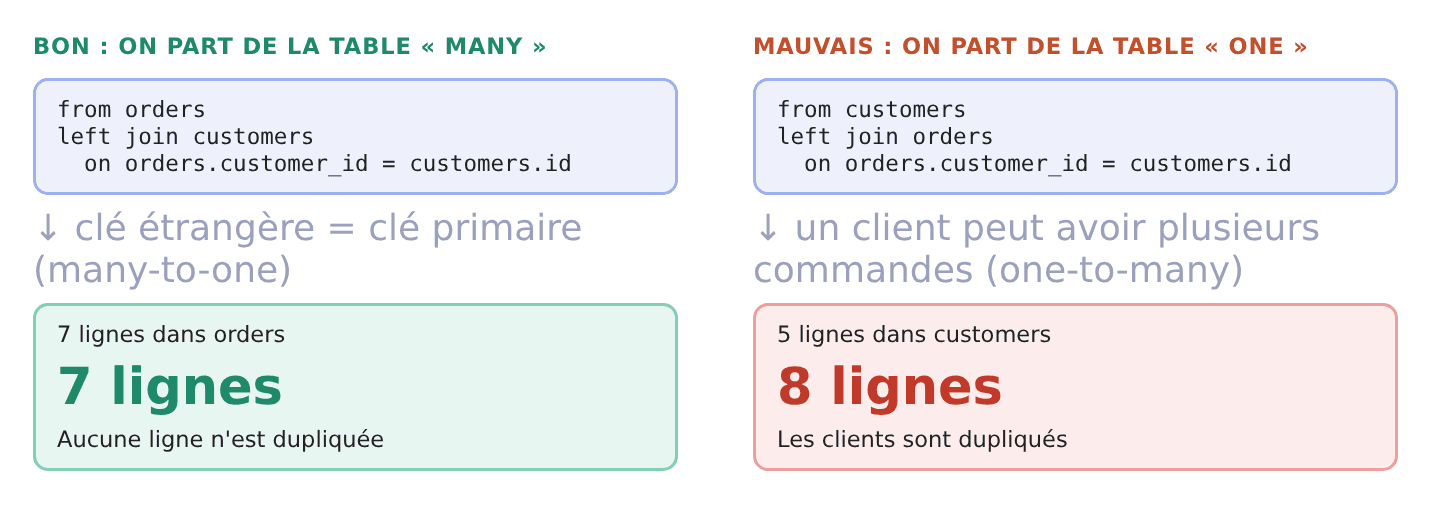
En partant de orders, chaque commande a au plus un client : 7 lignes, aucune duplication. En partant de customers, un client avec 3 commandes apparaît 3 fois, et le client sans commande apparaît quand même : 8 lignes au lieu de 5. Si tu fais ensuite une somme, les valeurs du client peuvent être comptées plusieurs fois. Pour les différents types de jointure, regarde aussi SQL pour l’analyse de données.
11. Pourquoi éviter select * et lister les colonnes ?
Écrire select * est tentant, mais c’est un piège dès que la requête vit plus de quelques jours. Si quelqu’un ajoute, renomme ou supprime une colonne dans la table source, ta requête change de comportement sans que tu t’en aperçoives. Regarde :
con.sql("create table produits as select 1 as id, 'stylo' as nom")

print(sql("select * from produits"))

con.sql("alter table produits add column prix_achat double default 0.4")   # une colonne interne s'ajoute

print(sql("select * from produits"))
print(sql("select id, nom from produits")) id nom
0 1 stylo
id nom prix_achat
0 1 stylo 0.4
id nom
0 1 styloAprès l’ajout de la colonne prix_achat (une donnée interne), select * la renvoie à tous ceux qui utilisent la requête. En listant les colonnes dont tu as besoin, tu rends ton intention explicite, tu repères plus vite les bugs et tu évites de transporter des données inutiles.
12. Quelle convention de nommage adopter ?
Choisis un style (le snake_case est le plus courant en SQL) et applique-le partout : schémas, tables, colonnes, CTE. Mélanger orderDate, order_date et "Order Date" t’oblige à deviner, et à utiliser des guillemets. Fais aussi un choix unique entre singulier et pluriel pour les noms de tables, et évite les espaces et les accents. Voici le coût d’un nom avec espace :
con.sql("""create table commandes_mal_nommees as select 1 as id, date '2024-01-01' as "Order Date" """)

try:
    sql("select Order Date from commandes_mal_nommees")
except duckdb.Error as erreur:
    print("sans guillemets :", str(erreur).splitlines()[0])

print(sql('select "Order Date" from commandes_mal_nommees'))sans guillemets : Parser Error: syntax error at or near "Date"
Order Date
0 2024-01-0113. Comment indenter et aligner une requête ?
Une requête bien structurée verticalement se lit comme un texte : un mot-clé principal par ligne, une colonne par ligne, des conditions alignées. Tu vois en un coup d’œil ce qui est sélectionné, d’où ça vient et comment c’est filtré. Les différences sont aussi plus lisibles dans Git quand tu modifies une seule colonne.
select
    customers.id
    , customers.name
    , sum(orders.amount) as total_revenue
from orders
left join customers on orders.customer_id = customers.id
where orders.created_at >= '2024-02-01'
group by
    customers.id
    , customers.name
order by total_revenue desc id name total_revenue
0 5 Test 999.0
1 3 Enzo 305.0
2 1 Lydia 200.0
3 2 John 45.514. Comment bien commenter une requête SQL ?
Un bon commentaire n’explique pas ce que fait le code (tout le monde peut le lire), mais pourquoi tu l’as écrit ainsi : une règle métier, une exception, une limite d’une source de données. Si tu ressens le besoin de commenter chaque ligne, c’est souvent qu’il faut renommer des éléments ou découper la requête en CTE.
select
    id
    , customer_id
    , amount
from orders
/* On exclut les commandes des comptes de test (ticket DATA-482) */
where customer_id not in (select id from customers where name = 'Test')
order by id id customer_id amount
0 1 1 120.0
1 2 1 80.0
2 3 2 45.5
3 4 3 210.0
4 5 3 60.0
5 6 3 35.0Ce code cache un piège : not in avec une sous-requête qui contient un NULL ne renvoie aucune ligne. Compare avec not exists sur une table test_customers qui contient un identifiant manquant :
con.sql("create table test_customers as select * from (values (5), (null)) as t(id)")

print(sql("select count(*) as n from orders where customer_id not in (select id from test_customers)"))
print(sql("""select count(*) as n from orders
where not exists (select 1 from test_customers where test_customers.id = orders.customer_id)""")) n
0 0
n
0 6La première requête renvoie 0 ligne au lieu de 6, sans aucune erreur. Utilise not exists (ou filtre les NULL dans la sous-requête) quand la colonne peut être vide.
15. Comment gérer les valeurs NULL en SQL ?
Dès qu’un NULL entre dans un calcul, le résultat est NULL. Une division par NULL ne lève pas d’erreur de division par zéro : elle renvoie silencieusement NULL. Utilise coalesce (ou ifnull selon ton moteur) pour fixer une valeur par défaut quand elle a du sens.
resultat = con.execute("""
select
    10 + null as addition
    , 10 / null as division
    , 10 + coalesce(null, 0) as avec_coalesce
""").fetchall()

print(resultat) # None correspond à NULL[(None, None, 10)]select
id
, amount
, shipping_fee
, amount + shipping_fee as total_sans_coalesce
, amount + coalesce(shipping_fee, 0) as total_amount
from orders
order by id id amount shipping_fee total_sans_coalesce total_amount
0 1 120.0 5.0 125.0 125.0
1 2 80.0 NaN NaN 80.0
2 3 45.5 4.5 50.0 50.0
3 4 210.0 0.0 210.0 210.0
4 5 60.0 5.0 65.0 65.0
5 6 35.0 NaN NaN 35.0
6 7 999.0 0.0 999.0 999.0Les commandes 2 et 6 n’ont pas de frais de port : sans coalesce, leur total est NULL (affiché NaN par Pandas). Fais aussi attention au comportement des agrégats : avg() ignore les NULL, et count(colonne) ne compte que les lignes non nulles, alors que count(*) compte toutes les lignes.
select
    count(*) as nb_lignes
    , count(shipping_fee) as nb_frais_renseignes
    , avg(shipping_fee) as moyenne_sans_null
    , avg(coalesce(shipping_fee, 0)) as moyenne_avec_zeros
from orders nb_lignes nb_frais_renseignes moyenne_sans_null moyenne_avec_zeros
0 7 5 2.9 2.071429Les deux moyennes diffèrent (2,9 contre 2,07) : choisis celle qui correspond à ta question. Un frais manquant veut-il dire « zéro » ou « inconnu » ?
16. Comment utiliser les fonctions de fenêtrage ?
Les fonctions de fenêtrage (avec over, partition by et order by) calculent un indicateur par groupe sans regrouper les lignes. Pour numéroter les commandes de chaque client, c’est bien plus lisible qu’une sous-requête corrélée :
select
    customer_id
    , id as order_id
    , created_at
    , row_number() over (
        partition by customer_id
        order by created_at
    ) as order_rank
from orders
order by customer_id, created_at customer_id order_id created_at order_rank
0 1 1 2024-02-01 10:15:00 1
1 1 2 2024-02-01 18:40:00 2
2 2 3 2024-02-05 11:00:00 1
3 3 4 2024-02-10 15:20:00 1
4 3 5 2024-03-12 09:05:00 2
5 3 6 2024-03-12 20:30:00 3
6 5 7 2024-03-02 12:00:00 1Attention à la différence entre les deux fonctions de rang les plus utilisées : rank() donne le même rang aux ex æquo (et saute des numéros ensuite), alors que row_number() attribue toujours des numéros distincts.
select
    id
    , score
    , rank() over (order by score desc) as rang
    , row_number() over (order by score desc) as numero
from (values (1, 100), (2, 100), (3, 80), (4, 60)) as t(id, score)
order by numero id score rang numero
0 1 100 1 1
1 2 100 1 2
2 3 80 3 3
3 4 60 4 4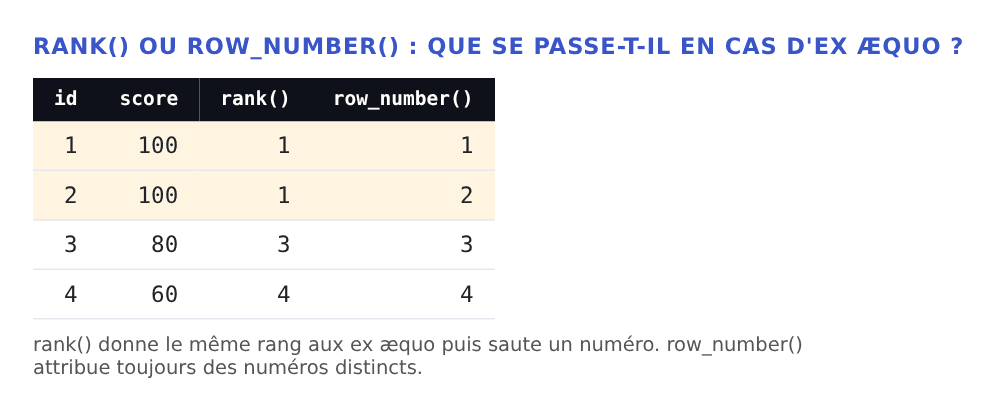
Pour garder une seule ligne par client (sa première commande, par exemple), row_number() est le bon choix, associé à un CTE qui filtre sur le rang 1 :
with ranked_orders as (
    select
        customer_id
        , id as order_id
        , created_at
        , row_number() over (
            partition by customer_id
            order by created_at
        ) as order_rank
    from orders
)

select customer_id, order_id, created_at
from ranked_orders
where order_rank = 1
order by customer_id customer_id order_id created_at
0 1 1 2024-02-01 10:15:00
1 2 3 2024-02-05 11:00:00
2 3 4 2024-02-10 15:20:00
3 5 7 2024-03-02 12:00:00Pour aller plus loin, lis mon guide sur les fonctions Window de SQL.
Comment faire respecter ces règles automatiquement ?
Appliquer 16 règles à la main est fastidieux. Un linter comme SQLFluff vérifie ton style SQL et peut même corriger certaines erreurs. Ici, je lui demande de contrôler que les mots-clés sont en minuscules (règle CP01) :
from sqlfluff.core import FluffConfig, Linter
import sqlfluff

requete = "SELECT id, email FROM customers WHERE email LIKE '%@domain.com'\n"

config = FluffConfig(configs={
    "core": {"dialect": "ansi", "rules": "CP01"},
    "rules": {"capitalisation.keywords": {"capitalisation_policy": "lower"}},
})

for v in Linter(config=config).lint_string(requete).get_violations():
    print(v.rule_code(), f"ligne {v.line_no}, colonne {v.line_pos} :", v.desc())

print(sqlfluff.fix(requete, config=config))CP01 ligne 1, colonne 1 : Keywords must be lower case.
CP01 ligne 1, colonne 18 : Keywords must be lower case.
CP01 ligne 1, colonne 33 : Keywords must be lower case.
CP01 ligne 1, colonne 45 : Keywords must be lower case.
select id, email from customers where email like '%@domain.com'Chaque violation est signalée avec sa position, et fix() renvoie la requête corrigée. Tu peux aussi brancher SQLFluff sur ton éditeur ou sur ton dépôt Git, pour que le style soit vérifié à chaque commit.
Questions fréquentes
Faut-il écrire le SQL en majuscules ou en minuscules ?
Les deux conventions sont valables et le moteur SQL ne fait pas de différence. Ce qui compte, c’est de choisir une règle et de l’appliquer dans toute l’équipe. Les minuscules sont plus faciles à lire pour un humain, et un outil comme SQLFluff peut faire respecter la règle automatiquement.
Quelle est la différence entre union et union all ?
union supprime les lignes en double, ce qui oblige le moteur à les comparer. union all met simplement les résultats bout à bout. Sauf si tu as besoin de dédupliquer, utilise union all : dans mon test sur deux fois 5 millions de lignes, il était plus de 100 fois plus rapide.
Pourquoi éviter select * dans une requête SQL ?
Parce que le résultat change dès que quelqu’un ajoute, renomme ou supprime une colonne de la table source, sans que ta requête ne change. Lister les colonnes rend l’intention explicite, évite de transporter des données inutiles et facilite le débogage.
Pourquoi une jointure peut-elle dupliquer des lignes ?
Quand tu pars de la table « one » (customers) pour joindre la table « many » (orders), chaque client est répété autant de fois qu’il a de commandes. Dans mon exemple, 5 clients donnent 8 lignes. Pars de la table qui contient la clé étrangère (orders left join customers) : tu conserves 7 lignes, comme dans orders.
Pourquoi not in ne renvoie-t-il parfois aucune ligne ?
Si la sous-requête de not in contient au moins un NULL, la comparaison n’est jamais vraie et la requête ne renvoie aucune ligne, sans erreur. Utilise not exists, ou ajoute un filtre is not null dans la sous-requête.
Quelle est la différence entre rank() et row_number() ?
rank() donne le même rang aux ex æquo puis saute des numéros (1, 1, 3, 4), alors que row_number() attribue toujours des numéros distincts (1, 2, 3, 4). Pour garder une seule ligne par groupe, row_number() est le bon choix.
Conclusion : par où commencer ?
Ces 16 pratiques ne servent pas à faire joli : elles évitent de vrais bugs (lignes dupliquées par une jointure, not in qui ne renvoie rien, colonnes qui apparaissent sans prévenir) et rendent les requêtes faciles à relire. Si tu dois en prioriser trois, commence par lister les colonnes, partir de la bonne table dans tes jointures et gérer explicitement les NULL. Pour le reste, choisis des conventions avec ton équipe et laisse un linter les faire respecter.
Pour pratiquer SQL avec Python sur des cas concrets, le mieux est de coder. Sur DataXp, tu apprends Python et la data science avec des exercices pratiques à faire directement en ligne.
Pour aller plus loin en SQL
- Le guide pour maîtriser les fonctions Window de SQL : pour aller plus loin que la pratique 16
- SQL : ordre d’exécution des requêtes : comprendre pourquoi une requête s’exécute dans cet ordre
- Top 10 des requêtes SQL avancées : la suite logique une fois les bonnes pratiques acquises
- SQL pour l’analyse de données : des bases aux requêtes avancées
- 30 requêtes SQL expliquées par leurs équivalents Pandas : SQL et Pandas côte à côte