
Quel est le meilleur langage pour l’analyse de données ? Python ou R ?
Dans cet article, je vais comparer Python vs R de façon objective. Pour ce faire, j’analyserai des données avec ces deux langages afin d’obtenir les mêmes résultats. Cela nous permettra de comprendre les forces et les faiblesses de chacun.
Même si je n’enseigne pour le moment que Python, je pense que Python et R ont tous les deux leur place dans la boîte à outils d’un data scientist.
En bref : Python et R ont tous les deux leur place dans la boîte à outils d’un data scientist. Dans cet article, on analyse les mêmes données (481 joueurs NBA de la saison 2013-2014, 31 colonnes) avec les deux langages : import, moyennes, corrélations, clustering, régression linéaire, forêt aléatoire et Web Scraping. Verdict : R est plus fonctionnel, avec davantage de fonctions intégrées et un écosystème statistique plus large ; Python est plus orienté objet, s’appuie sur des bibliothèques principales (Pandas, scikit-learn) et s’en sort mieux pour les tâches non statistiques.
Tu peux aussi exécuter le code Python de cet article dans ce notebook Google Colab : chaque extrait est dans sa propre cellule, prêt à être modifié.
Nous analyserons ici un ensemble de données sur les joueurs de la NBA et leur performance au cours de la saison 2013-2014. Tu peux télécharger le fichier nba_2013.csv.
Pour chaque étape de l’analyse, nous montrerons le code Python et R ainsi que les résultats (depuis Jupyter Notebook pour Python et RStudio pour R). On en profitera pour ajouter quelques explications et remarques sur les différentes approches.
Les codes Python de cet article ont été mis à jour pour fonctionner avec les versions récentes de Pandas et de scikit-learn.
Sans plus tarder, que le match commence !
Comment importer un fichier CSV en Python et en R ?
Python :
import pandas as pd

nba = pd.read_csv("nba_2013.csv")R :
nba <- read.csv("nba_2013.csv")Ce code lit le fichier CSV nba_2013.csv, qui contient des données sur les joueurs NBA de la saison 2013-2014, et le stocke dans une variable nommée nba.
La seule vraie différence : en Python, nous devons importer la bibliothèque Pandas pour avoir accès aux DataFrame.
Les DataFrames, en R comme en Python, sont des tableaux bidimensionnels (matrices) où chaque colonne peut avoir un type de données différent.
À la fin de cette étape, le fichier CSV est chargé dans un tableau dans les deux langages.
Comment trouver le nombre de lignes d’un tableau en Python et en R ?
Python :
nba.shape(481, 31)R :
dim(nba)481 31nba.shape (Python) et dim(nba) (R) retournent le nombre de joueurs et le nombre de colonnes du DataFrame.
Nous avons 481 lignes (ou joueurs) et 31 colonnes contenant des données sur les joueurs.
Comment afficher la première ligne d’un DataFrame en Python et en R ?
Python :
nba.head(1).T 0
player Quincy Acy
pos SF
age 23
bref_team_id TOT
g 63
gs 0
mp 847
fg 66
fga 141
fg. 0.468
x3p 4
x3pa 15
x3p. 0.266667
x2p 62
x2pa 126
x2p. 0.492063
efg. 0.482
ft 35
fta 53
ft. 0.66
orb 72
drb 144
trb 216
ast 28
stl 23
blk 26
tov 30
pf 122
pts 171
season 2013-2014
season_end 2013R :
head(nba, 1) player pos age bref_team_id g gs mp fg fga fg. x3p x3pa x3p. x2p x2pa x2p. efg. ft fta ft.
1 Quincy Acy SF 23 TOT 63 0 847 66 141 0.468 4 15 0.2666667 62 126 0.4920635 0.482 35 53 0.66
orb drb trb ast stl blk tov pf pts season season_end
1 72 144 216 28 23 26 30 122 171 2013-2014 2013Les deux codes ci-dessus affichent la première ligne du tableau. On remarque que la syntaxe est très similaire.
Python est plus orienté objet : on applique la méthode head sur l’objet DataFrame.
R, quant à lui, utilise la fonction head. C’est assez fréquent : Python est orienté objet, alors que R est plus fonctionnel.
Comment calculer la moyenne de chaque colonne en Python et en R ?
Nous allons maintenant calculer la valeur moyenne de chaque statistique. Les colonnes ont des noms comme fg (field goals made) et ast (assists). Ce sont les statistiques de la saison pour le joueur correspondant.
Si tu veux une explication plus complète de toutes les statistiques de basketball, consulte le glossaire de la NBA.
Python :
nba.mean(numeric_only=True)age 26.509356
g 53.253638
gs 25.571726
mp 1237.386694
fg 192.881497
fga 424.463617
fg. 0.436436
x3p 39.613306
x3pa 110.130977
x3p. 0.285111
x2p 153.268191
x2pa 314.332640
x2p. 0.466947
efg. 0.480752
ft 91.205821
fta 120.642412
ft. 0.722419
orb 55.810811
drb 162.817048
trb 218.627859
ast 112.536383
stl 39.280665
blk 24.103950
tov 71.862786
pf 105.869023
pts 516.582121
season_end 2013.000000
dtype: float64R :
sapply(nba, mean, na.rm=TRUE) player pos age bref_team_id g gs mp fg
NA NA 26.5093555 NA 53.2536383 25.5717256 1237.3866944 192.8814969
fga fg. x3p x3pa x3p. x2p x2pa x2p.
424.4636175 0.4364363 39.6133056 110.1309771 0.2851112 153.2681913 314.3326403 0.4669472
efg. ft fta ft. orb drb trb ast
0.4807516 91.2058212 120.6424116 0.7224187 55.8108108 162.8170478 218.6278586 112.5363825
stl blk tov pf pts season season_end
39.2806653 24.1039501 71.8627859 105.8690229 516.5821206 NA 2013.0000000On note quelques différences majeures dans notre approche. Dans les deux cas, nous appliquons une fonction à chaque colonne du tableau.
En Python, la méthode .mean() calcule la moyenne de chaque colonne. Avec les versions récentes de Pandas, il faut lui passer numeric_only=True pour ignorer les colonnes de texte (comme player ou pos) : sans cela, elle lève une erreur TypeError.
En R, la moyenne de valeurs de type chaîne de caractères donne NA (Not Available).
Nous devons aussi ignorer les valeurs NA lorsque nous calculons la moyenne, d’où le paramètre na.rm = TRUE de la fonction mean. Sans lui, nous obtenons NA pour la moyenne de colonnes comme x3p. (le pourcentage de réussite à trois points) : certains joueurs n’ont tenté aucun tir à trois points, donc leur pourcentage est manquant.
Si nous utilisons la fonction mean sans précaution dans R, nous obtenons NA comme réponse, sauf si nous spécifions na.rm = TRUE, qui ignore les valeurs NA. La méthode .mean() de Pandas ignore déjà ces valeurs par défaut.
Comment tracer des diagrammes de corrélation en Python et en R ?
Un moyen courant d’explorer un ensemble de données consiste à voir comment les différentes colonnes sont corrélées entre elles. Ici, nous allons comparer les colonnes ast (passes décisives), fg (paniers marqués) et trb (rebonds).
Python :
import seaborn as sns
import matplotlib.pyplot as plt

sns.pairplot(nba[["ast", "fg", "trb"]])
plt.show()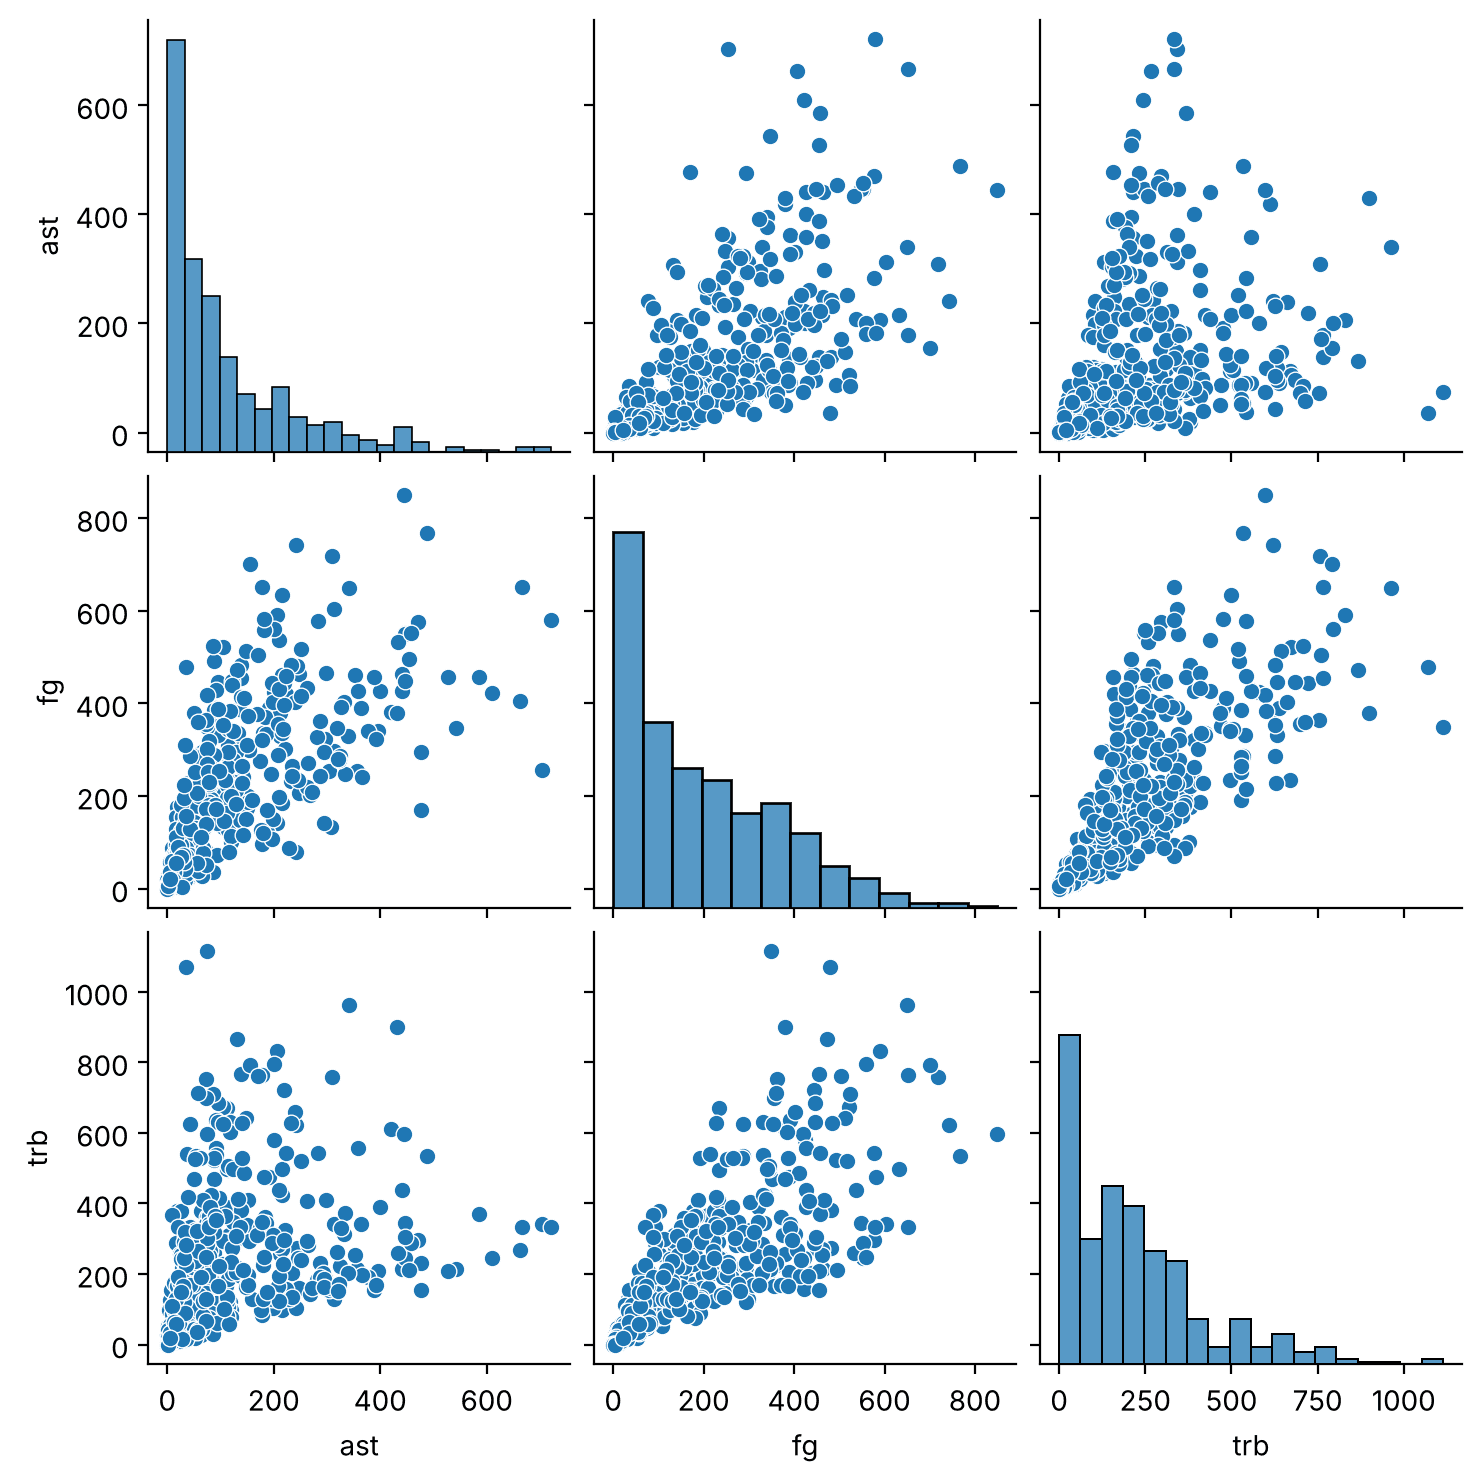
R :
library(GGally)

ggpairs(nba[,c("ast", "fg", "trb")])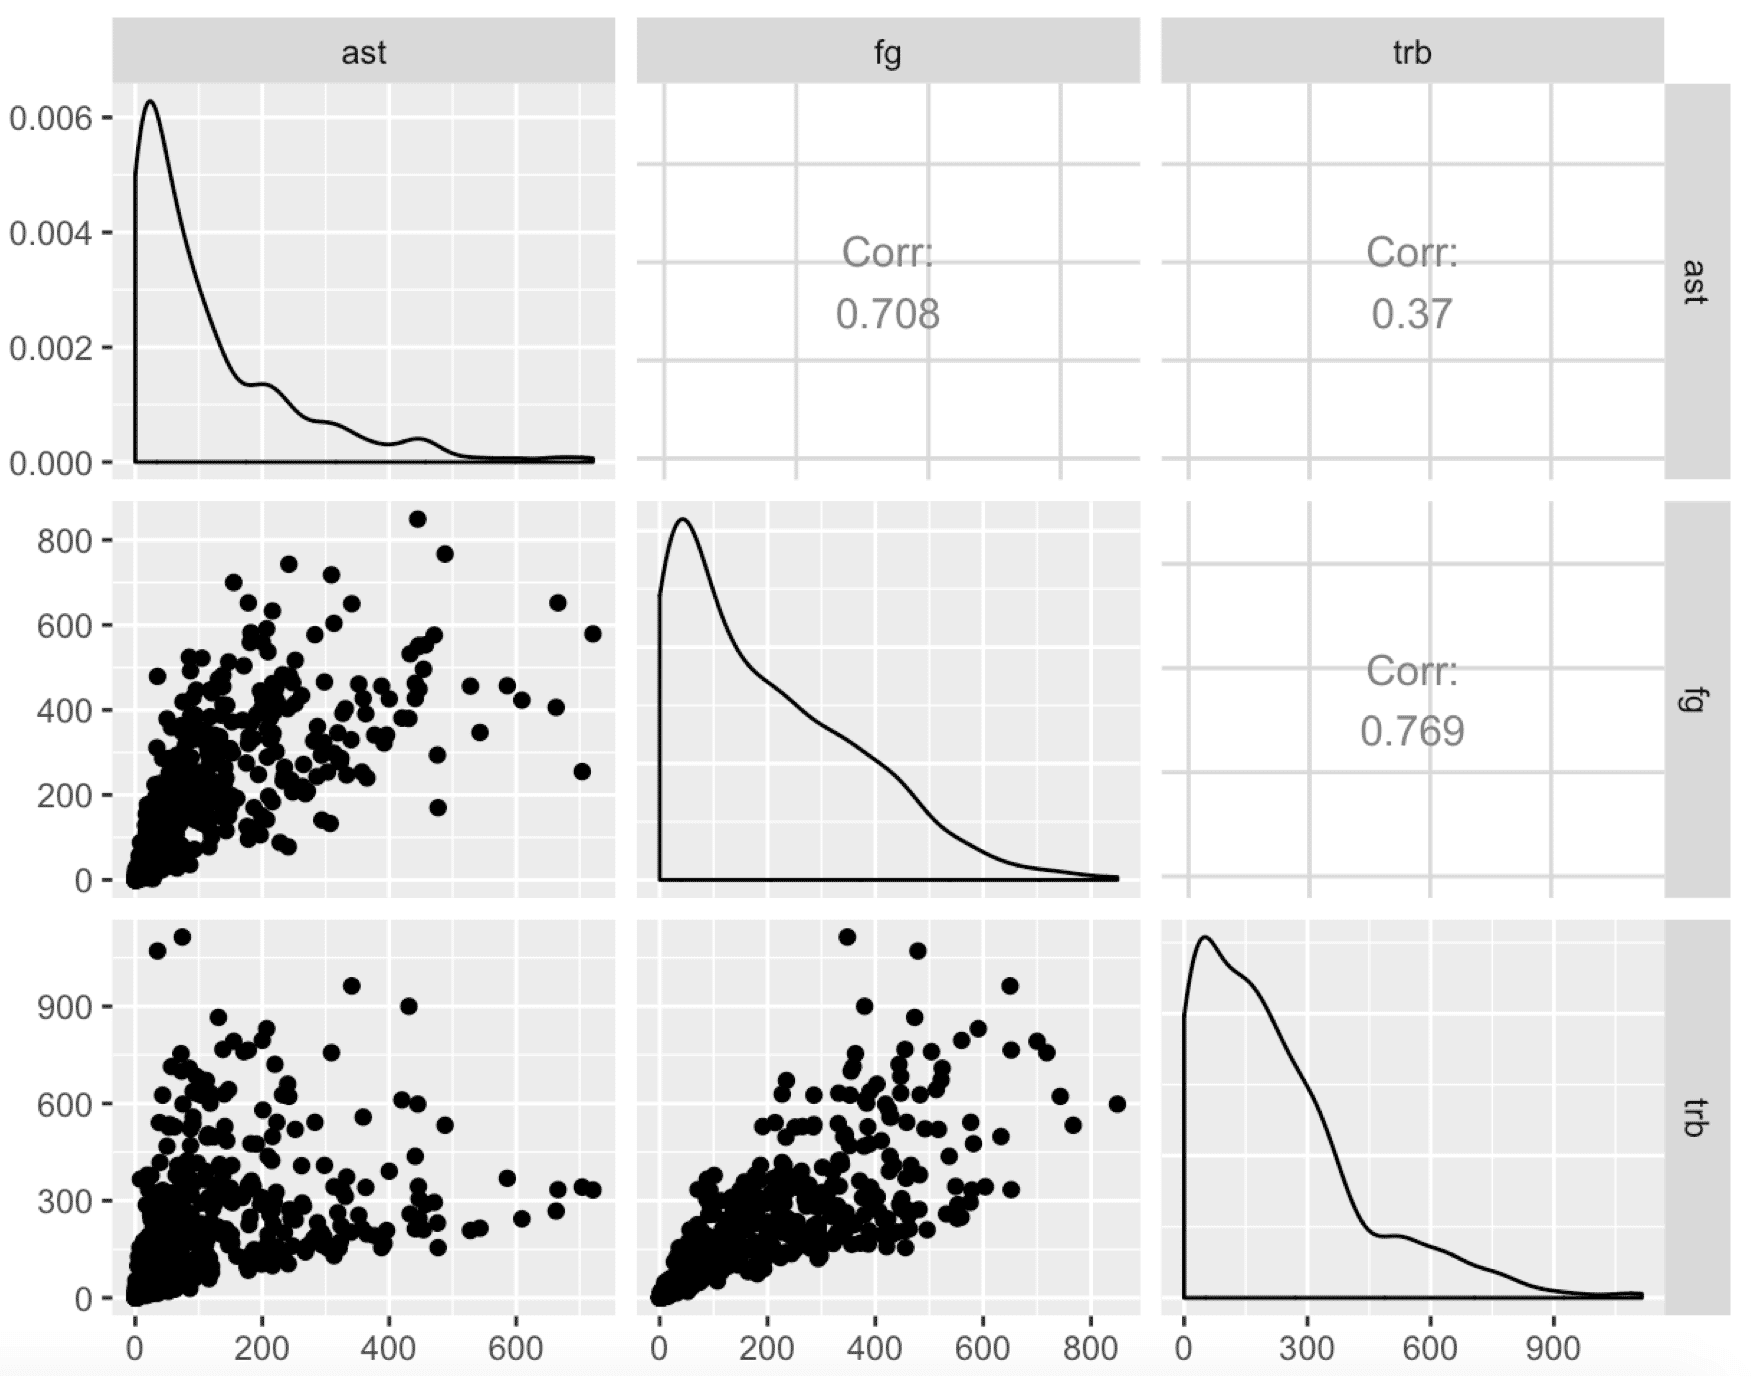
Résultat : nous obtenons des tracés très similaires.
Cela montre aussi que l’écosystème R en Data Science compte beaucoup de petites bibliothèques : GGally est une bibliothèque d’aide pour ggplot2, la bibliothèque de visualisation la plus utilisée en R, et il existe beaucoup d’autres bibliothèques de visualisation.
En Python, Matplotlib est la principale bibliothèque pour tracer des courbes, et Seaborn est une couche très utilisée au-dessus de Matplotlib. Avec la visualisation en Python, il y a généralement une seule façon de faire, alors qu’en R, il existe de nombreuses méthodes grâce aux nombreuses bibliothèques différentes.
Comment regrouper des données en clusters avec k-means en Python et en R ?
Un bon moyen d’explorer ce type de données est de les regrouper (on appelle ça faire des clusters). Les clusters montrent quels joueurs ont le plus de similarités.
Python :
from sklearn.cluster import KMeans

kmeans_model = KMeans(n_clusters=5, random_state=1)
good_columns = nba.select_dtypes("number").dropna(axis=1)

kmeans_model.fit(good_columns)
labels = kmeans_model.labels_R :
library(cluster)
set.seed(1)

isGoodCol <- function(col){
    sum(is.na(col)) == 0 && is.numeric(col)
}

goodCols <- sapply(nba, isGoodCol)
clusters <- kmeans(nba[,goodCols], centers=5)
labels <- clusters$clusterPour regrouper correctement, nous supprimons les colonnes non numériques ainsi que celles qui contiennent des valeurs manquantes (NA, NaN, etc.).
En R, nous faisons cela en appliquant une fonction à chaque colonne et en la supprimant si elle contient des valeurs manquantes ou n’est pas numérique. Nous utilisons ensuite la fonction kmeans, intégrée à R, pour trouver 5 clusters dans nos données (le package cluster nous servira plus loin pour le graphique).
Nous fixons la graine aléatoire avec set.seed pour que tu puisses reproduire les mêmes résultats de ton côté.
En Python, nous utilisons la principale bibliothèque de Machine Learning, scikit-learn, pour ajuster un modèle de clustering k-means et obtenir nos labels de clusters.
La préparation des données est très proche de celle faite en R, sauf que nous utilisons les méthodes select_dtypes et dropna pour supprimer les colonnes non numériques et les colonnes avec des valeurs manquantes.
Comment visualiser les clusters avec une PCA en Python et en R ?
Nous pouvons maintenant identifier les joueurs par groupe pour découvrir des tendances. Une façon d’y parvenir est d’utiliser d’abord l’analyse en composantes principales (PCA, Principal Component Analysis) pour passer à deux dimensions, puis de tracer les données en donnant à chaque point une couleur selon son groupe (ou cluster).
Python :
from sklearn.decomposition import PCA

pca_2 = PCA(2)
plot_columns = pca_2.fit_transform(good_columns)
plt.scatter(x=plot_columns[:,0], y=plot_columns[:,1], c=labels)
plt.show()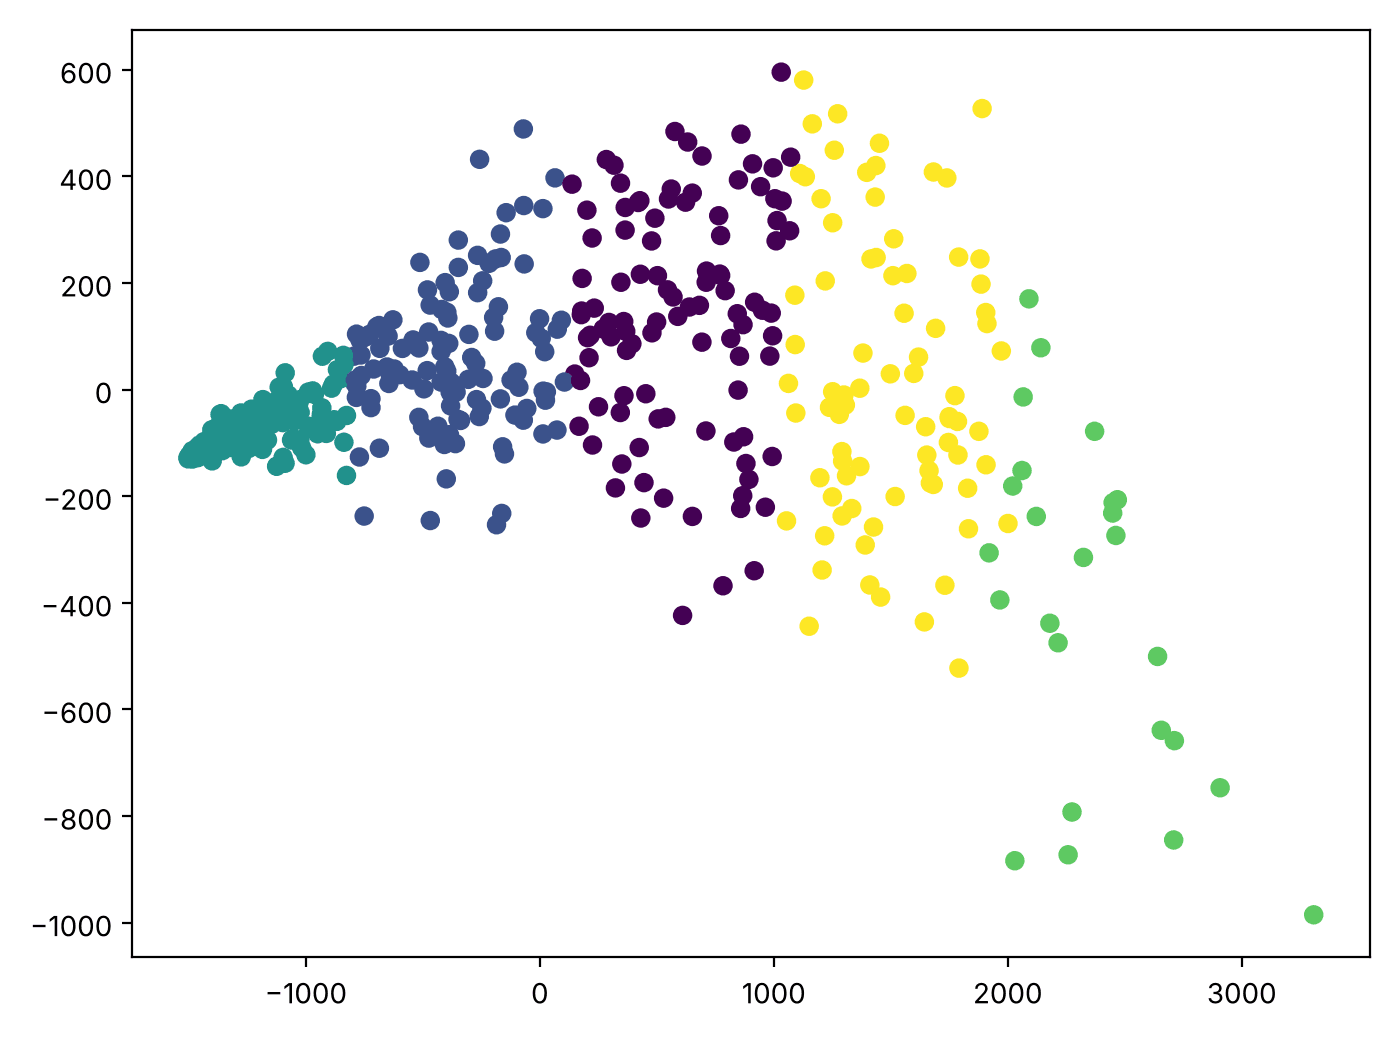
R :
nba2d <- prcomp(nba[,goodCols], center=TRUE)
twoColumns <- nba2d$x[,1:2]
clusplot(twoColumns, labels)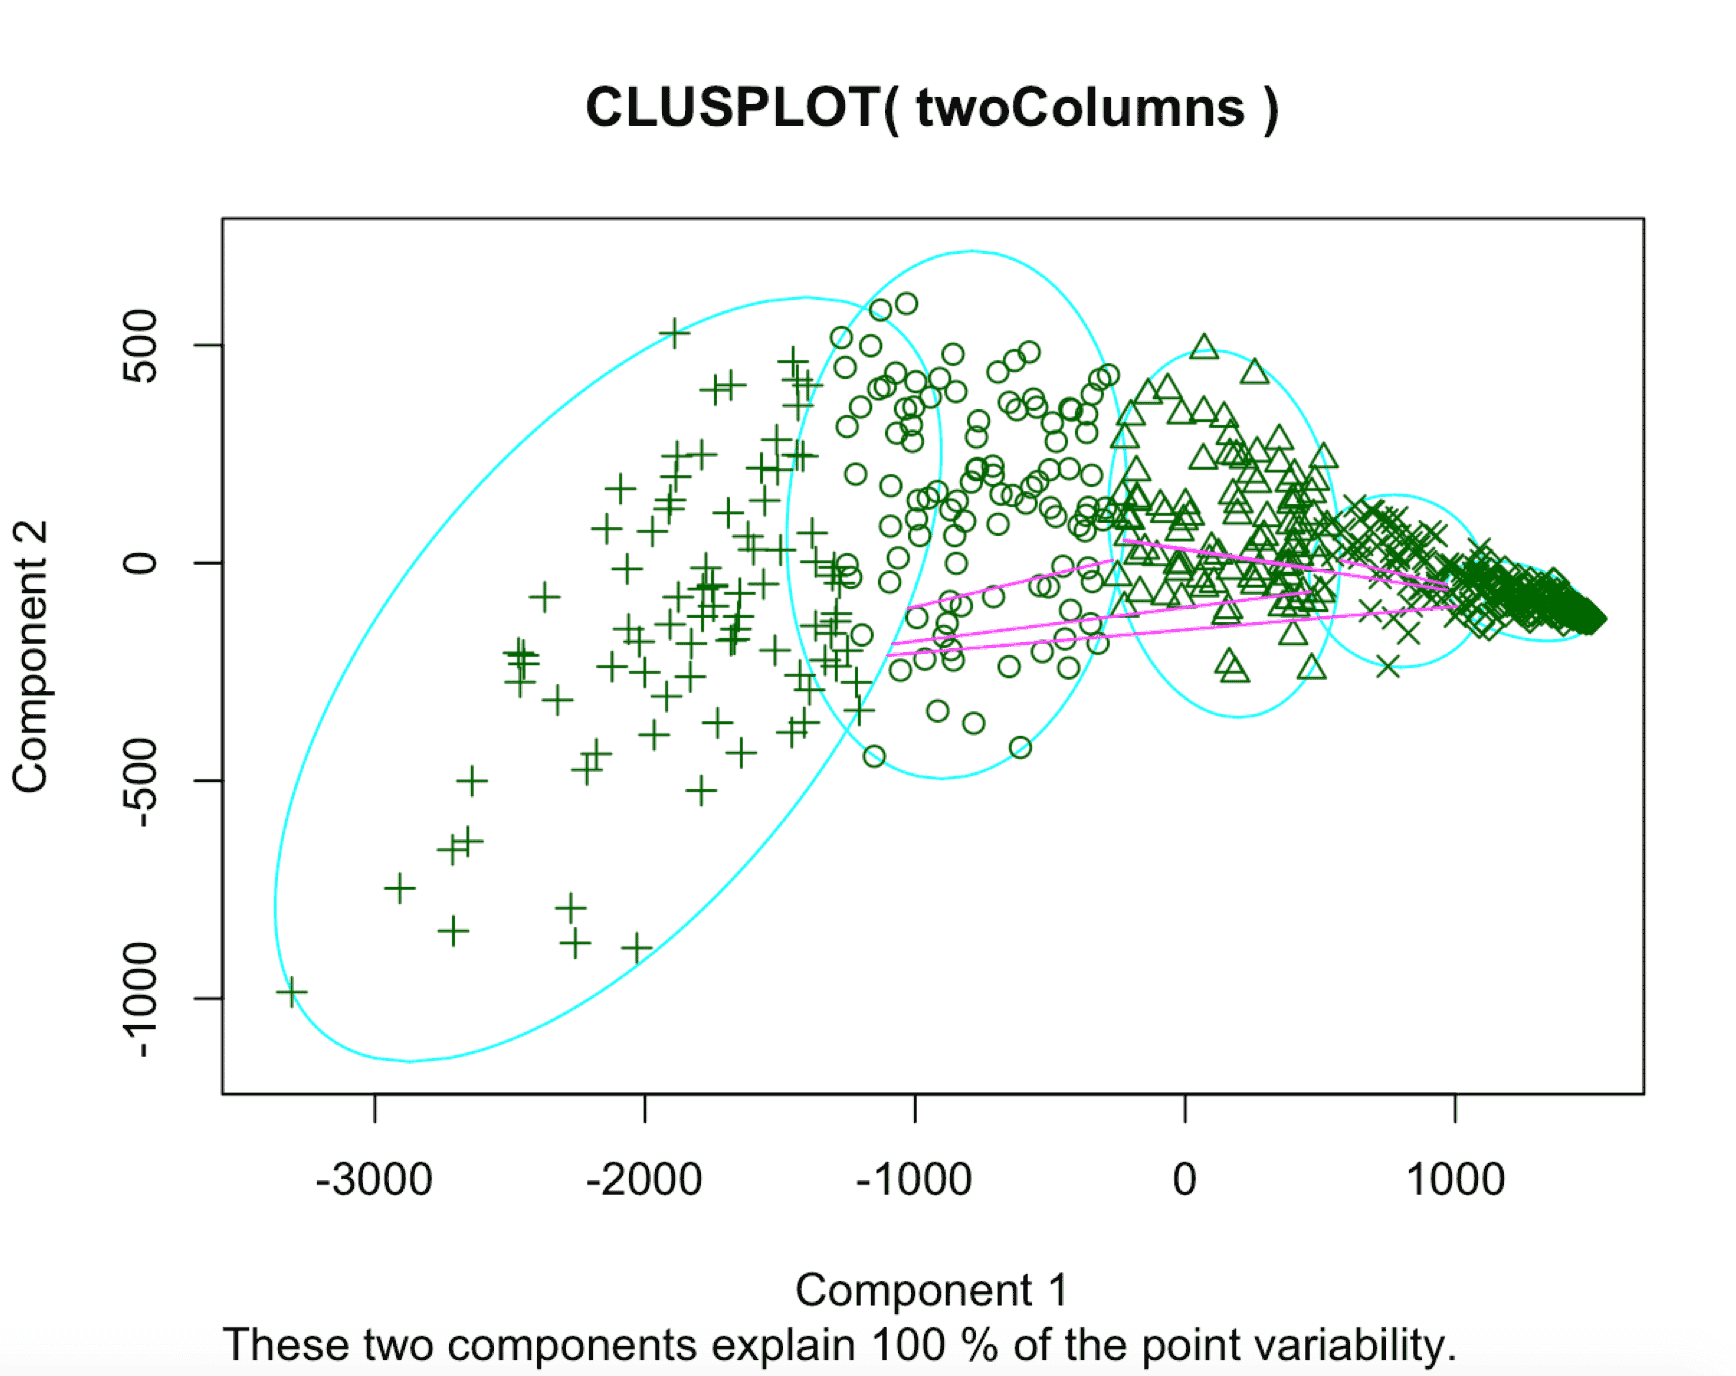
Nous avons donc tracé un nuage de points de nos données, dont la couleur dépend du cluster.
En R, nous avons utilisé la fonction clusplot, qui fait partie de la bibliothèque cluster. La PCA est réalisée avec la fonction prcomp, intégrée à R.
En Python, nous avons utilisé la classe PCA de scikit-learn, puis Matplotlib pour créer le graphique.
Comment séparer un dataset en jeu d’entraînement et jeu de test en Python et en R ?
Si nous voulons faire du Machine Learning supervisé, c’est une bonne idée de diviser les données en deux ensembles : un ensemble d’entraînement et un ensemble de test.
Python :
train = nba.sample(frac=0.8, random_state=1)
test = nba.loc[~nba.index.isin(train.index)]R :
trainRowCount <- floor(0.8 * nrow(nba))
set.seed(1)

trainIndex <- sample(1:nrow(nba), trainRowCount)

train <- nba[trainIndex,]
test <- nba[-trainIndex,]Tu remarqueras que R a beaucoup plus de fonctions intégrées (built-in) axées sur l’analyse de données, comme floor, sample et set.seed.
Ces mêmes fonctions sont appelées via des bibliothèques en Python (math.floor, random.sample, random.seed).
En Python, Pandas propose une méthode sample qui retourne un certain nombre de lignes tirées au hasard dans un DataFrame, ce qui rend le code beaucoup plus concis.
En R, il existe des packages pour simplifier l’échantillonnage, mais ils ne sont pas beaucoup plus concis que la fonction sample intégrée.
Dans les deux cas, j’ai fixé une graine aléatoire (random_state=1 en Python, set.seed(1) en R) pour rendre les résultats reproductibles chez toi. Les deux langages n’utilisent toutefois pas le même générateur aléatoire : les échantillons ne seront pas identiques.
Comment faire une régression linéaire en Python et en R ?
Disons que nous voulons prédire le nombre de passes décisives (ast) par joueur à partir du nombre de paniers marqués (fg).
Python :
from sklearn.linear_model import LinearRegression

lr = LinearRegression()
lr.fit(train[["fg"]], train["ast"])
predictions = lr.predict(test[["fg"]])R :
fit <- lm(ast ~ fg, data=train)
predictions <- predict(fit, test)scikit-learn a un modèle de régression linéaire, LinearRegression, que nous pouvons ajuster pour générer des prédictions.
R s’appuie sur les fonctions intégrées lm et predict. La fonction predict se comporte différemment selon le type de modèle qui lui est transmis : on peut l’utiliser avec une grande variété de modèles.
Comment obtenir les statistiques récapitulatives d’un modèle en Python et en R ?
Python :
import statsmodels.formula.api as sm

model = sm.ols(formula='ast ~ fg', data=train)
fitted = model.fit()
fitted.summary() OLS Regression Results
==============================================================================
Dep. Variable: ast R-squared: 0.512
Model: OLS Adj. R-squared: 0.511
Method: Least Squares F-statistic: 401.8
Date: Wed, 21 Oct 2026 Prob (F-statistic): 1.23e-61
Time: 08:02:00 Log-Likelihood: -2294.3
No. Observations: 385 AIC: 4593.
Df Residuals: 383 BIC: 4600.
Df Model: 1
Covariance Type: nonrobust
==============================================================================
coef std err t P>|t| [0.025 0.975]
------------------------------------------------------------------------------
Intercept 5.1571 7.154 0.721 0.471 -8.909 19.223
fg 0.5597 0.028 20.045 0.000 0.505 0.615
==============================================================================
Omnibus: 169.539 Durbin-Watson: 1.965
Prob(Omnibus): 0.000 Jarque-Bera (JB): 884.768
Skew: 1.836 Prob(JB): 7.50e-193
Kurtosis: 9.455 Cond. No. 383.
==============================================================================
Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.R :
summary(fit)Call:
lm(formula = ast ~ fg, data = train)
Residuals:
Min 1Q Median 3Q Max
-228.26 -35.38 -11.45 11.99 559.61
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 9.0585 7.1026 1.275 0.203
fg 0.5307 0.0274 19.368 <2e-16 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 92.89 on 382 degrees of freedom
Multiple R-squared: 0.4954, Adjusted R-squared: 0.4941
F-statistic: 375.1 on 1 and 382 DF, p-value: < 2.2e-16Si nous voulons obtenir des statistiques récapitulatives sur le modèle, comme le coefficient de détermination (R², r-squared), nous devons en faire un peu plus en Python qu’en R.
Avec R, nous pouvons utiliser la fonction intégrée summary pour obtenir des informations sur le modèle.
Avec Python, nous devons utiliser le package statsmodels, qui permet d’utiliser de nombreuses méthodes statistiques.
Nous obtenons des résultats similaires, bien qu’il soit généralement un peu plus difficile de faire de l’analyse statistique en Python, et que certaines méthodes statistiques de R n’existent pas en Python.
Comment ajuster une forêt aléatoire (Random Forest) en Python et en R ?
Notre régression linéaire a bien fonctionné avec une seule variable. Mais nous soupçonnons qu’il peut y avoir des non-linéarités dans les données.
Nous voulons donc ajuster un modèle de forêt aléatoire (Random Forest).
Python :
from sklearn.ensemble import RandomForestRegressor

predictor_columns = ["age", "mp", "fg", "trb", "stl", "blk"]
rf = RandomForestRegressor(n_estimators=100, min_samples_leaf=3, random_state=1)
rf.fit(train[predictor_columns], train["ast"])
predictions = rf.predict(test[predictor_columns])R :
library(randomForest)

predictorColumns <- c("age", "mp", "fg", "trb", "stl", "blk")
rf <- randomForest(train[predictorColumns], train$ast, ntree=100)
predictions <- predict(rf, test[predictorColumns])La principale différence ici est qu’il faut utiliser le package randomForest en R pour disposer de l’algorithme, alors qu’il est intégré à scikit-learn en Python.
scikit-learn dispose d’une interface unifiée pour de nombreux algorithmes de Machine Learning, et il n’y a généralement qu’une seule implémentation principale pour chaque algorithme.
En R, il existe de nombreux petits packages contenant des algorithmes individuels, souvent avec des moyens peu cohérents d’y accéder.
Cela se traduit par une plus grande diversité d’algorithmes, mais ils sont un peu plus compliqués à utiliser.
Comment calculer l’erreur d’un modèle (MSE) en Python et en R ?
Maintenant que nous avons ajusté deux modèles, calculons l’erreur moyenne. Nous allons utiliser le MSE (Mean Squared Error, erreur quadratique moyenne).
Python :
from sklearn.metrics import mean_squared_error

mean_squared_error(test["ast"], predictions)4890.926288389911R :
mean((test$ast - predictions)^2)4573.86778567462En Python, scikit-learn dispose de diverses mesures d’erreur que nous pouvons utiliser, comme mean_squared_error.
En R, il existe probablement quelques petites bibliothèques qui calculent le MSE, mais le faire manuellement est assez facile dans les deux langages.
La différence entre les erreurs (environ 4 891 en Python contre 4 574 en R) est presque certainement due aux paramètres des modèles et à l’échantillonnage aléatoire : Python et R ne tirent pas les mêmes joueurs pour l’entraînement et le test. Rien de bien méchant.
Comment télécharger une page Web en Python et en R ?
Maintenant que nous avons des données sur les joueurs de la NBA de la saison 2013-2014, nous allons les compléter avec des données supplémentaires : le score d’un match de la finale NBA 2015 (Cleveland – Golden State).
Remarque : la structure de cette page a pu évoluer depuis la rédaction de l’article, et le site limite les requêtes automatiques. Les codes ci-dessous illustrent la démarche, mais peuvent nécessiter une adaptation.
Python :
import requests

url = "https://www.basketball-reference.com/boxscores/201506140GSW.html"
data = requests.get(url).contentR :
library(RCurl)

url <- "https://www.basketball-reference.com/boxscores/201506140GSW.html"
data <- readLines(url)En Python, la bibliothèque requests facilite le téléchargement de pages Web, avec une API cohérente pour tous les types de requêtes.
En R, RCurl fournit un outil similaire, tout aussi simple. Les deux téléchargent la page Web dans une chaîne de caractères (string).
Comment extraire des données d’une page Web en Python et en R ?
Maintenant que nous avons la page Web, nous devons l’analyser pour extraire les scores des joueurs.
Python :
from bs4 import BeautifulSoup
import re

soup = BeautifulSoup(data, "html.parser")
box_scores = []

for table in soup.find_all(id=re.compile("[A-Z]{3,}_basic")):
    rows = []
    for i, row in enumerate(table.find_all("tr")):
        if i == 0:
            continue
        elif i == 1:
            cell_tag = "th"
        else:
            cell_tag = "td"
        row_data = [item.get_text() for item in row.find_all(cell_tag)]
        rows.append(row_data)
box_scores.append(rows)R :
library(rvest)

page <- read_html(url)
table <- html_nodes(page, ".stats_table")[3]
rows <- html_nodes(table, "tr")
cells <- html_nodes(rows, "td a")
teams <- html_text(cells)

extractRow <- function(rows, i){
    if(i == 1){
        return(NULL)
    }
    row <- rows[i]
    tag <- "td"
    if(i == 2){
        tag <- "th"
    }
    items <- html_nodes(row, tag)
    html_text(items)
}

scrapeData <- function(team){
    teamData <- html_nodes(page, paste("#", team, "_basic", sep=""))
    rows <- html_nodes(teamData, "tr")
    lapply(seq_along(rows), extractRow, rows=rows)
}

data <- lapply(teams, scrapeData)Cela crée une liste contenant deux listes : la première avec le score de CLE (Cleveland Cavaliers) et la seconde avec celui de GSW (Golden State Warriors). Les deux contiennent les en-têtes ainsi que les statistiques de chaque joueur dans le match.
Nous ne transformerons pas ces données en données d’entraînement, mais il serait facile de les transformer pour les ajouter à notre variable nba.
Le code R est plus complexe que le code Python, car il n’existe pas de moyen pratique d’utiliser des expressions régulières pour sélectionner des éléments. Nous devons donc faire une analyse supplémentaire pour obtenir les noms d’équipe à partir du code HTML.
R encourage aussi à appliquer des fonctions à des vecteurs plutôt qu’à écrire des boucles for. Nous utilisons lapply pour cela, mais comme chaque ligne doit être traitée différemment selon qu’il s’agit d’un en-tête ou non, nous transmettons à la fonction l’index de l’élément voulu et la liste de toutes les lignes.
Nous utilisons rvest, un package de Web Scraping très utilisé en R, pour extraire les données dont nous avons besoin. Note que nous pouvons passer une URL directement à rvest : l’étape précédente avec RCurl n’était donc pas nécessaire en R.
En Python, nous utilisons BeautifulSoup, la bibliothèque de Web Scraping la plus utilisée. Elle permet de parcourir les balises HTML et de construire simplement une liste de listes.
Python ou R : quel est le verdict ?
Nous avons vu comment analyser un ensemble de données avec R et Python. Il reste de nombreux sujets que nous n’avons pas approfondis : la fiabilité des résultats de l’analyse, le partage de ces résultats, les tests, la préparation à la production et la création de visualisations supplémentaires. Ils permettraient de tirer des conclusions plus définitives.
Pour l’instant, voici ce que nous pouvons dire :
R est plus fonctionnel, Python est plus orienté objet.
Comme nous l’avons vu avec des fonctions telles que lm et predict, R fait la plupart du travail avec ses fonctions intégrées. Cela contraste avec la classe LinearRegression de Python et la méthode sample des DataFrames.
R a plus de fonctions intégrées pour analyser des données, Python s’appuie sur des bibliothèques.
En ce qui concerne les statistiques, nous pouvons utiliser la fonction intégrée summary de R, alors qu’il a fallu importer la bibliothèque statsmodels en Python.
De même, la structure de DataFrame (tableau) est intégrée à R, alors qu’elle doit être importée via la bibliothèque Pandas en Python.
Python a des packages “principaux” pour les tâches d’analyse de données, R a un plus grand écosystème de petits packages.
Avec Python, nous pouvons faire une régression linéaire, des forêts aléatoires et bien plus encore avec scikit-learn, qui offre une API stable et maintenue à jour.
En R, nous avons une plus grande diversité de packages, mais aussi plus de fragmentation et moins de cohérence (la régression linéaire est une fonction intégrée, lm, alors que randomForest est un package séparé, etc.).
R est meilleur pour les statistiques de façon générale.
R a été construit comme un langage statistique, et cela se voit. statsmodels et d’autres bibliothèques Python offrent une couverture satisfaisante des méthodes statistiques, mais l’écosystème R est beaucoup plus large.
Il est généralement plus simple de faire des tâches non statistiques en Python.
Avec des bibliothèques bien maintenues comme BeautifulSoup et requests, le Web Scraping en Python est beaucoup plus facile qu’en R. Cela s’applique aussi aux tâches que nous n’avons pas examinées de près, comme sauvegarder des données dans des bases de données, déployer des serveurs web ou exécuter des workflows complexes.
Il existe tout de même de nombreux parallèles dans le workflow d’analyse de données des deux langages.
Il y a des points d’inspiration clairs entre R et Python : les DataFrames de Pandas ont été inspirés par ceux de R, et le package rvest a été inspiré par BeautifulSoup. De plus, les deux écosystèmes continuent de se renforcer.
Il est remarquable de constater à quel point la syntaxe et les approches sont similaires pour de nombreuses tâches courantes dans les deux langages.
Même si je pense que Python s’en sort mieux dans un plus grand nombre de domaines, R est un langage efficace. Il peut être utilisé comme complément de Python (exploration de données, statistiques), voire comme ton seul outil d’analyse de données.
Comme le montre cette comparaison, les deux langages ont beaucoup de similitudes dans la syntaxe et l’approche. Garde en tête que tu ne peux pas te tromper en apprenant l’un ou l’autre (ou les deux).
Si tu choisis Python, le parcours Python de DataXp te fait pratiquer sur des exercices corrigés, avec un coach IA qui t’aide quand tu bloques. Les premiers modules sont gratuits.
Questions fréquentes sur Python vs R
Python ou R : lequel choisir pour l’analyse de données ?
Les deux sont de bons choix. R est meilleur pour les statistiques, avec un écosystème de packages très large. Python est généralement plus simple pour les tâches non statistiques (Web Scraping, bases de données, serveurs web, workflows complexes) et offre une API stable et cohérente avec scikit-learn. Tu ne peux pas te tromper en apprenant l’un ou l’autre, ou les deux.
Quelle est la différence principale entre Python et R ?
R est plus fonctionnel et intègre beaucoup de fonctions d’analyse (lm, predict, summary, la structure de tableau). Python est plus orienté objet et passe par des bibliothèques : Pandas pour les DataFrame, scikit-learn pour le Machine Learning, statsmodels pour les statistiques.
Quelles sont les équivalences entre Python et R pour manipuler un tableau ?
Un DataFrame Pandas correspond au data.frame de R. nba.shape correspond à dim(nba), nba.head() à head(nba), et mean() avec numeric_only=True en Python à mean(na.rm = TRUE) appliqué colonne par colonne en R.
Pourquoi Python est-il considéré comme plus cohérent en Machine Learning ?
scikit-learn propose une interface unifiée pour de nombreux algorithmes (régression linéaire, forêt aléatoire, k-means, PCA), avec généralement une seule implémentation principale par algorithme. En R, les algorithmes sont répartis dans de nombreux petits packages (lm intégré, randomForest séparé), avec des interfaces moins homogènes.
Peut-on utiliser Python et R ensemble ?
Oui. R peut servir de complément à Python (exploration de données, statistiques) ou être ton seul outil d’analyse. Les deux écosystèmes s’inspirent l’un de l’autre : les DataFrames de Pandas ont été inspirés par ceux de R, et le package rvest par BeautifulSoup.
Pour aller plus loin avec Python, consulte aussi notre guide des 21 astuces et concepts Python pour améliorer ton code.
Beau travail !
Shïtõ 3 ⛩