Dans cet article, nous allons faire une analyse de données sur le Covid-19 avec Python, NumPy et Pandas, à partir des statistiques de tous les pays touchés. Nous préparerons d’abord les données avec Pandas (les « dépivoter », les regrouper, les trier), puis nous les visualiserons avec Matplotlib et Folium : diagrammes à barres, camemberts, courbes et carte du monde.
Mise à jour (octobre 2026) : cet article date de 2020 et les données s’arrêtent au 14 juin 2020. Le jeu de données source, compilé par l’université Johns Hopkins, n’est plus alimenté depuis le 10 mars 2023, mais il reste un excellent terrain d’entraînement pour Pandas. J’ai testé tout le code avec Pandas 3 et recalculé les résultats et les graphiques.
En bref : pour analyser les données du Covid-19 avec Python, charge les fichiers de séries temporelles de l’université Johns Hopkins (un fichier pour les cas confirmés, un pour les décès) dans des DataFrames Pandas. Transforme les colonnes de dates en une seule colonne avec melt(), regroupe les chiffres par date et par pays avec groupby(), puis trace des diagrammes avec Matplotlib et une carte avec Folium. Au 14 juin 2020, date de nos données, les États-Unis comptent 2 094 058 cas confirmés et 115 732 décès, devant le Brésil (867 624 cas confirmés).
Tu peux exécuter tout le code de cet article dans ce notebook Google Colab.
Quelles données utiliser pour analyser le Covid-19 ?
Le jeu de données a été compilé par le centre CSSE de l’université Johns Hopkins, à partir des chiffres officiels de chaque pays. Il est disponible sur Kaggle et dans le dépôt GitHub de l’université (licence CC BY 4.0).
Dans la version du 14 juin 2020, cet ensemble de données est composé de plusieurs fichiers :
covid_19_data.csv– contient une liste d’observations pour tous les différents États/provinces de chaque pays. Il contient des observations pour les cas confirmés, les décès et les cas de rétablissement.COVID19_line_list_data.csv– contient une liste détaillée de cas avec des détails tels que le lieu, les symptômes, les visites à l’hôpital, ainsi que la source d’information, etc.COVID19_open_line_list.csv– similaire au fichier précédent (COVID19_line_list_data.csv).time_series_covid_19_confirmed_US.csv– Une ventilation détaillée de tous les cas confirmés aux États-Unis. Contient des détails tels que le lieu, la ville et l’État.time_series_covid_19_deaths_US.csv– Une ventilation détaillée de tous les cas de décès aux États-Unis. Contient des détails tels que le lieu, la ville et l’État.time_series_covid_19_confirmed.csv– Contient la liste de tous les cas confirmés pour tous les pays du monde. Il énumère les provinces/états pour chaque pays, ainsi que la géolocalisation de chaque lieu.time_series_covid_19_deaths.csv– Contient la liste de tous les cas de décès pour tous les pays du monde. Il énumère les provinces/états pour chaque pays, ainsi que la géolocalisation de chaque lieu.time_series_covid_19_recovered.csv– Contient la liste de tous les cas de rétablissement pour tous les pays du monde. Il énumère les provinces/états pour chaque pays, ainsi que la géolocalisation de chaque lieu.
Ici, nous allons explorer les statistiques de chaque pays touché par le Covid-19. Nous nous concentrons donc sur ces trois fichiers CSV :
time_series_covid_19_confirmed.csvtime_series_covid_19_deaths.csvtime_series_covid_19_recovered.csv
J’aurais aussi pu utiliser le fichier covid_19_data.csv, qui regroupe dans un seul fichier les cas confirmés, les décès et les cas de rétablissement. Malheureusement, il ne contient pas la latitude et la longitude de chaque lieu, dont nous avons besoin pour tracer la carte. J’ai donc préféré utiliser les trois fichiers séparés.
Ces trois fichiers sont petits (environ 100 Ko chacun). Je les ai enregistrés, tels qu’ils étaient le 14 juin 2020, dans un dossier GitHub, sous les mêmes noms que sur Kaggle : le code ci-dessous les lit directement, sans rien télécharger. Données : © université Johns Hopkins, licence CC BY 4.0.
Avant de continuer, ouvre ces fichiers CSV avec un tableur et explore leurs colonnes.
Comment analyser les données du Covid-19 avec Pandas ?
Importation des bibliothèques
La première étape de tout projet d’analyse de données consiste à importer les bibliothèques nécessaires. Pandas sert à manipuler les données ; NumPy nous servira plus loin pour dimensionner les cercles de la carte :
import pandas as pd
import numpy as npLecture des données
Les fichiers sont ceux du 14 juin 2020 : si tu télécharges une version plus récente du jeu de données, tes résultats seront différents des miens.
Chargeons dès maintenant les fichiers CSV dans des DataFrames Pandas :
dataset_url = "https://raw.githubusercontent.com/moncoachdata/blog-data-science/main/analyse-de-donnees-sur-le-covid-19/"

df_conf      = pd.read_csv(dataset_url + "time_series_covid_19_confirmed.csv")
df_death     = pd.read_csv(dataset_url + "time_series_covid_19_deaths.csv")
df_recovered = pd.read_csv(dataset_url + "time_series_covid_19_recovered.csv")

print(df_conf.shape)
print(df_death.shape)
print(df_recovered.shape)(266, 149)
(266, 149)
(253, 149)Chaque fichier contient 149 colonnes : quatre colonnes d’informations (Province/State, Country/Region, Lat et Long) et une colonne par jour, du 22 janvier au 14 juin 2020. Le DataFrame df_recovered n’a pas la même forme que les deux autres : il a moins de lignes. Cherchons pourquoi.
Commençons par afficher df_conf :
df_conf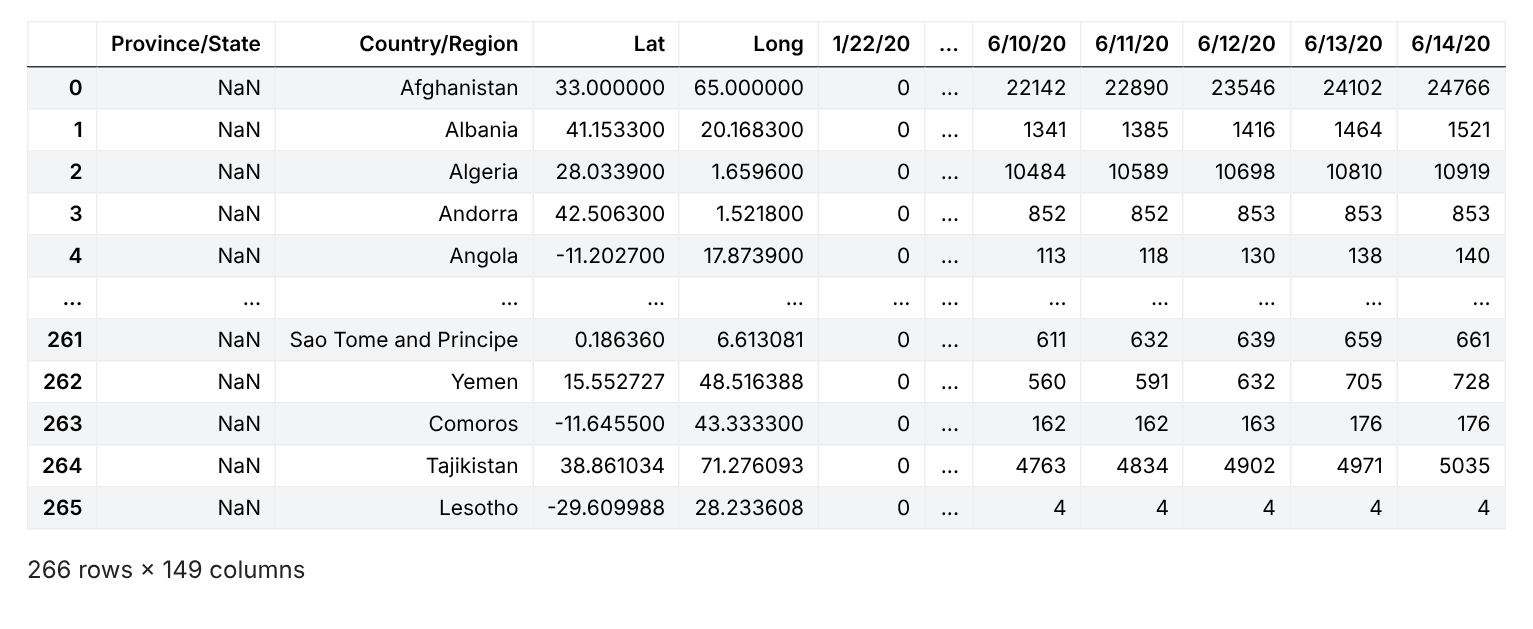
Tri et observation des DataFrames
Trions maintenant les DataFrames par Province/State et Country/Region :
df_conf = df_conf.sort_values(
    by=['Province/State','Country/Region'])
df_conf = df_conf.reset_index(drop=True)

df_death = df_death.sort_values(
    by=['Province/State','Country/Region'])
df_death = df_death.reset_index(drop=True)

df_recovered = df_recovered.sort_values(
    by=['Province/State','Country/Region'])
df_recovered = df_recovered.reset_index(drop=True)Vérifions le résultat :
df_conf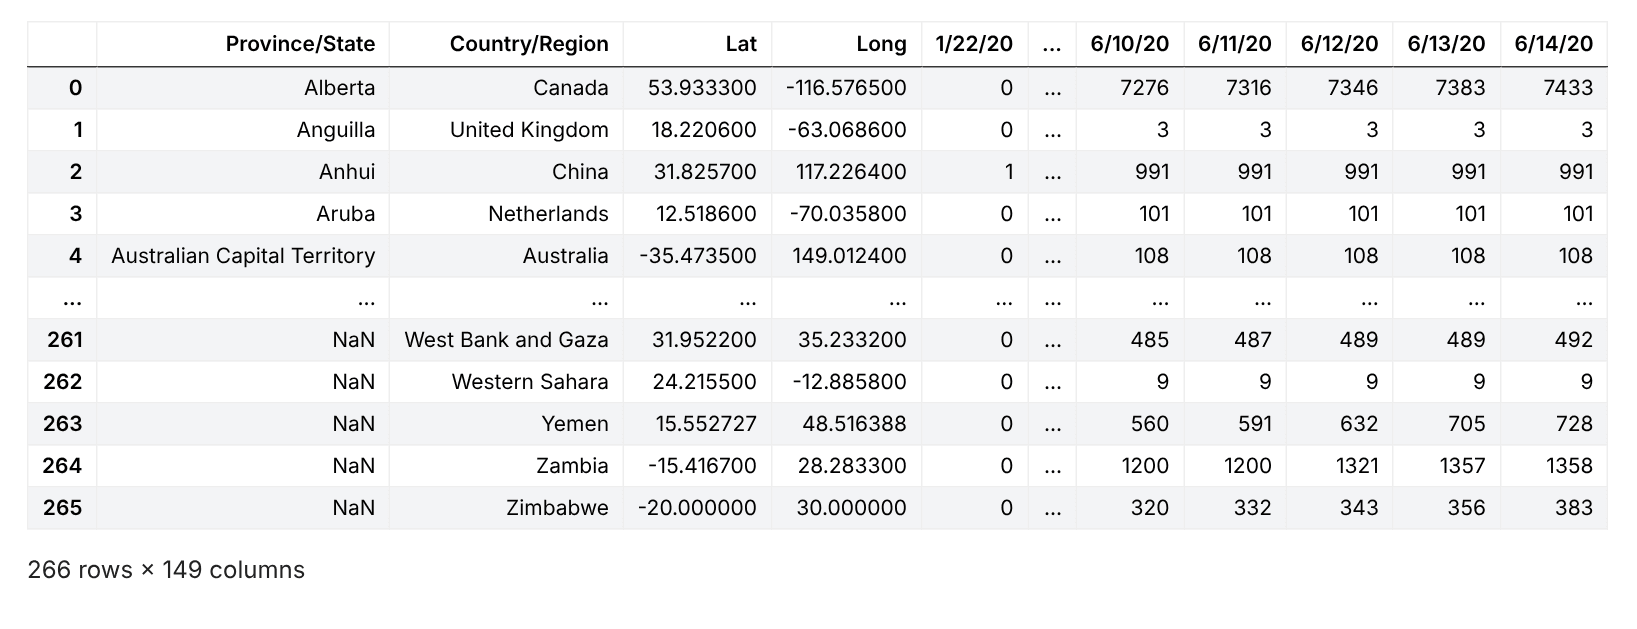
Les deux autres DataFrames (df_death et df_recovered) sont similaires. Remarque : les dates des cas signalés sont stockées dans des colonnes. À partir de la cinquième colonne (index 4), chaque colonne correspond à un jour (1/22/20, 1/23/20, etc.) et contient le nombre de cas signalés à cette date.
Pour l’analyse, nous allons devoir regrouper toutes ces dates dans une seule colonne, et placer les chiffres correspondants dans une autre colonne. Mais avant cela, comparons les trois DataFrames pour voir s’ils contiennent les mêmes lignes :
# Vérifie si des colonnes de 2 dataframes sont les mêmes
print(df_conf[["Province/State","Country/Region"]].equals(
df_death[["Province/State","Country/Region"]]))Trueprint(df_conf[["Province/State","Country/Region"]].equals(
df_recovered[["Province/State","Country/Region"]]))FalseComme tu peux le voir, df_conf et df_death contiennent les mêmes valeurs dans les colonnes Province/State et Country/Region, contrairement à df_recovered.
La raison : le fichier time_series_covid_19_recovered.csv enregistre le Canada comme un seul pays, alors que les deux autres fichiers le découpent par province. Vérifions-le :
print(df_conf.loc[df_conf["Country/Region"] == "Canada", "Province/State"].tolist())
print(df_recovered.loc[df_recovered["Country/Region"] == "Canada", "Province/State"].tolist())['Alberta', 'British Columbia', 'Diamond Princess', 'Grand Princess', 'Manitoba', 'New Brunswick', 'Newfoundland and Labrador', 'Northwest Territories', 'Nova Scotia', 'Ontario', 'Prince Edward Island', 'Quebec', 'Saskatchewan', 'Yukon']
[nan]Le Canada occupe 14 lignes dans df_conf (une par province, plus les deux paquebots), mais une seule dans df_recovered (province vide) : c’est la différence de 13 lignes entre 266 et 253.
Pour cette raison, et pour garder cet article simple, nous laissons de côté les cas de rétablissement (time_series_covid_19_recovered.csv).
Extraire les noms des colonnes contenant des dates
Nous allons maintenant extraire les différentes dates qui sont enregistrées dans les fichiers CSV :
dates_conf = df_conf.columns[4:]
dates_death = df_death.columns[4:]
print(dates_conf)
print(dates_death)

# s'assurer que les dates sont les mêmes pour les 2 DataFrames
if dates_conf.equals(dates_death):
print("Les dates sont les mêmes")On obtient en sortie le résultat suivant (145 jours, du 22 janvier au 14 juin 2020) :
Index(['1/22/20', '1/23/20', '1/24/20', '1/25/20', '1/26/20', '1/27/20',
       '1/28/20', '1/29/20', '1/30/20', '1/31/20',
       ...
       '6/5/20', '6/6/20', '6/7/20', '6/8/20', '6/9/20', '6/10/20', '6/11/20',
       '6/12/20', '6/13/20', '6/14/20'],
      dtype='str', length=145)
Index(['1/22/20', '1/23/20', '1/24/20', '1/25/20', '1/26/20', '1/27/20',
       '1/28/20', '1/29/20', '1/30/20', '1/31/20',
       ...
       '6/5/20', '6/6/20', '6/7/20', '6/8/20', '6/9/20', '6/10/20', '6/11/20',
       '6/12/20', '6/13/20', '6/14/20'],
      dtype='str', length=145)
Les dates sont les mêmesAfficher nos DataFrames dans un format contenant une colonne pour les dates, une pour les cas confirmés et une autre pour les décès
Nous voulons maintenant « dépivoter » (unpivot) les DataFrames : au lieu d’avoir une colonne par date, les dates seront stockées comme valeurs dans une nouvelle colonne Date.
Le nombre de cas sera enregistré dans les colonnes Confirmed et Deaths. Pour cela, nous utilisons la méthode melt() :
df_conf_melted = df_conf.melt(id_vars=['Province/State',
                              'Country/Region', 'Lat', 'Long'],
                              value_vars=dates_conf,
                              var_name='Date',
                              value_name='Confirmed')

df_death_melted = df_death.melt(id_vars=['Province/State',
                                'Country/Region', 'Lat', 'Long'],
                                value_vars=dates_death,
                                var_name='Date',
value_name='Deaths')Voir les DataFrames résultants
Voici les DataFrames une fois « dépivotés ».
Commençons par df_conf_melted :
df_conf_melted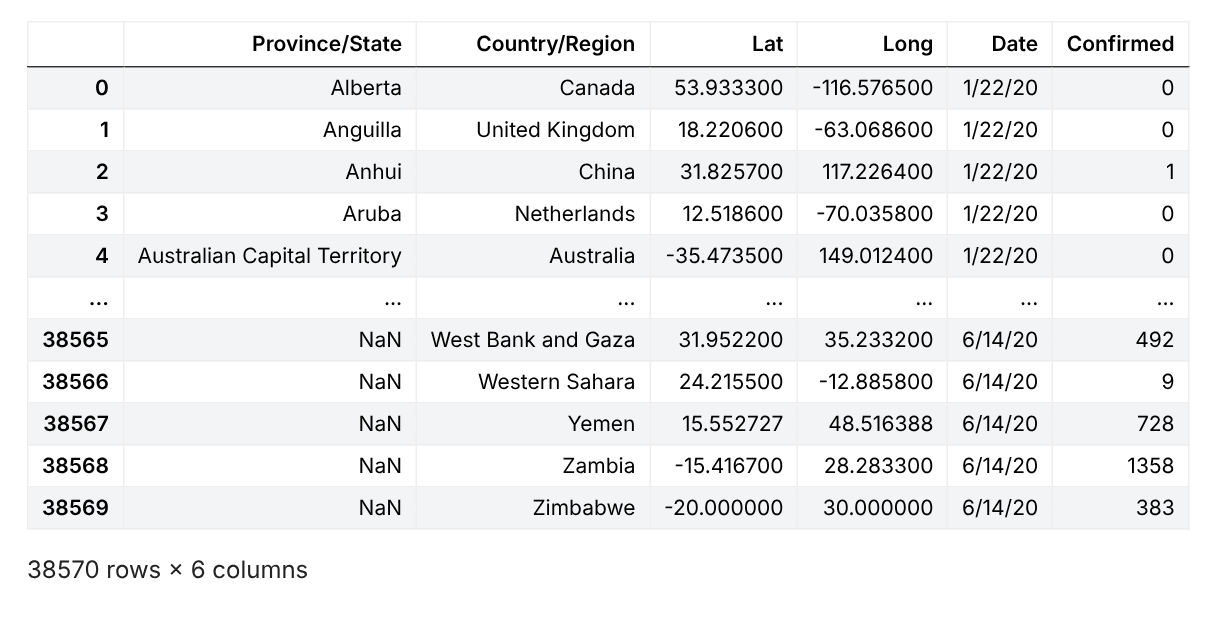
Regardons aussi le DataFrame df_death_melted :
df_death_melted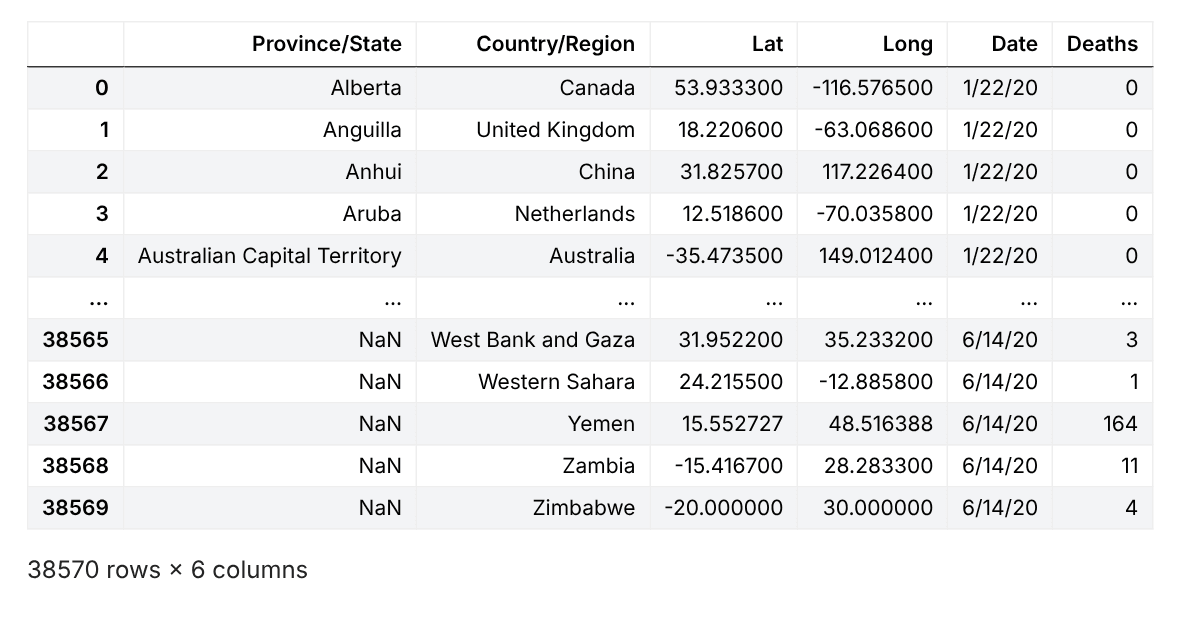
Vérifions que les deux DataFrames ont la même forme (266 pays/provinces × 145 dates = 38 570 lignes) :
print(df_conf_melted.shape)
print(df_death_melted.shape)(38570, 6)
(38570, 6)Combiner les 2 DataFrames résultants en un seul
Combinons maintenant ces deux DataFrames en un seul, pour faciliter les analyses suivantes :
df_combined = pd.concat([df_conf_melted,
                         df_death_melted["Deaths"]],
                         axis = 1,
                         sort = False)

df_combined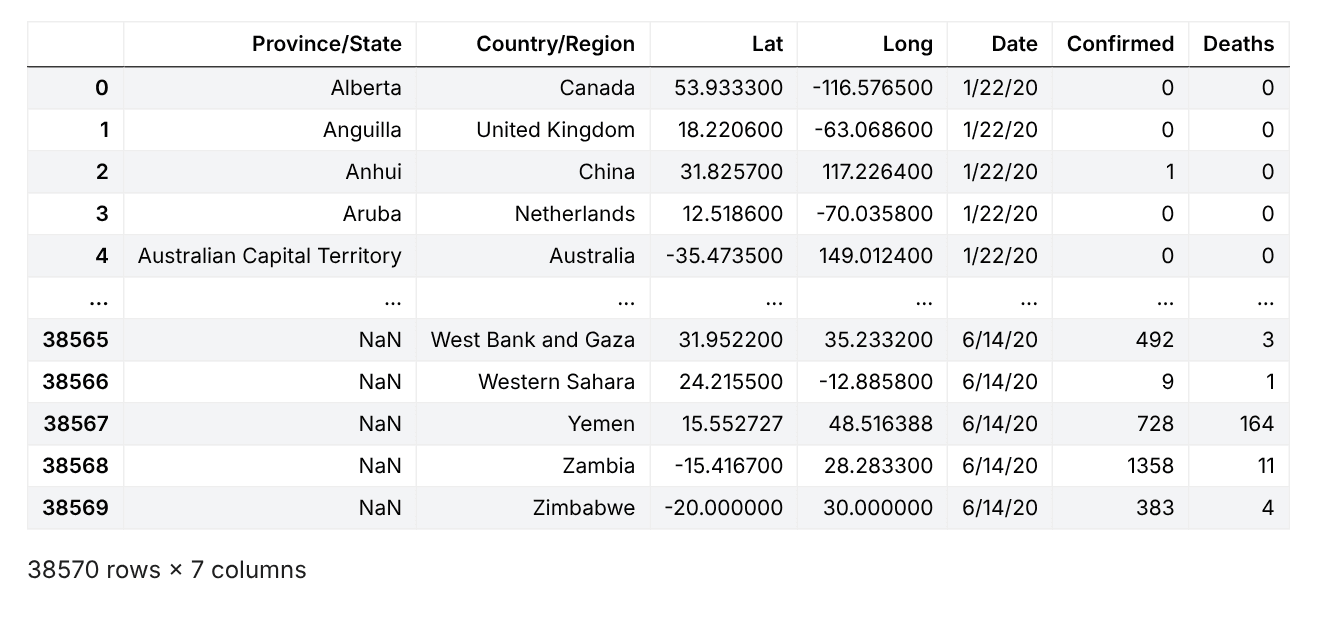
Calculons aussi le pourcentage de décès par rapport au nombre de cas confirmés (c’est en réalité un ratio entre 0 et 1, non multiplié par 100) :
df_combined["Percentage"] = df_combined["Deaths"] / df_combined["Confirmed"]

df_combined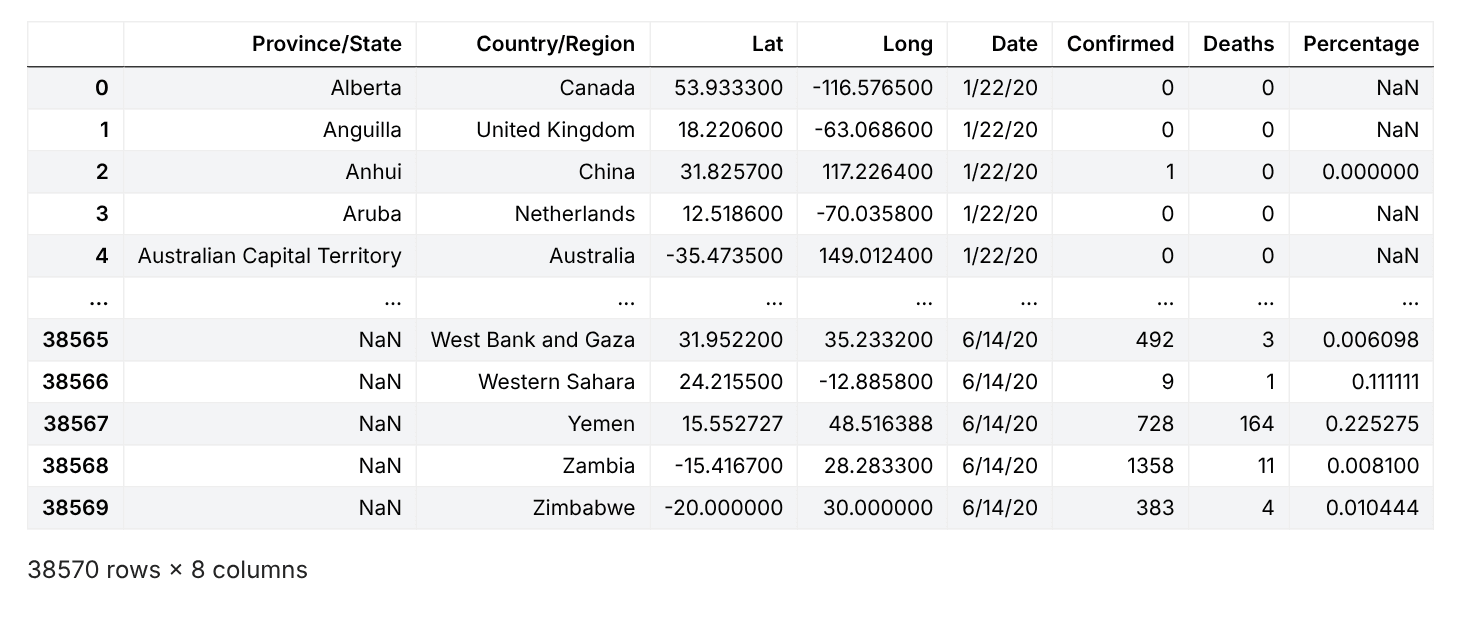
Certaines cellules de la colonne Percentage contiennent des NaN, causés par la division de 0 par 0 (aucun cas confirmé, donc aucun décès). Nous les remplaçons par 0 :
df_combined["Percentage"] = df_combined["Percentage"].fillna(0)

df_combined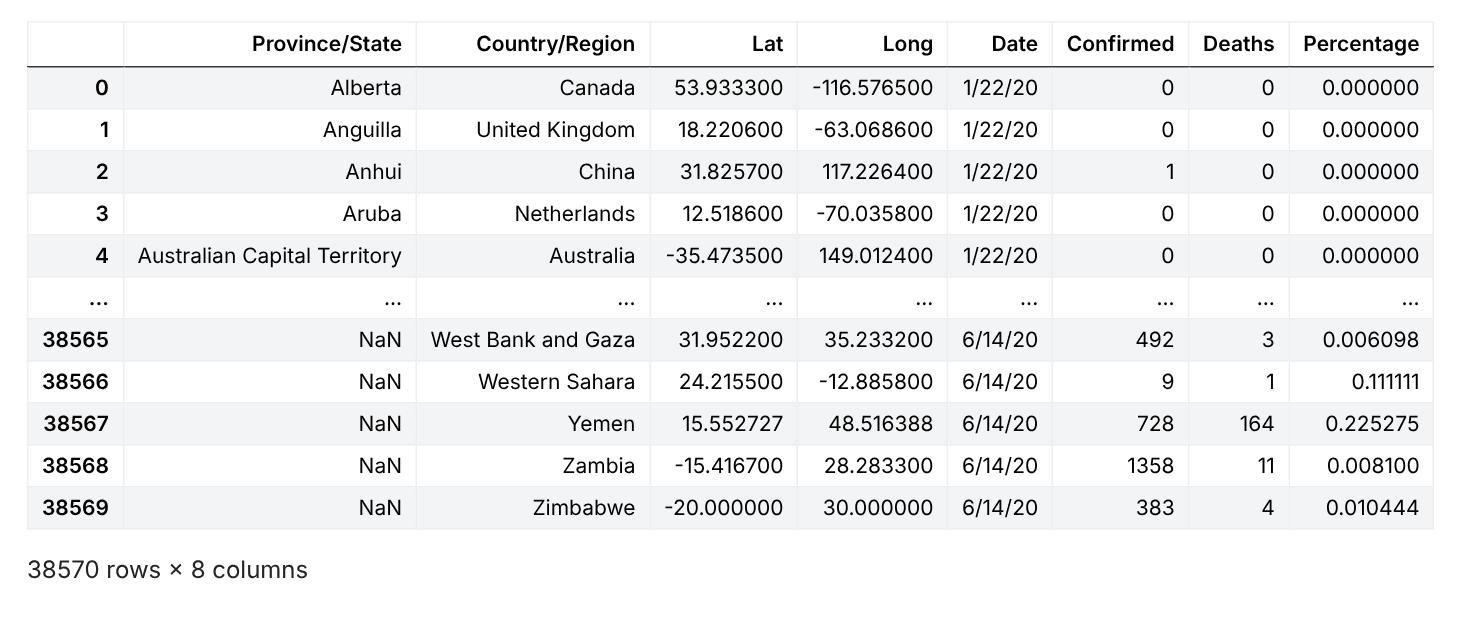
Vérifions les types de données des colonnes du DataFrame :
df_combined.dtypesProvince/State str
Country/Region str
Lat float64
Long float64
Date str
Confirmed int64
Deaths int64
Percentage float64
dtype: objectLa colonne Date est de type str, c’est-à-dire du texte (avant Pandas 3, ce type s’affichait object).
Convertir la colonne Date en format datetime
Nous devons convertir la colonne Date en un format datetime.date afin de pouvoir effectuer plus tard un tri basé sur les dates :
import datetime

def format_time(datetime_str):
    d = datetime.datetime.strptime(datetime_str, '%m/%d/%y')
    return d.date()

df_combined["Date"] = df_combined["Date"].apply(format_time)

df_combined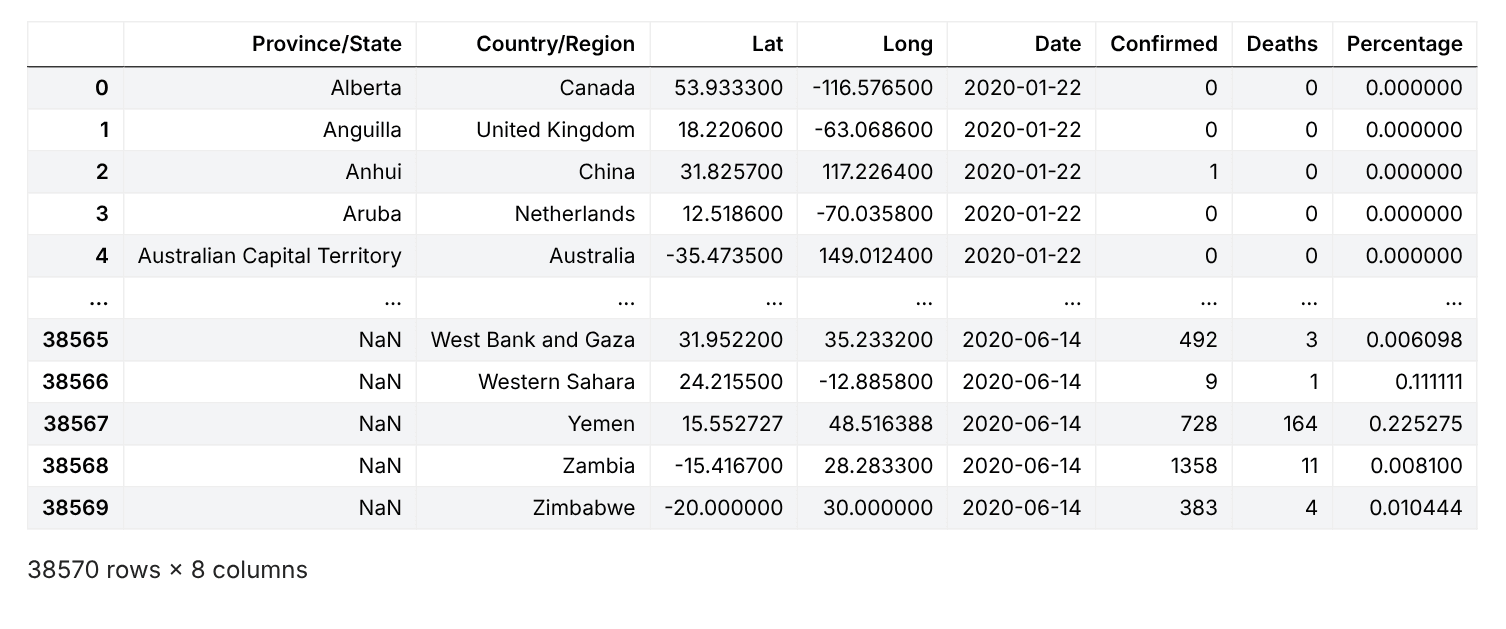
Afficher le nombre quotidien de cas confirmés et de décès
Maintenant que les données sont combinées et nettoyées, nous pouvons commencer à les analyser pour en tirer des informations utiles.
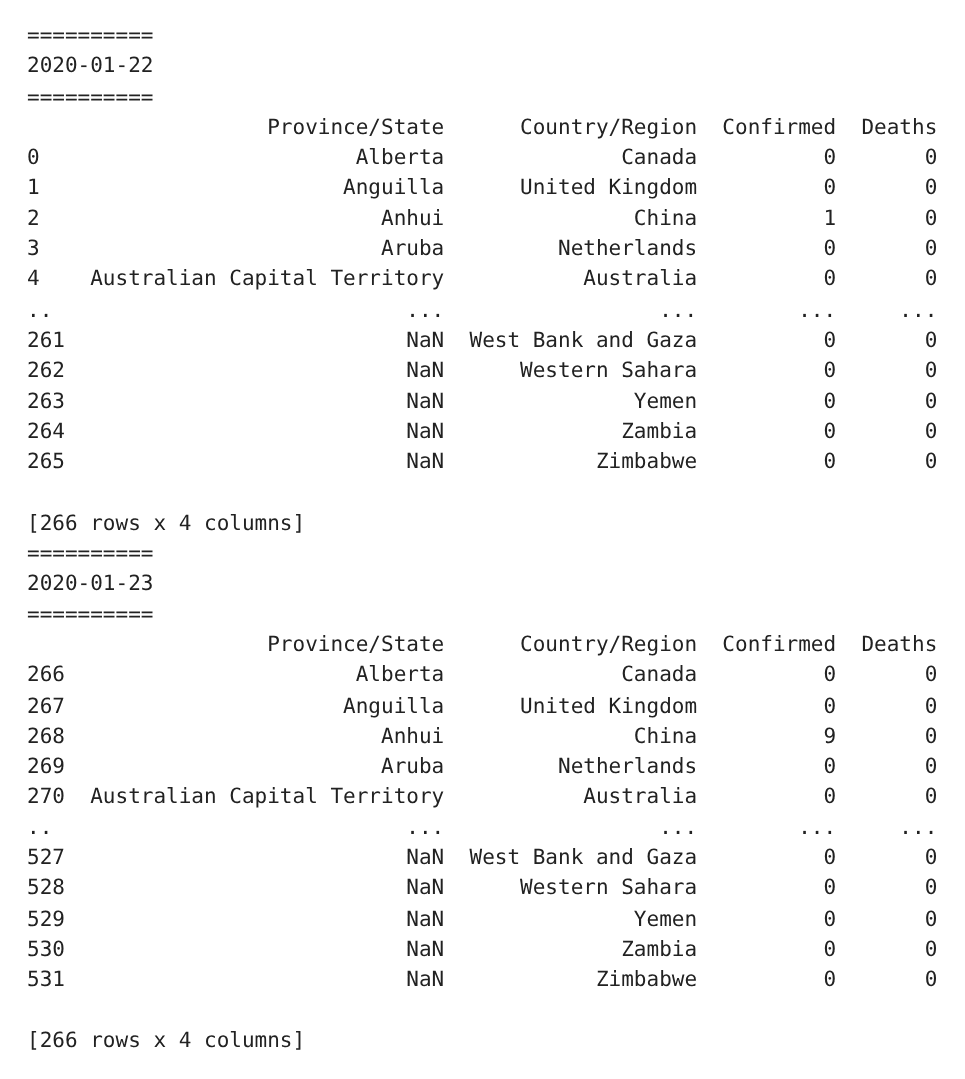
Commençons par afficher le nombre quotidien de cas confirmés et de décès :
grouped_by_date = df_combined.groupby("Date")

for date, group in grouped_by_date:
    print("==========")
    print(date)
    print("==========")
    print(group[["Province/State","Country/Region", "Confirmed",
"Deaths"]])On voit alors le nombre de cas confirmés et de décès pour chaque jour (ci-dessous, le début de la sortie : le premier jour et le début du second) :
Afficher le nombre total quotidien de cas confirmés et de décès pour chaque pays
Le résultat précédent détaille chaque province/état de chaque pays. Pour obtenir le total par pays, on effectue une agrégation avec groupby() et aggregate() :
df_daily = df_combined.groupby(["Date","Country/Region"]).aggregate(
    {'Confirmed': 'sum', 'Deaths': 'sum'})

df_daily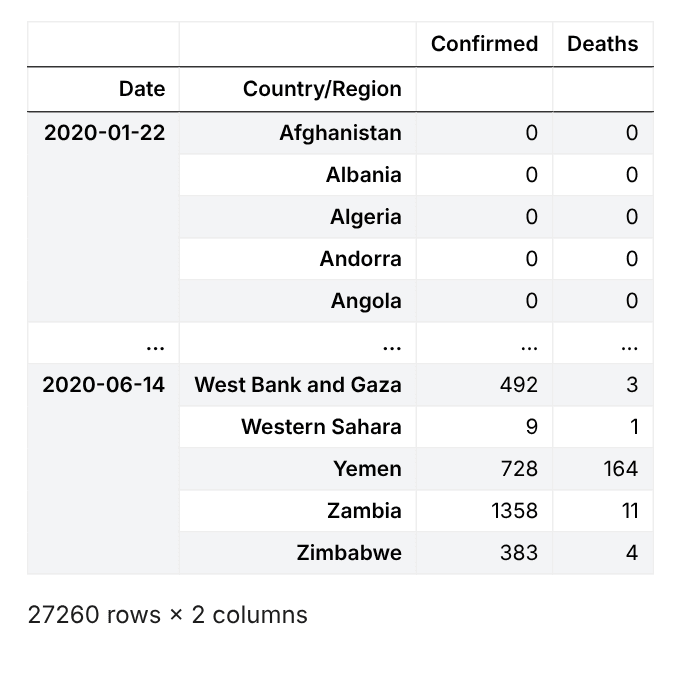
Obtenir les données pour un jour précis
Pour obtenir les chiffres d’un jour précis, utilise l’indexeur loc[] :
df_day = df_daily.loc[format_time('3/22/20')]

df_day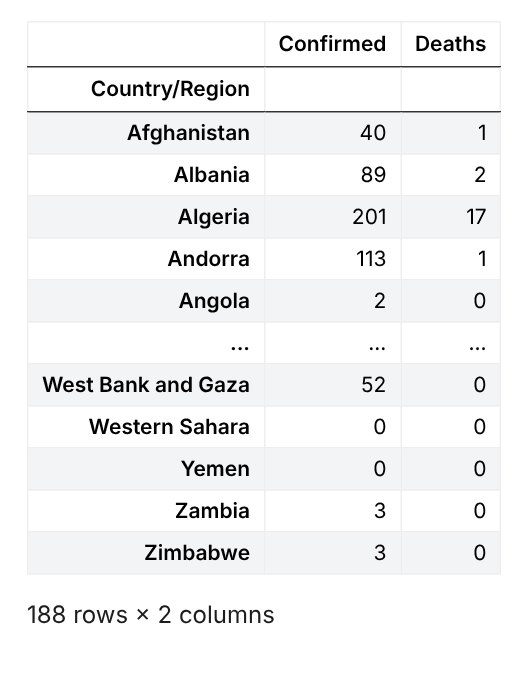
Obtenir les données pour un jour spécifique et pour un pays spécifique
Tu peux aussi récupérer les chiffres d’un pays en particulier :
USA
df_day_usa = df_daily.loc[(format_time('5/22/20'),'US')]

df_day_usaConfirmed 1608623
Deaths 96296
Name: (2020-05-22, US), dtype: int64France
df_day_france = df_daily.loc[(format_time('5/22/20'),'France')]

df_day_franceConfirmed 182354
Deaths 28292
Name: (2020-05-22, France), dtype: int64Afficher les données pour le jour le plus récent
Pour obtenir les chiffres du jour le plus récent, on récupère d’abord la dernière date du DataFrame, puis on s’en sert pour extraire les données de cette date :
# Obtenir la date la plus récente
most_recent_date = df_combined['Date'].max()
print(most_recent_date)2020-06-14# Obtenir toutes les données pour la date la plus récente
df_most_recent = df_daily.loc[most_recent_date,:]
df_most_recent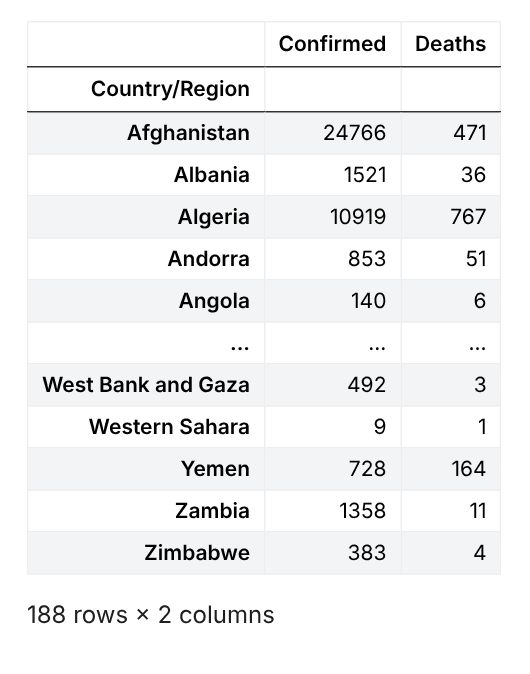
Les 10 premiers pays en termes de cas confirmés
Pour obtenir les 10 premiers pays en nombre de cas confirmés, trie le DataFrame df_most_recent selon la colonne Confirmed, puis affiche les 10 premières lignes :
df_most_confirmed_recent_sorted = df_most_recent.sort_values(
    by="Confirmed", ascending=False)

df_most_confirmed_recent_sorted.head(10)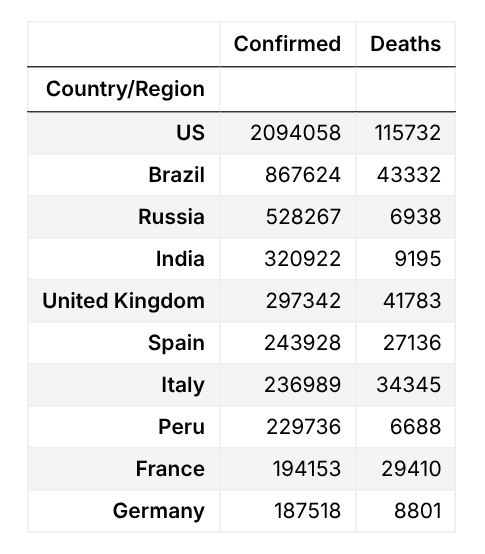
Afficher les chiffres les plus récents pour un pays spécifique
Utilise la fonction input() pour demander à l’utilisateur le pays dont il souhaite connaître les chiffres (ici, nous avons saisi « France ») :
df_most_recent[df_most_recent.index == input("Entrer le nom de pays : ")]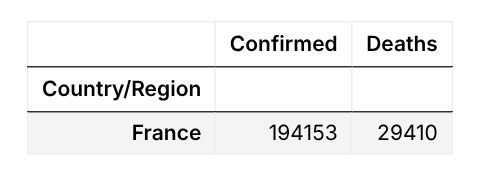
Les 10 pays où le plus grand nombre de décès ont été signalés
Pour obtenir les dix pays où le plus de décès ont été signalés, trie d’abord df_most_recent selon la colonne Deaths.
Filtre ensuite les pays qui n’ont signalé aucun décès, puis affiche les 10 premières lignes :
df_most_deaths_recent_sorted = df_most_recent.sort_values(
    by="Deaths", ascending=False)

df_most_deaths_recent_sorted = df_most_deaths_recent_sorted[
    df_most_deaths_recent_sorted.Deaths > 0]

df_most_deaths_recent_sorted.head(10)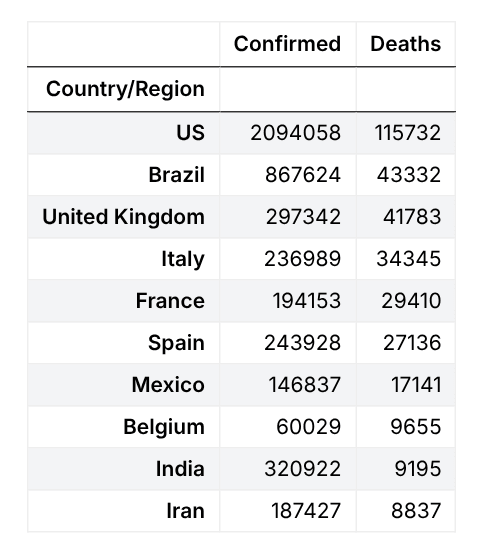
Afficher les données les plus récentes pour la Chine continentale
Dès les premiers jours de l’épidémie, plusieurs provinces chinoises ont été touchées. Voyons les chiffres de chacune d’elles :
# obtenir toutes les lignes pour la Chine continentale
df_combined_china = df_combined[df_combined['Country/Region'] == "China"]

# en utilisant le dataframe de la chine, grouper par date et par province
df_combined_china_date = df_combined_china.groupby(["Date","Province/State"]).aggregate(
    {'Confirmed': 'sum', 'Deaths': 'sum'})

# trouver les données pour la date la plus récente
df_combined_china_most_recent = df_combined_china_date.loc[most_recent_date,:]

df_combined_china_most_recent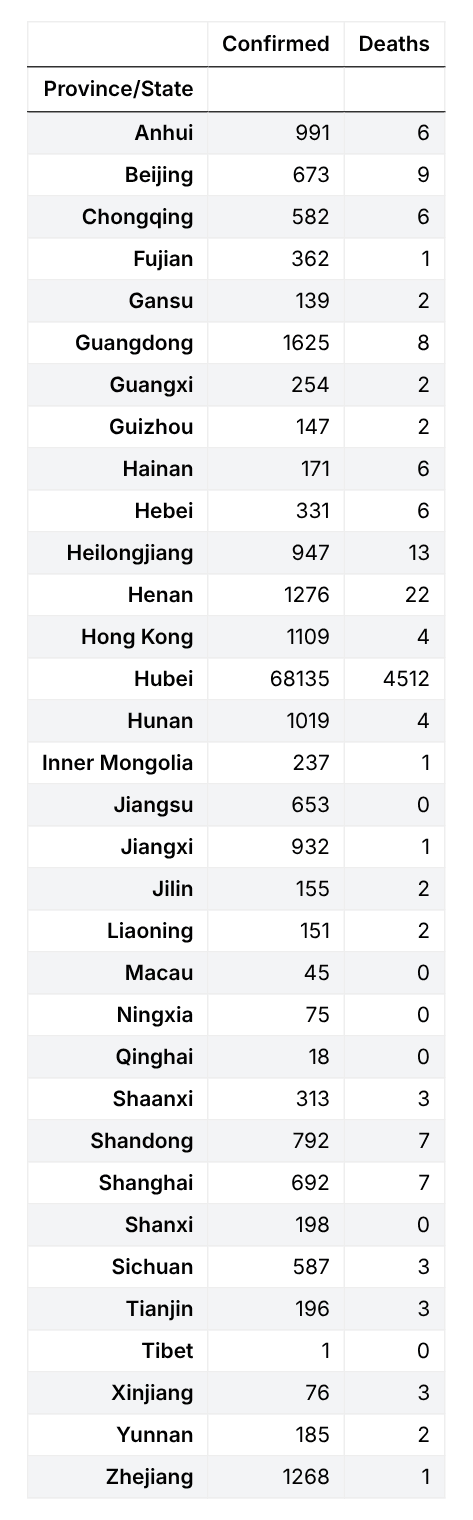
Afficher les 10 premières provinces de Chine avec des cas confirmés
Pour obtenir les dix provinces de Chine ayant le plus de cas confirmés, trie df_combined_china_most_recent selon la colonne Confirmed, puis récupère ses dix premières lignes :
df_combined_china_most_recent_sorted = df_combined_china_most_recent.sort_values(
    by="Confirmed", ascending=False).head(10)

df_combined_china_most_recent_sorted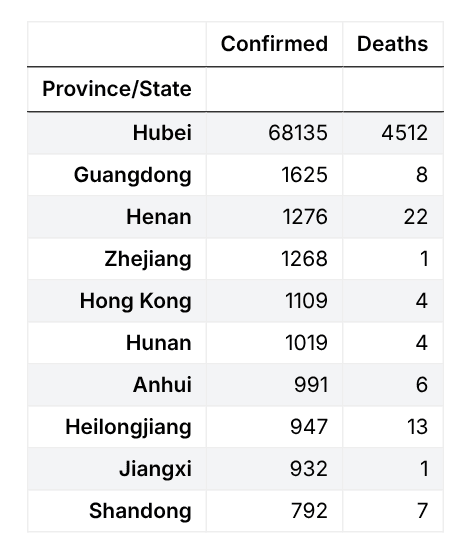
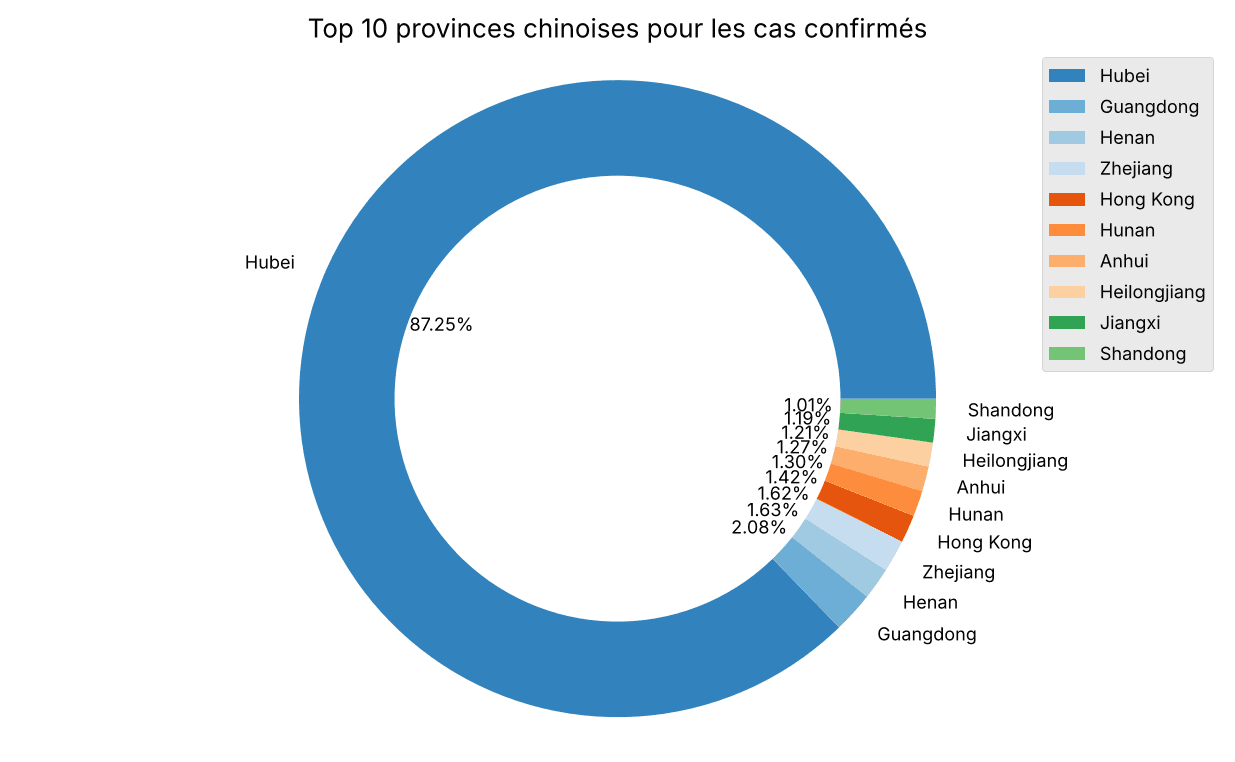
Comme tu peux le constater, le Hubei est la province la plus touchée en Chine : 68 135 des 84 335 cas confirmés du pays.
Les premiers cas de Covid-19 ont été identifiés à Wuhan, la capitale de la province du Hubei, en Chine.
Comment visualiser les données du Covid-19 avec Matplotlib et Folium ?
Maintenant que les données sont prêtes, passons à la visualisation. Certains DataFrames utilisés ici (df_combined, df_daily, df_most_recent, etc.) viennent de la première partie : exécute donc le code dans l’ordre.
Afficher des diagrammes à barres pour les cas confirmés et les décès pour chaque pays
Le premier visuel est une série de diagrammes à barres : le nombre total de cas confirmés et de décès pour chaque pays.
import matplotlib.pyplot as plt

plt.style.use('ggplot')
plt.rcParams["figure.figsize"] = (12, 7)

# pays à tracer (retire ce filtre pour obtenir un graphique par pays)
pays = ["Afghanistan", "US", "Singapore", "France"]

for country, df_country in df_daily.groupby(level=1):
    if country not in pays:
        continue

    dates = list(df_country.index.get_level_values('Date'))
    confirmed = list(df_country.Confirmed)
    deaths = list(df_country.Deaths)

    plt.bar(dates, confirmed, color='lightblue',
        label="Nombre total de cas confirmés")
    plt.bar(dates, deaths, color='red',
        label="Nombre total de décès signalés")
    plt.xlabel("Dates")
    plt.ylabel("Nombre de personnes")
    plt.title(country)
    plt.legend()
plt.show()Ce code parcourt les pays grâce à groupby(level=1) (le niveau 1 de l’index de df_daily est Country/Region), puis trace deux séries de barres avec plt.bar() : les cas confirmés et les décès. Cela produit un graphique par pays. Pour ne pas en afficher 188, la liste pays limite le tracé à quatre pays : retire la condition if pour tous les obtenir.
Voici le premier (Afghanistan) :
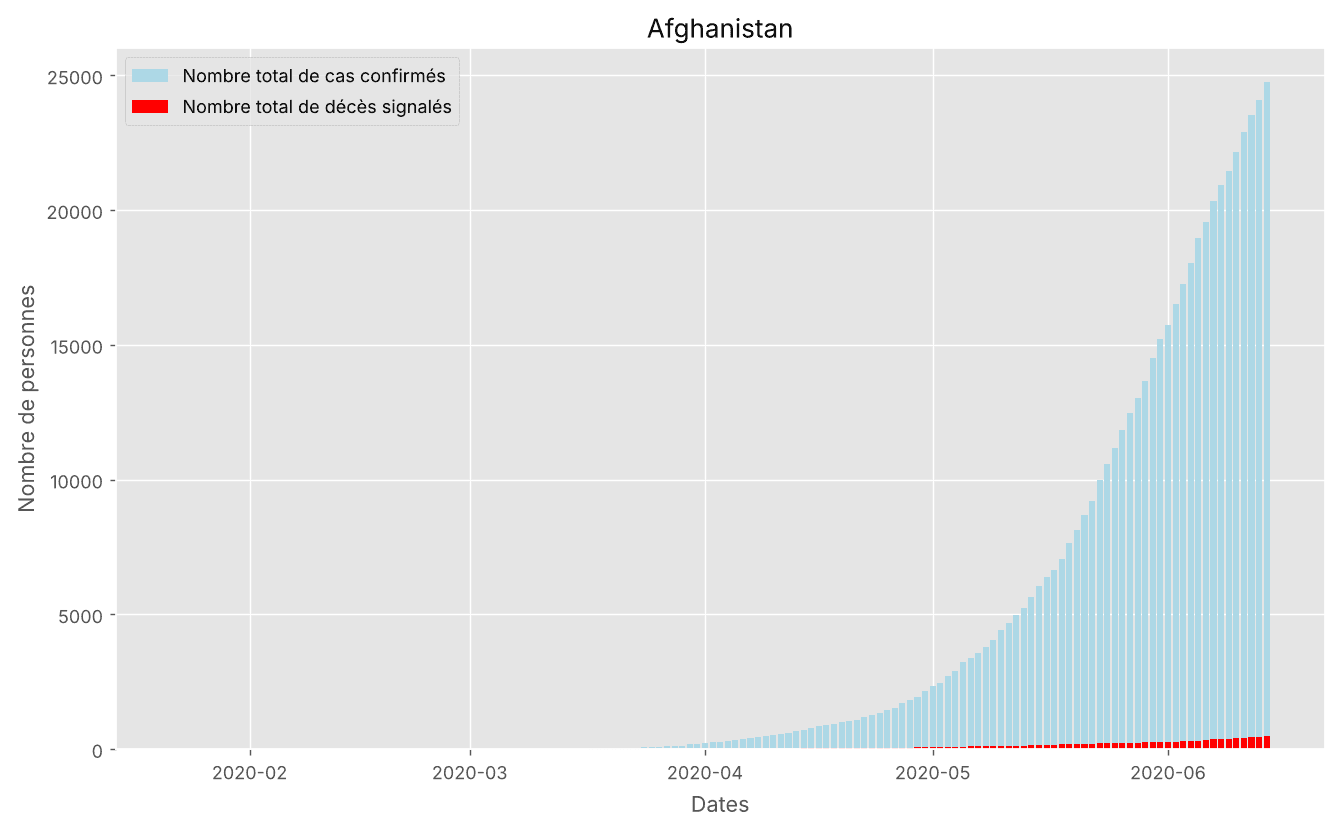
Les barres bleu clair représentent le nombre de cas confirmés à chaque date, et les barres rouges le nombre de décès. Voici le graphique pour les États-Unis :
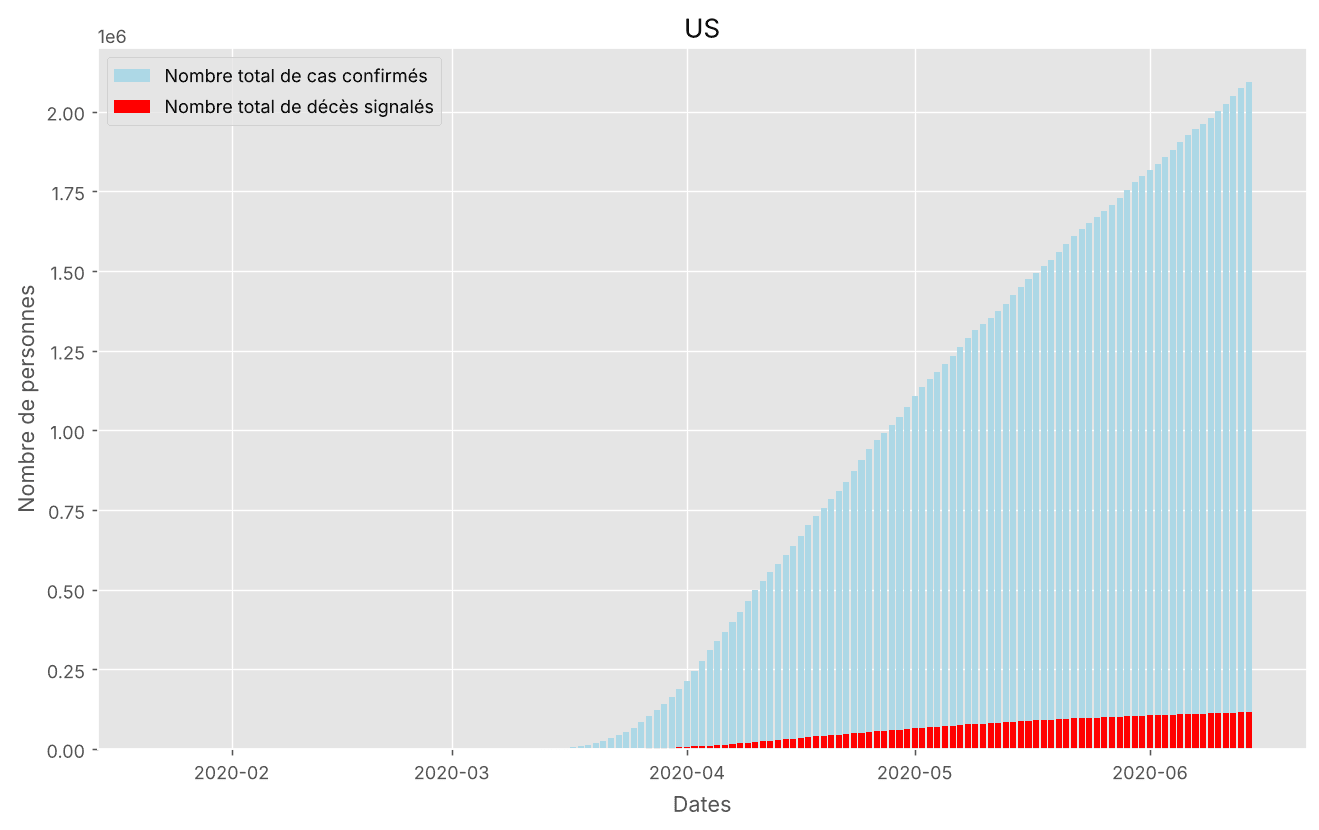
Attention : les nombres sont cumulatifs. La tendance est donc toujours à la hausse (au mieux, elle reste stable s’il n’y a pas de nouveaux cas).
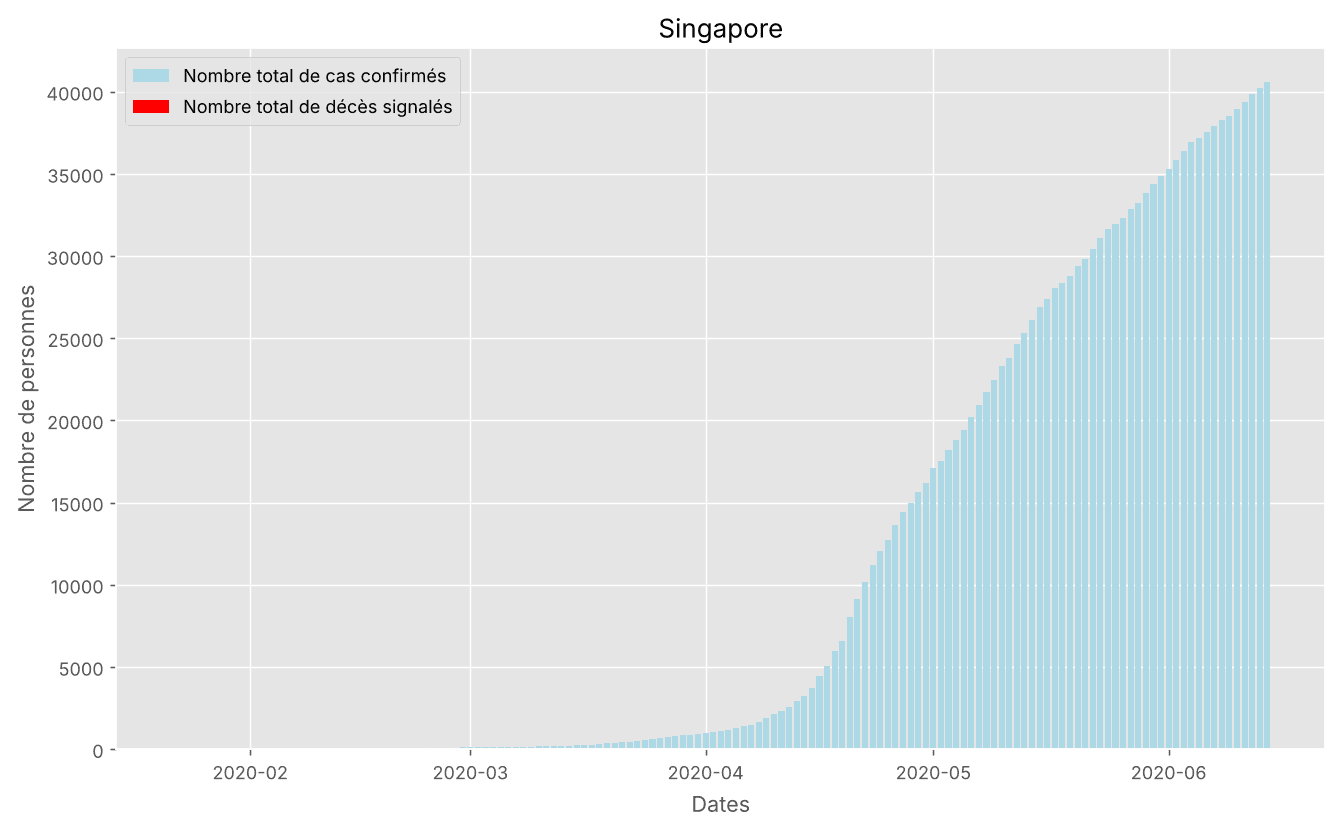
Pour les pays où le nombre de décès est faible par rapport aux cas confirmés, les barres rouges sont minuscules, voire invisibles. Singapour en est un exemple (26 décès pour 40 604 cas) :
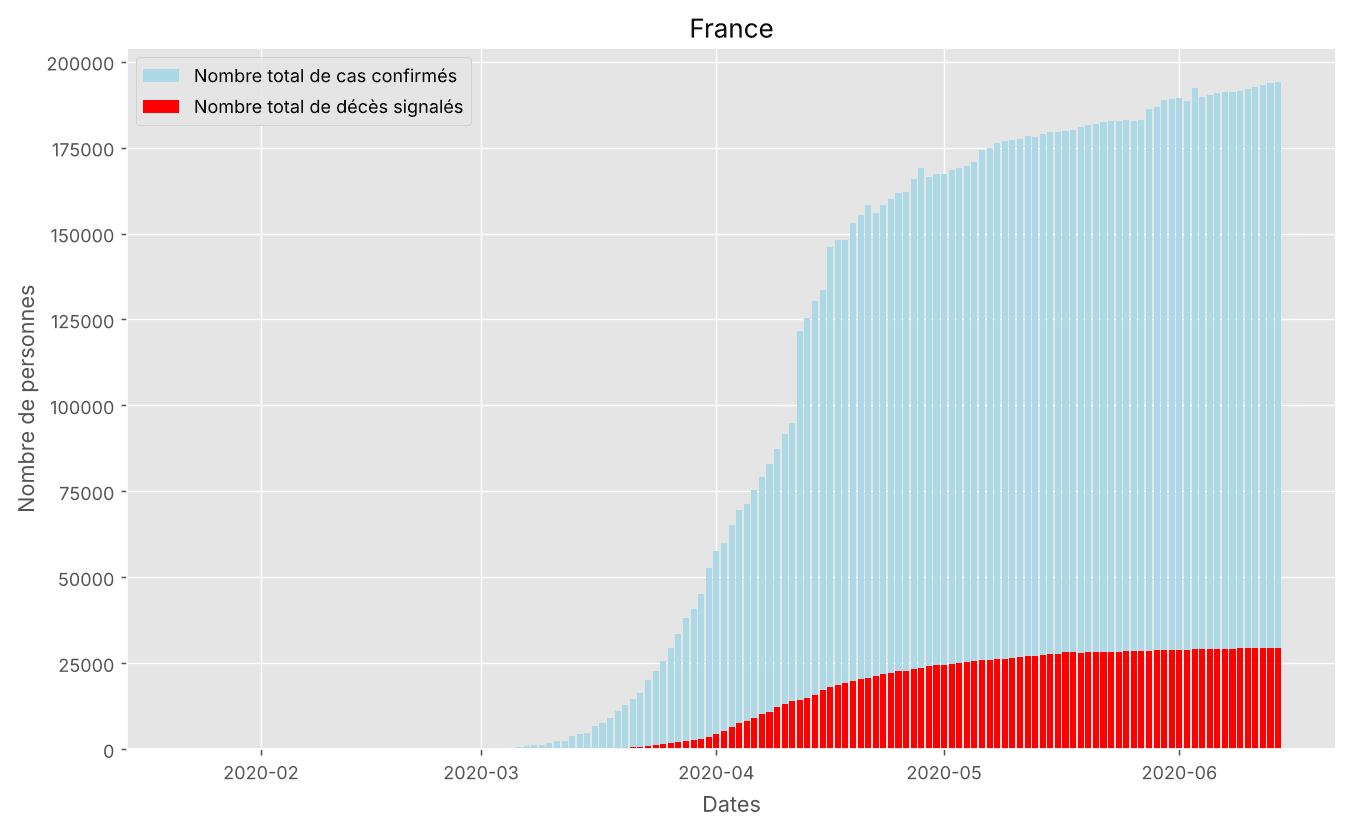
La France, en revanche, a un taux de mortalité relativement élevé (environ 15 % au 14 juin, avec des cas largement sous-estimés au début de l’épidémie, faute de tests) :
Créer des diagrammes circulaires
Le visuel suivant est un diagramme circulaire, aussi appelé camembert. Nous définissons pour cela la fonction plot_pie(df, column, title), qui prend trois arguments :
df: le DataFrame ;column: le nom de la colonne à utiliser dans ce DataFrame ;title: le titre du camembert.
Voici la fonction :
def plot_pie(df, column, title):
    labels = list(df.index)
    sizes = list(df[column])
    explode = [0] * len(labels)

    with plt.style.context(
        { "axes.prop_cycle" : plt.cycler("color",
        plt.cm.tab20c.colors)}):
        fig1, ax1 = plt.subplots()
        ax1.pie(sizes,
                explode=explode,
                labels=labels,
                autopct='%1.2f%%',
                shadow=False,
                startangle=0)
        ax1.axis('equal')  # Un rapport d'aspect égal garantit que le diagramme
                           # sera dessiné en cercle.
        plt.legend()
        plt.title(title)

    centre_circle = plt.Circle((0,0),0.70,fc='white')
    fig = plt.gcf()
    fig.gca().add_artist(centre_circle)
plt.show()La fonction trace le camembert avec ax1.pie(), puis ajoute un cercle blanc au centre (plt.Circle) pour obtenir un diagramme en anneau.
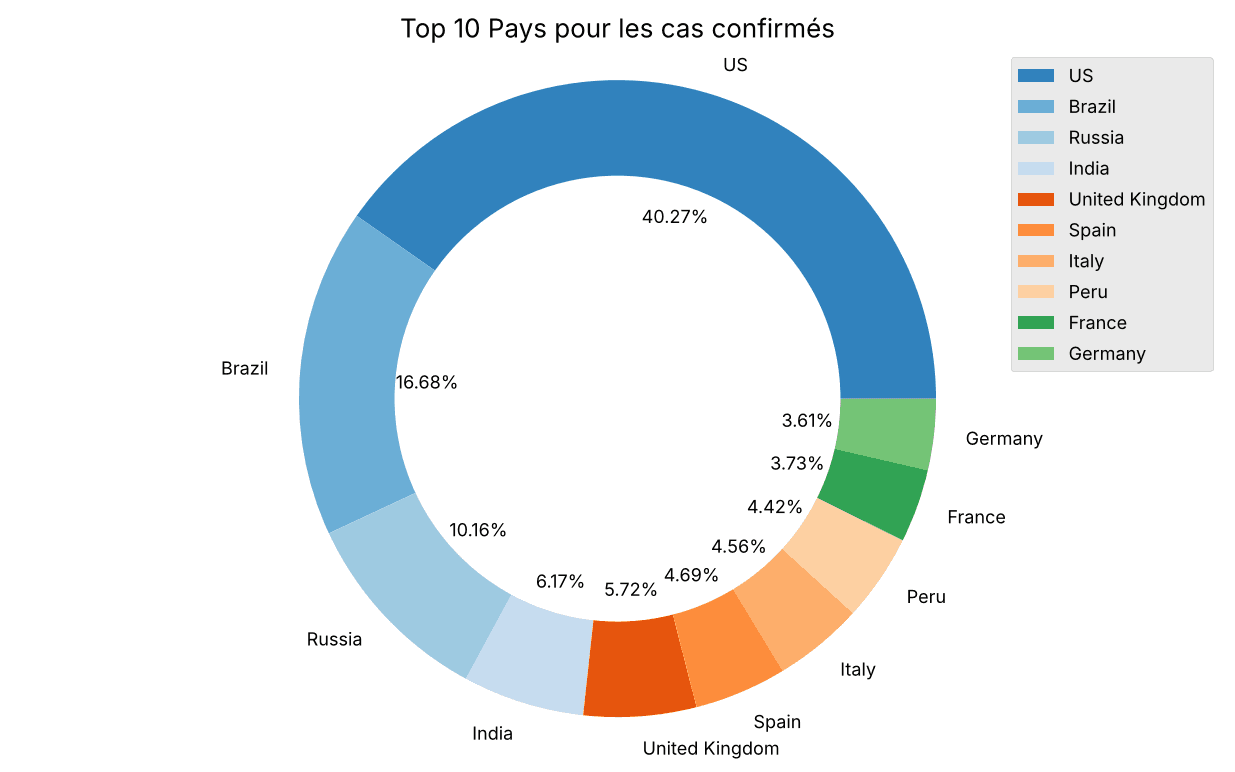
Afficher la répartition des 10 premiers pays pour le nombre de cas confirmés
Pour visualiser la répartition des 10 premiers pays où des cas ont été confirmés, traçons un graphique circulaire :
top10_countries_confirmed = df_most_confirmed_recent_sorted.head(10)
plot_pie(top10_countries_confirmed,
         "Confirmed",
"Top 10 Pays pour les cas confirmés")On obtient le graphique suivant. Parmi les 10 premiers pays, les États-Unis représentent 40 % du nombre total de cas confirmés.
Les 10 premières provinces de Chine avec des cas confirmés
Voyons maintenant les dix premières provinces de Chine où des cas ont été confirmés :
plot_pie(df_combined_china_most_recent_sorted,
         "Confirmed",
"Top 10 provinces chinoises pour les cas confirmés")Sans aucune surprise, le Hubei est l’épicentre de l’épidémie :
Les 10 premiers pays où des décès ont été signalés
Ensuite, on affiche les 10 premiers pays où des décès ont été signalés :
df_most_deaths_recent_sorted = df_most_deaths_recent_sorted.head(10)
plot_pie(df_most_deaths_recent_sorted,
         "Deaths",
"Top 10 des pays pour les décès")On obtient ceci :
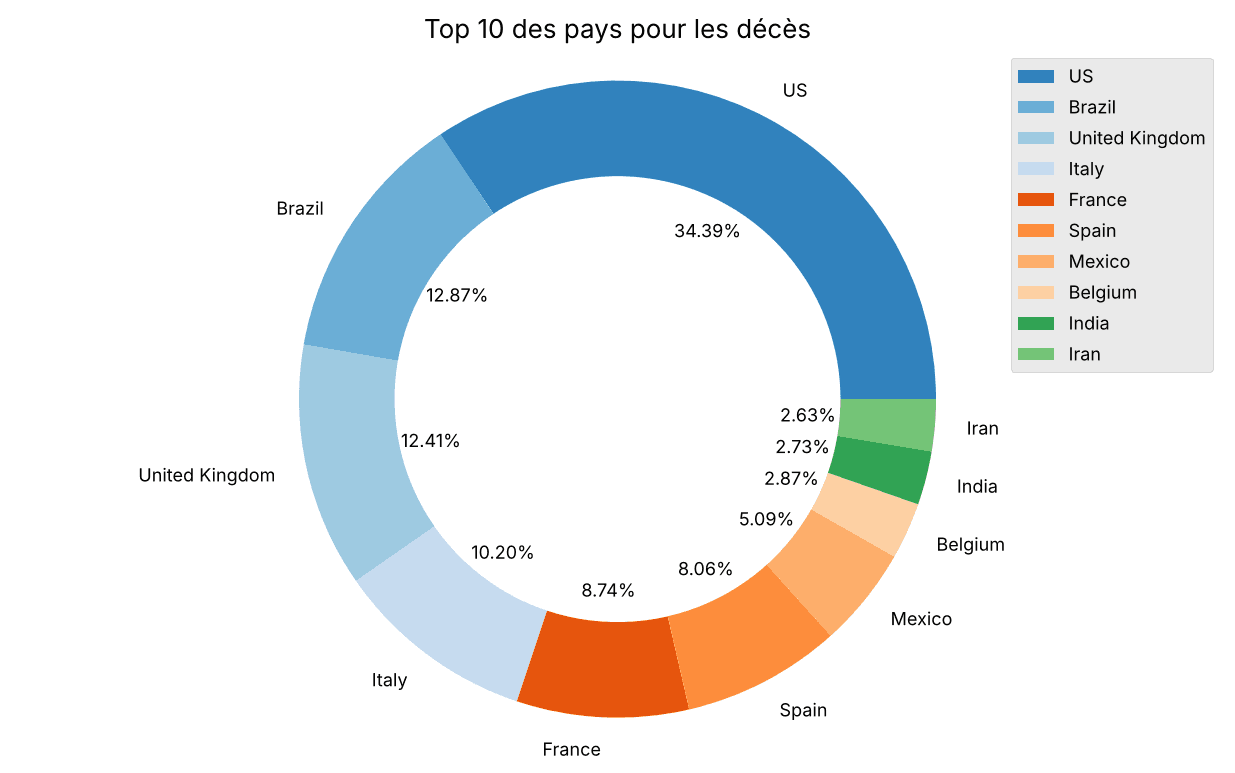
Bien que la France se classe 9e pour le nombre de cas confirmés, elle se classe 5e en termes de décès signalés.
Aplatir les courbes
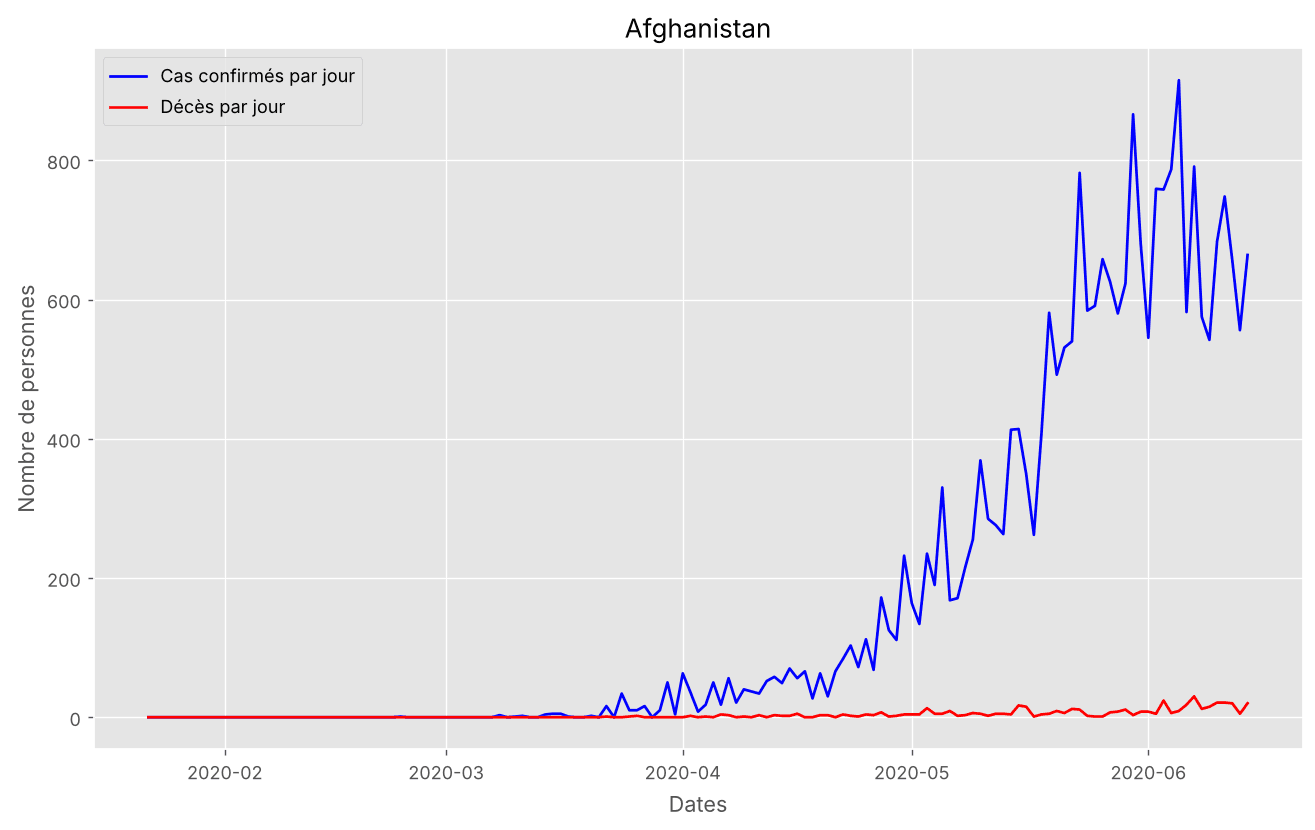
Rappelle-toi que les chiffres enregistrés (cas confirmés et décès) sont cumulatifs. Il est donc difficile de savoir si la situation d’un pays s’améliore ou s’aggrave.
Nous allons « dérouler » ces chiffres pour obtenir les nouveaux cas déclarés chaque jour :
plt.rcParams["figure.figsize"] = (12, 7)

# pays à tracer
pays = ["Afghanistan", "New Zealand", "South Africa", "Spain"]

# pour chaque pays
for country, df_country in df_daily.groupby(level=1):
    if country not in pays:
        continue

    # obtenir la liste des dates
    dates = list(df_country.index.get_level_values('Date'))

    # dérouler (inverse de la somme cumulée) les cas confirmés et les décès
    daily = df_country[['Confirmed', 'Deaths']]
    df_unrolled = daily.diff().fillna(daily)

    # tracer les graphiques linéaires
    plt.plot(dates, df_unrolled['Confirmed'], color='blue',
             label="Cas confirmés par jour")
    plt.plot(dates, df_unrolled['Deaths'], color='red',
             label="Décès par jour")
    plt.xlabel("Dates")
    plt.ylabel("Nombre de personnes")
    plt.title(country)
    plt.legend()
plt.show()Pour chaque pays, nous isolons les colonnes Confirmed et Deaths, puis diff() calcule la différence entre un jour et le précédent : on obtient les nouveaux cas du jour. Le premier jour n’a pas de jour précédent, donc diff() y renvoie NaN, que fillna() remplace par la valeur d’origine. Nous traçons ensuite une courbe par pays.
Voici un exemple (Afghanistan) :
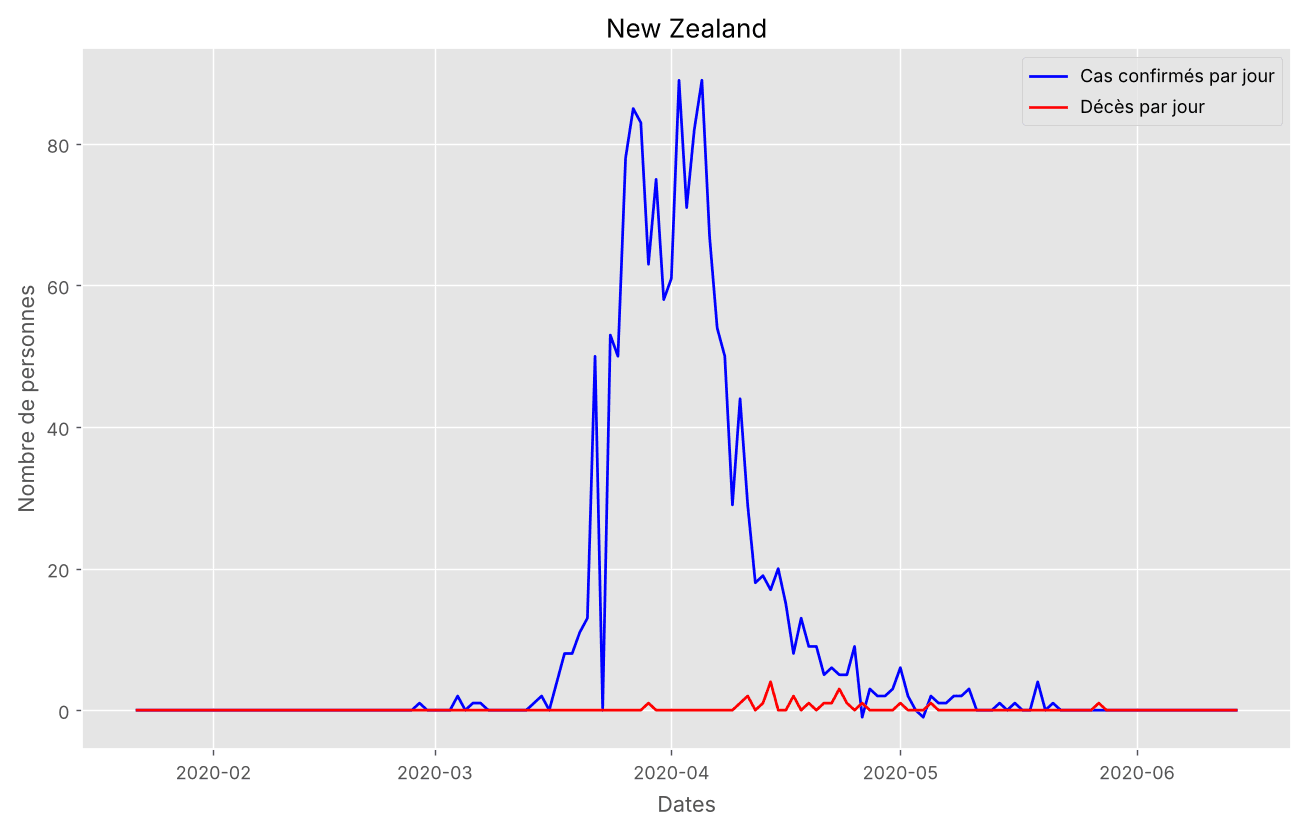
Comme tu peux le voir, la Nouvelle-Zélande avait presque vaincu le virus à cette date (aucun nouveau cas dans les sept derniers jours des données) :
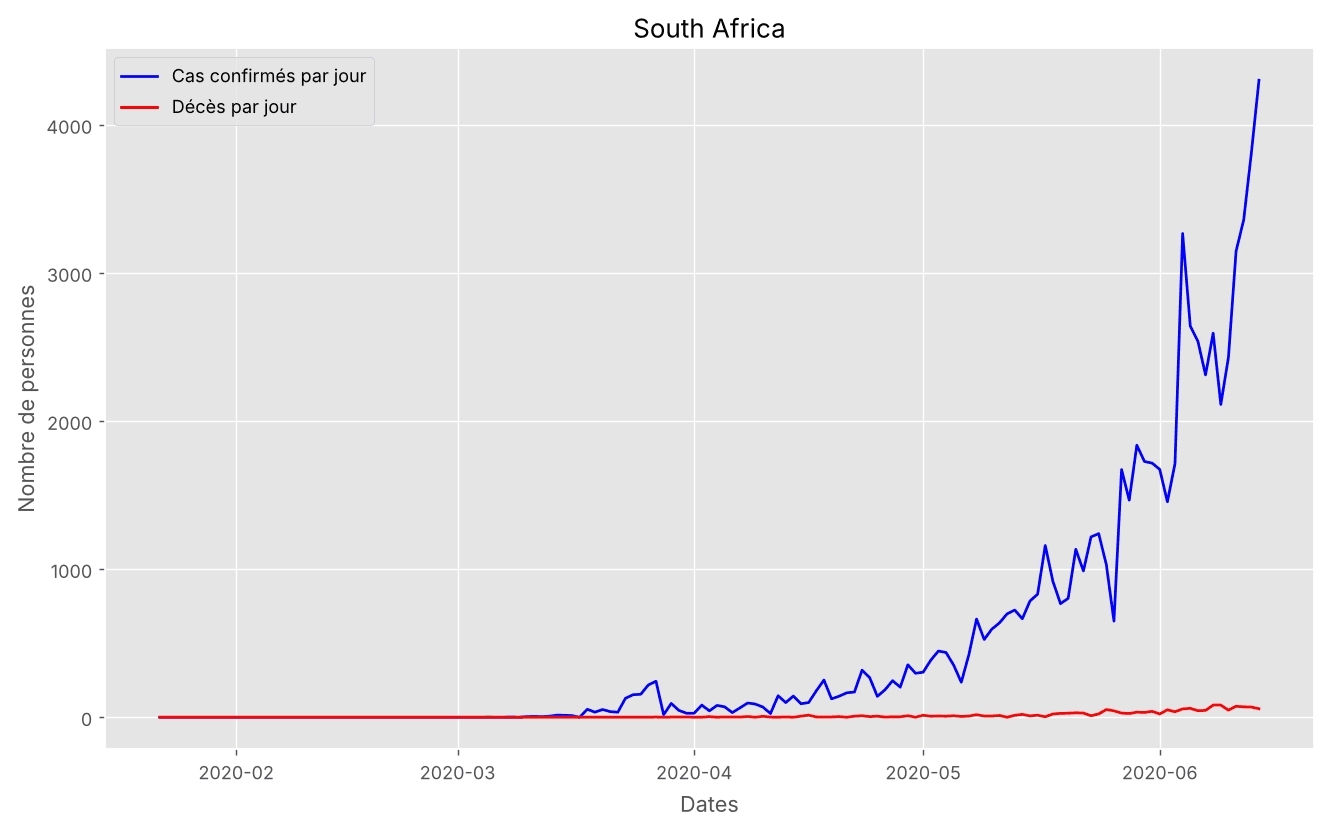
Alors que l’Afrique du Sud menait encore un combat difficile (plus de 4 000 nouveaux cas le 14 juin) :
Tu peux aussi constater que certains pays ont des « pics » qui passent sous 0 (ici, l’Espagne) :
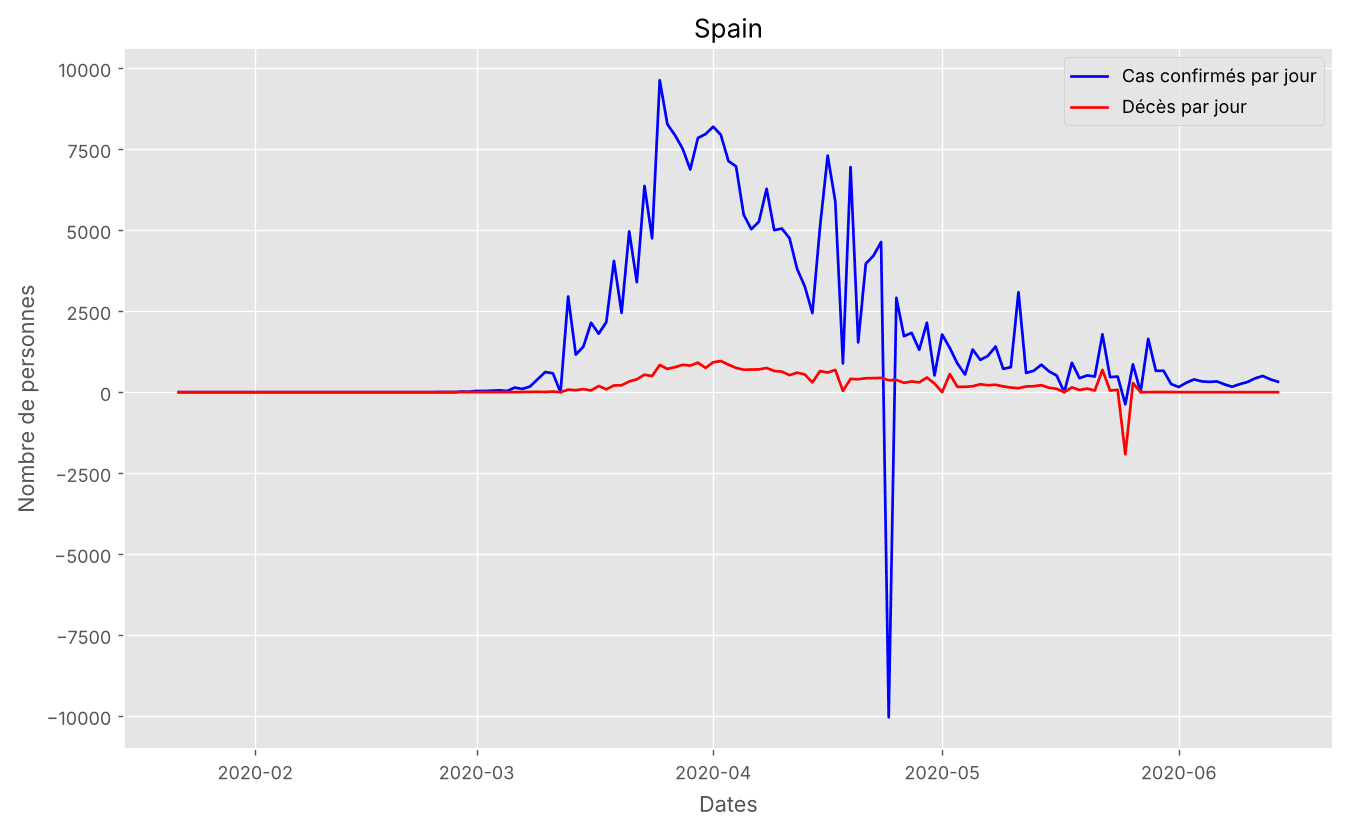
Cela s’explique probablement par des corrections apportées aux chiffres : un jour, le total cumulé est de 5000, puis il est corrigé à la baisse le lendemain (4000), par exemple à cause d’erreurs de tests ou d’enregistrement. Pour l’Espagne, la plus grosse correction (−10 034) date du 24 avril 2020.
Afficher tous les cas confirmés sur la carte du monde
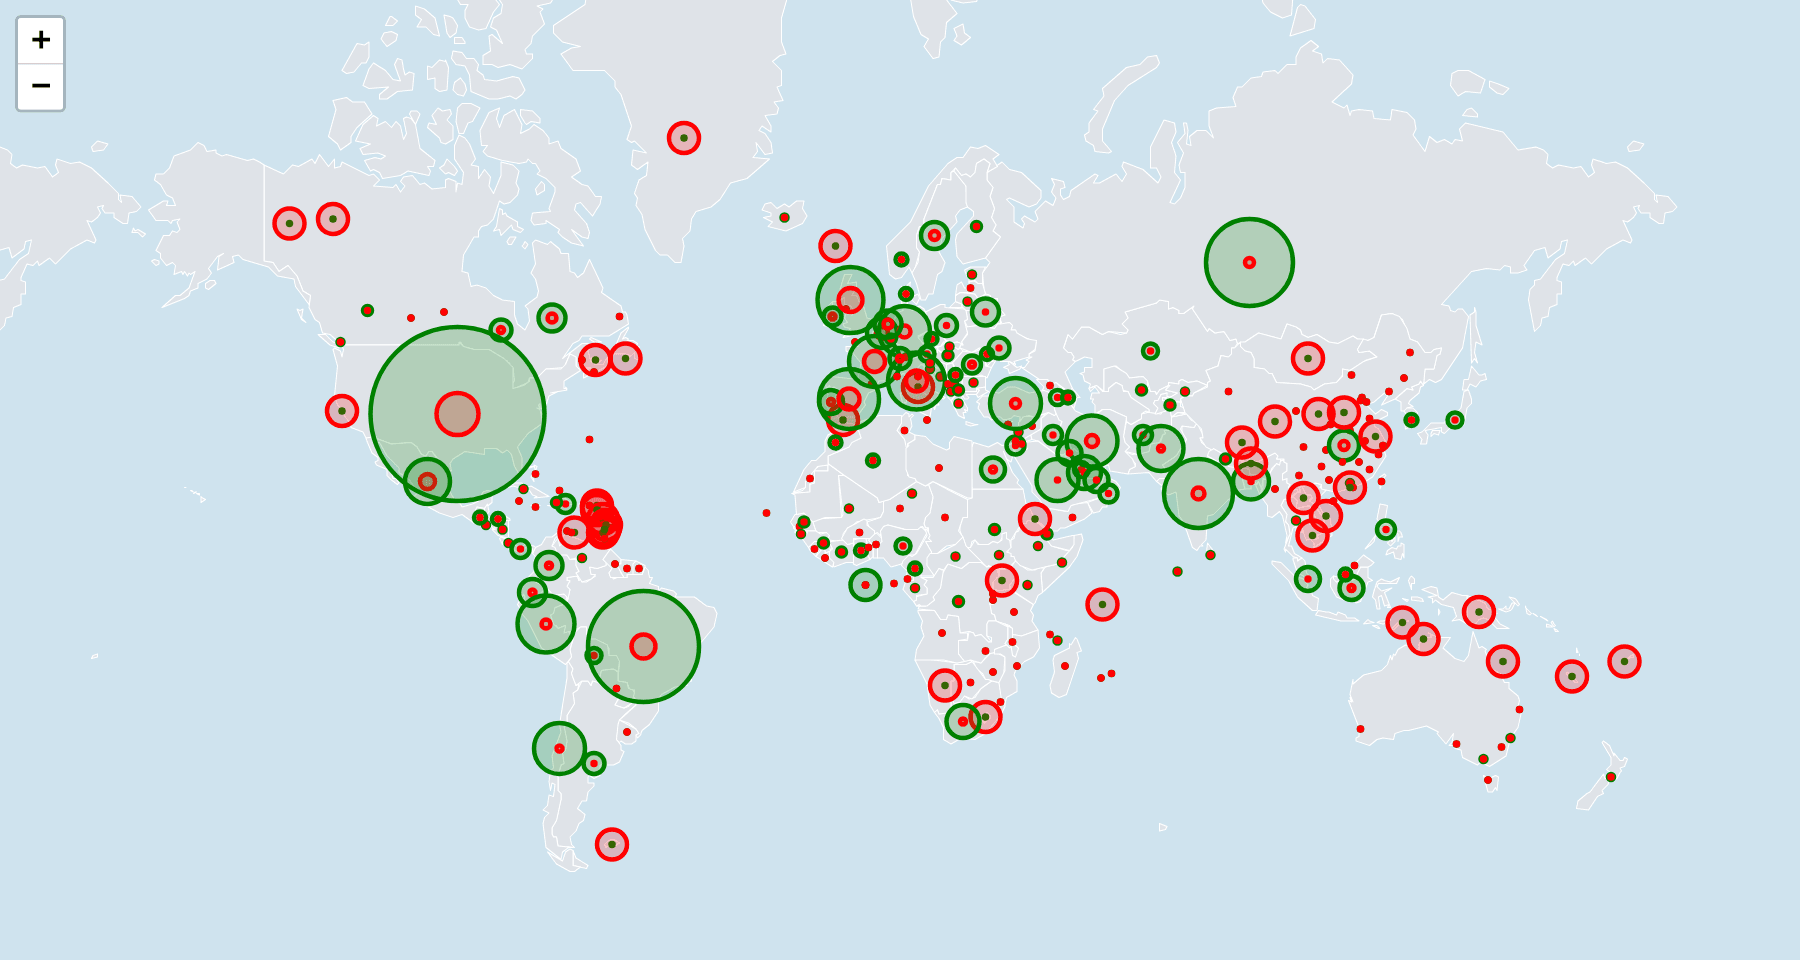
Enfin, affichons tous les cas sur une carte du monde. Nous traçons des cercles dont l’aire représente la gravité de la situation dans chaque pays : vert pour les cas confirmés et rouge pour les décès. Le rayon est proportionnel à la racine carrée du nombre de cas (np.sqrt()) : ainsi, c’est la surface du cercle, et non son rayon, qui est proportionnelle au nombre de cas, ce qui garde la carte lisible malgré l’écart entre les États-Unis et les petits pays.
import folium

# obtenir la date la plus récente du DataFrame
most_recent_date = df_combined['Date'].max()

# obtenir toutes les données de cette date la plus récente
df_latest_day = df_combined[df_combined.Date == most_recent_date]

# créer une carte
folium_map = folium.Map(location=[40.738, -73.98], zoom_start=4)
scale = 25

for _, row in df_latest_day.iterrows():
    lat = row["Lat"]
    lng = row["Long"]
    confirmed = row["Confirmed"]
    deaths = row["Deaths"]

    # Cas confirmés : cercle sur la province/état/région/pays
    marker_confirmed = folium.CircleMarker(location=[lat, lng],
                                           radius=np.sqrt(confirmed) / scale,
                                           color="green",
                                           fill=True)
    marker_confirmed.add_to(folium_map)

    # Décès : cercle sur la province/état/région/pays
    marker_deaths = folium.CircleMarker(location=[lat, lng],
                                        radius=np.sqrt(deaths) / scale,
                                        color="red",
                                        fill=True)
    marker_deaths.add_to(folium_map)

folium_map.save("Covid-19 Map.html")Pour la carte, nous utilisons la bibliothèque Folium, qui permet de créer des cartes de type Leaflet. Leaflet est la principale bibliothèque JavaScript open source pour les cartes interactives adaptées aux mobiles. Le fond de carte par défaut est OpenStreetMap.
Pour installer Folium, tape cette commande dans ton terminal :
pip install foliumLa carte est enregistrée dans un fichier HTML que tu peux ouvrir dans ton navigateur. Dans un notebook, tu peux aussi afficher directement folium_map, puis zoomer et déplacer la carte avec la souris.
Voici la carte obtenue, dézoomée pour voir le monde entier :
Questions fréquentes
Où trouver les données du Covid-19 pour s’entraîner avec Python ?
Sur Kaggle (le jeu « Novel Corona Virus 2019 Dataset ») et dans le dépôt GitHub de l’université Johns Hopkins, sous licence CC BY 4.0. Le centre de l’université a cessé de collecter les données le 10 mars 2023 : le jeu est figé, ce qui le rend reproductible. Les trois fichiers de cet article (version du 14 juin 2020) sont aussi dans le dossier GitHub de l’article.
Comment transformer des colonnes de dates en une seule colonne avec Pandas ?
Avec la méthode melt() : tu indiques les colonnes à conserver (id_vars), les colonnes de dates à « dépivoter » (value_vars) et les noms des deux nouvelles colonnes (var_name pour la date, value_name pour la valeur). On passe ainsi de 266 lignes × 149 colonnes à 38 570 lignes, une par pays et par date.
Comment obtenir les nouveaux cas par jour à partir de cas cumulés ?
Avec diff(), qui calcule la différence entre chaque ligne et la précédente, puis fillna() pour garder la valeur du premier jour. Si le total cumulé est corrigé à la baisse, la différence devient négative : c’est ce qui crée les pics sous zéro de la courbe de l’Espagne.
Pourquoi le fichier des cas de rétablissement n’a-t-il pas la même forme ?
Parce qu’il enregistre le Canada sur une seule ligne, alors que les fichiers des cas confirmés et des décès le découpent en 14 lignes (provinces et paquebots) : 253 lignes contre 266. Pour les comparer, il faudrait d’abord regrouper le Canada par pays dans les deux autres fichiers.
Comment afficher des données du Covid-19 sur une carte avec Python ?
Avec Folium : tu crées une carte avec folium.Map(), puis tu ajoutes un folium.CircleMarker() par lieu, à partir de sa latitude et de sa longitude. Prends la racine carrée du nombre de cas pour le rayon : la surface des cercles reste proportionnelle aux chiffres. La carte se sauvegarde en HTML avec save().
Peut-on comparer les pays avec ces chiffres ?
Pas tels quels. Le nombre de cas confirmés dépend du nombre de tests réalisés et de la façon dont chaque pays compte et corrige ses chiffres, et les populations diffèrent beaucoup (pour comparer, rapporte les chiffres au nombre d’habitants). Cet article sert à apprendre Pandas et la visualisation, pas à tirer des conclusions épidémiologiques.
Conclusion
Avec Pandas, nous avons nettoyé, regroupé et exploré les données du Covid-19. Avec Matplotlib et Folium, nous les avons mises en images : au lieu de lire des tableaux de chiffres, des graphiques et une carte permettent de transmettre l’essentiel beaucoup plus facilement.
Savoir lire un tableau de chiffres, c’est bien ; savoir en tirer le bon graphique, c’est mieux. Le cours Analyse et visualisation de données de DataXp t’entraîne sur des jeux de données réels. Tu écris et exécutes ton code dans le navigateur, avec des exercices corrigés, et les premiers chapitres sont gratuits.
Pour aller plus loin :